

O Qwen-Coder é um modelo de linguagem projetado para tarefas de código. Você pode usar a API para gerar código, completar código e chamar ferramentas para interagir com sistemas externos.
Recomendamos o uso dos modelos de uso geral mais recentes em vez dos modelos Qwen-Coder. Para obter mais informações, consulte Geração de texto para selecionar um modelo adequado ao seu cenário.
Primeiros passos
Antes de começar, obtenha uma chave de API e configure-a como uma variável de ambiente. Se você utilizar um kit de desenvolvimento de software (SDK), será necessário instalar o SDK da OpenAI ou do DashScope. O exemplo a seguir mostra como chamar o modeloqwen3-coder-next para escrever uma função em Python que encontra números primos.
- API Chat Completions compatível com OpenAI
- DashScope
- Python
- Node.js
- curl
Exemplo de solicitaçãoResposta
Copy
import os
from openai import OpenAI
client = OpenAI(
# API keys vary by region. To get an API key, visit: https://www.alibabacloud.com/help/en/model-studio/get-api-key
# If the environment variable is not configured, replace the following line with your Alibaba Cloud Model Studio API key: api_key="sk-xxx",
api_key=os.getenv("DASHSCOPE_API_KEY"),
base_url="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1",
)
completion = client.chat.completions.create(
model="qwen3-coder-next",
messages=[
{'role': 'system', 'content': 'You are a helpful assistant.'},
{'role': 'user', 'content': 'Write a Python function named find_prime_numbers that takes an integer n as a parameter and returns a list of all prime numbers less than n. Do not output non-code content or Markdown code blocks.'}],
)
print(completion.choices[0].message.content)
Copy
def find_prime_numbers(n):
if n <= 2:
return []
primes = []
for num in range(2, n):
is_prime = True
for i in range(2, int(num ** 0.5) + 1):
if num % i == 0:
is_prime = False
break
if is_prime:
primes.append(num)
return primes
Exemplo de solicitaçãoResposta
Copy
import OpenAI from "openai";
const client = new OpenAI(
{
// API keys vary by region. To get an API key, visit: https://www.alibabacloud.com/help/en/model-studio/get-api-key
// If the environment variable is not configured, replace the following line with your Model Studio API key: apiKey: "sk-xxx",
apiKey: process.env.DASHSCOPE_API_KEY,
// The following URL is for the Singapore region. When making a call, replace {WorkspaceId} with your actual workspace ID. URLs vary by region.
baseURL: "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1"
}
);
async function main() {
const completion = await client.chat.completions.create({
model: "qwen3-coder-next",
messages: [
{ role: "system", content: "You are a helpful assistant." },
{ role: "user", content: "Write a Python function named find_prime_numbers that takes an integer n as a parameter and returns a list of all prime numbers less than n. Do not output non-code content or Markdown code blocks." }
],
});
console.log(completion.choices[0].message.content);
}
main();
Copy
def find_prime_numbers(n):
if n <= 2:
return []
primes = []
for num in range(2, n):
is_prime = True
for i in range(2, int(num ** 0.5) + 1):
if num % i == 0:
is_prime = False
break
if is_prime:
primes.append(num)
return primes
Exemplo de solicitaçãoAs URLs variam conforme a região.Resposta
Copy
curl -X POST https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1/chat/completions \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "qwen3-coder-next",
"messages": [
{
"role": "system",
"content": "You are a helpful assistant."
},
{
"role": "user",
"content": "Write a Python function named find_prime_numbers that takes an integer n as a parameter and returns a list of all prime numbers less than n. Do not output non-code content or Markdown code blocks."
}
]
}'
Copy
{
"model": "qwen3-coder-next",
"id": "chatcmpl-3123d5cb-01b8-9a90-98cc-5bffbb369xxx",
"choices": [
{
"message": {
"content": "def find_prime_numbers(n):\n if n <= 2:\n return []\n \n primes = []\n for num in range(2, n):\n is_prime = True\n for i in range(2, int(num ** 0.5) + 1):\n if num % i == 0:\n is_prime = False\n break\n if is_prime:\n primes.append(num)\n \n return primes",
"role": "assistant"
},
"index": 0,
"finish_reason": "stop"
}
],
"created": 1770108104,
"object": "chat.completion",
"usage": {
"total_tokens": 155,
"completion_tokens": 89,
"prompt_tokens": 66
}
}
- Python
- Java
- curl
Exemplo de solicitaçãoResposta
Copy
import dashscope
import os
dashscope.base_http_api_url = 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1'
messages = [
{
"role": "system",
"content": "You are a helpful assistant."
},
{
"role": "user",
"content": "Write a Python function named find_prime_numbers that takes an integer n as a parameter and returns a list of all prime numbers less than n. Do not output non-code content or Markdown code blocks."
}
]
response = dashscope.Generation.call(
# API keys vary by region. To get an API key, visit: https://www.alibabacloud.com/help/en/model-studio/get-api-key
# If the environment variable is not configured, replace the following line with your Alibaba Cloud Model Studio API key: api_key = "sk-xxx",
api_key=os.getenv("DASHSCOPE_API_KEY"),
model="qwen3-coder-next",
messages=messages,
result_format="message"
)
if response.status_code == 200:
print(response.output.choices[0].message.content)
else:
print(f"HTTP return code: {response.status_code}")
print(f"Error code: {response.code}")
print(f"Error message: {response.message}")
Copy
def find_prime_numbers(n):
if n <= 2:
return []
primes = []
for num in range(2, n):
is_prime = True
for i in range(2, int(num ** 0.5) + 1):
if num % i == 0:
is_prime = False
break
if is_prime:
primes.append(num)
return primes
Exemplo de solicitaçãoResposta
Copy
import java.util.Arrays;
import com.alibaba.dashscope.aigc.generation.Generation;
import com.alibaba.dashscope.aigc.generation.GenerationResult;
import com.alibaba.dashscope.aigc.generation.GenerationParam;
import com.alibaba.dashscope.common.Message;
import com.alibaba.dashscope.common.Role;
import com.alibaba.dashscope.exception.ApiException;
import com.alibaba.dashscope.exception.InputRequiredException;
import com.alibaba.dashscope.exception.NoApiKeyException;
import com.alibaba.dashscope.protocol.Protocol;
public class Main {
public static GenerationResult callWithMessage()
throws NoApiKeyException, ApiException, InputRequiredException {
String apiKey = System.getenv("DASHSCOPE_API_KEY");
Generation gen = new Generation(Protocol.HTTP.getValue(), "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1");
Message sysMsg = Message.builder()
.role(Role.SYSTEM.getValue())
.content("You are a helpful assistant.").build();
Message userMsg = Message.builder()
.role(Role.USER.getValue())
.content("Write a Python function named find_prime_numbers that takes an integer n as a parameter and returns a list of all prime numbers less than n. Do not output non-code content or Markdown code blocks.").build();
GenerationParam param = GenerationParam.builder()
.apiKey(apiKey)
.model("qwen3-coder-next")
.messages(Arrays.asList(sysMsg, userMsg))
.resultFormat(GenerationParam.ResultFormat.MESSAGE)
.build();
return gen.call(param);
}
public static void main(String[] args){
try {
GenerationResult result = callWithMessage();
System.out.println(result.getOutput().getChoices().get(0).getMessage().getContent());
} catch (ApiException | NoApiKeyException | InputRequiredException e) {
System.err.println("Request exception: " + e.getMessage());
e.printStackTrace();
}
}
}
Copy
def find_prime_numbers(n):
if n <= 2:
return []
primes = []
for num in range(2, n):
is_prime = True
for i in range(2, int(num ** 0.5) + 1):
if num % i == 0:
is_prime = False
break
if is_prime:
primes.append(num)
return primes
Exemplo de solicitaçãoAs URLs variam conforme a região.Resposta
Copy
curl -X POST "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1/services/aigc/text-generation/generation" \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "qwen3-coder-next",
"input":{
"messages":[
{
"role": "system",
"content": "You are a helpful assistant."
},
{
"role": "user",
"content": "Write a Python function named find_prime_numbers that takes an integer n as a parameter and returns a list of all prime numbers less than n. Do not output non-code content or Markdown code blocks."
}
]
},
"parameters": {
"result_format": "message"
}
}'
Copy
{
"output": {
"choices": [
{
"message": {
"content": "def find_prime_numbers(n):\n if n <= 2:\n return []\n \n primes = []\n for num in range(2, n):\n is_prime = True\n for i in range(2, int(num ** 0.5) + 1):\n if num % i == 0:\n is_prime = False\n break\n if is_prime:\n primes.append(num)\n \n return primes",
"role": "assistant"
},
"finish_reason": "stop"
}
]
},
"usage": {
"total_tokens": 155,
"input_tokens": 66,
"output_tokens": 89
},
"request_id": "dd78b1cf-8029-46bb-9bea-b794ded7bxxx"
}
Capacidades principais
Chamada de ferramentas
Forneça ao modelo um conjunto de ferramentas para interagir com ambientes externos, como leitura e escrita de arquivos, chamada de APIs ou operação de bancos de dados. O modelo decide se e como chamar essas ferramentas com base nas suas instruções. Para obter mais informações, consulte Function Calling. O fluxo completo de chamada de ferramentas inclui:- Definir ferramentas e iniciar uma solicitação: Defina uma lista de ferramentas na solicitação e instrua o modelo a concluir uma tarefa que exija essas ferramentas.
- Executar as ferramentas: Analise os
tool_callsretornados pelo modelo e chame as funções de ferramenta correspondentes implementadas localmente para executar a tarefa. - Retornar os resultados da execução: Empacote os resultados da execução da ferramenta em um formato específico e envie-os de volta ao modelo. O modelo utiliza esses resultados para concluir a tarefa final.
write_file para salvá-lo em um arquivo local.
- API Chat Completions compatível com OpenAI
- DashScope
- Python
- Node.js
- curl
Copy
import os
import json
from openai import OpenAI
client = OpenAI(
# API keys vary by region. To get an API key, visit: https://www.alibabacloud.com/help/en/model-studio/get-api-key
# If the environment variable is not configured, replace the following line with your Alibaba Cloud Model Studio API key: api_key="sk-xxx",
api_key=os.getenv("DASHSCOPE_API_KEY"),
base_url="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1",
)
tools = [
{
"type": "function",
"function": {
"name": "write_file",
"description": "Writes content to a specified file. Creates the file if it does not exist.",
"parameters": {
"type": "object",
"properties": {
"path": {
"type": "string",
"description": "The relative or absolute path of the object file."
},
"content": {
"type": "string",
"description": "The string content to write to the file."
}
},
"required": ["path", "content"]
}
}
}
]
# Implement the tool function
def write_file(path: str, content: str) -> str:
"""Writes content to a file."""
try:
# Ensure the directory exists
os.makedirs(os.path.dirname(path),
exist_ok=True) if os.path.dirname(path) else None
with open(path, 'w', encoding='utf-8') as f:
f.write(content)
return f"Success: The file '{path}' has been written."
except Exception as e:
return f"Error: An exception occurred while writing the file - {str(e)}"
messages = [{"role": "user", "content": "Write a Python quicksort algorithm and name the file quick_sort.py."}]
completion = client.chat.completions.create(
model="qwen3-coder-next",
messages=messages,
tools=tools
)
assistant_output = completion.choices[0].message
if assistant_output.content is None:
assistant_output.content = ""
messages.append(assistant_output)
# If no tool call is needed, print the content directly
if assistant_output.tool_calls is None:
print(f"No tool call needed. Direct response: {assistant_output.content}")
else:
# Enter the tool calling loop
while assistant_output.tool_calls is not None:
for tool_call in assistant_output.tool_calls:
tool_call_id = tool_call.id
func_name = tool_call.function.name
arguments = json.loads(tool_call.function.arguments)
print(f"Calling tool [{func_name}] with arguments: {arguments}")
# Execute the tool
tool_result = write_file(**arguments)
# Construct the tool return message
tool_message = {
"role": "tool",
"tool_call_id": tool_call_id,
"content": tool_result,
}
print(f"Tool returned: {tool_message['content']}")
messages.append(tool_message)
# Call the model again to get a summarized natural language response
response = client.chat.completions.create(
model="qwen3-coder-next",
messages=messages,
tools=tools
)
assistant_output = response.choices[0].message
if assistant_output.content is None:
assistant_output.content = ""
messages.append(assistant_output)
print(f"Final model response: {assistant_output.content}")
Copy
Calling tool [write_file] with arguments: {'content': 'def quick_sort(arr):\\n if len(arr) <= 1:\\n return arr\\n pivot = arr[len(arr) // 2]\\n left = [x for x in arr if x < pivot]\\n middle = [x for x in arr if x == pivot]\\n right = [x for x in arr if x > pivot]\\n return quick_sort(left) + middle + quick_sort(right)\\n\\nif __name__ == \\"__main__\\":\\n example_list = [3, 6, 8, 10, 1, 2, 1]\\n print(\\"Original list:\\", example_list)\\n sorted_list = quick_sort(example_list)\\n print(\\"Sorted list:\\", sorted_list)', 'path': 'quick_sort.py'}
Tool returned: Success: The file 'quick_sort.py' has been written.
Final model response: I have created a file named `quick_sort.py` for you, which contains the Python implementation of the quicksort algorithm. You can run this file to see the example output. Let me know if you need any further modifications or explanations!
Copy
import OpenAI from "openai";
import fs from "fs/promises";
import path from "path";
const client = new OpenAI({
// API keys vary by region. To get an API key, visit: https://www.alibabacloud.com/help/en/model-studio/get-api-key
// If the environment variable is not configured, replace the following line with your Model Studio API key: apiKey: "sk-xxx",
apiKey: process.env.DASHSCOPE_API_KEY,
baseURL: "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1"
});
const tools = [
{
"type": "function",
"function": {
"name": "write_file",
"description": "Writes content to a specified file. Creates the file if it does not exist.",
"parameters": {
"type": "object",
"properties": {
"path": {
"type": "string",
"description": "The relative or absolute path of the object file."
},
"content": {
"type": "string",
"description": "The string content to write to the file."
}
},
"required": ["path", "content"]
}
}
}
];
// Implement the tool function
async function write_file(filePath, content) {
try {
// For security reasons, the file writing feature is disabled by default. To use it, uncomment the following lines and ensure the path is secure.
// const dir = path.dirname(filePath);
// if (dir) {
// await fs.mkdir(dir, { recursive: true });
// }
// await fs.writeFile(filePath, content, "utf-8");
return `Success: The file '${filePath}' has been written.`;
} catch (error) {
return `Error: An exception occurred while writing the file - ${error.message}`;
}
}
const messages = [{"role": "user", "content": "Write a Python quicksort algorithm and name the file quick_sort.py."}];
async function main() {
const completion = await client.chat.completions.create({
model: "qwen3-coder-next",
messages: messages,
tools: tools
});
let assistant_output = completion.choices[0].message;
// Ensure content is not null
if (!assistant_output.content) assistant_output.content = "";
messages.push(assistant_output);
// If no tool call is needed, print the content directly
if (!assistant_output.tool_calls) {
console.log(`No tool call needed. Direct response: ${assistant_output.content}`);
} else {
// Enter the tool calling loop
while (assistant_output.tool_calls) {
for (const tool_call of assistant_output.tool_calls) {
const tool_call_id = tool_call.id;
const func_name = tool_call.function.name;
const args = JSON.parse(tool_call.function.arguments);
console.log(`Calling tool [${func_name}] with arguments:`, args);
// Execute the tool
const tool_result = await write_file(args.path, args.content);
// Construct the tool return message
const tool_message = {
"role": "tool",
"tool_call_id": tool_call_id,
"content": tool_result
};
console.log(`Tool returned: ${tool_message.content}`);
messages.push(tool_message);
}
// Call the model again to get a summarized natural language response
const response = await client.chat.completions.create({
model: "qwen3-coder-next",
messages: messages,
tools: tools
});
assistant_output = response.choices[0].message;
if (!assistant_output.content) assistant_output.content = "";
messages.push(assistant_output);
}
console.log(`Final model response: ${assistant_output.content}`);
}
}
main();
Copy
Calling tool [write_file] with arguments: {
content: 'def quick_sort(arr):\\n if len(arr) <= 1:\\n return arr\\n pivot = arr[len(arr) // 2]\\n left = [x for x in arr if x < pivot]\\n middle = [x for x in arr if x == pivot]\\n right = [x for x in arr if x > pivot]\\n return quick_sort(left) + middle + quick_sort(right)\\n\\nif __name__ == \\"__main__\\":\\n example_list = [3, 6, 8, 10, 1, 2, 1]\\n print(\\"Original list:\\", example_list)\\n sorted_list = quick_sort(example_list)\\n print(\\"Sorted list:\\", sorted_list)',
path: 'quick_sort.py'
}
Tool returned: Success: The file 'quick_sort.py' has been written.
Final model response: The `quick_sort.py` file has been successfully created with the Python implementation of the quicksort algorithm. You can run this file to see the sorting result for the example list. Let me know if you need any further modifications or explanations!
Este exemplo mostra a primeira etapa do processo de chamada de ferramenta: iniciar uma solicitação e recuperar a intenção do modelo de chamar uma ferramenta.As URLs variam conforme a região.Resposta
Copy
curl -X POST https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1/chat/completions \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "qwen3-coder-next",
"messages": [
{
"role": "user",
"content": "Write a Python quicksort algorithm and name the file quick_sort.py."
}
],
"tools": [
{
"type": "function",
"function": {
"name": "write_file",
"description": "Writes content to a specified file. Creates the file if it does not exist.",
"parameters": {
"type": "object",
"properties": {
"path": {
"type": "string",
"description": "The relative or absolute path of the object file."
},
"content": {
"type": "string",
"description": "The string content to write to the file."
}
},
"required": ["path", "content"]
}
}
}
]
}'
Copy
{
"choices": [
{
"message": {
"content": "",
"role": "assistant",
"tool_calls": [
{
"index": 0,
"id": "call_0ca7505bb6e44471a40511e5",
"type": "function",
"function": {
"name": "write_file",
"arguments": "{\"content\": \"def quick_sort(arr):\\\\n if len(arr) <= 1:\\\\n return arr\\\\n pivot = arr[len(arr) // 2]\\\\n left = [x for x in arr if x < pivot]\\\\n middle = [x for x in arr if x == pivot]\\\\n right = [x for x in arr if x > pivot]\\\\n return quick_sort(left) + middle + quick_sort(right)\\\\n\\\\nif __name__ == \\\\\\\"__main__\\\\\\\":\\\\n example_list = [3, 6, 8, 10, 1, 2, 1]\\\\n print(\\\\\\\"Original list:\\\\\\\", example_list)\\\\n sorted_list = quick_sort(example_list)\\\\n print(\\\\\\\"Sorted list:\\\\\\\", sorted_list)\", \"path\": \"quick_sort.py\"}"
}
}
]
},
"finish_reason": "tool_calls",
"index": 0,
"logprobs": null
}
],
"object": "chat.completion",
"usage": {
"prompt_tokens": 494,
"completion_tokens": 193,
"total_tokens": 687,
"prompt_tokens_details": {
"cached_tokens": 0
}
},
"created": 1761620025,
"system_fingerprint": null,
"model": "qwen3-coder-next",
"id": "chatcmpl-20e96159-beea-451f-b3a4-d13b218112b5"
}
- Python
- Java
- curl
Copy
import os
import json
import dashscope
dashscope.base_http_api_url = 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1'
tools = [
{
"type": "function",
"function": {
"name": "write_file",
"description": "Writes content to a specified file. Creates the file if it does not exist.",
"parameters": {
"type": "object",
"properties": {
"path": {
"type": "string",
"description": "The relative or absolute path of the object file."
},
"content": {
"type": "string",
"description": "The string content to write to the file."
}
},
"required": ["path", "content"]
}
}
}
]
# Implement the tool function
def write_file(path: str, content: str) -> str:
"""Writes content to a file."""
try:
# For security reasons, the file writing feature is disabled by default. To use it, uncomment the following lines and ensure the path is secure.
# os.makedirs(os.path.dirname(path),exist_ok=True) if os.path.dirname(path) else None
# with open(path, 'w', encoding='utf-8') as f:
# f.write(content)
return f"Success: The file '{path}' has been written."
except Exception as e:
return f"Error: An exception occurred while writing the file - {str(e)}"
messages = [{"role": "user", "content": "Write a Python quicksort algorithm and name the file quick_sort.py."}]
response = dashscope.Generation.call(
# If the environment variable is not configured, replace the following line with your Model Studio API key: api_key="sk-xxx",
api_key=os.getenv('DASHSCOPE_API_KEY'),
model='qwen3-coder-next',
messages=messages,
tools=tools,
result_format='message'
)
if response.status_code == 200:
assistant_output = response.output.choices[0].message
messages.append(assistant_output)
# If no tool call is needed, print the content directly
if "tool_calls" not in assistant_output or not assistant_output["tool_calls"]:
print(f"No tool call needed. Direct response: {assistant_output['content']}")
else:
# Enter the tool calling loop
while "tool_calls" in assistant_output and assistant_output["tool_calls"]:
for tool_call in assistant_output["tool_calls"]:
func_name = tool_call["function"]["name"]
arguments = json.loads(tool_call["function"]["arguments"])
tool_call_id = tool_call.get("id")
print(f"Calling tool [{func_name}] with arguments: {arguments}")
# Execute the tool
tool_result = write_file(**arguments)
# Construct the tool return message
tool_message = {
"role": "tool",
"content": tool_result,
"tool_call_id": tool_call_id
}
print(f"Tool returned: {tool_message['content']}")
messages.append(tool_message)
# Call the model again to get a summarized natural language response
response = dashscope.Generation.call(
api_key=os.getenv('DASHSCOPE_API_KEY'),
model='qwen3-coder-next',
messages=messages,
tools=tools,
result_format='message'
)
if response.status_code == 200:
print(f"Final model response: {response.output.choices[0].message.content}")
assistant_output = response.output.choices[0].message
messages.append(assistant_output)
else:
print(f"Error during summary response generation: {response}")
break
else:
print(f"Execution error: {response}")
Copy
Calling tool [write_file] with arguments: {'content': 'def quick_sort(arr):\\n if len(arr) <= 1:\\n return arr\\n pivot = arr[len(arr) // 2]\\n left = [x for x in arr if x < pivot]\\n middle = [x for x in arr if x == pivot]\\n right = [x for x in arr if x > pivot]\\n return quick_sort(left) + middle + quick_sort(right)\\n\\nif __name__ == \\"__main__\\":\\n example_list = [3, 6, 8, 10, 1, 2, 1]\\n print(\\"Original list:\\", example_list)\\n sorted_list = quick_sort(example_list)\\n print(\\"Sorted list:\\", sorted_list)', 'path': 'quick_sort.py'}
Tool returned: Success: The file 'quick_sort.py' has been written.
Final model response: The `quick_sort.py` file has been successfully created with the Python implementation of the quicksort algorithm. You can run this file to see the sorting result for the example list. Let me know if you need any further modifications or explanations!
Copy
import com.alibaba.dashscope.aigc.generation.Generation;
import com.alibaba.dashscope.aigc.generation.GenerationParam;
import com.alibaba.dashscope.aigc.generation.GenerationResult;
import com.alibaba.dashscope.common.Message;
import com.alibaba.dashscope.common.Role;
import com.alibaba.dashscope.protocol.Protocol;
import com.alibaba.dashscope.exception.NoApiKeyException;
import com.alibaba.dashscope.exception.InputRequiredException;
import com.alibaba.dashscope.tools.FunctionDefinition;
import com.alibaba.dashscope.tools.ToolCallBase;
import com.alibaba.dashscope.tools.ToolCallFunction;
import com.alibaba.dashscope.tools.ToolFunction;
import com.alibaba.dashscope.utils.JsonUtils;
import com.fasterxml.jackson.databind.JsonNode;
import com.fasterxml.jackson.databind.ObjectMapper;
import java.io.File;
import java.nio.charset.StandardCharsets;
import java.nio.file.Files;
import java.nio.file.Paths;
import java.util.ArrayList;
import java.util.Arrays;
import java.util.List;
public class Main {
/**
* Writes content to a file.
* @param arguments A JSON string passed in by the model, which contains the parameters required for the tool.
* @return The result string after the tool is executed.
*/
public static String writeFile(String arguments) {
try {
ObjectMapper objectMapper = new ObjectMapper();
JsonNode argsNode = objectMapper.readTree(arguments);
String path = argsNode.get("path").asText();
String content = argsNode.get("content").asText();
// For security reasons, the file writing feature is disabled by default. To use it, uncomment the following lines and ensure the path is secure.
// File file = new File(path);
// File parentDir = file.getParentFile();
// if (parentDir != null && !parentDir.exists()) {
// parentDir.mkdirs();
// }
// Files.write(Paths.get(path), content.getBytes(StandardCharsets.UTF_8));
return "Success: File '" + path + "' has been written";
} catch (Exception e) {
return "Error: An exception occurred while writing the file - " + e.getMessage();
}
}
public static void main(String[] args) {
try {
// Define the tool parameter schema.
String writePropertyParams =
"{\"type\":\"object\",\"properties\":{\"path\":{\"type\":\"string\",\"description\":\"The relative or absolute path of the target file\"},\"content\":{\"type\":\"string\",\"description\":\"The string content to write to the file\"}},\"required\":[\"path\",\"content\"]}";
FunctionDefinition writeFileFunction = FunctionDefinition.builder()
.name("write_file")
.description("Writes content to a specified file. Creates the file if it does not exist.")
.parameters(JsonUtils.parseString(writePropertyParams).getAsJsonObject())
.build();
Generation gen = new Generation(Protocol.HTTP.getValue(), "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1");
String userInput = "Write a Python script for quick sort and name it quick_sort.py";
List<Message> messages = new ArrayList<>();
messages.add(Message.builder().role(Role.USER.getValue()).content(userInput).build());
// First call to the model.
GenerationParam param = GenerationParam.builder()
.model("qwen3-coder-next")
.apiKey(System.getenv("DASHSCOPE_API_KEY"))
.messages(messages)
.tools(Arrays.asList(ToolFunction.builder().function(writeFileFunction).build()))
.resultFormat(GenerationParam.ResultFormat.MESSAGE)
.build();
GenerationResult result = gen.call(param);
Message assistantOutput = result.getOutput().getChoices().get(0).getMessage();
messages.add(assistantOutput);
// If no tool call is required, directly output the content.
if (assistantOutput.getToolCalls() == null || assistantOutput.getToolCalls().isEmpty()) {
System.out.println("No tool call is required. Direct reply: " + assistantOutput.getContent());
} else {
// Enter the tool calling loop.
while (assistantOutput.getToolCalls() != null && !assistantOutput.getToolCalls().isEmpty()) {
for (ToolCallBase toolCall : assistantOutput.getToolCalls()) {
ToolCallFunction functionCall = (ToolCallFunction) toolCall;
String funcName = functionCall.getFunction().getName();
String arguments = functionCall.getFunction().getArguments();
System.out.println("Calling tool [" + funcName + "], arguments: " + arguments);
// Execute the tool.
String toolResult = writeFile(arguments);
// Construct the tool return message.
Message toolMessage = Message.builder()
.role("tool")
.toolCallId(toolCall.getId())
.content(toolResult)
.build();
System.out.println("Tool returns: " + toolMessage.getContent());
messages.add(toolMessage);
}
// Call the model again to get a summarized natural language response.
param.setMessages(messages);
result = gen.call(param);
assistantOutput = result.getOutput().getChoices().get(0).getMessage();
messages.add(assistantOutput);
}
System.out.println("Final model reply: " + assistantOutput.getContent());
}
} catch (NoApiKeyException | InputRequiredException e) {
System.err.println("Error: " + e.getMessage());
} catch (Exception e) {
e.printStackTrace();
}
}
}
Copy
Calling tool [write_file] with arguments: {"content": "def quick_sort(arr):\\n if len(arr) <= 1:\\n return arr\\n pivot = arr[len(arr) // 2]\\n left = [x for x in arr if x < pivot]\\n middle = [x for x in arr if x == pivot]\\n right = [x for x in arr if x > pivot]\\n return quick_sort(left) + middle + quick_sort(right)\\n\\nif __name__ == \\\"__main__\\\":\\n example_array = [3, 6, 8, 10, 1, 2, 1]\\n print(\\\"Original array:\\\", example_array)\\n sorted_array = quick_sort(example_array)\\n print(\\\"Sorted array:\\\", sorted_array)", "path": "quick_sort.py"}
Tool returned: Success: The file 'quick_sort.py' has been written.
Final model response: I have successfully created the Python code file `quick_sort.py` for you. This file contains a `quick_sort` function and an example of its usage. You can run it in your terminal or editor to test the quicksort functionality.
Este exemplo mostra a primeira etapa do processo de chamada de ferramenta: iniciar uma solicitação e recuperar a intenção do modelo de chamar uma ferramenta.As URLs variam conforme a região.Resposta
Copy
curl --location "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1/services/aigc/text-generation/generation" \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header "Content-Type: application/json" \
--data '{
"model": "qwen3-coder-next",
"input": {
"messages": [{
"role": "user",
"content": "Write a Python quicksort algorithm and name the file quick_sort.py."
}]
},
"parameters": {
"result_format": "message",
"tools": [
{
"type": "function",
"function": {
"name": "write_file",
"description": "Writes content to a specified file. Creates the file if it does not exist.",
"parameters": {
"type": "object",
"properties": {
"path": {
"type": "string",
"description": "The relative or absolute path of the object file."
},
"content": {
"type": "string",
"description": "The string content to write to the file."
}
},
"required": ["path", "content"]
}
}
}
]
}
}'
Copy
{
"output": {
"choices": [
{
"finish_reason": "tool_calls",
"message": {
"role": "assistant",
"tool_calls": [
{
"function": {
"name": "write_file",
"arguments": "{\"content\": \"def quick_sort(arr):\\\\n if len(arr) <= 1:\\\\n return arr\\\\n pivot = arr[len(arr) // 2]\\\\n left = [x for x in arr if x < pivot]\\\\n middle = [x for x in arr if x == pivot]\\\\n right = [x for x in arr if x > pivot]\\\\n return quick_sort(left) + middle + quick_sort(right)\\\\n\\\\nif __name__ == \\\\\\\"__main__\\\\\\\":\\\\n example_list = [3, 6, 8, 10, 1, 2, 1]\\\\n print(\\\\\\\"Original list:\\\\\\\", example_list)\\\\n sorted_list = quick_sort(example_list)\\\\n print(\\\\\\\"Sorted list:\\\\\\\", sorted_list), \"path\": \"quick_sort.py\"}"
},
"index": 0,
"id": "call_645b149bbd274e8bb3789aae",
"type": "function"
}
],
"content": ""
}
}
]
},
"usage": {
"total_tokens": 684,
"output_tokens": 193,
"input_tokens": 491,
"prompt_tokens_details": {
"cached_tokens": 0
}
},
"request_id": "d2386acd-fce3-9d0f-8015-c5f3a8bf9f5c"
}
Conclusão de código
O Qwen-Coder oferece suporte a dois métodos de conclusão de código. Selecione um com base nas suas necessidades:- Modo parcial: Adequado para todos os modelos e regiões do Qwen-Coder. Oferece suporte à conclusão de prefixo e é simples de implementar. Recomendamos este método.
- API Completions: Disponível apenas para os modelos da série
qwen2.5-coderna região China (Pequim). Suporta tanto a conclusão de prefixo quanto a conclusão fill-in-the-middle.
Modo Parcial
Esse recurso permite que o modelo complete automaticamente o restante do seu código com base em um prefixo fornecido. Para usar esse recurso, adicione uma mensagem comrole definido como assistant e partial: true à lista messages. O content da mensagem assistant corresponde ao prefixo de código que você fornece. Para obter mais informações, consulte Modo parcial.
- Compatível com OpenAI
- DashScope
- Python
- Node.js
- curl
SolicitaçãoResposta
Copy
import os
from openai import OpenAI
client = OpenAI(
# If the environment variable is not configured, replace the following line with your Alibaba Cloud Model Studio API key: api_key="sk-xxx",
api_key=os.getenv("DASHSCOPE_API_KEY"),
base_url="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1",
)
completion = client.chat.completions.create(
model="qwen3-coder-next",
messages=[{
"role": "user",
"content": "Help me write a Python script to generate prime numbers up to 100. Do not output non-code content or Markdown code blocks."
},
{
"role": "assistant",
"content": "def generate_prime_number",
"partial": True
}]
)
print(completion.choices[0].message.content)
Copy
(n):
primes = []
for i in range(2, n+1):
is_prime = True
for j in range(2, int(i**0.5)+1):
if i % j == 0:
is_prime = False
break
if is_prime:
primes.append(i)
return primes
prime_numbers = generate_prime_number(100)
print(prime_numbers)
Exemplo de solicitaçãoResposta
Copy
import OpenAI from "openai";
const client = new OpenAI(
{
// If the environment variable is not configured, replace the following line with your Model Studio API key: apiKey: "sk-xxx",
apiKey: process.env.DASHSCOPE_API_KEY,
baseURL: "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1"
}
);
async function main() {
const completion = await client.chat.completions.create({
model: "qwen3-coder-next",
messages: [
{ role: "user", content: "Help me write a Python script to generate prime numbers up to 100. Do not output non-code content or Markdown code blocks." },
{ role: "assistant", content: "def generate_prime_number", partial: true}
],
});
console.log(completion.choices[0].message.content);
}
main();
Copy
(n):
primes = []
for i in range(2, n+1):
is_prime = True
for j in range(2, int(i**0.5)+1):
if i % j == 0:
is_prime = False
break
if is_prime:
primes.append(i)
return primes
prime_numbers = generate_prime_number(100)
print(prime_numbers)
Exemplo de solicitaçãoAs URLs variam conforme a região.Resposta
Copy
curl -X POST https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1/chat/completions \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "qwen3-coder-next",
"messages": [{
"role": "user",
"content": "Help me write a Python script to generate prime numbers up to 100. Do not output non-code content or Markdown code blocks."
},
{
"role": "assistant",
"content": "def generate_prime_number",
"partial": true
}]
}'
Copy
{
"choices": [
{
"message": {
"content": "(n):\n primes = []\n for num in range(2, n + 1):\n is_prime = True\n for i in range(2, int(num ** 0.5) + 1):\n if num % i == 0:\n is_prime = False\n break\n if is_prime:\n primes.append(num)\n return primes\n\nprime_numbers = generate_prime_number(100)\nprint(prime_numbers)",
"role": "assistant"
},
"finish_reason": "stop",
"index": 0,
"logprobs": null
}
],
"object": "chat.completion",
"usage": {
"prompt_tokens": 38,
"completion_tokens": 93,
"total_tokens": 131,
"prompt_tokens_details": {
"cached_tokens": 0
}
},
"created": 1761634556,
"system_fingerprint": null,
"model": "qwen3-coder-next",
"id": "chatcmpl-c108050a-bb6d-4423-9d36-f64aa6a32976"
}
- Python
- curl
Exemplo de solicitaçãoResposta
Copy
from http import HTTPStatus
import dashscope
import os
dashscope.base_http_api_url = 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1'
messages = [{
"role": "user",
"content": "Help me write a Python script to generate prime numbers up to 100. Do not output non-code content or Markdown code blocks."
},
{
"role": "assistant",
"content": "def generate_prime_number",
"partial": True
}]
response = dashscope.Generation.call(
# If the environment variable is not configured, replace the following line with your Model Studio API key: api_key="sk-xxx",
api_key=os.getenv('DASHSCOPE_API_KEY'),
model='qwen3-coder-next',
messages=messages,
result_format='message',
)
if response.status_code == HTTPStatus.OK:
print(response.output.choices[0].message.content)
else:
print(f"HTTP return code: {response.status_code}")
print(f"Error code: {response.code}")
print(f"Error message: {response.message}")
Copy
(n):
primes = []
for i in range(2, n+1):
is_prime = True
for j in range(2, int(i**0.5)+1):
if i % j == 0:
is_prime = False
break
if is_prime:
primes.append(i)
return primes
prime_numbers = generate_prime_number(100)
print(prime_numbers)
Exemplo de solicitaçãoAs URLs variam conforme a região.Resposta
Copy
curl -X POST "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1/services/aigc/text-generation/generation" \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "qwen3-coder-next",
"input":{
"messages":[{
"role": "user",
"content": "Help me write a Python script to generate prime numbers up to 100. Do not output non-code content or Markdown code blocks."
},
{
"role": "assistant",
"content": "def generate_prime_number",
"partial": true
}]
},
"parameters": {
"result_format": "message"
}
}'
Copy
{
"output": {
"choices": [
{
"message": {
"content": "(n):\n prime_list = []\n for i in range(2, n+1):\n is_prime = True\n for j in range(2, int(i**0.5)+1):\n if i % j == 0:\n is_prime = False\n break\n if is_prime:\n prime_list.append(i)\n return prime_list\n\nprime_numbers = generate_prime_number(100)\nprint(prime_numbers)",
"role": "assistant"
},
"finish_reason": "stop"
}
]
},
"usage": {
"total_tokens": 131,
"output_tokens": 92,
"input_tokens": 39,
"prompt_tokens_details": {
"cached_tokens": 0
}
},
"request_id": "9917f629-e819-4519-af44-b0e677e94b2c"
}
API Completions
A API Completions está disponível apenas para modelos na região China (Pequim) e requer uma chave de API da região China (Pequim).
fim (Fill-in-the-Middle) no prompt para orientar a conclusão do modelo.
- Conclusão baseada em prefixo
- Conclusão baseada em prefixo e sufixo
Modelo de prompt:
Copy
<|fim_prefix|>{prefix_content}<|fim_suffix|>
<|fim_prefix|>e<|fim_middle|>são tokens especiais que orientam o modelo a completar o texto. Não os modifique.- Substitua
{prefix_content}pelas informações do seu prefixo, como nome da função, parâmetros de entrada e instruções de uso.
Copy
import os
from openai import OpenAI
client = OpenAI(
base_url="https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/compatible-mode/v1",
api_key=os.getenv("DASHSCOPE_API_KEY")
)
completion = client.completions.create(
model="qwen-coder-turbo",
prompt="<|fim_prefix|>def quick_sort(arr):<|fim_suffix|>",
)
print(completion.choices[0].text)
Copy
import OpenAI from "openai";
const client = new OpenAI(
{
// If the environment variable is not configured, replace the following line with your Alibaba Cloud Model Studio API key: apiKey: "sk-xxx",
apiKey: process.env.DASHSCOPE_API_KEY,
baseURL: "https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
}
);
async function main() {
const completion = await client.completions.create({
model: "qwen-coder-turbo",
prompt: "<|fim_prefix|>def quick_sort(arr):<|fim_suffix|>",
});
console.log(completion.choices[0].text)
}
main();
Copy
curl -X POST https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/compatible-mode/v1/completions \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "qwen-coder-turbo",
"prompt": "<|fim_prefix|>def quick_sort(arr):<|fim_suffix|>"
}'
Modelo de prompt:
Copy
<|fim_prefix|>{prefix_content}<|fim_suffix|>{suffix_content}<|fim_middle|>
<|fim_prefix|>,<|fim_middle|>e<|fim_middle|>são tokens especiais que orientam o modelo a completar o texto. Não os modifique.- Substitua
{prefix_content}pelas informações do seu prefixo, como nome da função, parâmetros de entrada e instruções de uso. - Substitua
{suffix_content}pelas informações do seu sufixo, como os parâmetros de retorno da função.
Copy
import os
from openai import OpenAI
client = OpenAI(
base_url="https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/compatible-mode/v1",
api_key=os.getenv("DASHSCOPE_API_KEY")
)
prefix_content = """def reverse_words_with_special_chars(s):
'''
Reverse each word in a string while preserving the position of non-alphabetic characters and word order.
Example:
reverse_words_with_special_chars("Hello, world!") -> "olleH, dlrow!"
Parameters:
s (str): The input string, which may contain punctuation.
Returns:
str: The processed string with words reversed but non-alphabetic characters in their original positions.
'''
"""
suffix_content = "return result"
completion = client.completions.create(
model="qwen-coder-turbo",
prompt=f"<|fim_prefix|>{prefix_content}<|fim_suffix|>{suffix_content}<|fim_middle|>",
)
print(completion.choices[0].text)
Copy
import OpenAI from 'openai';
const client = new OpenAI({
baseURL: "https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/compatible-mode/v1",
apiKey: process.env.DASHSCOPE_API_KEY
});
const prefixContent = `def reverse_words_with_special_chars(s):
'''
Reverse each word in a string while preserving the position of non-alphabetic characters and word order.
Example:
reverse_words_with_special_chars("Hello, world!") -> "olleH, dlrow!"
Parameters:
s (str): The input string, which may contain punctuation.
Returns:
str: The processed string with words reversed but non-alphabetic characters in their original positions.
'''
`;
const suffixContent = "return result";
async function main() {
const completion = await client.completions.create({
model: "qwen-coder-turbo",
prompt: `<|fim_prefix|>${prefixContent}<|fim_suffix|>${suffixContent}<|fim_middle|>`
});
console.log(completion.choices[0].text);
}
main();
Copy
curl -X POST https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/compatible-mode/v1/completions \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "qwen-coder-turbo",
"prompt": "<|fim_prefix|>def reverse_words_with_special_chars(s):\n\"\"\"\nReverse each word in a string while preserving the position of non-alphabetic characters and word order.\n Example:\n reverse_words_with_special_chars(\"Hello, world!\") -> \"olleH, dlrow!\"\n Parameters:\n s (str): The input string, which may contain punctuation.\n Returns:\n str: The processed string with words reversed but non-alphabetic characters in their original positions.\n\"\"\"\n<|fim_suffix|>return result<|fim_middle|>"
}'
Entrada em produção
Para otimizar a eficiência e reduzir o custo de uso dos modelos Qwen-Coder, considere as seguintes sugestões:- Ative asaída em streaming: Defina
stream=Truepara receber resultados intermediários em tempo real. Isso reduz o risco de tempos limite e melhora a experiência do usuário. - Reduza a temperatura: Tarefas de geração de código geralmente exigem resultados determinísticos e precisos. Diminuir o parâmetro
temperaturereduz a aleatoriedade da saída gerada. - Utilize um modelo com suporte a cache de contexto: Em cenários com muitos prefixos repetitivos, como conclusão e revisão de código, usar um modelo que ofereça suporte ao cache de contexto pode reduzir efetivamente a sobrecarga.
- Controle a quantidade de ferramentas: Para garantir chamadas de modelo eficientes e econômicas, passe no máximo 20 ferramentas no parâmetro
toolspor chamada. Passar muitas descrições de ferramentas consome tokens de entrada em excesso, o que aumenta custos, reduz a velocidade de resposta e dificulta a seleção da ferramenta correta pelo modelo. Para obter mais informações, consulte Function Calling.
Faturamento e limitação de taxa
-
Faturamento básico: A cobrança é feita com base no número de
tokensde entrada etokensde saída de cada solicitação. O preço unitário varia dependendo do modelo. Para preços específicos, consulte a Lista de modelos. -
Itens especiais de faturamento:
- Faturamento escalonado: Os modelos da série
qwen3-coderutilizam um método de faturamento escalonado. Quando o número de tokens de entrada em uma única solicitação atinge um nível específico, todos os tokens de entrada e saída dessa solicitação são cobrados conforme a taxa desse nível. - Cache de contexto: Para modelos compatíveis com cache de contexto, o mecanismo de cache pode reduzir significativamente os custos de solicitações com grandes quantidades de entrada repetitiva, como em revisões de código. O texto de entrada que atinge o cache implícito é cobrado a 20% da taxa padrão. O texto de entrada que atinge o cache explícito é cobrado a 10% da taxa padrão. Para obter mais informações, consulte Cache de contexto.
- Chamada de ferramentas (Function Calling): Ao usar o recurso de chamada de ferramentas, as descrições definidas no parâmetro
toolssão incluídas na contagem total detokense geram cobranças.
- Faturamento escalonado: Os modelos da série
- Limitação de taxa: As chamadas de API estão sujeitas a limites duplos de solicitações por minuto (RPM) e tokens por minuto (TPM). Para obter mais informações, consulte Limitação de taxa.
- Cota gratuita(apenas região Singapura): Após ativar o Model Studio ou ter sua solicitação de modelo aprovada, cada modelo Qwen-Coder inclui uma cota gratuita de 1 milhão de tokens para novos usuários válida por 90 dias.
Referência da API
Para obter mais informações sobre os parâmetros de entrada e saída dos modelos Qwen-Coder, consulte Geração de texto.Perguntas frequentes
Por que ferramentas de desenvolvimento como Qwen Code e Claude Code consomem muitos tokens?
Ao usar uma ferramenta de desenvolvimento externa para chamar um modelo Qwen-Coder, a ferramenta pode fazer várias chamadas de API, o que consome muitos tokens. Para métodos específicos de monitoramento e redução do consumo de tokens, consulte os documentos do Qwen Code e do Claude Code. Você pode ativar o recurso parar-quando-cota-esgotada para evitar cobranças extras após o esgotamento da sua cota gratuita. Você também pode adquirir um plano de codificação com IA. Esse plano oferece uma taxa mensal fixa por uma cota mensal de solicitações que pode ser usada em ferramentas de IA. Para obter mais informações, consulte o documento Visão geral do Plano de Codificação.Como visualizo o uso do modelo?
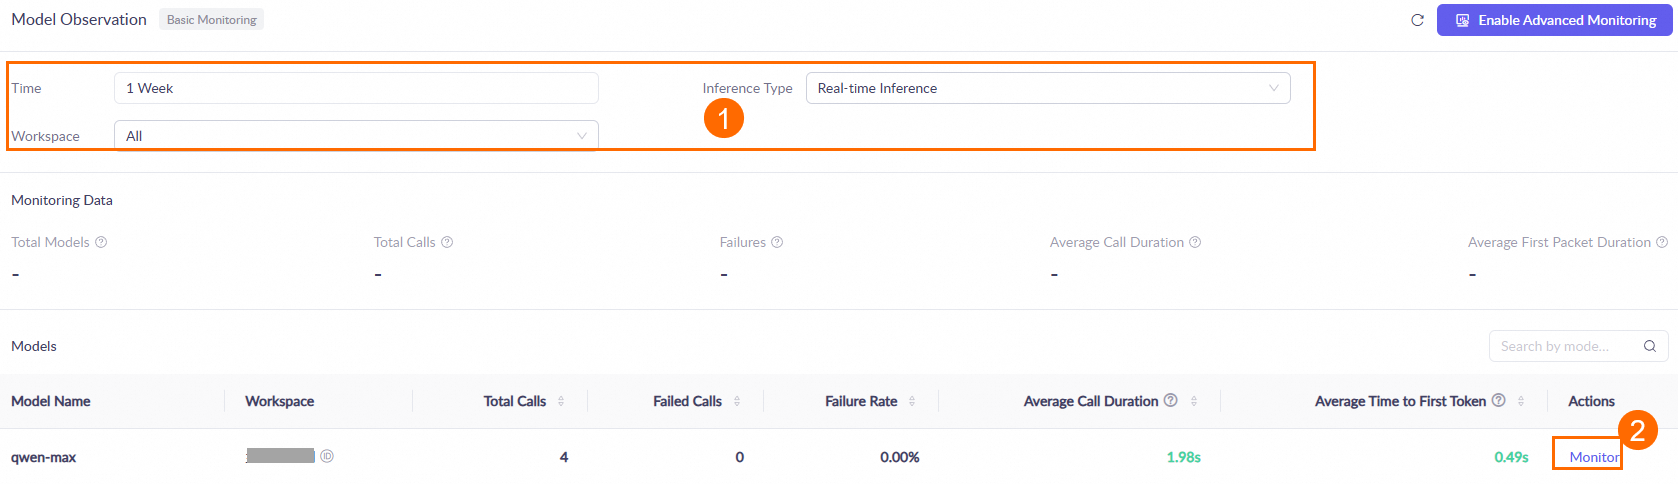
Uma hora após chamar um modelo, acesse a página Monitoramento (Singapura ou Pequim). Defina as condições de consulta, como intervalo de tempo e workspace. Em seguida, na área Models, localize o modelo desejado e clique em Monitor na coluna Actions para visualizar as estatísticas de chamadas do modelo. Para obter mais informações, consulte o documento Monitoramento.Os dados são atualizados de hora em hora. Durante períodos de pico, pode haver uma latência de até uma hora.
Como faço para o modelo gerar apenas código, sem texto explicativo?
Você pode utilizar os seguintes métodos:- Restrições no prompt: Forneça instruções claras no prompt, por exemplo: "Retorne apenas o código. Não inclua explicações, comentários ou tags Markdown."
- Defina uma sequência de parada: Use frases como
stop=["\n# Explanation:", "Note:"]para encerrar a geração antes que o modelo comece a produzir texto explicativo. Para obter mais informações, consulte a Referência da API Qwen.