

Seja utilizando os modelos pré-configurados da plataforma ou seus próprios modelos ajustados finamente, a implantação permite obter um service de inferência independente e com recursos dedicados. Essa abordagem atende às necessidades do seu negócio em diferentes níveis de desempenho, como alta concorrência e baixa latência.
Métodos de faturamento
Antes da implantação, você pode consultar o custo horário estimado dos diferentes modelos no console de Implantação Dedicada.
Provisioned Throughput (PTU, Provisioned Throughput Unit) (Alto throughput; alto desempenho) | Model Unit (Métricas de desempenho personalizadas; isolamento de recursos) | Uso baseado em Tokens (Pagamento conforme o uso após ajuste fino/validação de efeito) | |||
|---|---|---|---|---|---|
Definição | Método de implantação de modelo que reserva recursos da plataforma para garantir uma capacidade específica de throughput de TPM; sem limitação de taxa dentro da cota garantida. | Método de implantação de modelo que configura o poder computacional com base na duração de uso e na quantidade de Model Units, com recursos dedicados. | Método de implantação de modelo que utiliza os Tokens de entrada e os Tokens de saída gerados por chamada como base de medição de uso. | ||
Vantagens |
|
| Sem cobrança quando não estiver em uso. | ||
Modelos suportados | Alguns modelos pré-configurados | Alguns modelos pré-configurados e todos os modelos ajustados finamente | Alguns modelos ajustados finamente com LoRA | ||
Casos de uso |
|
| Validação de efeito de modelo ajustado finamente | ||
Diagrama de faturamento | 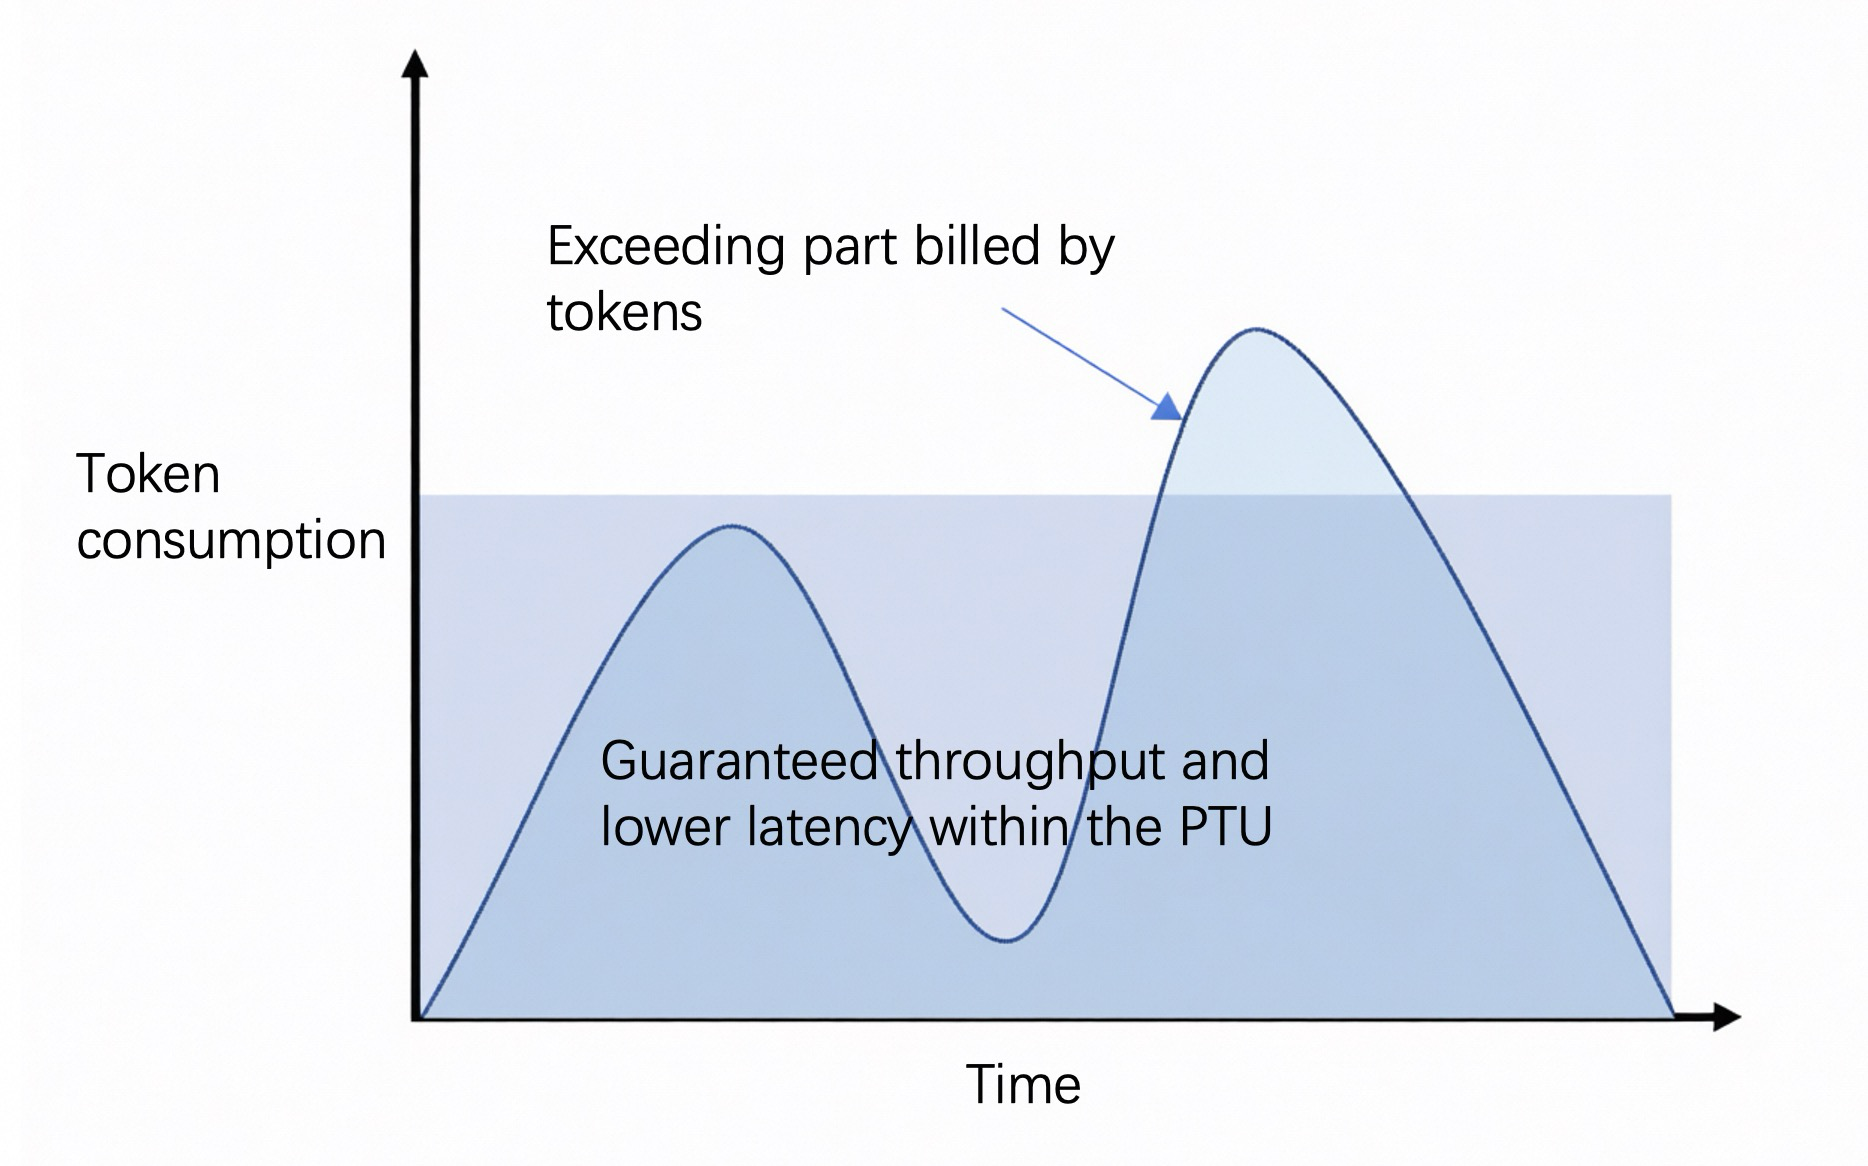 | 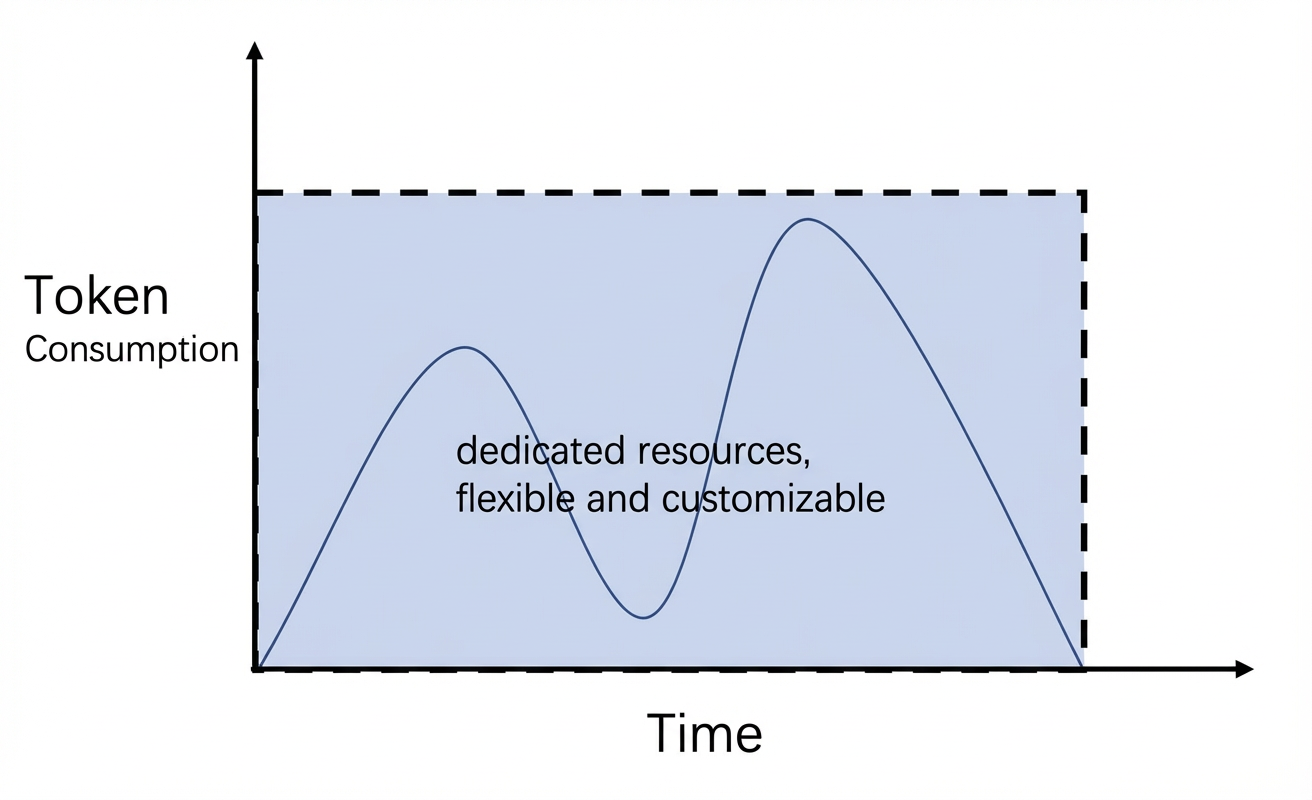 | 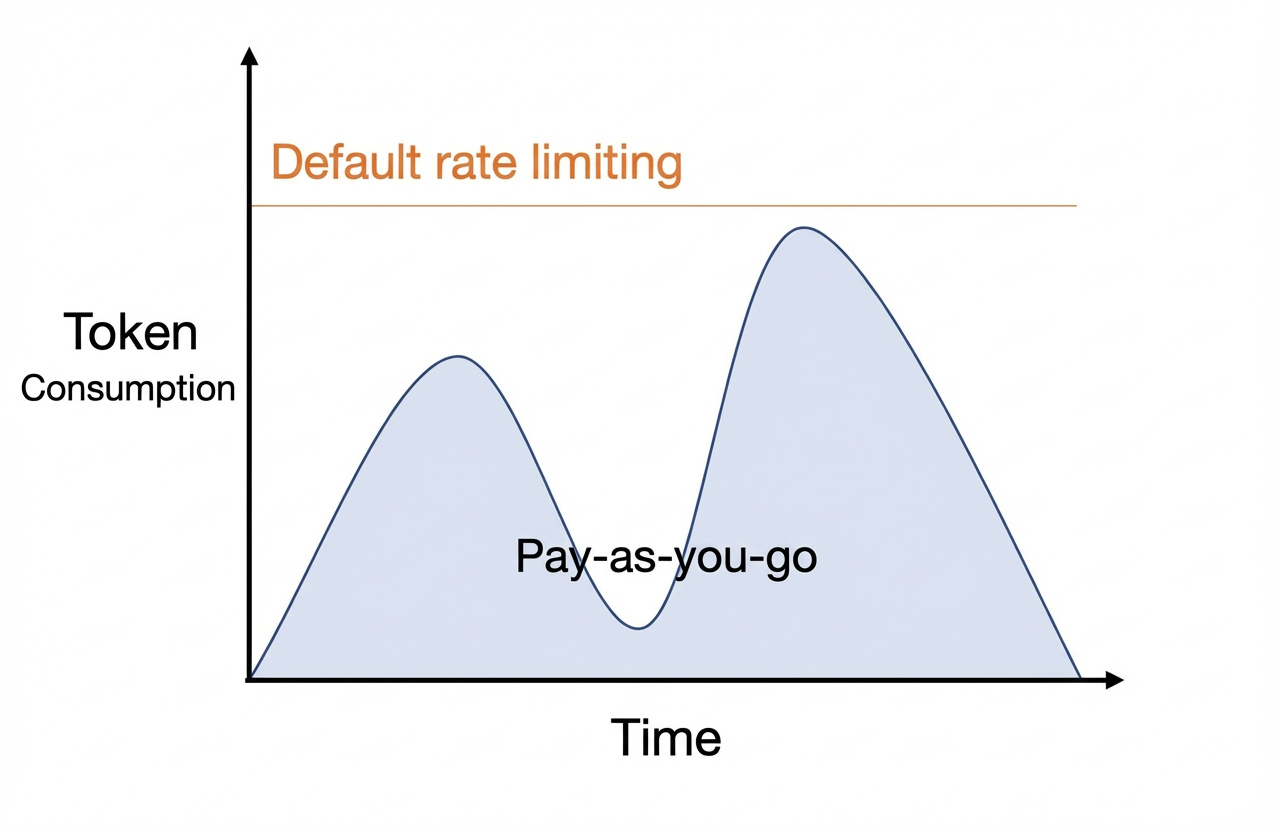 | ||
Método de faturamento | Por duração de uso e throughput provisionado Pagamento conforme o uso, pacote diário | Por duração de uso e quantidade de Model Units Pagamento conforme o uso, pacote mensal | Por uso de Tokens do modelo Pagamento conforme o uso | ||
Método de dimensionamento | Aumento/diminuição self-service do throughput | Aumento/diminuição self-service de Model Units | Envie uma solicitação no console e aguarde a revisão manual. | ||
Restrições do produto |
| Após uma compra pré-paga, se você cancelar antecipadamente dentro do primeiro mês, o preço unitário diário (≈ preço unitário mensal / 30) será cobrado multiplicado por 1,2 |
| ||
Modos de implantação
Para os modelos suportados e os preços de cada modo de implantação, consulte as páginas correspondentes de cada modo:
- Implantação de PTU Provisioned Throughput
- Implantação de computação dedicada
- Implantação com pagamento por Token conforme o uso
- Importação de modelos
Métodos de implantação
É possível implantar modelos no console. Siga as etapas a seguir:
Caso receba um aviso de permissões insuficientes, consulte a seção de solução de problemas de permissões no guia de implantação por API.
- Faça login no console do Model Studio. No painel de navegação à esquerda, escolha Inferência de Modelo > Implantação Dedicada.
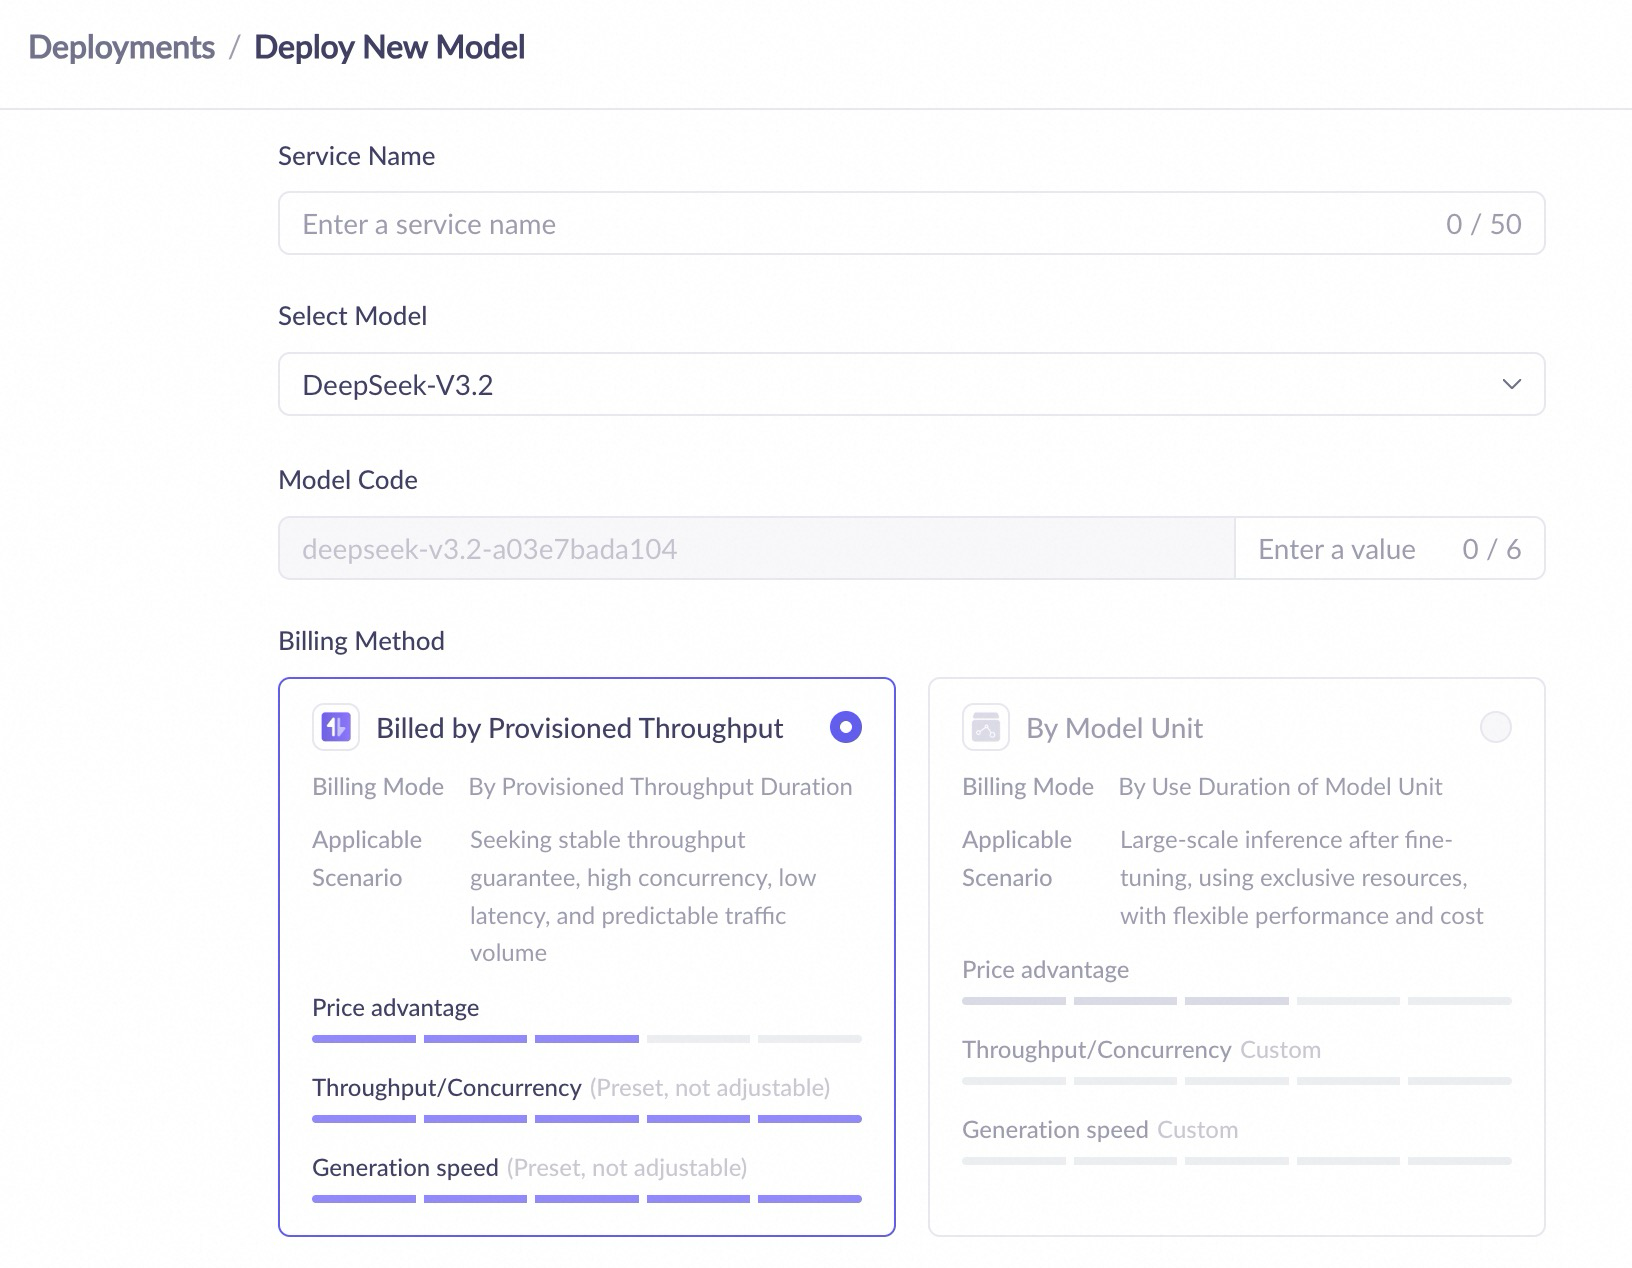
- Clique em Implantar Novo Modelo.
-
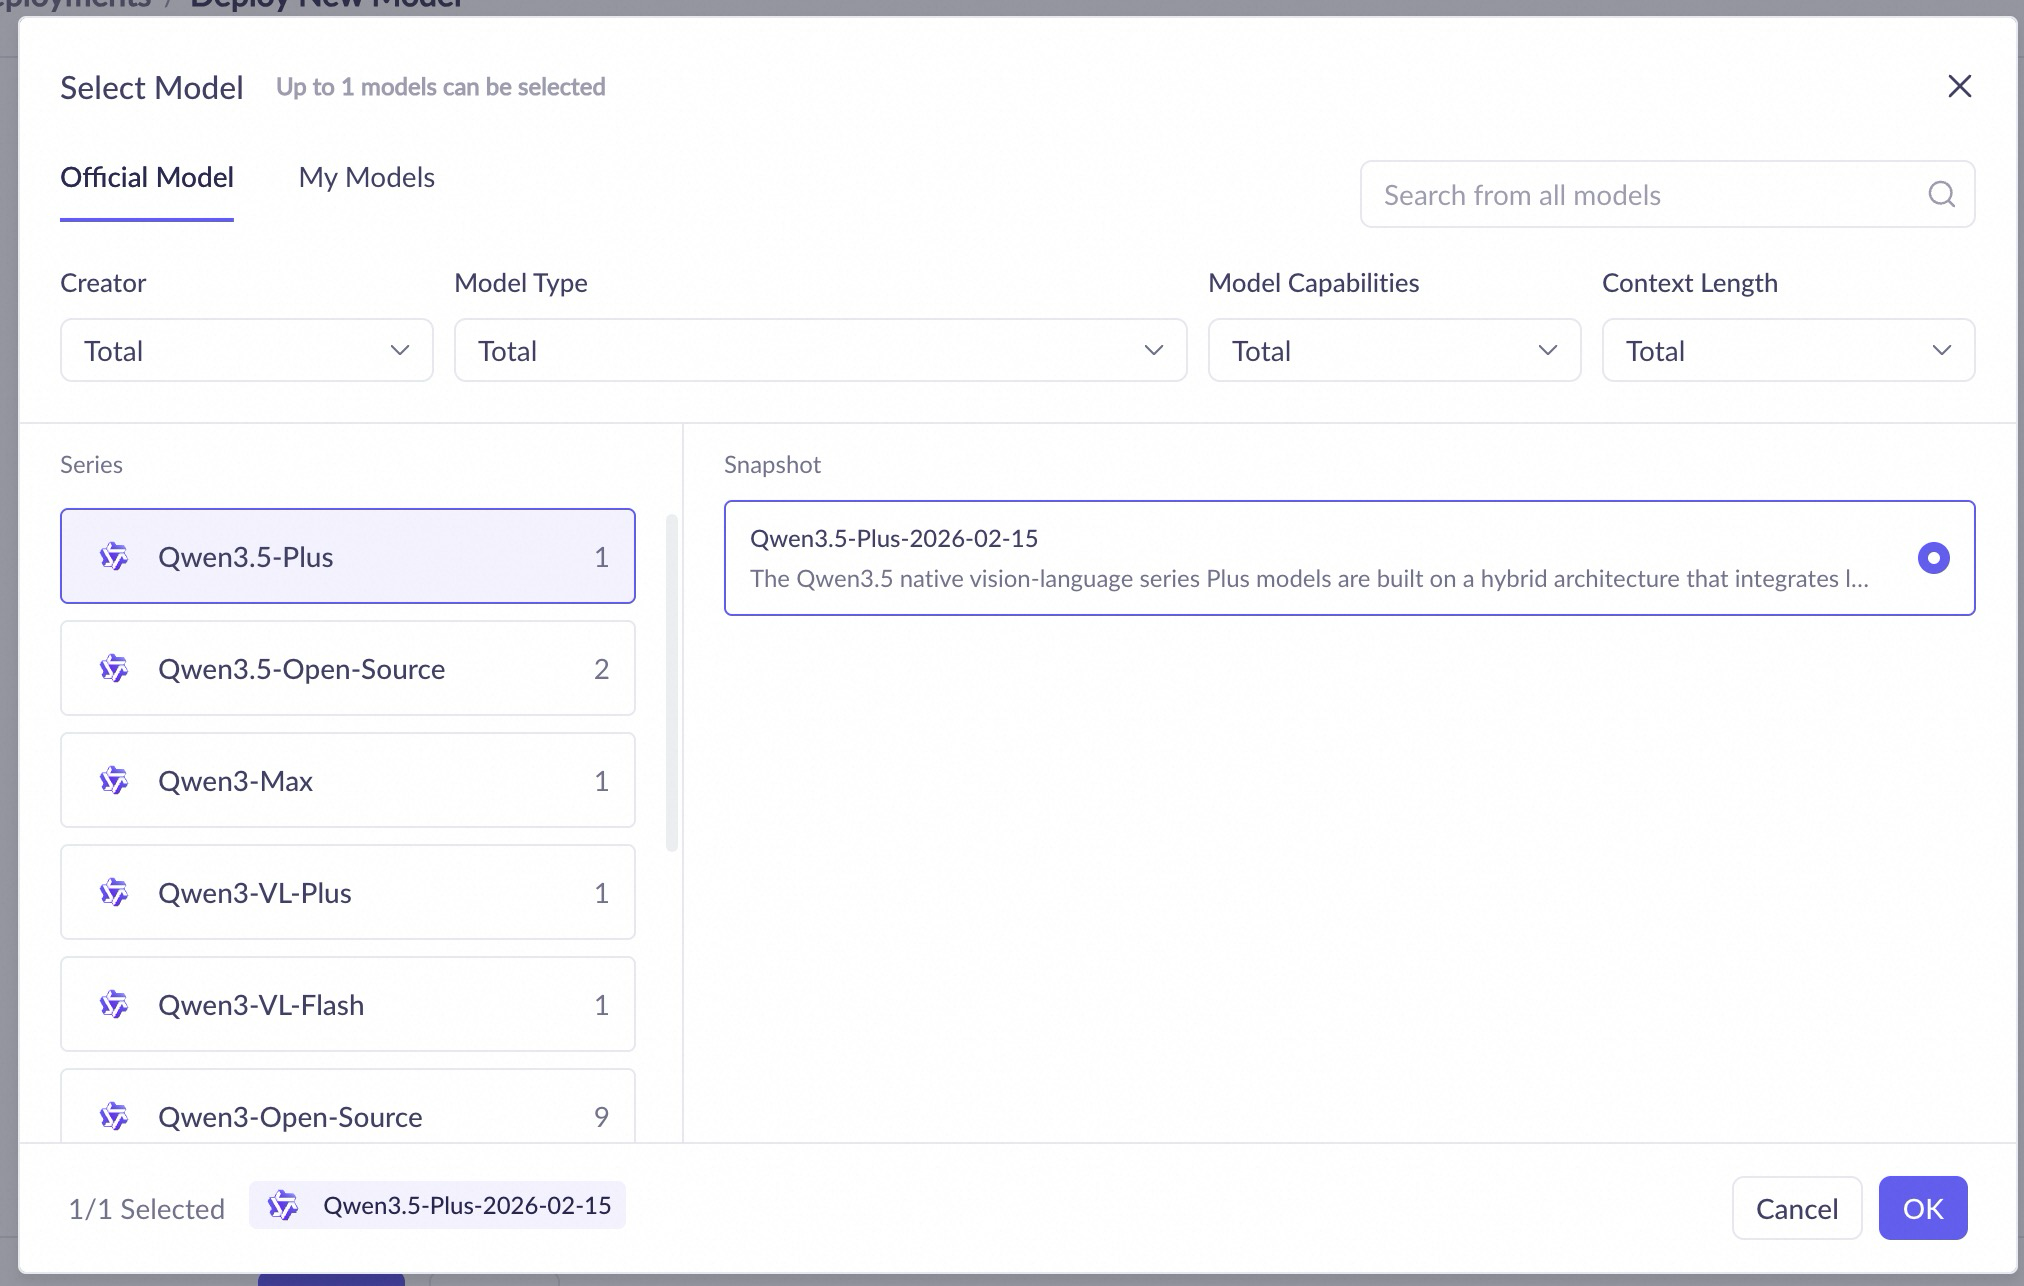
Insira um Nome do Serviço, conclua Selecionar Modelo e Método de Faturamento, mantenha as demais configurações padrão e clique em Confirmar.
Você deve concluir o ajuste fino do modelo antes de poder implantar a maioria dos modelos.
- Volte à lista de implantações. Quando o status da implantação mudar para Running, o modelo terá sido implantado com sucesso.
Página da lista de implantações
Após uma implantação bem-sucedida, você pode visualizar e gerenciar todos os serviços de implantação na página da lista de implantações. A página da lista contém as seguintes informações:
- Nome do serviço: O nome do serviço de implantação. Clique para visualizar os detalhes da implantação.
- Nome do modelo: O modelo utilizado na implantação.
- Model Code: O identificador exclusivo gerado após a implantação bem-sucedida do modelo, usado para especificar o modelo ao chamar a API.
- Status da implantação/Status do evento: Inclui Implantação pendente, Implantando, Running, Falha na implantação, Desativando, Serviço pausado, Stopped, Excluindo, Assinatura suspensa/Suspensão por pagamento atrasado, Retomando serviço, Running (Alterando configuração), Running (Falha na alteração) e outros status.
- Método de faturamento: O método de faturamento do serviço de implantação atual.
- Detalhes da implantação: Informações de configuração como tipo de unidade de modelo e quantidade de réplicas.
- Detalhes da limitação de taxa: Exibe a configuração de limitação de taxa do serviço de implantação atual, como RPM (requisições por minuto) e TPM (tokens por minuto).
- Tempo de serviço: Exibe a hora de criação e a hora de expiração do serviço de implantação.
- Operação: Dependendo do status da implantação e do método de faturamento, você pode executar operações como Update, Monitor, Scale, Renew, Take offline, Delete e Try; instâncias de Provisioned Throughput Unit (PTU) também suportam a adição de pacotes de capacidade na página de Reserva de Throughput.
Colocar um Serviço de Implantação Offline
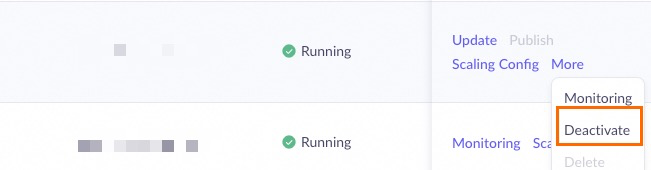
Acesse o console de Implantação Dedicada, localize o serviço de implantação que deseja interromper e clique na operação correspondente de acordo com o tipo de faturamento:
- Unidade de modelo pré-paga: Clique em Deactivate e confirme.
- Pós-pago: Clique em Delete e confirme.
FAQ
Posso carregar e implantar meus próprios modelos?
É possível importar alguns modelos de código aberto no console Meus Modelos (Pequim); para a lista detalhada de modelos suportados, consulte: Importação de modelos.
Além disso, a Plataforma de Inteligência Artificial PAI do Alibaba Cloud oferece a capacidade de implantar seus próprios modelos. Consulte Implantação de LLM de Grandes Modelos de Linguagem do PAI para conhecer o método de implantação.
Como faço para alternar para outros métodos de faturamento?
Você só pode liberar os recursos originais e, em seguida, criar novos recursos usando o método de faturamento desejado.
Recomenda-se alternar seguindo as etapas abaixo:
- Implante novos recursos usando o método de faturamento desejado.
- Alterne a API e teste a disponibilidade do serviço.
- Coloque offline e libere os recursos originais.