

Este tópico descreve os recursos de entrada longa e cache de prefixo das implantações PTU (Provisioned Throughput), incluindo regras de consumo de cota, como usar a calculadora de cota de throughput provisionado (Provisioned Throughput Quota Calculator) e as descrições dos campos de resposta da API.
Visão geral
O PTU (Provisioned Throughput Unit) é um método de implantação de modelo que reserva recursos da plataforma para garantir uma capacidade de throughput TPM específica; nenhuma limitação de taxa se aplica dentro da cota garantida. Ele é adequado para ambientes de produção de alto throughput, alto desempenho e alta carga, fornecendo capacidade de throughput estável, menor latência e maior certeza de recursos. Em comparação com o faturamento baseado em tokens, o TPS (tokens gerados por segundo) normalmente aumenta cerca de 1,5 a 2,0 vezes.
Casos de uso:
- Atendimento inteligente ao cliente para aplicativos bancários (tráfego estável, exige experiência simultânea garantida).
- Moderação de conteúdo em tempo real para plataformas sociais (exige processamento estável de tarefas de pipeline previsíveis).
- API de tradução em nuvem pública (fornece garantias de serviço básicas para usuários de pacote padrão).
Regras de faturamento
费用 = 使用时长 × (输入 TPM 单价 × 输入 TPM + 输出 TPM 单价 × 输出 TPM)
No modo pós-pago, o cálculo é feito por hora: a unidade de duração de uso é a hora e o preço unitário é obtido da coluna "1 hora contínua" da tabela abaixo; no modo pré-pago, o cálculo é feito por dia: a unidade de duração de uso é o dia e o preço unitário é obtido da coluna "1 dia contínuo" da tabela abaixo.
- Pedidos pré-pagos entram em vigor em tempo real após o pagamento, com período de validade de N dias terminando às 23:59 do dia N.
- Após a expiração de um pedido pré-pago, o serviço será interrompido com um atraso de 2 horas, e os recursos serão retidos por 14 horas após a interrupção e então liberados.
- Pedidos pré-pagos oferecem suporte ao encerramento antecipado; a parte utilizada é liquidada com um coeficiente de 1,2x para fins de reembolso. Para obter detalhes, consulte Regras de reembolso para downgrades de configuração.
- No faturamento pós-pago, se a conta estiver em atraso, os recursos implantados continuarão a ser retidos e cobrados por 24 horas, período durante o qual o serviço ainda poderá ser usado normalmente. Após 24 horas, o sistema interrompe a cobrança, a implantação do modelo entra em estado de inadimplência e os recursos subjacentes serão excluídos, mas a tarefa de implantação do modelo será retida. Após o pagamento do atraso, o sistema realocará os recursos e restaurará o uso (as taxas continuarão a acumular após a restauração). Se você não quiser continuar incorrendo em taxas, é possível excluir a tarefa de implantação do modelo, e a cobrança será interrompida após a exclusão bem-sucedida.
- Nesse caso (somente na estratégia "auto-overflow"), o cabeçalho da resposta da API incluirá:
x-dashscope-ptu-overflow:true. - Para as estatísticas de TPM, acesse: Monitoramento de modelos.
Modelos e preços compatíveis
- Singapura
- China Norte 2 (Pequim)
- Qwen
- DeepSeek
- Qwen-VL
- GLM
Nome do modelo | Código do modelo | Token de entrada máximo | Entrada pós-paga Por 10K TPM/hora | Saída pós-paga Por 1K TPM/hora | Entrada pré-paga Por 10K TPM/dia | Saída pré-paga Por 1K TPM/dia |
|---|---|---|---|---|---|---|
Qwen3.8-Max | qwen3.8-max | 1M | $4.8 | $1.44 | $57.6 | $17.28 |
Qwen3.7-Flash-2026-07-15 Entre em contato com seu gerente de negócios para ativar | qwen3.7-flash-2026-07-15 | 128K | $0.072 | $0.031 | $0.864 | $0.374 |
Qwen3.7-Max-2026-05-20 | qwen3.7-max-2026-05-20 | 256K | $1.92 | $1.8 | $72 | $21.6 |
Qwen3.7-Plus-2026-05-26 | qwen3.7-plus-2026-05-26 | 256K | $0.96 | $0.384 | $11.52 | $4.608 |
Qwen3.6-Plus-2026-04-02 | qwen3.6-plus-2026-04-02 | 128K | $1.2 | $0.72 | $14.4 | $8.64 |
Qwen3.5-Plus-2026-04-20 | qwen3.5-plus-2026-04-20 | 128K | $0.96 | $0.576 | $11.52 | $6.912 |
Entrada longa e cache de prefixo
Os coeficientes em camadas para entrada longa e os descontos de cache variam conforme o modelo. A tabela a seguir lista os parâmetros dos modelos compatíveis atualmente:
Modelo | Tipo | Comprimento máximo de entrada | Desconto de cache | Coeficiente em camadas para entrada longa |
|---|---|---|---|---|
glm-5.2 | PTU | (0, 1M) | 0,25 | 1 |
qwen3.8-flash | PTU | (0, 1M) | 0,125 | 1 |
qwen3.8-max | PTU | (0, 1M) | 0,125 | 1 |
qwen3.7-flash-2026-07-15 | PTU | (0, 1M) | 0,2 | Igual para entrada e saída |
deepseek-v4-flash-0731 | PTU | (0, 1M) | 0,1 | 1 |
qwen3.7-plus-2026-05-26 | PTU | PTU | 1 milhão | 0,2 (parcela com acerto de cache calculada a 20% da capacidade) |
glm-5.1 | PTU | PTU | 200K | 0,2 (parcela com acerto de cache calculada a 20% da capacidade) |
deepseek-v4-pro | PTU | PTU | 256K | 0,08 (parcela com acerto de cache calculada a 8% da capacidade) |
Outros modelos | PTU | PTU | Consulte o console | Consulte o console |
Exemplos de cálculo (usando glm-5.1)
Provisioned Throughput Quota Calculator
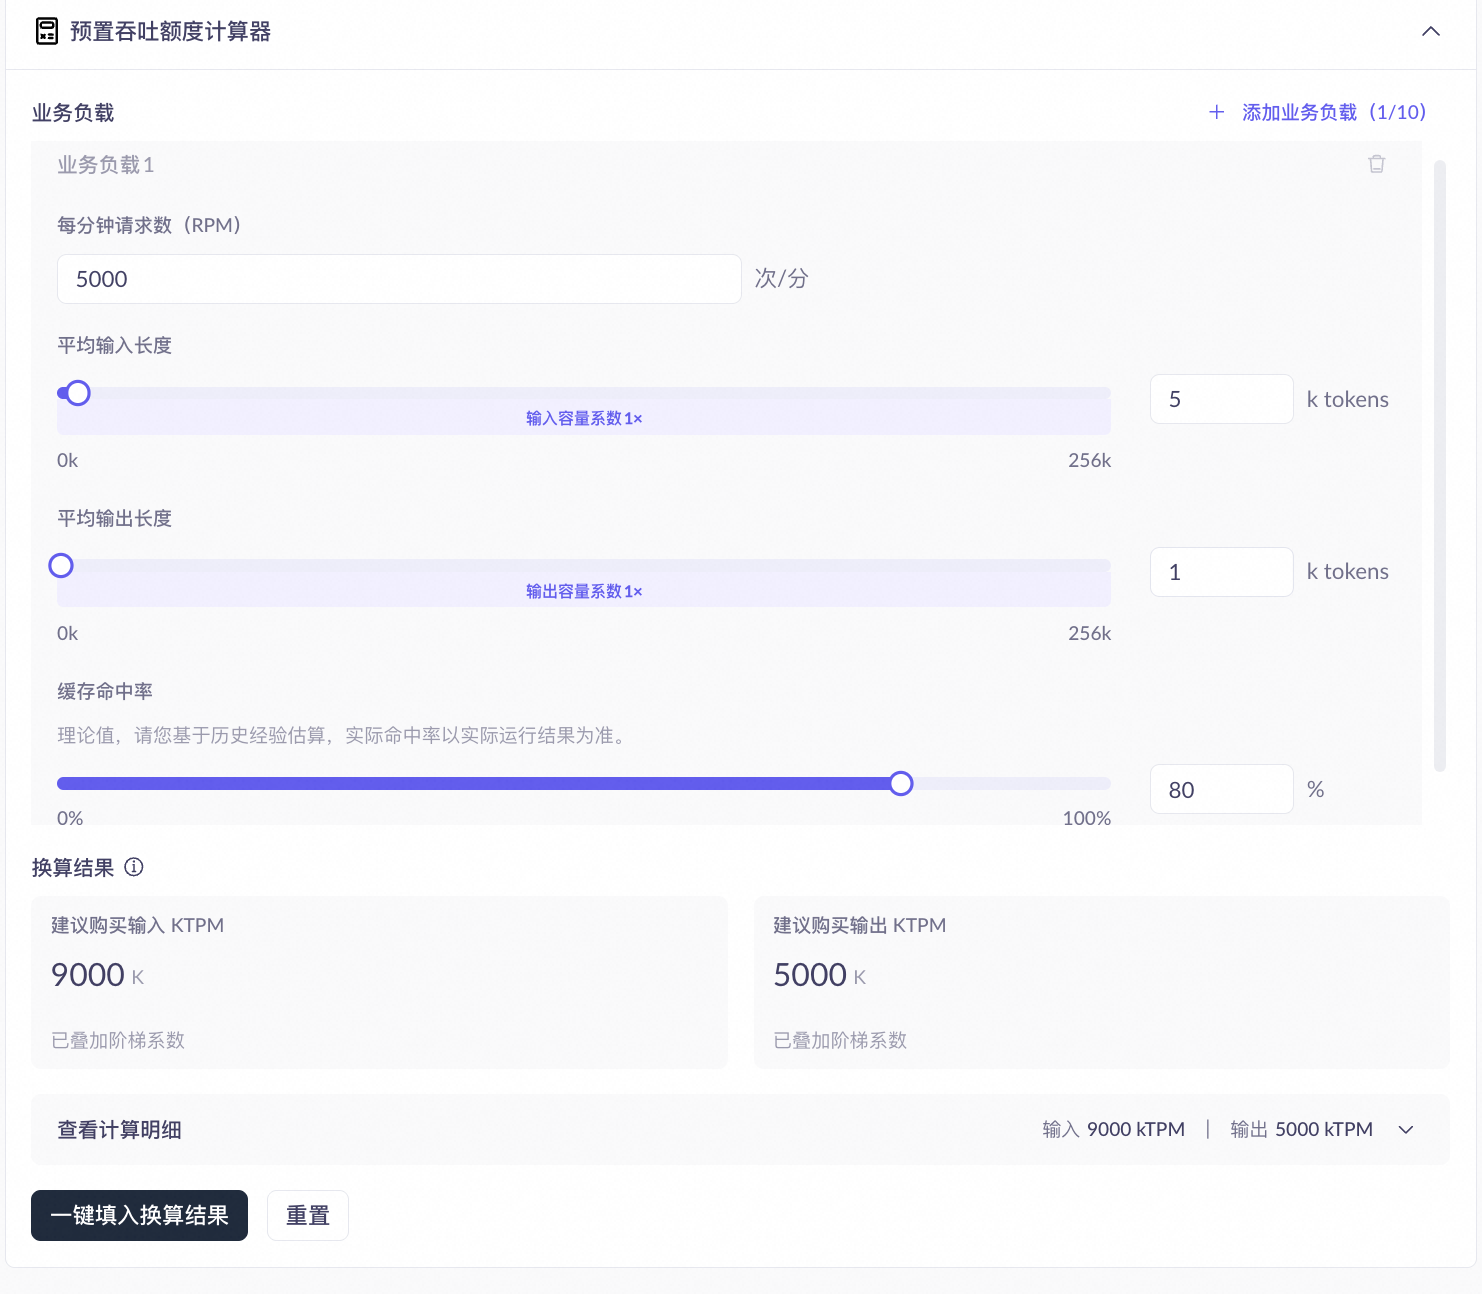
Parâmetro | Descrição | Impacto nos resultados |
|---|---|---|
Solicitações por minuto (RPM) | Quantidade de solicitações por minuto durante o pico de negócios. | Quanto maior o RPM, maior será o aumento proporcional dos valores recomendados de KTPM de entrada e saída. |
Comprimento médio de entrada (tokens) | Média de tokens de entrada por solicitação. | Entradas mais longas elevam a camada e o coeficiente, aumentando o KTPM de entrada recomendado. Os limites das camadas variam conforme o modelo; consulte o console para os valores reais. |
Comprimento médio de saída (tokens) | Média de tokens de saída por solicitação. | Saídas mais extensas podem aumentar o coeficiente aplicável, resultando em um KTPM de saída recomendado mais alto. |
Taxa de acerto de cache (%) | Percentual de tokens de prefixo da solicitação que atingem o cache. A taxa real depende da repetição do conteúdo das solicitações; consulte os resultados reais em tempo de execução. | Uma taxa de acerto maior desacelera o consumo da cota de entrada, reduzindo o KTPM de entrada recomendado. Afeta apenas o KTPM de entrada, não o de saída. |
Campos de resposta da API
As respostas da API para implantações PTU incluem os seguintes campos relacionados à cota, que identificam o método de faturamento e o consumo de cota:
Campo | Tipo | Descrição |
|---|---|---|
| String | Campo de resposta de nível superior (consistente em todos os formatos de API). O valor |
| Integer | Tokens reais de cota PTU consumidos após a conversão (inclui coeficientes em camadas e descontos de cache). |
| Integer | Quantidade de tokens que atingiram o cache de prefixo. Para obter detalhes, consulte Context Cache. |
- Compatível com OpenAI Chat
- OpenAI Responses
- Compatível com Anthropic
- DashScope
Campo | Caminho JSON | Descrição |
|---|---|---|
|
| Contagem de tokens em cache no lado da entrada |
|
| Consumo de cota PTU no lado da entrada |
|
| Consumo de cota PTU no lado da saída |
Monitoramento e verificação
É possível monitorar as implantações PTU por meio do recurso de monitoramento de modelos na plataforma Model Studio. As métricas a seguir são relevantes para entrada longa e cache:
- Utilização de PTU: três curvas independentes para entrada, saída e saída do modo de raciocínio. Em cenários de entrada longa, os coeficientes em camadas podem fazer a utilização ultrapassar 100%. Esse comportamento é esperado.
- Uso de tokens e acertos de cache: inclui a série de dados
cached_tokenspara mostrar a proporção de acertos de cache em relação ao total de entrada. - Contagem de chamadas dentro e fora da cota: exibe a proporção de solicitações que excedem a cota PTU (na estratégia de auto-overflow, as solicitações retornam ao faturamento de pagamento conforme o uso; na estratégia use-only-PTU-capacity, erros 429 são retornados).
Dimensionamento
Clique no botão Scaling para ajustar manualmente, por autoatendimento, o throughput (número de instâncias). Para as regras detalhadas de redução de taxas e reembolso, consulte: Regras de reembolso para downgrades de configuração.
Perguntas frequentes
P: O que acontece quando a cota PTU é excedida?
P: O que acontece quando a cota PTU é excedida?
service_tier na resposta da API não é retornado ou retorna default, e o cabeçalho da resposta inclui x-dashscope-ptu-overflow:true, de modo que o serviço não é interrompido; na estratégia "use-only-PTU-capacity", as solicitações que excedem a cota retornam um erro 429 e nenhuma taxa adicional é cobrada.P: O que acontece quando uma única entrada excede o limite do modelo?
P: O que acontece quando uma única entrada excede o limite do modelo?
P: Como verifico se o cache está funcionando?
P: Como verifico se o cache está funcionando?
cached_tokens na resposta da API. Um valor maior que 0 indica um acerto no cache de prefixo. Tokens com acerto de cache consomem cota pelo coeficiente de desconto do modelo (para as taxas de desconto específicas, consulte Entrada longa e cache de prefixo). Também é possível visualizar tendências no gráfico de uso de tokens na página de monitoramento do console.P: E se cached_tokens for sempre 0 e o cache não estiver funcionando?
P: E se cached_tokens for sempre 0 e o cache não estiver funcionando?
P: Por que a utilização ultrapassa 100%?
P: Por que a utilização ultrapassa 100%?