

Os datasets são a base para o treinamento e a avaliação de modelos. O recurso Data Management do Alibaba Cloud Model Studio ajuda você a criar e gerenciar datasets com eficiência.
Visão geral dos datasets
O recurso Data Management do Alibaba Cloud Model Studio gerencia centralmente todos os datasets relacionados a grandes modelos no seu workspace de negócios. Os datasets dividem-se em Training Set (usado para ajuste fino de modelos, com suporte a SFT/DPO/CPT) e Evaluation Set (usado para avaliação de modelos).
Os conjuntos de treinamento suportam quatro cenários: geração de texto, compreensão multimodal, imagem para vídeo (primeiro quadro) e imagem para vídeo (primeiro e último quadro). Os conjuntos de avaliação suportam apenas o cenário de geração de texto. O tipo de dataset não pode ser alterado após a criação; escolha com cuidado com base no uso downstream.
Os nomes dos datasets podem ter até 50 caracteres (são aceitos caracteres chineses, ingleses, dígitos, sublinhados, hifens e pontos), e as descrições até 200 caracteres. O sistema não permite criar ou publicar datasets vazios. Não há limite para a quantidade de datasets que você pode criar nem para o volume de dados importados.
Os métodos de treinamento DPO/CPT e a montagem de armazenamento em cloud estão disponíveis apenas na região Beijing.
Métodos e cenários de treinamento
Os conjuntos de treinamento oferecem três métodos distintos, cada um com cenários específicos e requisitos mínimos de dados:
- SFT (supervised fine-tuning): ajuste fino supervisionado por instruções que capacita o modelo a resolver tarefas específicas. Recomenda-se pelo menos mil entradas. Disponível em todos os sites.
- DPO (direct preference optimization): treinamento de alinhamento de preferências. Recomenda-se pelo menos cem entradas.
- CPT (continual pre-training): injeção de conhecimento de domínio. Recomenda-se pelo menos 50 milhões de tokens de dados.
Método de treinamento | Finalidade | Volume de dados recomendado | Disponibilidade por site |
|---|---|---|---|
SFT | Ajuste fino supervisionado (ajuste por instruções) | Mais de 1.000 entradas | Todos os sites |
DPO | Otimização direta de preferência (alinhamento de preferência) | Mais de 100 entradas | Região Beijing |
CPT | Pré-treinamento contínuo (conhecimento de domínio) | 50 milhões de tokens | Região Beijing |
Métodos de importação
Existem três formas de importar datasets, cada uma adequada a diferentes cenários e pré-requisitos:
- Upload Local File: sem pré-requisitos; faça upload direto de arquivos locais, ideal para pequenos lotes de dados.
- OSS Import: adicione a tag
bailian-datahub-access=readao bucket de destino; indicado para grandes volumes de dados. Não compatível com conjuntos de avaliação. - Log Backflow: extrai automaticamente dados de treinamento dos logs de inferência do SLS; exige autorização de uma função vinculada a service, criando um ciclo de melhoria: inferência → dados → ajuste fino.
Método de importação | Pré-requisitos | Cenário aplicável | Compatível com conjunto de avaliação |
|---|---|---|---|
Upload local | Nenhum | Pequenos lotes de dados | Suportado |
Importação OSS | Tag do bucket bailian-datahub-access=read | Grandes lotes de dados | Não suportado |
Fluxo de retorno de logs | Autorização + Filtro de API Key/modelo | Criar dados de treinamento a partir de logs de inferência | Suportado |
Preparação de dados
A preparação de dados de alta qualidade é fundamental para os resultados do ajuste fino do modelo. Para os volumes de dados recomendados para cada método de treinamento (geração de texto SFT/DPO/CPT), consulte Regras de upload de dados de ajuste fino.
Não existem volumes oficiais recomendados para conjuntos de treinamento de compreensão multimodal e imagem para vídeo; prepare amostras suficientes conforme seu cenário real.
Formato de dados e modelos
Para as especificações de formato de arquivo de dados de cada cenário de treinamento (texto SFT/compreensão multimodal (imagem/vídeo → texto), DPO, CPT, conjuntos de avaliação), consulte Regras de upload de dados de ajuste fino.
Na página de criação de dataset do Data Management, baixe o modelo de dados correspondente ao cenário desejado; preparar os dados seguindo essa estrutura evita falhas na importação. Os conjuntos de avaliação suportam o formato de rodada única Text generation (prompt&completion) e o formato de conversa de múltiplas rodadas Text generation (ChatML-messages); para especificações detalhadas de campos e exemplos, consulte Regras de upload de dados de ajuste fino - Formato do conjunto de avaliação.
Para estratégias de diversidade e aumento de dados, consulte a documentação de ajuste fino de modelos. No caso de conjuntos de avaliação, prepare um conjunto independente e sem sobreposição de dados para avaliar objetivamente a capacidade de generalização do modelo.
Criar um dataset
Antes de criar um dataset, certifique-se de atender aos seguintes pré-requisitos: o service Model Studio deve estar ativado; para importação via OSS, adicione a tag bailian-datahub-access=read ao bucket de destino; para fluxo de retorno de logs, autorize uma função vinculada a service.
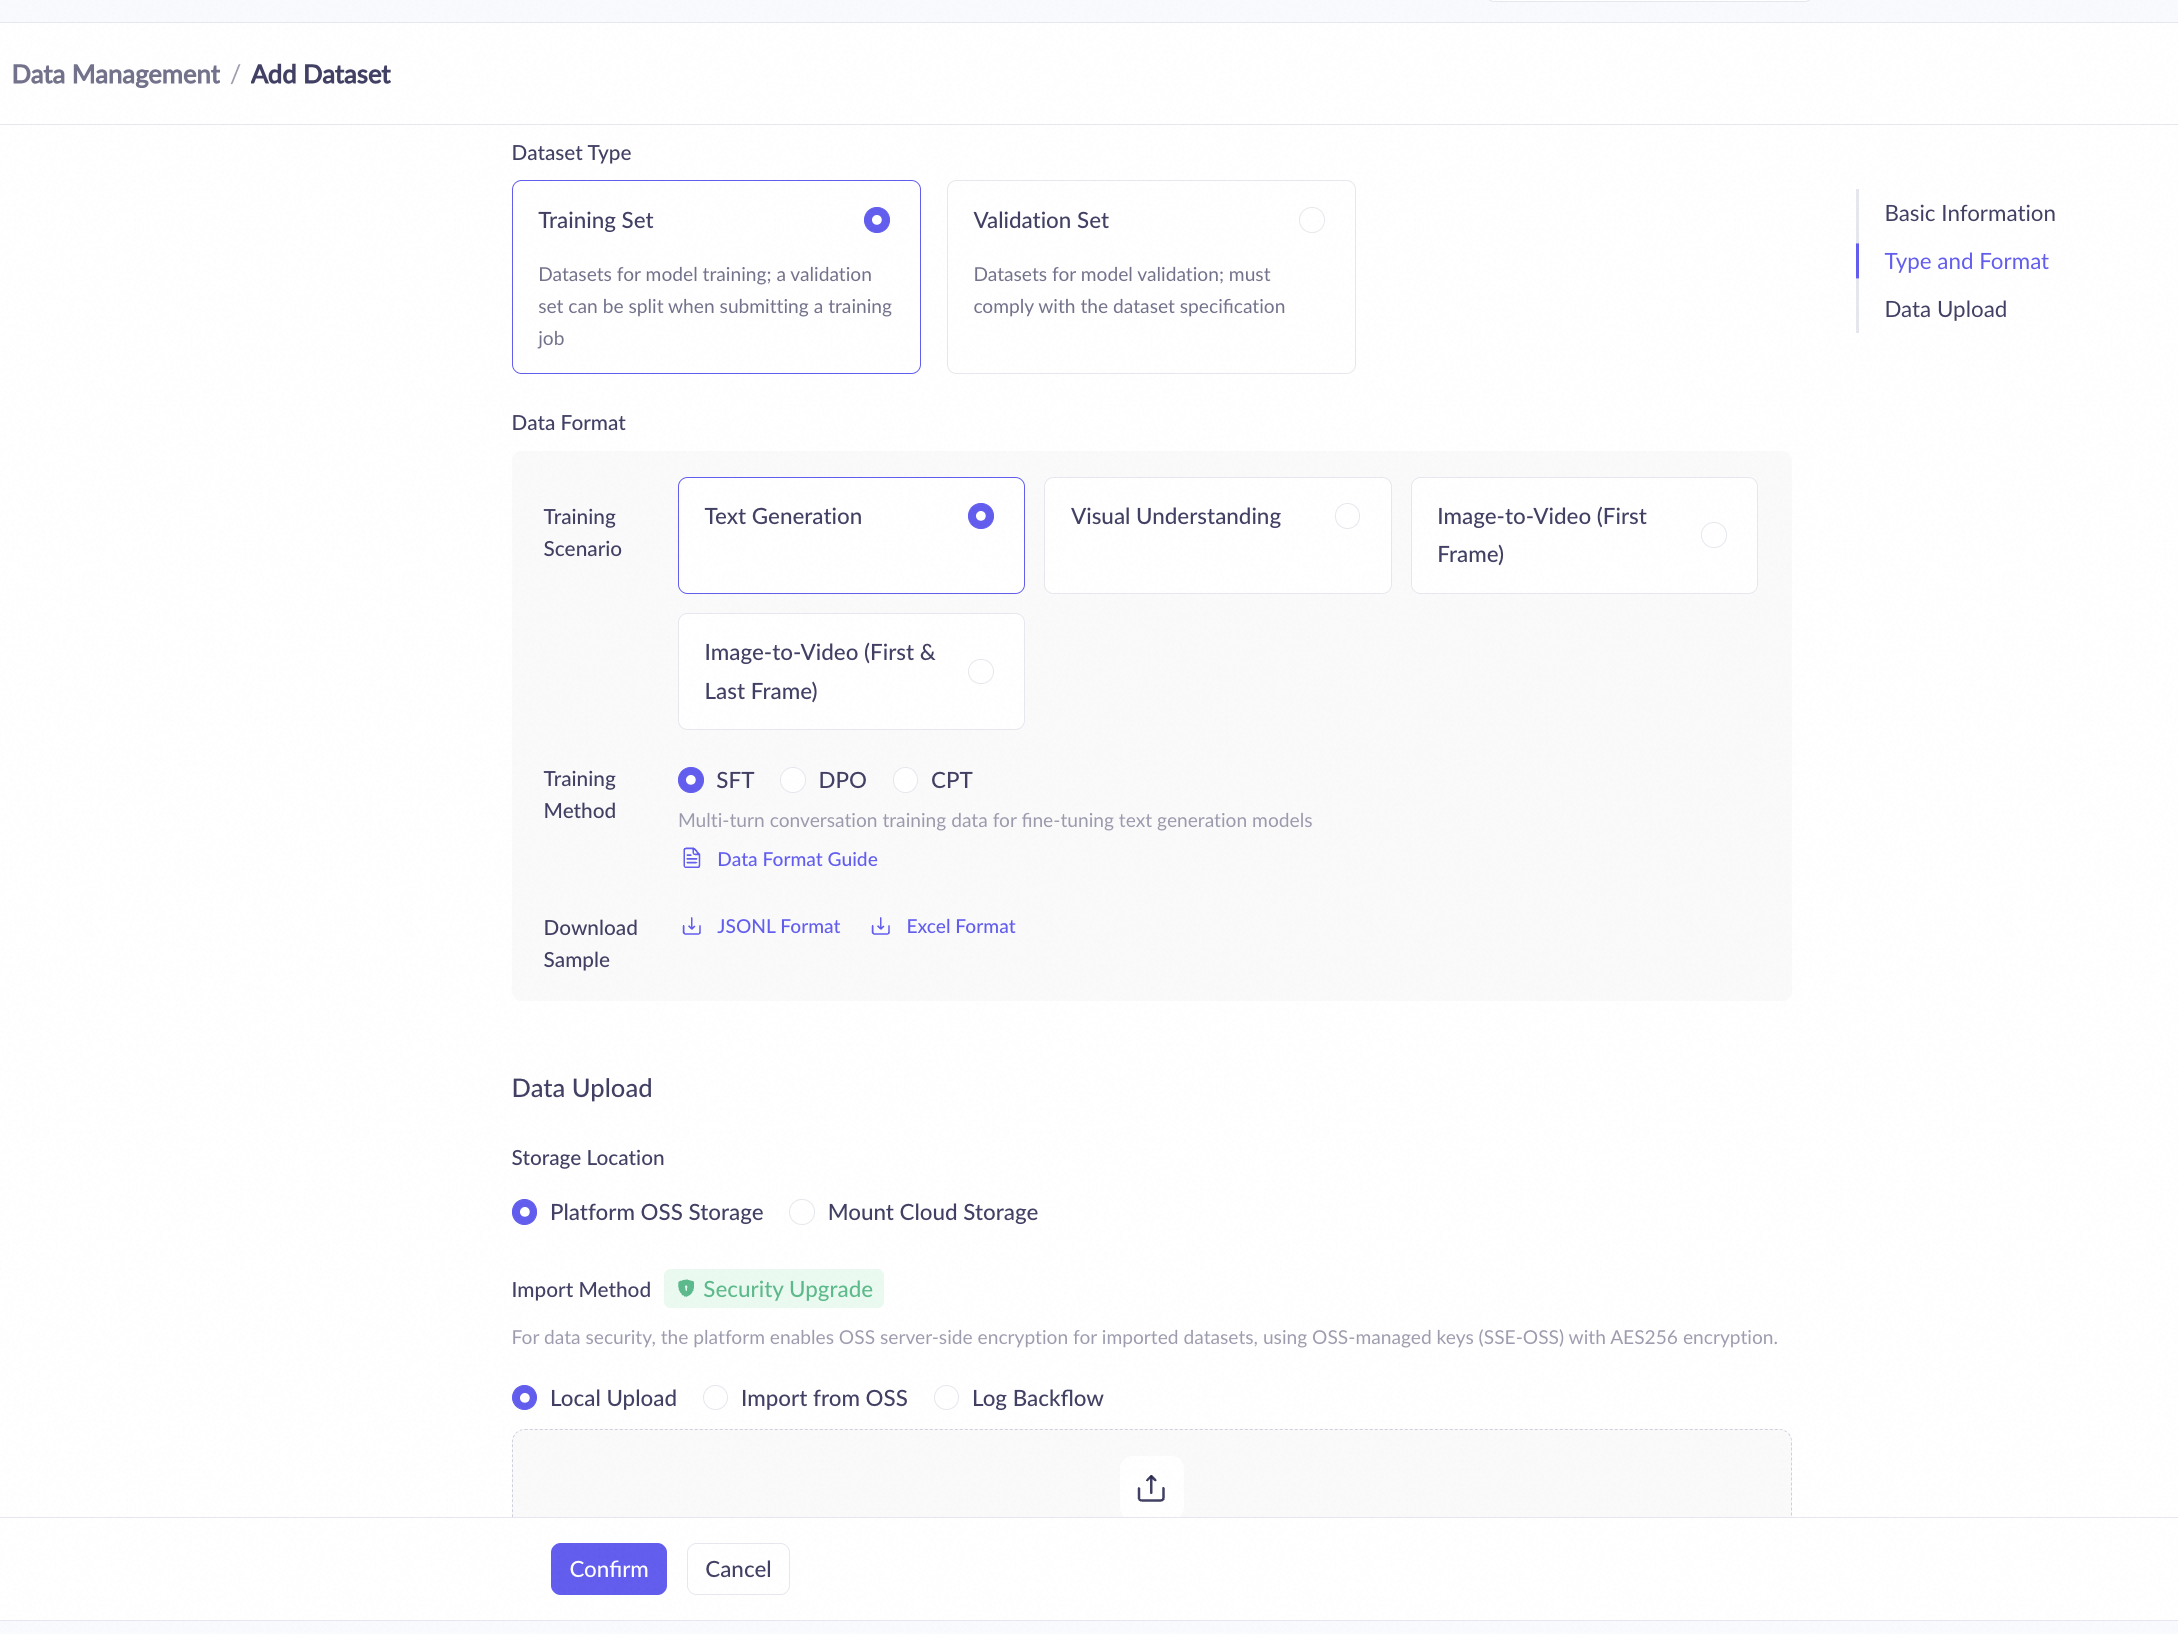
Na página de lista Data Management > Dataset, clique em Add Dataset e siga estas etapas:
- Insira um nome para o dataset (até 50 caracteres) e uma descrição (até 200 caracteres, opcional).
- Selecione o tipo de dataset: Training Set ou Evaluation Set (não é possível alterar após a criação).
- Escolha o cenário de treinamento: Training Set suporta geração de texto, compreensão multimodal, imagem para vídeo (primeiro quadro), imagem para vídeo (primeiro e último quadro), entre outros; para Evaluation Set, selecione aqui o formato de amostra — Text generation (ChatML-messages) (conversa de múltiplas rodadas; suporta jsonl, xls e xlsx, com arquivo único de no máximo 200 MB) ou Text generation (prompt&completion) (rodada única; apenas xls e xlsx, com arquivo único de no máximo 20 MB). A página de criação oferece o download de modelos de exemplo nos formatos correspondentes.
- Defina o método de treinamento: SFT, DPO ou CPT (necessário apenas para o Training Set; o Evaluation Set não tem essa configuração).
- Especifique o local de armazenamento: Platform OSS storage (gratuito, sem limite de volume de dados) ou Mount Cloud Storage (indisponível para conjuntos de avaliação).
- Escolha o método de importação e carregue os dados: upload local, importação OSS ou fluxo de retorno de logs (consulte as descrições nas abas abaixo).
- Clique em Submit; o dataset é publicado imediatamente, concluindo a criação.
Parâmetro | Descrição | Obrigatório | Descrição do valor |
|---|---|---|---|
Nome do dataset | Identificador do dataset | true | Até 50 caracteres; chinês/inglês/dígitos/sublinhado/hífen/ponto |
Descrição do dataset | Descrição do dataset | Até 200 caracteres | |
Tipo de dataset | Conjunto de treinamento ou avaliação; imutável após criação | true | Training Set/Evaluation Set |
Cenário de treinamento | Cenário de treinamento aplicável aos dados | true | Geração de texto/Compreensão multimodal/Imagem para vídeo (primeiro quadro)/Imagem para vídeo (primeiro e último quadro) |
Método de treinamento | Tipo de algoritmo de treinamento | true | SFT/DPO/CPT |
Local de armazenamento | Método de armazenamento do dataset | true | Platform OSS storage/Montagem de armazenamento em cloud |
Método de importação | Fonte de importação de dados | true | Upload local/Importação OSS/Fluxo de retorno de logs |
- Upload local
- Importação OSS
- Fluxo de retorno de logs
Gerenciamento de versões
Um dataset pode ter várias versões independentes, com numeração incremental automática. Na página de detalhes do dataset, clique em Add Version para criar uma nova versão.
A adição de uma versão usa o modo de criação nova, que exige a reimportação de todos os dados; o modo de herança, que modifica os dados incrementalmente com base na versão anterior, não é mais suportado.
- Create Mode: reimporta todos os dados; indicado para atualizações em grande escala.
Gerenciamento de datasets
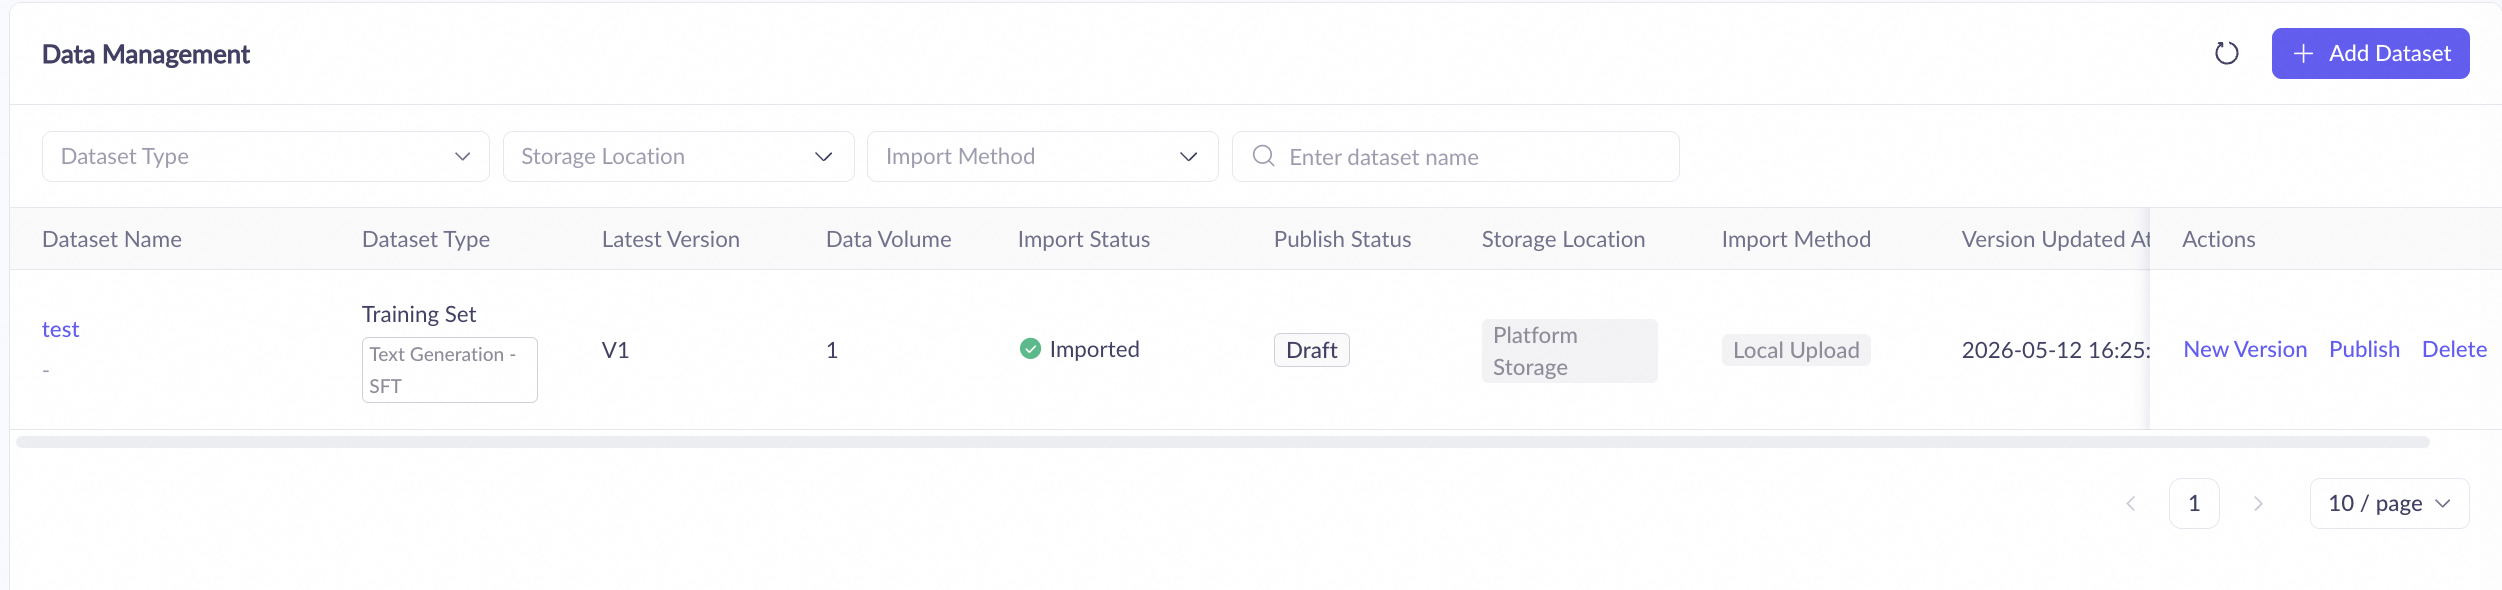
Na página de lista Data Management > Dataset, você pode visualizar todos os datasets, filtrar por tipo (conjunto de treinamento/avaliação) e pesquisar por nome. Datasets em processo de importação atualizam o status automaticamente a cada 5 segundos, sem necessidade de atualização manual.
Publicar e excluir
A ação Publish é irreversível; versões publicadas não podem mais ser editadas. Excluir uma versão publicada também é irreversível; apenas versões em rascunho criadas historicamente podem ser excluídas. Excluir um dataset inteiro remove todas as suas versões. Todas essas operações são irreversíveis; proceda com cautela.
Editar e exportar
Somente versões em rascunho criadas historicamente podem ser editadas online (o conteúdo Prompt/Completion é editável); novos datasets são publicados imediatamente após o envio e não geram mais versões em rascunho, e a edição não está disponível para versões publicadas. Ao exportar datasets, cada tipo possui um formato diferente: conjuntos de treinamento SFT são exportados como .jsonl, conjuntos multimodais como .zip e conjuntos de avaliação como .xlsx. Não é possível exportar datasets vazios.
Faturamento
O recurso Data Management é gratuito, mas o armazenamento de datasets e os recursos downstream geram custos; consulte a página de faturamento do Model Studio para detalhes.
- Platform OSS storage: as taxas seguem a página de faturamento do Model Studio.
- Mount Cloud Storage: os custos são faturados na própria conta OSS do usuário.
- Log Backflow: as taxas do SLS incorridas são cobradas na conta do produto SLS.
Próximas etapas
Depois que um dataset é criado e publicado, ele pode ser utilizado nos seguintes cenários downstream:
- Após a publicação de um conjunto de treinamento, ele é usado para ajuste fino de modelos (SFT/DPO/CPT).
- Após a publicação de um conjunto de avaliação, ele é usado para avaliação de modelos.