

Ao usar o Wan para geração de imagens , se o Guia de prompts para texto-para-vídeo/imagem-para-vídeo não atender às suas necessidades de personalização de estilos específicos, personagens de IP ou efeitos visuais , use o ajuste fino de modelo .
Escopo
- Região suportada: Este documento aplica-se apenas à região de Singapore. Use uma chave de API desta região.
- Método de ajuste fino suportado: Ajuste fino eficiente SFT-LoRA.
-
Modelos suportados:
- Geração de imagens (texto-para-imagem/imagem-para-imagem): wan2.7-image-pro, wan2.7-image.
Como ajustar um modelo
- Text-to-image
- Image-to-image
| Prompt de entradaUma pessoa em um vagão de metrô lotado durante o horário de pico matinal, segurando no corrimão, com passageiros desfocados ao fundo e luzes do túnel visíveis pelas janelas, vestindo camisa branca e calça preta comuns de escritório, parada de frente para a câmera, plano médio, sensação realista de foto espontânea. | Imagem de saída (antes do ajuste fino - texto-para-imagem)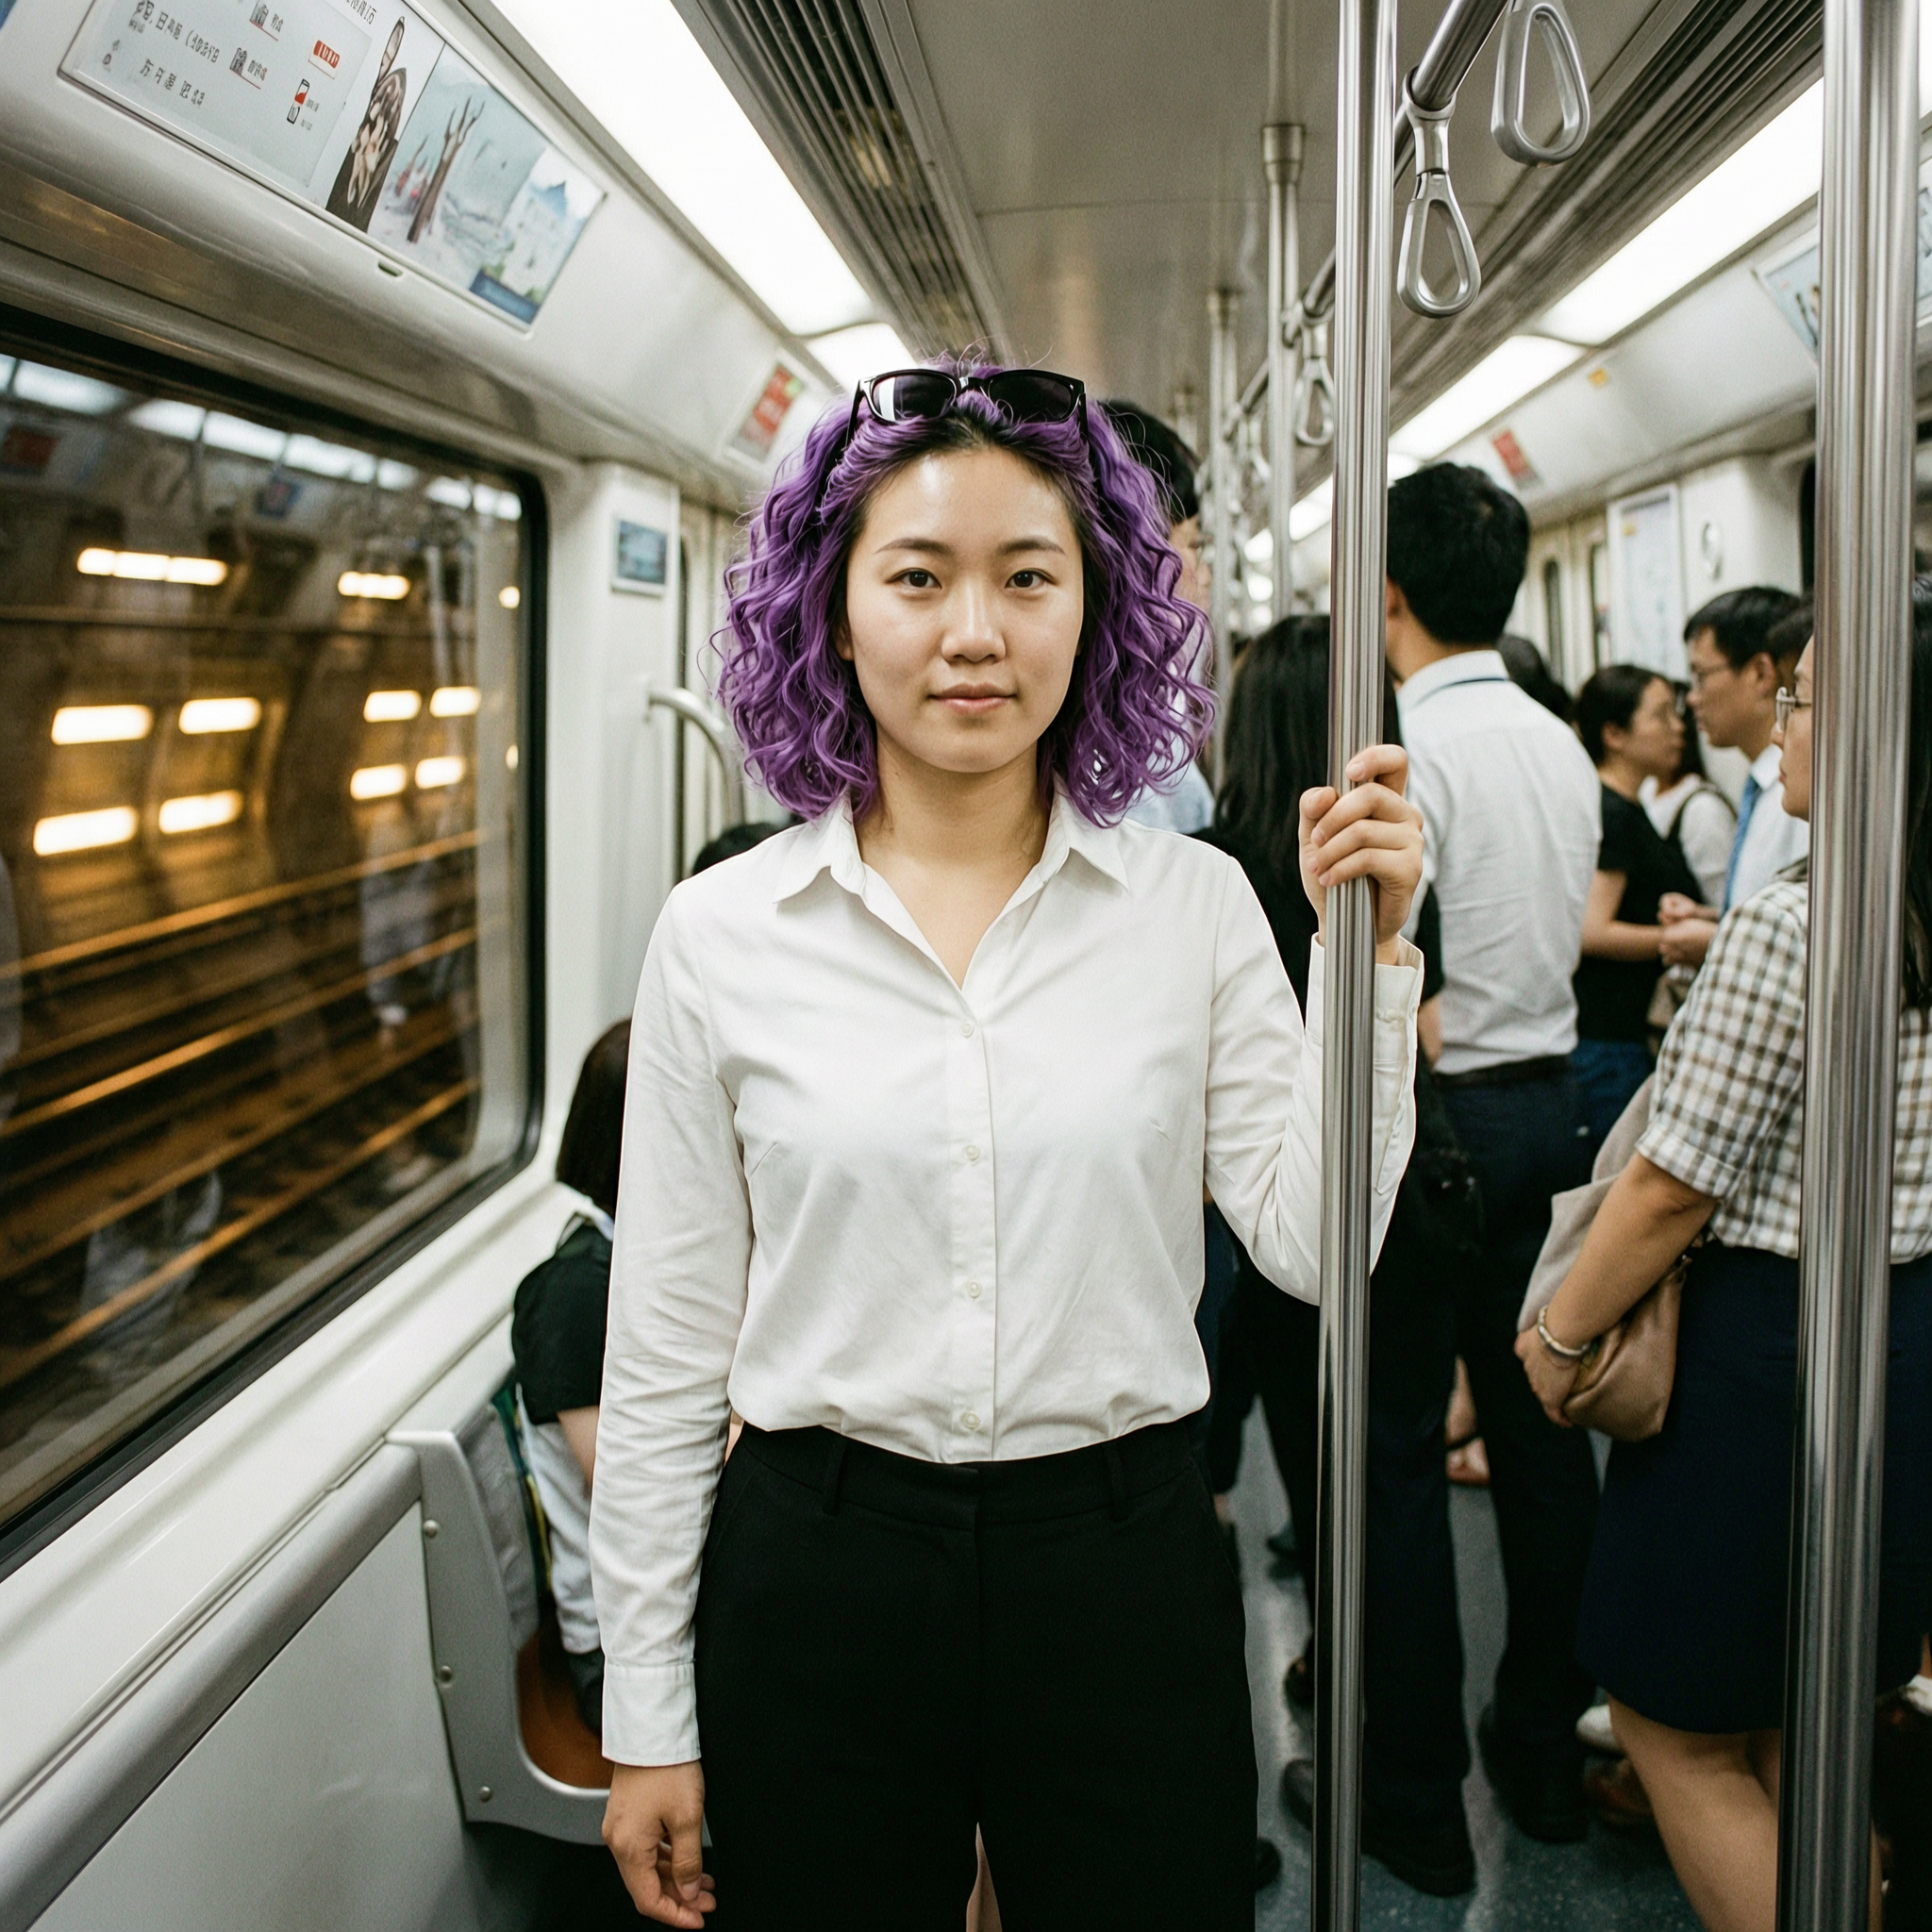 Sem uma imagem de referência, o modelo não consegue gerar um personagem específico. | Imagem de saída (após o ajuste fino)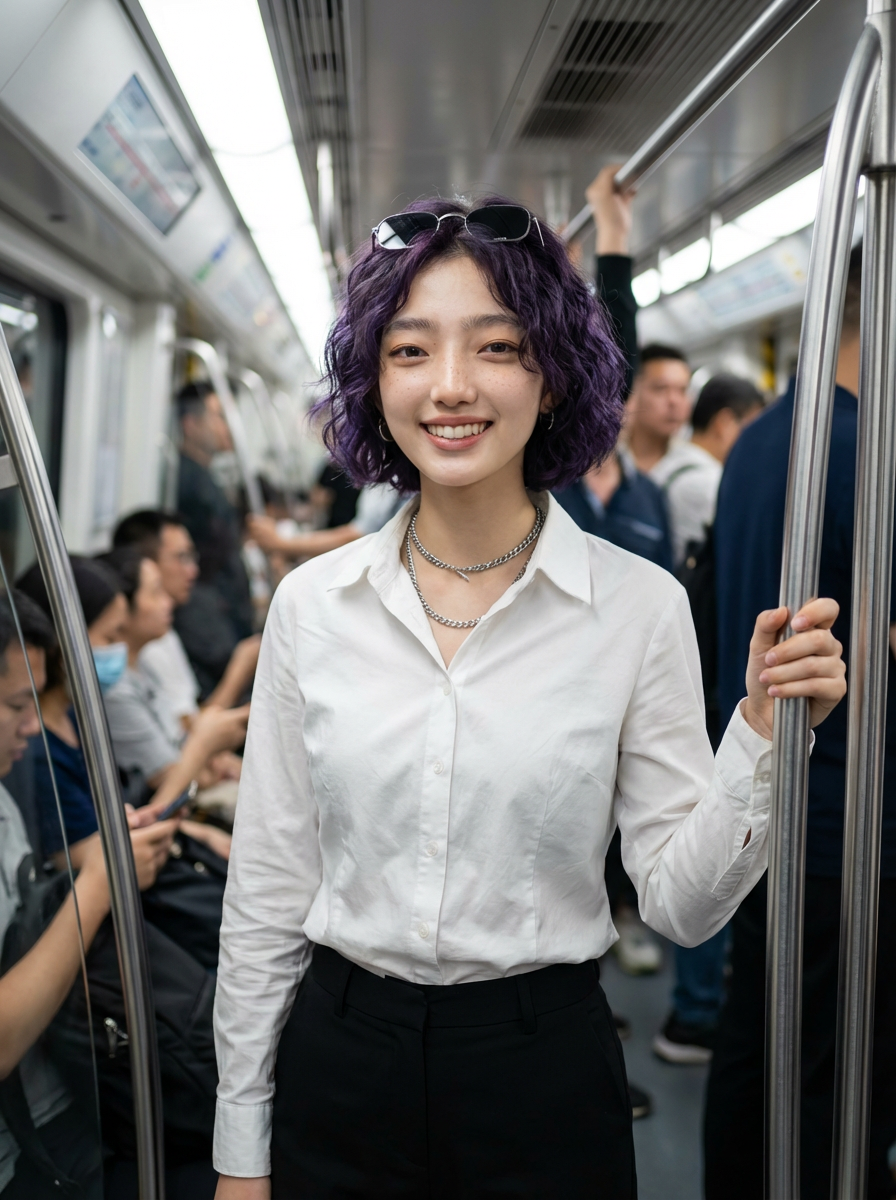 Após o ajuste fino, o modelo reproduz com confiabilidade o personagem específico do conjunto de treinamento. |
Etapa 1: Carregar o conjunto de dados
Carregue seu conjunto de dados local (no formato .zip) para a plataforma Alibaba Cloud Model Studio e obtenha o ID do arquivo (file_idid).
Dados de treinamento de exemplo: Para o formato, consulte Conjunto de treinamento.
- Geração de imagens - texto-para-imagem: wan-image-t2i-training-dataset.zip
- Geração de imagens - imagem-para-imagem: wan-image-i2i-training-dataset.zip
Este exemplo usa texto-para-imagem e carrega apenas o conjunto de treinamento. O sistema divide automaticamente uma parte do conjunto de treinamento para servir como conjunto de validação.
id. Este é o identificador exclusivo do conjunto de dados carregado.
Etapa 2: Ajustar o modelo
Etapa 2.1: Criar um job de ajuste fino
Use o ID do arquivo obtido na Etapa 1 para iniciar um job de treinamento. Exemplo de solicitação Substitua<replace_with_training_dataset_file_id> pelo id obtido na etapa anterior. Para a referência completa de parâmetros e restrições de formato, consulte Hiperparâmetros.
- Texto-para-imagem (t2i): aproximadamente 77 minutos para 300 etapas.
- Imagem-para-imagem (i2i): aproximadamente 110 minutos para 300 etapas.
output:
job_id: O ID do job, usado para consultar o progresso.finetuned_output: O nome do modelo ajustado. Use este nome para implantação e invocação subsequentes.status: O status do treinamento. Após criar um job de ajuste fino, o status inicial é PENDING, indicando que o treinamento ainda não começou.
Etapa 2.2: Consultar o status do job de ajuste fino
Use ojob_id obtido na Etapa 2.1 para consultar o progresso do job. Faça polling da seguinte API até que o status mude para SUCCEEDED.
Exemplo de solicitação
Substitua <replace_with_fine_tuning_job_id> na URL pelo valor de job_id.
output:
status: Quando o valor mudar para SUCCEEDED, o treinamento do modelo estará concluído e você poderá prosseguir com a implantação.usage: O número total de tokens consumidos durante o treinamento do modelo, usado para fins de faturamento.
Etapa 3: Implantar o modelo ajustado
Etapa 3.1: Implantar o modelo como um service online
Depois que o status do job de ajuste fino mudar para SUCCEEDED, implante o modelo como um service online. Exemplo de solicitação Substitua<replace_with_model_name> pelo valor de finetuned_output obtido na saída de Criar um job de ajuste fino.
output:
deployed_model: O nome do modelo implantado, usado para consultar o status da implantação e invocar o modelo.status: O status da implantação do modelo. Após implantar o modelo ajustado, o status inicial é PENDING, indicando que a implantação ainda não começou.
Etapa 3.2: Consultar o status da implantação
Consulte o status da implantação. Faça polling da seguinte API até que ostatus mude para RUNNING.
<replace_with_deployed_model> pelo valor de deployed_model obtido na saída da Etapa 3.1.
output:
status: Quando o status mudar para RUNNING, o modelo foi implantado com sucesso e você pode começar a invocá-lo.deployed_model: O nome do modelo implantado.
Etapa 4: Invocar o modelo para gerar imagens
Após a implantação bem-sucedida do modelo (quando o status da implantação for RUNNING), inicie as invocações.
type em message.content.Etapa 4.1: Criar uma tarefa de geração de imagens e obter o task_id
Etapa 4.1: Criar uma tarefa de geração de imagens e obter o task_id
<replace_with_deployed_model> pelo valor de deployed_model da etapa anterior.- Text-to-image
- Image-to-image
task_id para consultar o resultado na próxima etapa.Campo | Tipo | Obrigatório | Descrição | Exemplo |
|---|---|---|---|---|
model | string | Sim | O nome do modelo. Use um modelo ajustado que tenha sido implantado com sucesso e esteja com status RUNNING. | wan2.7-image-pro-xxxxxxxxxxxx |
input.messages[].content[].text | string | Sim | O prompt de texto. Recomendamos incluir a palavra-gatilho para ativar o estilo LoRA. | s86b5p, Uma pessoa em uma biblioteca privada silenciosa em uma tarde tranquila... |
parameters.size | string | Não | A resolução da imagem de saída.
| 2K |
parameters.n | integer | Não | O número de imagens a serem geradas. Valores válidos: 1-4. Padrão: 1. | 1 |
Etapa 4.2: Consultar resultados por task_id
Etapa 4.2: Consultar resultados por task_id
task_id até que o task_status mude para SUCCEEDED. Recupere a URL da imagem em output.choices[].message.content[].image.Exemplo de solicitação
Substitua 86ecf553-d340-4e21-xxxxxxxxx pelo seu task_id real.
A URL da imagem é válida por 24 horas. Baixe a imagem prontamente.
Criar conjuntos de dados personalizados
Além de usar os dados de exemplo deste documento para experimentar o fluxo de trabalho de ajuste fino, você também pode criar seus próprios conjuntos de dados para ajuste fino.
Um conjunto de dados deve conter um conjunto de treinamento (obrigatório) e um conjunto de validação (opcional; suporta divisão automática a partir do conjunto de treinamento). Compacte todos os arquivos no formato .zip. Os nomes dos arquivos devem conter apenas caracteres em inglês, dígitos, sublinhados ou hifens.
Formato do conjunto de dados
Conjunto de treinamento: Obrigatório
- Text-to-image
- Image-to-image
- Multi-image-to-image
- Exemplo de conjunto de treinamento: wan-image-t2i-training-dataset.zip
- Estrutura de diretórios do pacote Zip:
- Arquivo de anotação (data.jsonl): Cada linha representa uma amostra de treinamento e deve ser um objeto JSON.
- O arquivo data.jsonl deve estar no formato JSONL delimitado por linhas (um objeto JSON independente por linha). O uso de formato de array JSON (onde o primeiro caractere do arquivo é
[) não é permitido. - Os arquivos dentro do pacote zip devem estar em uma estrutura plana. Subdiretórios não são permitidos. Os nomes dos arquivos suportam apenas caracteres em inglês (caracteres chineses, espaços e caracteres especiais não são permitidos).
Conjunto de validação: Opcional
O conjunto de validação inclui um arquivo de anotação (data.jsonl) e imagens de referência opcionais (obrigatórias para o modo imagem-para-imagem). Imagens-alvo não são necessárias. Em cada checkpoint de avaliação, o job de treinamento invoca automaticamente o service do modelo para gerar imagens de pré-visualização usando os prompts (e imagens de referência) do conjunto de validação.
-
Conjunto de validação:
- Texto-para-imagem: wan-image-t2i-valid-dataset.zip
- Imagem-para-imagem: wan-image-i2i-valid-dataset.zip
- Estrutura de diretórios do pacote Zip:
-
Arquivo de anotação (data.jsonl): Cada linha representa uma amostra de validação e deve ser um objeto JSON.
- Text-to-image
- Image-to-image
- Multi-image-to-image
Escala de dados e limites
- Volume de dados: Recomendamos fornecer pelo menos 25 imagens (50 ou mais é recomendado para melhores resultados). Use o mesmo personagem ou estilo em várias cenas e ângulos, com descrições de conteúdo consistentes.
- Pacote Zip: Ao carregar via API, o tamanho total do pacote não deve exceder 1 GB.
-
Requisitos da imagem de treinamento:
- Formatos de imagem suportados: BMP, JPEG, PNG e WEBP.
- A resolução da imagem não deve exceder 4096×4096.
- O tamanho individual do arquivo de imagem não deve exceder 20 MB.
Coleta e limpeza de dados
1. Determinar o cenário de ajuste fino
O Wan suporta os seguintes cenários de ajuste fino para geração de imagens:- Estilização de personagem de IP: Treine o modelo para aprender o estilo de desenho de um personagem de IP específico, como personagens de anime ou imagens de mascotes.
- Estilo visual fixo: Melhore a capacidade do modelo de reproduzir um estilo de arte específico, como ilustração flat, pintura a tinta ou pixel art.
- Geração de cena específica: Replique padrões de composição específicos ou modelos de cena, como imagens de exibição de produtos ou layouts de pôsteres.
2. Obter materiais brutos
- Geração e seleção por IA: Use o modelo base Wan para gerar imagens em massa e selecione manualmente as amostras de alta qualidade que melhor correspondem ao efeito desejado. Este é o método mais utilizado.
- Fotografia real: Se o objetivo for alcançar cenas altamente realistas (como fotos reais de produtos ou retratos), o uso de filmagens reais é a melhor escolha.
- Renderização em software 3D: Para cenas que exigem controle fino de detalhes ou estilos de renderização 3D, recomendamos o uso de softwares 3D (como Blender ou C4D) para criar materiais de origem.
3. Limpar os dados
Dimensão | Melhor prática | Anti-padrão |
|---|---|---|
Consistência | As características principais devem ser altamente consistentes. Por exemplo: Ao treinar um "estilo de ilustração flat", todas as imagens devem compartilhar a mesma espessura de linha e esquema de cores. | Estilos mistos. O conjunto de dados contém imagens tanto no estilo impasto quanto no estilo flat. O modelo não consegue determinar qual estilo aprender. |
Diversidade | Quanto mais diversos os assuntos e cenas, melhor. Cubra diferentes assuntos (homens, mulheres, idosos, crianças, gatos, cães, edifícios) e diferentes composições (plano geral, close-up, extreme close-up). Resolução e proporções de aspecto também devem ser o mais variadas possível. | Cena ou assunto único. Todas as imagens mostram "uma pessoa de roupa vermelha contra uma parede branca". O modelo pode aprender erroneamente que "roupa vermelha" e "parede branca" fazem parte do estilo e falhar ao gerar corretamente em cenas diferentes. |
Equilíbrio | Proporções equilibradas entre tipos de dados. Se múltiplos estilos forem incluídos, a quantidade deve ser aproximadamente igual. | Proporções severamente desequilibradas. 90% são imagens de retrato e 10% são imagens de paisagem. O modelo pode ter um desempenho ruim ao gerar imagens de paisagem. |
Limpeza | Imagens limpas e claras. Use materiais originais sem distrações. | Contém elementos distrativos. Imagens contêm marcas d'água, bordas pretas óbvias ou ruído. O modelo pode aprender as marcas d'água como parte do estilo. |
Resolução | Resolução moderada. Recomendamos que a resolução da imagem de treinamento não exceda 2048×2048. Imagens excessivamente grandes aumentam o tempo de treinamento. | Resolução varia muito. Ter imagens pequenas de 256×256 e imagens grandes de 4096×4096 no conjunto de treinamento afeta a estabilidade do treinamento. |
Anotação de imagens: Escrevendo prompts para imagens
No arquivo de anotação do conjunto de dados (data.jsonl), cada imagem possui um prompt correspondente. O prompt descreve o conteúdo da imagem-alvo. A qualidade do prompt determina diretamente o que o modelo aprende.
Fórmula de escrita de prompt
Prompt = [Descrição do assunto] + [Descrição do fundo] + [Palavra-gatilho] + [Descrição do estilo]
Componente do prompt | Descrição | Recomendação | Exemplo |
|---|---|---|---|
Descrição do assunto | Descreve as pessoas ou objetos na imagem | Obrigatório | Uma jovem vestindo uma camisa longa vermelha de estilo chinês... |
Descrição do fundo | Descreve o ambiente onde o assunto está localizado | Obrigatório | O fundo é uma parede de tijolos coberta de videiras verdes... |
Palavra-gatilho | Uma palavra rara sem significado real | Recomendado | s86b5p ou m01aa |
Descrição do estilo | Descreve detalhadamente o estilo artístico e as características visuais da imagem-alvo | Recomendado | Renderizado em estilo de ilustração flat com linhas limpas e fluidas e cores planas vivas para enfatizar a tridimensionalidade e a estética de design moderno. |
Sobre palavras-gatilho
Sobre palavras-gatilho
- O que é uma palavra-gatilho? Ela serve como uma "âncora visual". Como muitos estilos visuais complexos (como uma textura de imagem única ou esquema de cores específico) são difíceis de descrever precisamente em texto, uma palavra-gatilho diz explicitamente ao modelo: quando você vir s86b5p, deve gerar este estilo visual específico.
- Por que usá-la? O ajuste fino do modelo estabelece mapeamentos entre "texto" e "características da imagem". A palavra-gatilho vincula um "estilo indescritível" a uma palavra única, permitindo que o modelo se fixe no alvo.
-
Se já temos uma palavra-gatilho, por que ainda descrever o estilo em detalhes?
Os dois servem a propósitos diferentes e funcionam melhor juntos.
- Descrição do estilo: Explica "como a imagem deve parecer". Ela informa ao modelo o estilo artístico básico e as características visuais. A descrição do estilo geralmente é consistente em várias amostras.
- Palavra-gatilho: Explica "como o estilo se parece especificamente". Ela representa características visuais únicas que não podem ser descritas com precisão em texto.
Avaliar modelos com conjuntos de validação
Especificar o conjunto de validação
Um job de ajuste fino deve incluir um conjunto de treinamento, enquanto o conjunto de validação é opcional. Você pode optar por deixar o sistema fazer a divisão automática ou carregar manualmente um conjunto de validação. Os métodos específicos são os seguintes:
Método 1: Nenhum conjunto de validação carregado (divisão automática pelo sistema)
Ao utilizar a API de ajuste fino de modelos de geração de vídeo e imagem, se nenhum conjunto de validação for carregado separadamente (ou seja, o parâmetrovalidation_file_ids não for fornecido), o sistema divide um conjunto de validação a partir do conjunto de treinamento com base no split, cujo padrão é 0,9. Isso significa que 90% é usado para treinamento e 10% para validação.
Método 2: Carregar manualmente um conjunto de validação (especificado via validation_file_ids)
Se você quiser usar seus próprios dados preparados para avaliar checkpoints em vez de depender da divisão aleatória do sistema, carregue um conjunto de validação personalizado. Nota: Uma vez que você opte por carregar manualmente, o sistema ignora completamente as regras de divisão automática acima e usa apenas os dados que você carregou para validação.Procedimento: Carregar manualmente um conjunto de validação
Procedimento: Carregar manualmente um conjunto de validação
- Prepare o conjunto de validação: Compacte os dados de validação em um arquivo
.zipseparado. Consulte Formato do conjunto de validação. - Carregue o conjunto de validação: Chame a API de Ajuste fino de modelos de geração de vídeo e imagem para carregar este arquivo
.zipdo conjunto de validação e obtenha um ID de arquivo dedicado. - Especifique o conjunto de validação ao criar o job: Ao chamar a API de Ajuste fino de modelos de geração de vídeo e imagem, preencha este ID de arquivo no parâmetro
validation_file_ids.
Selecionar o melhor checkpoint para implantação
Durante o treinamento, o sistema salva periodicamente "snapshots" do modelo (ou seja, checkpoints). Por padrão, o sistema produz o último checkpoint como o modelo final ajustado. No entanto, checkpoints produzidos em estágios intermediários podem ter um desempenho melhor do que a versão final. Selecione aquele que considerar mais satisfatório para implantação.
O sistema executa checkpoints no conjunto de validação e gera imagens de pré-visualização em intervalos definidos pelos Hiperparâmetros (hyper_parameters) eval_steps.
- Como avaliar: Julgue os resultados observando diretamente as imagens de pré-visualização geradas.
- Critérios de seleção: Encontre o checkpoint com os melhores resultados e o estilo mais próximo do desejado.
Procedimento
Etapa 1: Visualizar resultados de pré-visualização gerados pelos checkpoints
Etapa 1: Visualizar resultados de pré-visualização gerados pelos checkpoints
Etapa 1.1: Consultar a lista de checkpoints validados
Esta API retorna apenas checkpoints que passaram na validação e geraram imagens de pré-visualização com sucesso. Checkpoints que falharam na validação não são listados.Exemplo de solicitação<replace_with_fine_tuning_job_id>: Substitua inteiramente pelo parâmetro de saídajob_idda API de ajuste fino de modelos de geração de vídeo e imagem.
Etapa 1.2: Consultar os resultados do conjunto de validação para um checkpoint
Selecione um checkpoint da lista retornada na etapa anterior (por exemplo, "checkpoint-160") e visualize os resultados das imagens geradas.Exemplo de solicitação<replace_with_fine_tuning_job_id>: Substitua inteiramente pelo valor dejob_idda saída de Criar um job de ajuste fino.<replace_with_checkpoint_to_export>: Substitua inteiramente pelo valor do checkpoint, por exemplo "checkpoint-160".
img_path e é válida por 24 horas. Baixe as imagens prontamente para revisar os resultados. Repita esta etapa para comparar os resultados de múltiplos checkpoints e encontrar o mais satisfatório.Etapa 2: Exportar o checkpoint e obter o nome do modelo para implantação
Etapa 2: Exportar o checkpoint e obter o nome do modelo para implantação
Etapa 2.1: Exportar o modelo
Assumindo que "checkpoint-160" tenha os melhores resultados, o próximo passo é exportá-lo.Exemplo de solicitação<replace_with_fine_tuning_job_id>: Substitua inteiramente pelo valor dejob_idda saída de Criar um job de ajuste fino.<replace_with_checkpoint_to_export>: Substitua inteiramente pelo valor do checkpoint, por exemplo "checkpoint-160".<replace_with_exported_model_display_name>: Substitua inteiramente por um nome de modelo personalizado usado apenas para exibição no console, por exemplo "wan2.5-checkpoint-160". Este nome deve ser globalmente único. Não é suportada a exportação com nomes duplicados. Para detalhes dos parâmetros, consulte 3. Exportar um checkpoint.
output=true indica que a solicitação de exportação foi criada com sucesso.Etapa 2.2: Consultar o novo nome do modelo para implantação
Consulte o status de todos os checkpoints, confirme que a exportação foi concluída e obtenha o novo nome de modelo dedicado (model_name) para implantação.Exemplo de solicitação<replace_with_fine_tuning_job_id>: Substitua inteiramente pelo valor dejob_idda saída de Criar um job de ajuste fino.
status mudar para SUCCEEDED, a exportação foi bem-sucedida. O campo model_name retornado neste momento é o novo nome do modelo após a exportação.Etapa 3: Implantar e invocar o modelo
Etapa 3: Implantar e invocar o modelo
- Implantação do modelo: Preencha o parâmetro de entrada
model_namecom o valor específico obtido após a exportação. - Invocação do modelo: Siga a documentação da API para invocar o modelo implantado.
Faturamento
-
Treinamento do modelo: Cobrado.
- Custo = Total de tokens de treinamento × Preço unitário. Consulte Preços de treinamento e implantação.
- Após a conclusão do treinamento, verifique o número total de tokens consumidos durante o treinamento no campo
usageda API Recuperar um job de ajuste fino.
generation_type
Resolução da Imagem
Contagem Comum de Etapas
Consumo Estimado de Tokens
Custo Estimado
t2i (texto-para-imagem)
1K
500
6.400.000
$96
1.000
12.800.000
$192
2.000
25.600.000
$384
2K
500
11.610.000
$174,15
1.000
23.220.000
$348,3
2.000
46.440.000
$696,6
i2i (imagem-para-imagem)
1K
500
11.610.000
$174,15
1.000
23.220.000
$348,3
2.000
46.440.000
$696,6
2K
500
16.000.000
$240
1.000
32.000.000
$480
2.000
64.000.000
$960
-
Implantação e invocação do modelo: A implantação é gratuita. As invocações são cobradas à taxa padrão do modelo base ajustado.
ID do Modelo
Preço de Implantação e Invocação LoRA
wan2.7-image-pro
$0,075/imagem
wan2.7-image
$0,03/imagem
Referência da API
API de ajuste fino de modelos de geração de vídeo e imagem
FAQ
P: Como projetar uma boa palavra-gatilho?
R: As regras são as seguintes:
- Recomendamos usar combinações raras de caracteres sem significado semântico real, como s86b5p, m01aa ou EVEAven638123. Garanta que não haja significado semântico no vocabulário do modelo base.
- Evite usar palavras comuns em inglês (como beautiful, fire ou dance), pois isso poluiria o entendimento original do modelo sobre essas palavras.