

As APIs do Model Studio limitam o volume de requisições, o uso de tokens e a taxa de crescimento. Aplique estas estratégias para maximizar o throughput e manter a disponibilidade.
- Soluções de configuração da plataforma (alterações mínimas de código): Enfileiramento no servidor, Aumento dos limites de cota, PTU e Batch API.
- Estratégias de controle de tráfego no cliente (alterações no código do cliente): Quatro estratégias com complexidade de engenharia crescente, desde nova tentativa básica até controle de congestionamento adaptativo.
- Soluções de fallback arquitetônico (alterações na arquitetura do sistema): Fallback de modelo e Deslocamento de pico de carga usando filas de mensagens (MQ).
429 agora, acesse Diagnóstico de erros e recomendações de estratégia para identificar a causa. Para erros de pico de tráfego, tente primeiro o enfileiramento no servidor — ele requer apenas um cabeçalho de requisição.
Mecanismo de limitação de taxa da plataforma
A plataforma aplica limites de taxa a cada modelo independentemente no nível da conta raiz. Após o acionamento, o serviço geralmente é retomado em até um minuto. Para condições de limitação de taxa e uso atual por modelo, consulte Limitação de taxa e Monitoramento de modelos. Três tipos de regras de limitação se aplicam:
- Limites de cota por minuto (RPM / TPM): Número máximo de requisições por minuto (RPM) e uso máximo de tokens por minuto (TPM).
- Limites de frequência instantânea (RPS / TPS): Máximo de requisições por segundo (RPS) e máximo de uso de tokens por segundo (TPS). Chamadas densas à API ou consumo de tokens dentro de um único segundo podem acionar a limitação de taxa.
- Limites de taxa de crescimento (Pico de Tráfego): Um aumento repentino no volume de requisições ou no uso de tokens aciona a limitação de taxa. O limiar se ajusta dinamicamente. Aumente as requisições gradualmente para evitar o acionamento desse limite.
Diagnóstico de erros e recomendações de estratégia
O mesmo código de erro pode ser acionado por diferentes dimensões de limitação de taxa. Alta concorrência também pode saturar o servidor e causar tempos limite. A estratégia de controle de congestionamento adaptativo ajuda a mitigar esse problema.
Código de erro (DashScope / OpenAI) | Dimensão de acionamento | Diagnóstico de características | Estratégia recomendada |
|---|---|---|---|
Throttling.RateQuota / limit_requests | Taxa de requisições excedida | Erros intermitentes. A taxa de sucesso diminui ao longo do tempo. | Token bucket: Controle a cota de requisições por unidade de tempo. |
Taxa de requisições excedida | Erros concentrados na inicialização ou durante picos de concorrência. | Semáforo de concorrência ou limitador de taxa com suavização: Aumente o intervalo entre requisições. | |
Throttling.AllocationQuota / insufficient_quota | Uso de tokens excedido | Erros intermitentes ao processar textos longos. | Token bucket duplo: Limite as cotas de RPM e TPM simultaneamente. |
Uso de tokens excedido | Consumo instantâneo de tokens muito alto durante o processamento concorrente de textos longos. | Semáforo de concorrência ou limitador de taxa com suavização. | |
Throttling.BurstRate / limit_burst_rate | Taxa de crescimento de tráfego excedida | Grande volume repentino de requisições após a inicialização ou recuperação de um estado ocioso. | Tente primeiro o enfileiramento no servidor. Alternativamente, use um token bucket com valor inicial baixo, como |
Soluções de configuração da plataforma
Estas soluções dependem das capacidades da plataforma e exigem alterações mínimas ou nulas no código do cliente.
Enfileiramento no servidor (recomendado)
Para limitação de taxa por pico de tráfego, o Model Studio aceita um tempo máximo de espera no cabeçalho da requisição. O servidor enfileira e tenta novamente a requisição dentro desse período até que ela comece a ser processada ou o tempo limite da fila expire. Isso melhora significativamente as taxas de sucesso durante picos de tráfego em comparação com uma resposta 429 imediata.
X-DashScope-Wait-Timeout ao cabeçalho da requisição:
Campo do cabeçalho | Exemplo | Descrição |
|---|---|---|
X-DashScope-Wait-Timeout | 30 | Tempo máximo de espera em fila para requisições de pico, em segundos.
|
- Requisições sem streaming (stream: false): Tempo limite = tempo limite base original + valor de Wait-Timeout.
- Requisições com streaming (stream: true): Tempo limite > valor de Wait-Timeout. Requisições com streaming iniciam a contagem de tempo após o primeiro chunk, portanto, o tempo limite de resposta inicial precisa apenas exceder o tempo de enfileiramento.
Exemplo de código
Exemplo de código
Aumento dos limites de cota
Se a cota padrão for insuficiente, aumente a cota temporária de limite de taxa no console do Model Studio. As alterações entram em vigor imediatamente. Disponível nas regiões China (Pequim) e Singapura.
Cenários: Cota padrão de RPM/TPM insuficiente devido ao crescimento do negócio ou necessidade de aumento temporário de throughput para eventos de curta duração. Consulte Limites de taxa.
Configuração simples. Avalie esta opção antes de tentar estratégias no lado do cliente.
Unidade de throughput provisionada (PTU)
O serviço PTU fornece poder de computação dedicado e reservado. Ele evita contenção no pool de recursos públicos e é a solução preferida para requisitos de alto throughput em tempo real.
Use PTU quando seu negócio tiver requisitos de throughput determinísticos (como compromissos de SLA) ou quando desejar um throughput alto e estável sem controle de tráfego no lado do cliente.
PTUs são recursos reservados cobrados continuamente, mesmo quando não totalmente utilizados. Avalie as especificações necessárias com base na carga de pico real para evitar desperdício.
Processamento em lote assíncrono (Batch API)
Para tarefas sem requisitos rígidos de tempo real (limpeza de dados, análises em lote), use a Batch API para enviá-las para processamento em lote. As tarefas são executadas fora dos horários de pico, retornam resultados de forma assíncrona e não estão sujeitas aos limites de taxa online.
Indicado para tarefas offline que toleram tempos de retorno de horas a dias: anotação de dados, análise de logs, resumo em lote. Os custos da Batch API são tipicamente menores que os das chamadas de API em tempo real.
O tempo de retorno não é garantido. Não adequado para serviços que exigem respostas imediatas. Recupere os resultados via polling ou callback após o envio.
Estratégias de controle de tráfego no cliente
Quando as soluções da plataforma (como enfileiramento no servidor e aumentos de cota) não forem suficientes, adicione controle de tráfego no lado do cliente. O princípio central: distribuir requisições uniformemente dentro de uma janela de tempo para evitar picos. Após a inicialização do sistema ou um longo período ocioso, aumente a concorrência gradualmente.
Quatro estratégias em ordem crescente de complexidade. Cada uma inclui a anterior e adiciona novos elementos:
- Nova tentativa básica oferece apenas defesa passiva.
- Limitação de taxa de requisições adiciona enfileiramento ativo.
- Modelagem de tráfego introduz ainda controle no nível de token e envio suave.
- Controle de congestionamento adaptativo ajusta dinamicamente a taxa de envio com base em feedback em tempo real.
Comparação de desempenho de throughput de cada estratégia
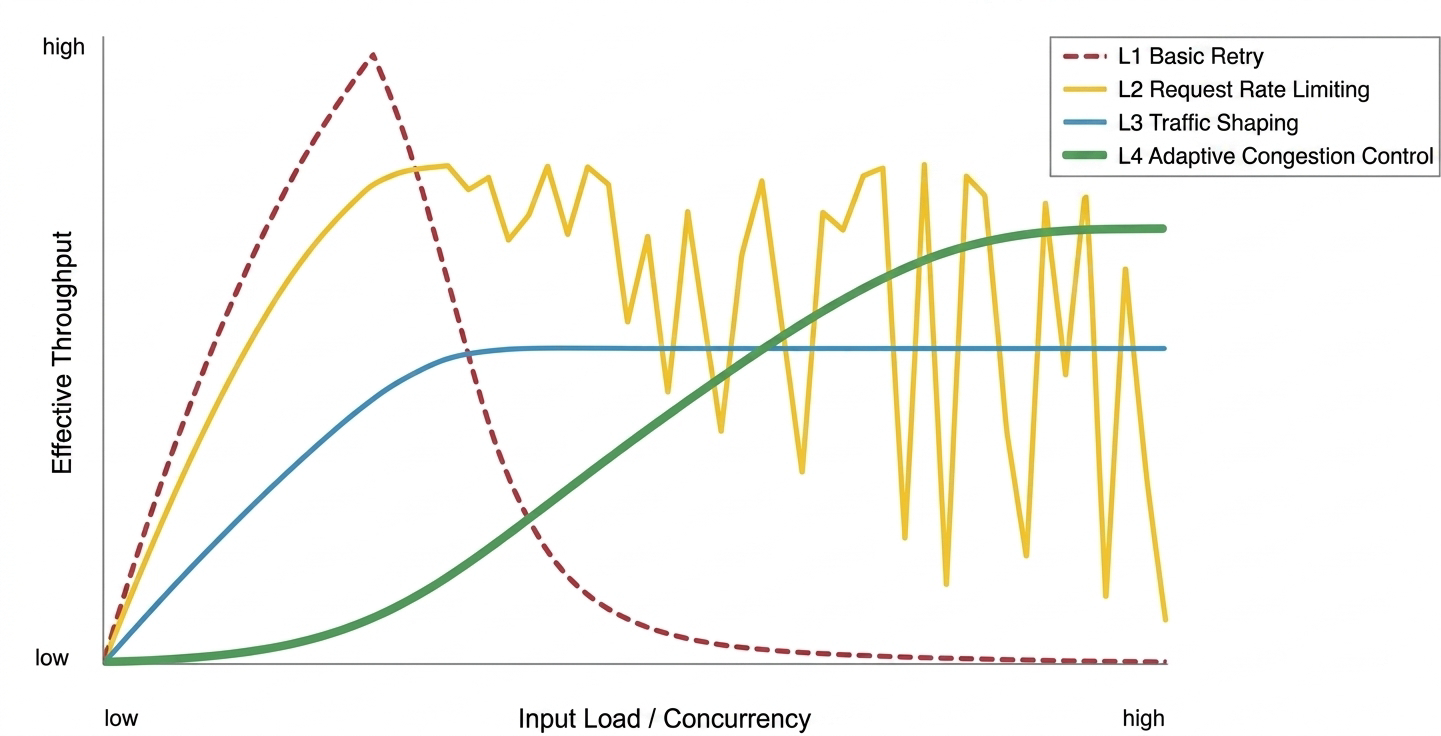
- Estratégia de nova tentativa básica: Eficaz sob baixa carga. Propensa a colapso congestivo sob alta concorrência, causando uma queda acentuada no throughput.
- Estratégia de limitação de taxa de requisições: Forte proteção contra colapso. No entanto, sob cargas mistas com textos longos, o throughput apresenta flutuações semelhantes a dentes de serra devido à falta de controle de tokens.
- Estratégia de modelagem de tráfego: Alta estabilidade. Alcança uma saída suave sacrificando parte do throughput de pico.
- Estratégia de controle de congestionamento adaptativo: Converge dinamicamente para um ponto de throughput alto e estável sob carga elevada, mas possui sobrecarga de sondagem na inicialização a frio.
Estratégia de nova tentativa básica
Adequada para testes pessoais, scripts locais e tarefas em segundo plano de baixa frequência. Sem limite de taxa nas requisições de saída. Aciona apenas nova tentativa com backoff exponencial e variação aleatória (jitter) em erros 429 ou 5xx.
Sem controle proativo de tráfego. Sob concorrência multithread, isso aciona facilmente a limitação de taxa e causa acúmulo de requisições.
Exemplo de código
Exemplo de código
- Tempo de espera dobra progressivamente: Por exemplo,
1s, 2s, 4s.... Isso evita requisições repetidas em um curto período. - Adição de variação aleatória: Um valor aleatório (como
2s +/- 0.5s) espalha o tráfego de novas tentativas, prevenindo uma inundação secundária (efeito manada).
Estratégia de limitação de taxa de requisições
Novas tentativas passivas sozinhas não conseguem lidar com tráfego real. Tentativas frequentes aumentam a latência. Esta estratégia introduz controle ativo de tráfego: verifique e limite as requisições antes de enviá-las, organizando o tráfego desordenado em uma fila que respeita o limite de RPM. A suavização ativa adiciona um pequeno atraso de enfileiramento previsível — muito menor que o custo de um ciclo de "erro — espera — nova tentativa". Um pequeno custo conhecido é melhor que um grande custo desconhecido.
Ideal para chatbots e outros serviços leves de requisição-resposta sensíveis ao tempo até o primeiro token.
O enfileiramento ativo no lado do cliente usa dois níveis de controle:
- Token bucket de RPM: Limita o total de requisições por minuto. A capacidade do bucket é igual à cota de RPM; os tokens são reabastecidos a uma taxa constante. Suporta empréstimo: se os tokens forem insuficientes, uma requisição toma emprestado da cota futura, estritamente em ordem FIFO.
- Semáforo de concorrência: Limita requisições concorrentes para evitar que alta concorrência instantânea acione limites de RPS.
initial_tokens=rpm_limit), adequado para serviços online que precisam processar requisições imediatamente na inicialização. Se um bucket cheio acionar limitação de taxa, reduza o valor inicial (por exemplo, initial_tokens=0 para uma "inicialização com bucket vazio") para aumentar a carga mais gradualmente.
Esta estratégia não rastreia o uso de tokens. Tarefas de texto longo ainda podem esgotar a cota de TPM.
Exemplo de código
Exemplo de código
Estratégia de modelagem de tráfego
Em cenários de lote que exigem throughput alto e estável (ingestão RAG em tempo real, análise em massa de documentos longos), a limitação de taxa de requisições tem um ponto cego de TPM. A modelagem de tráfego adiciona consciência dupla de recursos (RPM & TPM) e um mecanismo de modelagem que converte tráfego irregular em um fluxo suave.
Melhorias em relação à limitação de taxa de requisições:
- Controle duplo de recursos (RPM & TPM): Mantém buckets de tokens tanto para RPM quanto para TPM. Todas as requisições devem passar pelas verificações de cota de ambas as dimensões antes do envio.
- Pré-dedução para entrada, liquidação posterior para saída: O comprimento da saída é desconhecido antes da requisição. O bucket de TPM pré-deduz tokens de entrada no envio e liquida os tokens reais de saída após a conclusão. Mesmo que os tokens fiquem negativos, requisições subsequentes esperam até que a contagem se torne positiva, suavizando naturalmente o fluxo.
- Warm-up contínuo: Durante uma inicialização a frio, a taxa de emissão de tokens aumenta linearmente ao longo do tempo, eliminando o risco de picos iniciais.
- Limitador de taxa com suavização (Pacing): Suaviza a taxa de envio impondo um intervalo mínimo entre requisições (pacing), reduzindo o risco de acionar limites de taxa.
initial_tokens=0) para uma inicialização segura com menor complexidade. O token bucket Python aqui serve para demonstração. Em produção, use bibliotecas maduras de limitação de taxa, como SmoothRateLimiter do Guava em Java.
No exemplo de código, a espera de suavização é colocada dentro do bloqueio de concorrência. Múltiplas requisições podem competir pelo semáforo simultaneamente após o término de sua espera, reagrupando o tráfego na saída. A suavização dentro do bloqueio reduz ligeiramente a eficiência da concorrência, mas garante intervalos de envio precisos.
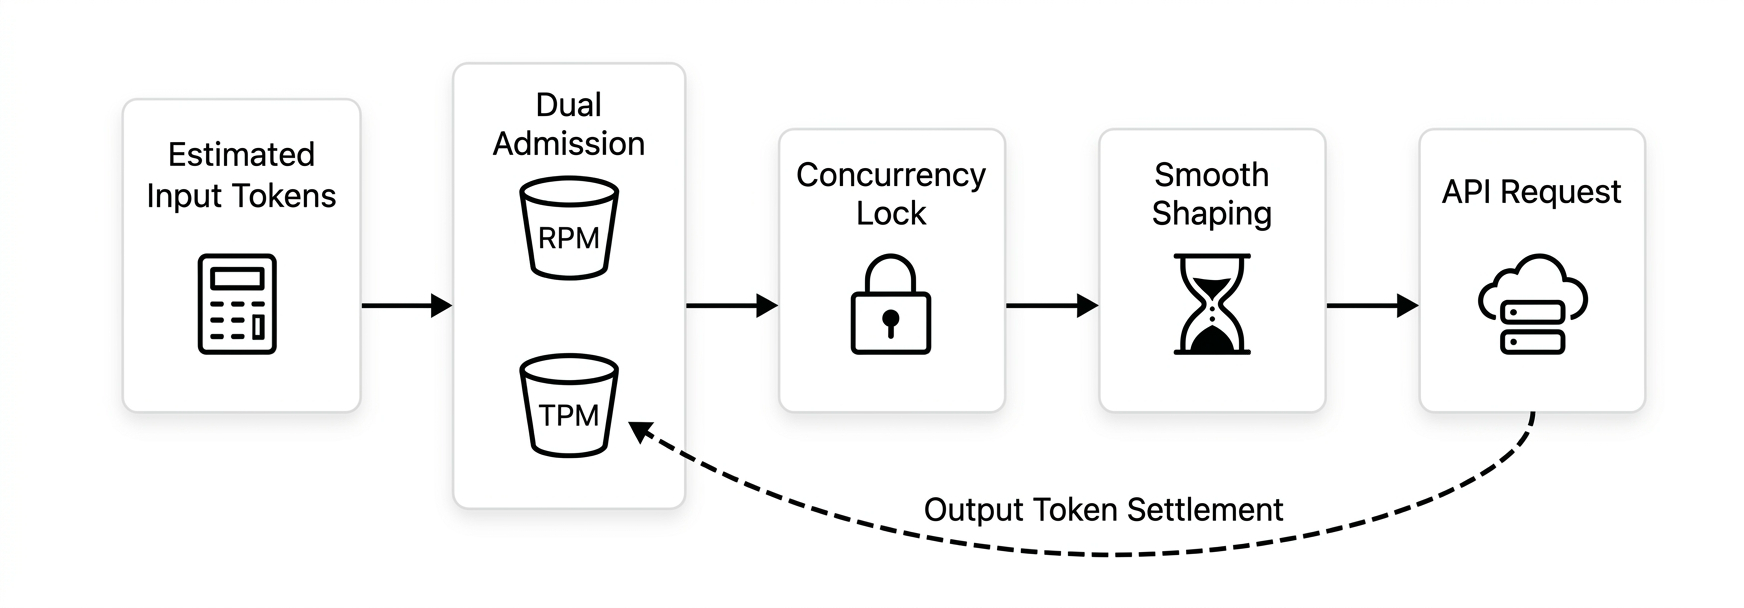
O pipeline completo de modelagem de tráfego é: Estimar tokens de entrada → Admissão dupla (RPM & TPM) → Bloqueio de concorrência → Modelagem de tráfego → Enviar → Liquidar tokens de saída.
Exemplo de código
Exemplo de código
Estratégia de controle de congestionamento adaptativo
Adequada para cargas de trabalho dinâmicas e de grande escala: gateways de API, proxies complexos, sistemas multilocatários.
- Paradoxo de desempenho: Se a carga for previsível (como processamento em lote), parâmetros estáticos ótimos superam a sondagem dinâmica que precisa de "tentativa e convergência".
- Sobrecarga de sondagem: Algoritmos dinâmicos envolvem inevitavelmente rampa de inicialização a frio e flutuações exploratórias — sobrecarga desnecessária em cenários conhecidos.
- Custo de manutenção: Feedback em malha fechada aumenta a complexidade do sistema e a dificuldade de solução de problemas.
- EBP: Armazena a marca d'água histórica de maior sucesso. Calcula o ganho de sondagem simulando a tensão de uma mola com base na distância da concorrência atual até a marca d'água (mais longe = mais rápido, mais perto = mais lento). Adiciona um pequeno impulso linear para continuar explorando mesmo em alta saturação.
- Consciência de congestionamento TPT: O tempo de geração de LLM escala com o comprimento da saída — alta latência em textos longos não significa congestionamento. TPT (Tempo Por Token) filtra o ruído de comprimento de conteúdo. O congestionamento só é declarado quando o TPT degrada significativamente.
- Governador de taxa anti-pico: Independentemente do alvo EBP, o governador limita a aceleração do crescimento da concorrência para garantir uma rampa suave e evitar mudanças abruptas que acionem limites de taxa de crescimento.
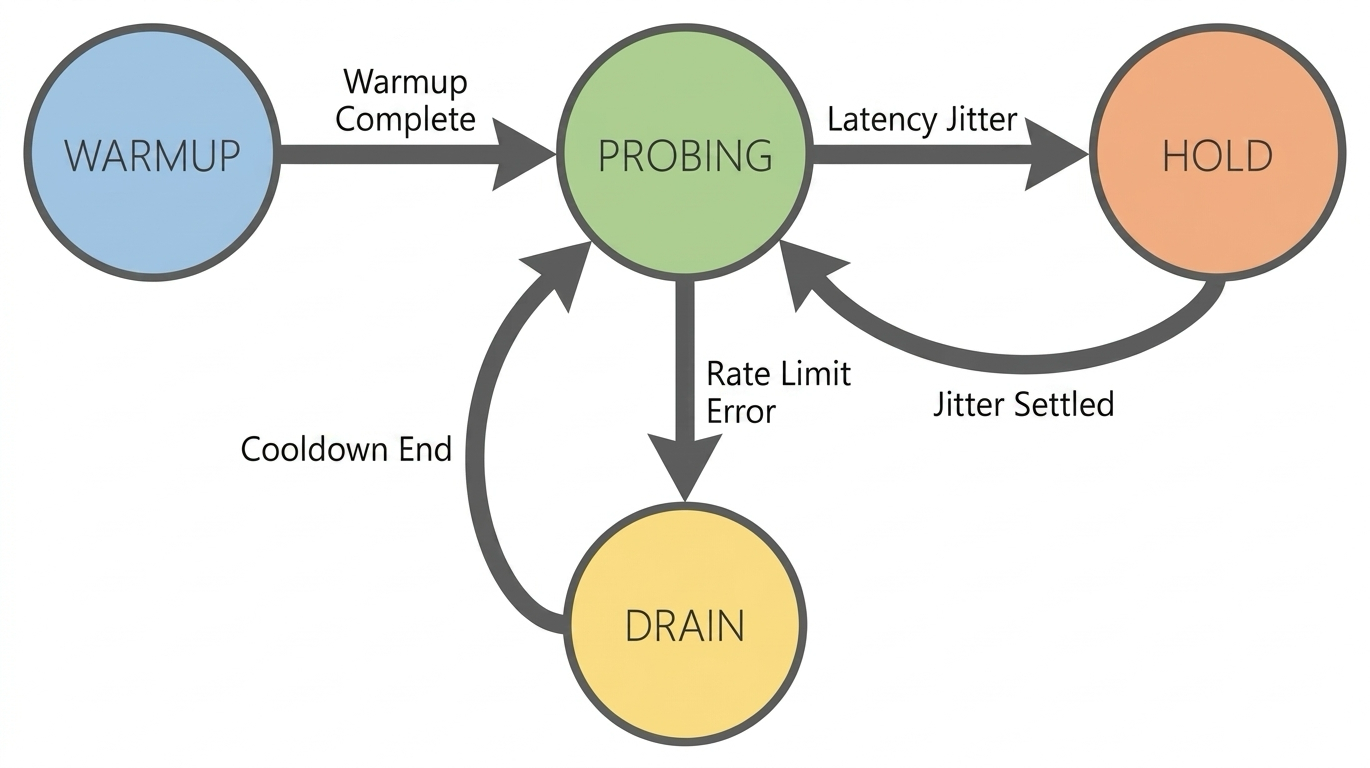
- Sondagem guiada: Introduz cotas conhecidas de RPM/TPM como um "limite superior orientador" para evitar colisões frequentes causadas por sondagem cega.
- Fonte de sinal (RTT → TPT): O BBR nativo usa RTT. Em cenários de LLM, a latência de comprimento de conteúdo ofusca o jitter de rede. O TPT elimina essa interferência.
- Aprimoramento do mecanismo de resposta (ProbeRTT → Hold): Diante de flutuações de latência, opta por manter o nível atual de concorrência em vez de recuar proativamente e reduzir o throughput.
- Resposta a limite rígido de taxa (Packet Loss → 429 Drain): Uma vez que um erro
429é acionado, entra em um estado agressivo de Drenagem e realiza uma recuperação rápida após um período de resfriamento.
- Ruído no TPT: O TPT é estimado como "latência total / total de tokens". A latência total inclui ida e volta de rede, enfileiramento e tempo até o primeiro token — suscetível a jitter ou entradas longas, o que pode acionar falsamente o estado Hold.
- Inanição de requisições grandes: Usa um despertar FIFO não estrito para desempenho de agendamento. Quando as cotas são escassas, requisições de poucos tokens podem preemptar recursos, fazendo com que requisições de muitos tokens esperem demais.
- Inicialização a frio: Requer um período de aquecimento para construir um modelo estatístico. Em tarefas de baixa carga ou curta duração, o throughput pode ser menor que nas três primeiras estratégias.
Exemplo de código
Exemplo de código
Soluções de fallback arquitetônico
Quando a configuração da plataforma e o controle de tráfego no cliente ainda não conseguem atender aos requisitos de disponibilidade ou throughput de pico, adicione mecanismos de fallback no nível da arquitetura.
Fallback de modelo
Quando o modelo primário não consegue responder devido a limitação de taxa ou problemas de serviço, faça fallback automaticamente para um modelo alternativo com cota mais generosa.
Princípios de design do caminho de fallback
- Escolha modelos de séries diferentes: A limitação de taxa é por modelo. Use um modelo diferente como fallback — por exemplo, faça fallback de
qwen3.6-plusparaqwen3.6-flash. - Acione o fallback apenas em erros de limite de taxa: Faça fallback em erros
429, não em todas as exceções. Trocar modelos não corrigirá tempos limite de rede ou erros de parâmetro. - Valide o modelo de fallback antecipadamente: Garanta que ele suporte os recursos necessários (Function Calling, saída estruturada, etc.) para evitar problemas funcionais após o fallback.
Exemplo de código
Exemplo de código
Deslocamento de pico de carga usando filas de mensagens (MQ)
Para serviços de backend que não exigem respostas imediatas, introduza um middleware de mensagens (RabbitMQ, Kafka) para deslocamento de pico de carga. O tráfego de pico vai primeiro para o MQ; os consumidores puxam e processam a uma taxa constante correspondente à cota de limite de taxa. Isso desacopla os picos de frontend das chamadas de backend.
Indicado para negócios onde os usuários aceitam resultados assíncronos: processamento de tickets, moderação de conteúdo, anotação de dados em lote.
Pontos-chave de design:
- Controle de taxa do consumidor: O lado do consumidor deve usar a estratégia de limitação de taxa de requisições ou modelagem de tráfego para consumir mensagens a uma taxa constante com base na cota de RPM/TPM, em vez de puxar mensagens sem limites.
- Tratamento de mensagens mortas: Mova mensagens que falham após múltiplas tentativas para uma fila de mensagens mortas e acione um alerta. Evite que tentativas infinitas bloqueiem o consumo.
- Propagação de contrapressão: Quando o backlog do MQ excede um limiar, propague a pressão para montante (por exemplo, retorne um status de enfileiramento) para evitar crescimento ilimitado da fila.
Considerações para ambiente de produção
Os exemplos de código usam um loop de thread única asyncio do Python para demonstrar algoritmos principais. Antes do uso em produção em larga escala, considere o seguinte.
-
Adaptação para modelos não textuais
As estratégias acima usam modelos de texto como exemplos, mas os princípios centrais aplicam-se a serviços multimodais (geração de imagens, síntese de fala). As unidades diferem, mas a essência é a mesma: limitar a taxa de envio e a capacidade de processamento.
- Modelos como reconhecimento de fala são tipicamente restringidos tanto pelo número de requisições por unidade de tempo (como RPM) quanto pelo uso (como duração do áudio). As estratégias são basicamente as mesmas para modelos de texto.
- Modelos para imagens e vídeos são tipicamente restringidos pela taxa de envio de tarefas e pelo número de tarefas concorrentes. Use a mesma abordagem da estratégia de limitação de taxa de requisições: limite a taxa de envio de tarefas e use um semáforo para controlar a concorrência.
-
Atomicidade em modelos concorrentes
Exemplo:
asynciousa agendamento cooperativo de thread única, então modificações de estado são inerentemente atômicas dentro de um único processo. Produção: Em ambientes multithread ou multiprocesso, garanta a segurança de concorrência do token bucket e da janela de estatísticas. Condições de corrida quebrarão o controle de tráfego. - Limitação de taxa distribuída Exemplo: Todos os componentes de controle de tráfego estão em memória. Produção: Em implantações de múltiplas instâncias, cada instância limita independentemente. O uso total pode exceder o limite. Use um contador centralizado (como Redis) para gerenciar o uso em todos os nós.
- Filas prioritárias e prevenção de inanição Exemplo: Sem diferenciação de prioridade. A estratégia de controle de congestionamento adaptativo usa despertar FIFO não estrito para desempenho de agendamento. Produção: Para requisições de alta/baixa prioridade, implemente uma fila prioritária ponderada para garantir largura de banda para tráfego de alta prioridade. Reserve uma cota mínima para filas de baixa prioridade para prevenir inanição.