

Para cenários de inferência que não exigem respostas em tempo real, a inferência em lote processa grandes volumes de solicitações de dados de forma assíncrona com 50% do custo da inferência em tempo real. Sua API compatível com OpenAI é ideal para jobs em lote, como avaliação de modelos e rotulagem de dados.
Como funciona
- Envie uma tarefa: faça upload de um arquivo JSONL contendo várias solicitações para criar uma tarefa de inferência em lote.
- Processamento assíncrono: o sistema processa as tarefas em uma fila em segundo plano. Monitore o progresso e o status da tarefa no console ou por meio da API.
- Baixe os resultados: após a conclusão da tarefa, o sistema gera um arquivo de resultados para as respostas bem-sucedidas e um arquivo de erros detalhando eventuais falhas.
Escopo
- China (Beijing)
- Singapore
-
Modelos de geração de texto
- Qwen-Max: qwen3.8-max, qwen3.7-max, qwen3-max
- Qwen-Plus: qwen3.7-plus, qwen3.6-plus, qwen3.5-plus, qwen-plus, qwen-plus-latest
- Qwen-Flash: qwen3.8-flash, qwen3.7-flash, qwen3.6-flash, qwen3.5-flash, qwen-flash
- Recommended models: qwen-long, qwen-long-latest
- Modelos de terceiros: deepseek-r1, deepseek-v3.2, deepseek-v3
-
Modelos multimodais
- Image and video understanding: qwen3.8-max, qwen3.8-flash, qwen3.7-plus, qwen3.6-plus, qwen3.7-flash, qwen3.6-flash, qwen3.5-plus, qwen3.5-flash, qwen3-vl-plus, qwen3-vl-flash
- Text extraction: qwen-vl-ocr, qwen-vl-ocr-latest
- Omni-modal: qwen3.5-omni-plus, qwen3.5-omni-flash
- Modelos de embedding de texto: text-embedding-v1, text-embedding-v2, text-embedding-v3, text-embedding-v4
- Singapore
- China (Beijing)
Uso de inferência em lote
Etapa 1: Preparar o arquivo de entrada
Antes de criar uma tarefa, prepare um arquivo JSONL que atenda aos seguintes requisitos:
- Formato: JSONL codificado em UTF-8 (um objeto JSON por linha).
-
Limites de escala: Até 50.000 solicitações por arquivo e tamanho máximo de 500 MB.
Se o seu conjunto de dados exceder esses limites, divida-o em vários arquivos e envie-os como tarefas separadas.
- Limite por linha: Cada objeto JSON pode ter até 1 MB e não deve exceder a janela de contexto do modelo.
- Consistência: Todas as solicitações dentro do mesmo arquivo devem usar o mesmo modelo .
-
Identificador exclusivo: Cada solicitação deve incluir um campo
custom_idexclusivo no arquivo para correspondência de resultados. O custom_id aceita no máximo 256 caracteres. Se esse limite for excedido, a validação da tarefa falhará. Para retornar um identificador mais longo, use um campo personalizado no parâmetrometadataao criar a tarefa. Para obter mais informações, consulte Use metadata to return custom identifiers. -
URLs de arquivos de mídia: Os arquivos de mídia referenciados no
bodyde uma solicitação multimodal por meio de campos comoimage_urlevideo_urldevem usar URLs publicamente acessíveis. Caminhos de arquivos locais (por exemplo,file:///home/user/test.mp4) e endereços de rede interna não são suportados. Uma tarefa que faça referência a tal endereço pode ser enviada com sucesso, mas nunca será processada até a conclusão. Faça upload do arquivo para um armazenamento publicamente acessível primeiro e, em seguida, referencie sua URL.
Parâmetro | Tipo | Obrigatório | Descrição |
|---|---|---|---|
| string | Sim | Identificador exclusivo da solicitação dentro do arquivo. |
| string | Sim | O método HTTP suportado é |
| string | Sim | Apenas o endpoint de solicitação |
| object | Sim | O corpo da solicitação tem o mesmo formato da API |
Arquivo de exemplo
Baixe o arquivo de exemplo test_model.jsonl. O conteúdo é o seguinte:
Instruções
- Leia o conteúdo em inglês para entender O QUE precisa ser comunicado
- Escreva o português brasileiro DO ZERO — esqueça a estrutura das frases em inglês
- Preserve toda a formatação markdown, blocos de código, links e imagens exatamente como estão
-
Copie os placeholders de xref (
{XREF_N}) literalmente, sem traduzir ou modificar - Aplique todas as regras específicas do idioma rigorosamente
- Aplique as regras de stopwords com tolerância zero
- Use o modo imperativo em passos numerados e listas de procedimentos
- Garanta a consistência terminológica — o mesmo termo deve ter a mesma tradução em todo o documento
- Varie os inícios de frase em listas e tabelas — nenhum início deve se repetir mais de 3 vezes
- Retorne APENAS o documento markdown em português brasileiro, sem explicações Ferramenta de geração em lote de JSONL Utilize esta ferramenta para gerar arquivos JSONL de forma rápida.
Configure o modo de pensamento na inferência em lote
Alguns modelos, como qwen3.7-plus, qwen3.7-max e as séries qwen3.6 e qwen3.5, possuem o modo de pensamento ativado por padrão, o que gera tokens de pensamento adicionais. Para configurar esse modo na inferência em lote, defina o parâmetro enable_thinking no mesmo nível do parâmetro model, dentro do body de cada requisição. O parâmetro opcional thinking_budget permite estabelecer um limite máximo para a quantidade de tokens de pensamento.
Exemplo: Desativar o modo de pensamento
Etapa 2: Criar uma tarefa de inferência em lote
- Na página Batches Batches, clique em Create Batch.
-
Na caixa de diálogo exibida, insira um Task Name e uma Task Description, defina o Maximum Waiting Time (de 1 a 14 dias) e faça o upload do seu arquivo JSONL.
Clique em Download Sample File para obter o modelo.
- Ao terminar, clique em Confirm.
Etapa 3: Monitorar e gerenciar tarefas
-
Visualizar:
- Na página da lista de tarefas, visualize o progresso da tarefa (requisições processadas/total de requisições) e o Status.
- Pesquise pelo nome ou ID da tarefa, ou filtre por workspace para localizar rapidamente uma tarefa específica.
-
Gerenciar:
- Cancelar: É possível cancelar tarefas no estado Executing na coluna Actions.
-
Solucionar problemas: Em caso de falha na tarefa, passe o mouse sobre o status para ver um resumo do erro ou baixe o arquivo de erros para mais detalhes.
Por exemplo, se houver mistura de modelos diferentes no arquivo em lote, a tarefa exibirá o status Failed com uma mensagem de erro como:
The model 'qwen-turbo' for this request does not match the rest of the batch. Each batch must contain requests for a single model.
Etapa 4: Baixar resultados
Quando a tarefa estiver concluída, clique em View Results para baixar o arquivo de saída:
- Arquivo de resultados: Registra todas as requisições bem-sucedidas e seus resultados de
response. - Arquivo de erros (se houver): Registra todas as requisições com falha e seus detalhes de
error.
custom_id, usado para corresponder aos dados de entrada originais, associar resultados ou localizar erros.
Etapa 5: Visualizar estatísticas de uso (opcional)
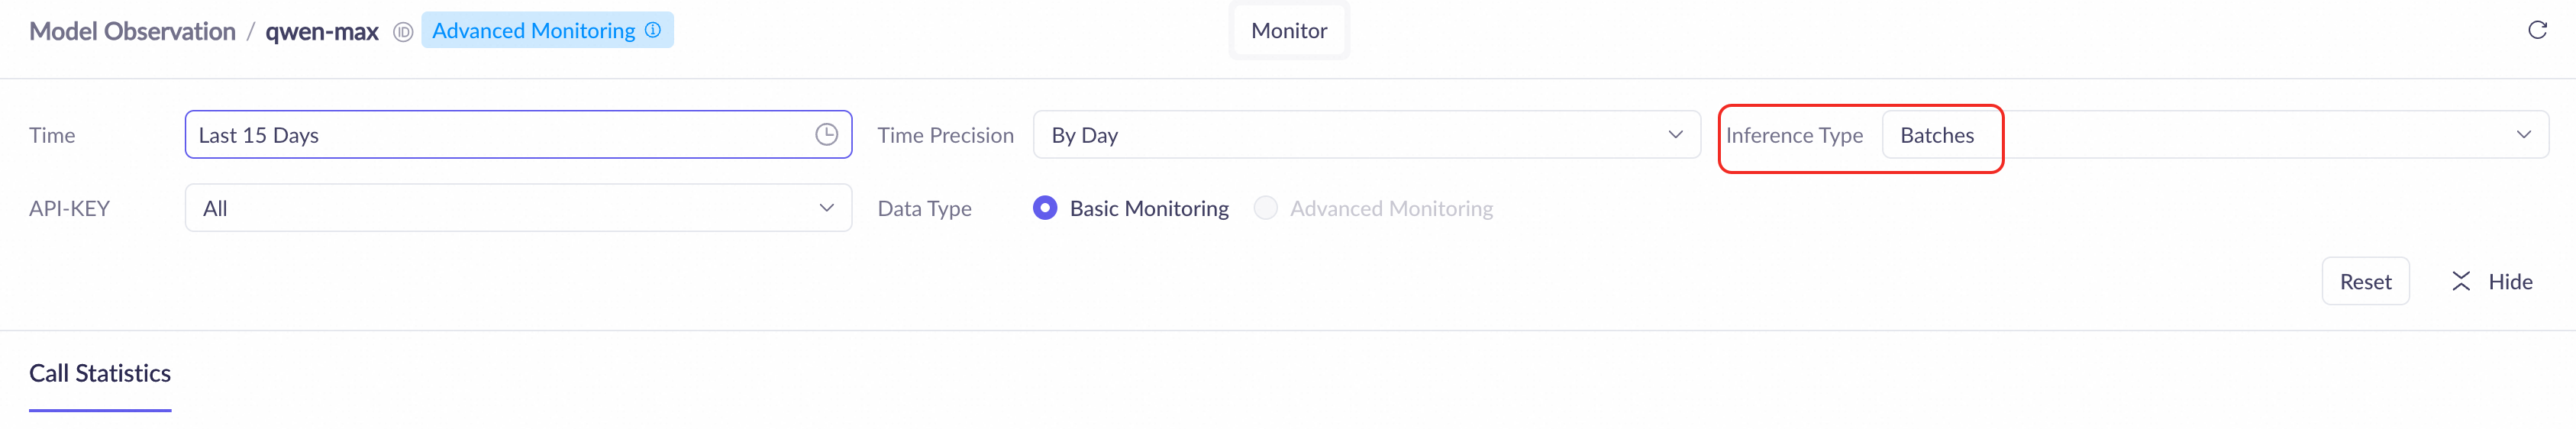
Na página Monitoring, filtre e visualize as estatísticas de uso da inferência em lote.
-
Visualizar visão geral dos dados: Selecione o período em View Details (até 30 dias), defina Select Time como Inference Type e visualize o seguinte:
- Dados de monitoramento: Estatísticas resumidas de todos os modelos no período selecionado, como o número total de chamadas e falhas.
- Lista de modelos: Dados detalhados de cada modelo, como total de chamadas, taxa de falhas e duração média das chamadas.
Para visualizar dados de inferência com mais de 30 dias, acesse a página Bills.
-
Visualizar detalhes do modelo: Na seção Batches, clique em Models na coluna Monitor do modelo desejado para visualizar as Actions, como o número de chamadas e o volume de chamadas.
Usar metadados para retornar identificadores personalizados
O campo custom_id suporta até 256 caracteres. Caso precise retornar um identificador mais longo no arquivo de resultados, utilize um campo personalizado em metadata.
Campos de metadados
O parâmetro metadata é opcional na criação de uma tarefa Batch e suporta os seguintes campos:
ds_name: Nome da tarefa. Este nome aparece na coluna Call Statistics no console.ds_description: Descrição da tarefa. Esta descrição aparece na coluna Task Name no console.- Campos personalizados: Além dos campos oficiais, o objeto
metadatatambém aceita quaisquer campos personalizados, cujos valores não estão limitados a 256 caracteres. Ao consultar os detalhes da tarefa, todos os campos personalizados são retornados integralmente.
Exemplo de código
O exemplo abaixo demonstra como usar um campo personalizado em metadata para transmitir um identificador com mais de 256 caracteres:
GET /v1/batches/{batch_id} para recuperar as informações completas de metadata, que incluem todos os campos personalizados e seu conteúdo completo.
Referência da API
Em ambientes de produção, utilize a API compatível com OpenAI para automatizar a criação e o gerenciamento de tarefas em lote. O fluxo de trabalho principal é o seguinte:
A inferência em lote suporta apenas chamadas de API compatíveis com OpenAI. Ao usar o OpenAI Python SDK, defina base_url como https://dashscope.aliyuncs.com/compatible-mode/v1. O DashScope Python SDK (pacote dashscope) não fornece interface de inferência em lote, portanto, não é possível enviar uma tarefa de inferência em lote por métodos como dashscope.BatchInference ou dashscope.Batches.
Exemplo:
-
Upload a file
Chame
POST /v1/filespara fazer o upload de um arquivo. Anote o ID do arquivo retornado. -
Para create a task, passe o ID do arquivo , chame
POST /v1/batchese anote obatch_idretornado. -
Poll status usando o
batch_idpara consultar periodicamenteGET /v1/batches/{batch_id}. Quando ostatusmudar paracompleted, anote ooutput_file_ide pare a consulta periódica. -
Para download the result file, use o
output_file_idpara chamarGET /v1/files/{output_file_id}/content.
Ciclo de vida da tarefa
Status | Descrição |
|---|---|
validating | O sistema está validando o formato do arquivo (especificação JSONL) e o formato da API de cada requisição. |
in_progress | O sistema validou o arquivo e iniciou o processamento das requisições de inferência. |
finalizing | Todas as requisições foram processadas e o sistema está gravando os resultados nos arquivos de saída. No console, esta etapa exibe o mesmo rótulo de status Task Description que |
completed | Os arquivos de resultado e de erro foram gerados e estão disponíveis para download. |
failed | A tarefa falhou durante a etapa de |
expired | O tempo de execução da tarefa excedeu o tempo máximo de espera definido na criação e foi encerrado pelo sistema. Ao criar uma nova tarefa, considere definir um tempo de espera maior. |
cancelled | A tarefa foi cancelada pelo usuário. Quaisquer requisições não processadas são encerradas. No console, este status é exibido como Executing. |
Faturamento
- Preços: Para todas as requisições bem-sucedidas, tanto os tokens de entrada quanto os de saída têm preço de 50% do valor da inferência em tempo real para o modelo correspondente. Para mais detalhes, consulte Models and Pricing.
-
Escopo de faturamento:
- A cobrança ocorre apenas para requisições executadas com sucesso dentro de uma tarefa.
- Falhas na análise de arquivos, falhas na execução da tarefa ou erros de requisição no nível da linha não geram cobranças.
- Para tarefas canceladas, quaisquer requisições concluídas com sucesso antes do cancelamento são cobradas normalmente.
- A inferência em lote é um item faturável separado e suporta o AI Universal Savings Plan. No entanto, não é elegível para outras promoções, como planos pré-pagos (Savings Plans) e new user free quotas, nem para recursos como context caching.
- Alguns modelos, como qwen3.7-plus, qwen3.7-max e as séries qwen3.6 e qwen3.5, possuem o modo de pensamento ativado por padrão. Isso gera tokens de pensamento adicionais, cobrados pelo preço de tokens de saída, aumentando assim os custos. Para controlar os gastos, defina o parâmetro
enable_thinkingde acordo com a complexidade da tarefa. Para mais detalhes, consulte Deep Thinking.
Perguntas frequentes
- Preciso comprar ou ativar algo extra para usar a inferência em lote? Não. O recurso fica disponível após a ativação do Model Studio. As cobranças ocorrem na base de pagamento conforme o uso e são deduzidas do saldo da sua conta.
-
Por que minha tarefa falhou imediatamente após o envio (o status mudou parafailed)?
Isso geralmente indica um erro no nível do arquivo, e nenhuma requisição de inferência foi executada. Verifique os itens a seguir nesta ordem:
- Formato do arquivo: Confirme se o arquivo usa o formato JSONL estrito, com um objeto JSON completo por linha.
- Escala do arquivo: Garanta que o tamanho do arquivo e o número de linhas não excedam os limites. Para mais detalhes, consulte Step 1: Prepare the input file.
- Consistência do modelo: Verifique se o campo
body.modelé idêntico para todas as requisições no arquivo e se o modelo utilizado é suportado na região atual.
- Quanto tempo leva para processar uma tarefa? O tempo de processamento depende da carga do sistema no momento do envio da tarefa. Durante períodos de alta demanda, as tarefas podem entrar em fila. No entanto, um resultado (sucesso ou falha) é sempre retornado dentro do tempo máximo de espera especificado.