

Este tópico mostra como implantar um modelo Qwen no Alibaba Cloud Model Studio por meio de chamadas de API.
Pré-requisitos
- Você já leu a Visão geral da implantação de modelos e está familiarizado com os modelos suportados e as etapas básicas de implantação.
- Obtenha uma chave de API e exporte a chave de API como uma variável de ambiente.
1. Implante o modelo
O comando a seguir usa o modelo personalizado ajustado qwen3-8b-ft-202511132025-0260 para criar um serviço dedicado chamado qwen3-8b-ft-202511132025-0260.
Para obter o ID do modelo personalizado, acesse a página Console do Model Studio - ajuste fino de modelos. Clique no Task Name do modelo que deseja implantar, clique em Outputs e, em seguida, clique no nome azul do modelo. Isso abre a página My Models, na qual é possível encontrar o Model ID na seção de informações básicas.
Use o Model ID como entrada para o parâmetro model_name para implantar o modelo por meio da API.
- Throughput provisionado (PTU)
- Unidade de modelo
- Uso de tokens
- CLI dashscope
deployed_model é o ID exclusivo do serviço dedicado.
2. Consulte o status do serviço
Execute o comando a seguir para consultar os detalhes de um serviço dedicado específico:
RUNNING, a implantação do serviço estará concluída.
3. Faça requisições de inferência
model deve ser definido como o code do modelo retornado após a implantação bem-sucedida. Obtenha-o no console de Dedicated Deployment.
Alinhamento de parâmetros de inferência
Os valores padrão dos parâmetros do motor de inferência do Model Studio podem ser diferentes dos do seu framework de inferência local. Para alinhar-se aos valores padrão do vLLM, consulte a tabela abaixo ao chamar a API; se você usar SGLang ou outros frameworks, consulte a documentação correspondente.
Nome do parâmetro | Valor recomendado (corresponde aos valores padrão do vLLM) |
|---|---|
temperature | Intervalo: [0, 2). Defina como 1.0 para corresponder ao valor padrão do vLLM. |
top_p | Intervalo: (0, 1.0]. Defina como 1.0 para corresponder ao valor padrão do vLLM. |
top_k | Defina como None ou um valor maior que 100 para desativar a amostragem top_k (apenas top_p se aplica). Definir como 99 aproxima o valor padrão 0 do vLLM (amostragem completa). |
presence_penalty | Intervalo: [-2.0, 2.0]. Defina como 0 para corresponder ao valor padrão do vLLM. |
repetition_penalty (protocolo DashScope) | Aumentar repetition_penalty reduz a repetição no texto gerado. Um valor de 1.0 significa ausência de penalização. Intervalo: maior que 0. Defina como 1.0 para corresponder ao valor padrão do vLLM. |
4. Exclua o serviço dedicado
Caso não precise mais de um serviço dedicado, você pode excluí-lo usando o comando a seguir:
Solução de problemas de permissões
Se você encontrar erros de permissão durante a implantação do modelo, há dois caminhos de solução de problemas, dependendo do método de implantação:
Implantação pelo console
- Se for exibida a mensagem "Permissão ausente para este módulo", certifique-se de que sua conta tenha a permissão Model Deployment - Operation na página de gerenciamento de permissões do espaço de negócios. Se você não conseguir operar normalmente, entre em contato com a organização ou com o administrador de TI para adicionar as permissões relevantes ou verificar os problemas de permissão em seu nome.
-
Se o erro "o espaço de negócios xx não tem permissão para implantar o modelo xx" for relatado durante a implantação, acesse a página Gerenciamento de espaço de negócios do Model Studio para adicionar a permissão de implantação do modelo correspondente ao espaço de negócios correspondente.
Erro de chamada de API:
Workspace xxx does not have deployment privilege for model xxxx.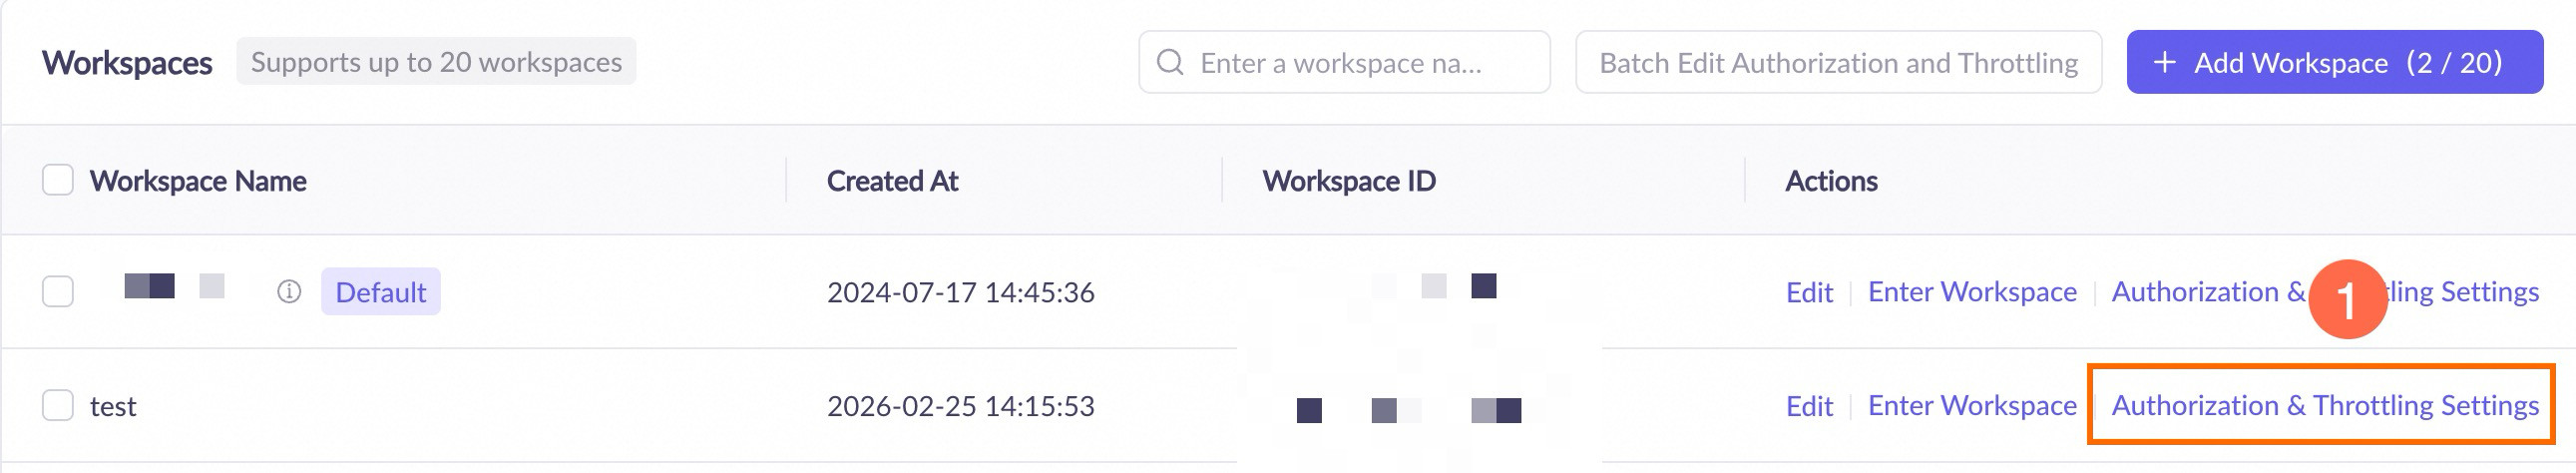 Se for solicitado que as permissões são insuficientes, entre em contato com a organização ou com o administrador de TI para adicionar as permissões relevantes ou realizar a operação em seu nome.
Implantação por API
Ao implantar um modelo usando uma API, certifique-se do seguinte:
-
O Workspace da chave de API deve ter permissão para gerenciar o modelo. Acesse a página Gerenciamento de espaço de negócios no Model Studio e verifique as configurações de permissão de implantação do modelo para o workspace correspondente.
Erro de chamada de API:
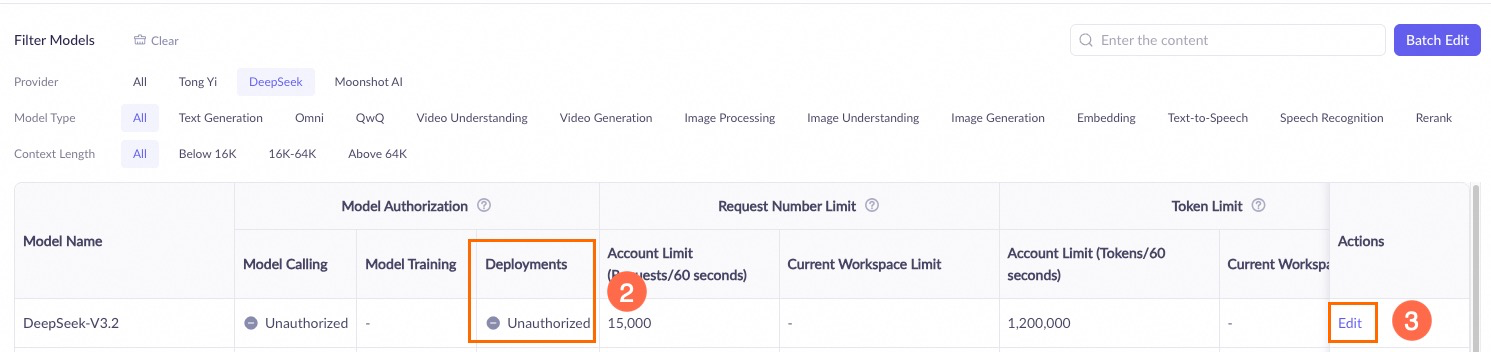
Na coluna Actions do workspace correspondente, clique em Model Permission and Flow Control Settings. Na Model List, localize o modelo de destino e verifique o status de autorização na coluna Model Deployment. Se aparecer Not Authorized, clique em Edit na coluna Actions para conceder a permissão. Se for solicitado que as permissões são insuficientes, entre em contato com a organização ou com o administrador de TI para adicionar as permissões relevantes ou realizar a operação em seu nome.Workspace xxx does not have deployment privilege for model xxxx. -
A Owner Account proprietária da chave de API precisa ter as permissões necessárias no Workspace. Acesse o console do Model Studio, clique no workspace no canto inferior esquerdo, alterne para o workspace correto e clique em
 para verificar as configurações de permissão de implantação do modelo.
Erro de chamada de API:
No painel de navegação à esquerda, clique em Permission Management e confirme se a lista de usuários inclui a conta proprietária da chave de API (com o tipo primary account). Se for solicitado que as permissões são insuficientes, entre em contato com a organização ou com o administrador de TI para adicionar as permissões relevantes ou realizar a operação em seu nome.Workspace access denied.