

A reserva de TPM garante uma capacidade de inferência dedicada para um modelo específico, assegurando que seus services não sejam afetados pelos limites de taxa do pool público durante os horários de pico. Este tópico descreve como criar, integrar e gerenciar reservas de TPM.
Visão geral
Com uma reserva de TPM (Tokens Por Minuto), você bloqueia um throughput de inferência dedicado para um modelo determinado. As chamadas dentro da capacidade reservada não estão sujeitas aos limites de taxa do pool de recursos público.
- Garantia de capacidade: A capacidade de TPM reservada é exclusiva para sua carga de trabalho e não é compartilhada com outros usuários.
- Código de modelo dedicado: Após criar uma reserva de TPM, o sistema gera automaticamente um código de modelo dedicado. Substitua o parâmetro
modelnas suas requisições de API por este código. - Estratégia de overflow: Ao criar uma reserva, escolha como lidar com o tráfego excedente — redirecionamento automático para pagamento conforme o uso (padrão, sem interrupção do service) ou uso exclusivo da capacidade reservada (requisições excedentes retornam 429, sem custos adicionais).
Compare e selecione um plano
O Model Studio oferece diversos planos de capacidade e faturamento para chamadas de inferência, incluindo pagamento conforme o uso, planos de recursos e planos de economia, reservas de TPM e implantações dedicadas PTU. Cada plano possui características distintas quanto à unidade de faturamento, nível de garantia de capacidade, tratamento de overflow e alterações de integração. Esta seção ajuda você a escolher o plano adequado com base nas necessidades do seu negócio.
Plano | Unidade de faturamento | Garantia de capacidade | Casos de uso | Tratamento de overflow | Alterações de código |
|---|---|---|---|---|---|
Pagamento conforme o uso | Por token | Nenhuma (pool público compartilhado) | Tráfego altamente variável/de curto prazo | Atendido automaticamente, sujeito aos limites de taxa públicos | Nenhuma alteração necessária |
Plano de recursos/Plano de economia | Cota pré-paga | Desconto por uso comprometido (não é capacidade dedicada) | Otimização de custos | Tráfego excedente muda para pagamento conforme o uso | Nenhuma alteração necessária |
Reserva de TPM | Pré-pago por kTPM | Capacidade dedicada com garantia firme | Tráfego previsível, sem tolerância a limitação de taxa | Opcional: overflow automático para pagamento conforme o uso (padrão) / apenas capacidade reservada retorna 429 | Substituir o parâmetro model |
PTU (Model deployment) | Pré-pago por kTPM | Instância de implantação dedicada | Alto throughput e alto desempenho | Opcional: overflow automático para pagamento conforme o uso (padrão) / apenas capacidade PTU retorna 429 | Substituir o parâmetro model |
Modelos suportados
Os preços estão sujeitos ao console; as tabelas servem apenas como referência.
- China (Beijing)
- Singapore
Nome do modelo | Pré-pago - diário | |
|---|---|---|
Entrada (por 10.000 TPM) | Saída (por 1.000 TPM) | |
Qwen3.8-Max | $16,63 | $4,99 |
Qwen3.7-Flash-2026-07-15 Entre em contato com seu gerente de conta para ativar | $0,28 | $0,11 |
Qwen3.7-Max-2026-05-20 | $16,63 | $4,99 |
Qwen3.7-Plus-2026-05-26 | $2,77 | $1,11 |
Qwen3.6-Flash-2026-04-16 | $1,66 | $1,00 |
GLM-5.2 | $11,09 | $3,88 |
GLM-5.1 | $8,32 | $3,33 |
DeepSeek-v4-Pro-0813 | $12,82 | $3,85 |
DeepSeek-v4-Flash | $1,39 | $0,28 |
DeepSeek-v4-Pro | $16,63 | $3,33 |
DeepSeek-v4-Flash-0731 | $4,27 | $1,28 |
Kimi-K2.6 | $9,01 | $3,74 |
Notas de faturamento e uso
- O faturamento inicia assim que a implantação for bem-sucedida. Chamadas dentro da capacidade reservada não geram cobranças adicionais.
- As taxas pré-pagas são quitadas em um pagamento único antecipado e permanecem válidas a partir do momento da compra. Consulte o console Bailian para verificar as cobranças reais.
- O ciclo de faturamento "diário" é calculado por dia natural: do momento em que a instância entra em vigor até às 00:00:00 do dia seguinte, em vez de 24 horas contínuas a partir da hora da compra. Por exemplo, uma reserva de 1 dia comprada às 16:00 expira à meia-noite (válida por cerca de 8 horas). Recomendamos comprar no início do dia ou ativar a opção Auto-renewal on expiry para evitar interrupção do service.
-
Reembolso por downgrade e cancelamento de assinatura: a parte utilizada é liquidada com um coeficiente de 1,2x. Fórmula:
Refund = prepaid fee of the reduced portion - (prepaid fee of the reduced portion × used duration / purchased duration × 1.2) - Quando a política de overflow é "Overflow automático": requisições que excedem a cota garantida degradam automaticamente para o faturamento padrão de pagamento conforme o uso, sem interrupção do service. Visualize a contagem de degradações na página de detalhes em Overflow degradation statistics. Quando definido como "Apenas capacidade reservada": requisições acima da cota retornam 429 e não geram cobranças adicionais.
- Até 2 horas após a expiração do service: a instância continua em execução, pode ser chamada e renovada; entre 2 e 14 horas após a expiração: a instância é parada, não pode ser chamada, mas ainda pode ser renovada; após 14 horas da expiração: a instância é excluída e não pode ser recuperada.
Clique aqui para visualizar os parâmetros de conversão de capacidade para cada modelo
Clique aqui para visualizar os parâmetros de conversão de capacidade para cada modelo
Modelo | Comprimento máximo de entrada | Desconto de cache | Coeficiente de faixa para entrada longa |
|---|---|---|---|
Qwen3.8-max | 1 Milhão | 0,125 | Sem faixas (1,0) |
Qwen3.6-flash-2026-04-16 | 256K | Cache não suportado | Sem faixas (1,0) |
Outros da série Qwen | 256K | 0,2 (acertos de cache consomem capacidade a 20% da taxa normal) | Sem faixas (1,0) |
glm-5.2 | 1 Milhão | 0,25 (acertos de cache consomem capacidade a 25% da taxa normal) | Sem faixas (1,0) |
glm-5.1 | 200K | 0,2 (acertos de cache consomem capacidade a 20% da taxa normal) | [0, 32K): entrada 1,0 / saída 1,0[32K, 200K]: entrada 1,33 / saída 1,17 |
DeepSeek-v4-Pro-0813 | 1 Milhão | 0,1 (acertos de cache consomem capacidade a 10% da taxa normal) | Sem faixas (1,0) |
DeepSeek-v4-Pro | 256K | 0,08 (acertos de cache consomem capacidade a 8% da taxa normal) | Sem faixas (1,0) |
DeepSeek-v4-Flash-0731 | 1 Milhão | 0,1 (acertos de cache consomem capacidade a 10% da taxa normal) | Sem faixas (1,0) |
DeepSeek-v4-Flash | 256K | 0,2 (acertos de cache consomem capacidade a 20% da taxa normal) | Sem faixas (1,0) |
Kimi-K2.6 | 256K | 0,2 (acertos de cache consomem capacidade a 20% da taxa normal) | Sem faixas (1,0) |
Criar uma reserva de TPM
Pré-requisitos: O service de modelos Bailian deve estar ativado e um workspace criado. Faça login no console Bailian e clique em Create TPM reservation.

-
Preencha os seguintes parâmetros:
Parâmetro
Descrição
Obrigatório
Descrição do valor
Nome da reserva
Nome personalizado para identificação.
Sim
≤ 50 caracteres
Selecionar modelo
Escolha o modelo para o qual reservar capacidade. Um código de modelo dedicado é gerado automaticamente após o envio.
Sim
Apenas modelos que suportam reserva de TPM estão disponíveis; consulte a exibição no console.
Ciclo de faturamento
Período de cobrança.
Sim
Diário
TPM de entrada
Throughput de entrada reservado, em kTPM (1 kTPM = 1.000 tokens/minuto).
Sim
O valor inicial e o incremento variam conforme o modelo; consulte a exibição no console.
TPM de saída
Throughput de saída reservado, em kTPM.
Sim
O valor inicial e o incremento variam conforme o modelo; consulte a exibição no console.
Duração da compra
Validade da reserva.
Sim
Insira o número de dias na caixa de entrada. Valores suportados: 1-30, 60, 90, 120, 365 dias.
Renovação automática na expiração
Deduz o pagamento e renova automaticamente às 08:00, um dia antes da expiração. Ativado por padrão.
Não
On / Off
Duração única de renovação
Duração de cada renovação automática.
Não
Insira o número de dias na caixa de entrada. O intervalo de valores é o mesmo da duração da compra.
Política de overflow
Define como lidar com requisições que excedem a capacidade reservada quando esta se esgota.
Sim
Overflow automático para pagamento conforme o uso por token (padrão; o overflow muda para pagamento conforme o uso, sem interrupção do service) / Apenas capacidade reservada (o overflow retorna 429, sem cobranças adicionais)
- Após confirmar os parâmetros, clique em Buy now. Na caixa de diálogo de confirmação de taxa, verifique as cobranças e clique em Confirm payment.
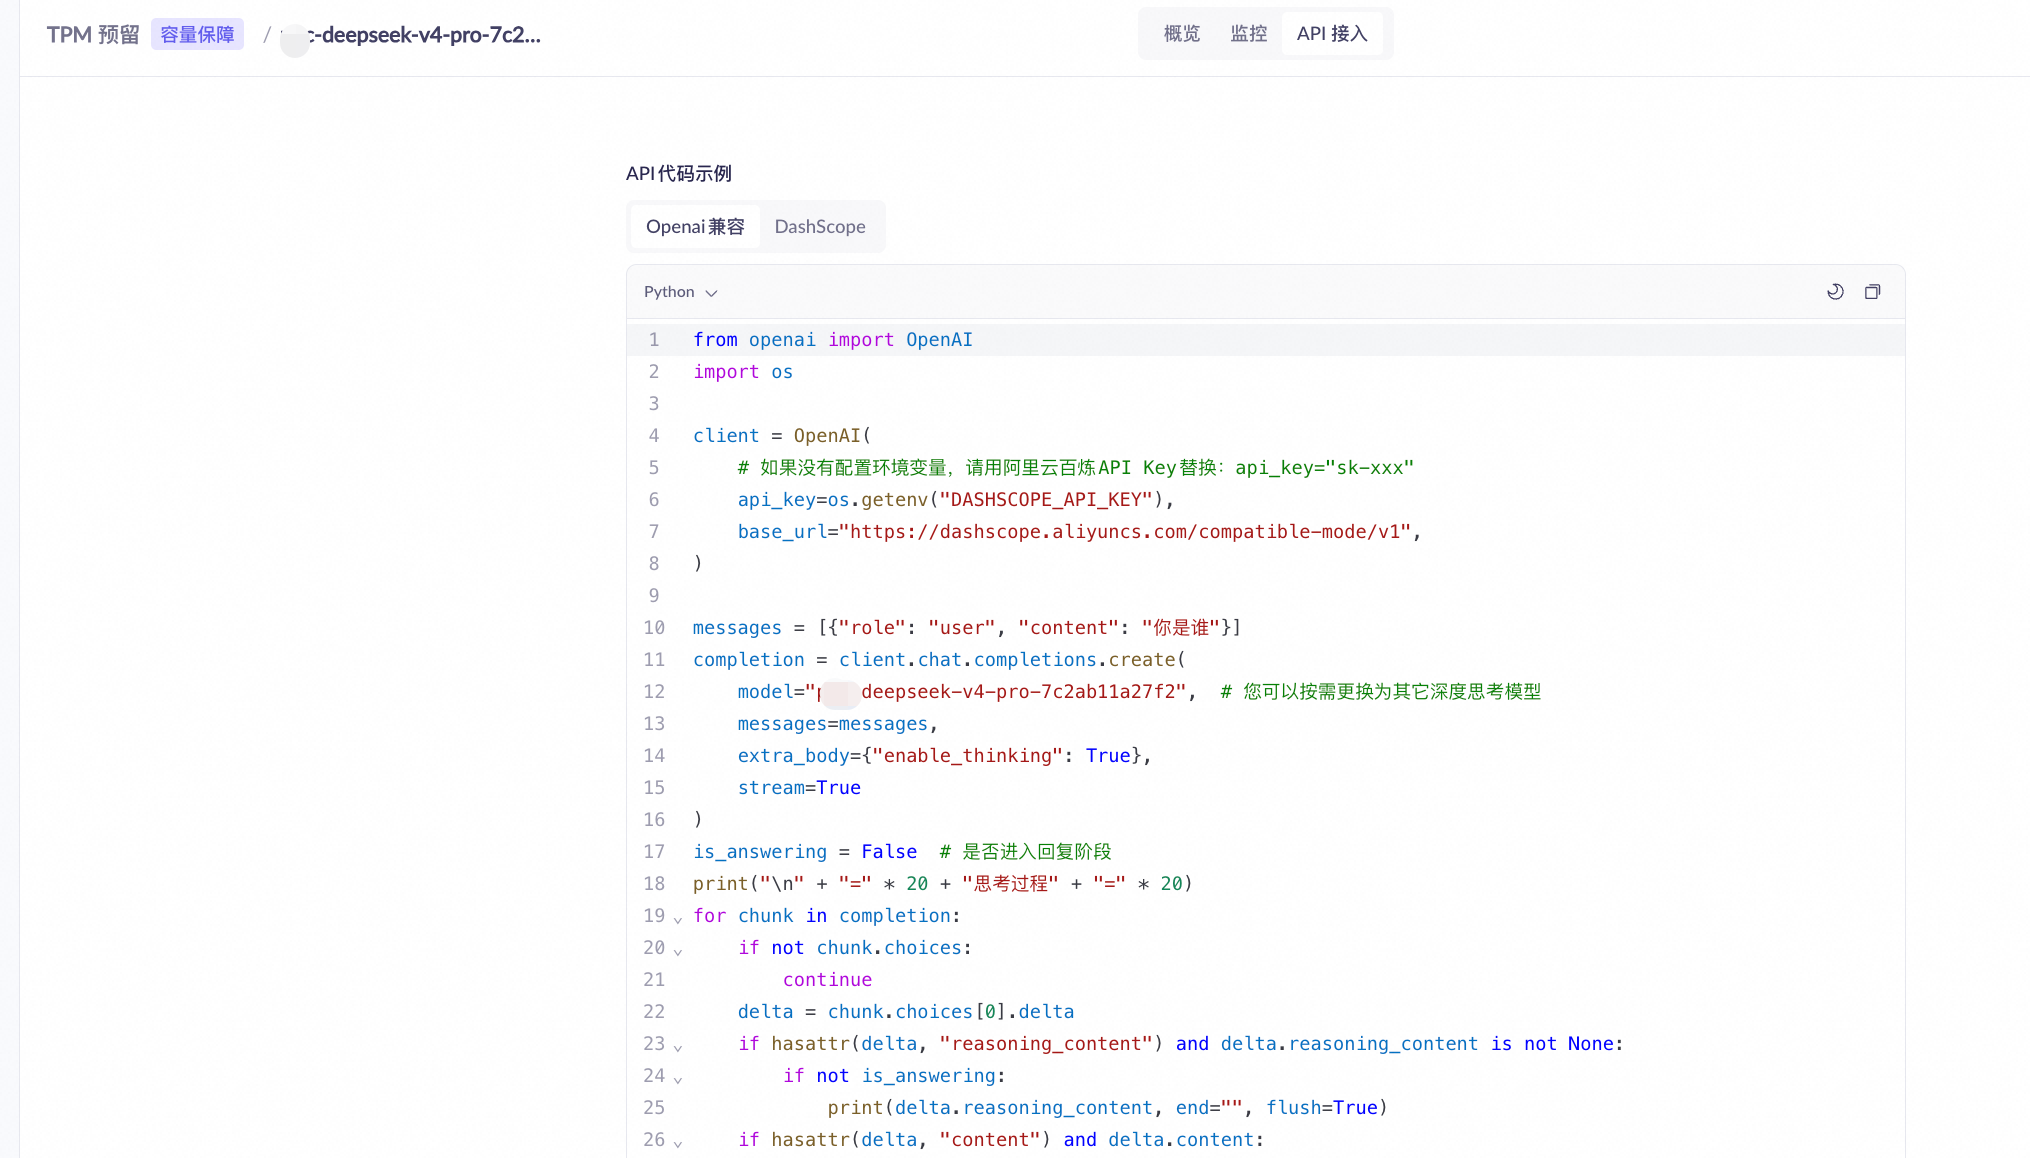
- Na aba Overview da página de detalhes da reserva de TPM, localize o Dedicated model code e clique para copiar.
-
Substitua o parâmetro
modelna sua requisição de API pelo código de modelo dedicado copiado:Pré-requisito: uma instância de reserva de TPM foi criada e seu status é Running .
O parâmetrothinking_budgetdo GLM-5.2 (que limita o comprimento do raciocínio) não tem efeito quando chamado.
Calculadora de capacidade de TPM
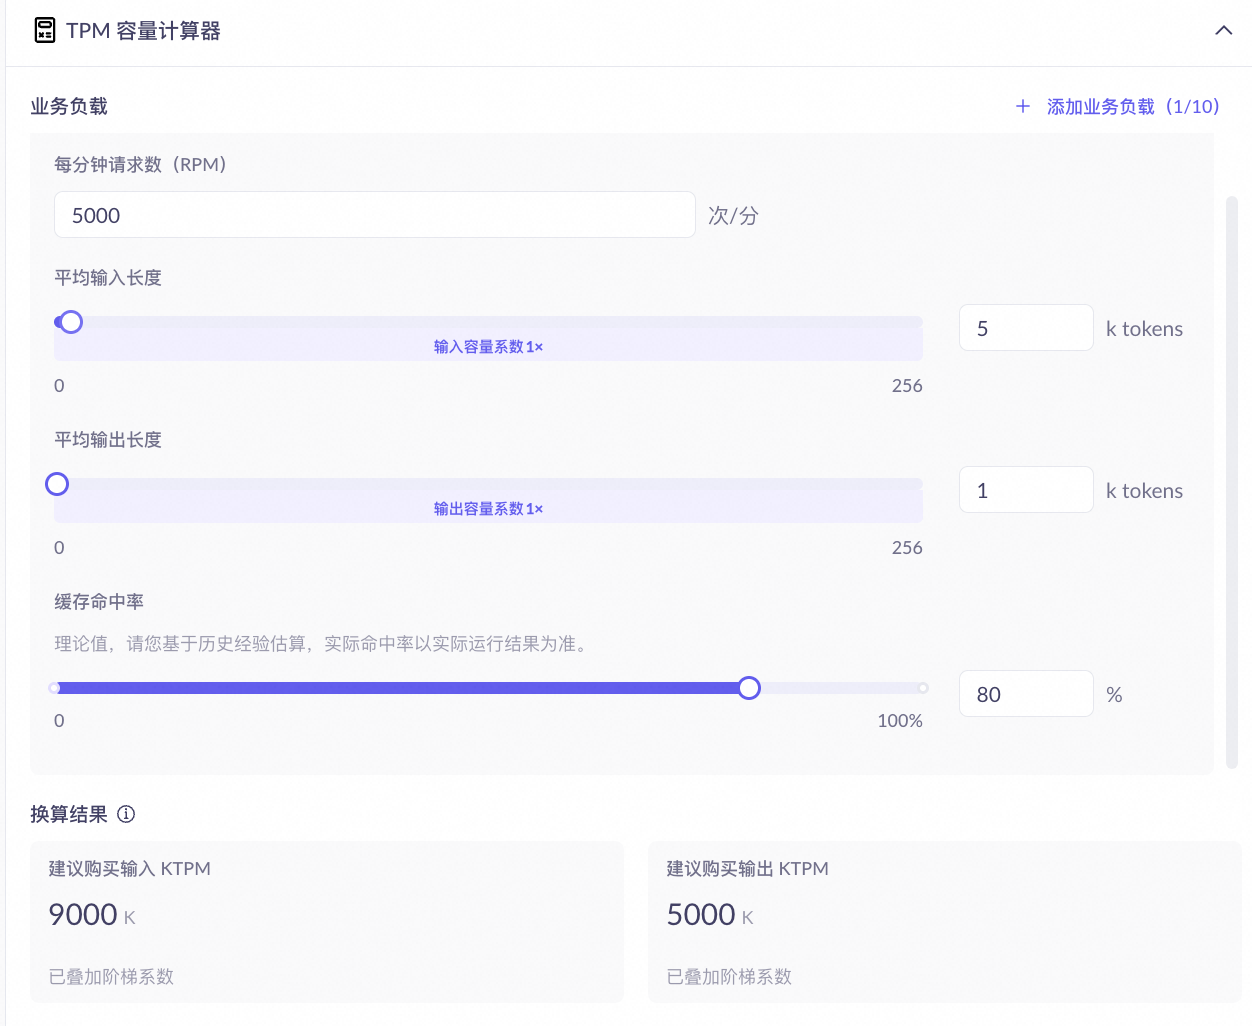
A calculadora de capacidade de TPM, localizada no lado direito da página de criação, ajuda a estimar a cota de TPM a ser comprada com base na sua carga de negócios. Após preencher os parâmetros abaixo, a calculadora fornece automaticamente o TPM de entrada e saída recomendados.
Parâmetro | Descrição | Impacto no resultado |
|---|---|---|
Requisições por minuto (RPM) | Número de requisições enviadas por minuto durante o horário de pico. | Quanto maior o RPM, maiores serão os TPMs de entrada e saída recomendados, proporcionalmente. |
Comprimento médio de entrada (tokens) | Média de tokens de entrada por requisição. | Entradas mais longas elevam a faixa e aumentam o coeficiente, resultando em um TPM de entrada recomendado maior. Os limites das faixas variam por modelo; consulte a exibição real no console. |
Comprimento médio de saída (tokens) | Média de tokens de saída por requisição. | Saídas mais longas podem aumentar o coeficiente, elevando o TPM de saída recomendado. |
Taxa de acerto de cache | Proporção de requisições cujos prefixos repetidos resultam em acerto de cache. A taxa real depende da repetição do conteúdo das requisições; consulte o resultado em tempo de execução. | Uma taxa de acerto maior desacelera o consumo da capacidade de entrada, reduzindo o TPM de entrada recomendado. Afeta apenas o TPM de entrada, não o de saída. |
Visualizar e gerenciar
Acesse o console Bailian e abra a página da lista de reservas. A lista exibe todas as instâncias de reserva como cartões de modelo e permite filtrar por modelo, horário e status.

Detalhes da reserva
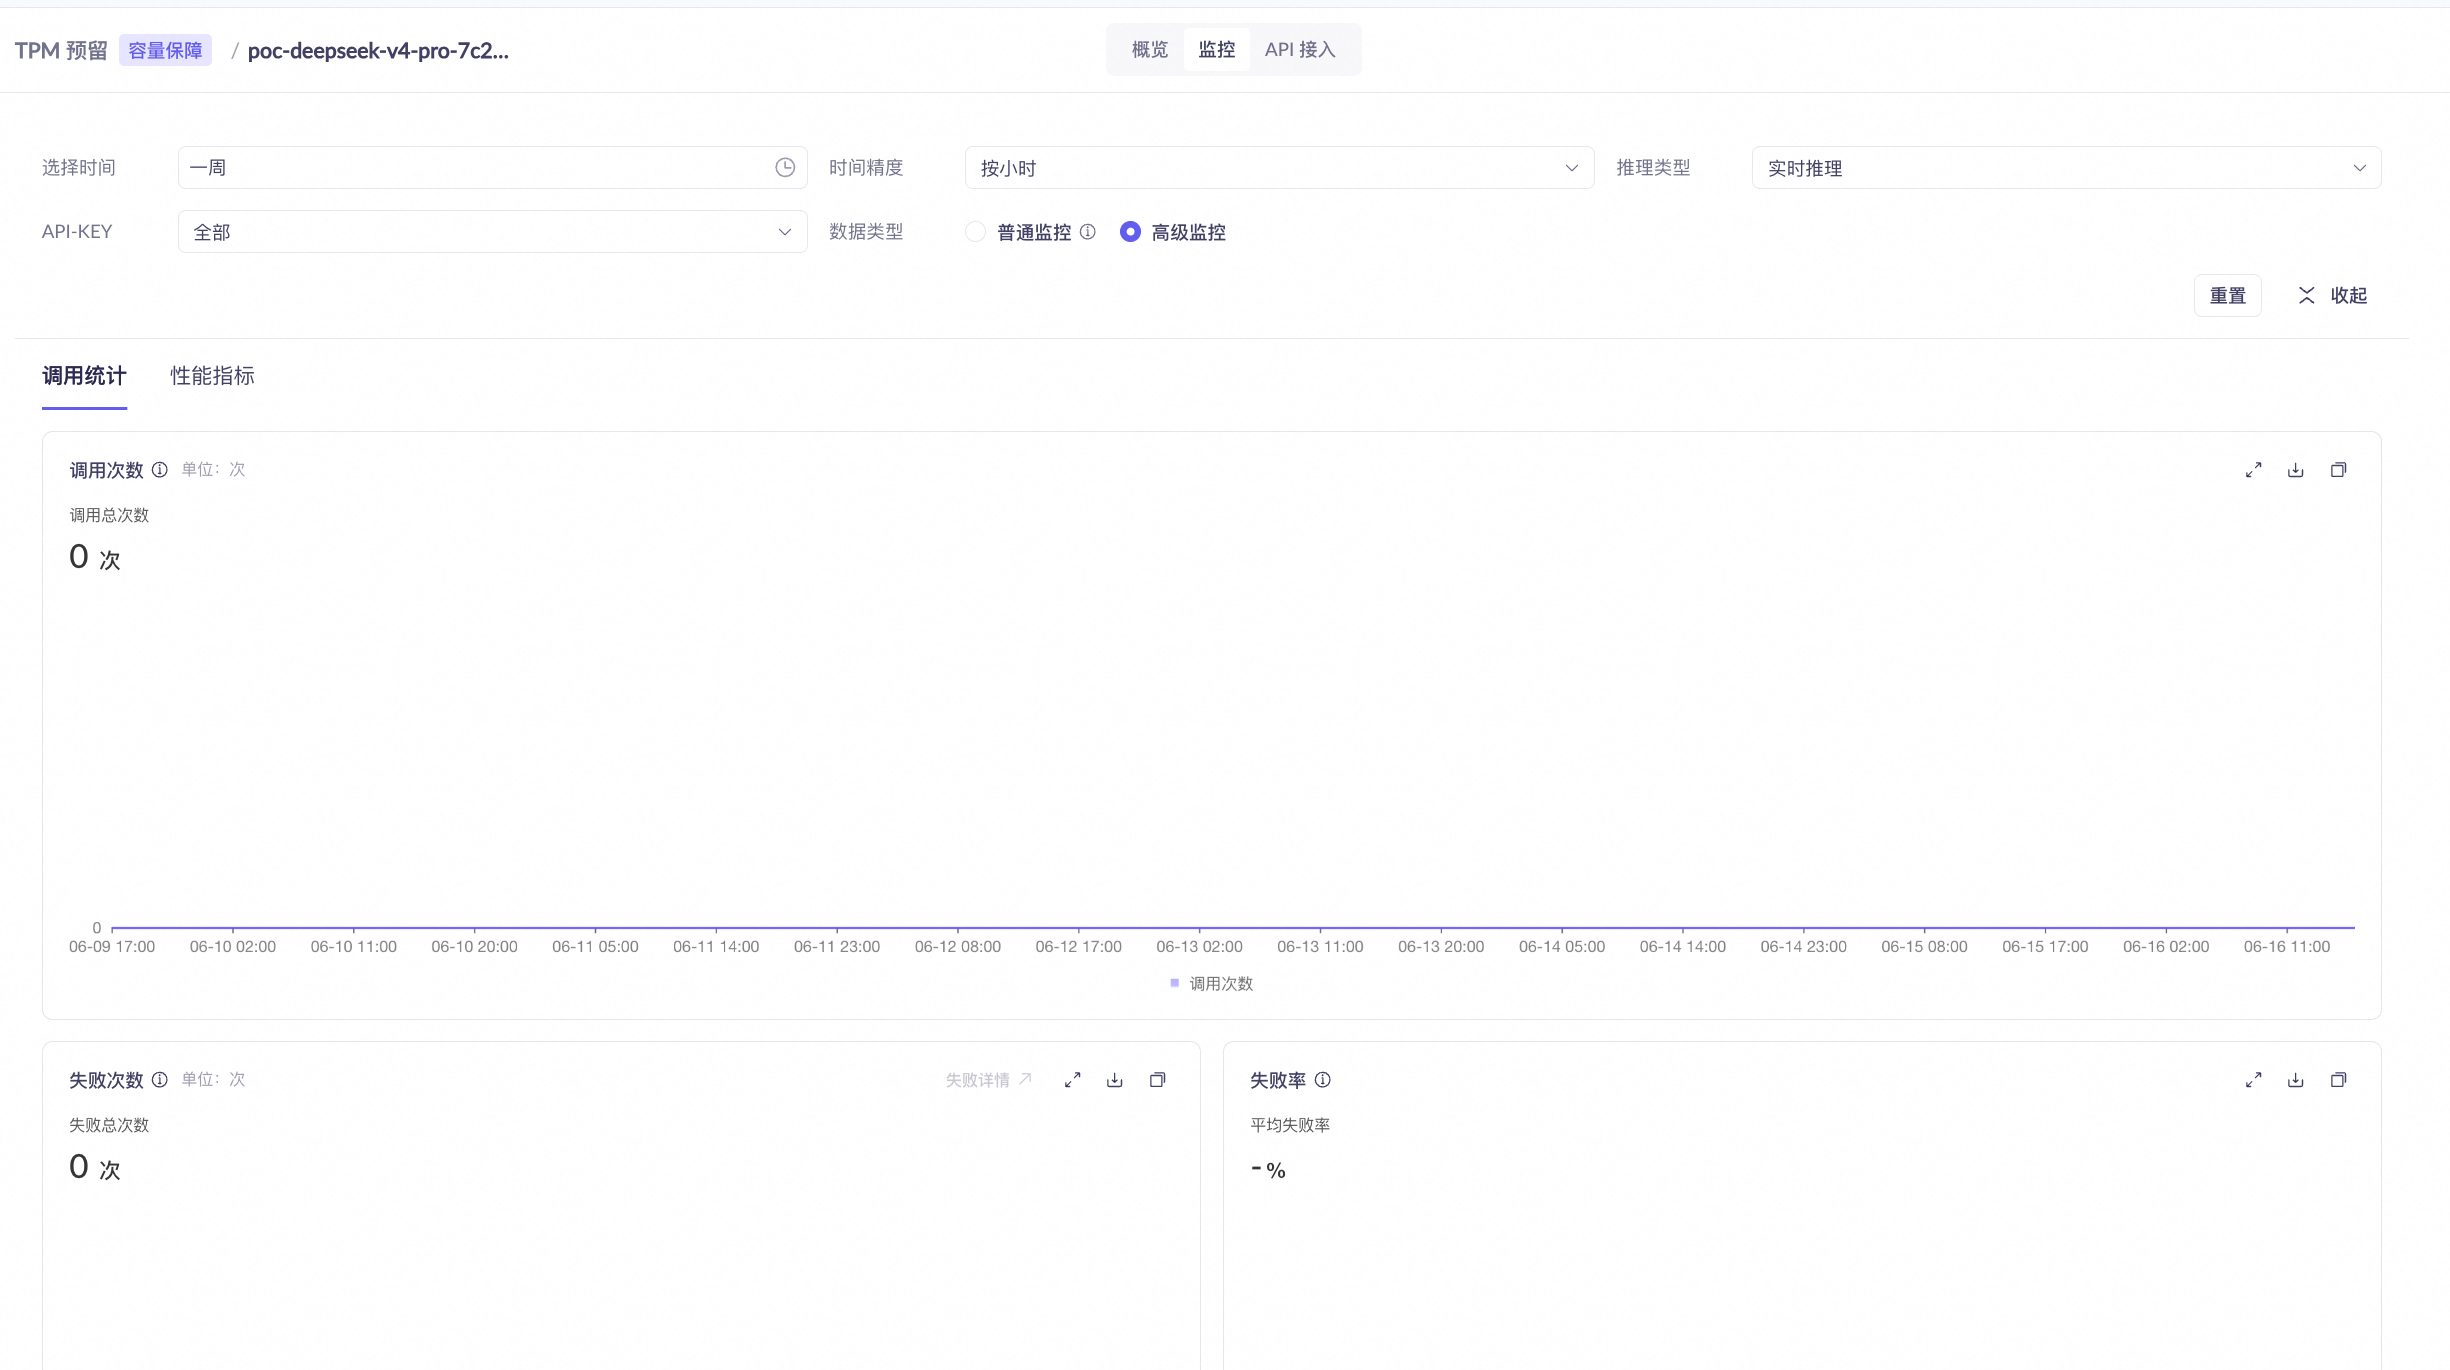
Clique no cartão do modelo desejado para abrir a página de detalhes, que contém as seguintes 3 abas:
- Overview
- Monitoring
- API access
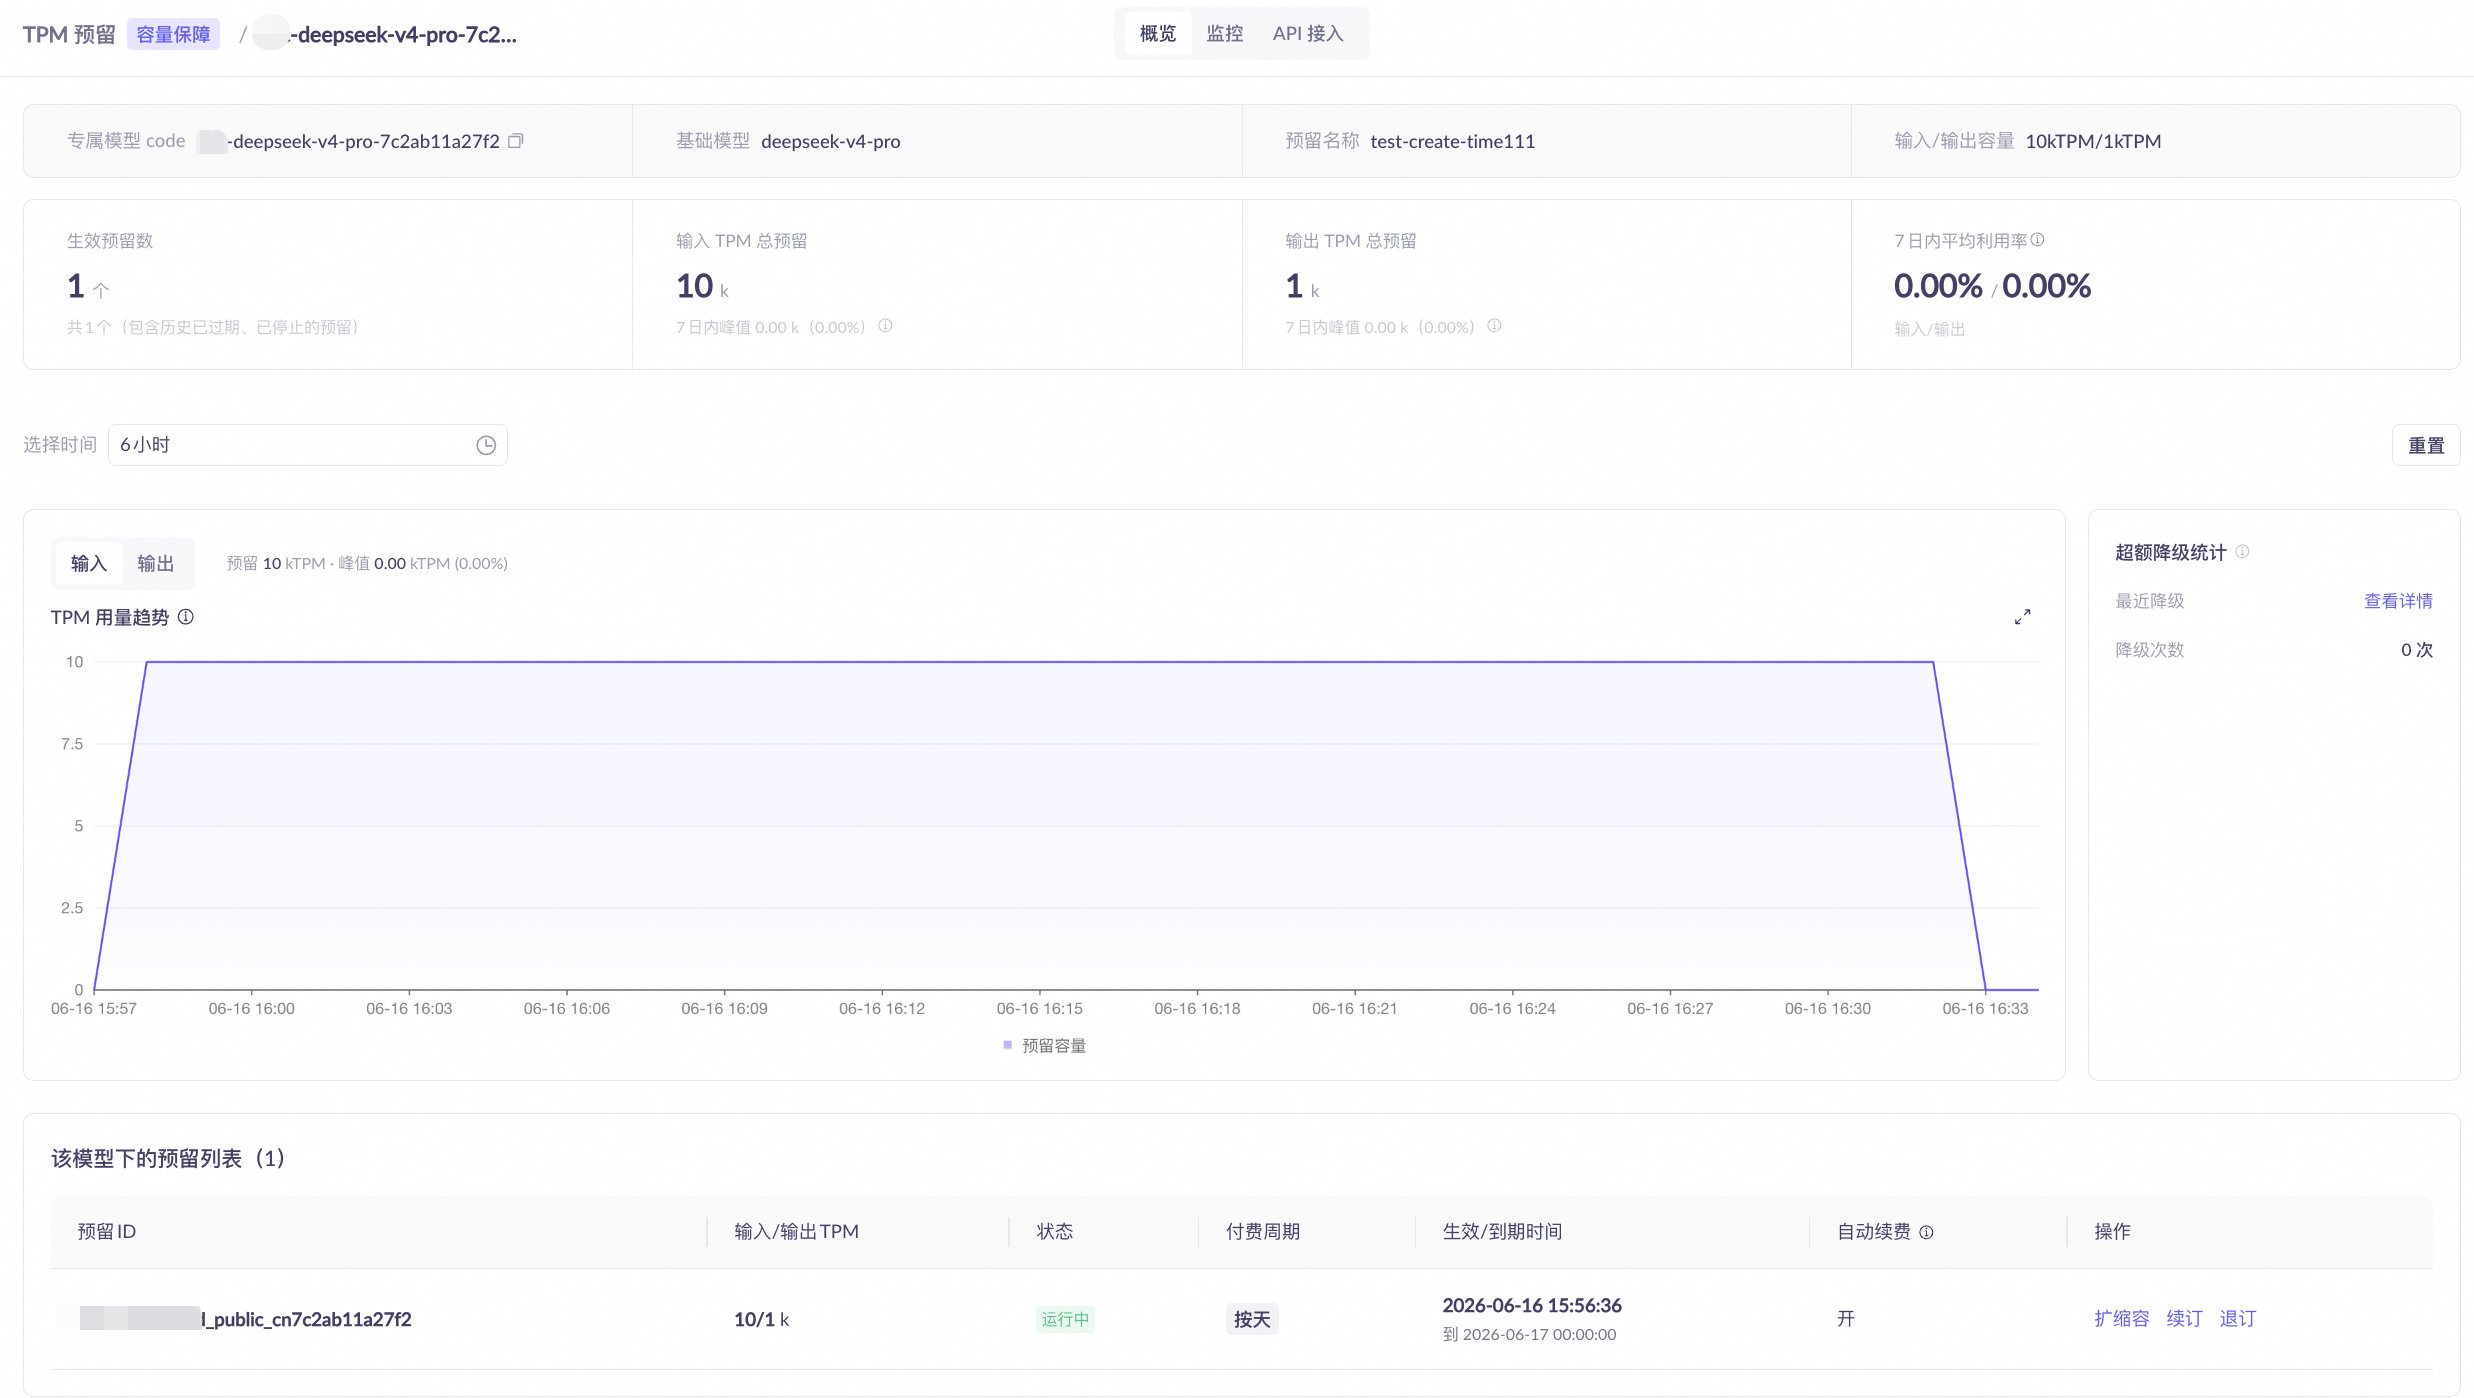
- Informações básicas: nome da reserva, código do modelo dedicado (copiável), modelo base, capacidade de entrada/saída.
- Cartões de estatísticas (últimos 7 dias): contagem de reservas ativas, uso total e de pico de TPM, utilização média.
- Tendência de utilização: alterne entre as direções de entrada/saída; exibe a linha de capacidade reservada e o uso real.
- Estatísticas de degradação por overflow: mostra o número de requisições degradadas após exceder a capacidade reservada (a degradação ocorre apenas sob a política "Overflow automático").
Operações de gerenciamento
Na lista de reservas da aba Overview da página de detalhes, localize a instância alvo e utilize a coluna Operation para executar as seguintes ações:
- Scaling
- Renewal
- Unsubscribe
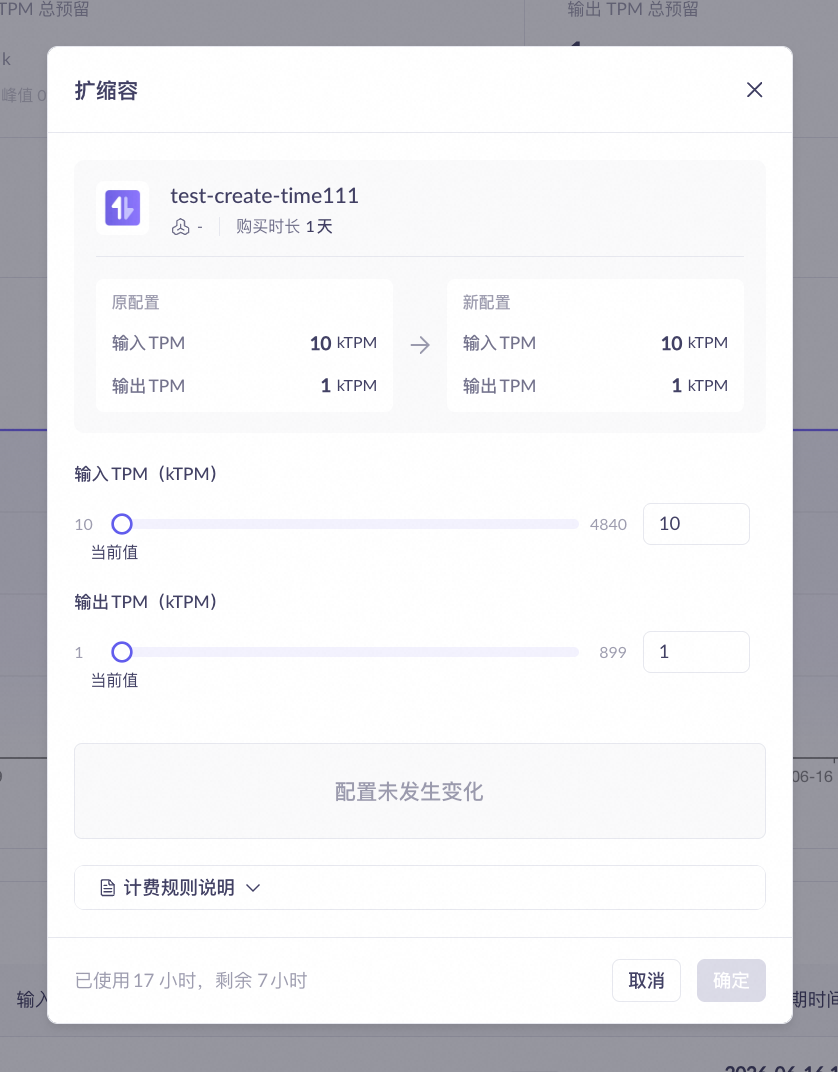
Status da instância de reserva
Status da instância de reserva
Status | Descrição |
|---|---|
Running | Em execução normal; pode ser chamado usando o código do modelo dedicado. |
Pending | Criado; aguardando entrar em vigor. |
Modifying | Dimensionamento em andamento; o service não é interrompido durante este período. |
Stopped | Parado devido a motivos como pagamento atrasado; pode ser restaurado após a renovação. |
Expired | Expirado sem renovação; os recursos foram liberados. |
Canceled | Cancelamento de assinatura concluído; irreversível. |
Perguntas frequentes
P: O que acontece quando a capacidade reservada é excedida?
P: O que acontece quando a capacidade reservada é excedida?
P: Como obtenho o código do modelo dedicado?
P: Como obtenho o código do modelo dedicado?
model na sua requisição de API por este código para utilizar a capacidade reservada.P: O que acontece quando uma reserva expira?
P: O que acontece quando uma reserva expira?
P: Como determino se devo aumentar o dimensionamento?
P: Como determino se devo aumentar o dimensionamento?
P: Qual é a validade real de uma reserva de "1 dia"?
P: Qual é a validade real de uma reserva de "1 dia"?