

Ao utilizar o recurso de imagem para vídeo , se a otimização de prompt ou a chamada dos efeitos de vídeo oficiais não atenderem aos seus requisitos personalizados para ações, efeitos ou estilos específicos , utilize o ajuste fino do modelo .
Escopo de aplicação
- Região aplicável: Os recursos descritos neste documento estão disponíveis apenas na região Singapore. Utilize uma chave de API criada nesta região.
- Método de ajuste fino suportado: Ajuste fino SFT-LoRA eficiente.
-
Modelos suportados para ajuste fino:
- Imagem para vídeo (baseado no primeiro quadro): wan2,7-i2v, wan2,6-i2v, wan2,5-i2v-preview, wan2,2-i2v-flash.
- Imagem para vídeo (baseado no primeiro e último quadro): wan2,2-kf2v-flash.
Como ajustar um modelo
- Imagem para vídeo (baseado no primeiro quadro)
- Imagem para vídeo (baseado no primeiro e último quadro)
Imagem de primeiro quadro de entrada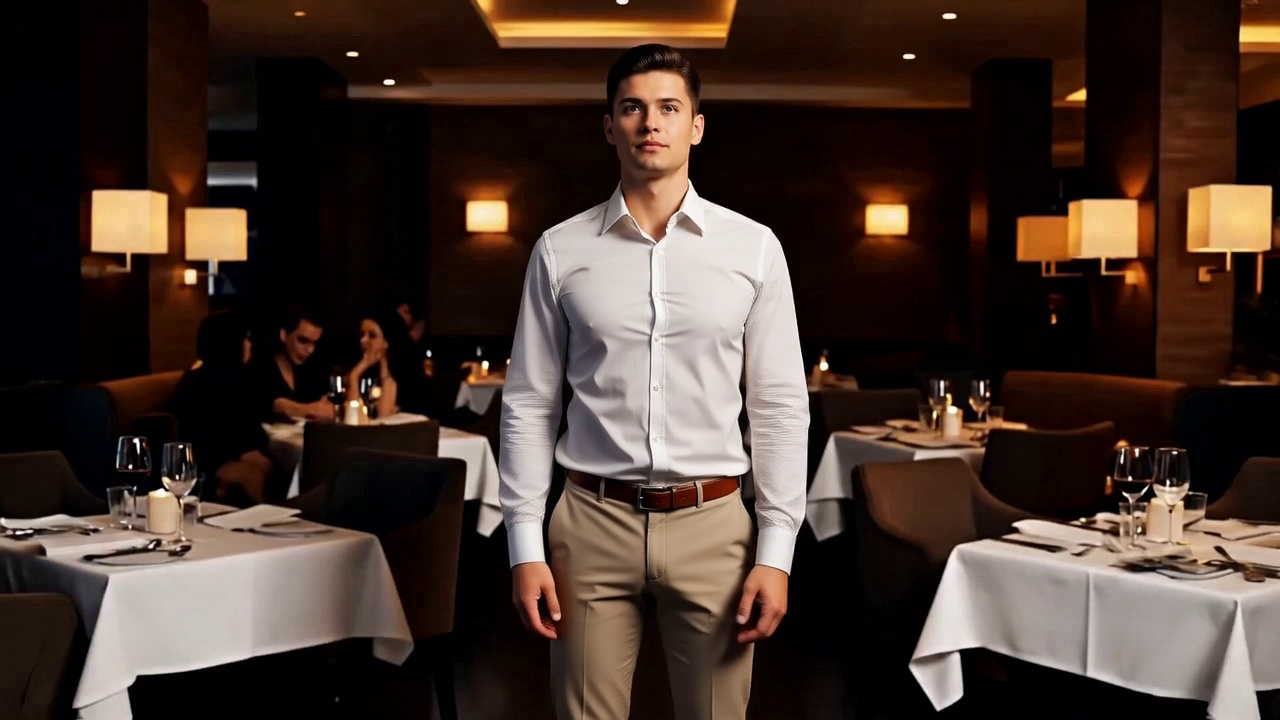 | Vídeo de saída (antes do ajuste fino)Não é possível gerar um efeito de chuva de dinheiro consistente todas as vezes usando prompts. O movimento não é controlável. | Vídeo de saída (após o ajuste fino)O modelo ajustado reproduz o efeito específico de chuva de dinheiro do conjunto de dados de treinamento sem necessidade de prompts. |
Etapa 1: Carregar seu conjunto de dados
Carregue seu conjunto de dados local (no formato .zip) para o Alibaba Cloud Model Studio. Obtenha o ID do arquivo (file_idid).
Conjunto de dados de treinamento de exemplo: Consulte o conjunto de treinamento para detalhes sobre o formato.
- Imagem para vídeo (baseado no primeiro quadro): wan-i2v-training-dataset.zip.
- Imagem para vídeo (baseado no primeiro e último quadro): wan-kf2v-training-dataset.zip.
Este exemplo utiliza o modelo de imagem para vídeo baseado no primeiro quadro. Carregue apenas o conjunto de treinamento. O sistema divide automaticamente uma parte dele como conjunto de validação. O carregamento de um conjunto de dados leva vários minutos. O tempo exato depende do tamanho do arquivo.
id. Este é o identificador exclusivo do seu conjunto de dados carregado.
Etapa 2: Ajustar o modelo
Etapa 2.1 Crie um trabalho de ajuste fino
Inicie o treinamento utilizando o ID do arquivo obtido na Etapa 1.<replace with training dataset file ID> integralmente pelo id da etapa anterior.
output:
job_id: ID do trabalho. Utilize-o para verificar o progresso.finetuned_output: Nome do novo modelo ajustado. Utilize este nome para a implantação.status: Status do treinamento. Após a criação do trabalho, o status inicial é PENDING. O treinamento ainda não começou.
Etapa 2.2 Verificar o status do trabalho de ajuste fino
Utilize ojob_id da Etapa 2.1 para verificar o progresso. Consulte este endpoint periodicamente até que o status se torne SUCCEEDED.
<replace with fine-tuning job job_id> na URL integralmente pelo valor de job_id.
output:
status: Quando este valor se tornar SUCCEEDED, o treinamento estará concluído. Você poderá implantar o modelo.usage: Total de tokens utilizados para treinamento. Usado para faturamento.
Etapa 3: Implantar o modelo ajustado
Etapa 3.1 Implantar o modelo como um service online
Após o status do trabalho de ajuste fino ser SUCCEEDED, implante o modelo como um service online. Exemplo de solicitação Substitua<replace with model name model_name> integralmente pelo valor de finetuned_output obtido ao criar o trabalho de ajuste fino.
output:
deployed_model: Nome do modelo implantado. Utilize-o para verificar o status da implantação e chamar o modelo.status: Status da implantação. Após implantar o modelo ajustado, o status inicial é PENDING. A implantação ainda não começou.
Etapa 3.2 Verificar o status da implantação
Consulte este endpoint periodicamente até que ostatus se torne RUNNING.
<replace with deployed_model> integralmente pelo valor de deployed_model obtido na Etapa 3.1.
Exemplo de resposta
Verifique estes dois parâmetros no campo output:
status: Quando o status se tornar RUNNING, o modelo foi implantado com sucesso. Você pode começar a chamá-lo.deployed_model: Nome do modelo implantado.
Etapa 4: Chamar o modelo para gerar vídeos
Após a implantação bem-sucedida do modelo (quando o status da implantação for RUNNING), você pode começar a chamar o modelo.
Etapa 4.1: Crie uma tarefa de geração de vídeo e obter o task_id
Etapa 4.1: Crie uma tarefa de geração de vídeo e obter o task_id
<replace with deployed_model name> pelo valor de deployed_model obtido na etapa anterior.- Imagem para vídeo (baseado no primeiro quadro)
- Imagem para vídeo (baseado no primeiro e último quadro)
Chamada do modelo Wan2.7
Chamada do modelo Wan2.7
Chamada do modelo Wan2.6/Wan2.5/Wan2.2
Chamada do modelo Wan2.6/Wan2.5/Wan2.2
task_id para consultar os resultados na próxima etapa.duration), consulte a documentação da API.Campo | Tipo | Obrigatório | Descrição | Valor de exemplo |
|---|---|---|---|---|
model | string | Sim | Nome do modelo. Utilize um modelo ajustado implantado com sucesso e com status RUNNING. | xxxx-ft-202511111122-xxxx |
input.prompt | string | Não | Prompt de texto. A eficácia deste parâmetro depende da configuração aigc_config.use_input_prompt:
| - |
parameters.resolution | string | Não | Resolução do vídeo gerado. Modelos wan2,2 e wan2,5: 480P, 720P. O padrão é 720P. Modelos wan2,6: 720P, 1080P. O padrão é 720P. Modelos wan2,7: 720P, 1080P. O padrão é 1080P. | 720P |
parameters.prompt_extend | boolean | Não | Ative reescrita de prompt. Ao chamar um modelo LoRA ajustado, desative esta opção. Defina como false. | false |
Etapa 4.2: Consultar resultados usando o task_id
Etapa 4.2: Consultar resultados usando o task_id
task_id até que o task_status se torne SUCCEEDED. Em seguida, obtenha a URL do vídeo.Exemplo de solicitação
Substitua 86ecf553-d340-4e21-xxxxxxxxx pelo task_id real.
A URL do vídeo é válida por 24 horas. Baixe o vídeo prontamente.
Crie um conjunto de dados personalizado
Além de utilizar os conjuntos de dados de exemplo neste guia, você pode criar seu próprio conjunto de dados para ajuste fino.
Seu conjunto de dados deve incluir um conjunto de treinamento (obrigatório) e pode incluir um conjunto de validação (opcional, suporta divisão automática a partir do conjunto de treinamento). Compacte todos os arquivos em um arquivo .zip. Utilize apenas letras inglesas, números, sublinhados ou hifens nos nomes dos arquivos.
Formato do conjunto de dados
Conjunto de treinamento: Obrigatório
- Imagem para vídeo (baseado no primeiro quadro)
- Imagem para vídeo (baseado no primeiro e último quadro)
- Conjunto de treinamento de exemplo: wan-i2v-training-dataset.zip.
- Estrutura de diretórios ZIP:
- Arquivo de anotação (data.jsonl): Cada linha representa uma amostra de treinamento. Deve ser um objeto JSON. Estrutura:
Conjunto de validação: Opcional
- Imagem para vídeo (baseado no primeiro quadro)
- Imagem para vídeo (baseado no primeiro e último quadro)
- Conjunto de validação de exemplo: wan-i2v-valid-dataset.zip.
- Estrutura de diretórios ZIP:
- Arquivo de anotação (data.jsonl): Cada linha representa uma amostra de validação. Deve ser um objeto JSON. Estrutura:
Escala de dados e limites
- Volume de dados: Forneça pelo menos 10 amostras. Mais dados de treinamento resultam em melhores resultados. Recomendamos de 20 a 100 amostras para um desempenho estável.
- Arquivo ZIP: Ao carregar via API, o tamanho total deve ser ≤ 1 GB.
-
Requisitos para imagens de treinamento:
- Formatos: BMP, JPEG, PNG, WEBP.
- Resolução ≤ 4096×4096.
- Sem limite rígido para tamanho individual de arquivo (o sistema pré-processa automaticamente).
-
Requisitos para vídeos de treinamento:
- Formatos: MP4, MOV.
- Resolução ≤ 4096×4096.
- Sem limite rígido para tamanho individual de arquivo (o sistema pré-processa automaticamente).
- Duração por vídeo: recomendado de 2 a 5 segundos para modelos wan2,2; recomendado de 2 a 10 segundos para modelos wan2,5 ; recomendado de 2 a 10 segundos para modelos wan2,6 e wan2,7.
Coleta e limpeza de dados
1. Defina o cenário de ajuste fino
O Wanxiang suporta ajuste fino para imagem para vídeo nestes cenários:- Efeitos de vídeo fixos: Ensinar ao modelo uma mudança visual específica, como um carrossel ou troca mágica de figurino.
- Ações de personagem fixas: Melhorar a capacidade do modelo de reproduzir movimentos corporais específicos, como passos de dança ou técnicas de artes marciais.
- Movimento de câmera fixo: Replicar cinematografia complexa, como movimentos de push, pull, pan, tilt ou órbita.
2. Coletar ativos brutos
- Geração e filtragem por IA: Utilize o modelo base Wanxiang para gerar vídeos em lote. Selecione manualmente amostras de alta qualidade que melhor correspondam ao seu efeito alvo. Este é o método mais comum.
- Filmagem real: Se você precisar de alto realismo para cenas interativas (por exemplo, abraços, apertos de mão), utilize filmagens reais.
- Renderização em software 3D: Para efeitos ou animações abstratas que exigem controle preciso, utilize software 3D (por exemplo, Blender, Cinema 4D).
3. Limpar os dados
Dimensão | Requisitos Positivos | Exemplo Negativo |
|---|---|---|
Consistência | As características principais devem ser altamente uniformes. Exemplo: Para treinar "rotação de 360 graus", todos os vídeos devem girar no sentido horário aproximadamente na mesma velocidade. | Direções mistas. O conjunto de dados contém rotações horárias e anti-horárias. O modelo não sabe qual direção aprender. |
Diversidade | Mais variedade em sujeitos e cenas é melhor. Cubra diferentes sujeitos (homens, mulheres, crianças, animais, edifícios) e composições (close-ups, planos abertos, ângulos altos, ângulos baixos). Varie também a resolução e a proporção da tela. | Cena ou sujeito único. Todos os vídeos mostram "uma pessoa de roupa vermelha girando diante de uma parede branca". O modelo pode tratar erroneamente "roupa vermelha" e "parede branca" como parte do efeito. Ele falha quando a roupa muda. |
Equilíbrio | Os tipos de dados devem ser equilibrados. Se existirem múltiplos estilos, suas quantidades devem ser aproximadamente iguais. | Desequilíbrio severo. 90% são vídeos retrato, 10% são vídeos paisagem. O modelo pode ter baixo desempenho em vídeos paisagem. |
Pureza | Visuais limpos e claros. Utilize ativos originais sem interferências. | Elementos interferentes. Vídeos contêm legendas, logotipos, marcas d'água, barras pretas óbvias ou ruído. O modelo pode aprender a marca d'água como parte do efeito. |
Duração | Duração do ativo ≤ duração alvo. Se você deseja vídeos de 5 segundos, corte os ativos para 4-5 segundos. | Ativos muito longos. Você quer vídeos de 5 segundos, mas fornece ativos de 8 segundos ao modelo. Isso leva a um aprendizado incompleto da ação e a uma sensação truncada. |
Anotação de vídeo: Escrever prompts para vídeos
No arquivo de anotação do conjunto de dados (data.jsonl), cada vídeo possui um prompt correspondente. O prompt descreve o conteúdo do vídeo. A qualidade do prompt determina diretamente o que o modelo aprende.
| Exemplo de promptThe video begins with a young woman standing in front of a brick wall covered with ivy. She has long, smooth reddish-brown hair, wearing a white sleeveless dress, a shiny silver necklace, and a smile on her face. The background is a brick wall covered with green vines, appearing rustic and natural. Then the s86b5p money rain effect begins, countless huge-sized US dollar bills (beige background/dark green patterns) pour down like a torrential rain, densely hitting and surrounding her. The bills continue to fall, she stretches her arms upward, neck slightly tilted back, expression surprised, completely immersed in this wild money rain. |
Fórmula de escrita de prompt
Prompt = [Descrição do sujeito] + [Descrição do fundo] + [Palavra-gatilho] + [Descrição do movimento]
Elemento do prompt | Descrição | Orientação | Exemplo |
|---|---|---|---|
Descrição do sujeito | Descreva pessoas ou objetos presentes no quadro | Obrigatório | The video begins with a young woman... |
Descrição do fundo | Descreva o ambiente onde o sujeito está localizado | Obrigatório | The background is a brick wall covered with green vines... |
Palavra-gatilho | Uma palavra rara e sem significado | Recomendado | s86b5p ou m01aa |
Descrição do movimento | Descreva detalhadamente as mudanças dinâmicas durante o efeito | Recomendado | Countless huge-sized US dollar bills (beige background/dark green patterns) pour down like a torrential rain... |
Sobre palavras-gatilho
Sobre palavras-gatilho
- O que é uma palavra-gatilho? Ela atua como uma "âncora visual". Muitos movimentos complexos (por exemplo, um caminho de dança único ou efeito de luz) são difíceis de descrever em texto. Uma palavra-gatilho força o modelo a gerar exatamente aquele efeito visual quando vê a palavra.
- Por que utilizá-la? O ajuste fino cria um mapeamento entre texto e características de vídeo. A palavra-gatilho vincula um efeito difícil de descrever a uma palavra única, permitindo que o modelo fixe no alvo.
-
Se temos uma palavra-gatilho, por que descrever o movimento em detalhes?
Elas desempenham papéis diferentes e funcionam melhor juntas.
- A descrição do movimento explica o que acontece na cena. Ela informa ao modelo ações físicas básicas e lógica. As descrições de movimento geralmente são consistentes entre as amostras.
- A palavra-gatilho explica como a ação se parece especificamente. Ela representa mudanças e características únicas que palavras não conseguem descrever.
Como escrever bons prompts
Seguir regras de consistência para descrições de efeitos
Para todas as amostras que contenham o mesmo efeito, mantenha a parte da descrição do movimento o mais consistente possível. Aplique esta regra tanto aos conjuntos de treinamento quanto aos de validação.-
Propósito: Quando o modelo vê
s86b5pseguido pela mesma descrição fixa e sempre vê chuva de dinheiro, ele aprende que s86b5p = efeito visual de chuva de dinheiro. -
Exemplo: Seja o sujeito uma "jovem mulher" ou um "homem de terno", o prompt termina da mesma maneira para o efeito de chuva de dinheiro: “...then the s86b5p money rain effect begins, countless US dollar bills pour down like a torrential rain...”
Tipo de amostra
Conteúdo do prompt (Observe a consistência nas partes sublinhadas)
Amostra de treinamento 1
The video begins with a young woman standing in front of a brick wall... (descrição do ambiente omitida)...
Then the s86b5p money rain effect begins, countless huge-sized US dollar bills (beige background/dark green patterns) pour down like a torrential rain, densely hitting and surrounding her. The bills continue to fall, she stretches her arms upward, neck slightly tilted back, expression surprised, completely immersed in this wild money rain.Amostra de treinamento 2
The video begins with a man in a suit in a high-end restaurant... (descrição do ambiente omitida)...
Then the s86b5p money rain effect begins, countless huge-sized US dollar bills (beige background/dark green patterns) pour down like a torrential rain, densely hitting and surrounding him. The bills continue to fall, he stretches his arms upward, neck slightly tilted back, expression surprised, completely immersed in this wild money rain.Amostra de validação 1
The video begins with a young child standing in front of a cityscape... (descrição do ambiente omitida)...
Then the s86b5p money rain effect begins, countless huge-sized US dollar bills (beige background/dark green patterns) pour down like a torrential rain, densely hitting and surrounding him. The bills continue to fall while the camera slowly zooms in, he stretches his arms upward, neck slightly tilted back, expression surprised, completely immersed in this wild money rain.
Utilizar IA para gerar prompts
Para obter prompts de alta qualidade, utilize modelos de linguagem grandes multimodais como Qwen-VL para auxiliar.-
Utilizar IA para gerar descrições iniciais
-
Brainstorming de forma livre (encontrar inspiração): Se você não tem certeza de como descrever o efeito, deixe a IA explorar livremente.
- Envie “
Describe the video content in detail” e observe a saída do modelo. - Concentre-se nos termos que o modelo usa para trajetória de movimento (por exemplo, “pour down like a torrential rain”, “camera slowly zooms in”). Estes termos podem ser usados para otimização posterior.
- Envie “
-
Prompting de formato fixo (padronizar saída): Assim que tiver uma ideia geral, crie um formato fixo para guiar a IA a gerar prompts que correspondam ao seu modelo.
Código de exemplo
Consulte compreensão visual para detalhes sobre chamadas de API.
-
Brainstorming de forma livre (encontrar inspiração): Se você não tem certeza de como descrever o efeito, deixe a IA explorar livremente.
-
Extrair modelos de efeitos
- Execute o processo várias vezes em amostras com o mesmo efeito. Identifique frases precisas e de alta frequência usadas para descrever o efeito. Extraia uma "descrição de efeito" genérica.
- Copie e cole esta descrição de efeito padronizada em todas as amostras para esse efeito.
- Mantenha descrições únicas de "sujeito" e "fundo" para cada amostra. Substitua apenas a parte da "descrição de efeito" pelo modelo unificado.
- Revisão manual A IA pode alucinar ou cometer erros de detecção. Como etapa final, realize uma verificação manual. Por exemplo, confirme se as descrições da entidade e do fundo correspondem à cena real.
Avaliar o modelo usando um conjunto de validação
Especifique um conjunto de validação
Um trabalho de ajuste fino requer um conjunto de treinamento. Um conjunto de validação é opcional. Você pode optar por deixar o sistema dividir automaticamente ou carregar manualmente. Especifique da seguinte forma:
Método 1: Nenhum conjunto de validação carregado (o sistema divide automaticamente)
Quando você cria um trabalho de ajuste fino, se não carregar um conjunto de validação separado, ou seja, se o parâmetrovalidation_file_ids não for enviado, o sistema divide automaticamente uma parte do conjunto de treinamento para usar como conjunto de validação com base nos seguintes dois hiperparâmetros:
split: Proporção dos dados de treinamento a serem divididos. Por exemplo, 0,9 significa 90% para treinamento e 10% para validação.max_split_val_dataset_sample: Número máximo de amostras para o conjunto de validação dividido automaticamente.
dataset size × (1 - split) e max_split_val_dataset_sample.
-
Exemplo: Suponha que você carregue apenas um conjunto de treinamento com 100 amostras, split=0,9 (10% para validação) e max_split_val_dataset_sample=5.
- Divisão teórica: 100 × 10% = 10 amostras.
- Divisão real: min(10, 5)=5. Portanto, o sistema usa apenas 5 amostras para o conjunto de validação.
Método 2: Carregar um conjunto de validação manualmente (usando validation_file_ids)
Se preferir avaliar checkpoints usando seus próprios dados preparados em vez de depender de divisões aleatórias do sistema, carregue um conjunto de validação personalizado. Nota: Uma vez que você escolha o carregamento manual, o sistema ignora as regras de divisão automática acima e valida apenas com os dados carregados por você.Etapas: Carregar um conjunto de validação manualmente
Etapas: Carregar um conjunto de validação manualmente
- Preparar o conjunto de validação: Compacte os dados de validação em um arquivo
.zipindependente. Consulte formato do conjunto de validação. - Carregar o conjunto de validação: Chame a API de carregamento de conjunto de dados para carregar este arquivo
.zip. Obtenha um ID de arquivo dedicado. - Especifique o conjunto de validação ao criar o trabalho: Ao chamar a API de criação de trabalho de ajuste fino, coloque este ID de arquivo no parâmetro
validation_file_ids.
Selecione o melhor checkpoint para implantação
Durante o treinamento, o sistema salva "snapshots" periódicos (checkpoints). Por padrão, o sistema gera o checkpoint final como o modelo ajustado. Mas checkpoints intermediários podem superar a versão final. Você pode escolher o melhor para implantação.
O sistema executa checkpoints no conjunto de validação e gera vídeos de pré-visualização em intervalos definidos pelo hiperparâmetro eval_epochs.
- Avaliação: Julgue assistindo aos vídeos de pré-visualização diretamente.
- Critérios de seleção: Escolha o checkpoint com a melhor qualidade visual e sem distorção de movimento.
Procedimento
Etapa 1: Visualize resultados de pré-visualização para checkpoints
Etapa 1: Visualize resultados de pré-visualização para checkpoints
Etapa 1.1 Listar checkpoints validados
Esta API retorna apenas checkpoints que passaram na validação e geraram vídeos de pré-visualização com sucesso. Checkpoints com falha não são listados.Exemplo de solicitação<replace_with_fine-tuning_job_id>: Substitua integralmente pelojob_idda API de criação de trabalho de ajuste fino.
Etapa 1.2 Visualize resultados de validação para um checkpoint
Selecione um checkpoint da lista acima (por exemplo, “checkpoint-160”) e visualize seu resultado em vídeo.Exemplo de solicitação<replace_with_fine-tuning_job_id>: Substitua integralmente pelojob_idde criação do trabalho de ajuste fino.<replace_with_selected_checkpoint>: Substitua integralmente pelo valor do checkpoint, por exemplo, “checkpoint-160”.
video_path. Ela é válida por 24 horas. Baixe e revise prontamente. Repita esta etapa para comparar múltiplos checkpoints e encontrar o melhor.Etapa 2: Exportar o checkpoint e obter o nome do modelo para implantação
Etapa 2: Exportar o checkpoint e obter o nome do modelo para implantação
Etapa 2.1 Exportar o modelo
Suponha que “checkpoint-160” forneça o melhor resultado. Agora exporte-o.Exemplo de solicitação<replace_with_fine_tuning_job_id>: Substitua integralmente pelojob_idde criação do trabalho de ajuste fino.<replace_with_checkpoint_to_export>: Substitua integralmente pelo valor do checkpoint, por exemplo, “checkpoint-160”.<replace_with_exported_model_name_for_console_display>: Substitua integralmente por um nome de modelo personalizado para exibição no console, por exemplo, “wan2.5-checkpoint-160”. Este nome deve ser globalmente único. Nomes duplicados não são permitidos. Para orientação sobre parâmetros, consulte exportar checkpoint.
output=true significa que a solicitação de exportação foi criada com sucesso.Etapa 2.2 Consultar o novo nome do modelo após a implantação
Consulte todos os status de checkpoints para confirmar a conclusão da exportação e obter o nome único do modelo (model_name) para implantação.Exemplo de solicitação<replace_with_fine-tuning_job_id>: Substitua integralmente pelojob_idde criação do trabalho de ajuste fino.
status se tornar SUCCEEDED, a exportação foi bem-sucedida. O campo model_name é o novo nome do modelo para implantação e chamadas.Etapa 3: Implantar e chamar o modelo
Etapa 3: Implantar e chamar o modelo
- Implantação do modelo: No parâmetro de entrada
model_name, insira o valor específico obtido após a exportação. - Chamada do modelo: Siga a documentação da API para chamar o modelo implantado.
Entrar em produção
Em produção, se o modelo treinado inicialmente apresentar baixo desempenho (por exemplo, visuais distorcidos, efeitos fracos, movimento impreciso), ajuste ao longo destas dimensões:
1. Verificar dados e prompts
- Consistência de dados: A consistência é crítica. Verifique se há "amostras ruins" com direções opostas ou estilos muito diferentes.
- Contagem de amostras: Aumente os dados de alta qualidade para mais de 20 amostras.
- Prompt: Garanta que as palavras-gatilho sejam termos raros e sem significado (por exemplo, s86b5p). Evite palavras comuns (por exemplo, running) que causem interferência.
-
n_epochs (épocas de treinamento) Você pode usar os valores padrão para learning_rate (taxa de aprendizado) e batch_size (tamanho do lote). Estes valores tipicamente não requerem modificação.
- Padrão: 400. Utilize o padrão, a menos que seja necessário. Se ajustar, siga a regra: “Total de etapas de treinamento ≥ 800”.
-
Fórmula de etapas totais:
steps = n_epochs × ceiling (training set size / batch_size). -
Fórmula mínima de n_epochs:
n_epochs = 800 / ceiling (dataset size / batch_size). -
Exemplo: Suponha um conjunto de treinamento de 5 amostras, usando o modelo Wan2.5 (batch_size=2).
- Etapas por época: 5 / 2 = 2,5, arredondado para cima para 3. Total de épocas: n_epochs = 800 / 3 ≈ 267. Este é o mínimo recomendado. Você pode aumentar conforme necessário.
Faturamento
-
Treinamento do modelo: Cobrado.
- Custo = Total de tokens de treinamento × Preço unitário. Consulte faturamento de treinamento de modelo.
- Após o treinamento, verifique o total de tokens consumidos no campo
usageda API de consulta de status do trabalho de ajuste fino.
- Implantação do modelo: Gratuita.
-
Chamadas de modelo: Cobradas.
- Cobradas de acordo com o preço de chamada padrão do modelo base ajustado. Consulte preços do modelo.
Referência da API
API de ajuste fino de modelos de geração de vídeo e imagemFAQ
P: Como os volumes de dados dos conjuntos de treinamento e validação são calculados?
R: O conjunto de treinamento é obrigatório, o conjunto de validação é opcional. Os métodos de cálculo são os seguintes:-
Quando nenhum conjunto de validação é fornecido: O conjunto de treinamento carregado é o "tamanho total do conjunto de dados". O sistema divide automaticamente parte dos dados para validação.
- Tamanho do conjunto de validação =
min(total dataset size × (1 − split), max_split_val_dataset_sample). Para um exemplo, consulte especificar um conjunto de validação. - Tamanho do conjunto de treinamento =
total dataset size − validation set size.
- Tamanho do conjunto de validação =
-
Quando um conjunto de validação é carregado manualmente: O sistema não divide mais o conjunto de validação a partir dos dados de treinamento.
- Tamanho do conjunto de treinamento = Volume de dados do conjunto de treinamento carregado.
- Tamanho do conjunto de validação = Volume de dados do conjunto de validação carregado.
P: Como projetar uma boa palavra-gatilho?
R: Siga estas regras:- Utilize combinações de letras sem significado, como sksstyle, a8z2_bbb.
- Evite palavras comuns em inglês (por exemplo, beautiful, fire, dance). Isso evita poluir o entendimento original do modelo sobre essas palavras.
P: O ajuste fino pode alterar a resolução ou duração do vídeo?
R: Não. O ajuste fino aprende "conteúdo" e "dinâmica", não "especificações". O formato do vídeo de saída (resolução, taxa de quadros, duração máxima) ainda é determinado pelo modelo base.