

Este tópico descreve como executar tarefas de ajuste fino de modelos no console e ajuda a escolher o método e os parâmetros adequados. O ajuste fino de modelos inclui três métodos de treinamento: Supervised Fine-Tuning (SFT), Continual Pre-Training (CPT) e Direct Preference Optimization (DPO).
Processo de ajuste fino de modelos

Etapa 1: Selecione um método de ajuste fino
Acesse a página Model Fine-tuning e clique em Create Training Task.
Na página Create Training Task, na área Training Configuration, selecione o Training Method como Efficient Training ou Full-parameter Training. O painel Training Task Summary, no lado direito da página, exibe em tempo real o modelo da tarefa atual, a prioridade, o método de faturamento e outras configurações gerais.
Na seção Basic Information, defina o Job Name e a Job Priority. A prioridade do trabalho possui quatro níveis: L0, L1, L2 e L3, listados do maior para o menor. A prioridade afeta a ordem de agendamento dos trabalhos de treinamento. Uma prioridade mais alta significa execução antecipada.
Como escolher entre CPT, SFT e DPO
O CPT (Continual Pre-Training) utiliza grandes volumes de dados não rotulados para melhorar o desempenho do modelo em setores específicos.
O SFT (Supervised Fine-Tuning) usa conjuntos de dados direcionados e treinamento para aprimorar o desempenho do modelo em cenários de negócios específicos.
O DPO (Direct Preference Optimization) utiliza pares de amostras positivas e negativas em seu conjunto de dados de treinamento. Ao incorporar feedback negativo, ele reduz alucinações e otimiza casos problemáticos específicos.
Os três métodos de ajuste fino fornecidos pelo Model Studio não são mutuamente exclusivos, mas sim progressivos e complementares.
CPT (opcional) → SFT → DPO (opcional)
-
CPT (continual pre-training) - Complementa conhecimento (Modelos gerais possuem conhecimento amplo, porém superficial, o que pode não atender aos requisitos de profundidade e precisão de campos profissionais)
- Modelo financeiro:
Aprende termos financeiros - Modelo médico:
Memoriza patologia de medicamentos - Modelo jurídico:
Compreende artigos legais e precedentes
- Modelo financeiro:
-
SFT (supervised fine-tuning) - Aprende a executar tarefas
- Bot de atendimento ao cliente:
Aprende procedimentos de atendimento - Assistente de código:
Aprende paradigmas de programação - Chamada de ferramentas (Agente):
Aprende a usar MCP
- Bot de atendimento ao cliente:
-
DPO (direct preference optimization) - Executa tarefas com maior qualidade
- Segurança e responsabilidade:
Rejeita sugestões nocivas - Concisão e eficácia:
Fornece respostas concisas - Objetividade e neutralidade:
Avalia de forma justa e objetiva
- Segurança e responsabilidade:
- Conjunto de treinamento SFT
Os parâmetrosnameeweightdo OpenAI não são suportados. Todas as saídas do assistente serão treinadas.
"loss_weight", que define a importância relativa dessa linha durante o treinamento. (Intervalo: 0.0 a 1.0. Um valor maior indica maior importância.)Este parâmetro está disponível para visualização por convite. Para usá-lo, entre em contato com seu gerente de conta.
- Primeiro, colete um grande volume (pelo menos 10 milhões de tokens) de dados não rotulados específicos do domínio e execute o CPT para transformar o modelo em um especialista em seu setor ou domínio.
- Antes de lançar sua aplicação, colete amostras positivas suficientes (mais de 1.000) para seu cenário ou negócio específico — pares de entradas e saídas esperadas do modelo — e execute o SFT.
- Após o lançamento da sua aplicação ou entrada em operação experimental, colete feedback suficiente dos usuários (mais de 100, como curtidas, descurtidas ou feedback direto) ou casos problemáticos. Converta esses dados em um conjunto de treinamento DPO e execute o DPO.
Treinamento de parâmetros completos vs. treinamento eficiente
- O treinamento de parâmetros completos atualiza todos os parâmetros do modelo durante o aprendizado.
- O treinamento eficiente usa Low-Rank Adaptation (LoRA), que decompõe matrizes de pesos e atualiza apenas os componentes de baixa classificação.
Etapa 2: Configure hiperparâmetros
Descrições dos parâmetros de treinamento:
Nem todos os modelos suportam todos os parâmetros. Consulte o console para ver as opções disponíveis.
Nome do Parâmetro | Configuração recomendada | Função dos hiperparâmetros | |
|---|---|---|---|
Tamanho do lote (batch_size) | Use o padrão | O tamanho do lote determina quantas amostras de dados o modelo processa antes de atualizar seus parâmetros. Valores comuns são 16 ou 32. O intervalo válido varia conforme o modelo e o método de treinamento. Consulte o console. | O painel de configuração de parâmetros contém os seguintes parâmetros de treinamento e valores padrão, além do tamanho do lote:
|
Taxa de aprendizado (learning_rate) | Treinamento eficiente: ~1e-4 Treinamento de parâmetros completos: ~1e-5 Treinamento CPT: ~1e-5 | Controla a intensidade com que o modelo ajusta seus pesos. Se a taxa de aprendizado for muito alta, os parâmetros do modelo mudam drasticamente, o que pode piorar o desempenho. Se a taxa de aprendizado for muito baixa, o desempenho melhora pouco. | |
Épocas (n_epochs) | Volume de dados < 10.000: 3–5 épocas Volume de dados > 10.000: 1–2 épocas Ajuste com base nos resultados experimentais | Número de vezes que o modelo percorre os dados de treinamento. Ajuste com base na sua experiência. Mais épocas significam maior tempo de treinamento e custo mais alto. Intervalo: [1, 200]. | |
Etapas de avaliação (eval_steps) | Use o padrão | Frequência de avaliação do modelo durante o treinamento, medida em etapas de treinamento. Usado para rastrear a precisão e a perda do treinamento. Este parâmetro controla a frequência com que Validation Loss e Validation Token Accuracy aparecem. | |
Agendador de taxa de aprendizado (lr_scheduler_type) | Use “linear” ou “inverse_sqrt”. | Estratégia para ajustar dinamicamente a taxa de aprendizado durante o treinamento. Para detalhes, consulte Learning rate scheduler types. | |
Comprimento da sequência (max_length) | Defina para o valor máximo suportado pelo modelo | Comprimento máximo de tokens por amostra de treinamento. Se uma amostra exceder esse comprimento: O SFT descarta toda a amostra. O DPO trunca os tokens além do limite e treina com a amostra encurtada. Para conversão de token para string, consulte How to convert between tokens and strings. Intervalo: [500, 32768]. | |
Taxa de aquecimento (warmup_ratio) | Use o padrão | Fração do total de etapas de treinamento usada para aquecimento da taxa de aprendizado. O aquecimento começa com uma taxa de aprendizado baixa e aumenta linearmente até o valor alvo. Isso limita as mudanças de parâmetros no início do treinamento, melhorando a estabilidade. Uma taxa muito alta age como uma taxa de aprendizado baixa, resultando em pouca melhoria. Uma taxa muito baixa age como uma taxa de aprendizado alta, podendo degradar o desempenho. Intervalo: [0, 1].
| |
Decaimento de peso (weight_decay) | Use o padrão | Força de regularização L2. A regularização L2 ajuda a manter a generalização. Um valor muito alto reduz a eficácia do ajuste fino. Intervalo: [0, 0.2]. | |
Parâmetros de treinamento eficiente | |||
LoRA alpha (lora_alpha) | Use o padrão | Fator de escala que equilibra os pesos do modelo original e as atualizações de baixa classificação do LoRA. Um alpha mais alto dá mais peso às atualizações do LoRA, fazendo com que o modelo dependa mais de informações específicas da tarefa. Um alpha mais baixo preserva mais o conhecimento pré-treinado original. | |
LoRA dropout (lora_dropout) | Use o padrão | Taxa de dropout aplicada às matrizes de baixa classificação do LoRA durante o treinamento. O valor recomendado melhora a generalização. Um valor muito alto reduz a eficácia do ajuste fino. Intervalo: [0, 0.2]. | |
LoRA rank (lora_rank) | Defina para o valor máximo suportado pelo modelo | Classificação das matrizes de baixa classificação do LoRA. Uma classificação mais alta produz resultados ligeiramente melhores, mas com treinamento mais lento. | |
Congelar ViT (freeze_vit) | Use o padrão | Congela os parâmetros da rede backbone de visão para que não sejam atualizados durante o treinamento. Aplica-se apenas a modelos Qwen-VL (compreensão visual). O faturamento baseado em tokens está disponível apenas quando freeze_vit estiver definido como “true”. | |
- SFT (treinamento eficiente): Suporta todos os parâmetros acima.
- DPO (treinamento eficiente): Suporta todos os parâmetros, exceto “freeze_vit”.
- CPT (treinamento de parâmetros completos): Suporta apenas tamanho do lote, taxa de aprendizado, épocas, etapas de avaliação, agendador de taxa de aprendizado e comprimento da sequência. Não suporta parâmetros LoRA, taxa de aquecimento ou decaimento de peso.
Introdução às estratégias de agendamento de taxa de aprendizado
“Learning rate scheduler” é a primeira configuração em Hyperparameter Configuration > Expand Configuration. Ela oferece oito estratégias.
Para detalhes, consulte:
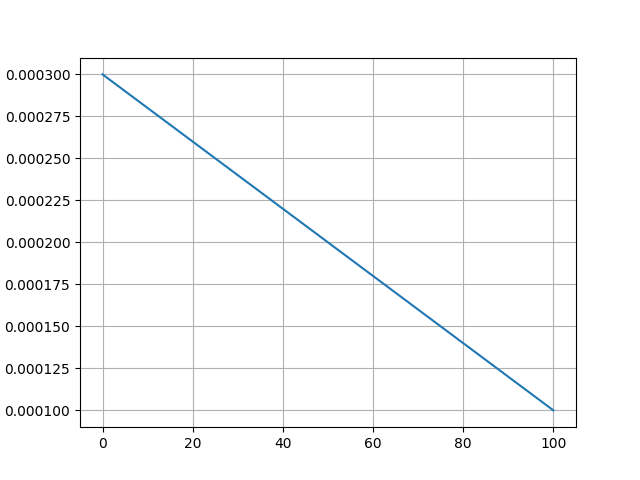
Linear: A taxa de aprendizado diminui linearmente. Caso de uso: Tarefas de treinamento curtas.
| Polynomial: A taxa de aprendizado diminui de acordo com uma função polinomial predefinida ao longo das etapas ou épocas de treinamento. Caso de uso: O decaimento polinomial oferece controle mais refinado sobre a taxa de aprendizado e é adequado para cenários que envolvem tarefas mais complexas. Mas o coeficiente polinomial interno é 1, tornando-o idêntico ao Linear. Não recomendado.
|
Cosine: A taxa de aprendizado segue uma curva cosseno. Caso de uso: Tarefas de treinamento longas que exigem ajustes finos. 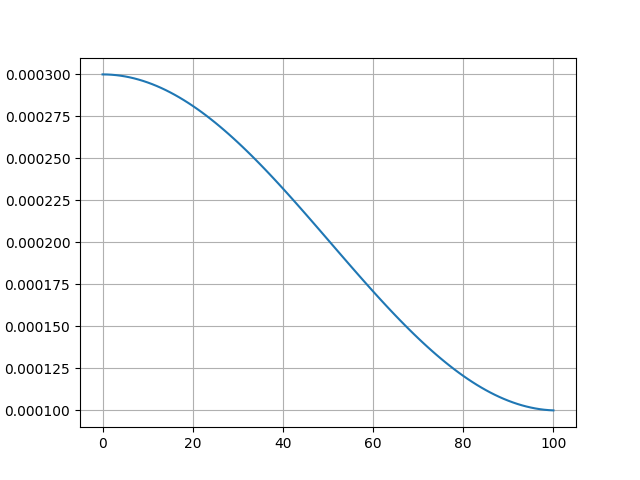 | Cosine_with_restarts: A taxa de aprendizado segue uma curva cosseno, redefine para o valor inicial no final de cada ciclo e inicia um novo ciclo. Caso de uso: Escapar de ótimos locais para encontrar soluções globais melhores. No entanto, testes mostram que a taxa de aprendizado não é realmente redefinida na parte inferior da curva. Não recomendado. |
Constant: A taxa de aprendizado permanece inalterada. “Warmup ratio” não tem efeito. Caso de uso: Exploração inicial de desempenho. 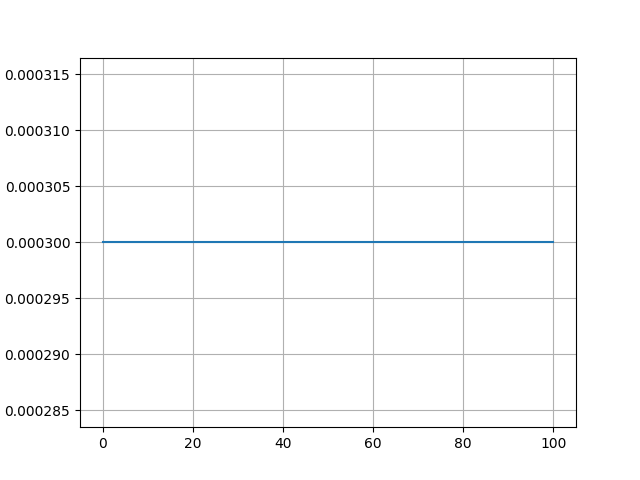 | Constant_with_warmup: A taxa de aprendizado permanece constante, mas “warmup ratio” se aplica. Caso de uso: Exploração inicial de desempenho. 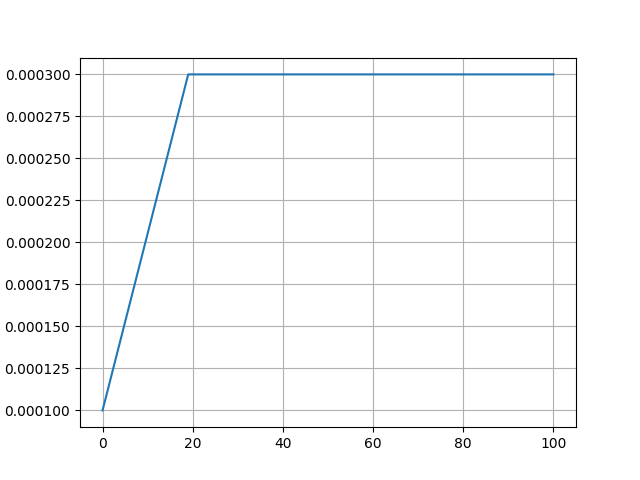 |
Inverse_sqrt: A taxa de aprendizado diminui proporcionalmente à raiz quadrada inversa da contagem de etapas de treinamento. Caso de uso: Ajuste fino SFT. Equilibra bem a eficiência de aprendizado e a convergência. 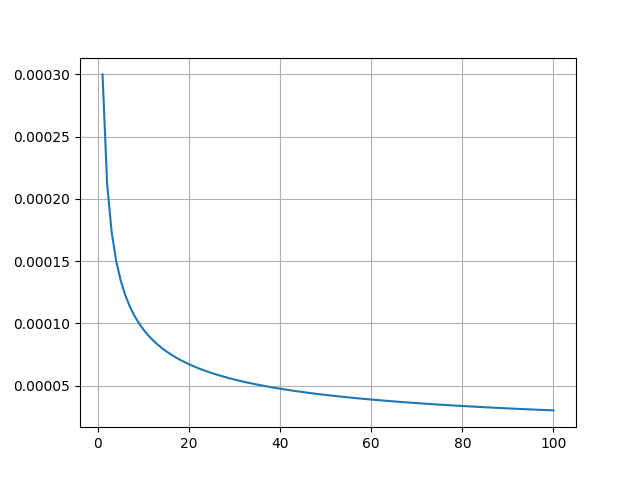 | Reduce_lr_on_plateau: Reduz automaticamente a taxa de aprendizado quando uma métrica monitorada (perda de validação ou precisão) não mostra melhoria significativa ao longo de várias épocas consecutivas. Caso de uso: Quando o modelo tem dificuldade para melhorar ainda mais, essa estratégia ajuda a continuar a otimização. 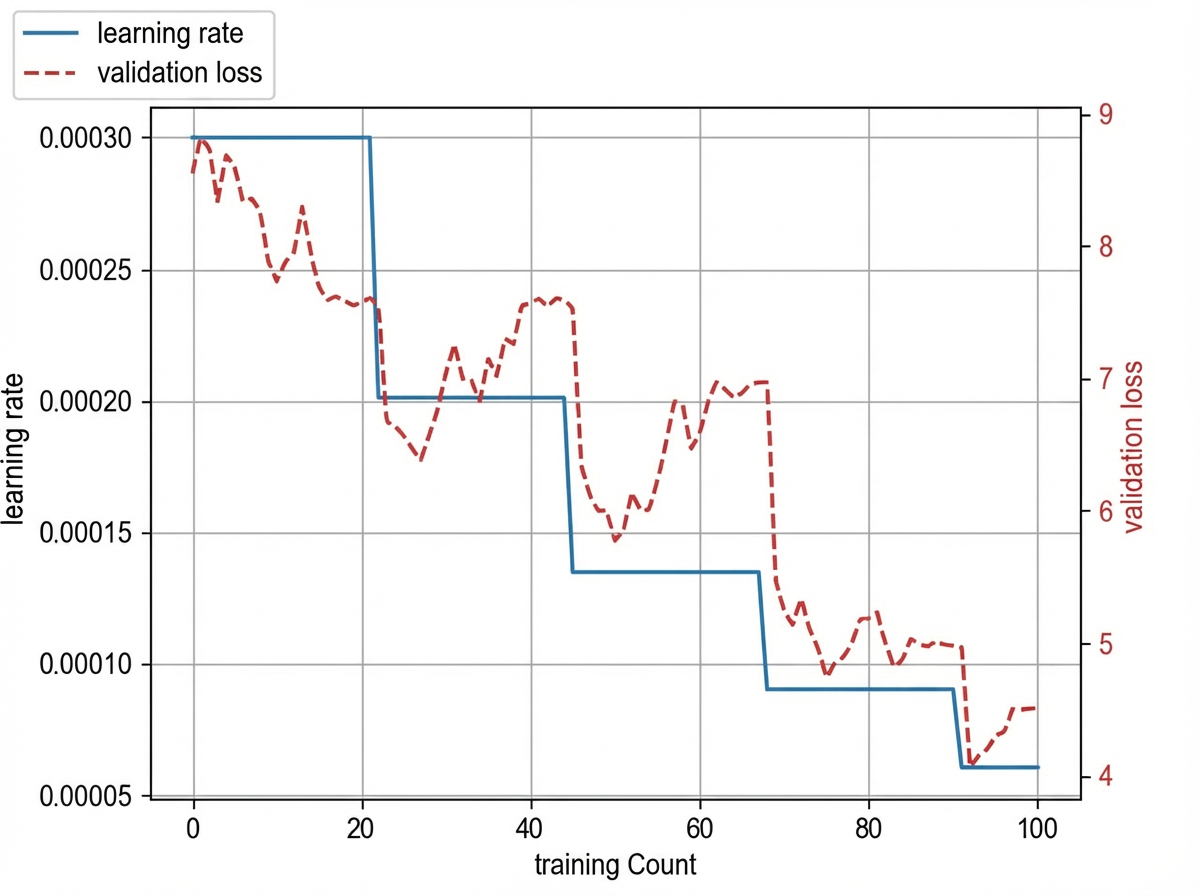 |
Etapa 3: Selecione dados de treinamento
Para dicas de construção de conjuntos de dados, consulte Dataset construction tips. Para carregar conjuntos de dados de ajuste fino, acesse a página Data Management.
Na seção Data Configuration, configure o seguinte:
- Conjunto de treinamento: Suporta dois métodos — Dataset Selection e Dataset Mounting. Dataset Selection usa conjuntos de dados de ajuste fino carregados anteriormente. Dataset Mounting monta diretamente arquivos de dados do OSS.
- Treinamento misto: Quando ativado, permite adicionar um conjunto de dados de treinamento misto adicional. O treinamento misto preserva as capacidades gerais do modelo durante o ajuste fino, evitando que ele perca a capacidade geral de conversação por overfitting em dados específicos da tarefa. Ative essa opção se tiver dados de vários cenários de negócios.
- Conjunto de validação: Suporta Auto Split e Dataset Selection. Auto Split seleciona aleatoriamente 10% dos dados de treinamento como conjunto de validação. Você também pode carregar um conjunto de dados de validação separado. O conjunto de validação avalia o desempenho do modelo durante o treinamento, mostrando Validation Loss e Validation Token Accuracy.
Etapa 4: Configure recursos de treinamento
Na seção Training Resource Configuration, selecione um método de faturamento para o trabalho de treinamento.
- Faturamento baseado em tokens: Usa recursos ociosos compartilhados. Faturado pelo número de tokens consumidos durante o treinamento. A velocidade do treinamento depende da disponibilidade de recursos e pode envolver filas.
Etapa 5: Saída do treinamento
As configurações a seguir aplicam-se ao treinamento SFT, DPO e CPT.
- Model Name: Defina o nome para o modelo de saída. Após a conclusão do treinamento, o checkpoint final é publicado automaticamente em My Models com este nome.
- Max Snapshots: Defina o número máximo de checkpoints a serem retidos.
- Checkpoint Interval: Defina a frequência de salvamento dos checkpoints — por época (ciclos de treinamento) ou etapa (etapas de treinamento).
- Model Encryption (Atualização de Segurança): Quando ativado, a plataforma criptografa os arquivos do modelo usando criptografia do lado do servidor OSS (SSE-OSS) com chaves totalmente gerenciadas. Algoritmo de criptografia: AES256.
Etapa 6: Treine o modelo
Clique em Start Training > Confirme o Model Fine-tuning Billing Notice > O treinamento começa.
Se encontrar permissões insuficientes, consulte: What to do if you lack permissions for model fine-tuning?Durante o treinamento, clique no botão Logs para visualizar os logs de treinamento em tempo real. Acesse também a aba Metrics para monitorar Training Loss, Validation Loss ou Validation Token Accuracy. Após a conclusão do treinamento, verifique a tendência entre Training Loss e Validation Loss.
-
Se o Training Loss diminuir enquanto o Validation Loss aumentar, o modelo está sofrendo overfitting. O treinamento provavelmente falhou ou produziu resultados ruins. Aplique as seguintes otimizações (em ordem de recomendação) e retreine:
- Use aumento de dados para aumentar a diversidade e o volume de dados.
- Colete mais dados de treinamento para aumentar a diversidade e o volume.
- Ajuste hiperparâmetros: reduza épocas, diminua a taxa de aprendizado, reduza o tamanho do lote, aumente o decaimento de peso, eleve o LoRA dropout ou aumente a taxa de aquecimento.
-
Se o Training Loss mostrar pouca mudança ou aumentar (raro), o modelo está sofrendo underfitting. O treinamento falhou. Aplique as seguintes otimizações (em ordem de recomendação) e continue o treinamento:
- Verifique a qualidade dos dados e garanta uma limpeza minuciosa.
- Ajuste hiperparâmetros: aumente épocas, eleve a taxa de aprendizado, aumente o tamanho do lote, diminua o decaimento de peso, reduza o LoRA dropout ou diminua a taxa de aquecimento.
- Se nenhum dos problemas ocorrer, prossiga para as próximas etapas.
Etapa 7: Publique o modelo para implantação
Apenas o ajuste fino SFT suporta a publicação de snapshots intermediários do modelo.Após a conclusão do treinamento, o checkpoint final é publicado automaticamente em My Models com o nome configurado em Step 5: Training output. Para publicar um checkpoint intermediário, acesse a aba Outputs na página de detalhes do trabalho de treinamento. Visualize a lista de checkpoints salvos, selecione o checkpoint desejado e clique em Publish Model. A aba Outputs mostra: ID do Checkpoint, informações de salvamento, status de publicação, nome do modelo, tempo restante de retenção, hora de criação e ações.
Etapa 8: Implante o modelo
Acesse a página My Models para encontrar rapidamente os modos de implantação suportados, ID do modelo e outros detalhes. Após a implantação, avalie seu modelo ajustado. Para detalhes de implantação, consulte Model deployment.
Etapa 9: Avalie o modelo
Use o recurso Model Evaluation do Alibaba Cloud Model Studio para avaliar o desempenho do seu modelo personalizado. Para detalhes, consulte Help Center: Model evaluation overview.
FAQ
Quando devo usar o ajuste fino de modelos?
-
Embora o ajuste fino de modelos de geração de texto possa alcançar excelentes resultados em cenários de negócios específicos, ele apresenta as seguintes limitações:
- Demorado: Isso inclui a criação de um conjunto de dados CPT em grande escala (pelo menos 50 milhões de tokens), a construção de um conjunto de dados SFT eficaz (mais de 1.000 entradas), a coleta de casos problemáticos suficientes (mais de 100) para construir um conjunto de dados DPO eficaz para model deployment billing, e a lentidão das iterações de otimização do modelo.
- Alto custo: Um modelo ajustado só pode ser usado após a implantação, e o model deployment billing é alto.
-
O Alibaba Cloud Model Studio recomenda tentar primeiro usar Prompt Engineering ou Function Calling para personalizar sua aplicação. O ajuste fino de modelos geralmente é o "último recurso" para melhorar o desempenho do modelo. Isso ocorre porque:
- Em muitas tarefas, um modelo pode inicialmente ter um desempenho ruim, mas a aplicação das técnicas corretas de prompt pode melhorar os resultados sem exigir ajuste fino do modelo.
- Otimizar iterativamente prompts e plugins é mais ágil e econômico do que as iterações de ajuste fino do modelo, pois o ajuste fino pode exigir recoleta, limpeza e otimização de dados, coleta de casos problemáticos e realização de pesquisas com clientes.
- Mesmo que decida realizar o ajuste fino do modelo, o trabalho inicial em engenharia de prompts e otimização de plugins não será desperdiçado. Esse trabalho preliminar pode ser totalmente reutilizado na construção do conjunto de dados de ajuste fino.
O que devo fazer se receber um erro de permissão durante o ajuste fino do modelo?
Entre em contato com o administrador da plataforma ou do espaço de trabalho para verificar e conceder as seguintes permissões:
- Sua conta deve ter permissões de página para Model Fine-tuning – Operation, Model Deployment – Operation e Model Evaluation – Operation no espaço de trabalho onde executa trabalhos de ajuste fino. Para detalhes, consulte: Account permission management. Link do console: Model Studio – Account Management.
- O espaço de trabalho onde executa trabalhos de ajuste fino deve ter permissões de Model Training (ajuste fino) para o modelo específico. Para detalhes, consulte: Grant sub-workspaces model invocation, training, and deployment permissions. Link do console: Model Studio – Workspace Management. Na página Model List em Business Space Management, confirme se a coluna Model Training do modelo alvo (por exemplo, Qwen3-8B) mostra o status Authorized.
O que devo fazer se os resultados da avaliação forem ruins após o ajuste fino?
- Se estiver usando avaliação manual, verifique se seus critérios de avaliação correspondem ao seu negócio ou cenário.
- Colete casos de teste com resultados de avaliação ruins, analise por que falharam e ajuste seu conjunto de dados de treinamento adequadamente. Em seguida, itere no ajuste fino.
- Gere exemplos DPO a partir de casos mal avaliados e execute o treinamento DPO.
Posso baixar um modelo ajustado no Alibaba Cloud Model Studio para implantação local?
Modelos ajustados no Alibaba Cloud Model Studio não podem ser exportados. Eles só podem ser testados e invocados após a implantação no Model Studio.
O que devo fazer se o ajuste fino do modelo falhar devido a dados de treinamento insuficientes?
Se o ajuste fino falhar por causa de dados insuficientes, tente ajustar o parâmetro Sequence Length (max_length).
Explicação
O comprimento da sequência define o comprimento máximo de tokens por amostra de treinamento. No SFT (Supervised Fine-Tuning), amostras que excedem esse comprimento são descartadas. Se o comprimento da sequência for muito grande, muitas amostras podem ser descartadas, deixando dados insuficientes para o treinamento e causando falha.
Solução
- Ao criar um trabalho de treinamento, expanda Parameter Settings e localize max_length (Sequence Length).
- Reduza o comprimento da sequência (por exemplo, para 8192) para que mais amostras atendam ao requisito de comprimento e participem do treinamento.
- Reenvie o trabalho de treinamento.
O que devo fazer se o modelo ajustado ainda responder com a identidade do modelo base no Playground?
A página Playground no console Model Studio não suporta a definição de um prompt de sistema. Como resultado, as configurações de identidade dos seus dados de ajuste fino não podem entrar em vigor, e o modelo responde como o modelo base.
Para verificar suas configurações de identidade ajustadas, use um dos seguintes métodos:
- Método 1: Chame o modelo através da API e inclua o parâmetro
systemna solicitação para passar o prompt de sistema. - Método 2: Use a página Model Debugging no console Model Studio para definir um prompt de sistema antes de testar.