

Alibaba Cloud Model Studio menyediakan model pembuatan video untuk pembuatan umum (text-to-video, image-to-video, reference-to-video, pengeditan video) dan skenario vertikal (sinkronisasi bibir manusia digital, image-to-action, penukaran karakter video, pembuatan emoji).
watermark yang secara default bernilai false (tanpa watermark). Untuk informasi lebih lanjut, lihat Referensi API text-to-video Wan 2.7 dan Referensi API image-to-video Wan 2.7.
Ikhtisar model
Pemilihan model
-
Pembuatan video umum
- Untuk menghasilkan video dari prompt teks, gunakan Wan - text-to-video.
- Untuk menghasilkan cuplikan sinematik dari satu gambar, gunakan Wan - image-to-video - frame pertama.
- Untuk mengontrol transisi antara gambar awal dan akhir, gunakan Wan - image-to-video - frame pertama dan terakhir.
- Untuk mereplikasi penampilan dan suara karakter dari video referensi agar sesuai dengan naskah baru, gunakan Wan - reference-to-video.
-
Sinkronisasi bibir manusia digital: Menganimasikan foto statis agar berbicara, bernyanyi, atau bercerita — latar belakang tetap diam sementara wajah, kepala, dan tubuh bergerak.
- Untuk hasil paling alami, termasuk ekspresi wajah, gerakan kepala, dan tubuh, gunakan Wan - manusia digital. Model ini menggantikan EMO.
- Untuk video lebih dari 20 detik dengan gerakan kepala sederhana, seperti laporan berita, gunakan LivePortrait.
- Transfer gerakan video: Fitur ini menjaga latar belakang foto tetap statis dan menganimasikan orang tersebut menggunakan gerakan dari video referensi. Gunakan Wan - image-to-action.
- Penukaran karakter video: Fitur ini mengganti orang dalam video dengan orang dari gambar sambil mempertahankan latar belakang aslinya. Gunakan Wan - penukaran karakter video.
- Penggantian tarian: Mengganti penari dalam video dengan orang dari gambar. Untuk kualitas terbaik, gunakan Wan - image-to-action dan Wan - penukaran karakter video. Jika anggaran terbatas, gunakan AnimateAnyone.
- Penggantian gerakan bibir video: Fitur ini mengganti gerakan bibir dalam video yang ada agar sesuai dengan audio baru. Gunakan VideoRetalk.
- Pembuatan emoji: Fitur ini membuat emoji menggunakan templat bergaya tetap. Gunakan Emoji.
- Penggambaran ulang video: Untuk menggunakan templat bergaya tetap, gunakan Transformasi gaya video. Untuk menggambarkan gaya secara bebas menggunakan prompt, gunakan Wan - pengeditan video.
-
Pengeditan video: Untuk semua tugas berikut, gunakan Wan - pengeditan video umum.
- Pengeditan video lokal: Ganti elemen seperti subjek atau pakaian, atau hapus orang yang tidak terlibat.
- Ekstensi video: Perpanjang video pendek, misalnya dari 1 detik menjadi 5 detik.
- Ekspansi bingkai video: Ubah video landscape menjadi mode portrait atau isi batas yang hilang.
- Pembuatan referensi multi-gambar: Gabungkan gambar latar belakang dan subjek untuk membuat video.
Model yang didukung
Wan - text-to-video
Menghasilkan video dari prompt teks. Mendukung input teks dan audio untuk membuat video multi-shot sinematik.
Referensi API | Harga model | Coba online: Singapura, Virginia, Beijing
- Global
- Internasional
- AS
- Tiongkok daratan
Model | Fitur | Modalitas input | Spesifikasi video output |
|---|---|---|---|
wan2.6-t2v | Video dengan audio Narasi multi-shot, sinkronisasi audio-video | Teks, audio | Opsi resolusi: 720P, 1080P Durasi video: 5 s, 10 s, 15 s Spesifikasi tetap: 30 fps, MP4 (encoding H.264) |
| Input prompt | Video output (wan2.6, video multi-shot) |
|---|---|
| Direkam dari sudut rendah, dalam close-up medium, dengan nada hangat, pencahayaan campuran (cahaya praktis dari lampu meja menyatu dengan cahaya mendung dari jendela), pencahayaan samping, dan komposisi sentral. Di kantor detektif klasik, rak buku kayu dipenuhi berkas kasus lama dan asbak. Lampu meja hijau menerangi berkas kasus yang tersebar di tengah meja. Seekor rubah, mengenakan mantel trench coklat tua dan fedora abu-abu muda, duduk di kursi kulit, bulunya merah, ekornya bertumpu ringan di tepi, jarinya perlahan membalik halaman kuning. Di luar, hujan rintik-rintik turun di bawah langit biru, menggores kaca dengan alur berkelok-kelok. Perlahan ia mengangkat kepalanya, telinganya bergerak sedikit, matanya yang kuning menatap langsung ke kamera, mulutnya bergerak jelas saat berbicara dengan suara halus dan sinis: 'Kasus itu dingin, lebih dingin dari ikan di musim dingin. Tapi setiap ayam punya rahasia, dan aku, untuk satu hal, berniat menemukannya.' |
Wan - image-to-video
Model image-to-video Wan ditingkatkan dengan input multimodal (teks/gambar/audio/video) dan mendukung tiga tugas: frame-pertama-ke-video, frame-pertama-dan-terakhir-ke-video, dan kelanjutan video.
Referensi API | Harga model | Panduan prompt
- Internasional
- Tiongkok Daratan
Model | Features | Input modality | Output video specifications |
|---|---|---|---|
wan2.7-i2v-2026-04-25 | Video with audio First-frame-to-video, first-and-last-frame-to-video, video continuation, video continuation with last frame control Multi-shot narrative, audio-video synchronization | Text, image, audio, video | Pilihan resolusi: 720P, 1080P Durasi video: [2s, 15s] (bilangan bulat) Spesifikasi tetap: 30 fps, MP4 (H.264 encoding) |
wan2.7-i2v | Video with audio First-frame-to-video, first-and-last-frame-to-video, video continuation, video continuation with last frame control Multi-shot narrative, audio-video synchronization | Text, image, audio, video | Pilihan resolusi: 720P, 1080P Durasi video: [2s, 15s] (bilangan bulat) Spesifikasi tetap: 30 fps, MP4 (H.264 encoding) |
Wan - image-to-video - frame pertama
Menghasilkan video dari gambar frame pertama yang ditentukan. Model ini menerima teks, gambar frame pertama, dan audio sebagai input untuk menghasilkan video multi-shot sinematik.
Referensi API | Harga model | Coba online: Singapura, Virginia, Beijing
- Global
- Internasional
- AS
- Tiongkok Daratan
Model | Fitur | Modalitas input | Spesifikasi video output |
|---|---|---|---|
wan2.6-i2v | Video dengan audio Narasi multi-shot, sinkronisasi audio-video | Teks, gambar, audio | Opsi resolusi: 720P, 1080P Durasi video: 5 s, 10 s, 15 s Spesifikasi tetap: 30 fps, MP4 (encoding H.264) |
| Prompt input | Gambar frame pertama input dan audio | Video hasil (WAN2.6, video multi-bidikan) |
|---|---|---|
| Sebuah adegan seni fantasi urban. Karakter seni grafiti yang dinamis. Seorang remaja yang terbuat dari cat semprot hidup dari dinding beton. Ia melakukan rap bahasa Inggris dengan kecepatan tinggi sambil mengambil pose rapper klasik yang energetik. Adegan ini berlatar di bawah jembatan kereta api perkotaan pada malam hari. Pencahayaan berasal dari satu lampu jalan, menciptakan suasana sinematik dengan energi tinggi dan detail luar biasa. Audio video sepenuhnya terdiri dari rap-nya, tanpa dialog atau kebisingan lainnya. | 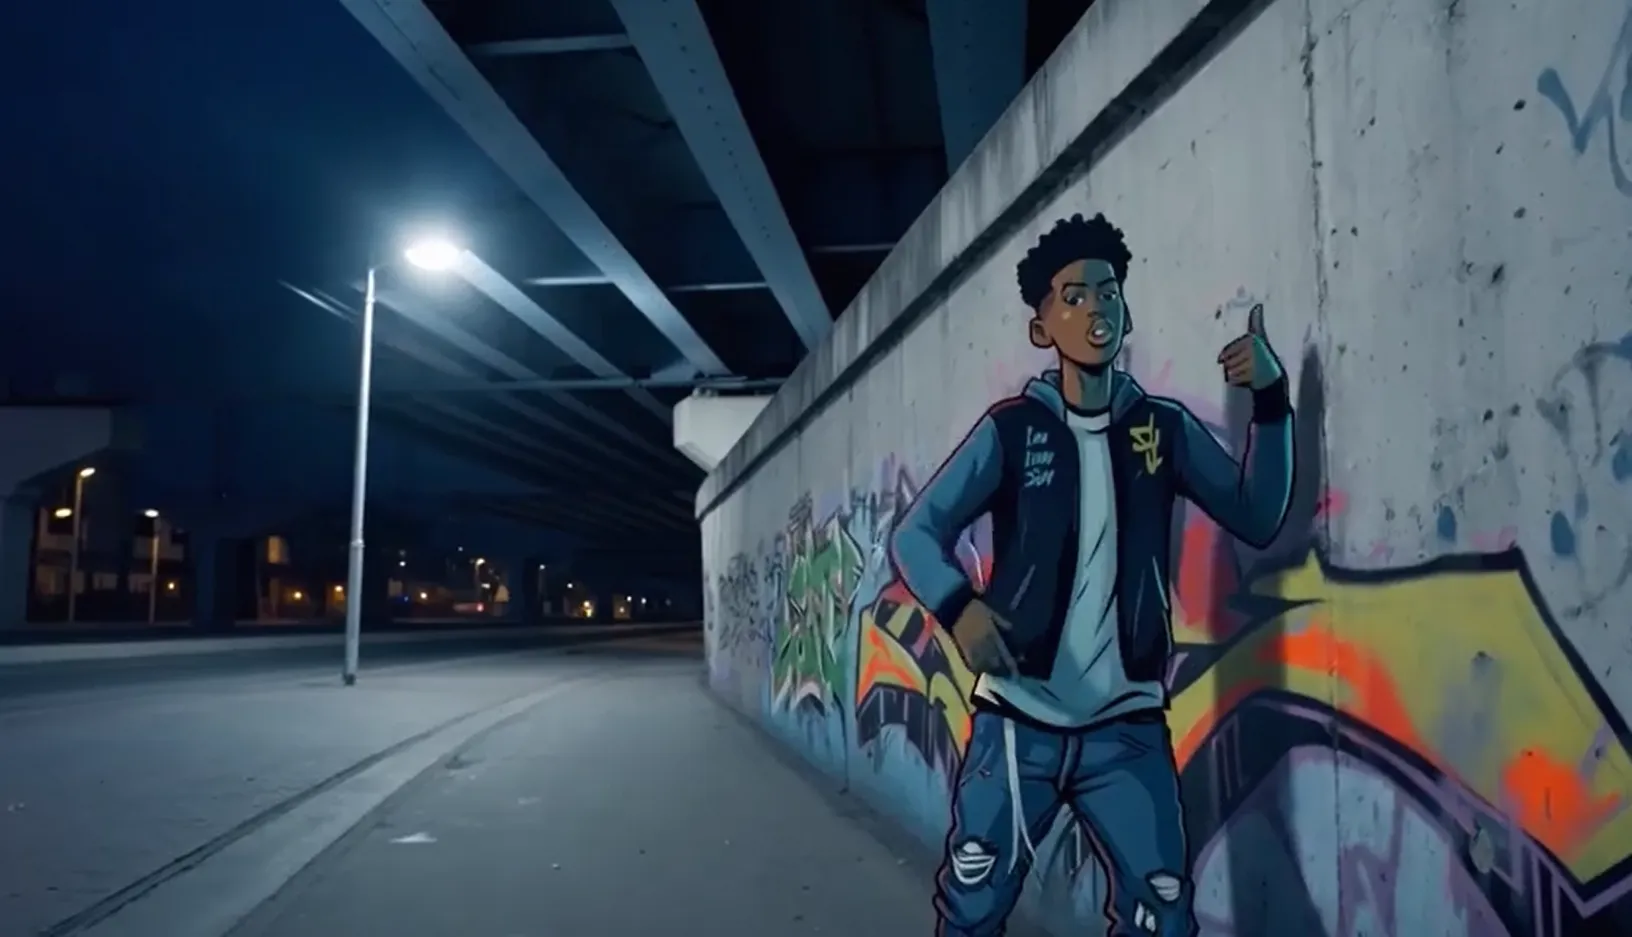 Audio input: |
Wan - image-to-video - frame pertama dan terakhir
Menghasilkan video yang secara mulus bertransisi antara gambar frame pertama dan frame terakhir yang ditentukan. Model ini menerima teks, gambar frame pertama dan terakhir, serta audio sebagai input untuk menghasilkan video multi-shot sinematik.
Referensi API | Harga model | Coba online
- Internasional
- Tiongkok Daratan
| Model | Fitur | Modalitas input | Spesifikasi video output |
|---|---|---|---|
wan2.2-kf2v-flash Direkomendasikan | Video tanpa suaraStabilitas dan tingkat keberhasilan lebih baik dibandingkan model 2.1. | Teks, gambar | Opsi resolusi: 480P, 720P, 1080PDurasi video: 5 detikSpesifikasi tetap: 30 fps, MP4 (encoding H.264) |
| wan2.1-kf2v-plus | Video tanpa suara | Teks, gambar | Opsi resolusi: 720PDurasi video: 5 detikSpesifikasi tetap: 30 fps, MP4 (encoding H.264) |
| Gambar frame pertama input | Input gambar bingkai terakhir | Input prompt | Video output |
|---|---|---|---|
 |  | Gaya realistis. Seekor kucing hitam kecil menatap langit dengan rasa ingin tahu. Kamera mulai dari ketinggian mata, secara bertahap naik, dan berakhir dengan bidikan dari atas ke bawah terhadap tatapan ingin tahu kucing tersebut. |
Wan - reference-to-video
Memainkan aksi karakter dari video yang ditentukan. Input video dan prompt teks untuk menghasilkan video output yang mempertahankan konsistensi karakter.
Referensi API | Harga model
- Global
- Internasional
- Tiongkok daratan
Model | Fitur | Modalitas input | Spesifikasi video output |
|---|---|---|---|
wan2.6-r2v | Video dengan audio Generasi video peran tunggal/multi-peran Narasi multi-shot, sinkronisasi audio-video | Teks, video | Opsi resolusi: 720P, 1080P Durasi video: 5 s, 10 s Spesifikasi tetap: 30 fps, MP4 (encoding H.264) |
| Video referensi input 1 (peran: gadis kecil) | Video referensi input 2 (peran: jam alarm) | Prompt input | Video keluaran (dialog multi-peran) |
|---|---|---|---|
| character1 berkata kepada character2: “Aku akan mengandalkanmu besok pagi!” character2 menjawab: “Kamu bisa mengandalkanku!” |
Wan - pengeditan video
Model pengeditan video. Menerima input multimodal teks, gambar, dan video untuk melakukan berbagai tugas pembuatan dan pengeditan video.
Referensi API pengeditan video 2.7 | Referensi API pengeditan video 2.1 | Harga model
- Internasional
- Tiongkok Daratan
Model | Fitur | Modalitas input | Spesifikasi video output |
|---|---|---|---|
wan2.7-videoedit | Video dengan audio, video tanpa suara (tergantung video input) Pengeditan berbasis instruksi, migrasi video | Teks, gambar, video | Opsi resolusi: 720P, 1080P Durasi video: [2 s, 10 s] (integer) Spesifikasi tetap: 30 fps, MP4 (encoding H.264) |
wan2.1-vace-plus | Video tanpa suara Referensi multi-gambar, penggambaran ulang video, pengeditan lokal, ekstensi video, ekspansi bingkai video | Teks, gambar, video | Opsi resolusi: 720P Durasi video: Hingga 5 detik Spesifikasi tetap: 30 fps, MP4 (encoding H.264) |
Pengeditan video 2.1
Pengeditan video 2.1
-
Fitur 1: Referensi multi-gambar
Gambar referensi input 1 (entitas referensi) Gambar referensi input 2 (latar belakang referensi) Input prompt Video output 

Video menunjukkan seorang gadis berjalan anggun keluar dari kedalaman hutan berkabut kuno. Langkahnya ringan, dan kamera menangkap setiap momen lincahnya. Saat ia berhenti dan melihat sekeliling hutan yang rimbun, senyum kejutan dan sukacita mekar di wajahnya. Momen ini, membeku dalam interaksi cahaya dan bayangan, merekam pertemuannya yang indah dengan alam. -
Fitur 2: Penggambaran ulang video
Video input Masukkan prompt Video output Video menunjukkan sebuah mobil hitam bergaya steampunk, dikendarai seorang pria, dihiasi roda gigi dan pipa tembaga. Latar belakangnya adalah pabrik permen berbasis uap dengan elemen retro, menciptakan adegan vintage dan menyenangkan. -
Fitur 3: Pengeditan video lokal
Video input Gambar mask input (area putih menunjukkan area pengeditan) Input prompt Video output 
Video menunjukkan kafe Prancis bergaya Paris di mana seekor singa berjas dengan elegan menyesap kopi. Ia memegang cangkir kopi di satu tangan, menyesap dengan lembut dengan ekspresi puas. Kafenya didekorasi dengan selera tinggi, dengan warna lembut dan pencahayaan hangat menerangi area tempat singa tersebut berada. -
Fitur 4: Ekstensi video
Input first video segment (1s) Input prompt Output video (extended video is 5s) Seekor dog wearing sunglasses skateboards on a street, 3D cartoon. -
Fitur 5: Ekspansi bingkai video
Video input Prompt input Video output Seorang wanita elegan bermain biola dengan penuh semangat, dengan orkestra simfoni lengkap di belakangnya.
Wan - manusia digital
Model | Features | Input modality | Output description |
|---|---|---|---|
wan2.2-s2v-detect | Image detection | Image | Status deteksi output: Pass atau Fail |
wan2.2-s2v | Video generation Video with audio | Image, audio | Opsi resolusi: 480P, 720P Durasi video: Hingga 20 detik (mengikuti durasi audio) Spesifikasi yang ditentukan:
|
| Contoh input (gambar karakter + audio) | Video output (sinkronisasi bibir) |
|---|---|
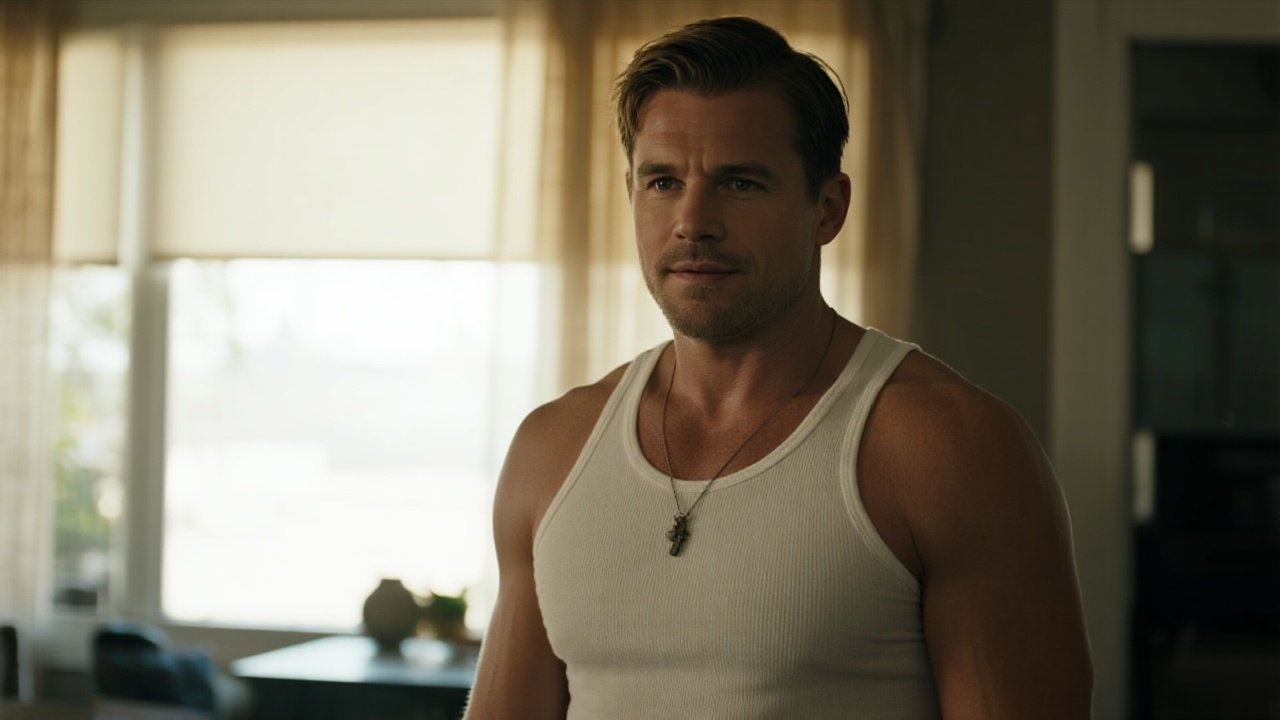 |
Wan - image to action
Menganimasikan seseorang dari gambar menggunakan gerakan dari video referensi. Anda memberikan gambar dan video, dan model menghasilkan video yang menerapkan gerakan dari video referensi ke orang tersebut, sementara latar belakang gambar asli tetap statis.
Referensi API | Harga model
- Internasional
- Tiongkok daratan
Model | Fitur | Modalitas input | Spesifikasi video output |
|---|---|---|---|
wan2.2-animate-move | Video dengan audio, video tanpa suara (tergantung pada video input)
| Image, video | Opsi resolusi: 720P Durasi video: 2s < duration < 30s Spesifikasi yang ditetapkan:
|
| Gambar karakter input | Video referensi input | Video output (mode standarwan-std) | Video output (mode profesionalwan-pro) |
|---|---|---|---|
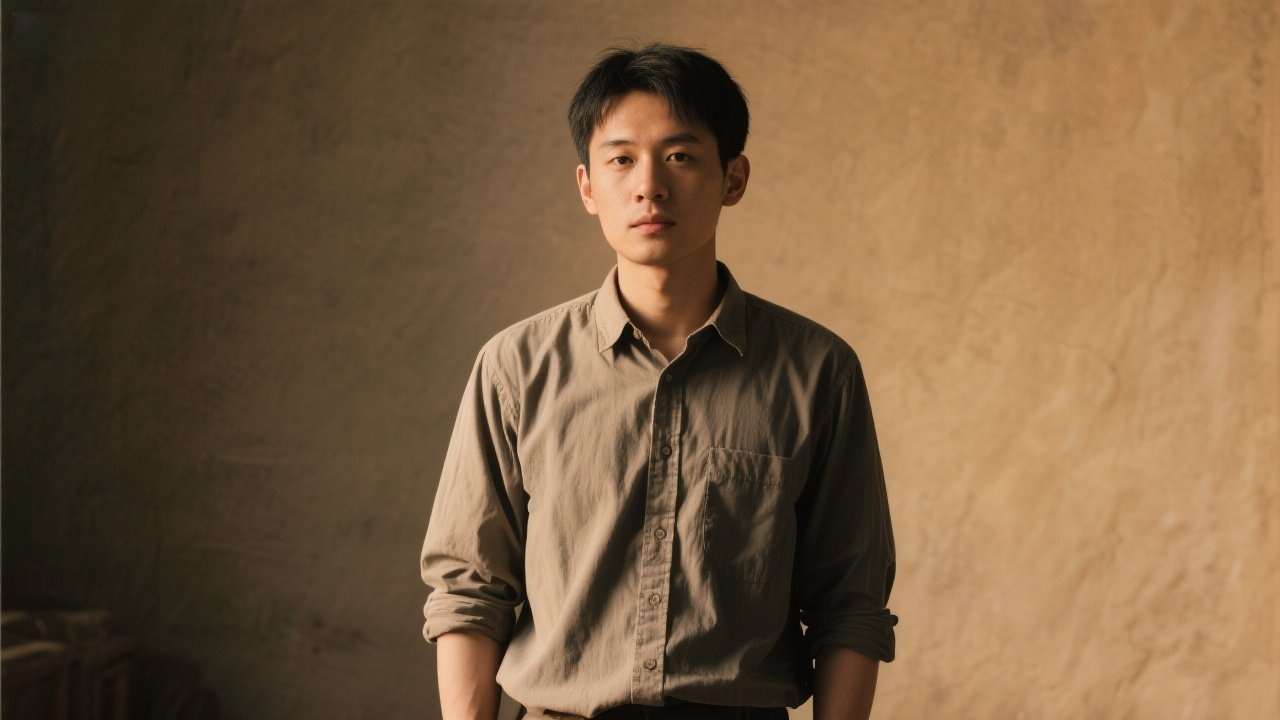 |
Wan - penukaran karakter video
Mengganti karakter dalam video dengan karakter dari gambar referensi. Anda memberikan video sumber dan gambar referensi, dan model menghasilkan video output yang mempertahankan latar belakang asli. Fitur ini ideal untuk kasus penggunaan seperti penukaran wajah dan penggantian karakter penuh.
Referensi API | Harga model
- Internasional
- Tiongkok daratan
Model | Fitur | Modalitas input | Spesifikasi video output |
|---|---|---|---|
wan2.2-animate-mix | Video dengan audio, video tanpa suara (tergantung video input)
| Gambar, video | Opsi resolusi: 720P Durasi video: 2 s < Durasi < 30 s Spesifikasi yang ditentukan:
|
| Video input | Gambar karakter input untuk penggantian | Video output (mode standarwan-std) | Video output (mode profesionalwan-pro) |
|---|---|---|---|
|
AnimateAnyone
- Hanya cakupan penerapan layanan Tiongkok daratan yang didukung. Penyimpanan data berada di wilayah akses Beijing. Sumber daya komputasi inferensi model dibatasi hanya untuk Tiongkok daratan.
- Kami merekomendasikan menggunakan Wan - image-to-action dan Wan - penukaran karakter video sebagai ganti AnimateAnyone. Model-model ini menawarkan kualitas lebih baik, sedangkan AnimateAnyone adalah opsi yang lebih hemat biaya.
| Model | Fitur | Modalitas input | Deskripsi output |
|---|---|---|---|
| animate-anyone-detect-gen2 | Deteksi gambar | Gambar | Status deteksi output: Lulus atau Gagal |
| animate-anyone-template-gen2 | Generasi templat video tariMenyaring templat aksi dari video tari. | Video | Menghasilkan ID templat aksi tari. |
| animate-anyone-gen2 | Generasi videoVideo tanpa suara | Gambar, video, ID templat aksi tari | Opsi resolusi video: 720PDurasi video: 2 s ≤ durasi ≤ 60 sSpesifikasi tetap: 15 fps, MP4 (encoding H.264) |
| Gambar karakter input | Masukkan Video Tarian | Video output (dihasilkan dengan latar belakang gambar) | Video output (dihasilkan dengan latar belakang video) |
|---|---|---|---|
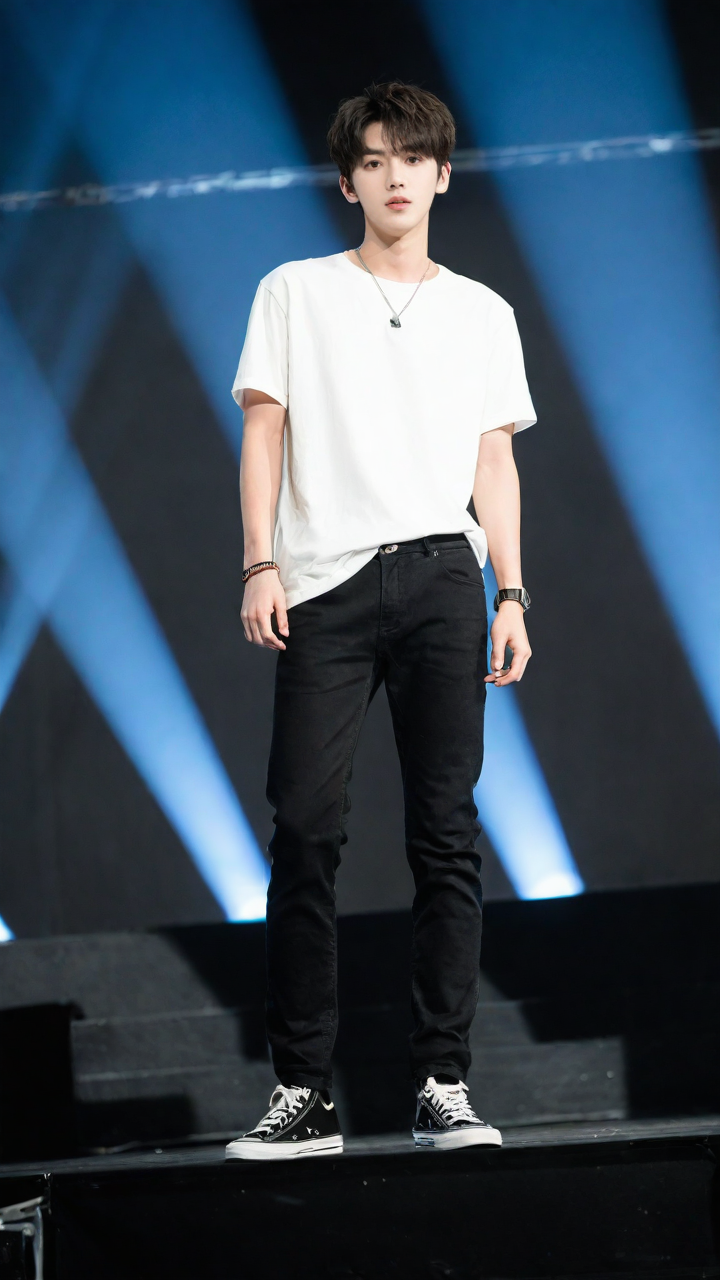 |
EMO
- Hanya cakupan penerapan layanan Tiongkok daratan yang didukung. Penyimpanan data berada di wilayah akses Beijing. Sumber daya komputasi inferensi model dibatasi hanya untuk Tiongkok daratan.
- Pertimbangkan untuk menggunakan Wan - manusia digital sebagai alternatif untuk EMO. Wan - manusia digital memberikan hasil yang lebih baik, sedangkan EMO adalah opsi yang lebih hemat biaya.
Model | Fitur | Modalitas input | Deskripsi output |
|---|---|---|---|
emo-detect-v1 | Deteksi gambar | Gambar | Status deteksi output: Lulus atau Gagal |
emo-v1 | Generasi video Video dengan audio | Gambar, audio | Resolusi video:
Durasi video: hingga 60 detik Spesifikasi tetap: 15 fps, MP4 (encoding H.264) |
| Contoh input (gambar potret + audio) | Video Output (Lip-Sync Bernyanyi) |
|---|---|
 Audio input: |
LivePortrait
- Hanya cakupan penerapan layanan Tiongkok daratan yang didukung. Penyimpanan data berada di wilayah akses Beijing. Sumber daya komputasi inferensi model dibatasi hanya untuk Tiongkok daratan.
- Pertimbangkan untuk menggunakan Wan - manusia digital sebagai alternatif untuk LivePortrait. Wan - manusia digital memberikan hasil kualitas lebih tinggi, sedangkan LivePortrait adalah opsi yang lebih hemat biaya. Perhatikan bahwa LivePortrait cocok untuk menghasilkan video panjang (lebih dari 20 detik).
Model | Features | Input modality | Output description |
|---|---|---|---|
liveportrait-detect | Image detection | Image | Status deteksi output: Pass atau Fail |
liveportrait | Video generation Video with audio | Image, audio | Resolusi video: Mengikuti gambar input, hingga hampir 4K (4096 × 4096). Durasi video: 1s < durasi < 180s Laju frame video: 15 fps ≤ laju frame ≤ 30 fps Format video: MP4 (H.264 encoding) |
| Contoh input (gambar potret + audio) | Video output (pengisi suara sinkronisasi bibir) |
|---|---|
 Audio input: |
Emoji
Model | Fitur | Modalitas input | Deskripsi output |
|---|---|---|---|
emoji-detect-v1 | Deteksi gambar | Gambar | Status deteksi output: Lulus atau Gagal |
emoji-v1 | Generasi video Video tanpa suara | Gambar, ID templat emoji | Resolusi video: Tetap pada 512 × 512 Durasi video: Hingga 5 detik (mengikuti durasi templat) Spesifikasi tetap: 15 fps, MP4 (encoding H.264) |
| Masukkan gambar potret | Video output (emoji "jijik") |
|---|---|
 |
VideoRetalk
Model | Fitur | Modalitas input | Spesifikasi video output |
|---|---|---|---|
videoretalk | Video dengan audio | Video, audio | Resolusi video: Mengikuti video input, hingga hampir 2K (2048 × 2048). Durasi video: 2 s < Durasi < 120 s Laju frame video: 15 fps ≤ laju frame ≤ 60 fps Format video: MP4 (encoding H.264) |
| Contoh input (video siaran karakter + audio) | Video output (penggantian sinkronisasi bibir) |
|---|---|
| Audio input: |
Transformasi gaya video
| Model | Fitur | Modalitas input | Spesifikasi video output |
|---|---|---|---|
| video-style-transform | Video dengan audio, video tanpa suaraTergantung pada video input. | ID gaya penggambaran ulang video | Resolusi video: Mengikuti video input, hingga hampir 4K (4096 × 4096).Durasi video: Hingga 30 detikLaju frame video: 15 fps ≤ laju frame ≤ 25 fpsFormat video: MP4 (encoding H.264) |
| Video input | Video output (transfer gaya: "manga Jepang") |
|---|---|