

Saat menggunakan Wan untuk image generation , jika Text-to-video/image-to-video prompt guide tidak dapat memenuhi kebutuhan kustomisasi Anda untuk gaya tertentu, karakter IP, atau efek visual , gunakan model fine-tuning .
Scope
- Supported region: Dokumen ini hanya berlaku untuk wilayah Singapura. Anda harus menggunakan API key dari wilayah ini.
- Supported fine-tuning method: Fine-tuning efisien SFT-LoRA.
-
Supported models:
- Image generation (text-to-image/image-to-image): wan2.7-image-pro, wan2.7-image.
How to fine-tune a model
- Text-to-image
- Image-to-image
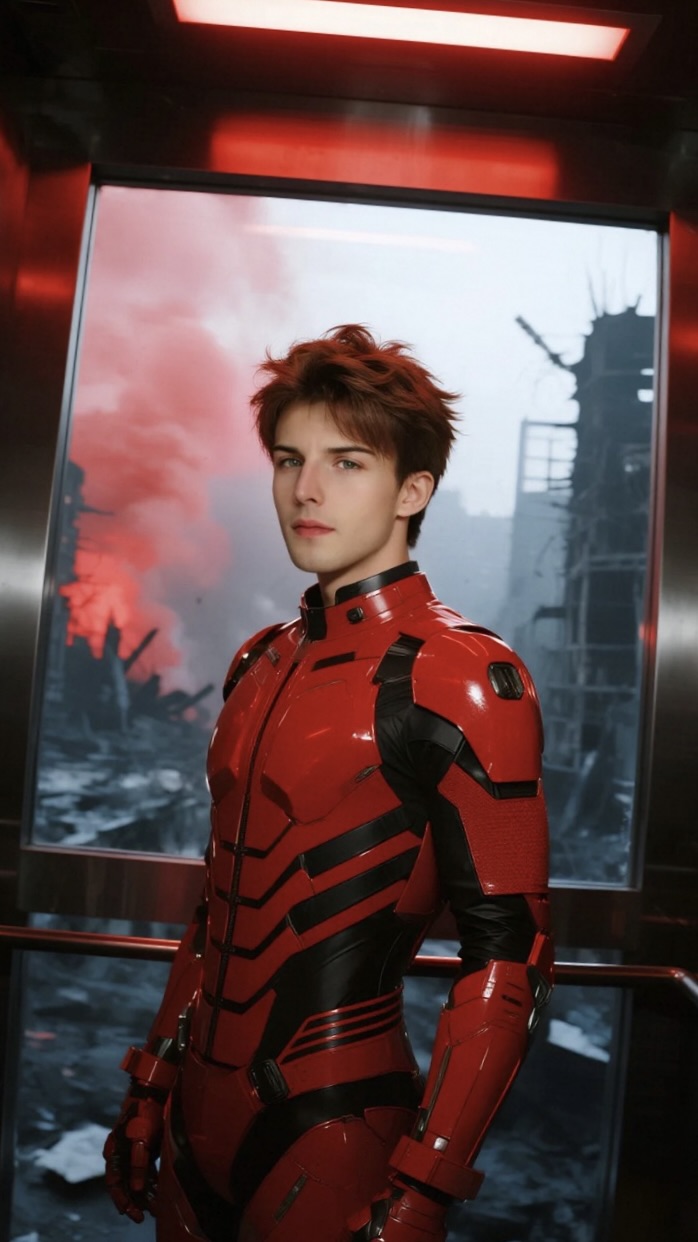
| Input promptA person in a crowded morning rush hour subway car, holding onto the handrail, with blurred passengers in the background and tunnel lights visible through the windows, wearing an ordinary office worker white shirt and black trousers, standing facing the camera, half-body shot, realistic candid feel. | Output image (before fine-tuning - text-to-image)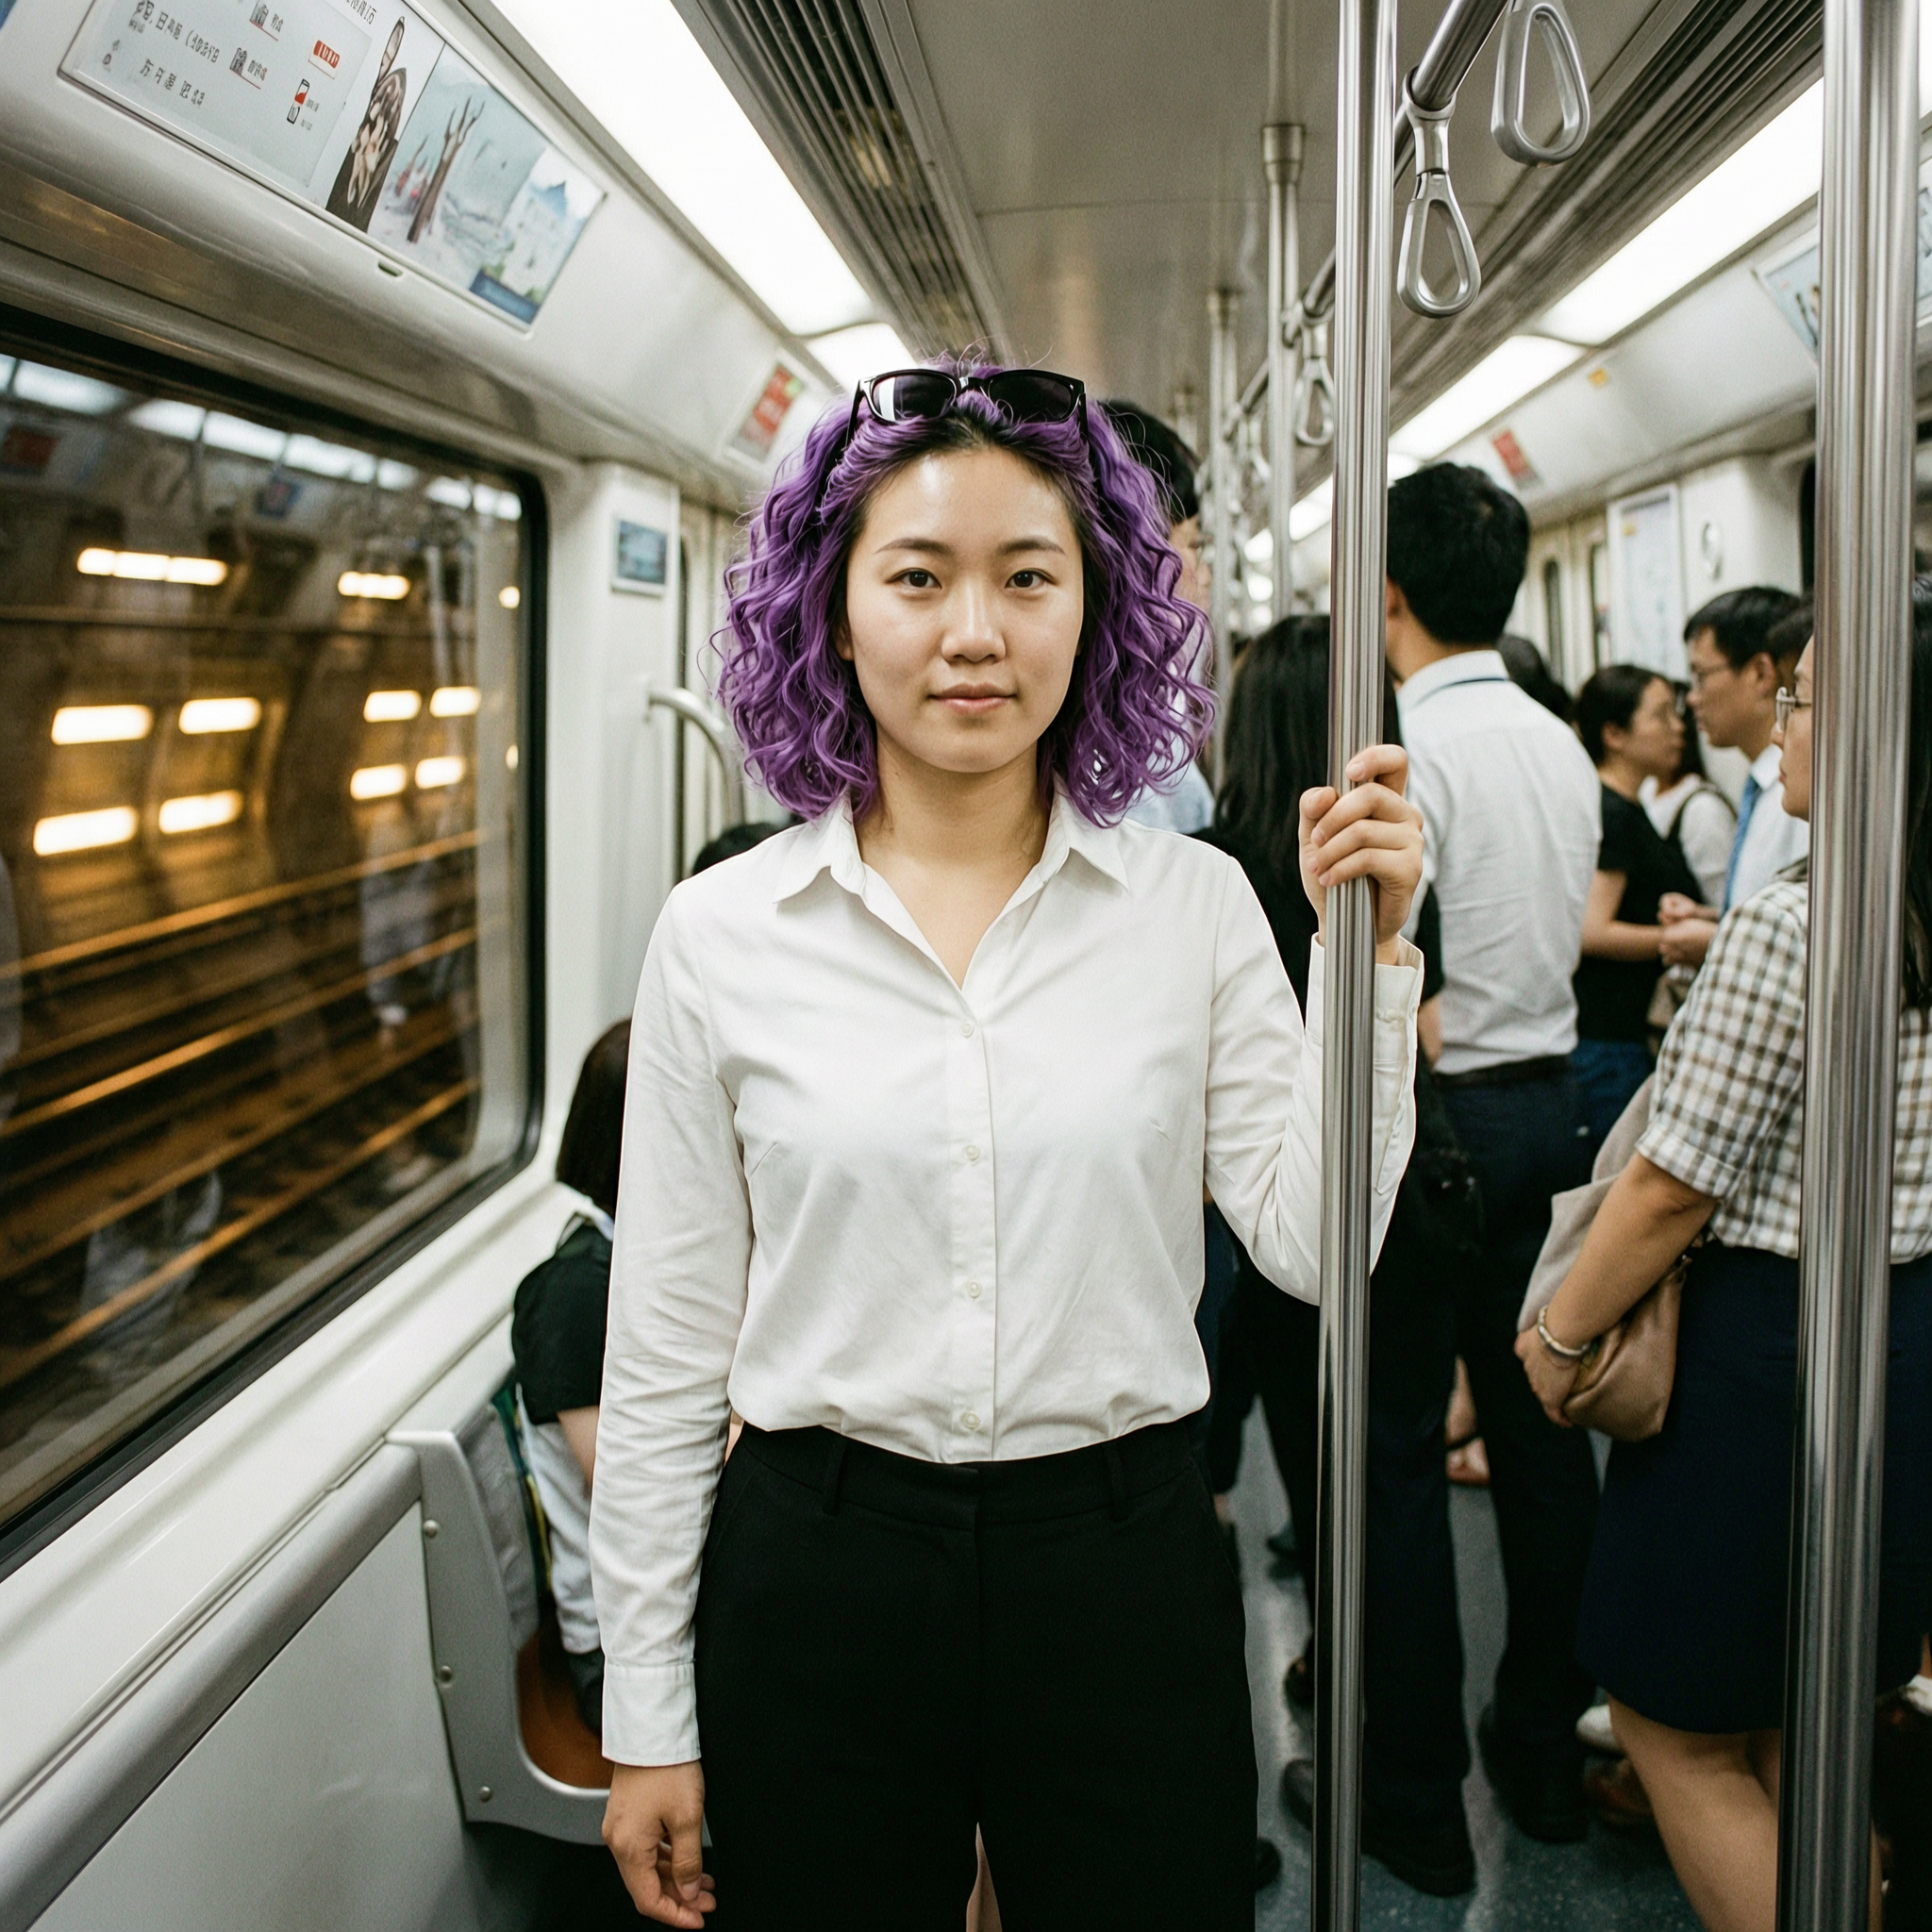 Tanpa gambar referensi, model tidak dapat menghasilkan karakter tertentu. | Output image (after fine-tuning)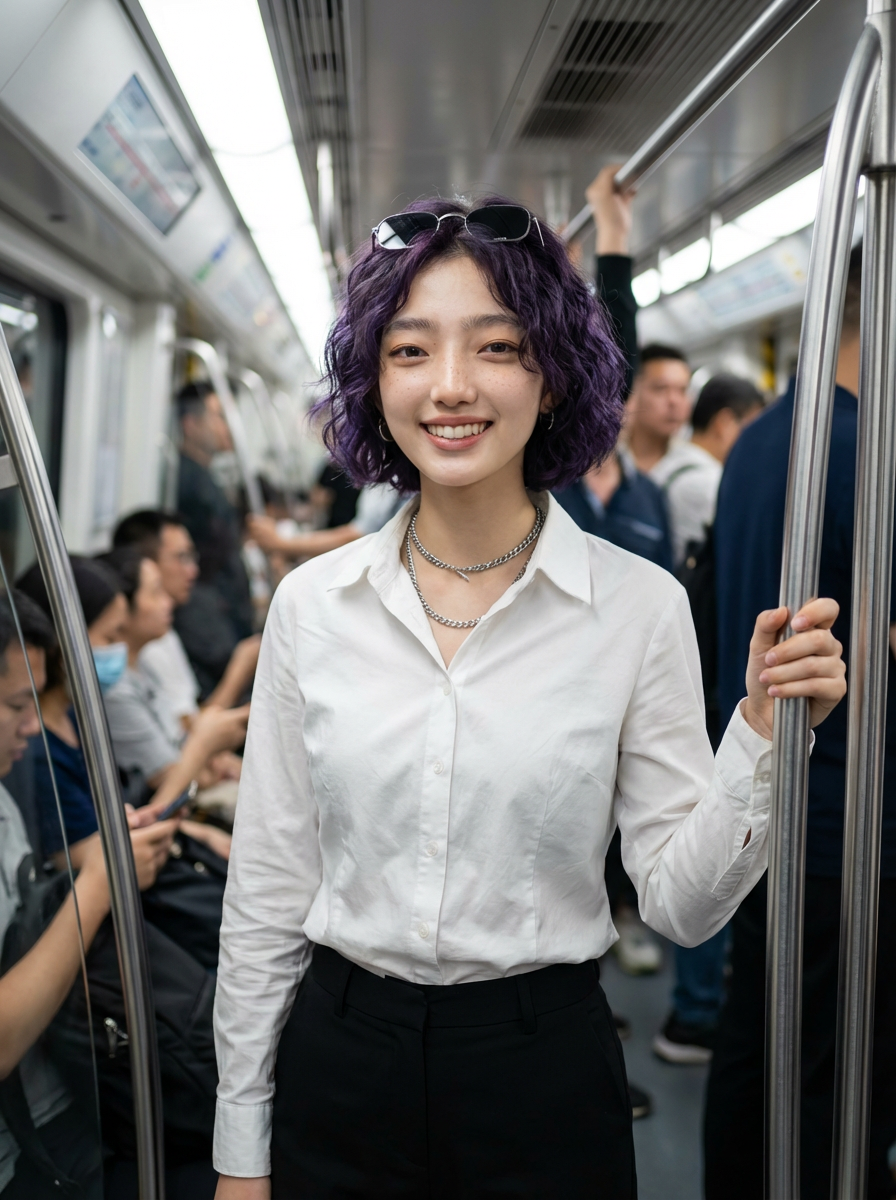 Setelah fine-tuning, model dapat mereproduksi karakter tertentu dari set pelatihan secara konsisten. |
Step 1: Upload the dataset
Unggah dataset lokal Anda (dalam format .zip) ke platform Alibaba Cloud Model Studio dan peroleh ID file (id).
Data pelatihan contoh: Untuk formatnya, lihat Training set.
- Image generation - text-to-image: wan-image-t2i-training-dataset.zip
- Image generation - image-to-image: wan-image-i2i-training-dataset.zip
Contoh ini menggunakan text-to-image dan hanya mengunggah set pelatihan. Sistem secara otomatis membagi sebagian dari set pelatihan sebagai set validasi.
id. Ini adalah pengidentifikasi unik untuk dataset yang diunggah.
Step 2: Fine-tune the model
Step 2.1: Create a fine-tuning job
Gunakan ID file dari Langkah 1 untuk memulai pekerjaan pelatihan. Request example Ganti<replace_with_training_dataset_file_id> dengan id yang diperoleh pada langkah sebelumnya. Untuk referensi parameter lengkap dan batasan format, lihat Hyperparameters.
Hyperparameters
Hyperparameters
Parameter | Type | Required | Description | Recommended value |
|---|---|---|---|---|
max_steps | int | Yes | Total training steps. Parameter inti yang menentukan jumlah total iterasi pelatihan. Kami merekomendasikan minimal 500 langkah untuk memastikan konvergensi model, dan nilai yang lebih tinggi untuk dataset yang lebih besar. | 800 |
eval_steps | int | Yes | Validation interval. Nilainya harus ≥ 0. Menentukan frekuensi (dalam langkah) evaluasi model selama pelatihan. Checkpoint juga disimpan pada setiap interval tersebut. | 200 |
learning_rate | float | Yes | tingkat pembelajaran. Mengontrol besarnya pembaruan bobot model. Nilai yang terlalu tinggi dapat menurunkan performa model, sedangkan nilai yang terlalu rendah mungkin menghasilkan perubahan yang tidak signifikan. Kami merekomendasikan menggunakan nilai default. | 3e-5 |
generation_type | string | Yes | generation mode. Gunakan | t2i |
max_pixels | string | Yes | Maximum resolution for training images. Misalnya, "1k" atau "2k" (1K = 1024×1024, 2K = 2048×2048). Menetapkan batas atas jumlah total piksel (lebar × tinggi) untuk gambar dalam set pelatihan. Sistem hanya mengecilkan gambar yang melebihi nilai ini; gambar di bawah batas tetap tidak berubah. Kami merekomendasikan menjaga konsistensi tiga parameter terkait resolusi ( | text-to-image: "2k" |
val_img_size | string | Yes | Validation image generation resolution. Misalnya, "1k" atau "2k" (1K = 1024×1024, 2K = 2048×2048). Resolusi target untuk gambar yang dihasilkan selama evaluasi validasi. | text-to-image: "2k" |
max_token_length | string | Yes | Maximum token length per step. Misalnya, "1k" atau "2k". Parameter ini, bersama dengan | text-to-image: "2k" |
gradient_clip | float | Yes | pemotongan gradien. Ambang batas untuk pemotongan norma gradien global di semua parameter yang dapat dilatih, digunakan untuk mencegah gradien meledak. Atur ke -1 untuk menonaktifkan pemotongan. | 0.5 |
weight_decay | float | Yes | weight decay. Koefisien weight decay terpisah untuk pengoptimal AdamW. Berlaku untuk semua parameter yang dapat dilatih dan digunakan untuk regularisasi guna mencegah overfitting. | 0.02 |
lora_rank | int | Yes | LoRA rank. Rank (dimensi) matriks low-rank LoRA. Nilai ini menentukan jumlah parameter yang dapat dilatih untuk fine-tuning. Nilai yang lebih besar meningkatkan kemampuan fitting model tetapi memperlambat pelatihan. Nilainya harus merupakan pangkat dari 2 (misalnya, 16, 32, 64). | 32 |
save_total_limit | int | No | Checkpoint save limit. Jumlah maksimum checkpoint model yang disimpan. Sistem hanya menyimpan N checkpoint terbaru, di mana N adalah nilai ini. | 10 |
split | float | No | Training set split ratio. Rentang nilainya (0, 1). Parameter ini hanya berlaku jika | 0.9 |
- Text-to-image (t2i): sekitar 77 menit untuk 300 langkah.
- Image-to-image (i2i): sekitar 110 menit untuk 300 langkah.
output:
job_id: ID pekerjaan, digunakan untuk menanyakan progres.finetuned_output: Nama model hasil fine-tuning. Anda harus menggunakan nama ini untuk penerapan dan pemanggilan selanjutnya.status: Status pelatihan. Setelah membuat pekerjaan fine-tuning, status awalnya adalah PENDING, yang menunjukkan bahwa pelatihan belum dimulai.
Step 2.2: Query the fine-tuning job status
Gunakanjob_id yang diperoleh pada Langkah 2.1 untuk menanyakan progres pekerjaan. Poll API berikut hingga status berubah menjadi SUCCEEDED.
Request example
Ganti <replace_with_fine_tuning_job_id> dalam URL dengan nilai job_id.
output:
status: Ketika nilainya berubah menjadi SUCCEEDED, pelatihan model selesai dan Anda dapat melanjutkan ke penerapan model.usage: Jumlah total token yang dikonsumsi selama pelatihan model, digunakan untuk penagihan.
Step 3: Deploy the fine-tuned model
Step 3.1: Deploy the model as an online service
Setelah status pekerjaan fine-tuning berubah menjadi SUCCEEDED, terapkan model sebagai layanan online. Request example Ganti<replace_with_model_name> dengan nilai finetuned_output dari output Create a fine-tuning job.
output:
deployed_model: Nama model yang diterapkan, digunakan untuk menanyakan status penerapan dan memanggil model.status: Status penerapan model. Setelah menerapkan model hasil fine-tuning, status awalnya adalah PENDING, yang menunjukkan bahwa penerapan belum dimulai.
Step 3.2: Query the deployment status
Tanyakan status penerapan. Poll API berikut hinggastatus berubah menjadi RUNNING.
<replace_with_deployed_model> dengan nilai deployed_model dari output Langkah 3.1.
output:
status: Ketika status berubah menjadi RUNNING, model telah berhasil diterapkan dan Anda dapat mulai memanggilnya.deployed_model: Nama model yang diterapkan.
Step 4: Invoke the model to generate images
Setelah model berhasil diterapkan (status penerapan status adalah RUNNING), Anda dapat mulai melakukan pemanggilan.
type dalam message.content.Step 4.1: Create an image generation task and obtain the task_id
Step 4.1: Create an image generation task and obtain the task_id
<replace_with_deployed_model> dengan nilai deployed_model dari langkah sebelumnya.- Text-to-image
- Image-to-image
task_id untuk menanyakan hasil pada langkah berikutnya.Field | Type | Required | Description | Example |
|---|---|---|---|---|
model | string | Yes | Nama model. Anda harus menggunakan model hasil fine-tuning yang telah berhasil diterapkan dengan status RUNNING. | wan2.7-image-pro-xxxxxxxxxxxx |
input.messages[].content[].text | string | Yes | Prompt teks. Kami merekomendasikan menyertakan kata pemicu untuk mengaktifkan gaya LoRA. | s86b5p, A person in a quiet private library on a peaceful afternoon... |
parameters.size | string | No | Resolusi gambar output.
| 2K |
parameters.n | integer | No | Jumlah gambar yang dihasilkan. Nilai valid: 1-4. Default: 1. | 1 |
Step 4.2: Query results by task_id
Step 4.2: Query results by task_id
task_id hingga task_status berubah menjadi SUCCEEDED. Ambil URL gambar dari output.choices[].message.content[].image.Request example
Ganti 86ecf553-d340-4e21-xxxxxxxxx dengan task_id Anda yang sebenarnya.
URL gambar berlaku selama 24 jam. Unduh gambar segera.
Build custom datasets
Selain menggunakan data contoh dalam dokumen ini untuk mencoba alur kerja fine-tuning, Anda juga dapat membuat dataset sendiri untuk fine-tuning.
Dataset harus berisi set pelatihan (wajib) dan set validasi (opsional; mendukung pemisahan otomatis dari set pelatihan). Kemas semua file dalam format .zip. Nama file hanya boleh berisi karakter Inggris, angka, garis bawah, atau tanda hubung.
Dataset format
Training set: Required
- Text-to-image
- Image-to-image
- Multi-image-to-image
- Contoh set pelatihan: wan-image-t2i-training-dataset.zip
- Struktur direktori paket zip:
- File anotasi (data.jsonl): Setiap baris merepresentasikan satu sampel pelatihan dan harus berupa objek JSON.
- data.jsonl harus dalam format JSONL berbasis baris (satu objek JSON independen per baris). Menggunakan format array JSON (di mana karakter pertama file adalah
[) tidak diperbolehkan. - File dalam paket zip harus ditempatkan dalam struktur datar. Subdirektori tidak diperbolehkan. Nama file hanya mendukung karakter Inggris (karakter Cina, spasi, dan karakter khusus tidak diperbolehkan).
Validation set: Optional
Set validasi mencakup file anotasi (data.jsonl) dan gambar referensi opsional (wajib untuk mode image-to-image). Gambar target tidak diperlukan. Pada setiap checkpoint evaluasi, pekerjaan pelatihan secara otomatis memanggil layanan model untuk menghasilkan gambar pratinjau menggunakan prompt (dan gambar referensi) dari set validasi.
-
Set validasi:
- Text-to-image: wan-image-t2i-valid-dataset.zip
- Image-to-image: wan-image-i2i-valid-dataset.zip
- Struktur direktori paket zip:
-
File anotasi (data.jsonl): Setiap baris merepresentasikan satu sampel validasi dan harus berupa objek JSON.
- Text-to-image
- Image-to-image
- Multi-image-to-image
Data scale and limits
- Data volume: Kami merekomendasikan menyediakan minimal 25 gambar (50 atau lebih direkomendasikan untuk hasil yang lebih baik). Gunakan karakter atau gaya yang sama di berbagai adegan dan sudut pandang dengan deskripsi konten yang konsisten.
- Zip package: Saat mengunggah melalui API, ukuran total paket tidak boleh lebih dari 1 GB.
-
Training image requirements:
- Format gambar yang didukung: BMP, JPEG, PNG, dan WEBP.
- Resolusi gambar tidak boleh lebih dari 4096×4096.
- Ukuran file gambar individual tidak boleh lebih dari 20 MB.
Data collection and cleaning
1. Determine the fine-tuning scenario
Wan mendukung skenario fine-tuning berikut untuk image generation:- IP character stylization: Latih model untuk mempelajari gaya menggambar karakter IP tertentu, seperti karakter anime atau gambar maskot.
- Fixed visual style: Tingkatkan kemampuan model untuk mereproduksi gaya seni tertentu, seperti ilustrasi datar, lukisan tinta, atau seni piksel.
- Specific scene generation: Replikasi pola komposisi atau templat adegan tertentu, seperti gambar tampilan produk atau tata letak poster.
2. Obtain raw materials
- Generasi AI dan seleksi: Gunakan model dasar Wan untuk menghasilkan gambar secara massal, lalu pilih secara manual sampel berkualitas tinggi yang paling sesuai dengan efek target. Ini adalah metode yang paling umum digunakan.
- Fotografi nyata: Jika tujuan Anda adalah mencapai adegan yang sangat realistis (seperti foto produk nyata atau fotografi potret), menggunakan rekaman hasil jepretan nyata adalah pilihan terbaik.
- Rendering perangkat lunak 3D: Untuk adegan yang memerlukan kontrol detail halus atau gaya rendering 3D, kami merekomendasikan menggunakan perangkat lunak 3D (seperti Blender atau C4D) untuk membuat materi sumber.
3. Clean the data
Dimension | Best practice | Anti-pattern |
|---|---|---|
Consistency | Fitur inti harus sangat konsisten. Contoh: Saat melatih "gaya ilustrasi datar", semua gambar harus memiliki ketebalan garis dan skema warna yang sama. | Gaya campuran. Dataset berisi gambar bergaya impasto dan bergaya datar. Model tidak dapat menentukan gaya mana yang harus dipelajari. |
Diversity | Semakin beragam subjek dan adegan, semakin baik. Cakup berbagai subjek (pria, wanita, lansia, anak-anak, kucing, anjing, bangunan) dan komposisi berbeda (shot panjang, close-up, extreme close-up). Resolusi dan rasio aspek juga harus bervariasi sebanyak mungkin. | Adegan atau subjek tunggal. Semua gambar menunjukkan "seseorang berpakaian merah di depan dinding putih". Model mungkin salah mengira bahwa "pakaian merah" dan "dinding putih" adalah bagian dari gaya, dan gagal menghasilkan dengan benar di adegan berbeda. |
Balance | Proporsi seimbang di seluruh jenis data. Jika beberapa gaya disertakan, jumlahnya harus kira-kira sama. | Proporsi sangat tidak seimbang. 90% adalah gambar potret dan 10% adalah gambar lanskap. Model mungkin berkinerja buruk saat menghasilkan gambar lanskap. |
Cleanliness | Gambar bersih dan jelas. Gunakan materi asli tanpa gangguan. | Berisi elemen gangguan. Gambar berisi watermark, batas hitam jelas, atau noise. Model mungkin mempelajari watermark sebagai bagian dari gaya. |
Resolution | Resolusi moderat. Kami merekomendasikan resolusi gambar pelatihan tidak melebihi 2048×2048. Gambar yang terlalu besar meningkatkan waktu pelatihan. | Resolusi bervariasi terlalu lebar. Memiliki gambar kecil 256×256 dan gambar besar 4096×4096 dalam set pelatihan memengaruhi stabilitas pelatihan. |
Image annotation: Writing prompts for images
Dalam file anotasi dataset (data.jsonl), setiap gambar memiliki prompt yang sesuai. Prompt tersebut menggambarkan konten gambar target. Kualitas prompt secara langsung menentukan apa yang dipelajari model.
Prompt writing formula
Prompt = [Subject description] + [Background description] + [Trigger word] + [Style description]
Prompt component | Description | Recommendation | Example |
|---|---|---|---|
Subject description | Menggambarkan orang atau objek dalam gambar | Wajib | A young woman wearing a red Chinese-style long shirt... |
Background description | Menggambarkan lingkungan tempat subjek berada | Wajib | The background is a brick wall covered with green vines... |
Trigger word | Kata langka yang tidak memiliki makna sebenarnya | Direkomendasikan | s86b5p atau m01aa |
Style description | Menggambarkan gaya seni dan karakteristik visual gambar target secara detail | Direkomendasikan | Rendered in flat illustration style with clean flowing lines and vivid flat colors to emphasize three-dimensionality and modern design aesthetics. |
About trigger words
About trigger words
- Apa itu kata pemicu? Berfungsi sebagai "jangkar visual". Karena banyak gaya visual kompleks (seperti tekstur gambar unik atau skema warna tertentu) sulit dijelaskan secara tepat dalam teks, kata pemicu secara eksplisit memberi tahu model: ketika Anda melihat s86b5p, Anda harus menghasilkan gaya visual spesifik ini.
- Mengapa menggunakannya? Fine-tuning model membentuk pemetaan antara "teks" dan "fitur gambar". Kata pemicu mengikat "gaya yang tidak dapat dijelaskan" ke kata unik, memungkinkan model mengunci target tersebut.
-
Jika kita sudah memiliki kata pemicu, mengapa masih perlu menggambarkan gayanya secara detail?
Keduanya memiliki tujuan berbeda dan bekerja lebih baik bersama.
- Deskripsi gaya: Menjelaskan "seperti apa gambar seharusnya". Memberi tahu model gaya seni dasar dan karakteristik visual. Deskripsi gaya biasanya konsisten di berbagai sampel.
- Kata pemicu: Menjelaskan "seperti apa tampilan spesifik gaya tersebut". Mewakili karakteristik visual unik yang tidak dapat dijelaskan secara tepat dalam teks.
Evaluate models with validation sets
Specify the validation set
Pekerjaan fine-tuning harus mencakup set pelatihan, sedangkan set validasi opsional. Anda dapat memilih agar sistem secara otomatis membagi atau mengunggah secara manual set validasi. Metode spesifiknya sebagai berikut:
Metode 1: Tidak mengunggah set validasi (pembagian otomatis sistem)
Saat Video and image generation model fine-tuning API, jika tidak mengunggah set validasi secara terpisah (yaitu, parametervalidation_file_ids tidak diberikan), sistem membagi set validasi dari set pelatihan berdasarkan split, yang default-nya 0,9. Artinya, 90% digunakan untuk pelatihan dan 10% untuk validasi.
Metode 2: Mengunggah set validasi secara manual (ditentukan melalui validation_file_ids)
Jika Anda ingin menggunakan data yang telah Anda siapkan sendiri untuk mengevaluasi checkpoint alih-alih mengandalkan pembagian acak sistem, Anda dapat mengunggah set validasi kustom. Catatan: Setelah Anda memilih untuk mengunggah secara manual, sistem sepenuhnya mengabaikan aturan pembagian otomatis di atas dan hanya menggunakan data yang Anda unggah untuk validasi.Prosedur: Mengunggah set validasi secara manual
Prosedur: Mengunggah set validasi secara manual
- Siapkan set validasi: Kemas data validasi ke dalam file
.zipterpisah. Lihat Validation set format. - Unggah set validasi: Panggil API Video and image generation model fine-tuning API untuk mengunggah file
.zipset validasi ini dan peroleh ID file khusus. - Tentukan set validasi saat membuat pekerjaan: Saat memanggil API Video and image generation model fine-tuning API, isi ID file ini dalam parameter
validation_file_ids.
Select the best checkpoint for deployment
Selama pelatihan, sistem secara berkala menyimpan "snapshot" model (yaitu, checkpoint). Secara default, sistem mengeluarkan checkpoint terakhir sebagai model hasil fine-tuning akhir. Namun, checkpoint yang dihasilkan selama tahap antara mungkin berkinerja lebih baik daripada versi akhir. Anda dapat memilih yang paling memuaskan untuk diterapkan.
Sistem menjalankan checkpoint pada set validasi dan menghasilkan gambar pratinjau pada interval yang ditetapkan oleh Hyperparameters (hyper_parameters) eval_steps.
- Cara mengevaluasi: Nilai hasilnya dengan langsung mengamati gambar pratinjau yang dihasilkan.
- Kriteria seleksi: Temukan checkpoint dengan hasil terbaik dan gaya yang paling sesuai.
Procedure
Langkah 1: Lihat hasil pratinjau yang dihasilkan oleh checkpoint
Langkah 1: Lihat hasil pratinjau yang dihasilkan oleh checkpoint
Langkah 1.1: Tanyakan daftar checkpoint yang telah divalidasi
API ini hanya mengembalikan checkpoint yang telah lulus validasi dan berhasil menghasilkan gambar pratinjau. Checkpoint yang gagal validasi tidak tercantum.Request example<replace_with_fine_tuning_job_id>: Ganti sepenuhnya dengan parameter outputjob_iddari Video and image generation model fine-tuning API.
Langkah 1.2: Tanyakan hasil set validasi untuk suatu checkpoint
Pilih checkpoint dari daftar yang dikembalikan pada langkah sebelumnya (misalnya, "checkpoint-160") dan lihat hasil gambar yang dihasilkan.Request example<replace_with_fine_tuning_job_id>: Ganti sepenuhnya dengan nilaijob_iddari output Create a fine-tuning job.<replace_with_checkpoint_to_export>: Ganti sepenuhnya dengan nilai checkpoint, misalnya "checkpoint-160".
img_path dan berlaku selama 24 jam. Unduh gambar segera untuk meninjau hasilnya. Ulangi langkah ini untuk membandingkan hasil beberapa checkpoint dan temukan yang paling memuaskan.Langkah 2: Ekspor checkpoint dan peroleh nama model untuk penerapan
Langkah 2: Ekspor checkpoint dan peroleh nama model untuk penerapan
Langkah 2.1: Ekspor model
Asumsikan "checkpoint-160" memiliki hasil terbaik, langkah selanjutnya adalah mengekspornya.Request example<replace_with_fine_tuning_job_id>: Ganti sepenuhnya dengan nilaijob_iddari output Create a fine-tuning job.<replace_with_checkpoint_to_export>: Ganti sepenuhnya dengan nilai checkpoint, misalnya "checkpoint-160".<replace_with_exported_model_display_name>: Ganti sepenuhnya dengan nama model kustom yang hanya digunakan untuk tampilan konsol, misalnya "wan2.5-checkpoint-160". Nama ini harus unik secara global. Mengekspor dengan nama duplikat tidak didukung. Untuk detail parameter, lihat 3. Export a checkpoint.
output=true menunjukkan bahwa permintaan ekspor telah berhasil dibuat.Langkah 2.2: Tanyakan nama model baru untuk penerapan
Tanyakan status semua checkpoint, pastikan ekspor selesai, dan peroleh nama model baru khusus (model_name) untuk penerapan.Request example<replace_with_fine_tuning_job_id>: Ganti sepenuhnya dengan nilaijob_iddari output Create a fine-tuning job.
status-nya berubah menjadi SUCCEEDED, ekspor berhasil. Bidang model_name yang dikembalikan pada titik ini adalah nama model baru setelah ekspor.Langkah 3: Terapkan dan panggil model
Langkah 3: Terapkan dan panggil model
model_name, ikuti langkah-langkah berikut untuk operasi selanjutnya:- Model deployment: Isi parameter input
model_namedengan nilai spesifik yang diperoleh setelah ekspor. - Model invocation: Ikuti dokumentasi API untuk memanggil model yang diterapkan.
Billing
-
Model training: Charged.
- Biaya = Total token pelatihan × Harga satuan. Lihat Training and deployment pricing.
- Setelah pelatihan selesai, periksa jumlah total token yang dikonsumsi selama pelatihan dalam bidang
usagedari API Retrieve a fine-tuning job.
generation_type
Image Resolution
Common Step Count
Estimated Token Consumption
Estimated Cost
t2i (text-to-image)
1K
500
6.400.000
$96
1.000
12.800.000
$192
2.000
25.600.000
$384
2K
500
11.610.000
$174,15
1.000
23.220.000
$348,3
2.000
46.440.000
$696,6
i2i (image-to-image)
1K
500
11.610.000
$174,15
1.000
23.220.000
$348,3
2.000
46.440.000
$696,6
2K
500
16.000.000
$240
1.000
32.000.000
$480
2.000
64.000.000
$960
-
Model deployment and invocation: Penerapan gratis. Pemanggilan dikenai biaya sesuai tarif standar model dasar hasil fine-tuning.
Model ID
LoRA Deployment & Invocation Price
wan2.7-image-pro
$0,075/image
wan2.7-image
$0,03/image
API reference
Video and image generation model fine-tuning API
FAQ
Q: How do I design a good trigger word?
A: Aturannya sebagai berikut:
- Kami merekomendasikan menggunakan kombinasi karakter langka yang tidak memiliki makna semantik sebenarnya, seperti s86b5p, m01aa, atau EVEAven638123. Pastikan tidak ada makna semantik dalam kosakata model dasar.
- Hindari menggunakan kata bahasa Inggris umum (seperti beautiful, fire, atau dance), karena hal ini akan mencemari pemahaman asli model terhadap kata-kata tersebut.