Anda dapat memperoleh layanan inferensi independen dengan sumber daya khusus melalui penerapan untuk memenuhi kebutuhan bisnis pada berbagai tingkat kinerja, seperti konkurensi tinggi dan latensi rendah.
Metode penagihan
Sebelum penerapan, Anda dapat melihat perkiraan biaya per jam berbagai model di Konsol Penerapan Model.
Provisioned Throughput (PTU, Provisioned Throughput Unit) (Throughput tinggi; kinerja tinggi) | Model Unit (Metrik kinerja kustom; isolasi sumber daya) | Token-based usage (Bayar sesuai penggunaan setelah fine-tuning/validasi efek) | |||
|---|---|---|---|---|---|
Definisi | Metode penerapan model yang menyediakan sumber daya platform untuk menjamin kapasitas throughput TPM tertentu; tidak ada pembatasan laju dalam kuota yang dijamin. | Metode penerapan model yang mengonfigurasi daya komputasi berdasarkan durasi penggunaan dan jumlah Model Unit, dengan sumber daya khusus. | Metode penerapan model yang menggunakan Tokens input dan Tokens output yang dihasilkan per panggilan sebagai dasar pengukuran penggunaan. | ||
Keunggulan |
|
| Tidak dikenai biaya saat tidak digunakan. | ||
Model yang didukung | Beberapa model yang telah dikonfigurasi sebelumnya | Beberapa model yang telah dikonfigurasi sebelumnya dan semua model yang telah difine-tune | Beberapa model yang telah difine-tune dengan LoRA | ||
Kasus penggunaan |
|
| Validasi efek model fine-tuned | ||
Diagram penagihan | 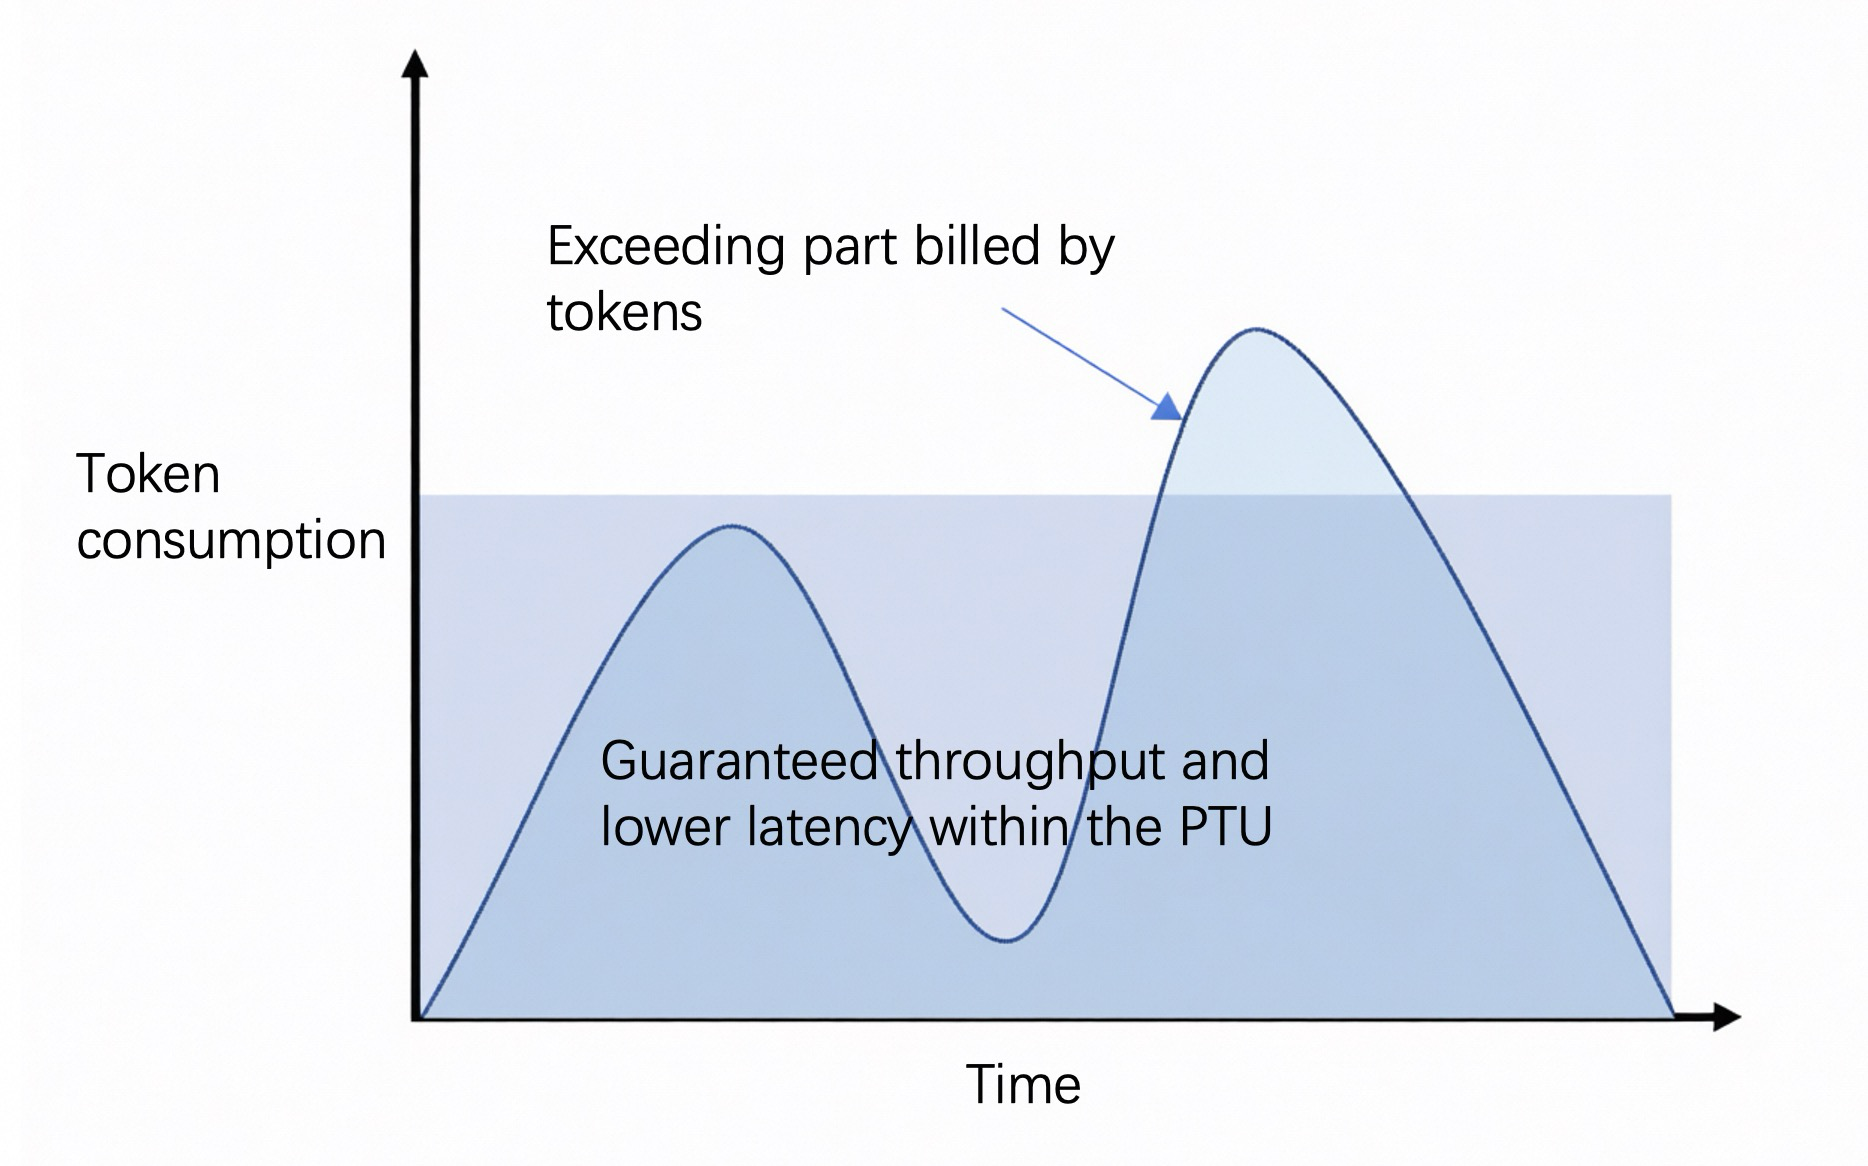 | 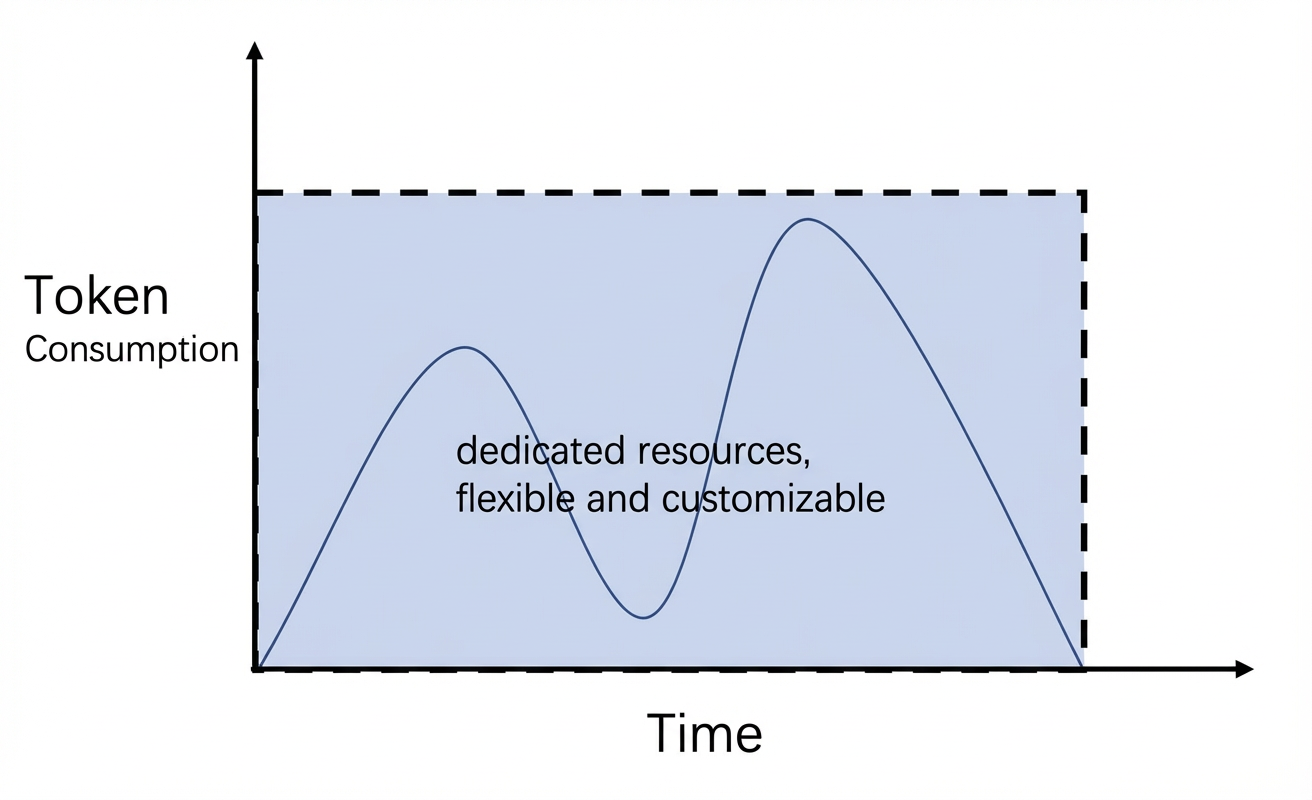 | 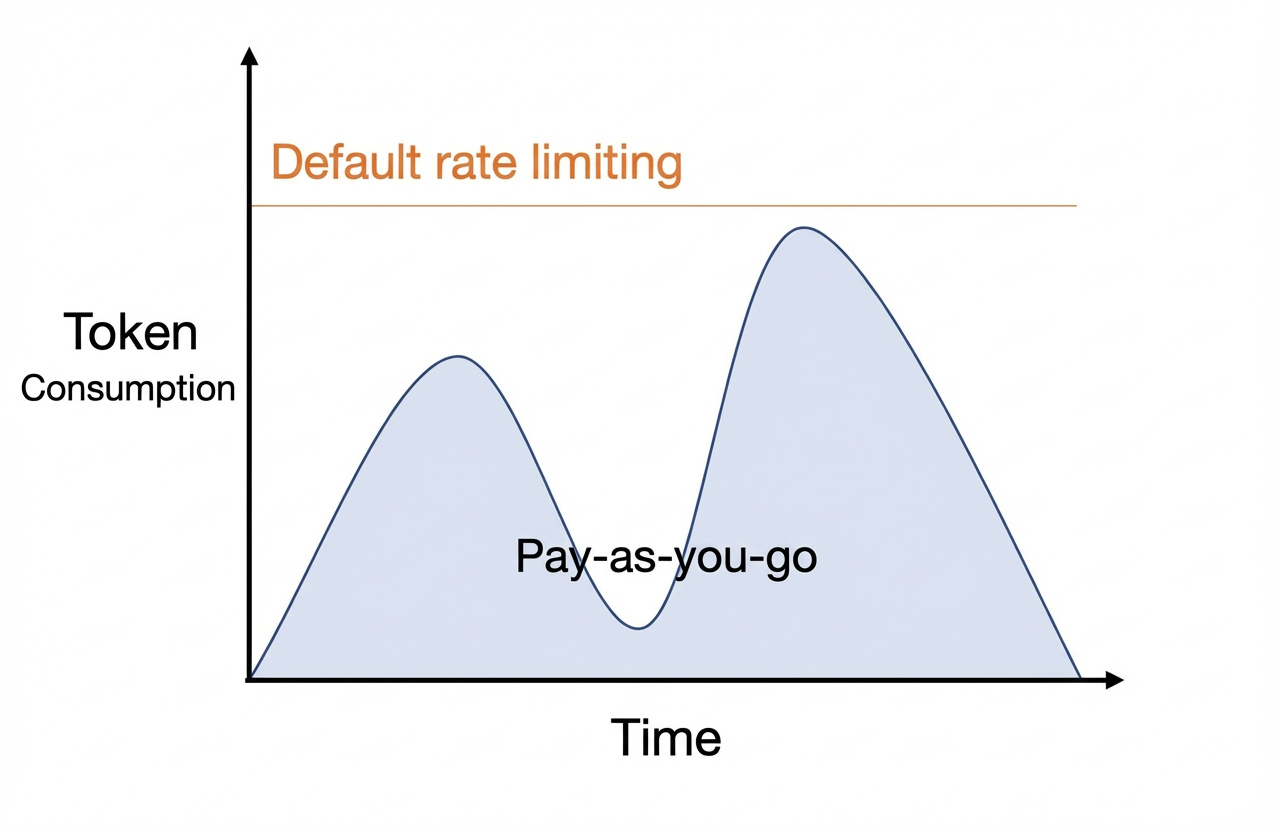 | ||
Metode penagihan | Berdasarkan durasi penggunaan dan throughput yang disediakan Bayar sesuai penggunaan, paket harian | Berdasarkan durasi penggunaan dan jumlah Model Unit Bayar sesuai penggunaan, paket bulanan | Berdasarkan penggunaan Token model Bayar sesuai penggunaan | ||
Metode penskalaan | Peningkatan/penurunan throughput mandiri | Peningkatan/penurunan Model Unit mandiri | Kirim permohonan di konsol dan tunggu tinjauan manual. | ||
Batasan produk |
| Setelah pembelian prabayar, jika Anda membatalkan lebih awal dalam bulan pertama, harga satuan harian (≈ harga satuan bulanan / 30) akan ditagih sebesar 1,2 kali lipat. |
| ||
Rincian penagihan
- Penagihan berdasarkan durasi penggunaan (Provisioned Throughput)
- Penagihan berdasarkan durasi penggunaan (Model Unit)
- Berdasarkan penggunaan token model
Biaya = Durasi penggunaan × (Harga satuan TPM input × TPM input + Harga satuan TPM output × TPM output)Postpaid dihitung per jam: satuan durasi penggunaan adalah jam, dan harga satuan diambil dari kolom "1 jam berkelanjutan" pada tabel di bawah ini; prepaid dihitung per hari: satuan durasi penggunaan adalah hari, dan harga satuan diambil dari kolom "1 hari berkelanjutan" pada tabel di bawah ini.- Pesanan prepaid berlaku secara real time setelah pembayaran, dengan periode validitas N hari yang berakhir pukul 23.59 pada hari ke-N. Jika pesanan dilakukan setelah pukul 22.00, tanggal kedaluwarsa akan diperpanjang secara otomatis 1 hari.
- Setelah pesanan prepaid kedaluwarsa, layanan akan dihentikan dengan penundaan 2 jam, dan sumber daya akan dipertahankan selama 14 jam setelah penghentian lalu dilepas.
- Pesanan prepaid tidak dapat menghentikan layanan lebih awal.
- Untuk penagihan postpaid, jika akun mengalami tunggakan, sumber daya yang diterapkan akan tetap dipertahankan dan ditagih selama 24 jam, di mana layanan masih dapat digunakan secara normal. Setelah 24 jam, sistem menghentikan penagihan, penerapan model memasuki status tunggakan, dan sumber daya dasar akan dihapus, tetapi tugas penerapan model akan dipertahankan. Setelah tunggakan dilunasi, sistem akan mengalokasikan ulang sumber daya dan memulihkan penggunaan (biaya akan terus berjalan setelah pemulihan). Jika Anda tidak ingin terus dikenai biaya, Anda dapat menghapus tugas penerapan model, dan penagihan akan berhenti setelah penghapusan berhasil.
- Dalam kasus ini (hanya di bawah strategi "auto-overflow"), Header respons API akan mencakup:
x-dashscope-ptu-overflow:true. - Untuk statistik TPM, buka: Pemantauan Model.
- Singapura
- China Utara 2 (Beijing)
- Qwen
- DeepSeek
- Qwen-VL
- GLM
Nama Model | Kode Model | Token Input Maks | Input Pascabayar Per 10K TPM/Jam | Output Postpaid Per 1K TPM/Jam | Input Prabayar Per 10K TPM/Hari | Prepaid Output Per 1K TPM/Hari |
|---|---|---|---|---|---|---|
Qwen3.8-Max | qwen3.8-max | 1M | $4,8 | $1,44 | $57,6 | $17,28 |
Qwen3.7-Flash-2026-07-15 Hubungi manajer bisnis Anda untuk mengaktifkan | qwen3.7-flash-2026-07-15 | 128K | $0,072 | $0,031 | $0,864 | $0,374 |
Qwen3.7-Max-2026-05-20 | qwen3.7-max-2026-05-20 | 256K | $1,92 | $1,8 | $72 | $21,6 |
Qwen3.7-Plus-2026-05-26 | qwen3.7-plus-2026-05-26 | 256K | $0,96 | $0,384 | $11,52 | $4,608 |
Qwen3.6-Plus-2026-04-02 | qwen3.6-plus-2026-04-02 | 128K | $1,2 | $0,72 | $14,4 | $8,64 |
Qwen3.5-Plus-2026-04-20 | qwen3.5-plus-2026-04-20 | 128K | $0,96 | $0,576 | $11,52 | $6,912 |
Metode penerapan
Anda dapat menerapkan model di konsol. Ikuti langkah-langkah berikut:
Jika Anda mendapat pesan izin tidak mencukupi, rujuk ke: Apa yang harus saya lakukan jika muncul pesan "izin tidak mencukupi" saat penerapan?
| 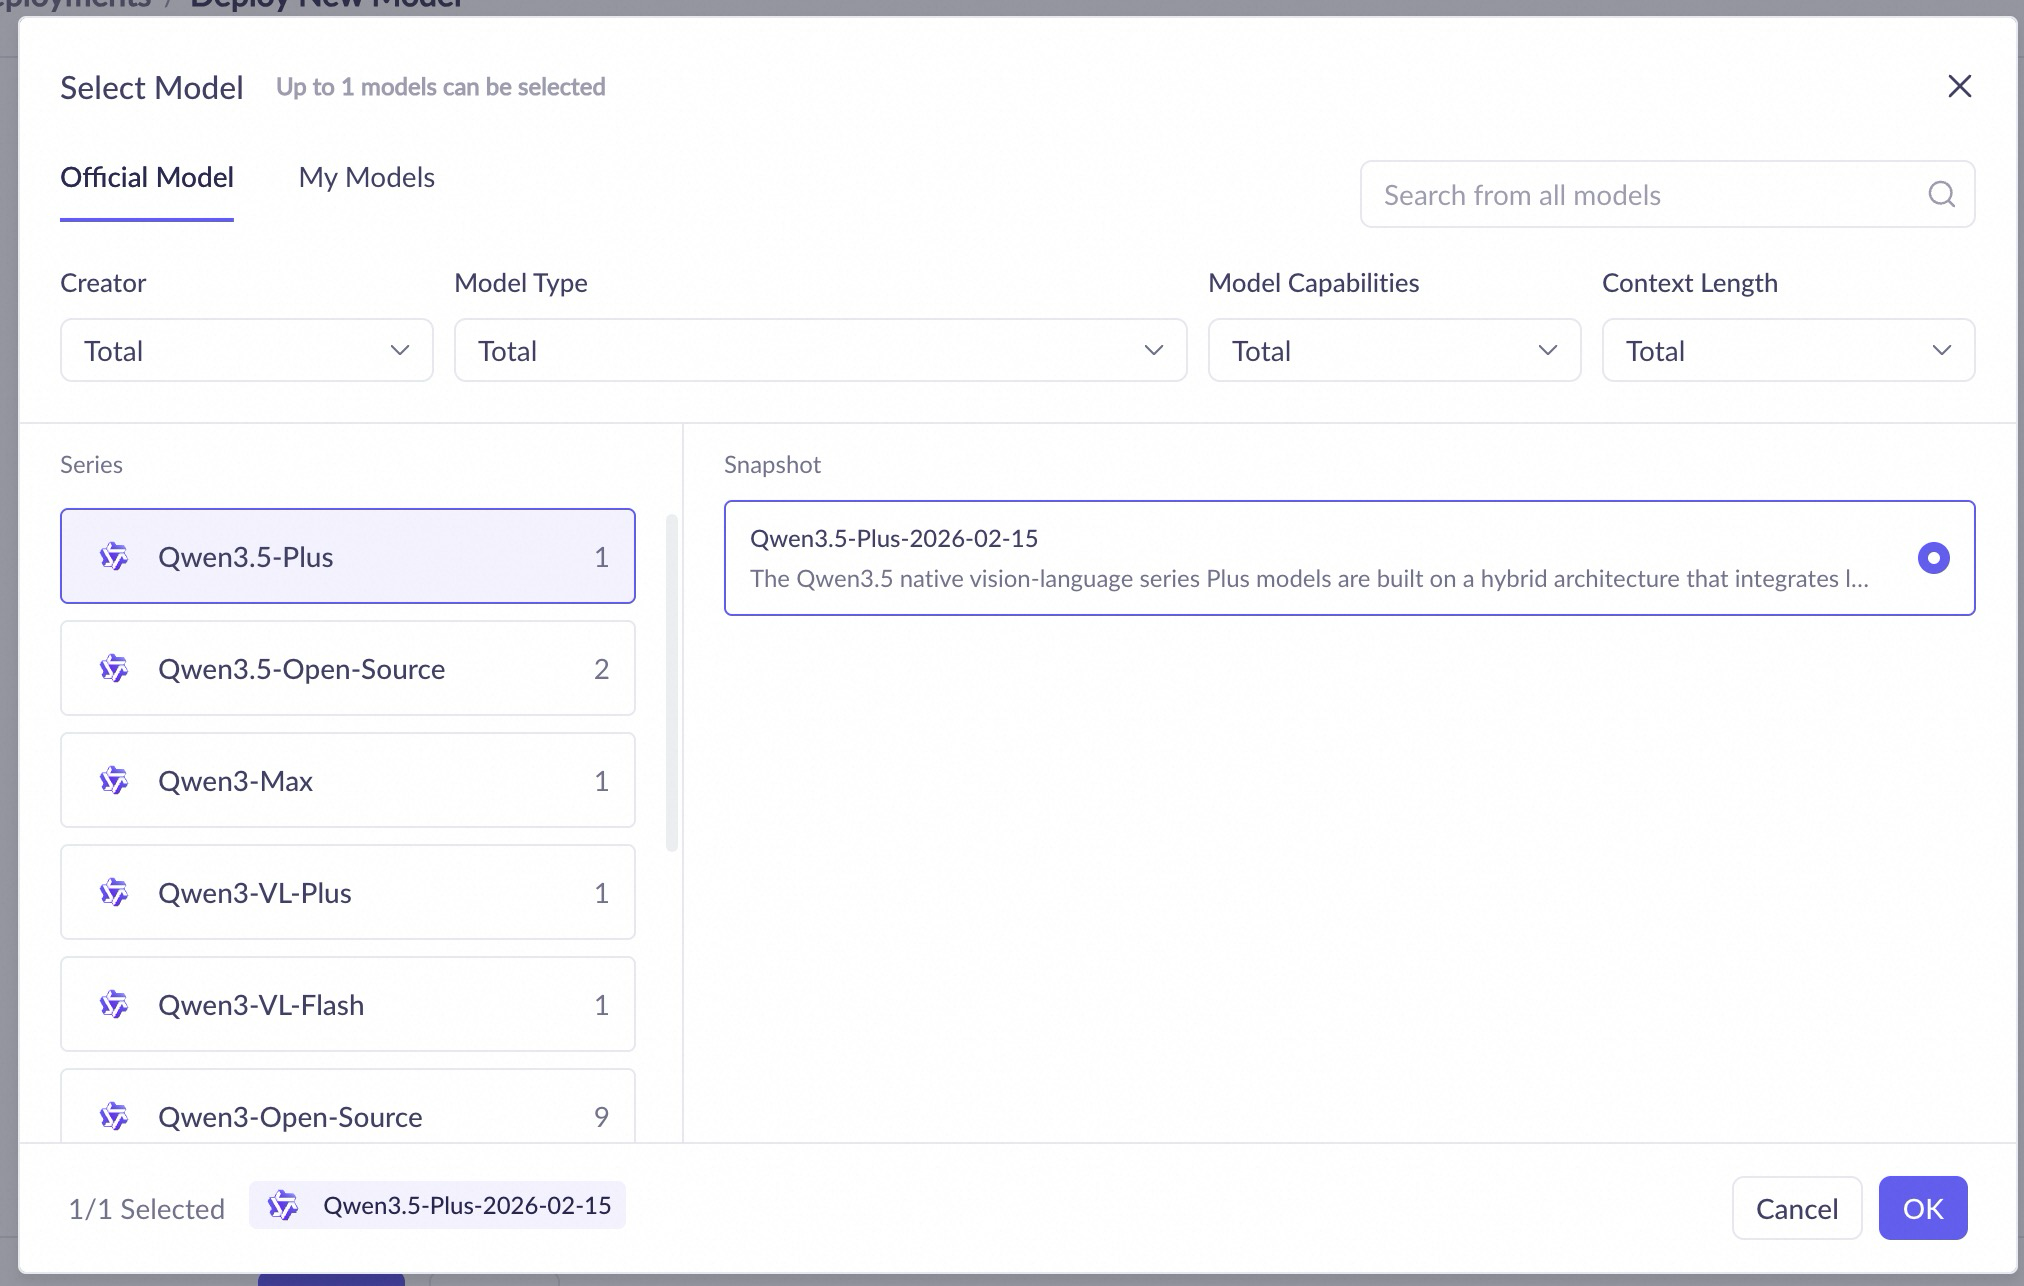 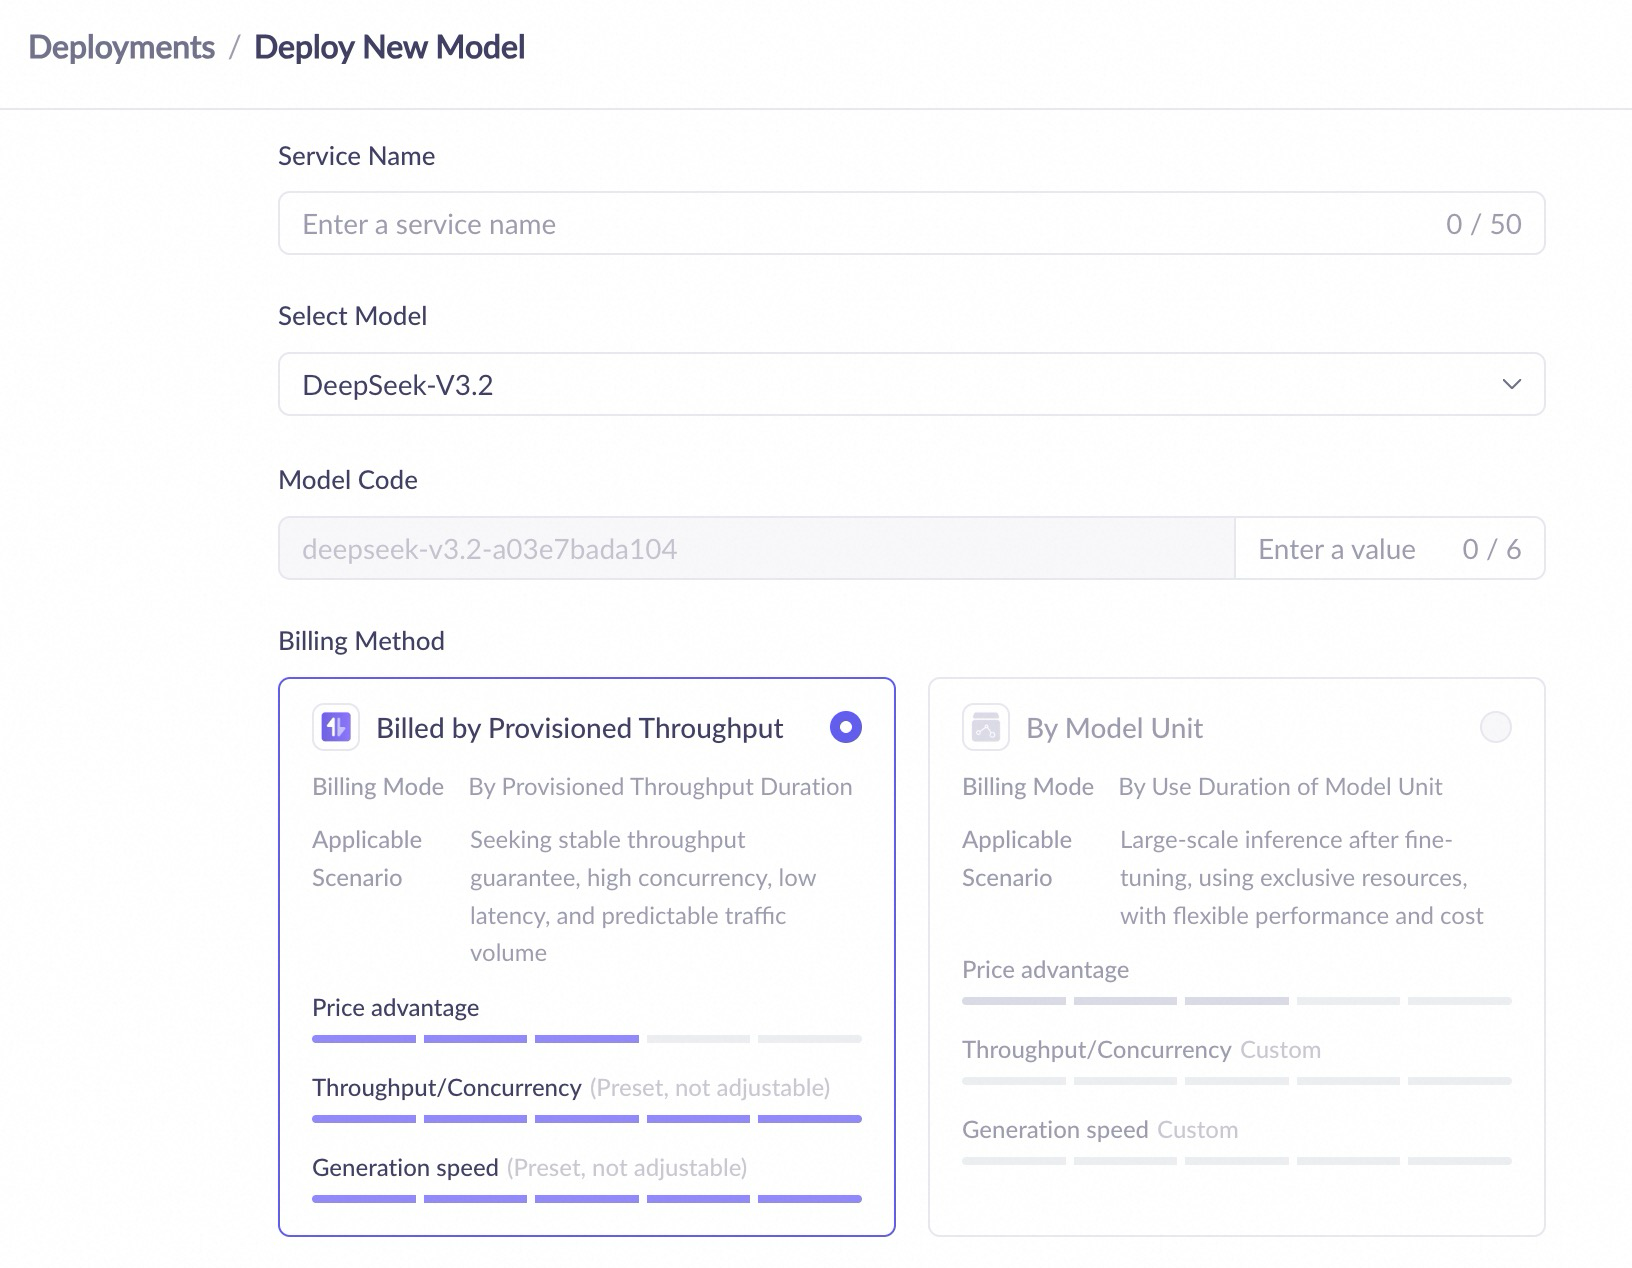 |
| |
Biaya akan dikenakan setelah model berhasil diterapkan. |
Konfigurasi penerapan
- Model Unit
Item konfigurasi | Rincian konfigurasi |
|---|---|
Nama layanan | Nama kustom untuk layanan penerapan. |
Model | Pilih model yang akan diterapkan, termasuk model preset platform dan model yang telah difine-tune. |
Jenis unit model | Pilih spesifikasi penerapan. Spesifikasi berbeda sesuai dengan daya komputasi dan kinerja berbeda. |
Jumlah replika | Tetapkan jumlah awal replika penerapan, yang memengaruhi kemampuan pemrosesan konkuren layanan. |
Template penerapan | Pilih template penerapan (misalnya, "penerapan single-node"). Template berbeda sesuai dengan skema konfigurasi sumber daya berbeda. Hanya tersedia dalam mode penagihan unit model. |
Mode inferensi model | Untuk beberapa model, saat diterapkan dalam modeModel Unit, Anda dapat mengonfigurasi mode inferensi, konteks maksimum, dan lainnya.
|
Konteks maksimum | Mode penerapanModel Unit beberapa model mendukung pengaturan ini. Panjang konteks maksimum bergantung pada jenis model. |
Pembatasan laju layanan | Mode penerapanModel Unit beberapa model mendukung pengaturan ini, yang dapat membatasi RPM dan TPM panggilan model. |
Halaman daftar penerapan
Setelah penerapan berhasil, Anda dapat melihat dan mengelola semua layanan penerapan di halaman daftar penerapan. Halaman daftar berisi informasi berikut:
- Nama layanan: Nama layanan penerapan. Klik untuk melihat detail penerapan.
- Nama model: Model yang digunakan untuk penerapan.
- Kode Model: Pengidentifikasi unik yang dihasilkan setelah model berhasil diterapkan, digunakan untuk menentukan model saat memanggil API.
- Status penerapan/Status event: Termasuk Menunggu penerapan, Menerapkan, Running, Penerapan gagal, Offline, Layanan dijeda, Dihentikan, Menghapus, Langganan ditangguhkan/Pembayaran tertunda ditangguhkan, Memulihkan layanan, Running (Mengubah konfigurasi), Running (Perubahan gagal), dan status lainnya.
- Metode penagihan: Metode penagihan layanan penerapan saat ini.
- Detail penerapan: Informasi konfigurasi seperti jenis unit model dan jumlah replika.
- Detail pembatasan laju: Menampilkan konfigurasi pembatasan laju layanan penerapan saat ini, seperti RPM (permintaan per menit) dan TPM (token per menit).
- Waktu layanan: Menampilkan waktu pembuatan dan waktu kedaluwarsa layanan penerapan.
- Operasi: Bergantung pada status penerapan dan metode penagihan, Anda dapat melakukan operasi seperti Perbarui, Pantau, Penskalaan, Perpanjang, Offline, Hapus, dan Coba.
Panggilan pasca-penerapan
Setelah model berhasil diterapkan, Anda dapat memanggilnya melalui antarmuka yang kompatibel OpenAI, DashScope, dan Assistant SDK.
Saat memanggil model yang berhasil diterapkan, nilai model harus berupa kode model yang dihasilkan setelah penerapan berhasil. Buka konsol penerapan model untuk mendapatkan Model Code.

Penskalaan Layanan Penerapan
- Throughput preset (ditagih berdasarkan durasi): Klik tombol Scaling untuk layanan mandiri, menyesuaikan jumlah instans secara manual. Untuk aturan pengurangan biaya dan pengembalian dana terperinci, silakan merujuk ke: Aturan pengembalian dana untuk downgrade konfigurasi.
- Model unit (ditagih berdasarkan durasi): Klik tombol Scaling untuk layanan mandiri, menyesuaikan jumlah instans secara manual.
Menonaktifkan Layanan Penerapan
Buka Konsol Penerapan Model, temukan layanan penerapan yang ingin Anda hentikan, lalu klik operasi yang sesuai berdasarkan jenis penagihan:
- Model unit prepaid: Klik Deactivate dan konfirmasi.
- Postpaid: Klik Delete dan konfirmasi.
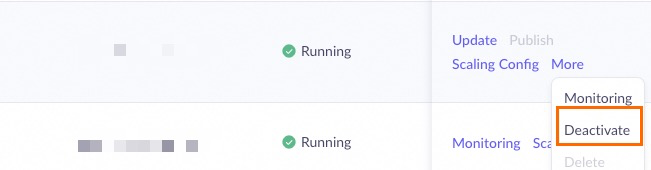
Operasi Lainnya
Selain menonaktifkan, kolom operasi di halaman daftar penerapan juga mendukung operasi berikut:
- Perbarui: Perbarui versi model layanan yang diterapkan, mendukung pembaruan penuh atau pembaruan batch (rilis canary).
- Hapus: Layanan bayar sesuai penggunaan dapat dihapus langsung untuk menghentikan penagihan.
- Perpanjang: Layanan prepaid dapat diperpanjang untuk memperpanjang waktu layanan, dan mendukung perpanjangan otomatis.
- Beli paket kapasitas: Beli paket kapasitas untuk penerapan throughput preset.
FAQ
Bisakah saya mengunggah dan menerapkan model saya sendiri?
Mengunggah dan menerapkan model Anda sendiri belum didukung. Kami menyarankan Anda terus mengikuti pembaruan terbaru Alibaba Cloud Model Studio.
Selain itu, Platform Kecerdasan Buatan Alibaba Cloud PAI menyediakan kemampuan untuk menerapkan model Anda sendiri. Anda dapat merujuk ke Penerapan Model Bahasa Besar PAI-LLM untuk mempelajari metode penerapan.
Apa yang harus saya lakukan jika muncul pesan "izin tidak mencukupi" saat penerapan?
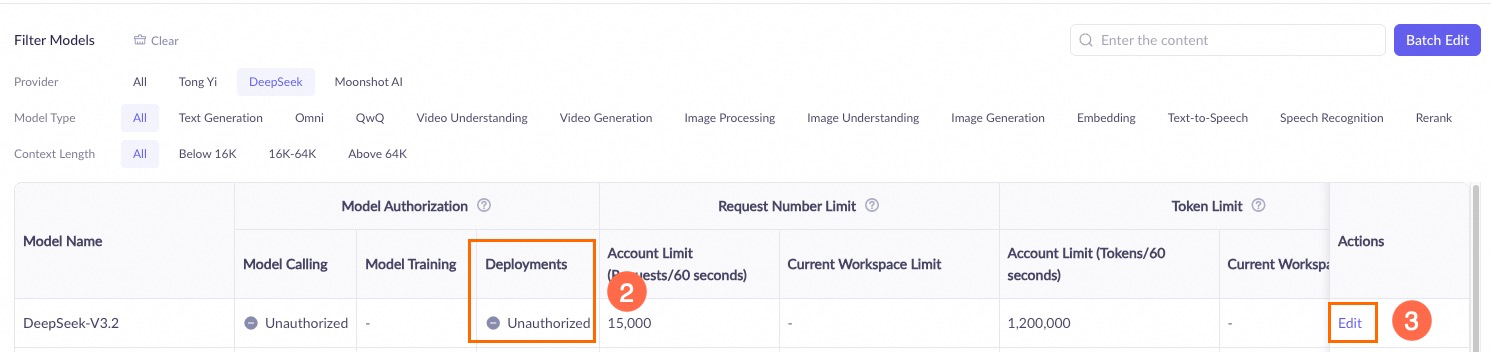
-
Jika muncul pesan "Missing permission for this module", pastikan akun Anda memiliki izin Model Deployment - Operation di halaman pengelolaan izin ruang bisnis.
Jika Anda tidak dapat beroperasi secara normal, hubungi organisasi atau administrator TI Anda untuk menambahkan izin terkait atau memeriksa masalah izin atas nama Anda.
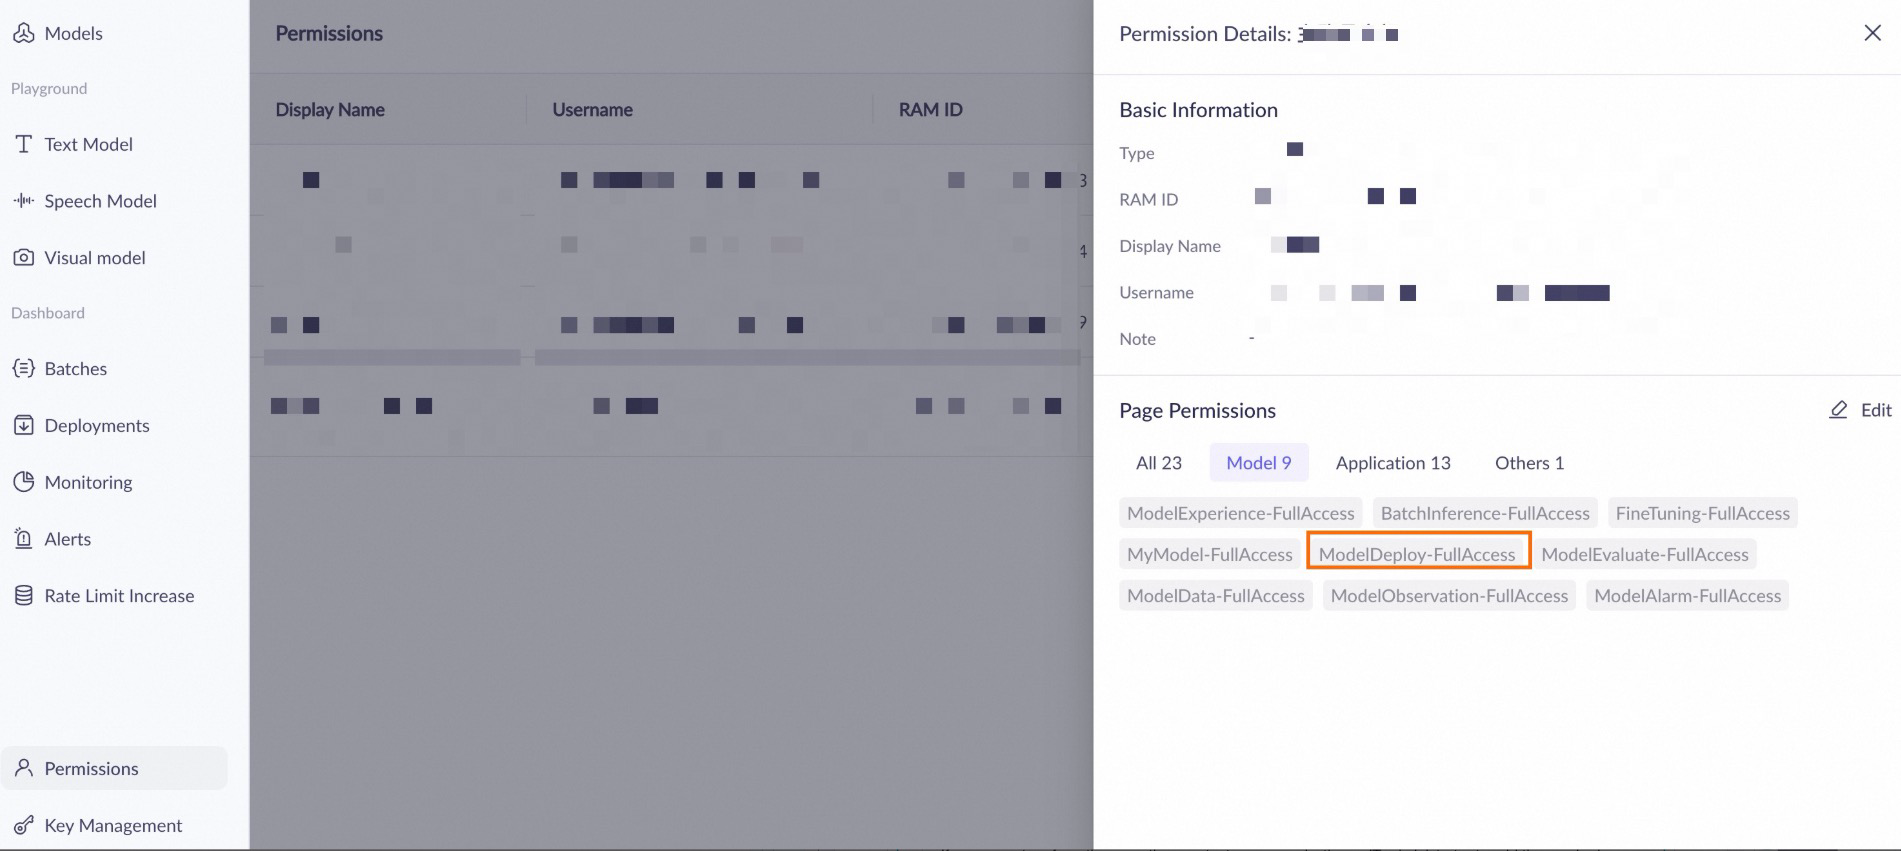
-
Jika terjadi kesalahan "ruang bisnis xx tidak memiliki izin untuk menerapkan model xx" selama penerapan, buka halaman Pengelolaan Ruang Bisnis Model Studio untuk menambahkan izin penerapan model yang sesuai untuk ruang bisnis yang sesuai.
Kesalahan pemanggilan API:
Workspace xxx does not have deployment privilege for model xxxx.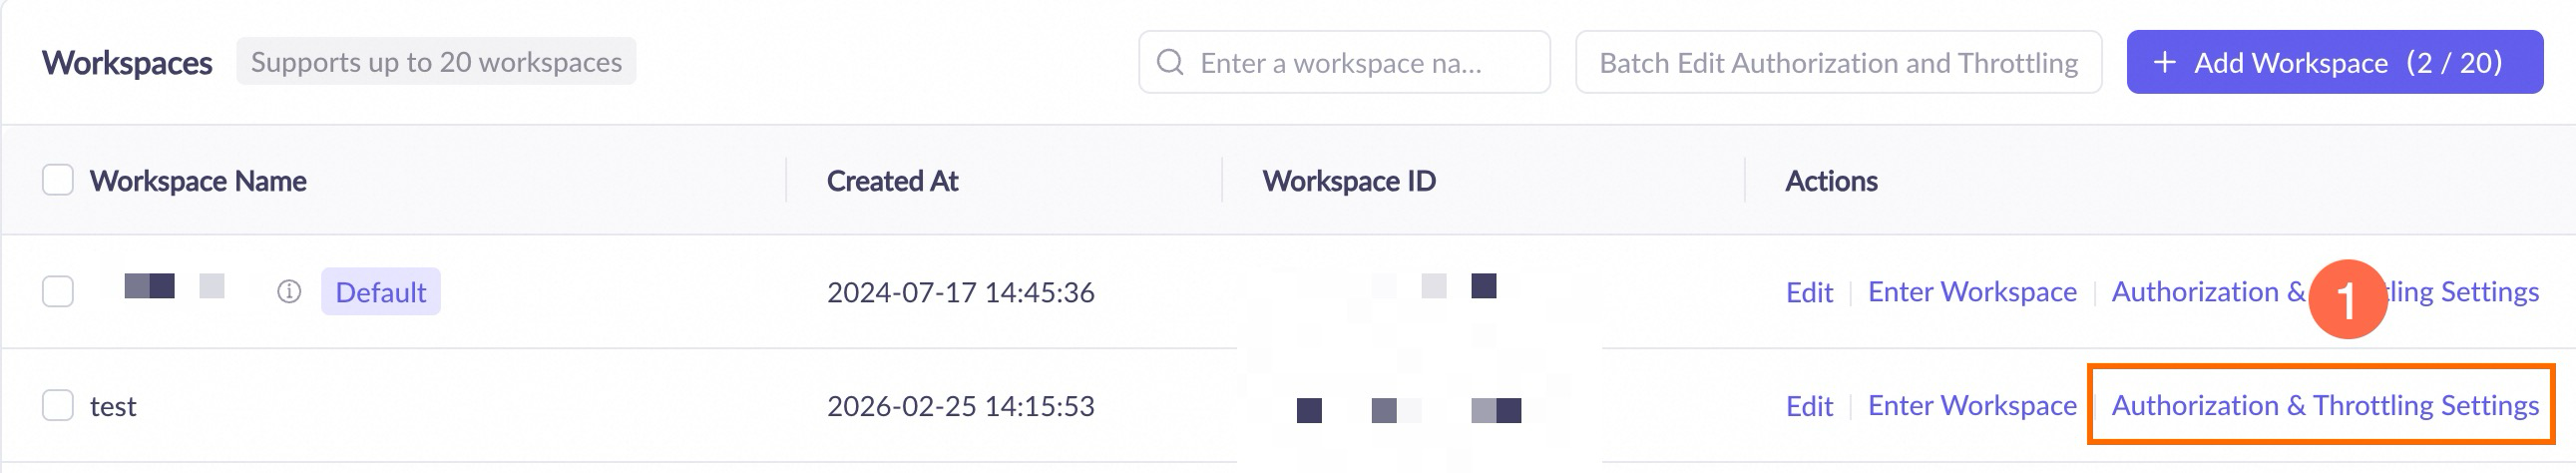 Jika muncul pesan izin tidak mencukupi, hubungi organisasi atau administrator TI Anda untuk menambahkan izin terkait atau beroperasi atas nama Anda.