

API Model Studio membatasi volume permintaan, penggunaan token, dan laju pertumbuhan. Terapkan strategi berikut untuk memaksimalkan throughput dan menjaga ketersediaan.
- Solusi konfigurasi platform (perubahan kode minimal): Server-side queuing, Tingkatkan batas kuota, PTU, dan Batch API.
- Strategi pengendalian trafik sisi klien (perubahan kode klien): Empat strategi dengan kompleksitas rekayasa yang meningkat, mulai dari retry dasar hingga adaptive congestion control.
- Solusi fallback arsitektural (perubahan arsitektur sistem): Model fallback dan peak-load shifting menggunakan message queues (MQ).
429, buka Diagnosis error dan rekomendasi strategi untuk mengidentifikasi penyebabnya. Untuk error akibat lonjakan trafik, coba server-side queuing terlebih dahulu — hanya memerlukan satu header permintaan.
Mekanisme rate limiting platform
Platform menerapkan rate limiting pada setiap model secara independen di tingkat akun root. Setelah dipicu, layanan biasanya pulih dalam waktu satu menit. Untuk kondisi rate limiting dan penggunaan saat ini per model, lihat 限流 dan Pemantauan model. Tiga jenis aturan rate limiting berlaku:
- Batas kuota tingkat menit (RPM / TPM): Jumlah maksimum permintaan per menit (RPM) dan penggunaan token maksimum per menit (TPM).
- Batas frekuensi instan (RPS / TPS): Maksimum permintaan per detik (RPS) dan penggunaan token maksimum per detik (TPS). Panggilan API padat atau konsumsi token dalam satu detik dapat memicu rate limiting.
- Batas laju pertumbuhan (Traffic Burst): Lonjakan tiba-tiba dalam volume permintaan atau penggunaan token memicu rate limiting. Ambang batasnya menyesuaikan secara dinamis. Tingkatkan permintaan secara bertahap untuk menghindari pemicuan batas ini.
Diagnosis error dan rekomendasi strategi
Kode error yang sama dapat dipicu oleh dimensi rate limiting yang berbeda. Konkurensi tinggi juga dapat menyebabkan server jenuh, sehingga terjadi timeout. Strategi adaptive congestion control dapat membantu mengurangi hal ini.
Kode error (DashScope / OpenAI) | Dimensi pemicu | Diagnosis fitur | Strategi yang direkomendasikan |
|---|---|---|---|
Throttling.RateQuota / limit_requests | Laju permintaan melebihi batas | Error bersifat intermiten. Tingkat keberhasilan menurun seiring waktu. | Token bucket: Kendalikan kuota permintaan per satuan waktu. |
Laju permintaan melebihi batas | Error terkonsentrasi saat startup atau selama lonjakan konkurensi. | Concurrency semaphore atau smoothing rate limiter: Tingkatkan interval antarpermintaan. | |
Throttling.AllocationQuota / insufficient_quota | Penggunaan token melebihi batas | Error bersifat intermiten saat memproses teks panjang. | Dual token bucket: Batasi kuota RPM dan TPM secara bersamaan. |
Penggunaan token melebihi batas | Konsumsi token instan terlalu tinggi selama pemrosesan konkuren teks panjang. | ||
Throttling.BurstRate / limit_burst_rate | Laju pertumbuhan trafik melebihi batas | Volume permintaan besar tiba-tiba setelah startup atau pemulihan dari keadaan idle. | Kami merekomendasikan mencoba server-side queuing terlebih dahulu. Alternatifnya, gunakan token bucket dengan nilai awal rendah, seperti |
Solusi konfigurasi platform
Solusi-solusi ini mengandalkan kemampuan platform dan memerlukan perubahan kode sisi klien yang minimal atau tanpa perubahan.
Server-side queuing (direkomendasikan)
Untuk rate limiting akibat lonjakan trafik, Model Studio menerima waktu tunggu maksimum dalam header permintaan. Server mengantrikan dan mencoba ulang permintaan dalam waktu tersebut hingga mulai diproses atau antrian timeout. Ini secara signifikan meningkatkan tingkat keberhasilan selama lonjakan trafik dibandingkan respons 429 langsung.
X-DashScope-Wait-Timeout ke header permintaan:
Bidang header | Contoh | Deskripsi |
|---|---|---|
X-DashScope-Wait-Timeout | 30 | Waktu tunggu antrian maksimum untuk permintaan lonjakan, dalam detik.
|
- Permintaan non-streaming (stream: false): Timeout = timeout dasar asli + nilai Wait-Timeout.
- Permintaan streaming (stream: true): Timeout > nilai Wait-Timeout. Permintaan streaming mulai menghitung waktu setelah chunk pertama, sehingga timeout respons awal hanya perlu melebihi waktu antrian.
Contoh kode
Contoh kode
Tingkatkan batas kuota
Jika kuota default tidak mencukupi, tingkatkan kuota rate limit sementara di Konsol Model Studio. Perubahan berlaku segera. Tersedia di wilayah China (Beijing) dan Singapura.
Skenario: Kuota RPM/TPM default tidak mencukupi karena pertumbuhan bisnis, atau diperlukan peningkatan throughput sementara untuk acara jangka pendek. Lihat Batas laju.
Mudah dikonfigurasi. Evaluasi opsi ini sebelum mencoba strategi sisi klien.
Provisioned throughput unit (PTU)
Layanan PTU menyediakan daya komputasi khusus dan berdedikasi. Layanan ini menghindari persaingan di kolam sumber daya publik dan merupakan solusi utama untuk kebutuhan real-time dengan throughput tinggi.
Gunakan PTU ketika bisnis Anda memiliki kebutuhan throughput yang pasti (seperti komitmen SLA) atau ketika Anda menginginkan throughput tinggi yang stabil tanpa pengendalian trafik sisi klien.
PTU adalah sumber daya berlangganan yang ditagih secara terus-menerus, bahkan saat tidak sepenuhnya digunakan. Evaluasi spesifikasi yang diperlukan berdasarkan beban puncak aktual untuk menghindari pemborosan.
Pemrosesan batch asinkron (Batch API)
Untuk tugas yang tidak memiliki persyaratan real-time ketat (pembersihan data, analitik batch), gunakan Batch API untuk mengirimnya ke pemrosesan batch. Tugas dijalankan selama jam sepi, mengembalikan hasil secara asinkron, dan tidak tunduk pada batas laju online.
Cocok untuk tugas offline yang dapat menerima waktu pengembalian hitungan jam hingga hari: anotasi data, analisis log, ringkasan batch. Biaya Batch API biasanya lebih rendah daripada panggilan API real-time.
Waktu pengembalian tidak dijamin. Tidak cocok untuk layanan yang memerlukan respons segera. Ambil hasil melalui polling atau callback setelah pengiriman.
Strategi pengendalian trafik sisi klien
Ketika solusi platform (seperti server-side queuing dan peningkatan kuota) tidak cukup, tambahkan pengendalian trafik di sisi klien. Prinsip intinya: sebarkan permintaan secara merata dalam jendela waktu untuk menghindari lonjakan. Setelah startup sistem atau periode idle panjang, tingkatkan konkurensi secara bertahap.
Empat strategi diurutkan berdasarkan kompleksitas yang meningkat. Setiap strategi mencakup strategi sebelumnya dan menambahkan fitur baru:
- Retry dasar hanya memberikan perlindungan pasif.
- Pembatasan laju permintaan menambahkan antrian aktif.
- Traffic shaping lebih lanjut memperkenalkan kontrol tingkat token dan pengiriman lancar.
- Adaptive congestion control secara dinamis menyesuaikan laju pengiriman berdasarkan umpan balik real-time.
Perbandingan performa throughput setiap strategi
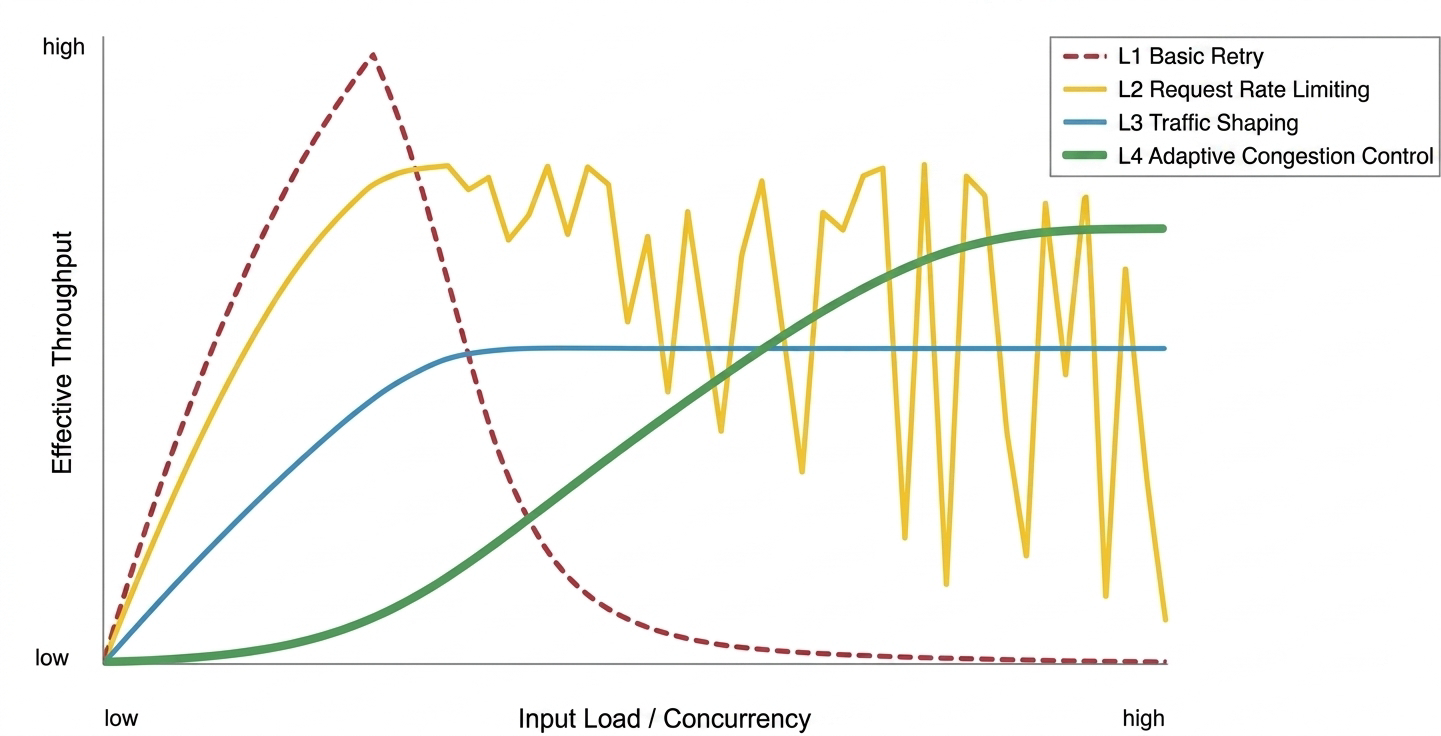
- Strategi retry dasar: Efektif di bawah beban rendah. Rentan terhadap keruntuhan kemacetan di bawah konkurensi tinggi, menyebabkan penurunan tajam dalam throughput.
- Strategi pembatasan laju permintaan: Perlindungan kuat terhadap keruntuhan. Namun, di bawah beban campuran dengan teks panjang, throughput menunjukkan fluktuasi seperti gergaji karena kurangnya kontrol token.
- Strategi traffic shaping: Stabilitas tinggi. Mencapai output lancar dengan mengorbankan sebagian throughput puncak.
- Strategi adaptive congestion control: Dapat secara dinamis konvergen ke titik throughput tinggi yang stabil di bawah beban tinggi, tetapi memiliki overhead probing cold-start.
Strategi retry dasar
Cocok untuk pengujian pribadi, skrip lokal, dan tugas latar belakang frekuensi rendah. Tidak ada batas laju pada permintaan keluar. Hanya memicu retry exponential backoff dengan jitter acak pada error 429 atau 5xx.
Tidak ada pengendalian trafik proaktif. Di bawah konkurensi multi-threaded, strategi ini mudah memicu rate limiting dan menyebabkan penumpukan permintaan.
Contoh kode
Contoh kode
- Waktu tunggu berlipat ganda secara progresif: Misalnya,
1s, 2s, 4s.... Ini menghindari permintaan berulang dalam periode singkat. - Tambahkan jitter acak: Nilai acak (seperti
2s +/- 0.5s) menyebarkan trafik retry, mencegah banjir sekunder (efek thundering herd).
Strategi pembatasan laju permintaan
Retry pasif saja tidak dapat menangani trafik nyata. Retry yang sering meningkatkan latensi. Strategi ini memperkenalkan pengendalian trafik aktif: periksa dan kendalikan permintaan sebelum mengirimnya, mengatur trafik tidak teratur menjadi antrian yang menghormati batas RPM. Penghalusan aktif menambahkan penundaan antrian kecil yang dapat diprediksi — jauh lebih kecil daripada biaya loop "error — tunggu — retry". Biaya kecil yang diketahui lebih baik daripada biaya besar yang tidak diketahui.
Cocok untuk chatbot dan layanan request-response ringan lainnya yang sensitif terhadap waktu hingga token pertama.
Antrian aktif sisi klien menggunakan dua tingkat pengendalian:
- RPM token bucket: Membatasi total permintaan per menit. Kapasitas bucket sama dengan kuota RPM; token diisi ulang pada laju konstan. Mendukung peminjaman: jika token tidak mencukupi, permintaan meminjam dari kuota masa depan, FIFO ketat.
- Concurrency semaphore: Membatasi permintaan konkuren untuk mencegah konkurensi instan tinggi memicu batas RPS.
initial_tokens=rpm_limit), cocok untuk layanan online yang perlu memproses permintaan segera saat startup. Jika bucket penuh memicu rate limiting, turunkan nilai awal (misalnya, initial_tokens=0 untuk "start bucket kosong") untuk meningkatkan secara lebih bertahap.
Strategi ini tidak melacak penggunaan token. Tugas teks panjang masih dapat menghabiskan kuota TPM.
Contoh kode
Contoh kode
Strategi traffic shaping
Dalam skenario batch yang memerlukan throughput tinggi dan stabil (ingesti RAG real-time, analisis dokumen panjang massal), pembatasan laju permintaan memiliki titik buta TPM. Traffic shaping menambahkan kesadaran sumber daya ganda (RPM & TPM) dan mekanisme shaping yang mengubah trafik lonjakan menjadi aliran lancar.
Penyempurnaan dibandingkan pembatasan laju permintaan:
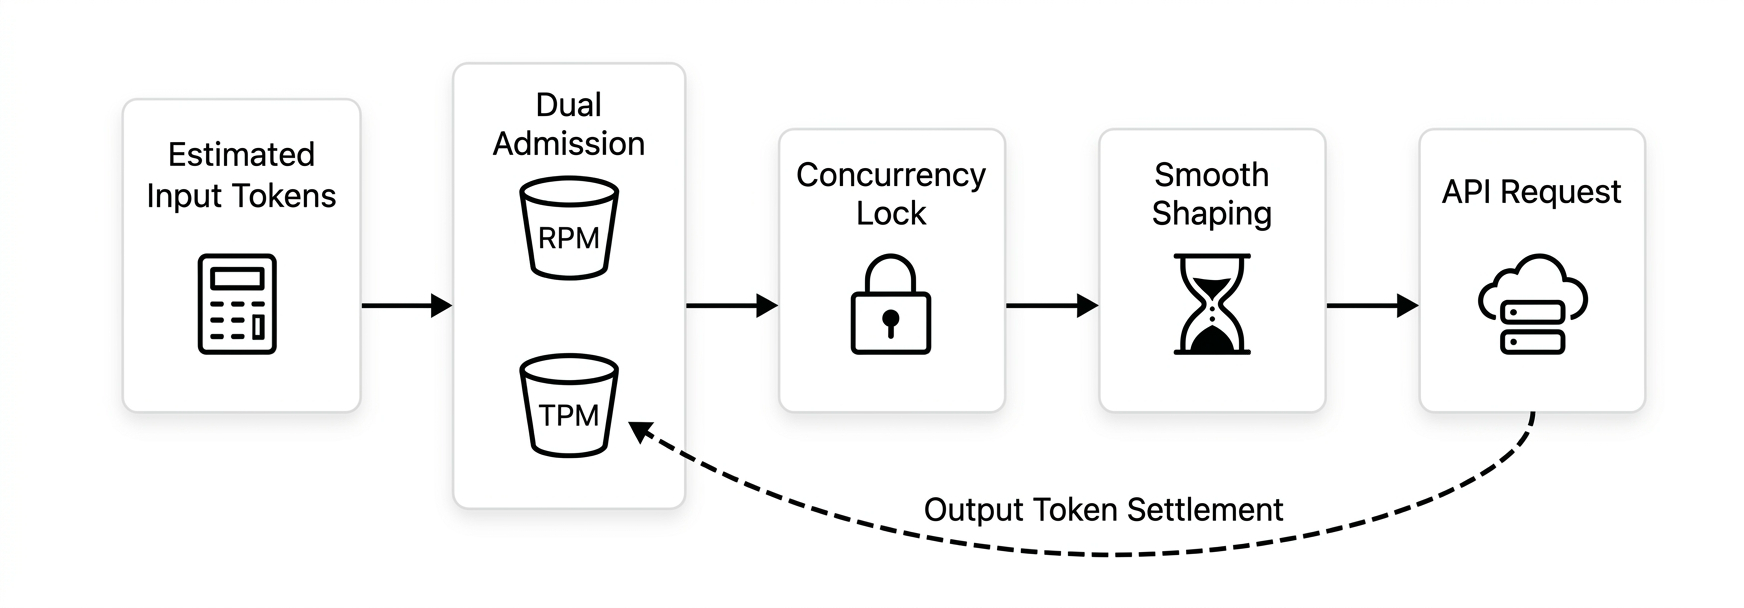
- Kontrol sumber daya ganda (RPM & TPM): Memelihara kedua bucket token RPM dan TPM. Semua permintaan harus lulus pemeriksaan kuota untuk kedua dimensi sebelum dikirim.
- Deduksi awal untuk input, penyelesaian akhir untuk output: Panjang output tidak diketahui sebelum permintaan. Bucket TPM mendeduksi token input saat mengirim dan menyelesaikan token output aktual setelah selesai. Bahkan jika token menjadi negatif, permintaan berikutnya menunggu hingga jumlahnya positif, secara alami menghaluskan aliran.
- Pemanasan kontinu: Selama cold start, laju penerbitan token meningkat secara linear seiring waktu, menghilangkan risiko lonjakan awal.
- Smoothing rate limiter (Pacing): Menghaluskan laju pengiriman dengan menerapkan interval minimum antarpermintaan (pacing), mengurangi risiko memicu batas laju.
initial_tokens=0) untuk start aman dengan kompleksitas lebih rendah. Token bucket Python di sini hanya untuk demonstrasi. Di produksi, gunakan pustaka pembatasan laju matang seperti SmoothRateLimiter Guava di Java.
Dalam contoh kode, tunggu penghalusan ditempatkan di dalam kunci konkurensi. Beberapa permintaan mungkin bersaing untuk semaphore secara simultan setelah waktu tunggu mereka berakhir, mengelompokkan kembali trafik di pintu keluar. Penghalusan di dalam kunci sedikit mengurangi efisiensi konkurensi tetapi memastikan interval pengiriman yang tepat.
Pipeline traffic shaping lengkap adalah: Perkirakan token input → Admisi ganda (RPM & TPM) → Kunci konkurensi → Traffic shaping → Kirim → Selesaikan token output.
Contoh kode
Contoh kode
Strategi pengendalian kemacetan adaptif
Cocok untuk beban kerja skala besar dan dinamis: gerbang API, proxy kompleks, sistem multi-penyewa.
- Paradoks performa: Jika beban dapat diprediksi (seperti pemrosesan batch), parameter statis optimal mengungguli probing dinamis yang memerlukan "percobaan dan konvergensi".
- Overhead probing: Algoritma dinamis pasti melibatkan ramp-up cold-start dan fluktuasi eksploratif — overhead yang tidak perlu dalam skenario yang diketahui.
- Biaya pemeliharaan: Umpan balik loop tertutup meningkatkan kompleksitas sistem dan kesulitan troubleshooting.
- EBP: Menyimpan watermark historis tertinggi yang berhasil. Menghitung gain probing dengan mensimulasikan tegangan pegas berdasarkan jarak dari konkurensi saat ini ke watermark (lebih jauh = lebih cepat, lebih dekat = lebih lambat). Menambahkan dorongan linier kecil untuk terus mengeksplorasi bahkan pada saturasi tinggi.
- Kesadaran kemacetan TPT: Waktu generasi model bahasa besar meningkat seiring panjang output — latensi tinggi pada teks panjang bukan berarti kemacetan. TPT (Time Per Token) menyaring noise panjang konten. Kemacetan hanya dinyatakan ketika TPT menurun secara signifikan.
- Pengatur laju anti-lonjakan: Terlepas dari target EBP, pengatur membatasi percepatan pertumbuhan konkurensi untuk memastikan ramp-up lancar dan menghindari perubahan langkah yang memicu batas laju pertumbuhan.
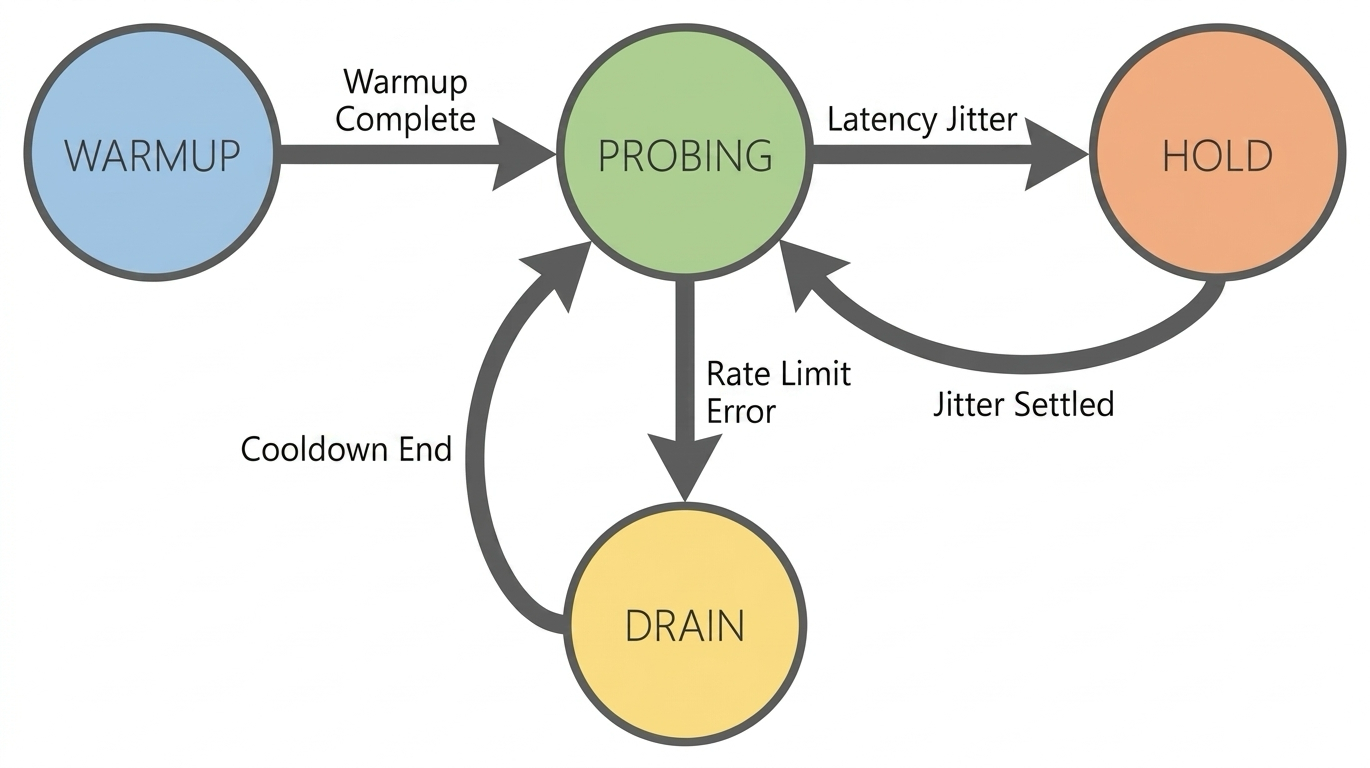
- Probing terpandu: Memperkenalkan kuota RPM/TPM yang diketahui sebagai "batas atas panduan" untuk menghindari tabrakan berulang akibat probing buta.
- Sumber sinyal (RTT → TPT): BBR asli menggunakan RTT. Dalam skenario model bahasa besar, latensi panjang konten jauh lebih besar daripada fluktuasi jaringan. TPT menghilangkan gangguan tersebut.
- Peningkatan mekanisme respons (ProbeRTT → Hold): Menghadapi fluktuasi latensi, memilih mempertahankan tingkat konkurensi saat ini alih-alih mundur proaktif dan mengurangi throughput.
- Respons batas laju keras (Packet Loss → 429 Drain): Setelah error
429dipicu, masuk ke keadaan Drain agresif dan melakukan pemulihan cepat setelah periode cooldown.
- Noise TPT: TPT diperkirakan sebagai "latensi total / total token". Latensi total mencakup round-trip jaringan, antrian, dan waktu hingga token pertama — rentan terhadap jitter atau input panjang, yang dapat memicu salah keadaan Hold.
- Starvation permintaan besar: Menggunakan wakeup FIFO non-ketat untuk performa penjadwalan. Ketika kuota langka, permintaan token pendek dapat mendahului sumber daya, menyebabkan permintaan token panjang menunggu terlalu lama.
- Cold start: Memerlukan periode pemanasan untuk membangun model statistik. Dalam tugas beban rendah atau berumur pendek, throughput mungkin lebih rendah daripada tiga strategi pertama.
Contoh kode
Contoh kode
Solusi fallback arsitektural
Ketika konfigurasi platform dan pengendalian trafik sisi klien masih tidak dapat memenuhi persyaratan ketersediaan atau throughput puncak, tambahkan mekanisme fallback di tingkat arsitektur.
Model fallback
Ketika model utama tidak dapat merespons karena rate limiting atau masalah layanan, secara otomatis fallback ke model alternatif dengan kuota yang lebih longgar.
Prinsip desain jalur fallback
- Pilih model dari seri berbeda: Rate limiting berlaku per model. Gunakan model berbeda sebagai fallback — misalnya, fallback dari
qwen3.6-pluskeqwen3.6-flash. - Picu fallback hanya pada error rate limit: Fallback pada error
429, bukan semua exception. Mengganti model tidak akan memperbaiki timeout jaringan atau error parameter. - Validasi model fallback terlebih dahulu: Pastikan model tersebut mendukung fitur yang diperlukan (Function Calling, structured output, dll.) untuk menghindari masalah fungsional setelah fallback.
Contoh kode
Contoh kode
Peak-load shifting menggunakan message queues (MQ)
Untuk layanan backend yang tidak memerlukan respons segera, perkenalkan middleware pesan (RabbitMQ, Kafka) untuk peak-load shifting. Trafik lonjakan masuk ke MQ terlebih dahulu; konsumen menarik dan memproses pada laju stabil yang sesuai dengan kuota rate limit. Ini memisahkan puncak frontend dari panggilan backend.
Cocok untuk bisnis di mana pengguna menerima hasil asinkron: pemrosesan tiket, moderasi konten, anotasi data batch.
Poin desain utama:
- Pengendalian laju konsumen: Sisi konsumen harus menggunakan strategi pembatasan laju permintaan atau traffic shaping untuk mengonsumsi pesan pada laju stabil berdasarkan kuota RPM/TPM, alih-alih menarik pesan tanpa batas.
- Penanganan dead-letter: Pindahkan pesan yang gagal setelah beberapa kali retry ke dead-letter queue dan picu alert. Cegah retry tak terbatas menghambat konsumsi.
- Propagasi back-pressure: Ketika backlog MQ melebihi ambang batas, propagasikan tekanan ke hulu (misalnya, kembalikan status antrian) untuk mencegah pertumbuhan antrian tak terbatas.
Pertimbangan lingkungan produksi
Contoh kode menggunakan loop single-threaded asyncio Python untuk mendemonstrasikan algoritma inti. Sebelum penggunaan produksi skala besar, pertimbangkan hal berikut.
-
Adaptasi ke model non-teks
Strategi di atas menggunakan model teks sebagai contoh, tetapi prinsip intinya berlaku untuk layanan multimodal (generasi gambar, sintesis suara). Satuannya berbeda, tetapi esensinya sama: membatasi laju pengiriman dan kapasitas pemrosesan.
- Model seperti pengenalan suara biasanya dibatasi oleh jumlah permintaan per satuan waktu (seperti RPM) dan penggunaan (seperti durasi audio). Strateginya pada dasarnya sama dengan model teks.
- Model untuk gambar dan video biasanya dibatasi oleh laju pengiriman tugas dan jumlah tugas konkuren. Anda dapat menggunakan pendekatan yang sama seperti strategi pembatasan laju permintaan: batasi laju pengiriman tugas dan gunakan semaphore untuk mengontrol konkurensi.
-
Atomicity dalam model konkuren
Contoh:
asynciomenggunakan penjadwalan kooperatif single-threaded, sehingga modifikasi state secara inheren atomik dalam satu proses. Produksi: Di lingkungan multi-threaded atau multi-proses, pastikan keamanan konkurensi bucket token dan jendela statistik. Race condition akan merusak pengendalian trafik. - Pembatasan laju terdistribusi Contoh: Semua komponen pengendalian trafik berada di memori. Produksi: Dalam penyebaran multi-instans, setiap instans melakukan throttling secara independen. Total penggunaan mungkin melebihi batas. Gunakan penghitung terpusat (seperti Redis) untuk mengelola penggunaan di semua node.
- Antrian prioritas dan pencegahan starvation Contoh: Tidak ada diferensiasi prioritas. Strategi adaptive congestion control menggunakan wakeup FIFO non-ketat untuk performa penjadwalan. Produksi: Untuk permintaan prioritas tinggi/rendah, implementasikan antrian prioritas berbobot untuk menjamin bandwidth bagi trafik prioritas tinggi. Cadangkan kuota minimum untuk antrian prioritas rendah untuk mencegah starvation.