

Topik ini menjelaskan kemampuan input panjang dan prefix cache penerapan PTU (Provisioned Throughput), termasuk aturan konsumsi kuota, cara menggunakan Provisioned Throughput Quota Calculator, serta deskripsi bidang respons API.
Ikhtisar
PTU (Provisioned Throughput Unit) adalah metode penerapan model yang memesan sumber daya platform untuk menjamin kapasitas throughput TPM tertentu; dalam kuota yang dijamin tidak diterapkan pembatasan laju. Cocok untuk lingkungan produksi dengan throughput tinggi, kinerja tinggi, dan beban tinggi, menyediakan kapasitas throughput yang stabil, latensi lebih rendah, dan kepastian sumber daya yang lebih kuat. Dibandingkan dengan penagihan berbasis token, TPS (token yang dihasilkan per detik) umumnya meningkat sekitar 1,5 hingga 2,0 kali lipat.
Kasus penggunaan:
- Layanan pelanggan cerdas untuk aplikasi perbankan (trafik stabil, memerlukan pengalaman konkuren yang terjamin).
- Moderasi konten real-time untuk platform sosial (memerlukan pemrosesan tugas pipeline yang dapat diprediksi secara stabil).
- API terjemahan public cloud (menyediakan jaminan layanan dasar bagi pengguna paket standar).
Aturan penagihan
费用 = 使用时长 × (输入 TPM 单价 × 输入 TPM + 输出 TPM 单价 × 输出 TPM)
Pascabayar dihitung per jam: satuan durasi penggunaan adalah jam, dan harga satuan diambil dari kolom "Berlanjut 1 jam" dalam tabel di bawah; prabayar dihitung per hari: satuan durasi penggunaan adalah hari, dan harga satuan diambil dari kolom "Berlanjut 1 hari" dalam tabel di bawah.
- Pesanan prabayar berlaku secara real-time setelah pembayaran, dengan masa berlaku N hari yang berakhir pada pukul 23:59 hari ke-N.
- Setelah pesanan prabayar kedaluwarsa, layanan akan dihentikan dengan penundaan 2 jam, dan sumber daya akan dipertahankan selama 14 jam setelah penghentian lalu dirilis.
- Pesanan prabayar mendukung pengakhiran lebih awal; bagian yang telah digunakan diselesaikan dengan koefisien 1,2x untuk pengembalian dana. Untuk detailnya, lihat Aturan pengembalian dana untuk penurunan konfigurasi.
- Untuk penagihan pascabayar, jika akun mengalami tunggakan, sumber daya yang diterapkan akan terus dipertahankan dan ditagih selama 24 jam, dan selama periode tersebut layanan masih dapat digunakan secara normal. Setelah 24 jam, sistem berhenti menagih, penerapan model memasuki status tunggakan, dan sumber daya yang mendasarinya akan dihapus, tetapi tugas penerapan model tetap dipertahankan. Setelah tunggakan dilunasi, sistem akan mengalokasikan ulang sumber daya dan memulihkan penggunaan (biaya akan terus berjalan setelah pemulihan). Jika Anda tidak ingin terus menimbulkan biaya, Anda dapat menghapus tugas penerapan model, dan penagihan akan berhenti setelah penghapusan berhasil.
- Dalam kasus ini (hanya di bawah strategi "auto-overflow"), Header respons API akan menyertakan:
x-dashscope-ptu-overflow:true. - Untuk statistik TPM, buka: Pemantauan model.
Model dan harga yang didukung
- Singapura
- Tiongkok Utara 2 (Beijing)
- Qwen
- DeepSeek
- Qwen-VL
- GLM
Nama Model | Kode Model | Token Input Maksimum | Input Pascabayar Per 10K TPM/jam | Output Pascabayar Per 1K TPM/jam | Input Prabayar Per 10K TPM/hari | Output Prabayar Per 1K TPM/hari |
|---|---|---|---|---|---|---|
Qwen3.8-Max | qwen3.8-max | 1M | $4.8 | $1.44 | $57.6 | $17.28 |
Qwen3.7-Flash-2026-07-15 Hubungi manajer bisnis Anda untuk mengaktifkan | qwen3.7-flash-2026-07-15 | 128K | $0.072 | $0.031 | $0.864 | $0.374 |
Qwen3.7-Max-2026-05-20 | qwen3.7-max-2026-05-20 | 256K | $1.92 | $1.8 | $72 | $21.6 |
Qwen3.7-Plus-2026-05-26 | qwen3.7-plus-2026-05-26 | 256K | $0.96 | $0.384 | $11.52 | $4.608 |
Qwen3.6-Plus-2026-04-02 | qwen3.6-plus-2026-04-02 | 128K | $1.2 | $0.72 | $14.4 | $8.64 |
Qwen3.5-Plus-2026-04-20 | qwen3.5-plus-2026-04-20 | 128K | $0.96 | $0.576 | $11.52 | $6.912 |
Input panjang dan prefix caching
Faktor bertingkat untuk input panjang dan diskon cache bervariasi tergantung model. Tabel berikut mencantumkan parameter untuk model yang saat ini didukung:
Model | Tipe | Panjang input maksimum | Diskon cache | Faktor kapasitas bertingkat input panjang |
|---|---|---|---|---|
glm-5.2 | PTU | (0, 1M) | 0,25 | 1 |
qwen3.8-flash | PTU | (0, 1M) | 0,125 | 1 |
qwen3.8-max | PTU | (0, 1M) | 0,125 | 1 |
qwen3.7-flash-2026-07-15 | PTU | (0, 1M) | 0,2 | Sama untuk input dan output |
deepseek-v4-flash-0731 | PTU | (0, 1M) | 0,1 | 1 |
qwen3.7-plus-2026-05-26 | PTU | PTU | 1 Juta | 0,2 (bagian yang mengenai cache dihitung pada 20% kapasitas) |
glm-5.1 | PTU | PTU | 200K | 0,2 (bagian yang mengenai cache dihitung pada 20% kapasitas) |
deepseek-v4-pro | PTU | PTU | 256K | 0,08 (bagian yang mengenai cache dihitung pada 8% kapasitas) |
Model lainnya | PTU | PTU | Mengacu pada konsol | Mengacu pada konsol |
Contoh perhitungan (menggunakan glm-5.1)
Kalkulator Kuota Provisioned Throughput
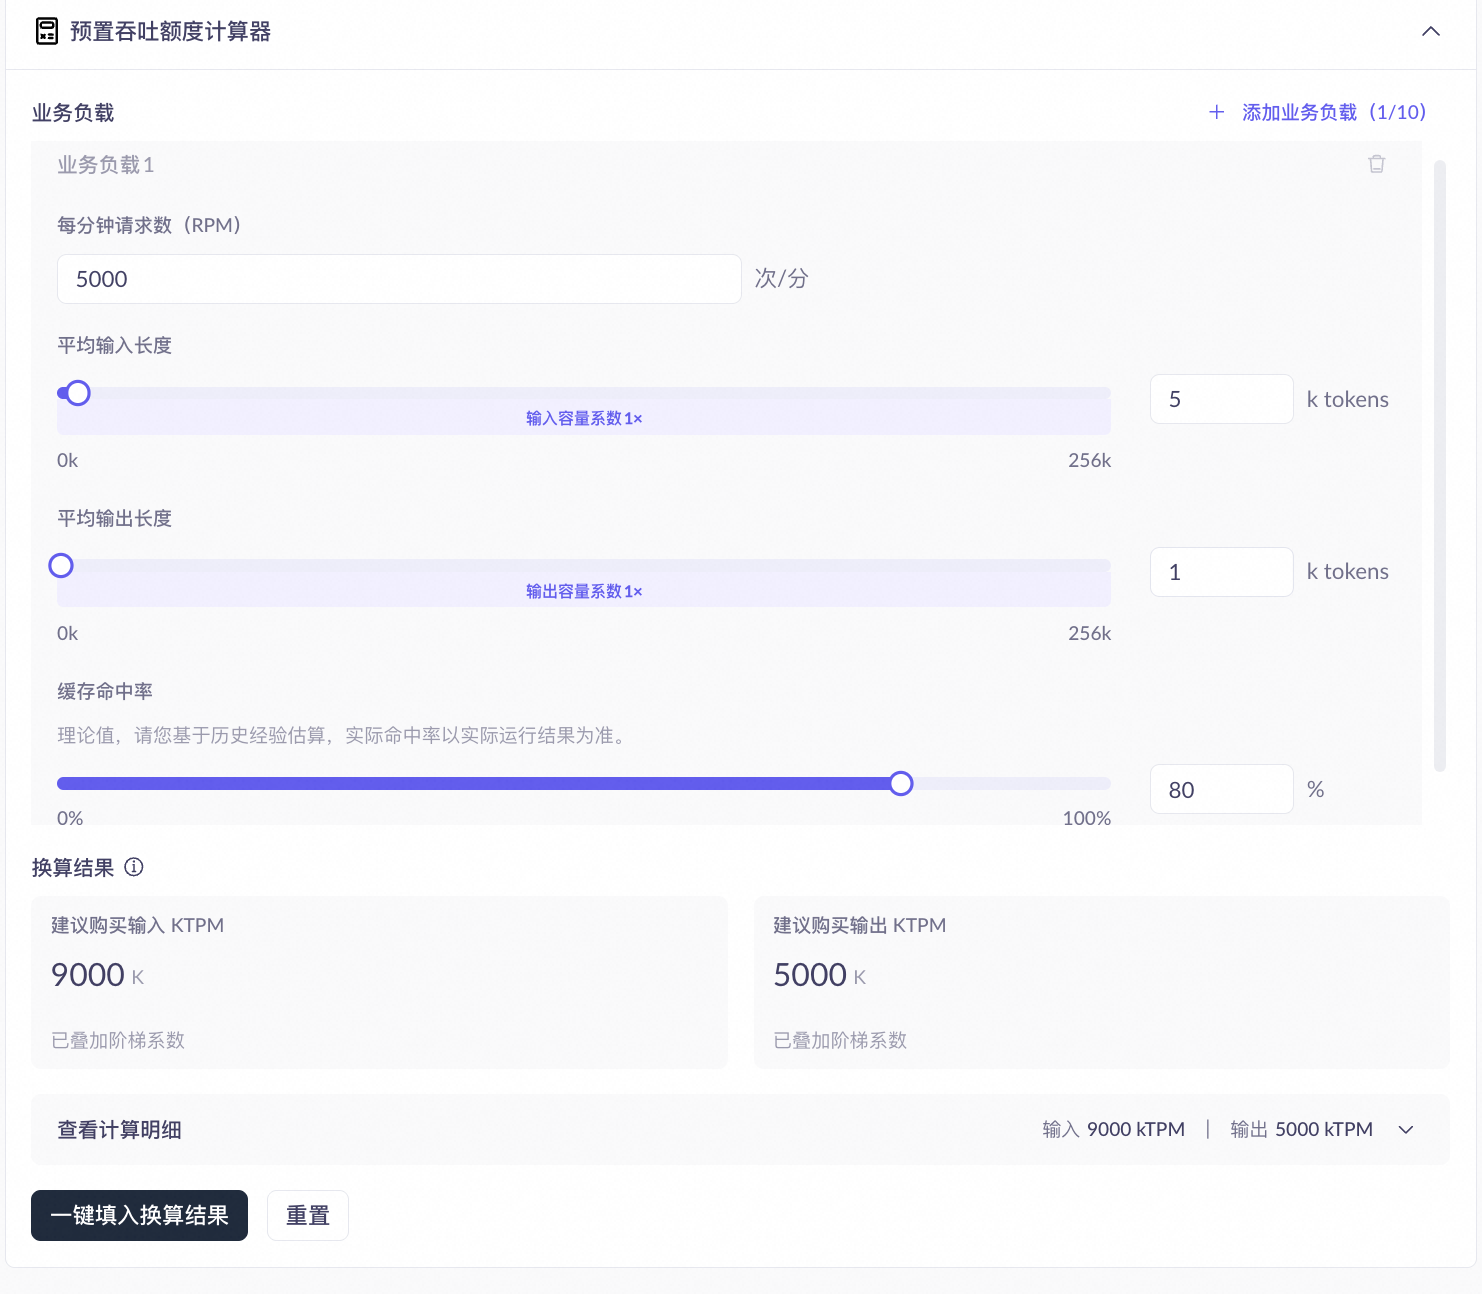
Parameter | Deskripsi | Dampak terhadap hasil |
|---|---|---|
Permintaan per menit (RPM) | Jumlah permintaan per menit selama jam sibuk bisnis. | Semakin besar RPM, semakin tinggi KTPM input dan output yang direkomendasikan secara proporsional. |
Panjang input rata-rata (token) | Rata-rata jumlah token input per permintaan. | Semakin panjang input, semakin tinggi tingkatan dan koefisiennya, serta semakin tinggi KTPM input yang direkomendasikan. Batas tingkatan bervariasi tergantung model; untuk nilai aktual, mengacu pada konsol. |
Panjang output rata-rata (token) | Rata-rata jumlah token output per permintaan. | Semakin panjang output, semakin tinggi kemungkinan koefisien, dan semakin tinggi KTPM output yang direkomendasikan. |
Tingkat hit cache (%) | Persentase token awalan permintaan yang mengenai cache. Tingkat hit aktual bergantung pada pengulangan konten permintaan; mengacu pada hasil runtime aktual. | Tingkat hit yang lebih tinggi memperlambat konsumsi kuota input, sehingga menurunkan KTPM input yang direkomendasikan. Hanya memengaruhi KTPM input, bukan KTPM output. |
Bidang respons API
Respons API untuk penerapan PTU mencakup bidang terkait kuota berikut yang mengidentifikasi metode penagihan dan konsumsi kuota:
Bidang | Tipe | Deskripsi |
|---|---|---|
| String | Bidang respons tingkat atas (konsisten di semua format API). Nilai |
| Integer | Token kuota PTU aktual yang dikonsumsi setelah konversi (mencakup faktor bertingkat dan diskon cache). |
| Integer | Jumlah token yang mengenai prefix cache. Untuk detailnya, lihat Context Cache. |
- Kompatibel OpenAI Chat
- Respons OpenAI
- Kompatibel Anthropic
- DashScope
Bidang | Jalur JSON | Deskripsi |
|---|---|---|
|
| Jumlah token cache di sisi input |
|
| Konsumsi kuota PTU di sisi input |
|
| Konsumsi kuota PTU di sisi output |
Pemantauan dan verifikasi
Anda dapat memantau penerapan PTU melalui fitur pemantauan model di platform Model Studio. Metrik berikut relevan dengan input panjang dan caching:
- Pemanfaatan PTU: Tiga kurva independen untuk input, output, dan output mode thinking. Dalam skenario input panjang, faktor bertingkat dapat menyebabkan pemanfaatan melebihi 100%. Hal ini merupakan perilaku yang diharapkan.
- Penggunaan token dan hit cache: Mencakup deret data
cached_tokensuntuk menunjukkan proporsi hit cache terhadap total input. - Jumlah panggilan dalam kuota dan luar kuota: Menunjukkan proporsi permintaan yang melebihi kuota PTU (di bawah strategi auto-overflow, permintaan beralih ke penagihan bayar sesuai penggunaan; di bawah strategi use-only-PTU-capacity, kesalahan 429 dikembalikan).
Penskalaan
Klik tombol Scaling untuk menyesuaikan throughput (jumlah instans) secara mandiri dan manual. Untuk aturan terperinci pengurangan biaya dan pengembalian dana, lihat: Aturan pengembalian dana untuk penurunan konfigurasi.
FAQ
T: Apa yang terjadi ketika kuota PTU terlampaui?
T: Apa yang terjadi ketika kuota PTU terlampaui?
service_tier dalam respons API tidak dikembalikan atau bernilai default, dan header respons menyertakan x-dashscope-ptu-overflow:true, sehingga layanan tidak terputus; di bawah strategi "use-only-PTU-capacity", permintaan yang melebihi kuota mengembalikan kesalahan 429 dan tidak ada biaya tambahan yang ditagihkan.T: Apa yang terjadi jika satu input melebihi batas model?
T: Apa yang terjadi jika satu input melebihi batas model?
T: Bagaimana cara memverifikasi bahwa caching berfungsi?
T: Bagaimana cara memverifikasi bahwa caching berfungsi?
cached_tokens dalam respons API. Nilai lebih dari 0 menunjukkan terjadinya hit prefix cache. Token yang mengenai cache mengonsumsi kuota dengan koefisien diskon model (untuk tarif diskon spesifik, lihat Input panjang dan prefix caching). Anda juga dapat melihat trennya pada grafik penggunaan token di halaman pemantauan konsol.T: Bagaimana jika cached_tokens selalu 0 dan caching tidak berfungsi?
T: Bagaimana jika cached_tokens selalu 0 dan caching tidak berfungsi?
T: Mengapa pemanfaatan melebihi 100%?
T: Mengapa pemanfaatan melebihi 100%?