

Saat menggunakan image-to-video , jika optimasi prompt atau pemanggilan efek video resmi tidak memenuhi kebutuhan kustom Anda untuk aksi, efek, atau gaya tertentu , gunakan model fine-tuning .
Ruang lingkup penerapan
- Wilayah yang didukung: Fitur yang dijelaskan dalam dokumen ini hanya tersedia di wilayah Singapura. Anda harus menggunakan API key yang dibuat di wilayah ini.
- Metode fine-tuning yang didukung: Fine-tuning SFT-LoRA efisien.
-
Model yang didukung untuk fine-tuning:
- Image-to-video (berbasis frame pertama): wan2.7-i2v, wan2.6-i2v, wan2.5-i2v-preview, wan2.2-i2v-flash.
- Image-to-video (berbasis frame pertama dan terakhir): wan2.2-kf2v-flash.
Cara melakukan fine-tuning model
- Image-to-video (berbasis frame pertama)
- Image-to-video (berbasis frame pertama dan terakhir)
Gambar input frame pertama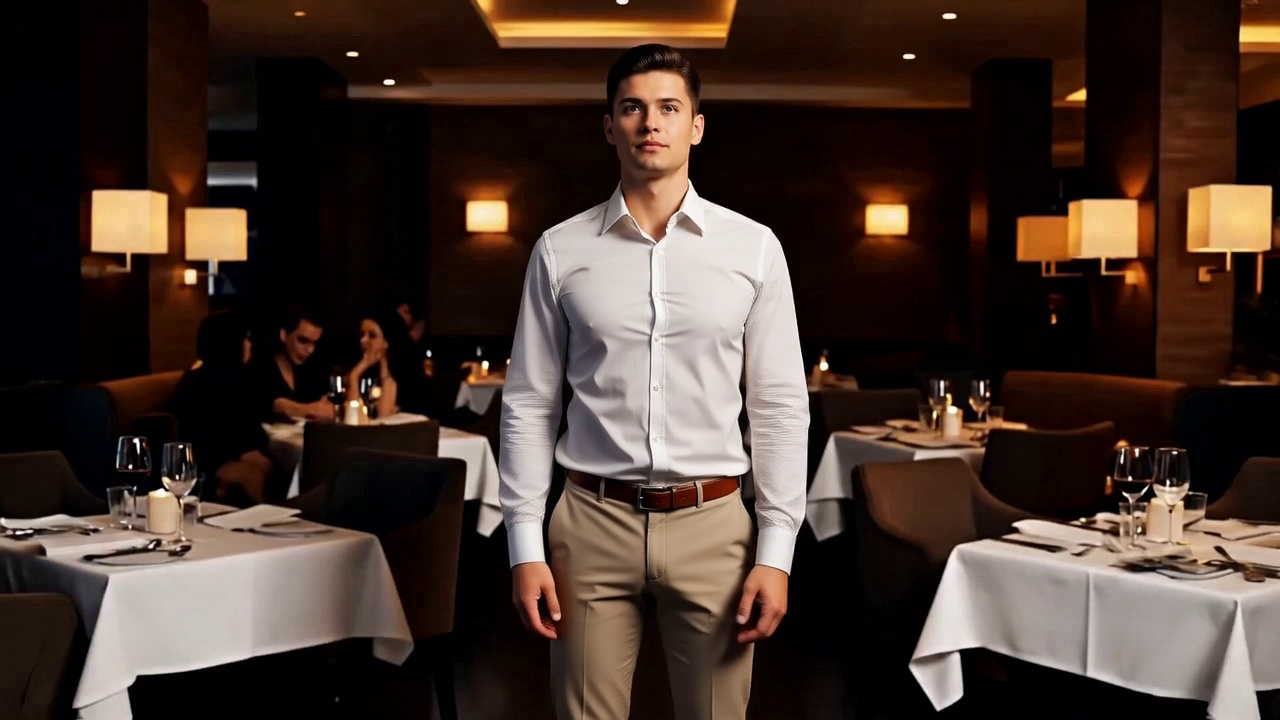 | Video output (sebelum fine-tuning)Anda tidak dapat menghasilkan efek hujan uang yang konsisten setiap kali menggunakan prompt. Gerakan tidak dapat dikontrol. | Video output (setelah fine-tuning)Model yang telah difine-tune mereproduksi efek hujan uang spesifik dari dataset pelatihan tanpa memerlukan prompt. |
Langkah 1: Unggah dataset Anda
Unggah dataset lokal Anda (dalam format .zip) ke Alibaba Cloud Model Studio dan catat ID file (id).
Contoh training dataset: Lihat training set untuk detail format.
- Image-to-video (berbasis frame pertama): wan-i2v-training-dataset.zip.
- Image-to-video (berbasis frame pertama dan terakhir): wan-kf2v-training-dataset.zip.
Contoh ini menggunakan model image-to-video berbasis frame pertama. Cukup unggah training set; sistem akan secara otomatis membagi sebagian datanya sebagai validation set. Proses pengunggahan dataset memerlukan beberapa menit, tergantung pada ukuran file.
id. Ini adalah pengenal unik untuk dataset yang Anda unggah.
Langkah 2: Fine-tune model
Langkah 2.1 Buat pekerjaan fine-tuning
Mulai pelatihan menggunakan ID file dari Langkah 1. Contoh permintaan Ganti<ganti dengan ID file dataset pelatihan> sepenuhnya dengan id dari langkah sebelumnya.
| Field | Type | Required | Description | Recommended value |
|---|---|---|---|---|
| batch_size | int | Yes | Ukuran batch. Jumlah sampel data yang dikirim ke model untuk pelatihan sekaligus.Parameter ini merupakan konfigurasi per-instans. Kami menyarankan menggunakan nilai default untuk setiap model. Jangan sesuaikan kecuali diperlukan.
Jumlah instans aktual yang berjalan untuk pekerjaan pelatihan ditentukan oleh penjadwalan platform. Global Step yang ditampilkan di log pelatihan mungkin berbeda dari hasil perkiraan, tetapi hal ini tidak mengubah jumlah total data pelatihan atau memengaruhi kinerja akhir model. | Tergantung model |
| n_epochs | int | Yes | Epoch pelatihan. steps = n_epochs x ceiling(ukuran dataset / batch_size). Total langkah harus >= 800.Contoh: dataset memiliki 5 sampel, batch_size=4, langkah per epoch = ceiling(5/4) = 2, epoch minimum = 800/2 = 400. Jumlah epoch pelatihan yang direkomendasikan menyesuaikan secara otomatis berdasarkan volume data. Data yang lebih sedikit memerlukan lebih banyak epoch untuk belajar secara cukup; data yang lebih banyak berarti setiap epoch berisi lebih banyak sampel, sehingga diperlukan lebih sedikit epoch. 50 epoch terutama cocok untuk dataset yang sangat kecil sekitar 2 sampel; ketika volume data mencapai 50–60 video, biasanya direkomendasikan untuk melatih sekitar 3000–5000 langkah. | 50 |
| learning_rate | float | Yes | Tingkat pembelajaran. Mengontrol besarnya pembaruan bobot model. Terlalu tinggi dapat menurunkan kualitas model; terlalu rendah dapat menghasilkan perubahan yang tidak signifikan. | 2e-5 |
| eval_epochs | int | Yes | Interval evaluasi. Nilai harus >= n_epochs/10. Menentukan berapa banyak epoch antara setiap evaluasi dan penyimpanan checkpoint. | 20 |
| max_pixels | int | Yes | Resolusi maksimum untuk video pelatihan (total piksel = lebar x tinggi). Sistem hanya menskalakan video yang melebihi nilai ini.
| Tergantung model |
| split | float | No | Rasio pemisahan training set. Rentang nilai: (0,1). Hanya berlaku saat validation_datasets tidak ditentukan. | 0.9 |
| max_split_val_dataset_sample | int | No | Jumlah maksimum sampel validasi dari pemisahan otomatis. Jumlah validasi = min(total x (1 - split), nilai ini). | 5 |
| save_total_limit | int | No | Jumlah maksimum checkpoint yang disimpan. Sistem hanya menyimpan N checkpoint terakhir. | 10 |
| lora_rank | int | No | Dimensi matriks low-rank LoRA. Nilai harus 2n (16/32/64). | 32 |
| lora_alpha | int | No | Koefisien penskalaan bobot LoRA. Nilai harus 2n (16/32/64). | 32 |
output:
job_id: ID pekerjaan. Gunakan untuk memeriksa progres.finetuned_output: Nama model fine-tuned baru. Gunakan nama ini untuk deployment.status: Status pelatihan. Setelah membuat pekerjaan, status awalnya adalah PENDING. Pelatihan belum dimulai.
Langkah 2.2 Periksa status pekerjaan fine-tuning
Gunakanjob_id dari Langkah 2.1 untuk memeriksa progres. Poll endpoint ini hingga status menjadi SUCCEEDED.
<ganti dengan job_id pekerjaan fine-tuning> di URL sepenuhnya dengan nilai job_id.
output:
status: Ketika nilai ini menjadi SUCCEEDED, pelatihan selesai. Anda dapat menerapkan model.usage: Total token yang digunakan untuk pelatihan. Digunakan untuk penagihan.
Langkah 3: Terapkan model yang telah difine-tune
Langkah 3.1 Terapkan model sebagai layanan online
Setelah status pekerjaan fine-tuning berubah menjadi SUCCEEDED, terapkan model tersebut sebagai layanan online. Contoh permintaan Ganti<ganti dengan nama model model_name> sepenuhnya dengan nilai finetuned_output dari membuat pekerjaan fine-tuning.
output:
deployed_model: Nama model yang diterapkan. Gunakan untuk memeriksa status deployment dan memanggil model.status: Status deployment. Setelah menerapkan model fine-tuned, status awalnya adalah PENDING, yang menandakan bahwa deployment belum dimulai.
Langkah 3.2 Periksa status deployment
Poll endpoint ini hinggastatus berubah menjadi RUNNING.
<ganti dengan deployed_model> sepenuhnya dengan nilai deployed_model dari Langkah 3.1.
Contoh respons
Periksa dua parameter berikut di field output:
status: Ketika status berubah menjadi RUNNING, model berhasil diterapkan dan siap digunakan.deployed_model: Nama model yang diterapkan.
Langkah 4: Panggil model untuk menghasilkan video
Setelah deployment model berhasil (ketika status deployment adalah RUNNING), Anda dapat mulai memanggil model.
Langkah 4.1: Buat tugas pembuatan video dan dapatkan task_id
Langkah 4.1: Buat tugas pembuatan video dan dapatkan task_id
<ganti dengan nama deployed_model> dengan nilai deployed_model yang dihasilkan dari langkah sebelumnya.- Image-to-video (berbasis frame pertama)
- Image-to-video (berbasis frame pertama dan terakhir)
Panggilan model Wan2.7
Panggilan model Wan2.7
Pemanggilan model Wan2.6/Wan2.5/Wan2.2
Pemanggilan model Wan2.6/Wan2.5/Wan2.2
task_id untuk menanyakan hasil pada langkah berikutnya.duration), lihat dokumentasi API.Field | Type | Required | Description | Contoh nilai |
|---|---|---|---|---|
model | string | Yes | Nama model. Anda harus menggunakan model fine-tuned yang berhasil diterapkan dan memiliki status RUNNING. | xxxx-ft-202511111122-xxxx |
input.prompt | string | No | Text prompt. Apa parameter ini berlaku tergantung pada pengaturan aigc_config.use_input_prompt:
| - |
parameters.resolution | string | No | Resolusi video yang dihasilkan. Model wan2.2 dan wan2.5: 480P, 720P. Default adalah 720P. Model wan2.6: 720P, 1080P. Default adalah 720P. Model wan2.7: 720P, 1080P. Default adalah 1080P. | 720P |
parameters.prompt_extend | boolean | No | Aktifkan penulisan ulang prompt. Saat memanggil model LoRA yang telah difine-tune, nonaktifkan ini. Atur ke false. | false |
Langkah 4.2: Tanyakan hasil menggunakan task_id
Langkah 4.2: Tanyakan hasil menggunakan task_id
task_id hingga task_status menjadi SUCCEEDED, lalu dapatkan URL video.Contoh permintaan
Ganti 86ecf553-d340-4e21-xxxxxxxxx dengan task_id yang sebenarnya.
URL video berlaku selama 24 jam. Unduh video segera.
Buat dataset kustom
Selain menggunakan dataset contoh dalam panduan ini, Anda dapat membuat dataset sendiri untuk fine-tuning.
Dataset Anda harus mencakup training set (wajib) dan boleh mencakup validation set (opsional, mendukung pemisahan otomatis dari training set). Kemas semua file ke dalam file .zip. Gunakan hanya huruf Inggris, angka, garis bawah, atau tanda hubung dalam nama file.
Format dataset
Training set: Wajib
- Image-to-video (berbasis frame pertama)
- Image-to-video (berbasis frame pertama dan terakhir)
- Contoh training set: wan-i2v-training-dataset.zip.
- Struktur direktori ZIP:
- File anotasi (data.jsonl): Setiap baris adalah satu sampel pelatihan. Harus berupa objek JSON. Struktur:
Validation set: Opsional
- Image-to-video (berbasis frame pertama)
- Image-to-video (berbasis frame pertama dan terakhir)
- Contoh validation set: wan-i2v-valid-dataset.zip.
- Struktur direktori ZIP:
- File anotasi (data.jsonl): Setiap baris adalah satu sampel validasi. Harus berupa objek JSON. Struktur:
Skala data dan batasan
- Volume data: Berikan minimal 10 sampel. Semakin banyak data pelatihan, hasilnya semakin baik. Kami merekomendasikan 20–100 sampel untuk kinerja yang stabil.
- Arsip ZIP: Saat mengunggah melalui API, ukuran total ≤ 1 GB.
-
Persyaratan gambar pelatihan:
- Format: BMP, JPEG, PNG, WEBP.
- Resolusi ≤ 4096×4096.
- Tidak ada batasan keras pada ukuran file individual (sistem melakukan pra-pemrosesan secara otomatis).
-
Persyaratan video pelatihan:
- Format: MP4, MOV.
- Resolusi ≤ 4096×4096.
- Tidak ada batasan keras pada ukuran file individual (sistem melakukan pra-pemrosesan secara otomatis).
- Durasi per video: model wan2.2 direkomendasikan 2–5 detik; model wan2.5 direkomendasikan 2–10 detik; model wan2.6 dan wan2.7 direkomendasikan 2–10 detik.
Pengumpulan dan pembersihan data
1. Tentukan skenario fine-tuning
Wanxiang mendukung fine-tuning untuk image-to-video dalam skenario berikut:- Efek video tetap: Ajarkan model perubahan visual spesifik, seperti carousel atau pergantian kostum ajaib.
- Aksi karakter tetap: Tingkatkan kemampuan model untuk mereproduksi gerakan tubuh spesifik, seperti gerakan tari atau teknik bela diri.
- Gerakan kamera tetap: Replikasi sinematografi kompleks, seperti dorong, tarik, geser, miring, atau bidikan orbit.
2. Kumpulkan aset mentah
- Generasi dan penyaringan AI: Gunakan model dasar Wanxiang untuk menghasilkan video secara batch. Pilih secara manual sampel berkualitas tinggi yang paling sesuai dengan efek target Anda. Ini adalah metode paling umum.
- Pembuatan film dunia nyata: Jika Anda memerlukan realisme tinggi untuk adegan interaktif (misalnya, berpelukan, berjabat tangan), gunakan rekaman nyata.
- Rendering perangkat lunak 3D: Untuk efek atau animasi abstrak yang memerlukan kontrol presisi, gunakan perangkat lunak 3D (misalnya, Blender, Cinema 4D).
3. Bersihkan data
Dimensi | Persyaratan Positif | Contoh negatif |
|---|---|---|
Konsistensi | Fitur inti harus sangat seragam. Contoh: Untuk melatih “rotasi 360 derajat”, semua video harus berputar searah jarum jam dengan kecepatan yang kurang lebih sama. | Arah campuran. Dataset berisi rotasi searah dan berlawanan arah jarum jam. Model tidak tahu arah mana yang harus dipelajari. |
Keragaman | Lebih banyak variasi subjek dan adegan lebih baik. Cakup berbagai subjek (pria, wanita, anak-anak, hewan, bangunan) dan komposisi (close-up, wide shot, sudut tinggi, sudut rendah). Variasikan juga resolusi dan rasio aspek. | Adegan atau subjek tunggal. Semua video menunjukkan “seseorang berpakaian merah berputar di depan dinding putih”. Model mungkin salah menganggap “pakaian merah” dan “dinding putih” sebagai bagian dari efek. Model gagal saat pakaian berubah. |
Keseimbangan | Jenis data harus seimbang. Jika ada beberapa gaya, jumlahnya harus kurang lebih sama. | Ketidakseimbangan parah. 90% adalah video potret, 10% adalah video lanskap. Model mungkin berkinerja buruk pada video lanskap. |
Kemurnian | Visual bersih dan jelas. Gunakan aset asli tanpa gangguan. | Elemen gangguan. Video berisi subtitle, logo, watermark, bilah hitam yang jelas, atau kebisingan. Model mungkin mempelajari watermark sebagai bagian dari efek. |
Durasi | Durasi aset ≤ durasi target. Jika Anda menginginkan video 5 detik, potong aset menjadi 4–5 detik. | Aset terlalu panjang. Anda menginginkan video berdurasi 5 detik, tetapi memberikan aset berdurasi 8 detik kepada model. Hal ini menyebabkan pembelajaran aksi menjadi tidak lengkap dan menghasilkan kesan terputus-putus. |
Anotasi video: Tulis prompt untuk video
Dalam file anotasi dataset (data.jsonl), setiap video memiliki prompt yang sesuai. Prompt menggambarkan konten video. Kualitas prompt secara langsung menentukan apa yang dipelajari model.
| Contoh promptVideo dimulai dengan seorang wanita muda berdiri di depan dinding bata yang ditutupi tanaman ivy. Ia memiliki rambut cokelat kemerahan panjang yang halus, mengenakan gaun tanpa lengan berwarna putih, kalung perak mengilap, dan senyum di wajahnya. Latar belakangnya adalah dinding bata yang ditutupi sulur hijau, terlihat rustic dan alami. Kemudian efek hujan uang s86b5p dimulai, lembaran uang kertas dolar AS berukuran sangat besar (latar belakang krem/pola hijau tua) turun deras seperti hujan lebat, memenuhi dan mengelilinginya secara padat. Uang terus berjatuhan; ia mengangkat kedua lengannya ke atas, leher sedikit mendongak, ekspresi terkejut, benar-benar tenggelam dalam hujan uang liar ini. |
Rumus penulisan prompt
Prompt = [Deskripsi subjek] + [Deskripsi latar belakang] + [Kata pemicu] + [Deskripsi gerakan]
Elemen prompt | Description | Panduan | Contoh |
|---|---|---|---|
Deskripsi subjek | Deskripsikan orang atau objek yang ada dalam frame | Wajib | The video begins with a young woman... |
Deskripsi latar belakang | Deskripsikan lingkungan tempat subjek berada | Wajib | The background is a brick wall covered with green vines... |
Kata pemicu | Kata yang jarang digunakan dan tidak bermakna | Direkomendasikan | s86b5p atau m01aa |
Deskripsi gerakan | Deskripsikan perubahan dinamis selama efek secara detail | Direkomendasikan | Countless huge-sized US dollar bills (beige background/dark green patterns) pour down like a torrential rain... |
Tentang kata pemicu
Tentang kata pemicu
- Apa itu kata pemicu? Berfungsi sebagai "jangkar visual". Banyak gerakan kompleks (misalnya, jalur tari unik atau efek cahaya) sulit dijelaskan dalam teks. Kata pemicu memaksa model menghasilkan efek visual yang tepat saat melihat kata tersebut.
- Mengapa menggunakannya? Fine-tuning membangun pemetaan antara teks dan fitur video. Kata pemicu mengikat efek yang sulit dijelaskan ke kata unik sehingga model dapat mengunci target.
-
Jika kita memiliki kata pemicu, mengapa masih perlu mendeskripsikan gerakan secara detail?
Keduanya memiliki peran berbeda dan bekerja lebih baik bersama.
- Deskripsi gerakan menjelaskan apa yang terjadi dalam adegan. Memberi tahu model tindakan fisik dasar dan logika. Deskripsi gerakan biasanya konsisten di semua sampel.
- Kata pemicu menjelaskan seperti apa tampilan spesifik dari aksi tersebut. Mewakili perubahan dan fitur unik yang tidak dapat dijelaskan dengan kata-kata.
Cara menulis prompt yang baik
Ikuti aturan konsistensi untuk deskripsi efek
Untuk semua sampel yang mengandung efek yang sama, pertahankan bagian deskripsi gerakan se-konsisten mungkin. Terapkan aturan ini pada training set dan validation set.-
Tujuan: Saat model melihat
s86b5pdiikuti deskripsi tetap yang sama dan selalu melihat hujan uang, model belajar bahwa s86b5p = efek visual hujan uang. -
Contoh: Baik subjeknya “wanita muda” atau “pria berjas”, prompt berakhir dengan cara yang sama untuk efek hujan uang: “...then the s86b5p money rain effect begins, countless US dollar bills pour down like a torrential rain...”
Jenis sampel
Konten prompt (Perhatikan konsistensi pada bagian yang digarisbawahi)
Training sample 1
Video dimulai dengan seorang wanita muda yang berdiri di depan dinding bata... (deskripsi lingkungan dihilangkan)...
Kemudian, efek hujan uang s86b5p dimulai: lembaran dolar AS raksasa yang tak terhitung jumlahnya (latar belakang krem/pola hijau tua) mengguyur turun seperti hujan deras, mengenai dan mengelilinginya secara rapat. Lembaran-lembaran uang terus berjatuhan; ia merentangkan tangan ke atas, lehernya sedikit mendongak ke belakang, dengan ekspresi terkejut, sepenuhnya larut dalam hujan uang yang liar ini.Training sample 2
Video dimulai dengan seorang pria berjas di sebuah restoran mewah... (deskripsi lingkungan dihilangkan)...
Lalu efek hujan uang s86b5p dimulai: uang kertas dolar AS berukuran sangat besar yang tak terhitung jumlahnya (latar belakang krem/pola hijau tua) mengguyur turun seperti hujan deras, menghantam dan mengelilinginya dengan rapat. Uang kertas terus berjatuhan; ia merentangkan tangan ke atas, lehernya sedikit mendongak, dengan ekspresi terkejut, sepenuhnya larut dalam hujan uang yang liar ini.Validation sample 1
Video dimulai dengan seorang anak kecil berdiri di depan pemandangan kota... (deskripsi lingkungan tidak disertakan)...
Kemudian, efek hujan uang s86b5p dimulai: lembaran-lembaran dolar AS berukuran raksasa yang tak terhitung jumlahnya (latar belakang krem/pola hijau tua) mengguyur turun seperti hujan deras, menerpa dan mengelilinginya dengan rapat. Sementara lembaran-lembaran uang terus berjatuhan, Kamera perlahan melakukan zoom in. Anak tersebut merentangkan tangannya ke atas, lehernya sedikit mendongak, dengan ekspresi terkejut, sepenuhnya larut dalam hujan uang yang liar ini.
Gunakan AI untuk menghasilkan prompt
Untuk mendapatkan prompt berkualitas tinggi, gunakan model bahasa besar multimodal seperti Qwen-VL untuk membantu.-
Gunakan AI untuk menghasilkan deskripsi awal
-
Brainstorming bebas (cari inspirasi): Jika Anda tidak yakin cara mendeskripsikan efek, biarkan AI menjelajah secara bebas.
- Kirim “
Describe the video content in detail” dan amati output model. - Fokus pada istilah yang digunakan model untuk lintasan gerakan (misalnya, “pour down like a torrential rain”, “camera slowly zooms in”). Istilah ini dapat digunakan untuk optimasi selanjutnya.
- Kirim “
-
Prompt format tetap (standarkan output): Setelah Anda memiliki gambaran kasar, rancang format tetap untuk memandu AI menghasilkan prompt yang sesuai dengan templat Anda.
Kode contoh
Lihat pemahaman visual untuk detail pemanggilan API.
-
Brainstorming bebas (cari inspirasi): Jika Anda tidak yakin cara mendeskripsikan efek, biarkan AI menjelajah secara bebas.
-
Ekstrak templat efek
- Jalankan proses ini beberapa kali pada sampel dengan efek yang sama. Identifikasi frasa berfrekuensi tinggi dan akurat yang digunakan untuk mendeskripsikan efek. Ekstrak “deskripsi efek” generik.
- Salin dan tempel deskripsi efek standar ini ke semua sampel untuk efek tersebut.
- Pertahankan deskripsi “subjek” dan “latar belakang” unik untuk setiap sampel. Ganti hanya bagian “deskripsi efek” dengan templat terpadu.
- Tinjauan manual AI dapat mengalami halusinasi atau kesalahan deteksi. Sebagai langkah terakhir, lakukan pemeriksaan manual—misalnya, pastikan deskripsi entitas dan latar belakang sesuai dengan adegan aktual.
Evaluasi model menggunakan validation set
Tentukan validation set
Pekerjaan fine-tuning memerlukan training set, sedangkan validation set bersifat opsional. Anda dapat memilih agar sistem memisahkan secara otomatis atau mengunggah secara manual. Tentukan pilihan Anda sebagai berikut:
Metode 1: Tidak mengunggah validation set (sistem memisahkan secara otomatis)
Saat Anda membuat pekerjaan fine-tuning, jika Anda tidak mengunggah validation set terpisah—artinya parametervalidation_file_ids tidak dikirim—sistem akan secara otomatis memisahkan sebagian training set untuk digunakan sebagai validation set berdasarkan dua hiperparameter berikut:
split: Proporsi data pelatihan yang dipisahkan. Misalnya, 0,9 berarti 90% untuk pelatihan dan 10% untuk validasi.max_split_val_dataset_sample: Jumlah maksimum sampel untuk validation set hasil pemisahan otomatis.
ukuran dataset × (1 - split) dan max_split_val_dataset_sample.
-
Contoh: Misalkan Anda hanya mengunggah training set dengan 100 sampel, split=0,9 (10% untuk validasi), dan max_split_val_dataset_sample=5.
- Pemisahan teoretis: 100 × 10% = 10 sampel.
- Pemisahan aktual: min(10, 5) = 5. Jadi, sistem menggunakan hanya 5 sampel untuk validation set.
Metode 2: Unggah validation set secara manual (menggunakan validation_file_ids)
Jika Anda lebih suka mengevaluasi checkpoint menggunakan data yang Anda siapkan sendiri daripada mengandalkan pemisahan acak sistem, unggah validation set kustom. Catatan: Setelah Anda memilih unggah manual, sistem mengabaikan aturan pemisahan otomatis di atas dan hanya memvalidasi dengan data yang Anda unggah.Langkah-langkah: Mengunggah set validasi secara manual
Langkah-langkah: Mengunggah set validasi secara manual
- Siapkan validation set: Kemas data validasi ke dalam file
.zipterpisah. Lihat format validation set. - Unggah validation set: Panggil API unggah dataset untuk mengunggah file
.zipini dan peroleh ID file khusus. - Tentukan validation set saat membuat pekerjaan: Saat memanggil API buat pekerjaan fine-tuning, masukkan ID file tersebut ke parameter
validation_file_ids.
Pilih checkpoint terbaik untuk deployment
Selama pelatihan, sistem menyimpan “snapshot” berkala (checkpoint). Secara default, sistem mengeluarkan checkpoint terakhir sebagai model fine-tuned. Namun, checkpoint antara mungkin mengungguli versi akhir. Anda dapat memilih checkpoint terbaik untuk deployment.
Sistem menjalankan checkpoint pada validation set dan menghasilkan video pratinjau pada interval yang ditentukan oleh hiperparameter eval_epochs.
- Evaluasi: Nilai dengan menonton video pratinjau secara langsung.
- Kriteria pemilihan: Pilih checkpoint dengan kualitas visual terbaik dan tanpa distorsi gerakan.
Prosedur
Langkah 1: Lihat hasil pratinjau untuk checkpoint
Langkah 1: Lihat hasil pratinjau untuk checkpoint
Langkah 1.1 Daftar checkpoint yang divalidasi
API ini hanya mengembalikan checkpoint yang lolos validasi dan berhasil menghasilkan video pratinjau. Checkpoint yang gagal tidak tercantum.Contoh permintaan<ganti_dengan_id_pekerjaan_fine-tuning>: Ganti sepenuhnya denganjob_iddari API buat pekerjaan fine-tuning.
Langkah 1.2 Lihat hasil validasi untuk checkpoint
Pilih satu checkpoint dari daftar di atas (misalnya, “checkpoint-160”) dan lihat hasil videonya.Contoh permintaan<ganti_dengan_id_pekerjaan_fine-tuning>: Ganti sepenuhnya denganjob_iddari membuat pekerjaan fine-tuning.<ganti_dengan_checkpoint_terpilih>: Ganti sepenuhnya dengan nilai checkpoint, misalnya “checkpoint-160”.
video_path. URL ini berlaku selama 24 jam. Unduh dan tinjau segera. Ulangi langkah ini untuk membandingkan beberapa checkpoint dan temukan yang terbaik.Langkah 2: Ekspor checkpoint dan dapatkan nama model untuk deployment
Langkah 2: Ekspor checkpoint dan dapatkan nama model untuk deployment
Langkah 2.1 Ekspor model
Asumsikan “checkpoint-160” memberikan hasil terbaik. Sekarang ekspor model tersebut.Contoh permintaan<ganti_dengan_id_pekerjaan_fine_tuning>: Ganti sepenuhnya denganjob_iddari membuat pekerjaan fine-tuning.<ganti_dengan_checkpoint_yang_diekspor>: Ganti sepenuhnya dengan nilai checkpoint, misalnya “checkpoint-160”.<ganti_dengan_nama_model_yang_diekspor_untuk_tampilan_konsol>: Ganti sepenuhnya dengan nama model kustom untuk tampilan konsol, misalnya “wan2.5-checkpoint-160”. Nama ini harus unik secara global; nama duplikat tidak diizinkan. Untuk panduan parameter, lihat ekspor checkpoint.
output=true berarti permintaan ekspor berhasil dibuat.Langkah 2.2 Tanyakan nama model baru setelah deployment
Tanyakan status semua checkpoint untuk mengonfirmasi penyelesaian ekspor dan mendapatkan nama model unik (model_name) untuk deployment.Contoh permintaan<ganti_dengan_id_pekerjaan_fine-tuning>: Ganti sepenuhnya denganjob_iddari membuat pekerjaan fine-tuning.
status menjadi SUCCEEDED, ekspor berhasil. Field model_name adalah nama model baru untuk deployment dan pemanggilan.Langkah 3: Terapkan dan panggil model
Langkah 3: Terapkan dan panggil model
model_name, ikuti langkah-langkah berikut:- Penerapan model: Di parameter input
model_name, masukkan nilai spesifik yang diperoleh setelah ekspor. - Pemanggilan model: Ikuti dokumentasi API untuk memanggil model yang diterapkan.
Go live
Dalam produksi, jika model yang dilatih awal berkinerja buruk (misalnya, visual terdistorsi, efek lemah, atau gerakan tidak akurat), lakukan penyesuaian berdasarkan dimensi berikut:
1. Periksa data dan prompt
- Konsistensi data: Konsistensi sangat penting. Periksa “sampel buruk” yang memiliki arah berlawanan atau gaya yang sangat berbeda.
- Jumlah sampel: Tingkatkan jumlah data berkualitas tinggi menjadi 20+ sampel.
- Prompt: Pastikan kata pemicu merupakan istilah yang tidak bermakna dan jarang digunakan (misalnya, s86b5p). Hindari kata umum (misalnya, running) yang dapat menyebabkan interferensi.
-
n_epochs (epoch pelatihan)
- Nilai default: 50. Gunakan nilai default kecuali diperlukan. Jika menyesuaikan, ikuti aturan: “Total langkah pelatihan ≥ 800”.
-
Rumus total langkah:
steps = n_epochs × ceiling (ukuran training set / batch_size). -
Rumus minimum n_epochs:
n_epochs = 800 / ceiling (ukuran dataset / batch_size). -
Contoh: Asumsikan training set berisi 5 sampel dan menggunakan model Wan2.5 (batch_size=4).
- Langkah per epoch: 5 / 4 = 1,25, dibulatkan ke atas menjadi 2. Total epoch: n_epochs = 800 / 2 = 400. Ini adalah minimum yang direkomendasikan. Anda dapat menambahkannya sesuai kebutuhan.
-
batch_size (ukuran batch)
- Ukuran batch menentukan jumlah sampel data yang dikirim ke model untuk pelatihan sekaligus.
- Parameter ini merupakan konfigurasi per instans. Kami menyarankan menggunakan nilai default untuk setiap model dan hanya menyesuaikannya jika diperlukan.
- wan2.7-i2v: Nilai yang direkomendasikan: 1.
- wan2.5-i2v-preview: Nilai yang direkomendasikan: 4.
- wan2.2-i2v-flash: Nilai yang direkomendasikan: 4.
- wan2.2-kf2v-flash: Nilai yang direkomendasikan: 4.
Jumlah instans aktual yang berjalan untuk pekerjaan pelatihan ditentukan oleh penjadwalan platform. Global Step yang ditampilkan di log pelatihan mungkin berbeda dari hasil perkiraan, tetapi hal ini tidak mengubah jumlah total data pelatihan atau memengaruhi kinerja akhir model.
- learning_rate (tingkat pembelajaran): Gunakan nilai default (2e-5). Biasanya tidak perlu dimodifikasi.
Penagihan
-
Pelatihan model: Dikenai biaya.
- Biaya = Total token pelatihan × Harga satuan. Lihat penagihan pelatihan model.
- Setelah pelatihan, periksa total token yang dikonsumsi pada field
usagedari API tanyakan status pekerjaan fine-tuning.
- Penerapan model: Gratis.
-
Pemanggilan model: Dikenai biaya.
- Ditagih sesuai harga pemanggilan standar model dasar fine-tuned. Lihat harga model.
Referensi API
API fine-tuning model untuk pembuatan video dan gambar
FAQ
T: Bagaimana volume data training set dan validation set dihitung?
J: Training set wajib, sedangkan validation set opsional. Metode perhitungannya adalah sebagai berikut:
-
Saat tidak ada validation set yang disediakan: Training set yang diunggah dianggap sebagai "ukuran total dataset". Sistem secara otomatis memisahkan sebagian data untuk validasi.
- Ukuran validation set =
min(ukuran total dataset × (1 − split), max_split_val_dataset_sample). Untuk contoh, lihat tentukan validation set. - Ukuran training set =
ukuran total dataset − ukuran validation set.
- Ukuran validation set =
-
Saat validation set diunggah secara manual: Sistem tidak lagi memisahkan validation set dari data pelatihan.
- Ukuran training set = Volume data training set yang diunggah.
- Ukuran validation set = Volume data validation set yang diunggah.
T: Bagaimana merancang kata pemicu yang baik?
J: Ikuti aturan berikut:
- Gunakan kombinasi huruf yang tidak bermakna, seperti sksstyle atau a8z2_bbb.
- Hindari kata bahasa Inggris umum (misalnya, beautiful, fire, dance) untuk mencegah polusi terhadap pemahaman asli model terhadap kata-kata tersebut.