

Topik ini menggunakan model Qwen sebagai contoh untuk memandu Anda melalui siklus lengkap penerapan model di Alibaba Cloud Model Studio menggunakan panggilan API (HTTP), termasuk penerapan, kueri, inferensi, penghapusan, dan pemecahan masalah izin.
Prasyarat
- Anda telah membaca sepenuhnya Penerapan model dan memahami model yang didukung oleh penerapan model Alibaba Cloud Model Studio serta langkah-langkah dasarnya.
- Anda telah mendapatkan dan mengonfigurasi Kunci API serta mengonfigurasi Kunci API dalam variabel lingkungan. Ganti
DASHSCOPE_API_KEYdalam contoh kode dengan Kunci API Model Studio Anda sendiri; jika Anda menggunakan dashscope CLI, ganti jugaDASHSCOPE_HTTP_BASE_URLdengan API Host yang Anda peroleh.
1. Terapkan model
Perintah berikut menunjukkan cara membuat layanan khusus. Di antaranya, contoh penagihan berbasis token menggunakan model kustom hasil fine-tuning qwen3-8b-ft-202511132025-0260 untuk membuat layanan khusus qwen3-8b-ft-202511132025-0260; contoh model unit menggunakan model preset.
Untuk mendapatkan ID model kustom: Buka Konsol Model Studio - Fine-tuning model, klik Task Name -> Output -> klik nama model berwarna biru untuk masuk ke halaman My Models, tempat Anda dapat melihat ID model di area informasi dasar model.
Gunakan Model IDsebagai input untuk parameter model_name untuk menerapkan model melalui API.
- Model unit
- Ditagih berdasarkan penggunaan token model
- dashscope CLI
- Setelah Anda menjalankan perintah penerapan, penagihan dimulai segera setelah layanan berhasil diterapkan, bahkan jika Anda tidak menggunakannya. Sebelum melanjutkan, sebaiknya tinjau aturan penagihan layanan.
- Sumber daya komputasi untuk rencana model unit post-paid dialokasikan berdasarkan prinsip first-come, first-served. Jika pembelian tidak berhasil, pengembalian dana penuh akan diberikan.
Item konfigurasi | Detail konfigurasi |
|---|---|
Nama layanan | Nama kustom untuk layanan penerapan. |
Pilih model | Pilih model yang akan diterapkan, termasuk model bawaan platform dan model hasil fine-tuning. |
Tipe model unit | Pilih spesifikasi penerapan. Spesifikasi yang berbeda sesuai dengan daya komputasi dan performa yang berbeda. |
Model unit per replika | Jumlah model unit yang diperlukan per replika ditentukan bersama oleh template penerapan dan tipe model unit, dan tidak dapat diubah. Misalnya, qwen3-32b memerlukan 16 model unit per replika. Total Model Unit = Replika yang Diterapkan × Model unit per Replika, yang menentukan berapa banyak sumber daya yang digunakan oleh layanan yang diterapkan. Meningkatkan jumlah replika yang diterapkan mengonsumsi lebih banyak model unit dan memberikan performa model yang lebih baik. |
Jumlah replika penerapan | Atur jumlah awal replika penerapan, yang memengaruhi kapasitas konkurensi layanan. |
Template penerapan | Pilih template penerapan (seperti "single-node deployment"). Template yang berbeda sesuai dengan skema konfigurasi sumber daya yang berbeda. Hanya tersedia dalam mode penagihan model unit. |
Konfigurasi mode inferensi model | Untuk beberapa model yang diterapkan dalam mode Model Unit, Anda dapat mengonfigurasi mode inferensi, panjang konteks maksimum, dan lainnya.
|
Panjang konteks maksimum | Mode penerapan Model Unit dari beberapa model mendukung pengaturan ini. Panjang konteks maksimum bergantung pada jenis model. |
Pembatasan laju layanan | Mode penerapan Model Unit dari beberapa model mendukung pengaturan ini. Anda dapat membatasi RPM dan TPM pemanggilan model. |
deployed_model adalah ID unik layanan khusus; gunakan nilai deployed_model ini sebagai pengenal di jalur API berikutnya seperti kueri dan penghapusan (bukan name dalam parameter permintaan).
2. Kueri status layanan
Gunakan perintah berikut untuk mengkueri informasi detail layanan khusus tertentu:
RUNNING, penerapan layanan telah selesai.
3. Kirim permintaan inferensi
model harus diatur ke code model yang diperoleh setelah penerapan model berhasil; buka konsol penerapan khusus (Beijing) untuk mendapatkannya.
Penyelarasan parameter inferensi
Nilai default parameter dari mesin inferensi Model Studio mungkin berbeda dengan framework inferensi lokal. Untuk menyelaraskan dengan default vLLM, lihat tabel berikut saat mengatur parameter; jika Anda menggunakan framework lain seperti SGLang, lihat dokumentasi yang sesuai untuk penyesuaian.
Nama parameter | Nilai yang direkomendasikan (sesuai default vLLM) |
|---|---|
temperature | Rentang nilai [0, 2); mengaturnya ke 1.0 setara dengan default mesin vLLM. |
top_p | Rentang nilai (0, 1.0]; mengaturnya ke 1.0 setara dengan default mesin vLLM. |
top_k | Ketika nilainya None atau lebih besar dari 100, kebijakan top_k tidak diaktifkan dan hanya top_p yang berlaku; mengaturnya ke 99 tidak mendukung sampling penuh, yang mendekati default vLLM yaitu 0 (sampling penuh). |
presence_penalty | Rentang nilai [-2.0, 2.0]; mengaturnya ke 0 setara dengan default mesin vLLM. |
repetition_penalty (protokol DashScope) | Meningkatkan nilai ini mengurangi pengulangan dalam generasi; 1.0 berarti tidak ada penalti; rentang nilainya lebih besar dari 0, dan mengaturnya ke 1.0 setara dengan default mesin vLLM. |
4. Hapus layanan khusus
Anda dapat menghapus layanan khusus yang tidak lagi digunakan dengan perintah berikut:
Pemecahan masalah izin
Jika Anda mengalami kesalahan izin yang tidak memadai selama penerapan model, ada dua jalur pemecahan masalah bergantung pada metode penerapan:
Penerapan konsol
- Jika "Kekurangan izin untuk modul ini" ditampilkan, pastikan akun Anda memiliki izin Model Deployment-Actions pada halaman manajemen izin ruang kerja. Jika Anda tidak dapat melakukan operasi, hubungi organisasi atau administrator TI Anda untuk menambahkan izin yang diperlukan atau memeriksa masalah izin untuk Anda.
-
Jika galat "Ruang kerja xx tidak memiliki izin untuk menerapkan model xx" dilaporkan selama penerapan, buka halaman Workspaces di Bailian dan tambahkan izin penerapan untuk model yang sesuai ke ruang kerja yang sesuai.
Kesalahan panggilan API:
Workspace xxx does not have deployment privilege for model xxxx.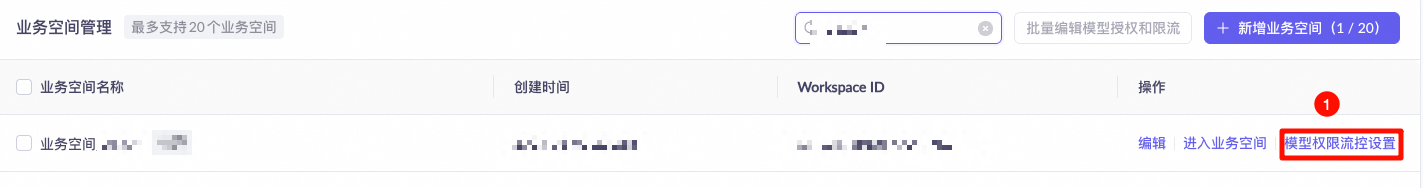 Jika Anda dimintai izin yang tidak memadai, hubungi organisasi atau administrator TI Anda untuk menambahkan izin terkait atau melakukan operasi atas nama Anda.
Penerapan API
Saat menerapkan model melalui API, Anda perlu memastikan bahwa:
-
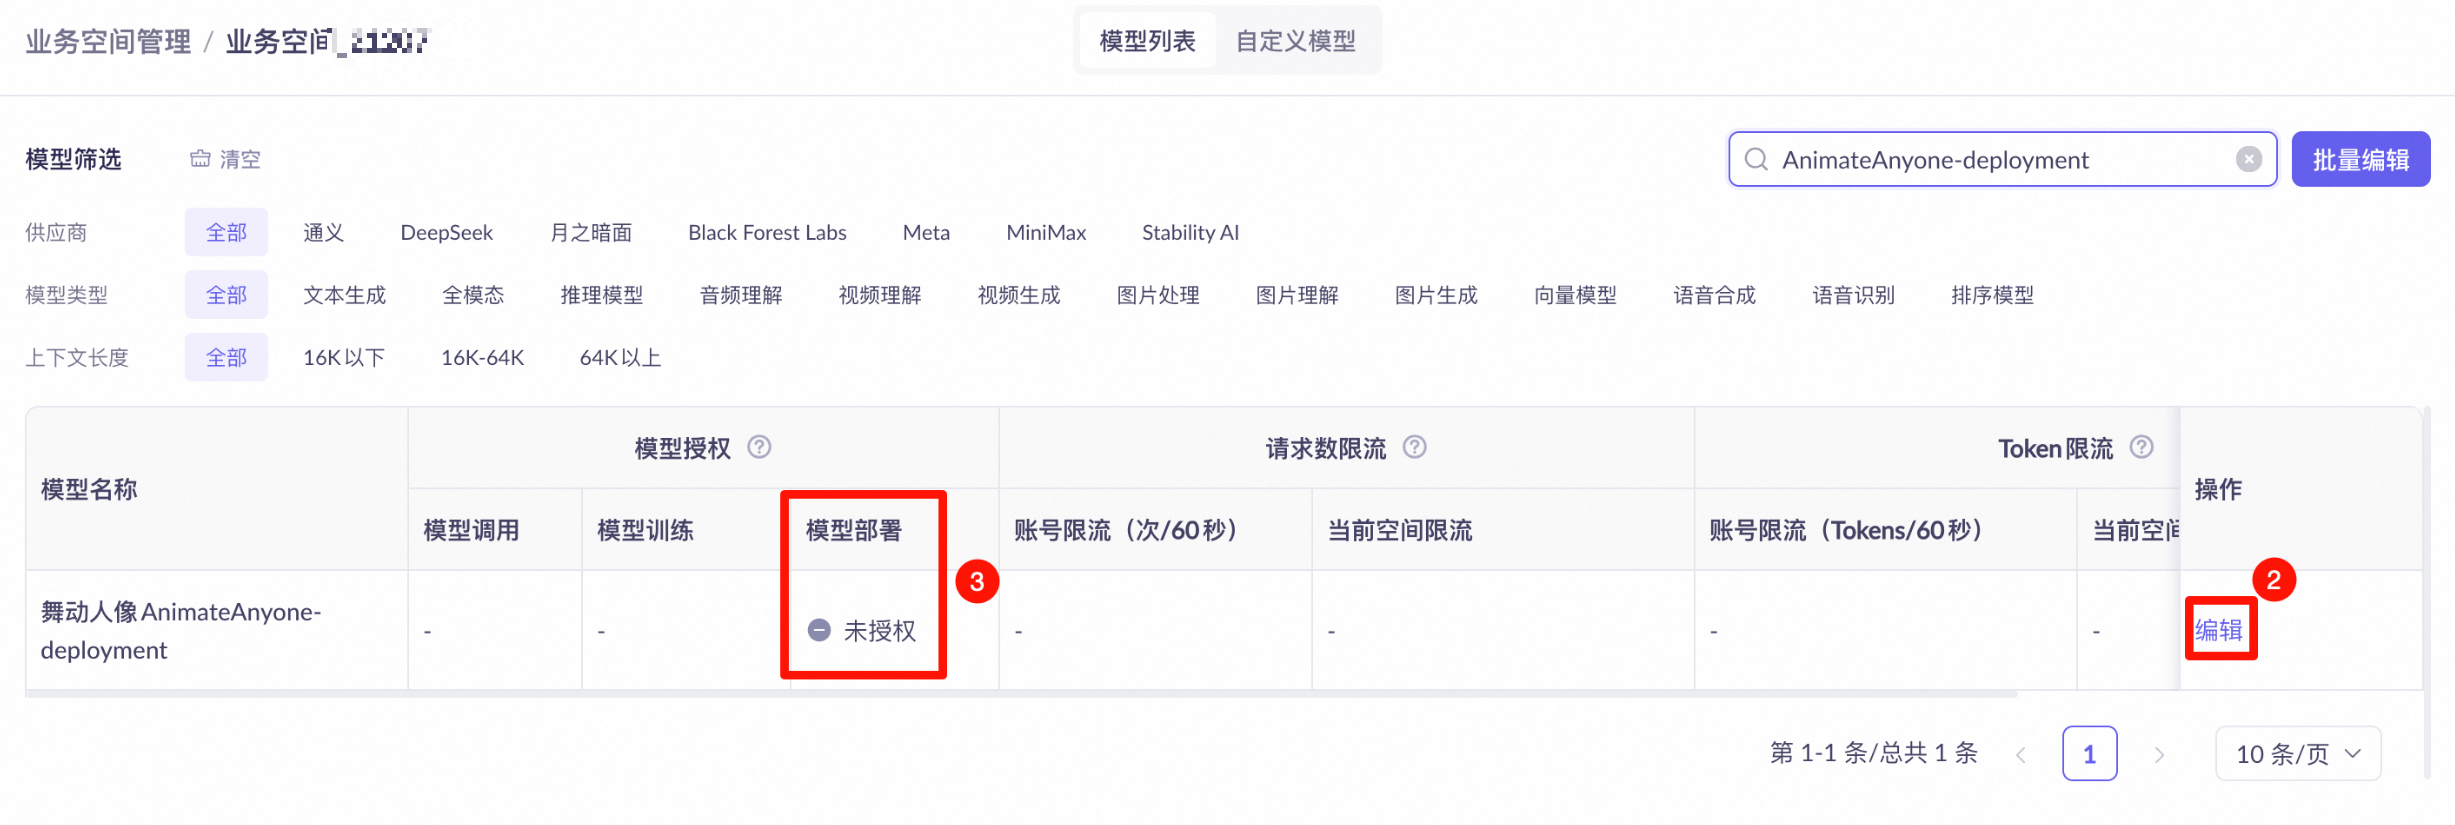
Workspace yang dimiliki Kunci API memiliki izin untuk mengelola model. Buka halaman Workspaces di Bailian dan periksa pengaturan izin penerapan model dari ruang kerja yang sesuai.
Kesalahan panggilan API:
Pada kolom Actions dari ruang kerja yang sesuai, klik Authorization & Throttling Settings. Temukan model target dalam daftar Models dan periksa status otorisasi di kolom Model Deployment. Jika Unauthorized ditampilkan, klik Modify di kolom Actions untuk memberikan otorisasi. Jika pesan izin yang tidak memadai muncul, hubungi organisasi atau administrator TI Anda untuk menambahkan izin yang diperlukan atau melakukan operasi untuk Anda.Workspace xxx does not have deployment privilege for model xxxx. -
Owner Account dari Kunci API memiliki izin operasi di Workspace tempat ia berada. Buka konsol Bailian, klik ruang kerja di pojok kiri bawah, alihkan ke ruang kerja yang sesuai, lalu klik
 Periksa pengaturan izin penerapan model dari ruang kerja yang sesuai.
Kesalahan panggilan API:
Di panel navigasi kiri, klik Permission Management dan pastikan daftar pengguna mencakup akun pemilik Kunci API (dengan tipe primary account). Jika Anda dimintai izin yang tidak memadai, hubungi organisasi atau administrator TI Anda untuk menambahkan izin terkait atau melakukan operasi atas nama Anda.Workspace access denied.