

Set data merupakan fondasi pelatihan dan evaluasi model. Fitur Data Management Alibaba Cloud Model Studio membantu Anda membuat dan mengelola set data secara efisien.
Ikhtisar set data
Data Management Alibaba Cloud Model Studio mengelola secara terpusat semua set data terkait model besar dalam ruang kerja bisnis Anda. Set data dibagi menjadi Training Set (digunakan untuk fine-tuning model, mendukung SFT/DPO/CPT) dan Evaluation Set (digunakan untuk Evaluasi model).
Set pelatihan mendukung empat skenario pelatihan: generasi teks, pemahaman multimodal, gambar-ke-video (frame pertama), dan gambar-ke-video (frame pertama dan terakhir). Set evaluasi hanya mendukung skenario generasi teks. Jenis set data tidak dapat diubah setelah dibuat; pilih dengan cermat berdasarkan penggunaan downstream Anda.
Nama set data dapat memiliki panjang hingga 50 karakter (mendukung karakter Tionghoa, Inggris, angka, garis bawah, tanda hubung, dan titik), serta deskripsi hingga 200 karakter. Pembuatan atau penerbitan set data kosong tidak didukung. Tidak ada batasan jumlah set data yang dapat Anda buat, dan tidak ada batas atas volume data yang dapat diimpor.
Metode pelatihan DPO/CPT dan pemasangan cloud storage hanya didukung di Wilayah Beijing.
Metode dan skenario pelatihan
Set pelatihan mendukung tiga metode pelatihan dengan skenario penerapan dan kebutuhan data minimum yang berbeda:
- SFT (supervised fine-tuning): fine-tuning instruksi yang memungkinkan model menyelesaikan tugas tertentu. Disarankan minimal seribu entri. Tersedia di semua situs.
- DPO (direct preference optimization): pelatihan penyelarasan preferensi. Disarankan minimal seratus entri.
- CPT (continual pre-training): injeksi pengetahuan domain. Disarankan minimal 50 juta token data.
Metode pelatihan | Tujuan | Volume data yang disarankan | Ketersediaan situs |
|---|---|---|---|
SFT | Supervised fine-tuning (fine-tuning instruksi) | 1.000+ entri | Semua situs |
DPO | Direct preference optimization (penyelarasan preferensi) | 100+ entri | Wilayah Beijing |
CPT | Continual pre-training (pengetahuan domain) | 50 juta token | Wilayah Beijing |
Metode impor
Set data mendukung tiga metode impor dengan skenario penerapan dan prasyarat yang berbeda:
- Upload Local File: tanpa prasyarat; unggah langsung file lokal, cocok untuk batch data kecil.
- OSS Import: tambahkan tag
bailian-datahub-access=readke bucket target; cocok untuk batch data besar. Tidak didukung untuk set evaluasi. - Log Backflow: ekstrak otomatis data pelatihan dari log inferensi SLS; memerlukan otorisasi peran terkait layanan, membentuk loop peningkatan inferensi → data → fine-tuning.
Metode impor | Prasyarat | Skenario penerapan | Didukung untuk set evaluasi |
|---|---|---|---|
Local upload | Tidak ada | Batch data kecil | Didukung |
OSS import | Tag bucket bailian-datahub-access=read | Batch data besar | Tidak didukung |
Log backflow | Otorisasi + API Key/filter model | Buat data pelatihan dari log inferensi | Didukung |
Persiapan data
Menyiapkan data berkualitas tinggi adalah kunci hasil fine-tuning model. Untuk volume data yang disarankan dari masing-masing metode pelatihan (generasi teks SFT/DPO/CPT), lihat Aturan unggah data fine-tuning.
Tidak ada rekomendasi resmi mengenai volume data untuk set pelatihan pemahaman multimodal dan gambar-ke-video; siapkan sampel yang cukup berdasarkan skenario aktual Anda.
Format data dan templat
Untuk spesifikasi format file data setiap skenario pelatihan (teks SFT/pemahaman multimodal (gambar/video → teks), DPO, CPT, set evaluasi), lihat Aturan unggah data fine-tuning.
Pada halaman pembuatan set data Data Management, unduh templat data untuk skenario yang sesuai; menyiapkan data sesuai struktur templat dapat mencegah kegagalan impor. Set evaluasi mendukung format single-turn Text generation (prompt&completion) dan format percakapan multi-turn Text generation (ChatML-messages); untuk spesifikasi bidang dan contoh selengkapnya, lihat Aturan unggah data fine-tuning - Format set evaluasi.
Untuk strategi diversifikasi dan augmentasi data, lihat dokumentasi fine-tuning model. Untuk set evaluasi, siapkan set data independen yang tidak tumpang tindih untuk menilai generalisasi model secara objektif.
Membuat set data
Sebelum membuat set data, prasyarat berikut harus dipenuhi: layanan Model Studio telah diaktifkan; untuk impor OSS, tambahkan tag bailian-datahub-access=read ke bucket target; untuk log backflow, otorisasi peran terkait layanan.
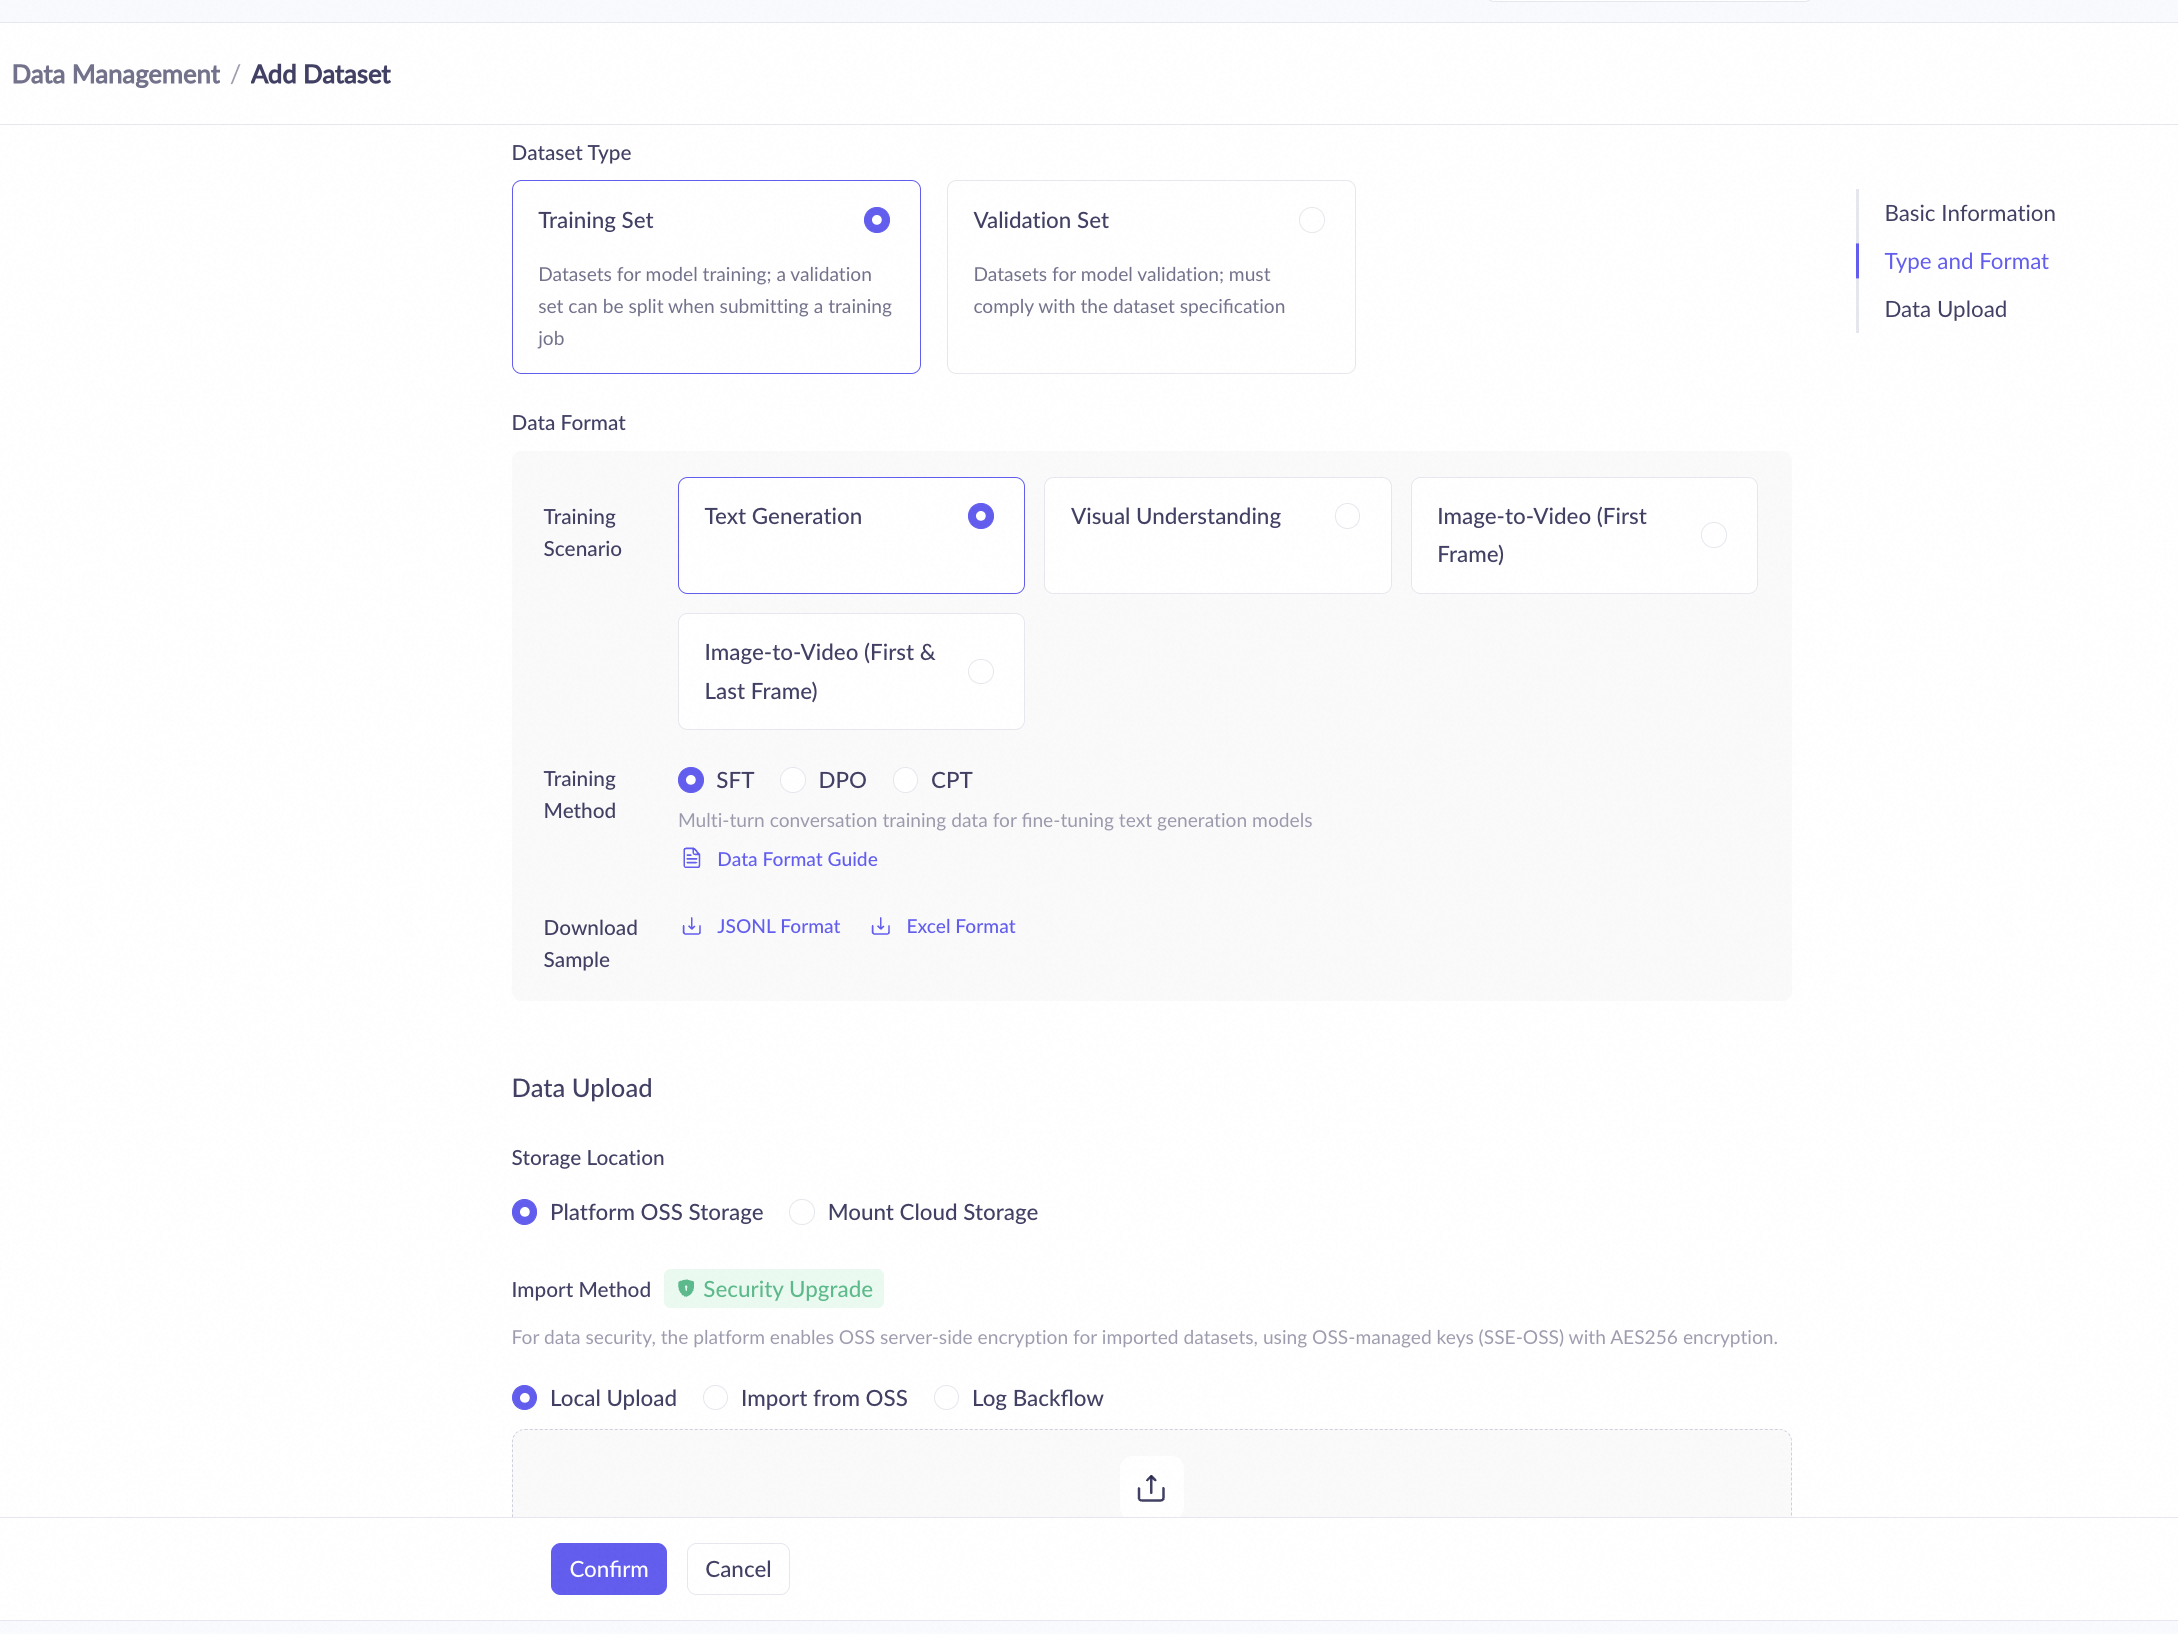
Pada halaman daftar Data Management > Dataset, klik Add Dataset, lalu ikuti langkah-langkah berikut:
- Masukkan nama set data (maksimal 50 karakter) dan deskripsi (maksimal 200 karakter, opsional).
- Pilih jenis set data: Training Set atau Evaluation Set (tidak dapat diubah setelah dibuat).
- Pilih skenario pelatihan: training set mendukung generasi teks, pemahaman multimodal, gambar-ke-video (frame pertama), gambar-ke-video (frame pertama dan terakhir), dan lainnya; untuk evaluation set, pilih format sampel pada langkah ini — Text generation (ChatML-messages) (percakapan multi-turn; mendukung jsonl, xls, dan xlsx; maksimal 200 MB per file) atau Text generation (prompt&completion) (single-turn; hanya xls dan xlsx; maksimal 20 MB per file). Halaman pembuatan menyediakan unduhan templat contoh untuk format yang sesuai.
- Pilih metode pelatihan: SFT, DPO, atau CPT (hanya diperlukan untuk training set; evaluation set tidak memiliki konfigurasi ini).
- Pilih lokasi penyimpanan: Platform OSS storage (gratis, tanpa batas volume data) atau Mount Cloud Storage (tidak tersedia untuk set evaluasi).
- Pilih metode impor dan unggah data: local upload, OSS import, atau log backflow (lihat deskripsi tab di bawah).
- Klik Submit; set data langsung diterbitkan, menyelesaikan pembuatan.
Parameter | Deskripsi | Wajib | Deskripsi nilai |
|---|---|---|---|
Dataset name | Identifier set data | true | Maksimal 50 karakter; Tionghoa/Inggris/angka/garis bawah/tanda hubung/titik |
Dataset description | Deskripsi set data | Maksimal 200 karakter | |
Dataset type | Set pelatihan atau set evaluasi; tidak dapat diubah setelah dibuat | true | Training set/Evaluation set |
Training scenario | Skenario pelatihan yang berlaku untuk data | true | Text generation/Multimodal understanding/Image-to-video (first frame)/Image-to-video (first and last frame) |
Training method | Jenis algoritma pelatihan | true | SFT/DPO/CPT |
Storage location | Metode penyimpanan set data | true | Platform OSS storage/Cloud storage mounting |
Import method | Sumber impor data | true | Local upload/OSS import/Log backflow |
- Local upload
- OSS import
- Log backflow
Manajemen versi
Satu set data dapat memiliki beberapa versi independen, dengan nomor versi yang bertambah otomatis. Pada halaman detail set data, klik Add Version untuk membuat versi baru.
Menambahkan versi menggunakan mode buat baru, yang mengharuskan impor ulang seluruh data; mode pewarisan yang memodifikasi data secara inkremental berdasarkan versi sebelumnya tidak lagi didukung.
- Create Mode: impor ulang seluruh data; cocok untuk pembaruan skala besar.
Manajemen set data
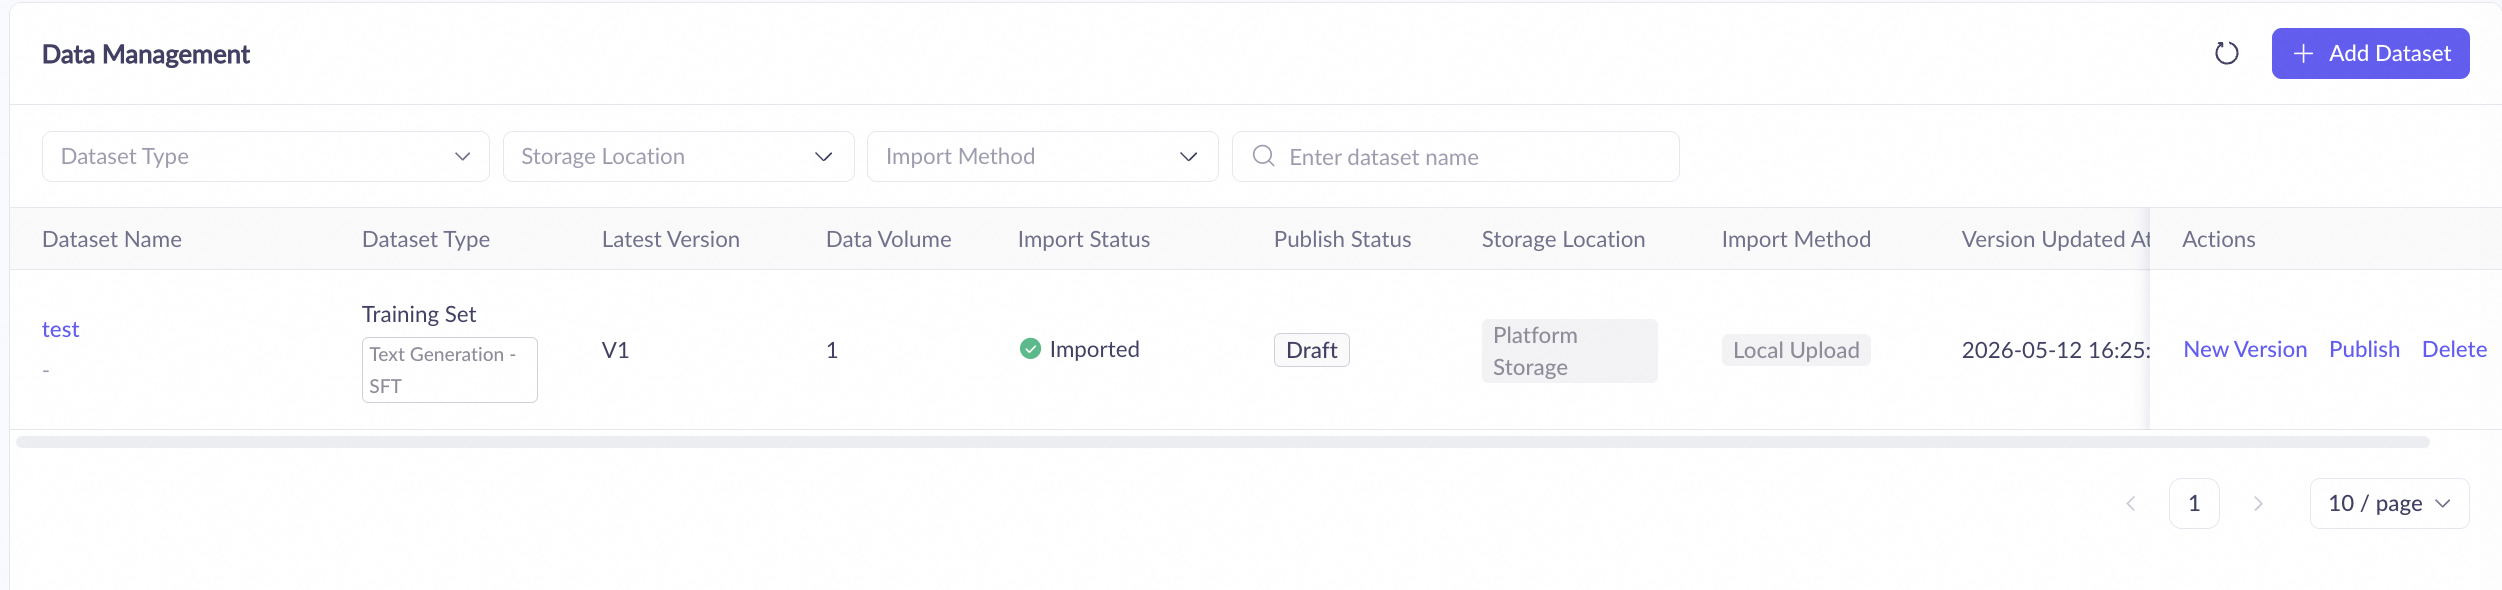
Pada halaman daftar Data Management > Dataset, Anda dapat melihat semua set data, memfilter berdasarkan jenis (set pelatihan/set evaluasi), dan mencari berdasarkan nama. Set data yang sedang diimpor memperbarui statusnya secara otomatis setiap 5 detik; tidak perlu refresh manual.
Terbitkan dan hapus
Publish bersifat ireversibel; versi yang telah diterbitkan tidak dapat lagi diedit. Delete pada versi yang telah diterbitkan juga ireversibel; hanya versi draft yang dibuat sebelumnya yang dapat dihapus. Menghapus seluruh set data akan menghapus semua versinya. Semua operasi ini ireversibel; lakukan dengan hati-hati.
Edit dan ekspor
Hanya versi draft yang dibuat sebelumnya yang dapat diedit secara online (konten Prompt/Completion dapat diedit); set data baru langsung diterbitkan saat dikirimkan dan tidak lagi menghasilkan versi draft, serta pengeditan tidak tersedia untuk versi yang telah diterbitkan. Saat mengekspor set data, setiap jenis memiliki format berbeda: set pelatihan SFT diekspor sebagai .jsonl, set pelatihan multimodal sebagai .zip, dan set evaluasi sebagai .xlsx. Ekspor set data kosong tidak didukung.
Penagihan
Fitur Data Management gratis, tetapi penyimpanan set data dan sumber daya downstream dikenai biaya; lihat halaman penagihan Model Studio untuk detailnya.
- Platform OSS storage: biaya berdasarkan halaman penagihan Model Studio.
- Mount Cloud Storage: biaya ditagihkan ke akun OSS milik pengguna sendiri.
- Log Backflow: biaya SLS yang timbul ditagihkan ke akun produk SLS.
Langkah berikutnya
Setelah set data dibuat dan diterbitkan, set data tersebut dapat digunakan dalam skenario downstream berikut:
- Setelah set pelatihan diterbitkan, set tersebut digunakan untuk fine-tuning model (SFT/DPO/CPT).
- Setelah set evaluasi diterbitkan, set tersebut digunakan untuk Evaluasi model.