Anda dapat menggunakan fine-tuning model di Alibaba Cloud Model Studio jika performa model tidak memenuhi ekspektasi Anda setelah mencoba metode optimasi seperti rekayasa prompt dan pemanggilan plugin. Sebagai strategi inti untuk meningkatkan performa model, fine-tuning dapat secara signifikan meningkatkan kemampuan model dalam industri atau skenario bisnis tertentu, menyelaraskan output-nya dengan preferensi manusia, serta mengurangi latensi output. Fine-tuning model mencakup tiga metode pelatihan: supervised fine-tuning (SFT), continual pre-training (CPT), dan direct preference optimization (DPO).
Pengenalan fine-tuning model
Fine-tuning model merupakan metode penting untuk mengoptimalkan performa model. Metode ini dapat:
- Meningkatkan performa model di industri tertentu atau untuk kebutuhan bisnis tertentu
- Mengurangi latensi output model
- Menekan halusinasi model
- Menyelaraskan model dengan nilai atau preferensi manusia
- Menggantikan model yang lebih besar dengan model ringan hasil fine-tuning
Proses fine-tuning model

Model yang didukung
Model yang didukung
Model yang didukung
- Singapura
- China (Beijing)
- Generasi teks
- Pemahaman visual (Qwen-VL)
Model | Kode model | Pelatihan Parameter Penuh SFT | Pelatihan Efisien SFT |
|---|---|---|---|
Qwen3.8-27B | qwen3.8-27b | ✓ | ✓ |
Qwen3.6-27B | qwen3.6-27b | ✓ | ✓ |
Qwen3.5-27B | qwen3.5-27b | ✓ | ✓ |
Qwen3.5-9B | qwen3.5-9b | ✓ | ✓ |
Qwen3-14B | qwen3-14b | × | ✓ |
Perbandingan metode fine-tuning
Atribut | CPT (continual pre-training) | SFT (supervised fine-tuning) | DPO (direct preference optimization) |
|---|---|---|---|
Rangkuman satu kalimat | Menambahkan pengetahuan (menyuntikkan pengetahuan domain) | Belajar melakukan tugas (mengikuti instruksi) | Melakukan dengan lebih baik (menyelaraskan dengan preferensi manusia) |
Data input | 10 juta+ token Teks domain tanpa label | 1.000+ entri Pasangan "pertanyaan-jawaban" berkualitas tinggi | 100+ grup Pasangan jawaban "lebih baik-lebih buruk" di bawah instruksi yang sama |
Tujuan inti | Adaptasi domain, mempelajari kosakata dan fakta khusus | Mengajarkan format dialog dan kemampuan pelaksanaan tugas kepada model | Membuat output model lebih selaras dengan nilai dan preferensi manusia |
Metode pembelajaran | Pembelajaran mandiri (memprediksi kata berikutnya) | Pembelajaran tersupervisi(meniru jawaban standar) | Pembelajaran preferensi langsung(meningkatkan probabilitas jawaban baik dan menurunkan probabilitas jawaban buruk) |
Tahap model | Biasanya sebelum SFT | Setelah CPT, sebelum DPO | Biasanya setelah SFT, sebagai langkah terakhir penyelarasan |
Perbandingan Mode Pelatihan
Pelatihan Parameter Penuh | Pelatihan Efisien (LoRA, direkomendasikan) | |
|---|---|---|
Skenario Penerapan | • Model perlu mempelajari kemampuan baru • Mengejar performa optimal secara global | • Mengoptimalkan performa model dalam skenario tertentu • Skenario yang sensitif terhadap waktu dan biaya pelatihan |
Waktu pelatihan | Lebih lama, dengan kecepatan konvergensi lebih lambat. | Lebih singkat, dengan kecepatan konvergensi lebih cepat. |
Rincian Penagihan
| Metode penagihan | Ditagih berdasarkan jumlah data yang digunakan untuk pelatihan |
| Rumus penagihan | Biaya pelatihan model = (Total token data pelatihan + Total token data pelatihan campuran) × Jumlah putaran × Harga satuan pelatihan (Unit penagihan minimum: 1 token)Anda dapat melihat estimasi biaya pelatihan di bagian bawah konsol fine-tuning model dan klik Computing Details untuk melihat total token pelatihan, jumlah putaran, dan harga satuan pelatihan. |
Harga satuan pelatihan
Harga satuan pelatihan
- Singapura
- China (Beijing)
- Qwen
- Qwen VL
Layanan model | Kode model | Harga |
|---|---|---|
Qwen3.8-27B | qwen3.8-27b | $0.0075/Ribu Token |
Qwen3.6-27B | qwen3.6-27b | $0.0075/Ribu Token |
Qwen3.5-27B | qwen3.5-27b | $0.0075/Ribu Token |
Qwen3.5-9B | qwen3.5-9b | $0.003/Ribu Token |
Qwen3-14B | qwen3-14b | $0.0016/Ribu Token |
Klik di sini untuk melihat lebih banyak batasan pada model Qwen VL
Klik di sini untuk melihat lebih banyak batasan pada model Qwen VL
Batasan
Batasan file input
- Batasan gambar
- Batasan video
-
Resolusi gambar:
-
Ukuran minimum: Lebar dan tinggi gambar keduanya harus lebih besar dari
10piksel. -
Rasio aspek: Untuk gambar asli dan gambar yang telah diskalakan, rasio sisi panjang terhadap sisi pendek tidak boleh melebihi
200:1.Untuk logika penskalaan gambar, lihat fungsi
smart_resizedi Menghitung token gambar. -
Batasan piksel:
- Sebaiknya jaga resolusi gambar tetap dalam batas
8K(7680x4320). Gambar dengan resolusi di atasnya dapat menyebabkan panggilan API mengalami waktu habis (timeout) karena ukuran file yang terlalu besar atau transmisi jaringan yang lama. - Mekanisme penskalaan otomatis: model dapat menyesuaikan ukuran gambar menggunakan
max_pixelsdanmin_pixels. Oleh karena itu, memberikan gambar beresolusi sangat tinggi tidak meningkatkan akurasi pengenalan, tetapi justru meningkatkan risiko kegagalan panggilan. Sebaiknya skalakan gambar ke ukuran yang sesuai di sisi klien terlebih dahulu.
- Sebaiknya jaga resolusi gambar tetap dalam batas
-
Ukuran minimum: Lebar dan tinggi gambar keduanya harus lebih besar dari
-
Format gambar yang didukung
-
Untuk resolusi di bawah 4K
(3840x2160), format gambar yang didukung adalah sebagai berikut:Format gambar
Ekstensi umum
Tipe MIME
BMP
.bmp
image/bmp
JPEG
.jpe, .jpeg, .jpg
image/jpeg
PNG
.png
image/png
TIFF
.tif, .tiff
image/tiff
WEBP
.webp
image/webp
HEIC
.heic
image/heic
-
Untuk resolusi antara
4K(3840x2160)dan8K(7680x4320), hanya format JPEG, JPG, dan PNG yang didukung
-
Untuk resolusi di bawah 4K
-
Ukuran gambar:
- Saat diberikan sebagai URL publik: untuk seri Qwen3.8, Qwen3.7, Qwen3.6, Qwen3.5, dan Qwen3-VL, satu gambar tidak boleh melebihi
20MB; untuk model lain, satu gambar tidak boleh melebihi10MB - Saat diberikan sebagai path lokal: satu gambar tidak boleh melebihi
10MB - Saat diberikan sebagai pengodean Base64 (antarmuka kompatibel OpenAI atau DashScope): untuk seri Qwen3.8, Qwen3.7, Qwen3.6, Qwen3.5, dan Qwen3-VL, file gambar asli sebelum pengodean tidak boleh melebihi
20MB; untuk model lain, tidak boleh melebihi10MB; dan string Data URI yang telah dikodekan tidak boleh melebihi20MB. - Saat diberikan sebagai pengodean Base64 (antarmuka kompatibel Anthropic): tunduk pada batasan bahwa seluruh badan permintaan tidak boleh melebihi
6MB, beberapa gambar harus berbagi kuota ini.
Untuk mengompresi file, lihat Cara mengompres gambar atau video ke ukuran yang diperlukan.
- Saat diberikan sebagai URL publik: untuk seri Qwen3.8, Qwen3.7, Qwen3.6, Qwen3.5, dan Qwen3-VL, satu gambar tidak boleh melebihi
-
Batasan jumlah gambar: untuk input multi-gambar, jumlah maksimum gambar yang didukung bervariasi menurut metode input:
-
Saat diberikan sebagai URL publik atau path lokal:
- Qwen3.8-Max dan Qwen3.7-Plus: hingga 2048 gambar
- Qwen3.7-Flash, Qwen3.6-Plus, Qwen3.6-Flash, Qwen3.5-Plus, Qwen3.5-Flash, Qwen3-VL, Qwen-VL, dan seri QVQ: hingga 256 gambar
- Saat diberikan sebagai pengodean Base64: hingga 250 gambar
-
Saat diberikan sebagai URL publik atau path lokal:
Selain itu, semua gambar tunduk pada batas token total model untuk gambar dan teks (yaitu, input maksimum). Jumlah total token dari semua gambar harus kurang dari input maksimum model.
Metode input file
-
URL publik: berikan alamat file yang dapat diakses publik dan mendukung protokol HTTP atau HTTPS. Untuk stabilitas dan performa optimal, Anda dapat mengunggah file ke OSS untuk mendapatkan URL publik. Layanan Model Studio tidak dapat mengakses alamat internal OSS (endpoint yang mengandung
-internal, sepertihttps://<bucket>.oss-cn-hangzhou-internal.aliyuncs.com/image.jpg). Memberikan alamat internal menyebabkan pengunduhan file gagal dan mengembalikanInvalidParameterdengan pesanFailed to download multimodal content. Gunakan nama domain publik OSS (sepertihttps://<bucket>.oss-cn-hangzhou.aliyuncs.com/image.jpg) atau URL bertanda tangan sementara OSS untuk memberikan file. - Pengodean Base64: konversikan file menjadi string berkode Base64 sebelum memberikannya.
- Path file lokal (khusus DashScope SDK): berikan path file lokal.
Untuk saran mengenai metode input file, lihat Bagaimana memilih metode unggah file?
Menghitung token gambar dan video
Menghitung token gambar dan video
- Gambar
- Video
Image Token = h_bar * w_bar / token_pixels + 2-
h_bar、w_bar: lebar dan tinggi gambar yang telah diskalakan. Model melakukan pra-pemrosesan sebelum memproses gambar, mengecilkan ukurannya hingga batas piksel tertentu. Batas piksel ini bergantung pada nilai parametermax_pixelsdanvl_high_resolution_images. -
token_pixels: jumlah piksel yang sesuai dengan setiapTokenvisual, yang bervariasi antar model:- Seri
qwen3.7, seriqwen3.6, seriqwen3.5,Qwen3-VL,qwen-vl-max,qwen-vl-plus: setiapTokensesuai dengan32x32piksel QVQdan modelQwen2.5-VLlainnya: setiap Token sesuai dengan28x28piksel
- Seri
Klik untuk melihat contoh estimasi token gambar
Klik untuk melihat contoh estimasi token gambar
Sebelum Anda memulai fine-tuning model
-
Meskipun fine-tuning model generasi teks dapat mencapai hasil yang sangat baik dalam bisnis/skenario tertentu, metode ini memiliki keterbatasan berikut:
- Memakan waktu, termasuk: membangun dataset CPT berskala besar (minimal 50 juta token), membangun dataset SFT yang efektif (1.000+ entri), mengumpulkan bad case yang cukup banyak (100+) untuk membangun dataset DPO yang efektif, serta iterasi optimasi model yang lambat.
- Biayanya tinggi. Model hasil fine-tuning hanya dapat digunakan setelah deployment, dan penagihan deployment model relatif tinggi.
-
Alibaba Cloud Model Studio merekomendasikan agar sebelum mempertimbangkan fine-tuning model generasi teks, Anda terlebih dahulu mencoba rekayasa prompt (Prompt Engineering) atau pemanggilan plugin (Function Calling) untuk menyesuaikan aplikasi Anda, dan fine-tuning model juga sering kali menjadi "upaya terakhir" untuk meningkatkan performa model, karena:
- Dalam banyak tugas, model mungkin awalnya berkinerja buruk, tetapi menerapkan teknik Prompt yang tepat dapat meningkatkan hasil, sehingga fine-tuning model tidak selalu diperlukan.
- Melakukan iterasi pada Prompt dan plugin lebih lincah dan murah dibandingkan iterasi fine-tuning model, karena satu iterasi fine-tuning mungkin memerlukan pengumpulan ulang data, pembersihan dan optimasi data, pengumpulan bad case, serta riset pelanggan.
- Meskipun pada akhirnya fine-tuning model tetap diperlukan, pekerjaan awal rekayasa prompt dan iterasi plugin tidak akan sia-sia. Anda dapat menggunakan kembali pekerjaan awal tersebut secara penuh saat membangun dataset fine-tuning (sebagai input untuk pembangunan dataset).
Mulai Cepat
Lakukan fine-tuning model di konsol
-
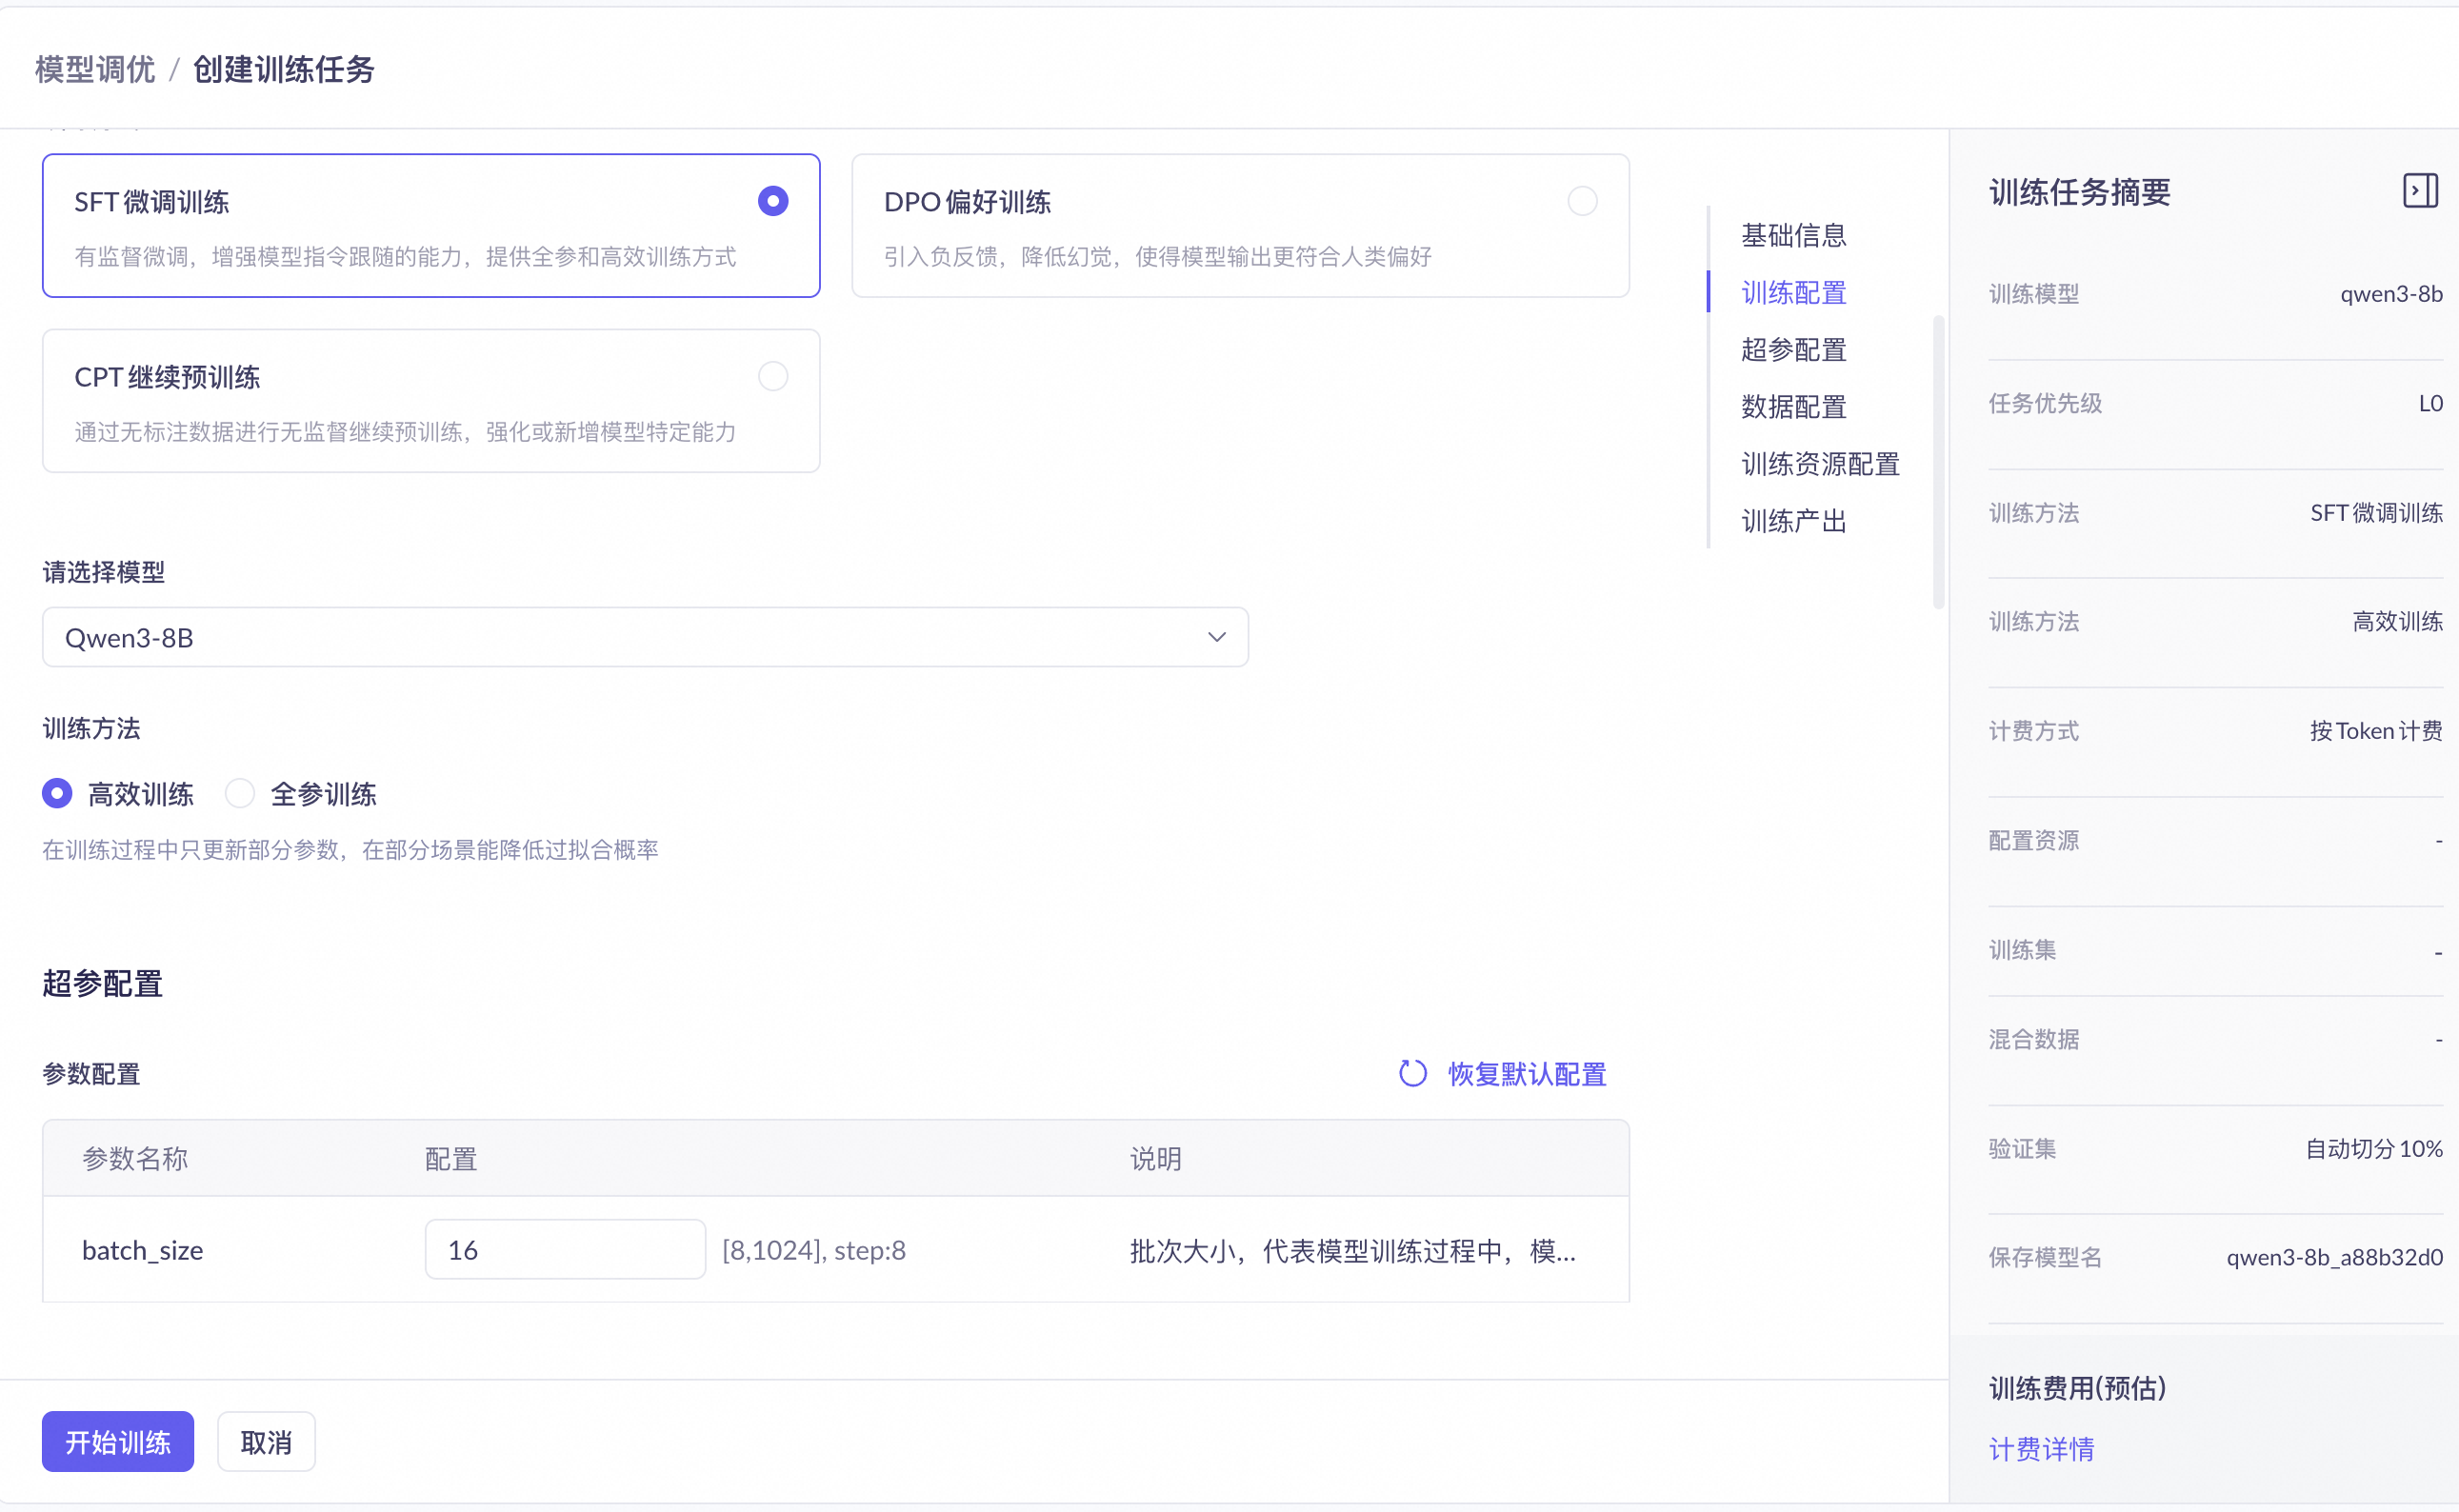
Masuk ke konsol Model Studio. Di panel navigasi kiri, pilih Model Training > Model Fine-tuning, lalu klik Create Training Task.
-
Lengkapi konfigurasi berikut di bagian Training Configuration:
- Training Method: Pilih SFT fine-tuning training.
- Select a model: Pilih Qwen3-8B.
- Training Method: Pilih Efficient Training.
- Di bagian Hyperparameter Configuration, pertahankan pengaturan parameter default. Model Studio menyediakan konfigurasi yang direkomendasikan untuk hiperparameter fine-tuning.
-
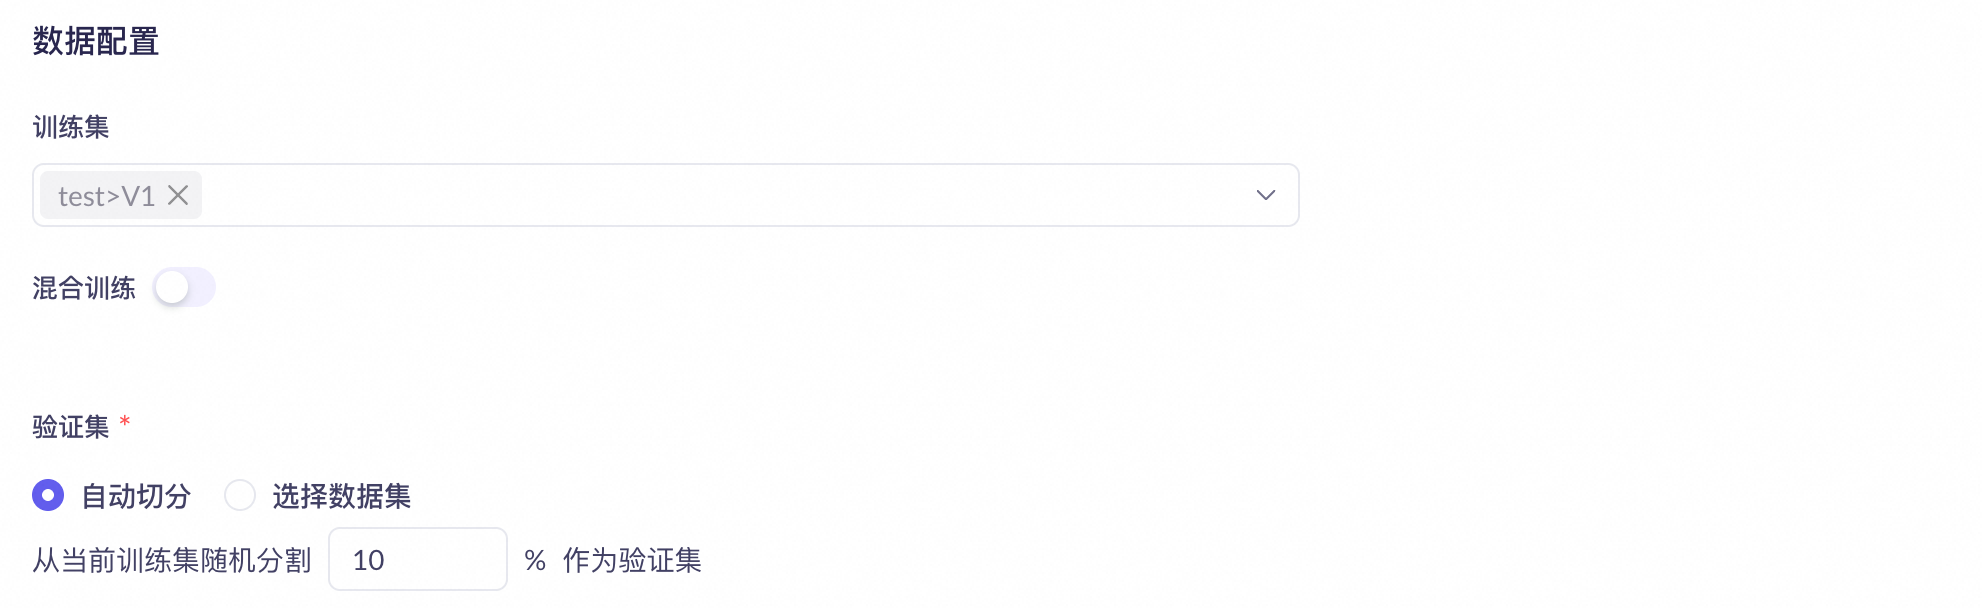
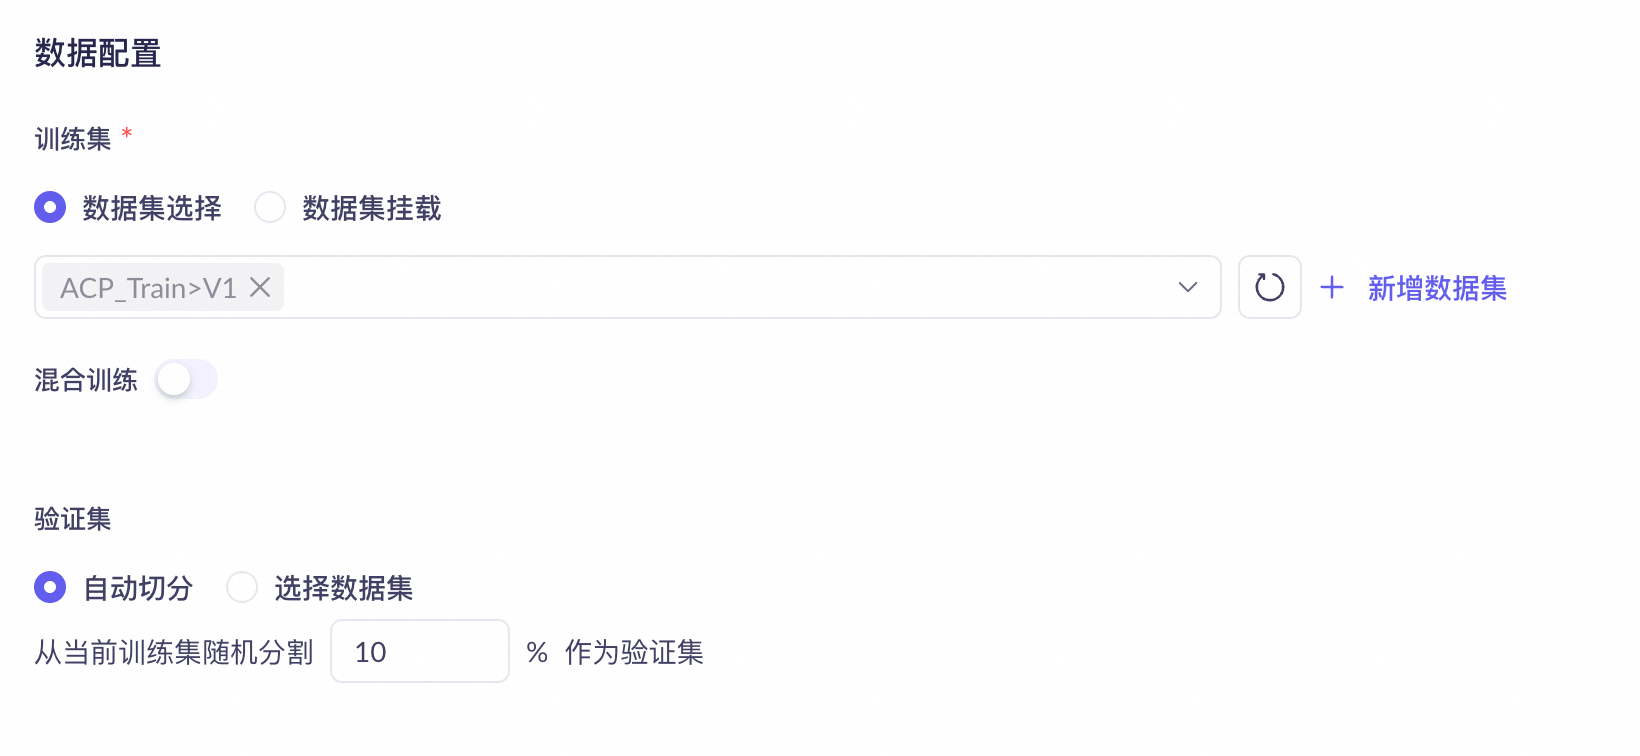
Lengkapi konfigurasi berikut di bagian Data Configuration:
- Training set: Pilih dataset fine-tuning yang telah Anda unggah. Contoh data: SFT-ChatML format example.jsonl.
- Mixed Training: Biarkan dinonaktifkan.
- Validation set: Pilih Automatic Splitting untuk membagi 10% dari training set sebagai validation set.
-
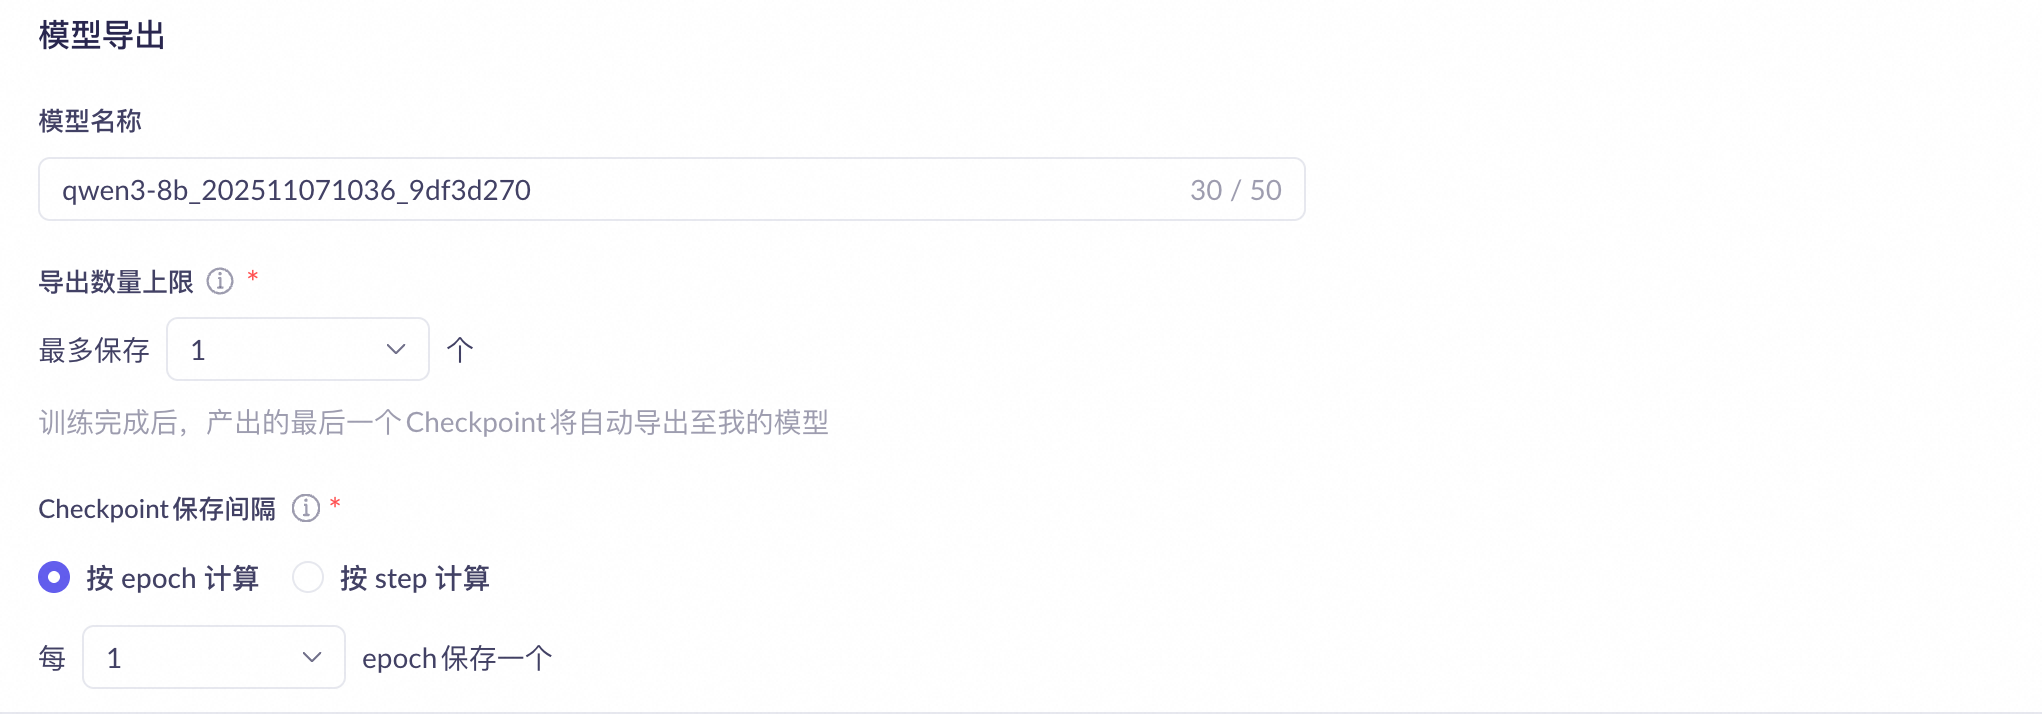
Di bagian Training Output, konfigurasikan cara snapshot parameter model (Checkpoint) disimpan. Anda dapat mempertahankan pengaturan default untuk konfigurasi berikut:
- Model: Setelah pelatihan selesai, Checkpoint output terakhir akan otomatis dipublikasikan ke My Models dengan nama ini.
- Up to : Atur jumlah model yang akhirnya diekspor oleh tugas pelatihan.
- Checkpoint saving interval: Anda dapat memilih By epoch atau By step.
 Setelah fine-tuning model selesai, Anda harus mengekspor snapshot parameter. Hanya setelah diekspor Anda dapat men-deploy model di Model Studio berdasarkan versi snapshot parameter tersebut. Snapshot parameter yang diekspor disimpan di penyimpanan cloud dan saat ini tidak dapat diakses atau diunduh.
- Klik Start Training dan tunggu hingga pelatihan model selesai.
- Di Model Inference > Dedicated Deployment, deploy model kustom yang telah dilatih. Setelah deployment, Anda dapat mengevaluasi model hasil fine-tuning. Untuk informasi selengkapnya, lihat Ikhtisar Dedicated Deployment.
Alur kerja fine-tuning khas
Ketiga metode fine-tuning yang disediakan Model Studio tidak saling eksklusif, melainkan progresif dan saling melengkapi.
CPT (optional) → SFT → DPO (optional)
-
CPT (continual pre-training) - melengkapi pengetahuan (pengetahuan model umum yang "luas tetapi dangkal" tidak dapat memenuhi persyaratan "kedalaman" dan "presisi" domain khusus)
- Model keuangan:
Learn financial terminology - Model medis:
Memorize drugs and pathology - Model hukum:
Understand statutes and precedents
- Model keuangan:
-
SFT (supervised fine-tuning) - belajar melakukan tugas
- Bot layanan pelanggan:
Learn customer service workflows - Asisten kode:
Learn programming paradigms - Pemanggilan alat (Agent):
Learn to use MCP
- Bot layanan pelanggan:
-
DPO (direct preference optimization) - melakukan dengan lebih baik
- Keamanan dan tanggung jawab:
Refuse harmful advice - Keringkasan dan efektivitas:
Answer crisply and cleanly - Objektivitas dan netralitas:
Evaluate fairly and objectively
- Keamanan dan tanggung jawab:
Format data fine-tuning
Untuk spesifikasi format data, aturan pengemasan, batasan ukuran dan kuantitas, serta kuota unggah API dari setiap metode pelatihan (SFT/DPO/CPT), lihat Aturan unggah data fine-tuning. Ikhtisar format file yang didukung oleh setiap metode pelatihan:
Metode pelatihan | Format file |
|---|---|
SFT generasi teks | jsonl (struktur multi-putaran ChatML messages) |
SFT multi-modal (gambar/video) | zip (data.jsonl + file gambar/video) |
DPO | jsonl (pasangan preferensi chosen/rejected) |
CPT | jsonl (teks biasa {text}) |
Set Evaluasi | xlsx (prompt&completion)/ jsonl, xls, xlsx (ChatML-messages)/ zip (multi-modal: pemahaman visual, teks-ke-gambar, gambar-ke-gambar, gambar-ke-video) |
Tips pembuatan dataset
Persyaratan skala dataset
Untuk CPT, dataset memerlukan setidaknya 50 juta token data pre-training berkualitas tinggi; untuk SFT, setidaknya ribuan contoh fine-tuning berkualitas tinggi; untuk DPO, biasanya ratusan contoh preferensi manusia. Jika hasil evaluasi model setelah fine-tuning tidak memuaskan, perbaikan paling sederhana adalah mengumpulkan lebih banyak data untuk pelatihan.
Jika Anda kekurangan data, kami menyarankan membangun aplikasi agen (Agent 1.0) dan menggunakan pengindeksan basis pengetahuan untuk meningkatkan kemampuan model. Dalam banyak skenario bisnis kompleks, Anda juga dapat mengadopsi pendekatan teknis gabungan yang mengintegrasikan fine-tuning model dengan pengambilan basis pengetahuan.
Ambil skenario layanan pelanggan sebagai contoh: fine-tuning model dapat menangani nada bicara, kebiasaan ekspresi, dan identitas diri respons layanan pelanggan, sedangkan pengetahuan domain yang terlibat dalam skenario tersebut dapat dimasukkan secara dinamis ke dalam konteks model melalui basis pengetahuan.
Alibaba Cloud Model Studio merekomendasikan agar Anda terlebih dahulu membangun aplikasi RAG untuk uji coba, lalu terus meningkatkan performa model melalui fine-tuning model setelah data aplikasi yang cukup terkumpul.
Anda juga dapat memperluas dataset Anda dengan strategi berikut:
- Gunakan model besar untuk mensimulasikan dan menghasilkan konten yang relevan dengan kebutuhan bisnis/skenario tertentu, membantu Anda menghasilkan lebih banyak data fine-tuning. (Untuk model generasi, kami menyarankan memilih model dengan performa kuat dan skala lebih besar)
- Dapatkan lebih banyak data secara manual melalui berbagai saluran seperti pengumpulan dari skenario aplikasi, web crawler, media sosial dan forum daring, dataset publik, mitra dan sumber daya industri, serta kontribusi pengguna.
Keragaman dan keseimbangan data
Fine-tuning model berlaku untuk skenario yang berbeda: untuk skenario bisnis tertentu, spesialisasi lebih penting; untuk skenario tanya jawab, generalitas lebih penting. Anda perlu merancang kasus penggunaan data berdasarkan modul bisnis atau skenario penggunaan yang dilayani model. Oleh karena itu, efektivitas pelatihan tidak hanya bergantung pada volume data, tetapi juga pada spesialisasi dan keragaman untuk skenario target.
Dengan skenario percakapan AI cerdas sebagai contoh, berikut diperkenalkan berbagai skenario bisnis yang harus dicakup oleh dataset yang terspesialisasi dan beragam:
Bisnis spesifik | Skenario/bisnis beragam |
|---|---|
Layanan pelanggan e-commerce | Notifikasi acara, konsultasi pra-penjualan, panduan saat penjualan, layanan purna jual, tindak lanjut purna jual, penanganan keluhan, dll. |
Layanan keuangan | Konsultasi pinjaman, konsultasi investasi dan manajemen kekayaan, layanan kartu kredit, manajemen rekening bank, dll. |
Layanan kesehatan daring | Konsultasi gejala, pendaftaran janji temu, panduan kunjungan, kueri informasi obat, tips kesehatan, dll. |
Sekretaris AI | Informasi IT, informasi administratif, informasi SDM, jawaban tunjangan karyawan, kueri kalender perusahaan, dll. |
Asisten perjalanan | Perencanaan perjalanan, panduan masuk dan keluar, konsultasi asuransi perjalanan, pengenalan adat dan budaya destinasi, dll. |
Penasihat hukum perusahaan | Tinjauan kontrak, perlindungan kekayaan intelektual, pemeriksaan kepatuhan, tanya jawab hukum ketenagakerjaan, konsultasi transaksi lintas batas, analisis hukum spesifik kasus, dll. |
Pemisahan set pelatihan dan set validasi
Saat Anda menggunakan konsol untuk fine-tuning model, Anda dapat memilih untuk
- Memisahkan dataset pelatihan lengkap secara otomatis, mengekstrak secara acak sejumlah kecil data untuk membentuk set validasi.
- Memilih dataset yang diunggah secara terpisah.