

Reservasi TPM mengunci kapasitas inferensi khusus untuk model tertentu, memastikan layanan Anda tidak terpengaruh oleh batas laju publik selama jam sibuk bisnis. Topik ini menjelaskan cara membuat, mengintegrasikan, dan mengelola reservasi TPM.
Ikhtisar
Dengan reservasi TPM (Tokens Per Minute), Anda dapat mengunci throughput inferensi khusus untuk model tertentu. Panggilan dalam kapasitas terjadwal tidak tunduk pada batas laju kolam sumber daya publik.
- Jaminan kapasitas: Kapasitas TPM terjadwal dikhususkan untuk workload Anda dan tidak dibagi dengan pengguna lain.
- Kode model khusus: Setelah membuat reservasi TPM, sistem secara otomatis menghasilkan kode model khusus. Anda harus mengganti parameter
modeldalam permintaan API Anda dengan kode ini. - Strategi overflow: Saat membuat reservasi, Anda dapat memilih cara menangani traffic berlebih—secara otomatis overflow ke pay-as-you-go (default, tanpa gangguan layanan) atau hanya menggunakan kapasitas terjadwal (permintaan berlebih mengembalikan error 429, tanpa biaya tambahan).
Bandingkan dan pilih rencana
Model Studio menawarkan berbagai rencana kapasitas dan penagihan untuk panggilan inferensi, termasuk pay-as-you-go, paket sumber daya, rencana penghematan, reservasi TPM, serta penerapan khusus PTU. Setiap rencana memiliki karakteristik berbeda terkait unit penagihan, tingkat jaminan kapasitas, penanganan overflow, dan perubahan integrasi. Bagian ini membantu Anda memilih rencana yang sesuai dengan kebutuhan bisnis.
Rencana | Unit penagihan | Jaminan kapasitas | Kasus penggunaan | Penanganan overflow | Perubahan kode |
|---|---|---|---|---|---|
Pay-as-you-go | Per token | Tidak ada (kolam publik bersama) | Traffic sangat bervariasi/jangka pendek | Dilayani secara otomatis, tunduk pada batas laju publik | Tidak perlu perubahan |
Paket sumber daya/Rencana penghematan | Kuota prabayar | Diskon penggunaan komitmen (bukan kapasitas khusus) | Optimasi biaya | Traffic berlebih beralih ke pay-as-you-go | Tidak perlu perubahan |
Reservasi TPM | Prabayar per kTPM | Kapasitas khusus dengan jaminan kuat | Traffic dapat diprediksi, tidak toleran terhadap pembatasan laju | Opsional: luapan otomatis ke pay-as-you-go (default) / hanya kapasitas terpesan mengembalikan 429 | Ganti parameter model |
PTU (Penerapan model) | Prabayar per kTPM | Instans penerapan khusus | Throughput dan performa tinggi | Opsi: auto-overflow ke pay-as-you-go (default) / hanya kapasitas PTU mengembalikan 429 | Ganti parameter model |
Model yang didukung
Harga mengikuti Konsol; tabel hanya sebagai Referensi.
- China (Beijing)
- Singapura
Nama model | Prabayar - harian | |
|---|---|---|
Input (per 10.000 TPM) | Output (per 1.000 TPM) | |
Qwen3.8-Max | $16,63 | $4,99 |
Qwen3.7-Flash-2026-07-15 Hubungi account manager Anda untuk aktivasi | $0,28 | $0,11 |
Qwen3.7-Max-2026-05-20 | $16,63 | $4,99 |
Qwen3.7-Plus-2026-05-26 | $2,77 | $1,11 |
Qwen3.6-Flash-2026-04-16 | $1,66 | $1,00 |
GLM-5.2 | $11,09 | $3,88 |
GLM-5.1 | $8,32 | $3,33 |
DeepSeek-v4-Pro-0813 | $12,82 | $3,85 |
DeepSeek-v4-Flash | $1,39 | $0,28 |
DeepSeek-v4-Pro | $16,63 | $3,33 |
DeepSeek-v4-Flash-0731 | $4,27 | $1,28 |
Kimi-K2.6 | $9,01 | $3,74 |
Catatan penagihan dan penggunaan
- Penagihan dimulai setelah penerapan berhasil. Panggilan dalam kapasitas terjadwal tidak dikenakan biaya tambahan.
- Biaya prabayar dibayarkan sekaligus di muka dan berlaku sejak saat pembelian. Lihat Pusat Tagihan Bailian untuk biaya aktual.
- Siklus penagihan "harian" dihitung berdasarkan hari kalender: dari saat instans berlaku hingga pukul 00.00.00 hari berikutnya, bukan 24 jam berkelanjutan sejak waktu pembelian. Misalnya, reservasi 1 hari yang dibeli pukul 16.00 berakhir pukul 00.00 (berlaku sekitar 8 jam). Kami menyarankan melakukan pembelian di awal hari atau mengaktifkan Auto-renewal on expiry untuk menghindari gangguan layanan.
-
Penurunan spesifikasi dan pengembalian dana pembatalan langganan: bagian yang telah digunakan diselesaikan dengan koefisien 1,2x. Rumus:
Refund = biaya prabayar bagian yang dikurangi - (biaya prabayar bagian yang dikurangi × durasi penggunaan / durasi pembelian × 1,2) - Saat kebijakan overflow diatur ke "Auto overflow", permintaan yang melebihi kuota terjamin secara otomatis beralih ke penagihan pay-as-you-go standar tanpa gangguan layanan. Anda dapat melihat jumlah degradasi pada halaman detail di Overflow degradation statistics. Jika diatur ke "Reserved capacity only", permintaan yang melebihi kuota mengembalikan error 429 dan tidak dikenakan biaya tambahan.
- Dalam 2 jam setelah layanan berakhir: instans masih Berjalan, dapat dipanggil, dan dapat diperpanjang; 2 hingga 14 jam setelah berakhir: instans dihentikan, tidak dapat dipanggil, tetapi masih dapat diperpanjang; 14 jam setelah berakhir: instans dihapus dan tidak dapat dipulihkan.
Klik di sini untuk melihat parameter konversi kapasitas untuk setiap model
Klik di sini untuk melihat parameter konversi kapasitas untuk setiap model
Model | Panjang input maks | Diskon Cache | Koefisien tier input panjang |
|---|---|---|---|
Qwen3.8-max | 1 Juta | 0,125 | Tidak ada tier (1,0) |
Qwen3.6-flash-2026-04-16 | 256K | Cache tidak didukung | Tidak ada tier (1,0) |
Seri Qwen lainnya | 256K | 0,2 (cache hit mengonsumsi kapasitas sebesar 20% dari laju normal) | Tidak ada tier (1,0) |
glm-5.2 | 1 Juta | 0,25 (cache hit mengonsumsi kapasitas sebesar 25% dari laju normal) | Tidak ada tier (1,0) |
glm-5.1 | 200K | 0,2 (cache hit mengonsumsi kapasitas sebesar 20% dari laju normal) | [0, 32K): input 1,0 / output 1,0 |
DeepSeek-v4-Pro-0813 | 1 Juta | 0,1 (cache hit mengonsumsi kapasitas sebesar 10% dari laju normal) | Tidak ada tier (1,0) |
DeepSeek-v4-Pro | 256K | 0,08 (cache hit mengonsumsi kapasitas sebesar 8% dari laju normal) | Tidak ada tier (1,0) |
DeepSeek-v4-Flash-0731 | 1 Juta | 0,1 (cache hit mengonsumsi kapasitas sebesar 10% dari laju normal) | Tidak ada tier (1,0) |
DeepSeek-v4-Flash | 256K | 0,2 (cache hit mengonsumsi kapasitas sebesar 20% dari laju normal) | Tidak ada tier (1,0) |
Kimi-K2.6 | 256K | 0,2 (cache hit mengonsumsi kapasitas sebesar 20% dari laju normal) | Tidak ada tier (1,0) |
Buat reservasi TPM
Prasyarat: layanan model Bailian telah diaktifkan dan ruang kerja telah dibuat. Masuk ke Konsol Bailian dan klik Create TPM reservation.

-
Isi parameter berikut:
Parameter
Deskripsi
Wajib
Deskripsi nilai
Nama reservasi
Nama kustom untuk identifikasi.
Ya
≤ 50 karakter
Pilih model
Pilih model yang akan dipesan kapasitasnya. Kode model khusus akan dihasilkan secara otomatis setelah pengiriman.
Ya
Hanya model yang mendukung reservasi TPM yang tersedia; lihat tampilan Konsol.
Siklus penagihan
Siklus penagihan.
Ya
Harian
TPM input
Throughput masukan yang dicadangkan, dalam kTPM (1 kTPM = 1.000 token/menit).
Ya
Nilai awal dan langkah bervariasi tergantung model; lihat tampilan Konsol.
TPM output
Throughput output terjadwal, dalam kTPM.
Ya
Nilai awal dan langkah bervariasi tergantung model; lihat tampilan Konsol.
Durasi pembelian
Durasi validitas reservasi.
Ya
Masukkan jumlah hari dalam kotak input. Nilai yang didukung: 1-30, 60, 90, 120, 365 hari.
Auto-renewal on expiry
Secara otomatis memotong pembayaran dan memperpanjang pada pukul 08.00 satu hari sebelum berakhir. Diaktifkan secara default.
Tidak
On / Off
Durasi perpanjangan tunggal
Durasi setiap perpanjangan otomatis.
Tidak
Masukkan jumlah hari dalam kotak input. Rentang nilainya sama dengan durasi pembelian.
Kebijakan overflow
Cara menangani permintaan yang melebihi kapasitas terjadwal saat habis.
Ya
Auto overflow ke pay-as-you-go per token (default; overflow beralih ke pay-as-you-go, tanpa gangguan layanan) / Hanya kapasitas terjadwal (overflow mengembalikan 429, tanpa biaya tambahan)
- Setelah mengonfirmasi parameter, klik Buy now. Pada dialog konfirmasi biaya, verifikasi biaya dan klik Confirm payment.
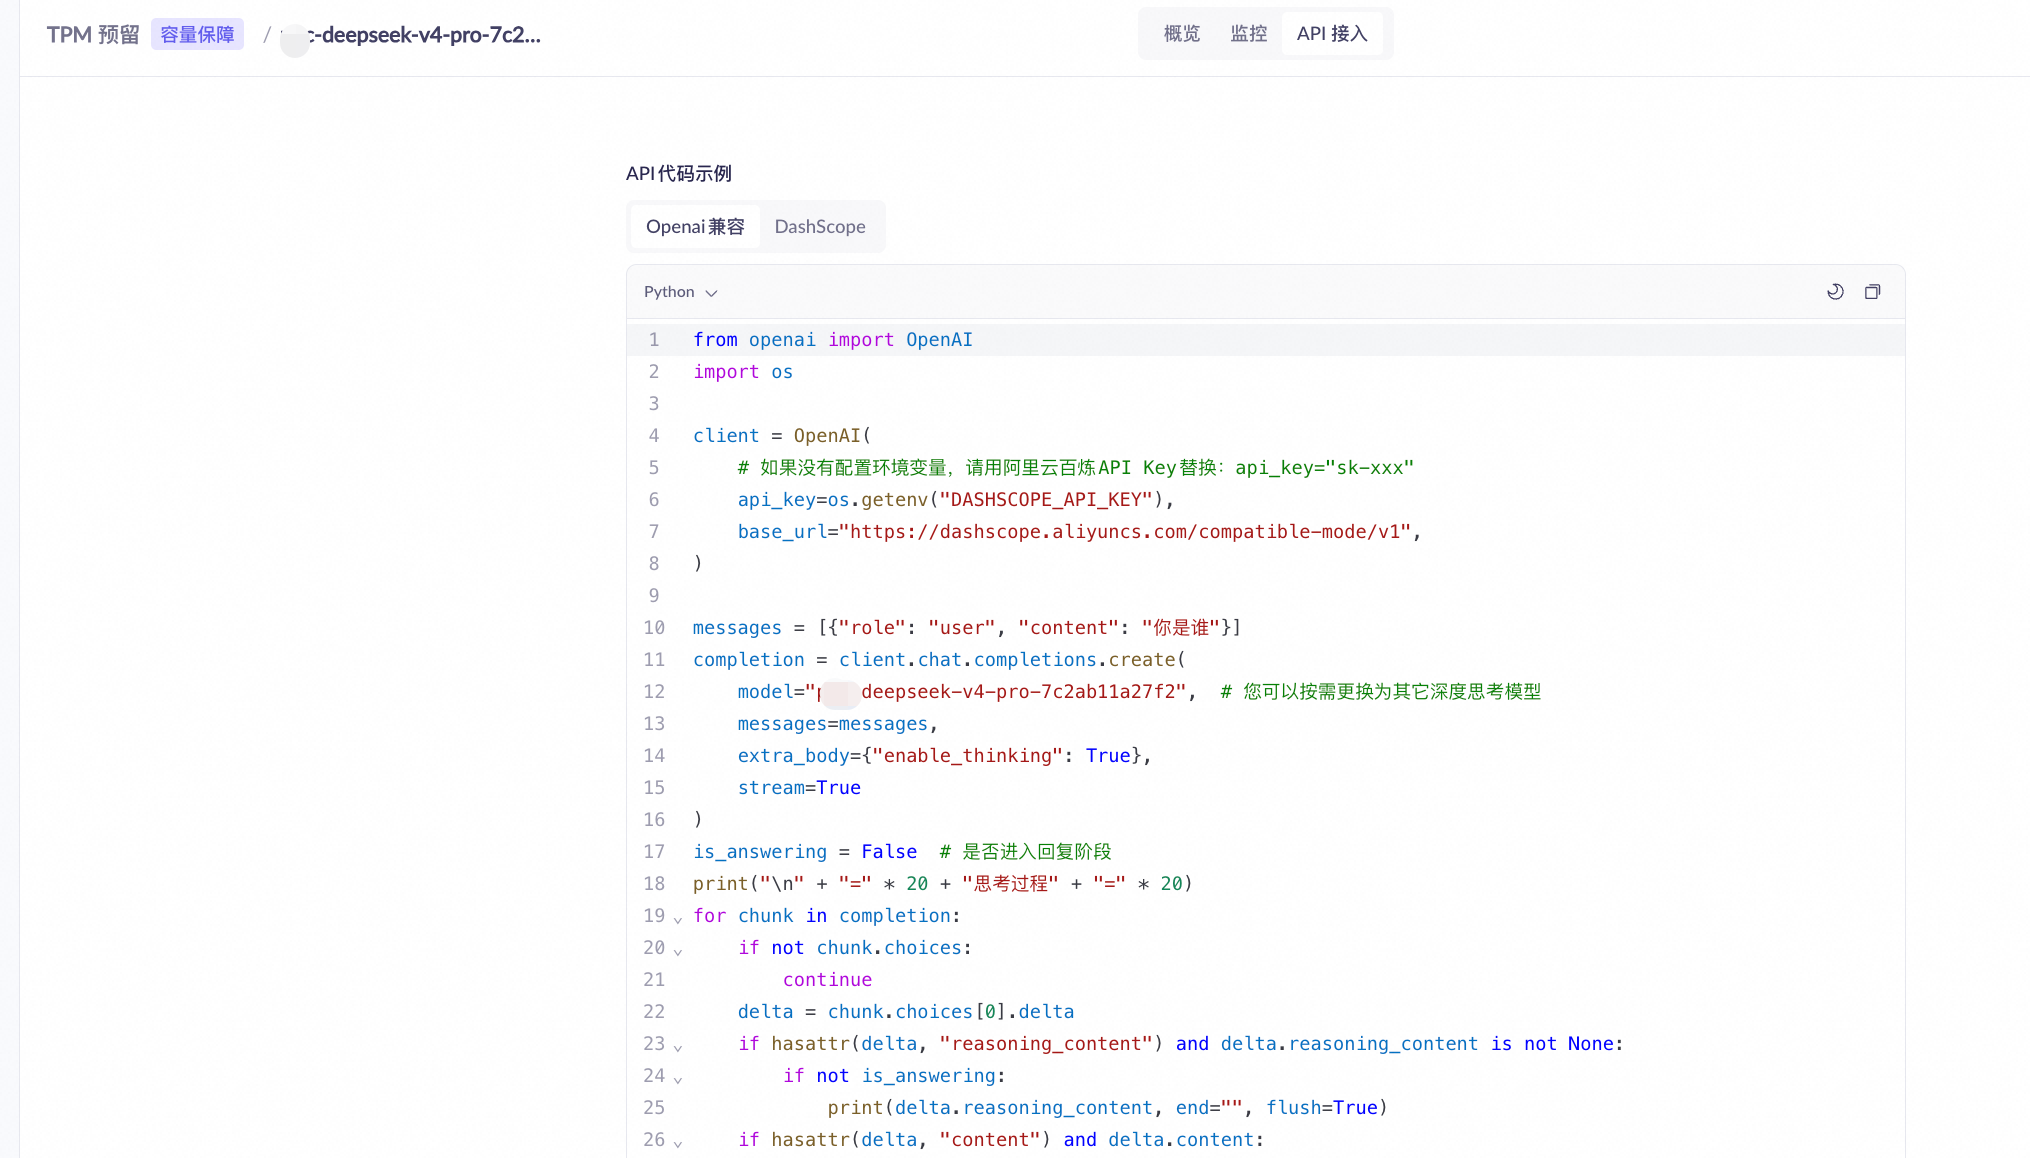
- Pada tab Overview halaman detail reservasi TPM, temukan Dedicated model code dan klik copy.
-
Ganti parameter
modeldalam permintaan API Anda dengan kode model khusus yang telah disalin:Prasyarat: instans reservasi TPM telah dibuat dan statusnya Running.
Parameterthinking_budgetGLM-5.2 (yang membatasi panjang pemrosesan) tidak berlaku saat dipanggil.
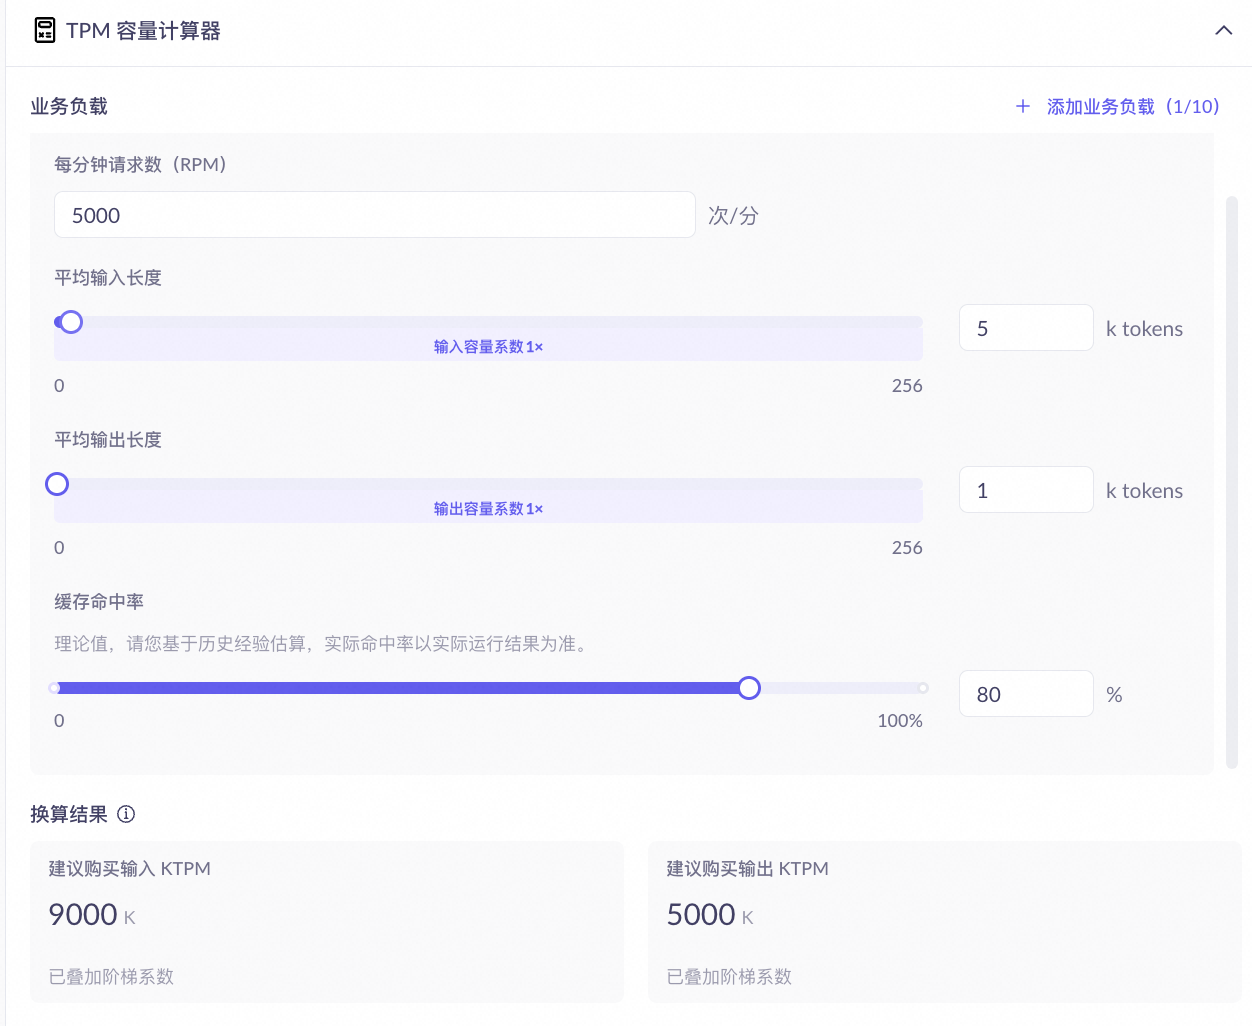
Kalkulator kapasitas TPM
Kalkulator kapasitas TPM di sisi kanan halaman pembuatan membantu Anda memperkirakan kuota TPM yang akan dibeli berdasarkan beban bisnis Anda. Setelah mengisi parameter berikut, kalkulator secara otomatis menghasilkan rekomendasi TPM input dan TPM output.
Parameter | Deskripsi | Dampak terhadap hasil |
|---|---|---|
Permintaan per menit (RPM) | Jumlah permintaan yang dikirim per menit selama jam sibuk bisnis. | Semakin besar RPM, semakin besar TPM input dan output yang direkomendasikan secara proporsional. |
Panjang input rata-rata (token) | Jumlah rata-rata token input per permintaan. | Semakin panjang input, semakin tinggi tier dan semakin besar koefisiennya, sehingga semakin tinggi TPM input yang direkomendasikan. Batas tier berbeda-beda tergantung model; lihat tampilan Konsol aktual. |
Panjang output rata-rata (token) | Jumlah rata-rata token output per permintaan. | Semakin panjang output, semakin besar koefisiennya, sehingga semakin tinggi TPM output yang direkomendasikan. |
Tingkat hit cache | Proporsi permintaan yang memiliki awalan berulang dan menghasilkan cache hit. Tingkat hit aktual bergantung pada pengulangan konten permintaan; lihat hasil waktu proses. | Semakin tinggi tingkat hit, semakin lambat konsumsi kapasitas input, sehingga semakin rendah TPM input yang direkomendasikan. Hanya memengaruhi TPM input, bukan TPM output. |
Lihat dan kelola
Buka Konsol Bailian dan buka halaman daftar reservasi. Daftar menampilkan semua instans reservasi sebagai kartu model dan mendukung penyaringan berdasarkan model, waktu, dan status.

Detail reservasi
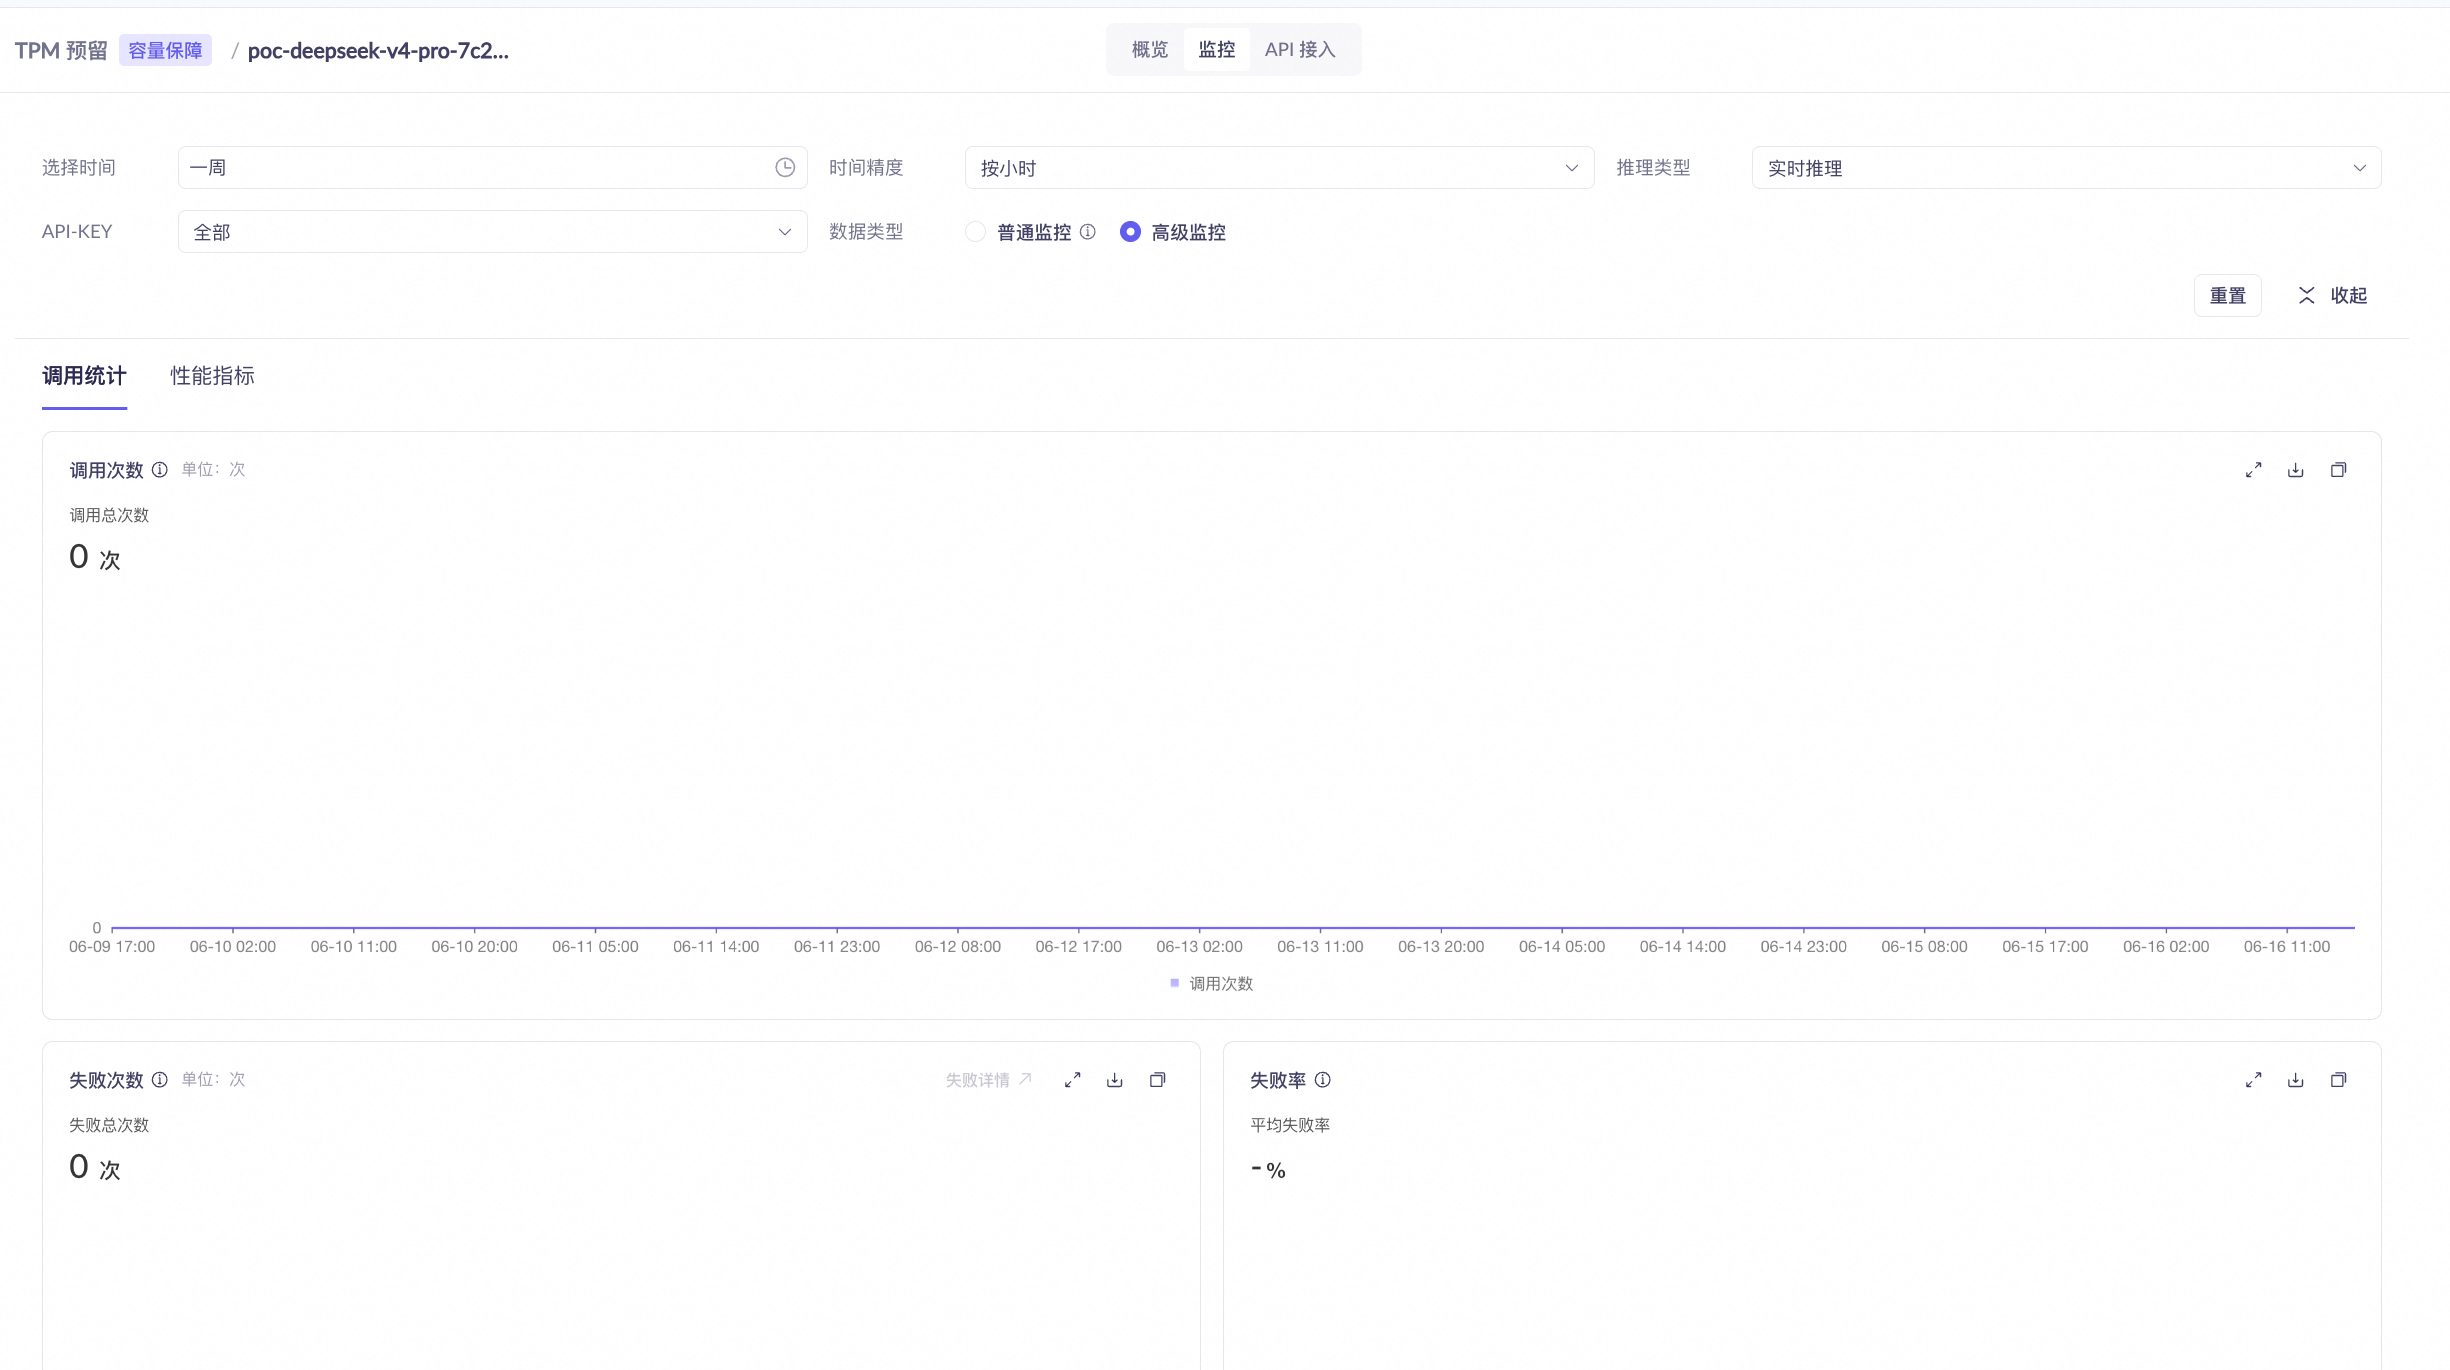
Klik kartu model target untuk membuka halaman detail, yang berisi tiga tab berikut:
- Overview
- Monitoring
- API access
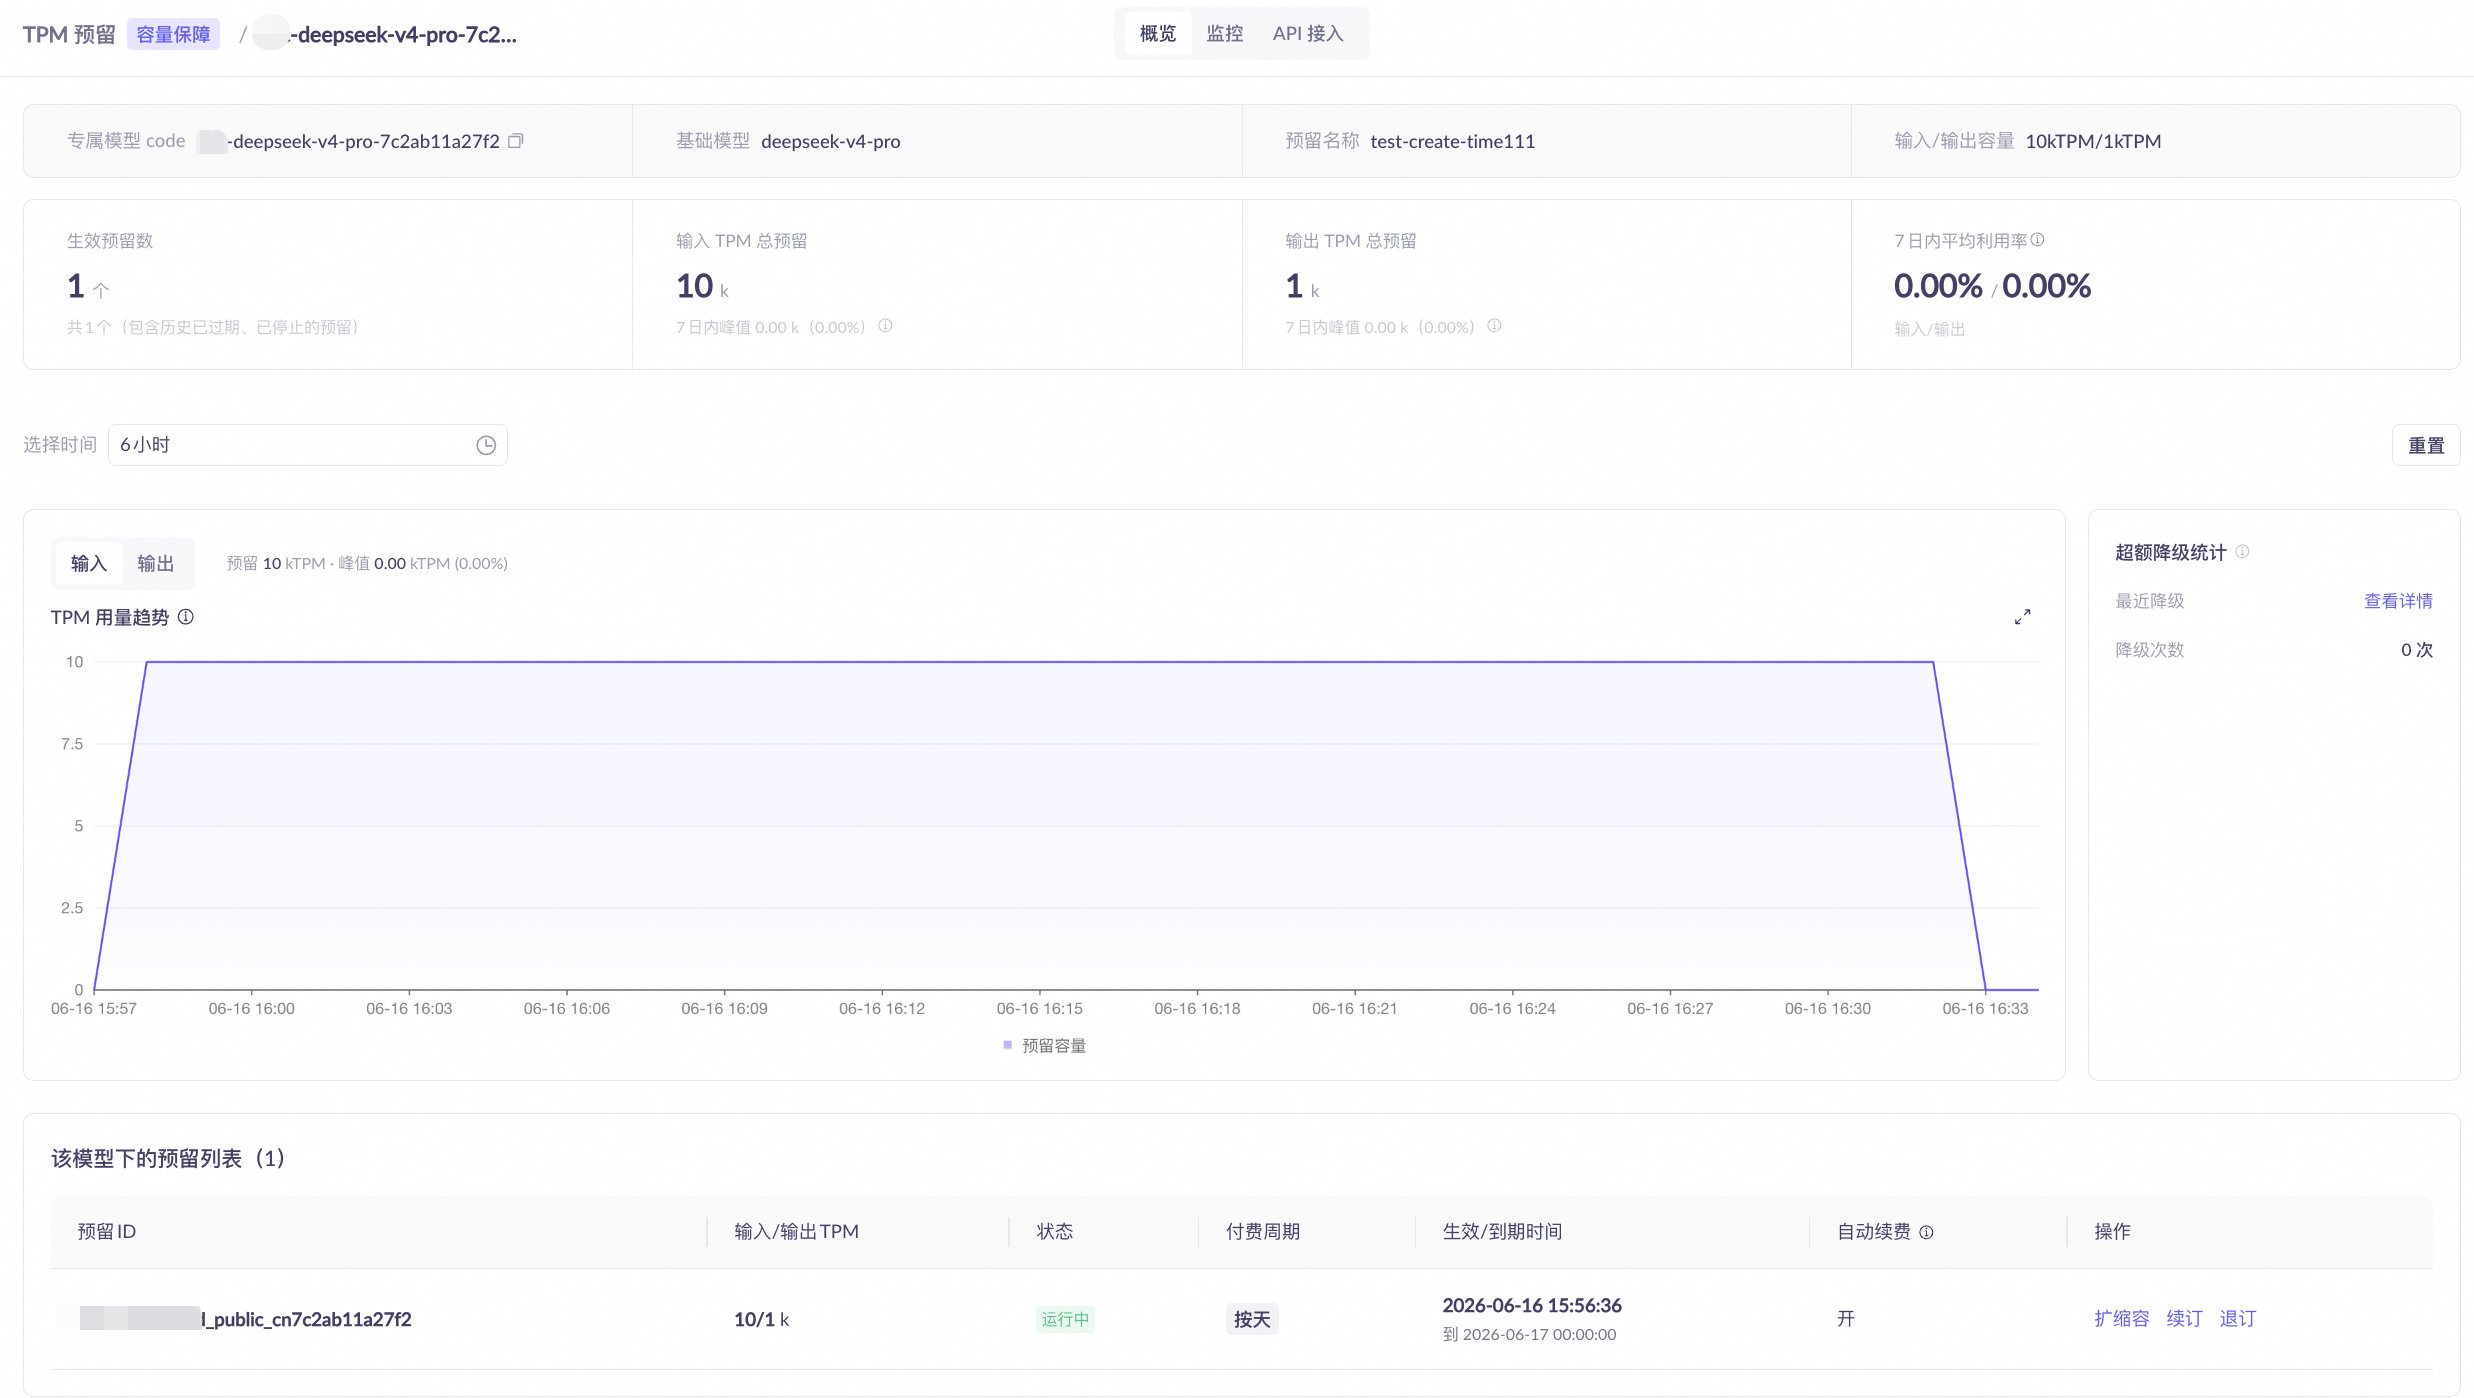
- Informasi dasar: nama reservasi, kode model khusus (dapat disalin), model dasar, kapasitas input/output.
- Kartu statistik (7 hari terakhir): jumlah reservasi aktif, total dan TPM penggunaan puncak, rata-rata utilisasi.
- Tren utilisasi: alihkan antara arah input/output; menampilkan garis kapasitas terjadwal dan penggunaan aktual.
- Statistik degradasi overflow: menunjukkan jumlah permintaan yang mengalami degradasi setelah melebihi kapasitas terjadwal (degradasi hanya terjadi di bawah kebijakan "Auto overflow").
Operasi manajemen
Pada daftar reservasi di tab Overview halaman detail, temukan instans target dan gunakan kolom Operasi untuk melakukan hal berikut:
- Scaling
- Renewal
- Unsubscribe
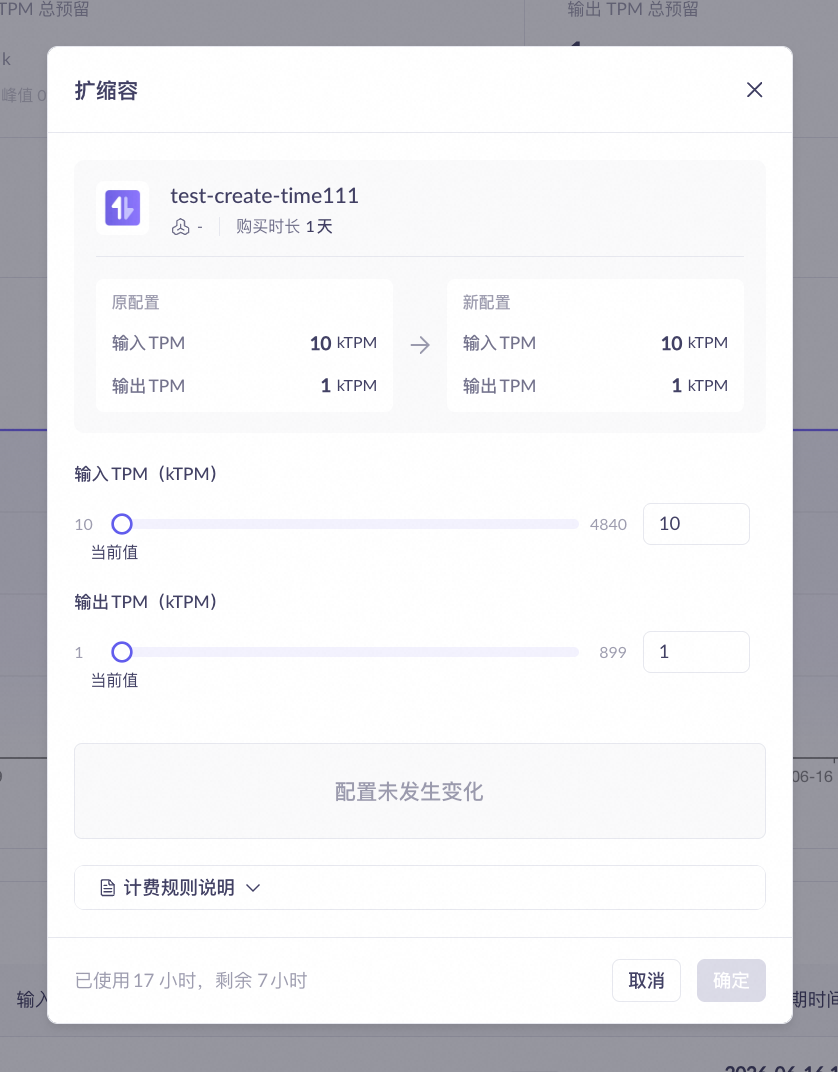
Status instans reservasi
Status instans reservasi
Status | Deskripsi |
|---|---|
Running | Berjalan normal; dapat dipanggil menggunakan kode model khusus. |
Pending | Dibuat; menunggu berlaku. |
Modifying | Scaling sedang berlangsung; layanan tidak terganggu selama periode ini. |
Stopped | Dihentikan karena alasan seperti Pembayaran tertunda; dapat dipulihkan setelah perpanjangan. |
Expired | Kedaluwarsa tanpa perpanjangan; sumber daya telah dilepas. |
Canceled | Pembatalan langganan selesai; tidak dapat dikembalikan. |
FAQ
T: Apa yang terjadi ketika kapasitas terjadwal terlampaui?
T: Apa yang terjadi ketika kapasitas terjadwal terlampaui?
T: Bagaimana cara mendapatkan kode model khusus?
T: Bagaimana cara mendapatkan kode model khusus?
model dalam permintaan API Anda dengan kode ini untuk menggunakan kapasitas terjadwal.T: Apa yang terjadi ketika reservasi berakhir?
T: Apa yang terjadi ketika reservasi berakhir?
T: Bagaimana cara menentukan apakah perlu scaling up?
T: Bagaimana cara menentukan apakah perlu scaling up?
T: Berapa lama sebenarnya masa berlaku reservasi "1 hari"?
T: Berapa lama sebenarnya masa berlaku reservasi "1 hari"?