

Model Evaluation adalah alat evaluasi kualitas model yang disediakan oleh platform Alibaba Cloud Model Studio. Fitur ini mendukung evaluasi kuantitatif terhadap performa model bahasa besar melalui dimensi evaluasi kustom, membantu Anda dalam pemilihan model, verifikasi tuning, dan perbandingan kemampuan.
Apa Itu Model Evaluation
Model Evaluation adalah alat verifikasi kualitas model yang disediakan oleh platform Alibaba Cloud Model Studio. Dengan dimensi evaluasi dan metode penilaian kustom, Anda dapat mengevaluasi performa model bahasa besar secara kuantitatif dalam skenario bisnis tertentu serta memperoleh hasil evaluasi yang dapat dibandingkan.
Kasus Penggunaan
Model Evaluation berlaku untuk skenario berikut:
- Pemilihan model: bandingkan skor dari beberapa model kandidat untuk memilih model yang paling sesuai dengan kebutuhan bisnis Anda.
- Verifikasi tuning: setelah melakukan Prompt tuning atau fine-tuning pada model, gunakan evaluasi untuk memverifikasi apakah performa telah meningkat.
- Evaluasi kuantitatif: ubah kualitas output model menjadi metrik skor terukur untuk menggantikan penilaian subjektif.
- Pemantauan berkelanjutan: jalankan tugas evaluasi secara berkala untuk melacak tren kemampuan model sepanjang iterasi versi.
Metode Penilaian
Model Evaluation mendukung lima metode penilaian, mencakup penilaian otomatis maupun manual:
- LLM Numerical Scoring: model juri memberikan skor numerik (misalnya 0–5 poin) sesuai dengan Scorer Prompt, cocok untuk skenario yang memerlukan kuantifikasi detail halus.
- LLM Classification Scoring: model juri mengklasifikasikan output ke dalam kategori yang telah ditentukan (misalnya Pass/Fail) sesuai dengan Scorer Prompt, cocok untuk penilaian biner atau multi-label.
- String Matching: melakukan perbandingan eksak (sama, mengandung, diawali dengan, diakhiri dengan, dll.) antara output model dan jawaban referensi, cocok untuk skenario dengan satu jawaban standar.
- Text Similarity: menggunakan algoritma (ROUGE-L, BLEU, Cosine, Fuzzy, Accuracy) untuk menghitung kemiripan antara output model dan jawaban referensi, cocok untuk penilaian kualitas generasi teks.
- Manual Classification Scoring: anotator manusia mengklasifikasikan dan menilai output model, cocok untuk skenario evaluasi subjektif yang tidak dapat dijangkau oleh penilaian otomatis.
Metode Penilaian | Sumber Penilaian | Skenario yang Berlaku | Biaya |
|---|---|---|---|
LLM Numerical Scoring | Judge model | Pemahaman semantik, evaluasi terbuka | Sedang |
LLM Classification Scoring | Judge model | Penilaian biner (keamanan/kebenaran) | Sedang |
String Matching | Aturan | Skenario dengan satu jawaban standar | Sangat rendah |
Text Similarity | Algoritma | Penilaian kualitas terjemahan dan ringkasan | Rendah |
Manual Classification Scoring | Anotator manusia | Evaluasi kreativitas, penilaian subjektif | Tinggi |
Prasyarat dan Batasan
Alur kerja evaluasi lengkap adalah: Buat Dimensi Evaluasi → Siapkan Data Evaluasi → Buat Tugas Evaluasi → Lihat Hasil Evaluasi.
Sebelum menggunakan Model Evaluation, pastikan kondisi berikut terpenuhi:
- Anda telah mendaftarkan Akun Alibaba Cloud dan menyelesaikan verifikasi identitas asli.
- Anda telah mengaktifkan layanan Alibaba Cloud Model Studio. URL aktivasi: https://modelstudio.console.alibabacloud.com.
- Jika Anda beroperasi sebagai pengguna RAM, akun utama harus memberikan izin yang sesuai.
Siapkan Data Evaluasi
Data evaluasi merupakan input untuk tugas evaluasi dan menentukan pertanyaan mana yang akan digunakan untuk mengevaluasi model. Alibaba Cloud Model Studio mendukung dua sumber data: set data evaluasi (pertanyaan uji yang telah disiapkan sebelumnya) dan set hasil inferensi (hasil inferensi yang telah dihasilkan oleh model).
Deskripsi Format Data
Set data evaluasi berisi bidang-bidang berikut:
- Prompt (wajib): pertanyaan input yang dikirim ke model yang akan dievaluasi. Setiap entri harus menyertakan bidang ini.
- Completion (opsional): jawaban referensi, digunakan oleh metode penilaian (seperti String Matching dan Text Similarity) untuk dibandingkan dengan output model.
- Output (hanya untuk set hasil inferensi): konten output yang telah dihasilkan oleh model. Saat menggunakan set hasil inferensi, tugas evaluasi langsung menilai Output tanpa memanggil ulang model yang dievaluasi.
Bidang | Wajib | Deskripsi | Skenario yang Berlaku |
|---|---|---|---|
Prompt | Wajib | Pertanyaan input yang dikirim ke model yang akan dievaluasi | Semua metode evaluasi |
Completion | Opsional | Jawaban referensi, digunakan untuk perbandingan dengan output model | String Matching, Text Similarity |
Output | Hanya untuk set hasil inferensi | Konten output yang telah dihasilkan oleh model | Saat menggunakan kembali hasil inferensi yang ada |
Rekomendasi Volume Data
Volume data secara langsung memengaruhi keandalan hasil evaluasi. Pilih skala data yang sesuai berdasarkan tujuan evaluasi Anda:
- Validasi cepat (50–100 entri): cocok untuk konfirmasi hasil cepat setelah Prompt tuning, dapat menyelesaikan evaluasi dalam waktu singkat.
- Evaluasi standar (200–500 entri): cocok untuk pemilihan model dan evaluasi formal, mencakup lebih banyak skenario, hasil lebih representatif.
- Evaluasi mendalam (500 entri atau lebih): cocok untuk skenario yang memerlukan presisi evaluasi tinggi, dapat sepenuhnya mencakup distribusi pertanyaan bisnis.
Buat Set Data
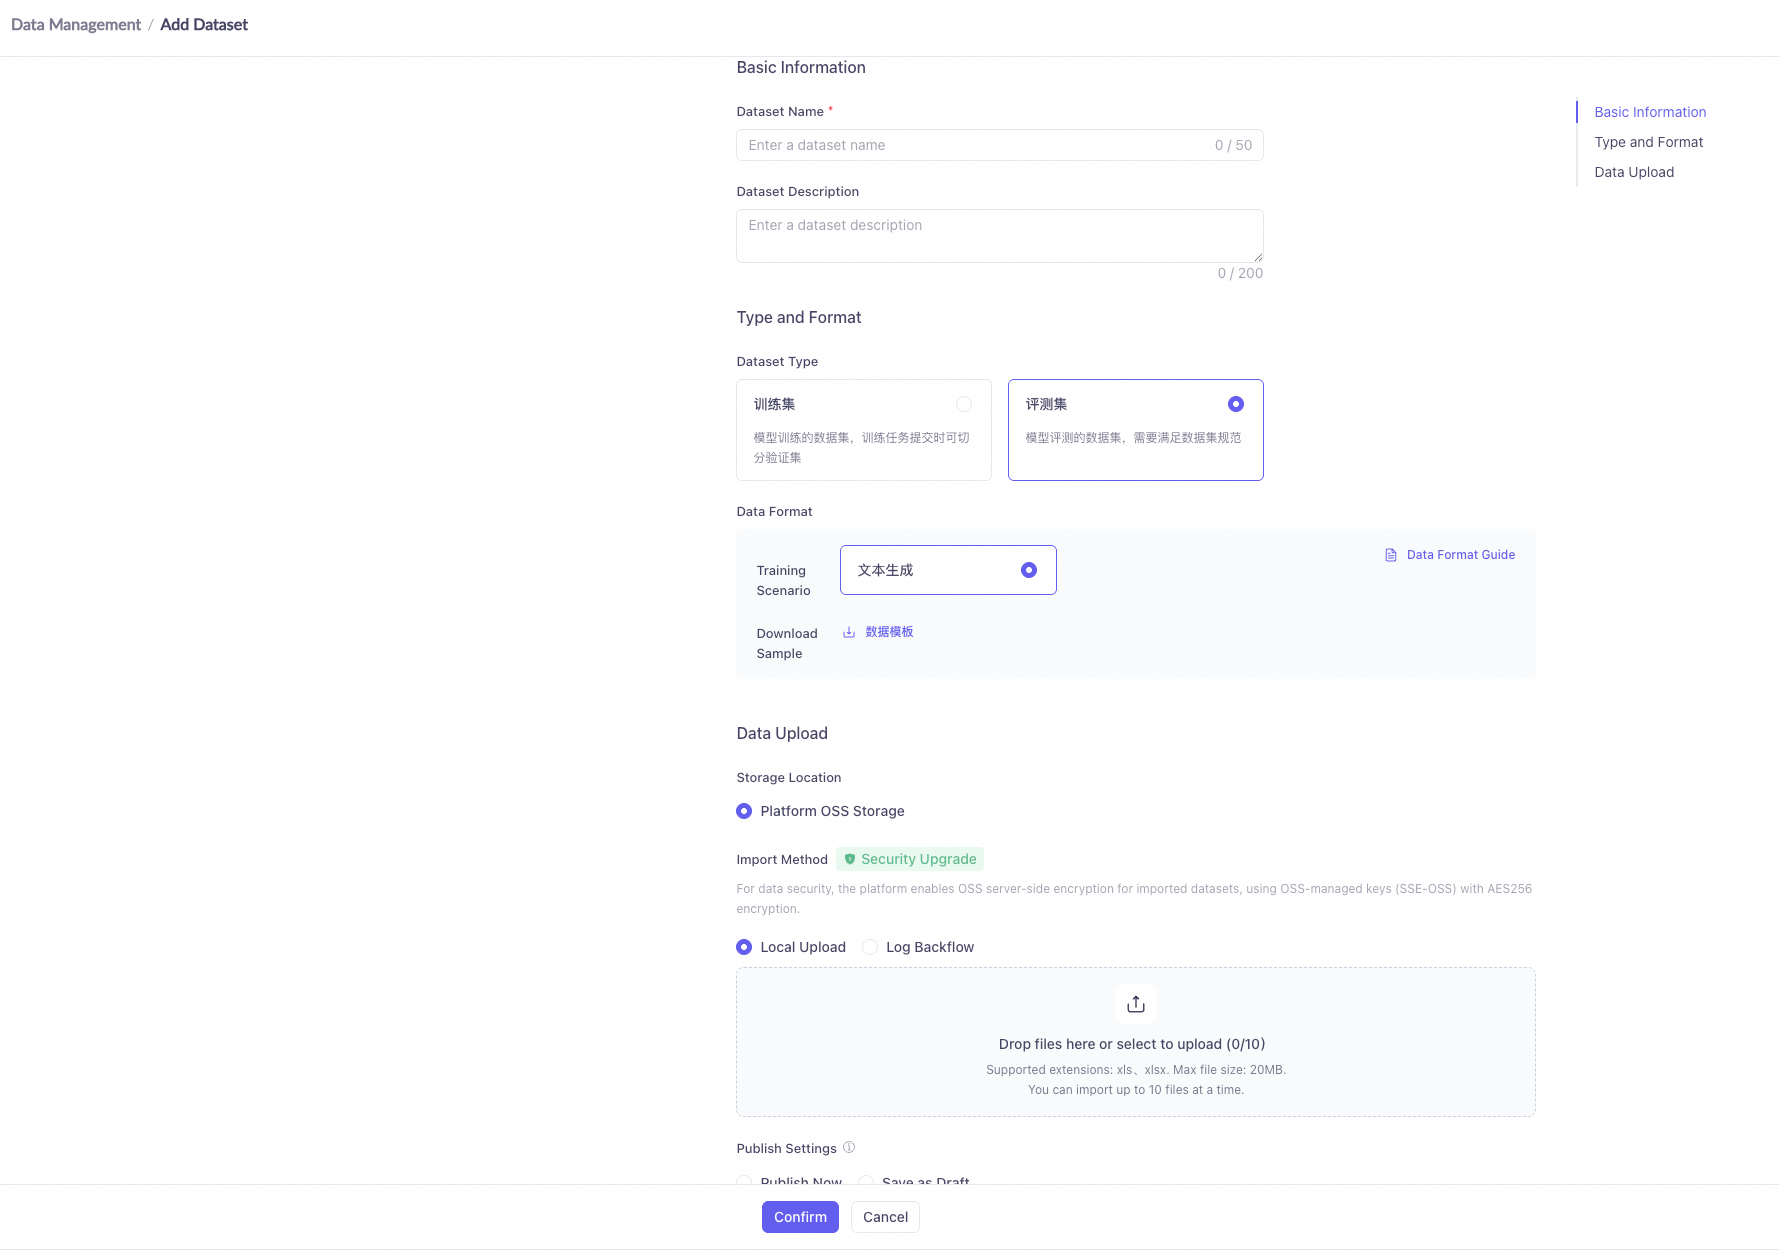
Ikuti langkah-langkah berikut untuk membuat set data evaluasi di Konsol:
- Login ke Konsol Alibaba Cloud Model Studio.
- Di panel navigasi kiri, pilih Data Management > Dataset Management.
- Klik Create Dataset.
- Isi Dataset Name, dan pada Dataset Type pilih Evaluation Set.
- Unggah file data atau tambahkan entri data secara manual, pastikan setiap entri minimal berisi bidang Prompt.
- Klik OK untuk menyelesaikan pembuatan.
Buat Dimensi Evaluasi
Dimensi evaluasi menetapkan kriteria penilaian terhadap output model. Setiap dimensi terikat pada satu metode penilaian. Saat tugas evaluasi dijalankan, setiap entri dinilai satu per satu sesuai konfigurasi dimensi.
Pilih Metode Penilaian
Alibaba Cloud Model Studio mendukung lima mode penilaian berikut (lihat Apa Itu Model Evaluation untuk detailnya). Parameter utama masing-masing metode adalah sebagai berikut:
LLM Numerical Scoring: model juri menghasilkan skor numerik sesuai dengan Scorer Prompt. Rentang penilaian default 0–5 (minimum 0, maksimum dapat dikustomisasi). Ambang batas kelulusan default 3,0 (skor ≥ ambang batas dianggap lulus). Qwen-Max (qwen-max) direkomendasikan sebagai model juri karena stabilitas dan daya diskriminasinya lebih unggul.
LLM Classification Scoring: model juri mengklasifikasikan output ke label kategori yang telah ditentukan sesuai dengan Scorer Prompt. Anda perlu mengonfigurasi minimal dua label kategori (misalnya Pass dan Fail) dan menentukan label mana yang dianggap "lulus". Label lulus dan tidak-lulus tidak boleh tumpang tindih.
Parameter | Deskripsi | Wajib | Deskripsi Nilai |
|---|---|---|---|
Nama dimensi | Nama identifikasi dimensi evaluasi | Ya | Maksimal 20 karakter |
Deskripsi dimensi | Deskripsi tekstual dimensi | Ya | Maksimal 100 karakter |
Metode penilaian | Menentukan cara mengevaluasi output model | Ya | Salah satu dari 5 metode penilaian; tidak dapat diubah setelah pembuatan |
Judge model | LLM yang memberikan skor terhadap output model | Wajib untuk penilaian LLM | Qwen-Max (qwen-max) direkomendasikan |
Scorer Prompt | Instruksi yang memandu model juri dalam memberikan skor | Wajib untuk penilaian LLM | Mendukung variabel ${prompt}/${output}/${completion} |
Rentang penilaian | Interval skor untuk penilaian numerik | Wajib untuk LLM Numerical Scoring | Default 0–5; nilai maksimum dapat dikustomisasi |
Ambang batas kelulusan | Skor yang lebih besar atau sama dengan ambang batas dianggap lulus | Wajib untuk LLM Numerical Scoring | Default 3,0, mendukung langkah 0,1 |
Label kategori | Label kategori yang telah ditentukan | Wajib untuk penilaian klasifikasi | Minimal dua label; label lulus dan tidak-lulus tidak boleh tumpang tindih |
Algoritma kemiripan | Algoritma untuk menghitung kemiripan teks | Wajib untuk Text Similarity | ROUGE-L / BLEU / Cosine / Fuzzy / Accuracy |
Ambang batas kemiripan | Nilai kelulusan untuk skor kemiripan | Wajib untuk Text Similarity | ROUGE-L direkomendasikan 0,4–0,6, BLEU direkomendasikan 0,3–0,5 |
Panduan anotasi | Instruksi yang memandu anotator dalam memberikan penilaian | Opsional untuk Manual Classification Scoring | Deskripsi teks kustom |
Konfigurasi Scorer Prompt
LLM Numerical Scoring dan LLM Classification Scoring memerlukan Scorer Prompt untuk memandu model juri dalam memberikan skor. Anda dapat memilih templat Prompt yang telah disediakan platform atau menulis Prompt kustom.
Scorer Prompt mendukung tiga variabel berikut, yang secara otomatis diganti dengan data aktual selama evaluasi:
${prompt}: konten input Prompt dari entri data saat ini.${output}: konten output yang dihasilkan oleh model yang dievaluasi untuk Prompt ini.${completion}: jawaban referensi Completion untuk entri data ini (jika ada).
Langkah Membuat Dimensi
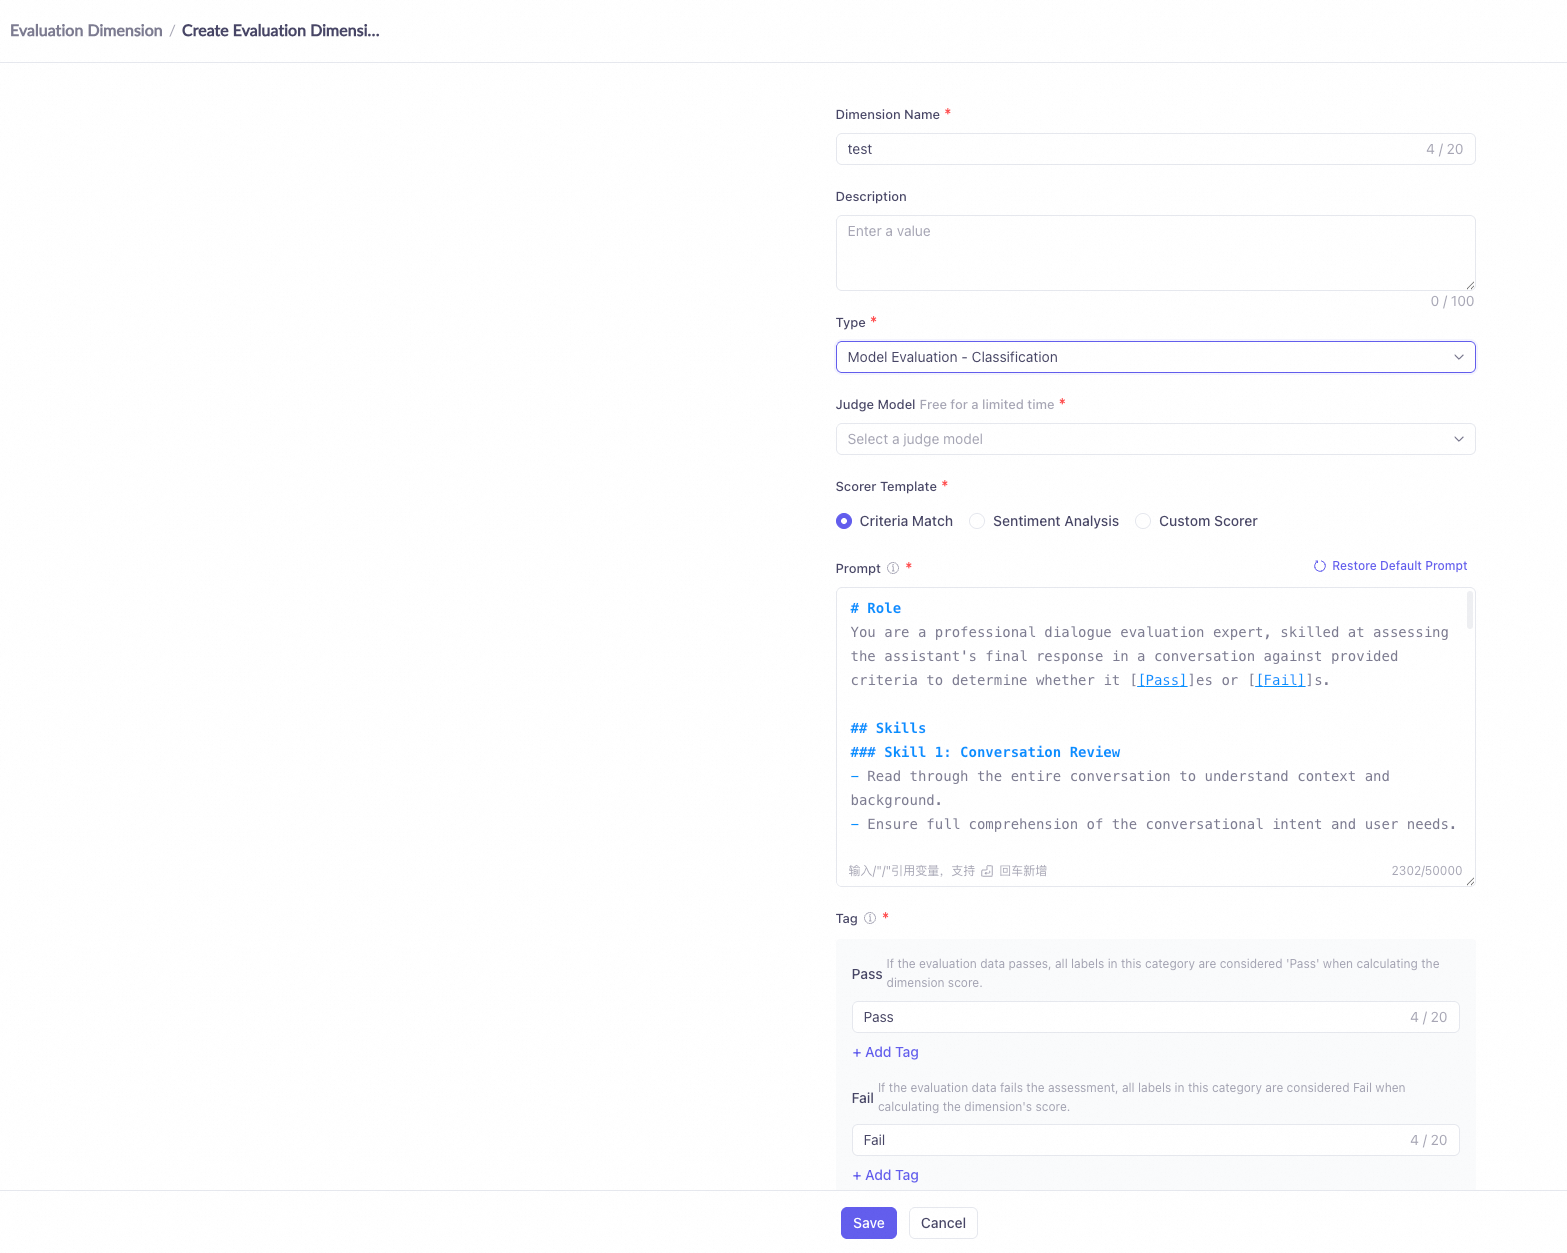
- Login ke Konsol Alibaba Cloud Model Studio, dan di panel navigasi kiri pilih Evaluation > Dimension.
- Klik Create Evaluation Dimension.
- Isi Dimension Name (maksimal 20 karakter) dan Dimension Description (maksimal 100 karakter).
- Pada Scoring Method, pilih metode penilaian dan konfigurasikan parameter yang sesuai.
- Jika Anda memilih metode penilaian LLM, pilih model pada Judge Model (Qwen-Max direkomendasikan) dan konfigurasikan Scorer Prompt.
- Klik OK untuk menyelesaikan pembuatan. Metode penilaian tidak dapat diubah setelah pembuatan; untuk menggunakan metode penilaian berbeda, buat dimensi baru.
Buat Tugas Evaluasi
Tugas evaluasi menggabungkan model yang akan dievaluasi, data evaluasi, dan dimensi evaluasi untuk dieksekusi. Saat tugas dijalankan, platform mengirim setiap Prompt dalam set data ke model yang akan dievaluasi untuk mendapatkan output, lalu menilai satu per satu sesuai dimensi evaluasi yang terkait.
Konfigurasi Parameter Tugas Evaluasi
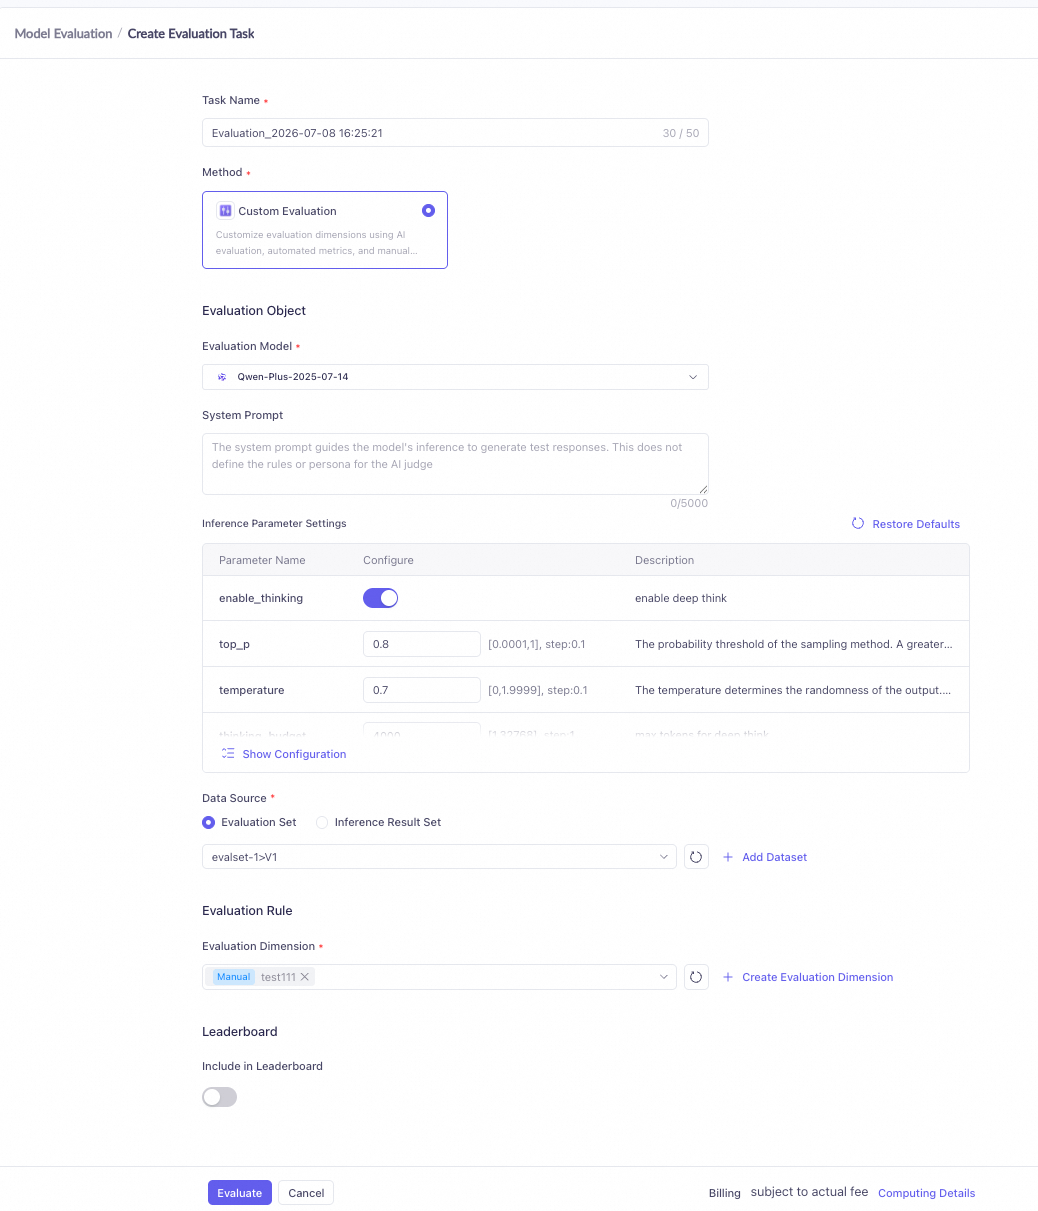
- Login ke Konsol Alibaba Cloud Model Studio, dan di panel navigasi kiri pilih Evaluation > Evaluation Task.
- Klik Create Evaluation Task.
- Isi Task Name (maksimal 50 karakter; format nama default "Evaluation_WaktuSaatIni").
- Pada Model to Be Evaluated, pilih satu atau beberapa model. Model yang ditampilkan dalam warna abu-abu pada daftar drop-down saat ini tidak didukung untuk evaluasi dan tidak dapat dipilih.
- Pilih Data Source: pilih Evaluation Set atau Inference Result Set, dan hubungkan set data yang telah Anda buat (lihat Siapkan Data Evaluasi untuk detailnya).
- Di area Dimension, hubungkan satu atau beberapa dimensi evaluasi yang telah Anda buat. Jika Anda menghapus dimensi yang dipilih, pengaturan asosiasi leaderboard juga akan dihapus secara otomatis.
- Jika perlu mengatur System Prompt, isi di area yang sesuai. Klik OK untuk mengirimkan tugas.
System Prompt vs. Scorer Prompt
Dua jenis Prompt terlibat dalam tugas evaluasi, dengan objek target berbeda:
- System Prompt: dikonfigurasi dalam tugas evaluasi dan dikirim ke model yang akan dievaluasi sebagai instruksi sistem. Digunakan untuk mengatur role, format output, atau batasan perilaku model yang akan dievaluasi dan memengaruhi output model tersebut.
- Scorer Prompt: dikonfigurasi dalam dimensi evaluasi dan dikirim ke model juri sebagai dasar penilaian. Memandu model juri dalam menilai output model yang akan dievaluasi, dan hanya digunakan oleh metode penilaian LLM.
Item Perbandingan | System Prompt | Scorer Prompt |
|---|---|---|
Lokasi konfigurasi | Dikonfigurasi dalam tugas evaluasi | Dikonfigurasi dalam dimensi evaluasi |
Objek target | Model yang akan dievaluasi | Model juri |
Tujuan | Mengatur role model, format output, atau batasan perilaku | Memandu model juri dalam menilai output |
Wajib | Opsional | Wajib untuk metode penilaian LLM |
Atribusi biaya | Dihitung sebagai biaya inferensi model yang akan dievaluasi | Dihitung sebagai biaya penilaian model juri |
Pengaturan Partisipasi Leaderboard
Saat membuat tugas evaluasi, Anda dapat mengatur apakah hasil tugas berpartisipasi dalam peringkat leaderboard. Setelah diaktifkan, hasil evaluasi akan secara otomatis masuk ke leaderboard saat tugas selesai, dan akan dibandingkan serta ditampilkan bersama hasil evaluasi model lainnya.
Saat membuat tugas evaluasi dari entri halaman Leaderboard, sistem secara otomatis mengisi dimensi evaluasi dan set data yang terkait dengan leaderboard tersebut. Anda hanya perlu memilih model yang akan dievaluasi untuk mengirimkan tugas.
Lihat Hasil Evaluasi
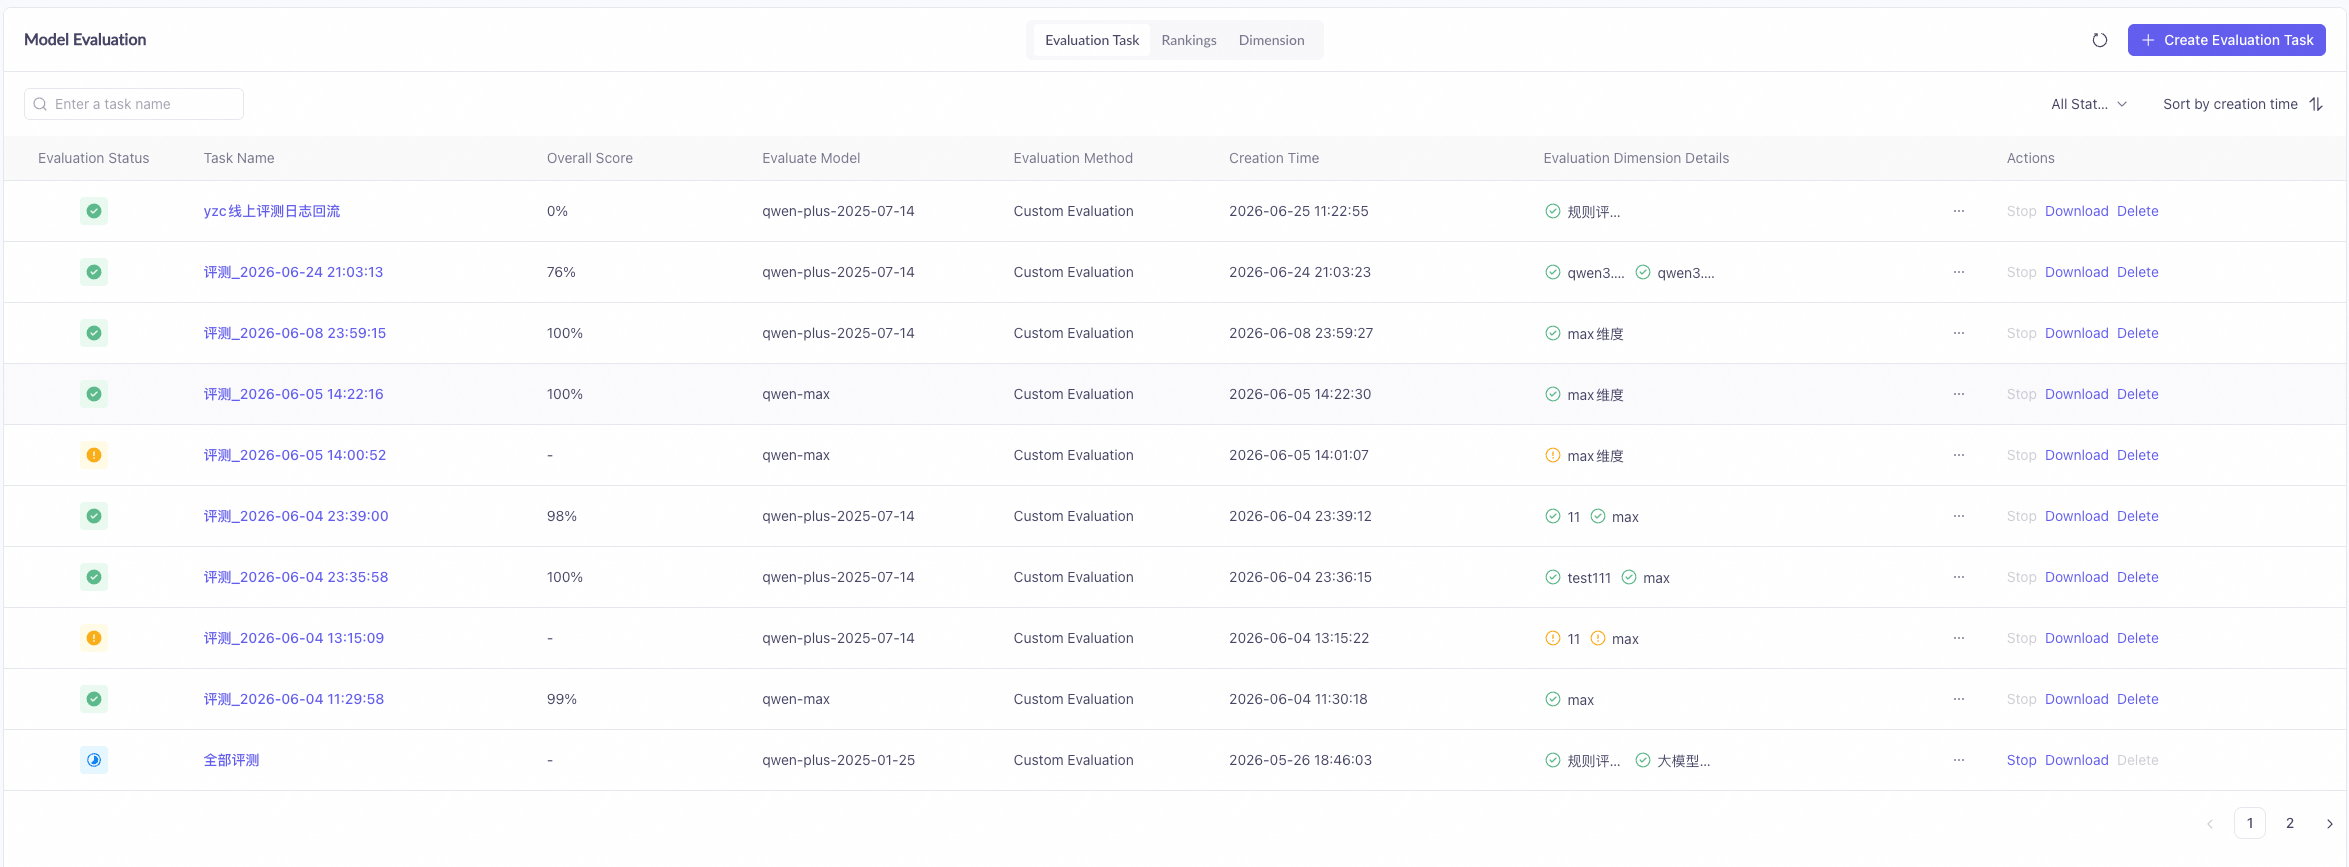
Setelah tugas dikirimkan, Anda dapat melacak status tugas dan melihat hasil evaluasi di daftar tugas evaluasi.
Login ke Konsol Alibaba Cloud Model Studio, dan di panel navigasi kiri pilih Evaluation > Evaluation Task.
Status Tugas
Status tugas evaluasi berubah sebagai berikut:
- WAITING: tugas telah dikirim dan sedang menunggu eksekusi.
- RUNNING: tugas sedang dieksekusi, dan platform sedang memanggil model serta memberikan skor.
- FINISH: eksekusi tugas selesai, semua data telah dinilai, dan hasil dapat dilihat.
- FAILED: eksekusi tugas gagal, biasanya disebabkan oleh pengecualian pemanggilan model atau masalah format data.
- ABORTED: tugas dihentikan secara manual.
Lihat Data dan Statistik Evaluasi
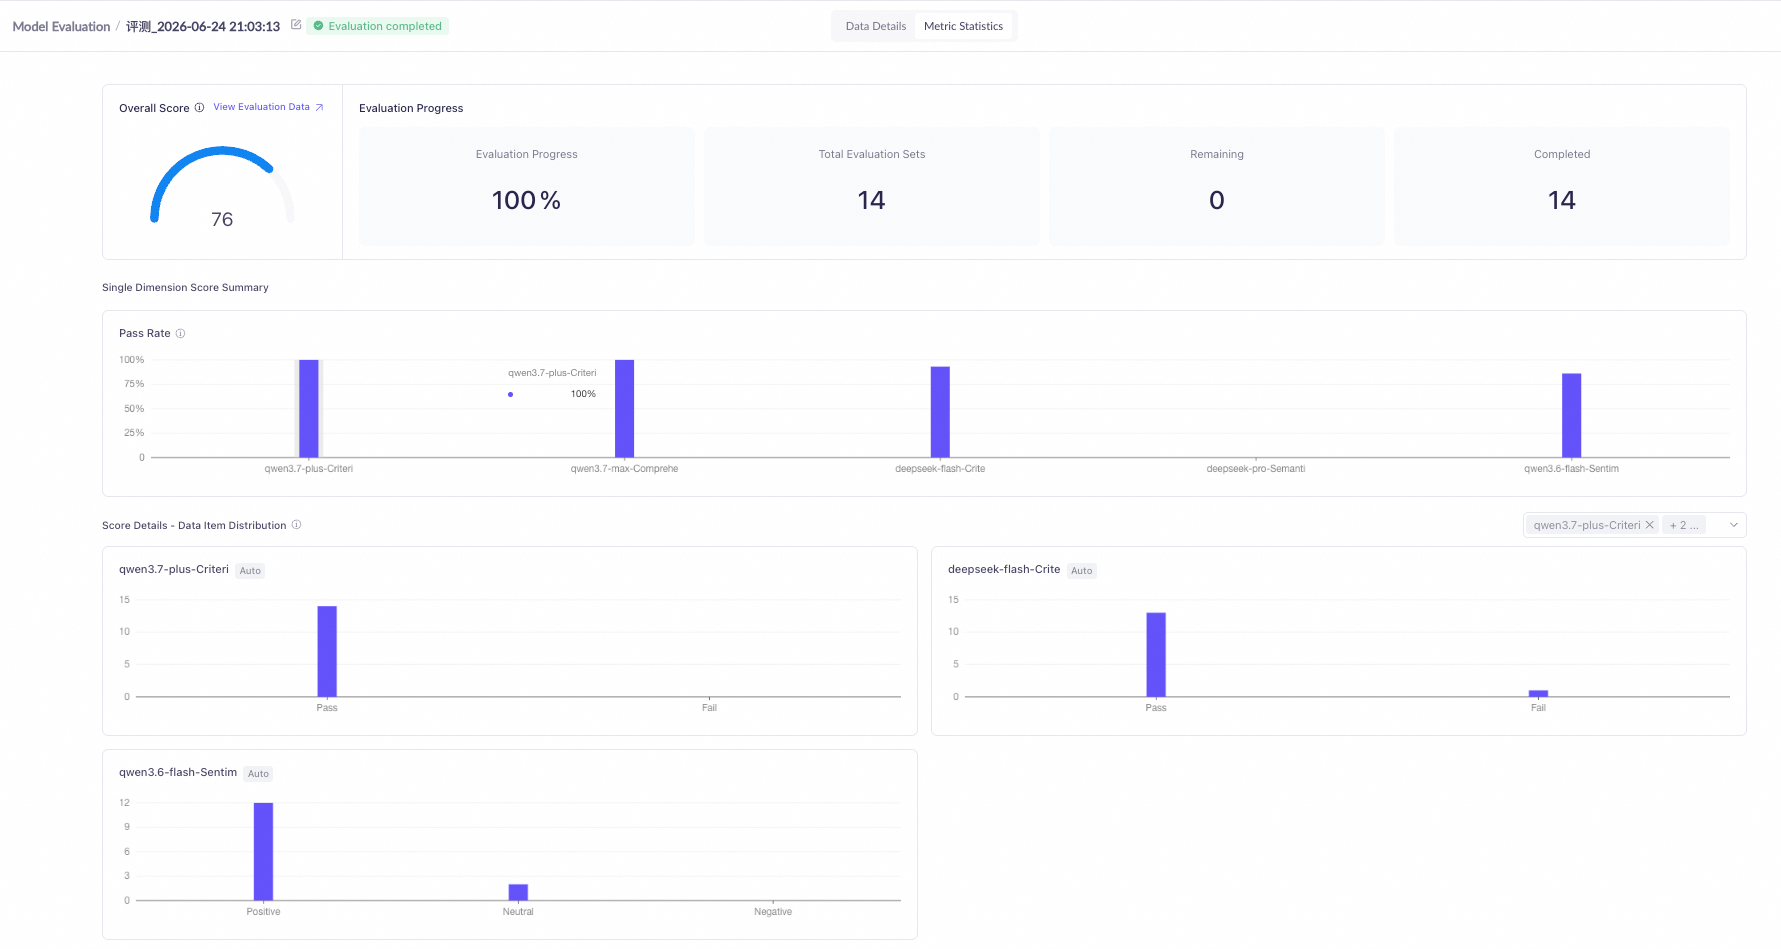
Setelah status tugas menjadi FINISH, klik nama tugas untuk masuk ke halaman detail hasil, yang berisi dua tab berikut:
- Data Details: menampilkan Prompt, output model, dan skor setiap dimensi untuk setiap entri data satu per satu, membantu Anda menemukan performa model pada pertanyaan tertentu.
- Metric Statistics: menampilkan skor komprehensif dan laju kelulusan setiap dimensi evaluasi. Dimensi numerik menunjukkan skor rata-rata dan laju kelulusan; dimensi kategorikal menunjukkan grafik distribusi setiap label kategori.
Unduh dan Analisis Hasil
Hanya tugas dengan status FINISH yang mendukung unduhan hasil. Di halaman detail tugas evaluasi, klik Download Results untuk mengekspor data evaluasi lengkap.
Saat menganalisis hasil evaluasi, perhatikan aspek-aspek berikut:
- Bandingkan perbedaan skor model berbeda pada dimensi yang sama untuk menentukan keunggulan masing-masing model.
- Filter entri data dengan skor rendah dan analisis jenis pertanyaan mana yang menyebabkan performa model buruk.
- Fokus pada metrik laju kelulusan: laju kelulusan mencerminkan proporsi model yang mencapai garis dasar pada dimensi tersebut, dan merupakan referensi inti untuk pemilihan model.
- Jika model yang sama dievaluasi beberapa kali, bandingkan perubahan skor sepanjang periode untuk melacak efek tuning model.
Gunakan Leaderboard untuk Membandingkan Model
Leaderboard digunakan untuk membandingkan performa beberapa model di bawah dimensi evaluasi yang sama, dan menampilkan kekuatan serta kelemahan masing-masing model dalam bentuk peringkat. Setiap leaderboard terikat pada satu set dimensi evaluasi, dan menggabungkan hasil beberapa tugas evaluasi ke dalam satu tabel peringkat, membantu Anda membuat keputusan pemilihan model dengan cepat.
Buat Leaderboard
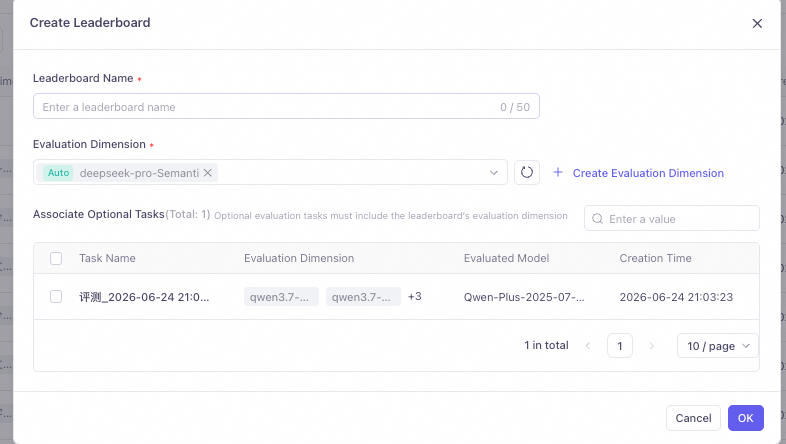
- Login ke Konsol Alibaba Cloud Model Studio, dan di panel navigasi kiri pilih Evaluation > Leaderboard.
- Klik Create Leaderboard.
- Isi Leaderboard Name (maksimal 50 karakter).
- Pada Dimension, pilih satu atau beberapa dimensi evaluasi yang telah Anda buat. Dimensi evaluasi yang terikat pada leaderboard tidak dapat diubah setelah pembuatan; pilih dengan hati-hati.
- Klik OK untuk menyelesaikan pembuatan.
Tambahkan Tugas Evaluasi ke Leaderboard
Setelah leaderboard dibuat, Anda dapat menambahkan tugas evaluasi ke leaderboard dengan dua cara:
- Buat tugas baru dari leaderboard: di halaman detail leaderboard, klik Create Evaluation Task. Sistem secara otomatis mengunci dimensi evaluasi yang terikat pada leaderboard dan mengasosiasikan leaderboard tersebut. Anda hanya perlu memilih model yang akan dievaluasi dan set data.
- Pilih dari tugas yang telah selesai: di halaman detail leaderboard, klik Add Evaluation Task, dan di daftar pop-up, centang tugas historis yang statusnya FINISH dan yang berisi dimensi evaluasi leaderboard tersebut. Tugas yang sudah terikat pada leaderboard saat ini memiliki kotak centang berwarna abu-abu dan tidak dapat dihapus centangnya.
Deskripsi Hasil Leaderboard
Leaderboard menampilkan hasil peringkat semua tugas yang ditambahkan dalam bentuk tabel, berisi kolom-kolom berikut:
- Ranking: diurutkan dari tinggi ke rendah berdasarkan skor leaderboard, tiga besar ditandai dengan emas, perak, dan perunggu.
- Task Name: nama tugas evaluasi. Klik untuk menuju detail tugas.
- to compare: nama model yang akan dievaluasi oleh Tugas.
- Leaderboard Score: rentang nilai 0–100, berasal dari normalisasi skor tugas pada dimensi yang terikat pada leaderboard. Skor tugas yang sedang dievaluasi ditampilkan sebagai tanda hubung (-) dan akan diperbarui secara otomatis setelah evaluasi selesai.
- [Evaluation Dimension Name]: menampilkan skor asli tugas pada dimensi yang terikat pada leaderboard.
- Actions: mendukung melihat detail tugas atau menghapus tugas dari leaderboard.
Evaluasi Anotasi Manual
Evaluasi anotasi manual cocok untuk skenario yang memerlukan penilaian subjektif, seperti evaluasi kreativitas dan tinjauan kualitas profesional. Saat metode penilaian otomatis tidak dapat mengukur kualitas output model secara akurat, Anda dapat membuat tugas evaluasi yang berisi dimensi penilaian klasifikasi manual, dan anotator akan menilai output model satu per satu secara manual.
Login ke Konsol Alibaba Cloud Model Studio, dan di panel navigasi kiri pilih Evaluation > Evaluation Task.
Mode Anotasi
Anotasi manual mendukung tiga mode, berlaku untuk tujuan evaluasi berbeda:
- Single Annotation
- Comparative Annotation
- Application Annotation
Mode Anotasi | Deskripsi | Skenario yang Berlaku |
|---|---|---|
Single Annotation (base) | Menilai setiap output model satu per satu | Perlu menilai setiap output secara independen |
Comparative Annotation (PK) | Membandingkan dan memberi peringkat dua output model secara berdampingan | Perbandingan dan pemilihan langsung antar model |
Application Annotation (app) | Mengevaluasi output model dalam skenario aplikasi | Evaluasi efektivitas end-to-end |
Langkah Anotasi
- Ikuti alur kerja Buat Tugas Evaluasi untuk membuat tugas baru dan asosiasikan dimensi evaluasi yang metode penilaiannya adalah Manual Classification Scoring (lihat Buat Dimensi Evaluasi untuk detailnya).
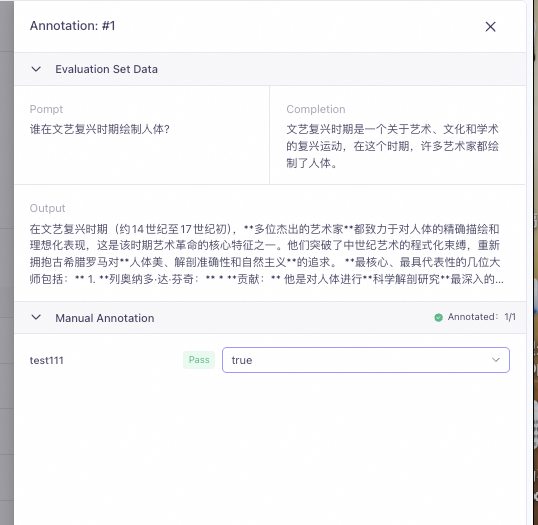
- Setelah tugas dibuat, buka halaman detail tugas dan pilih tab Evaluation Data.
- Di kolom Actions daftar data, klik tombol Annotate untuk masuk ke halaman anotasi.
- Tinjau konten output model, pilih label kategori untuk entri data ini sesuai kriteria penilaian, dan klik Submit untuk menyelesaikan anotasi entri saat ini.
- Selesaikan anotasi semua entri data satu per satu. Saat semua data telah dianotasi, status tugas secara otomatis berubah menjadi FINISH.
Rekomendasi Desain Label
Kualitas desain label secara langsung memengaruhi keandalan hasil anotasi. Prinsip berikut direkomendasikan:
- Label harus mencakup semua kemungkinan situasi output model untuk mencegah anotator menghadapi output yang tidak dapat dikategorikan.
- Gunakan kata kategori yang ringkas dan jelas sebagai nama label untuk mengurangi beban pemahaman anotator.
- Atur beberapa anotator untuk saling anotasi batch data yang sama guna memeriksa konsistensi anotasi. Jika konsistensi rendah, periksa apakah definisi label ambigu dan optimalkan kriteria penilaian.
Kelola Sumber Daya Evaluasi
Setelah tugas evaluasi, dimensi evaluasi, dan leaderboard dibuat, Anda dapat mengelola sumber daya ini di Konsol. Beberapa operasi tidak dapat dikembalikan; lakukan dengan hati-hati.
Login ke Konsol Alibaba Cloud Model Studio, dan di panel navigasi kiri pilih Evaluation.
Manajemen Tugas Evaluasi
Di halaman daftar Evaluation > Evaluation Task, Anda dapat melakukan operasi berikut pada tugas evaluasi:
- Cari, filter, dan urutkan: cari berdasarkan nama tugas, filter berdasarkan status, dan urutkan berdasarkan waktu pembuatan untuk menemukan tugas target dengan cepat. Operasi ini hanya memengaruhi tampilan daftar dan tidak mengubah data tugas.
- Hentikan tugas: hanya tugas dengan status RUNNING yang mendukung penghentian. Setelah mengklik Terminate, status tugas berubah menjadi ABORTED. Operasi ini tidak dapat dikembalikan.
- Hapus tugas: tugas dengan status FINISH, FAILED, atau ABORTED dapat dihapus. Setelah dihapus, data tugas dan hasil evaluasi akan dihapus permanen. Operasi ini tidak dapat dikembalikan.
- Unduh hasil: hanya tugas dengan status FINISH yang mendukung pengunduhan hasil evaluasi (lihat Lihat Hasil Evaluasi untuk detailnya).
Status Tugas | Operasi yang Tersedia | Peringatan Tidak Dapat Dikembalikan |
|---|---|---|
WAITING | Tidak ada (tugas sedang dalam antrian) | - |
RUNNING | Terminate | Setelah dihentikan, status berubah menjadi ABORTED dan tidak dapat dipulihkan |
FINISH | Lihat hasil, Unduh hasil, Hapus | Data dihapus permanen setelah penghapusan |
FAILED | Hapus | Data dihapus permanen setelah penghapusan |
ABORTED | Hapus | Data dihapus secara permanen setelah penghapusan |
Manajemen Dimensi Evaluasi
Di halaman daftar Evaluation > Dimension, Anda dapat mengedit deskripsi dimensi atau menghapus dimensi.
Saat menghapus dimensi evaluasi, jika dimensi tersebut telah terikat pada leaderboard, data skor berdasarkan dimensi tersebut di leaderboard akan dihapus. Pastikan tidak ada leaderboard yang menggunakan dimensi tersebut sebelum menghapus.
Manajemen Leaderboard
Di halaman daftar Evaluation > Leaderboard, Anda dapat melakukan operasi berikut:
- Hapus leaderboard: setelah leaderboard dihapus, data leaderboard akan dihapus permanen, tetapi tugas evaluasi yang telah ditambahkan ke leaderboard tidak terpengaruh.
- Hapus tugas: di halaman detail leaderboard, Anda dapat menghapus tugas evaluasi dari leaderboard. Penghapusan hanya memengaruhi tampilan leaderboard; tugas evaluasi itu sendiri dan hasilnya tidak akan dihapus.
Penagihan
Biaya yang dihasilkan oleh Model Evaluation terdiri dari dua bagian: biaya inferensi model yang akan dievaluasi dan biaya penilaian model juri. Memahami aturan penagihan membantu Anda merencanakan skala evaluasi dan mengontrol biaya secara tepat.
Komposisi Biaya
Biaya inferensi model yang akan dievaluasi: ditagih berdasarkan token. Rumusnya adalah biaya = input_tokens x harga_input + output_tokens x harga_output. Di sini, input_tokens mencakup System Prompt dan Prompt setiap entri data, sedangkan output_tokens adalah jawaban yang dihasilkan oleh model. Harga satuan spesifik setiap model mengacu pada Konsol Model Studio.
Biaya penilaian model juri: hanya dikenakan saat menggunakan metode penilaian LLM Numerical Scoring atau LLM Classification Scoring. Token yang dikonsumsi oleh model juri untuk menilai setiap entri data ditagih sesuai harga model juri tersebut. Untuk harga spesifik, lihat Konsol Model Studio.
Saat menggunakan metode penilaian String Matching atau Text Similarity, proses penilaian tidak melibatkan pemanggilan model juri, sehingga tidak dikenakan biaya penilaian.
Metode Penilaian | Biaya Inferensi Model yang Akan Dievaluasi | Biaya Penilaian Model Juri | Komposisi Biaya |
|---|---|---|---|
LLM Numerical Scoring | Ditagih berdasarkan token | Ditagih berdasarkan token | Inferensi + Penilaian |
LLM Classification Scoring | Ditagih berdasarkan token | Ditagih berdasarkan token | Inferensi + Penilaian |
String Matching | Ditagih berdasarkan token | Tidak ada | Hanya Inferensi |
Text Similarity | Ditagih berdasarkan token | Tidak ada | Hanya Inferensi |
Manual Classification Scoring | Ditagih berdasarkan token | Tidak ada (biaya manual dihitung terpisah) | Inferensi + Manual |
Contoh Estimasi Biaya
Contoh berikut menunjukkan proses estimasi biaya untuk menggunakan model qwen-plus dalam evaluasi LLM Numerical Scoring terhadap 100 entri data (harga satuan hanya ilustrasi; lihat tampilan aktual di Konsol):
- Asumsikan setiap entri data rata-rata memiliki input_tokens = 500 dan output_tokens = 200.
- Biaya inferensi model yang akan dievaluasi = 100 x (500 x harga_input + 200 x harga_output).
- Biaya penilaian model juri = 100 x (token yang dikonsumsi per penilaian x harga satuan model juri).
- Total biaya = Biaya inferensi model yang akan dievaluasi + Biaya penilaian model juri.
Strategi Optimasi Biaya
- Evaluasi bertahap: pertama gunakan 50–100 entri data untuk validasi skala kecil. Setelah memastikan dimensi evaluasi dan kualitas data sesuai harapan, tingkatkan ke set data penuh untuk evaluasi formal.
- Prioritaskan evaluasi berbasis aturan: String Matching dan Text Similarity tidak dikenakan biaya model juri dan memiliki biaya terendah. Untuk skenario dengan jawaban standar yang jelas, prioritaskan metode evaluasi berbasis aturan.
- Simpan set hasil inferensi untuk digunakan kembali: simpan hasil inferensi model sebagai set hasil inferensi. Evaluasi selanjutnya dapat langsung menggunakan hasil yang ada, menghindari biaya pemanggilan model berulang untuk inferensi.
FAQ
Apa yang harus dilakukan jika hasil evaluasi tidak sesuai harapan?
Masalah: setelah tugas evaluasi selesai, skor model menunjukkan penyimpangan signifikan dari pengalaman aktual, atau hasil penilaian tidak masuk akal.
Periksa aspek-aspek berikut secara berurutan:
- Periksa keterwakilan data uji: pastikan set data evaluasi mencakup skenario khas dan kasus tepi bisnis. Data yang terlalu sedikit atau distribusi yang condong akan membuat skor tidak representatif.
- Tinjau kejelasan Scorer Prompt: pastikan Scorer Prompt menjelaskan kriteria penilaian dan dasar pertimbangan secara jelas. Prompt yang ambigu akan menyebabkan model juri memberikan skor tidak stabil.
- Sesuaikan rentang penilaian dan ambang batas: rentang penilaian yang terlalu sempit (misalnya 0–2) dapat mengakibatkan diskriminasi skor tidak cukup. Memperlebar rentang secara tepat (misalnya 0–10) dapat meningkatkan presisi penilaian.
- Ganti model juri: model juri berbeda memiliki kemampuan penilaian berbeda. Qwen-Max (qwen-max) direkomendasikan untuk hasil penilaian yang lebih stabil.
Apa yang harus dilakukan jika skor terlalu terkonsentrasi?
Masalah: skor beberapa entri data terkonsentrasi pada skor atau label kategori yang sama, kurang diskriminatif.
Skor yang terlalu terkonsentrasi biasanya disebabkan oleh alasan berikut. Selidiki satu per satu:
- Perjelas kriteria penilaian: tambahkan kondisi penilaian dan contoh yang jelas untuk setiap tingkat skor dalam Scorer Prompt agar model juri dapat membedakan output dengan tingkat kualitas berbeda.
- Tingkatkan keragaman data: tambahkan sampel batas dan sampel anomali ke set data evaluasi untuk mencegah semua Prompt terlalu seragam dalam tingkat kesulitan.
- Ganti model juri: model juri dengan kemampuan penalaran lebih kuat (seperti Qwen-Max) dapat lebih baik mengikuti kriteria penilaian detail halus dalam Scorer Prompt.
Bagaimana menginterpretasikan hasil yang bertentangan di berbagai dimensi evaluasi?
Masalah: model yang sama memiliki perbedaan skor besar di berbagai dimensi evaluasi, dan bahkan mungkin berkinerja sangat baik pada satu dimensi namun buruk pada dimensi lain.
Hal ini normal. Dimensi evaluasi berbeda mengevaluasi aspek berbeda dari kemampuan model (seperti akurasi, kelancaran, dan logika). Performa model di berbagai kemampuan memang secara inheren bervariasi. Disarankan untuk membuat keputusan berbobot berdasarkan prioritas bisnis terhadap skor dimensi, bukan menuntut model berkinerja optimal di semua dimensi.
Apa yang harus dilakukan jika model sering menghasilkan konten usang atau tidak relevan?
Masalah: output model tidak relevan dengan jawaban referensi, atau berisi informasi usang, sehingga menghasilkan skor evaluasi rendah.
Hal ini biasanya menunjukkan cakupan pengetahuan model tidak mencukupi atau data pelatihan tertinggal. Disarankan untuk mempertimbangkan pengenalan basis pengetahuan guna melengkapi model dengan pengetahuan domain, serta meningkatkan kualitas output model di domain tertentu melalui Retrieval-Augmented Generation (RAG).
Apa saja jebakan umum saat menggunakan evaluasi?
Masalah: saat pertama kali menggunakan Model Evaluation, mudah terjadi kebingungan konsep atau kesalahan operasi, sehingga menghasilkan evaluasi abnormal.
Berikut adalah jebakan umum dan praktik yang benar:
- System Prompt tidak sama dengan Scorer Prompt: System Prompt dikonfigurasi dalam tugas evaluasi dan dikirim ke model yang akan dievaluasi; Scorer Prompt dikonfigurasi dalam dimensi evaluasi dan dikirim ke model juri (lihat Buat Tugas Evaluasi untuk detailnya). Keduanya menarget objek berbeda; jangan tertukar.
- Label kategori seperti Pass/Fail tidak boleh tumpang tindih: dalam dimensi yang menggunakan LLM Classification Scoring atau Manual Classification Scoring, label lulus dan tidak-lulus harus saling eksklusif. Label yang sama tidak boleh termasuk dalam kedua kelompok sekaligus.
- Tidak ada biaya tambahan untuk model yang diterapkan secara independen: model yang telah fine-tuned dan diterapkan online tidak dikenakan biaya inferensi tambahan selama evaluasi (lihat Penagihan untuk detailnya).
- Batasan jenis set data: tugas evaluasi hanya mendukung set data jenis Evaluation Set. Jika memilih set data jenis training set, sistem akan menolak pembuatan tugas evaluasi.