

Qwen-OCR est un modèle de compréhension visuelle conçu pour extraire du texte et des données structurées à partir d'images : documents numérisés, tableaux, reçus, etc. Il prend en charge plusieurs langues et gère des tâches OCR avancées telles que l'extraction d'informations, l'analyse de tableaux, la reconnaissance de formules mathématiques et le traitement de documents.
Exemples
| Image d'entrée | Résultat de la reconnaissance |
|---|---|
Reconnaissance multilingue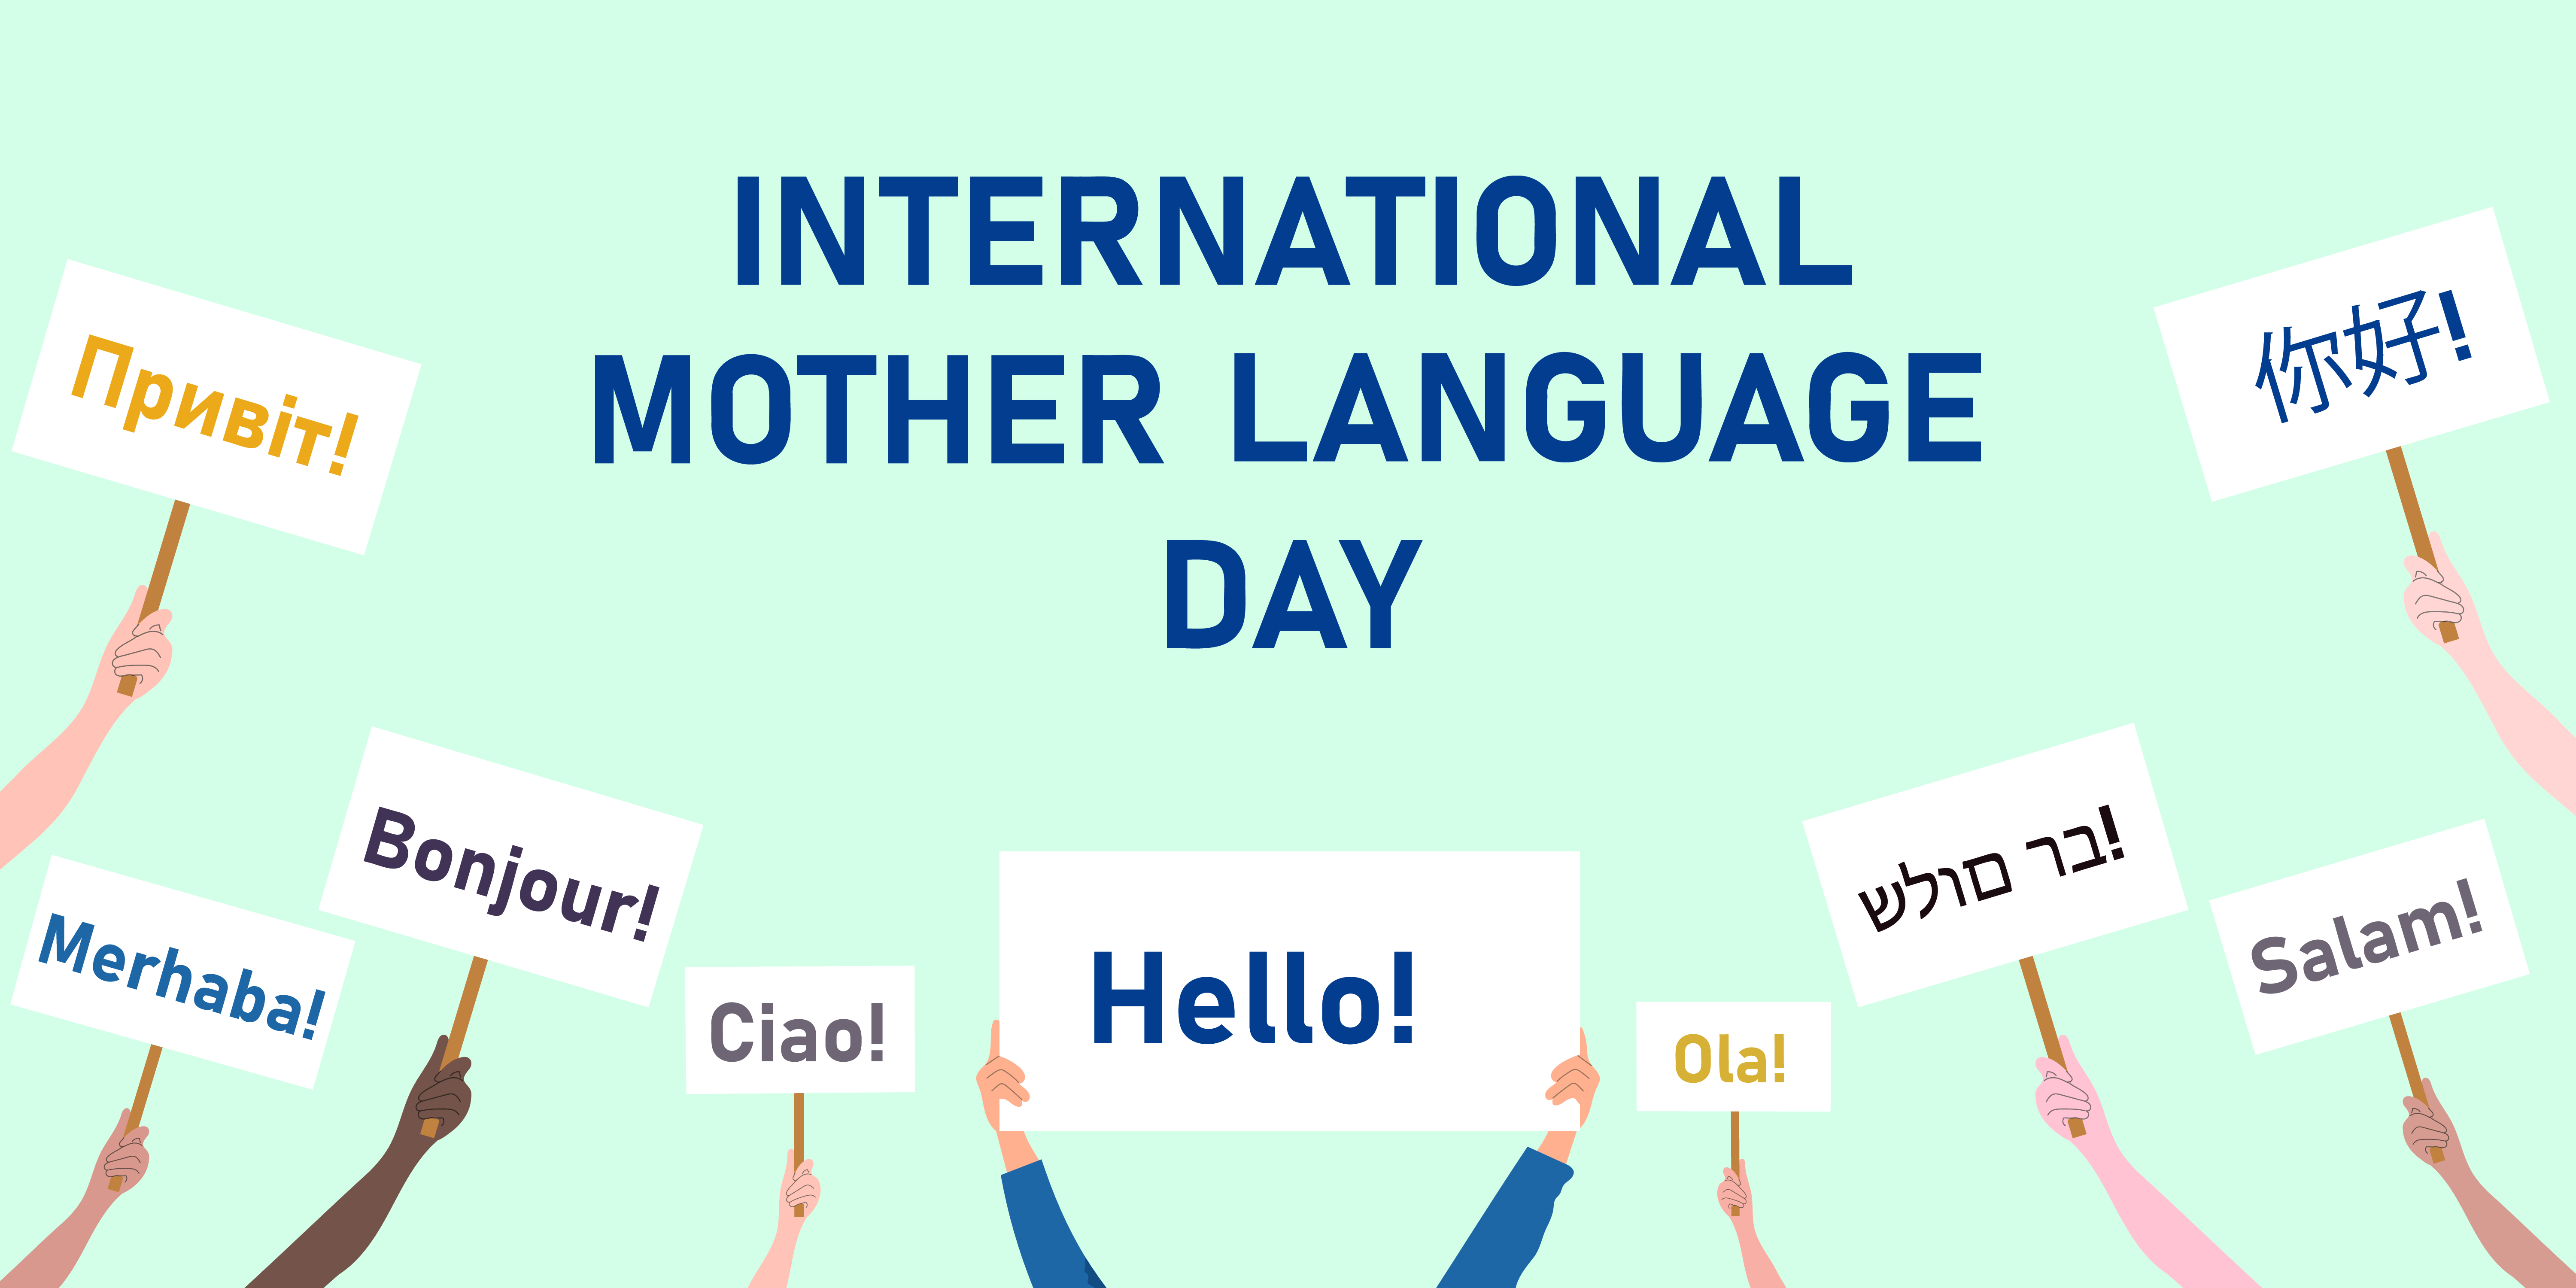 | INTERNATIONALMOTHER LANGUAGEDAYПривет!你好!Bonjour!Merhaba!Ciao!Hello!Ola!בר מולדSalam! |
Reconnaissance d'images inclinées | Product IntroductionImported fiber filaments from South Korea.6941990612023Item No.: 2023 |
Localisation du texte La tâche de reconnaissance haute précision permet la localisation du texte. | Visualisation de la localisation Consultez la FAQ pour savoir comment tracer le cadre englobant de chaque ligne de texte sur l'image originale. |
Sélection du modèle
Qwen-OCR propose les modèles suivants. Choisissez celui qui correspond le mieux à vos besoins métier :
- Qwen3.5-OCR : Fondé sur l'architecture Qwen3.5, ce modèle bénéficie d'améliorations majeures en matière d'analyse de documents, de localisation de texte et d'extraction d'informations clés. Il prend en charge les conversations multi-tours ainsi que l'analyse de documents PDF. L'extraction des données issues de documents officiels (cartes d'identité, permis de conduire, etc.) a été considérablement optimisée. Pour consulter la liste des types de documents pris en charge, reportez-vous à la section Types de certificats et de documents pris en charge. Ce modèle est disponible sous l'identifiant
qwen3.5-ocr. - Qwen-VL-OCR : Basé sur l'architecture Qwen3-VL. Il intègre nativement diverses fonctionnalités : analyse de documents, localisation de texte (reconnaissance haute précision), extraction d'informations, analyse de tableaux, reconnaissance de formules, reconnaissance de texte générique et reconnaissance multilingue. Il assure également la correction automatique de la rotation des images. Plusieurs versions sont disponibles :
qwen-vl-ocr(stable) (dernière version),qwen-vl-ocr-2025-11-20. - Versions antérieures (non recommandées) : Ces versions présentent des fonctionnalités et des performances inférieures aux modèles récents. Nous vous conseillons de migrer vers
qwen3.5-ocr. Cette catégorie inclut les modèlesqwen-vl-ocr-2024-10-28.
Pour les modèles qwen-vl-ocr, and la valeur par défaut du paramètre max_tokens` (longueur maximale de sortie) est fixée à 4096. Si vous souhaitez augmenter cette limite entre 4097 et 8192 tokens, contactez votre responsable commercial en précisant les informations suivantes : votre ID de compte Alibaba Cloud, le type d'images traitées (documents, e-commerce, contrats, etc.), le nom du modèle, le débit estimé en requêtes par seconde (QPS) ainsi que le volume quotidien total de requêtes, et enfin le pourcentage de requêtes dont la sortie dépasse 4096 tokens.
Expérience en ligne : Rendez-vous sur la console Model Studio, sélectionnez la région cible dans le coin supérieur droit, puis accédez à la section Vision Models pour tester les modèles Qwen-OCR.
Prérequis
- Créez une clé API et définissez-la comme variable d'environnement.
-
Si vous utilisez le SDK OpenAI ou le SDK DashScope, installez la dernière version du SDK. Versions minimales requises : DashScope Python SDK 1.22.2, Java SDK 2.21.8.
-
SDK DashScope
- Avantages : Accès complet aux fonctionnalités avancées (correction de rotation d'image, tâches OCR intégrées) via une API simple.
- Cas d'usage idéal : Projets nécessitant l'ensemble des fonctionnalités disponibles.
-
SDK compatible OpenAI
- Avantages : Remplacement direct des intégrations existantes basées sur le SDK OpenAI.
- Limitations : Les fonctionnalités avancées, telles que la correction de rotation d'image et les tâches OCR intégrées, ne sont pas directement exposées sous forme de paramètres. Vous pouvez toutefois les simuler en adaptant vos prompts et en analysant la sortie générée.
- Cas d'usage idéal : Projets utilisant déjà OpenAI et n'ayant pas besoin des fonctionnalités exclusives à DashScope.
-
SDK DashScope
Prise en main
L'exemple suivant extrait des champs structurés à partir d'une image de billet de train (URL) et retourne les résultats au format JSON. Pour les fichiers locaux, consultez la section Comment transmettre un fichier local. Pour connaître les contraintes d'entrée, reportez-vous aux Limitations relatives aux images.
- OpenAI compatible-Chat
- OpenAI compatible-Response
- DashScope
Exemple de réponse
Exemple de réponse
Appeler des tâches intégrées
Les modèles (à l'exception de qwen-vl-ocr-2024-10-28) incluent des tâches intégrées pour les scénarios OCR courants.
Comment appeler une tâche intégrée :
- SDK DashScope : Définissez le paramètre
ocr_optionspour invoquer les tâches intégrées. À partir deqwen3.5-ocr, ces tâches fonctionnent conjointement avec votre Prompt personnalisé (elles ne le remplacent plus) et leurs résultats sont renvoyés dans le champocr_result. Les modèles antérieurs utilisent unPromptinterne fixe. - SDK compatible OpenAI : Transmettez manuellement le
Promptspécifique à la tâche dans votre message.
task, un Prompt fixe, un format de sortie ainsi qu'un exemple de résultat :
Instructions
- Reconnaissance haute précision
- Extraction d'informations
- Analyse de tableaux
- Analyse de documents
- Reconnaissance de formules
- Reconnaissance générale de texte
- Reconnaissance multilingue
qwen-vl-ocr-2025-11-20 ou la version la plus récente (recommandé). Fonctionnalités :- Reconnaît et extrait le contenu textuel.
- Détecte la position du texte en localisant les lignes de texte et en retournant leurs coordonnées.
Pour tracer des cadres englobants sur l'image d'origine à partir des coordonnées retournées, consultez la FAQ .
| Valeur de task | Prompt spécifié | Format de sortie et exemple |
|---|---|---|
advanced_recognition | Localise toutes les lignes de texte et retourne les coordonnées du rectangle rotatif ([cx, cy, width, height, angle]). |
|
Exemple de réponse
Exemple de réponse
Analyse de documents PDF
qwen3.5-ocr permet de transmettre directement des fichiers PDF via l'API Response pour l'analyse de documents, sans qu'il soit nécessaire de découper manuellement le PDF en images. La longueur de sortie n'est pas limitée par la capacité maximale du modèle, ce qui permet d'analyser intégralement des documents volumineux. Seule l'API Response est prise en charge ; l'API Chat ne l'est pas. Limites des fichiers PDF : taille inférieure à 100 Mo. Le nombre maximal de pages dépend de task dans ocr_options : jusqu'à 50 pages lorsque task est défini sur document_parsing, et jusqu'à 10 pages lorsque task n'est pas défini ou est défini sur une autre tâche.
Les exemples suivants utilisent l'API Response pour transmettre des fichiers PDF afin d'effectuer une analyse de documents.
Pour les modèles antérieurs (qwen-vl-ocr-2025-11-20et versions précédentes) qui ne prennent pas en charge l'API Response, utilisez une bibliothèque de traitement d'images telle quePythonavecpdf2imagepour convertir chaque page du PDF en image, puis appliquez la méthode Entrée multi-images pour une reconnaissance page par page.
Pour plus d'informations sur l'utilisation de l'API Responses d'OpenAI (comme la récupération et la gestion des réponses terminées du modèle), consultez Compatibilité OpenAI - Responses .
Transmettre un fichier local (encodage Base64 ou chemin de fichier)
Téléversez des fichiers locaux à l'aide d'un encodage Base64 ou d'un chemin de fichier direct. Choisissez la méthode en fonction de la taille du fichier et du type de SDK — voir Comment choisir une méthode de téléversement de fichier. Les deux méthodes doivent respecter les exigences décrites dans Limites des images.
- Utiliser l'encodage Base64
- Utiliser le chemin de fichier
Étapes pour transmettre une chaîne encodée en Base64
Étapes pour transmettre une chaîne encodée en Base64
-
Encodez le fichier : convertissez l'image locale en une chaîne encodée en Base64.
Exemple de code pour convertir une image en chaîne encodée en Base64
-
Construisez une Data URL selon le format suivant :
data:[MIME_type];base64,{base64_image}.- Remplacez
MIME_typepar le type de média réel. Assurez-vous que ce type correspond à la valeurMIME Typeindiquée dans le tableau Limites des images, par exempleimage/jpegouimage/png. base64_imagecorrespond à la chaîne encodée en Base64 générée à l'étape précédente.
- Remplacez
-
Appelez le modèle : transmettez la
Data URLà l'aide du paramètreimageouimage_urlpour appeler le modèle.
- Transmettre un chemin de fichier
- Transmettre une chaîne encodée en Base64
La transmission d'un chemin de fichier est uniquement prise en charge pour les appels effectués avec les SDK Python et Java de DashScope. Cette méthode n'est pas compatible avec les appels HTTP DashScope ni les méthodes compatibles OpenAI.
Autres cas d'utilisation
Limites
Limites relatives aux images
- Dimensions et rapport d'aspect : La largeur et la hauteur de l'image doivent toutes deux être supérieures à 10 pixels. Le rapport d'aspect ne doit pas dépasser 200:1 ou 1:200.
- Nombre total de pixels : Le modèle redimensionne automatiquement les images, il n'existe donc pas de limite stricte quant au nombre total de pixels. Toutefois, une image ne peut pas excéder 15,68 millions de pixels.
-
Formats d'image pris en charge
-
Pour les images dont la résolution est inférieure à la 4K
(3840x2160), les formats suivants sont pris en charge :Format d'image
Extensions courantes
Type MIME
BMP
.bmp
image/bmp
JPEG
.jpe, .jpeg, .jpg
image/jpeg
PNG
.png
image/png
TIFF
.tif, .tiff
image/tiff
WEBP
.webp
image/webp
HEIC
.heic
image/heic
-
Pour les images dont la résolution est comprise entre
4K(3840x2160)et8K(7680x4320), seuls les formats JPEG, JPG et PNG sont pris en charge.
-
Pour les images dont la résolution est inférieure à la 4K
-
Taille de l'image :
- Si vous fournissez une image via une URL publique ou un chemin local :
qwen3.5-ocrprend en charge des images jusqu'à20 MB; les autres versions acceptent jusqu'à10 MB. - Si vous fournissez les données en encodage Base64, la chaîne encodée ne doit pas dépasser
10 MB.
Voir aussi : Comment compresser une image ou une vidéo à la taille requise ? .
- Si vous fournissez une image via une URL publique ou un chemin local :
Limites du modèle
-
Message système : Qwen-OCR utilise un
System Messageinterne fixe et n'accepte pas de message personnalisé. Transmettez toutes les instructions dans leUser Message. -
Conversations multi-tours : À partir de
qwen3.5-ocr, les conversations multi-tours sont prises en charge. Vous pouvez ainsi envoyer des messages texte de suivi sans URL d'image. Les versionsqwen-vl-ocr-2025-11-20et antérieures traitent uniquement le message le plus récent et ne conservent pas le contexte. - Risque d'hallucination : Le modèle peut produire des hallucinations si le texte d'une image est trop petit ou de faible résolution. Par ailleurs, la précision des réponses aux questions sans rapport avec l'extraction de texte n'est pas garantie.
-
Traitement des fichiers texte :
- Pour les fichiers contenant des données image, suivez les recommandations de la section Mise en production afin de les transformer en séquence d'images avant le traitement.
- Pour les fichiers contenant du texte brut ou des données structurées, utilisez Qwen-Long, un modèle capable d'analyser de longs textes.
Types de certificats et de documents pris en charge
La tâche d'extraction d'informations permet d'extraire des données structurées à partir des certificats, reçus et permis suivants.
- Passeports et documents de voyage : passeport chinois, passeport de Macao, permis de voyage pour les résidents de Hong Kong et de Macao se rendant en Chine continentale, permis de voyage pour les résidents de Taïwan se rendant en Chine continentale, et permis de retour pour les résidents de Hong Kong et de Macao.
- Documents relatifs aux véhicules et factures de vente : permis de conduire, plaque signalétique du véhicule, certificat de conformité du véhicule, carte grise, facture de vente de véhicule à moteur et facture de vente de véhicule d'occasion.
- Factures et reçus fiscaux : facture ordinaire TVA (rouleau), facture spéciale à montant fixe, facture générale imprimée par machine, certificat de paiement des impôts et reçu de revenus non fiscaux centraux.
- Reçus de transport : billet de train à grande vitesse 12306, billet de train, billet de bateau, reçu de péage autoroutier et facture imprimée par machine pour autoroute.
- Cartes financières et reçus : carte de crédit, lettre de change bancaire électronique, reçu de paiement et carte de sécurité sociale.
- Licences commerciales et permis : licence commerciale, licence d'exploitation alimentaire, licence de production alimentaire, licence d'exploitation pharmaceutique et licence d'exploitation de dispositifs médicaux.
- Certificat immobilier : certificat de propriété immobilière.
- Cartes d'identité internationales : carte d'identité de Hong Kong, de Macao, indonésienne, thaïlandaise, vietnamienne, malaisienne, philippine, indienne, turque, pakistanaise, mexicaine, britannique et américaine.
- Passeports et permis de conduire internationaux : passeport indien, singapourien, thaïlandais, américain, australien et des Émirats arabes unis, ainsi que les permis de conduire philippin, japonais et américain.
Facturation et limitation du débit
-
Facturation : Qwen-OCR est un modèle multimodal. Le coût total se calcule comme suit : (nombre de tokens d'entrée × prix unitaire d'entrée) + (nombre de tokens de sortie × prix unitaire de sortie). Consultez vos factures ou rechargez votre compte dans la console Expenses and Costs.
-
Calcul des tokens d'image : Utilisez le code suivant pour estimer la consommation de tokens d'image. La facturation réelle repose sur la réponse de l'API.
Exemple de code pour estimer les tokens d'image
Formule : Tokens d'image =(h_bar * w_bar) / token_pixels + 2.-
h_bar * w_barreprésente les dimensions de l'image redimensionnée. Le modèle prétraite l'image en la redimensionnant selon une limite spécifique de pixels. Cette limite dépend de la valeur du paramètremax_pixels. -
token_pixelscorrespond à la valeur en pixels parToken.- Pour
qwen3.5-ocr,qwen-vl-ocr,qwen-vl-ocr-2025-11-20et cette valeur est fixée à32*32(soit1024). - Pour les autres modèles, cette valeur est fixée à
28*28(soit784).
- Pour
-
-
Calcul des tokens d'image : Utilisez le code suivant pour estimer la consommation de tokens d'image. La facturation réelle repose sur la réponse de l'API.
- Limitation du débit : Pour connaître les limites de débit applicables à Qwen-OCR, reportez-vous à la section Limitation du débit.
- Quota gratuit (Singapour uniquement) : Qwen-OCR offre un quota gratuit d'un million de tokens. Ce quota est valable 90 jours à compter de la date d'activation de Model Studio ou de l'approbation de votre demande d'utilisation du modèle.
Mise en production
-
Prétraitement des images :
-
Veillez à ce que les images d'entrée soient nettes, uniformément éclairées et peu compressées :
- Stockez et transmettez les images dans un format sans perte (par exemple, PNG) afin d'éviter toute perte d'informations.
- Pour améliorer la netteté, appliquez des algorithmes de débruitage, tels qu'un filtrage moyen ou médian, pour lisser les images bruitées.
- Pour corriger un éclairage inégal, utilisez des algorithmes comme l'égalisation adaptative d'histogramme afin d'ajuster la luminosité et le contraste.
-
Images inclinées : Définissez
enable_rotate: truedans le SDK DashScope pour corriger la rotation avant la reconnaissance. -
Images très petites ou très grandes : Utilisez
min_pixelsetmax_pixelspour contrôler le redimensionnement de l'image.min_pixels: Agrandit les petites images pour en améliorer les détails. Conservez la valeur par défaut.max_pixels: Empêche les images trop volumineuses de consommer un nombre excessif de tokens. La valeur par défaut convient à la plupart des cas. Augmentez-la si du texte de petite taille n'est pas détecté, sachant que cela accroît la consommation de tokens.
-
Veillez à ce que les images d'entrée soient nettes, uniformément éclairées et peu compressées :
- Validation des résultats : Les résultats de reconnaissance du modèle peuvent contenir des erreurs. Pour les opérations métier critiques, mettez en place un processus de révision manuelle ou ajoutez des règles de validation afin de vérifier l'exactitude des sorties du modèle. Par exemple, utilisez la validation de format pour les numéros de carte d'identité et de carte bancaire.
- Traitement par lots : Pour les charges de travail volumineuses et non temps réel, utilisez l'API Batch afin de traiter les tâches de manière asynchrone à moindre coût.
FAQ
Comment choisir une méthode de téléchargement de fichier ?
Comment choisir une méthode de téléchargement de fichier ?
Type | Spécifications | DashScope SDK (Python, Java) | Compatible OpenAI / DashScope HTTP |
|---|---|---|---|
Image | Supérieure à 7 MB et inférieure à 10 MB | Transmettre le chemin local | Seules les URL publiques sont prises en charge. Utilisez Object Storage Service. |
Inférieure à 7 MB | Transmettre le chemin local | Encodage Base64 |
L'encodage Base64 augmente la taille des données. Le fichier original doit peser moins de 7 MB.
L'utilisation d'un chemin local ou de l'encodage Base64 permet d'éviter les délais d'attente de téléchargement côté serveur et d'améliorer la stabilité.
Comment dessiner des cadres de détection sur l'image d'origine après l'obtention des résultats de localisation de texte par le modèle ?
Comment dessiner des cadres de détection sur l'image d'origine après l'obtention des résultats de localisation de texte par le modèle ?