

Les API Model Studio limitent le volume de requêtes, l'utilisation des tokens et le taux de croissance. Appliquez ces stratégies pour maximiser le débit et maintenir la disponibilité.
- Solutions de configuration de la plateforme (modifications minimes du code) : Mise en file d'attente côté serveur, PTU et Batch API.
- Stratégies de contrôle du trafic côté client (modifications du code client) : Quatre stratégies de complexité technique croissante, allant de la nouvelle tentative de base au contrôle de congestion adaptatif.
- Solutions de repli architecturales (modifications de l'architecture système) : Repli de modèle et Lissage des pics de charge via files d'attente de messages (MQ).
429, accédez à la section Diagnostic des erreurs et recommandations de stratégies pour en identifier la cause. Pour les erreurs liées aux pics de trafic, essayez d'abord la mise en file d'attente côté serveur : elle ne nécessite qu'un seul en-tête de requête.
Mécanisme de limitation de débit de la plateforme
La plateforme applique des limites de débit à chaque modèle indépendamment, au niveau du compte racine. Après le déclenchement d'une limite, le service reprend généralement son fonctionnement dans un délai d'une minute. Pour connaître les conditions de limitation et l'utilisation actuelle par modèle, consultez les rubriques Limitation de débit et Surveillance des modèles. Trois types de règles s'appliquent :
- Limites de quota à la minute (RPM / TPM) : Nombre maximal de requêtes par minute (RPM) et utilisation maximale des tokens par minute (TPM).
- Limites de fréquence instantanée (RPS / TPS) : Nombre maximal de requêtes par seconde (RPS) et utilisation maximale des tokens par seconde (TPS). Des appels API denses ou une consommation élevée de tokens en une seule seconde peuvent déclencher la limitation.
- Limites du taux de croissance (Traffic Burst) : Une augmentation soudaine du volume de requêtes ou de l'utilisation des tokens déclenche la limitation. Le seuil s'ajuste dynamiquement. Augmentez progressivement le volume de requêtes pour éviter d'atteindre cette limite.
Diagnostic des erreurs et recommandations de stratégies
Un même code d'erreur peut provenir de différentes dimensions de limitation. Une concurrence élevée peut également saturer le serveur et provoquer des délais d'attente. La stratégie de contrôle de congestion adaptatif permet d'atténuer ce phénomène.
Code d'erreur (DashScope / OpenAI) | Dimension déclenchante | Diagnostic fonctionnel | Stratégie recommandée |
|---|---|---|---|
Throttling.RateQuota / limit_requests | Taux de requêtes dépassé | Erreurs intermittentes. Le taux de réussite diminue avec le temps. | Seau à jetons : Contrôlez le quota de requêtes par unité de temps. |
Taux de requêtes dépassé | Erreurs concentrées au démarrage ou lors de pics de concurrence. | Sémaphore de concurrence ou limiteur de débit lissant : Augmentez l'intervalle entre les requêtes. | |
Throttling.AllocationQuota / insufficient_quota | Utilisation des tokens dépassée | Erreurs intermittentes lors du traitement de textes longs. | Double seau à jetons : Limitez simultanément les quotas RPM et TPM. |
Utilisation des tokens dépassée | La consommation instantanée de tokens est trop élevée lors du traitement simultané de textes longs. | ||
Throttling.BurstRate / limit_burst_rate | Taux de croissance du trafic dépassé | Volume important et soudain de requêtes après le démarrage ou la sortie d'un état inactif. | Essayez d'abord la mise en file d'attente côté serveur. Vous pouvez aussi utiliser un seau à jetons avec une valeur initiale faible, telle que |
Solutions de configuration de la plateforme
Ces solutions reposent sur les capacités de la plateforme et nécessitent peu ou pas de modifications du code client.
Mise en file d'attente côté serveur (recommandé)
Pour la limitation liée aux pics de trafic, Model Studio accepte une limite supérieure du temps d'attente dans l'en-tête de la requête. Après réception de la requête, le serveur la retente au fil de cette fenêtre jusqu'à ce que le traitement commence ou que les tentatives de la fenêtre se terminent. Cette valeur n'est qu'une limite supérieure ; le serveur n'attend pas de l'atteindre pour retenter. Cela améliore considérablement les taux de réussite lors des pics de trafic par rapport à une réponse 429 immédiate.
X-DashScope-Wait-Timeout à l'en-tête de la requête :
| Champ d'en-tête | Exemple | Description |
|---|---|---|
| X-DashScope-Wait-Timeout | 90 | Limite supérieure de la fenêtre d'attente en file d'attente pour les requêtes en rafale, en secondes. Le serveur retente la requête dans cette fenêtre au lieu d'attendre d'atteindre la valeur.
|
- Requêtes non streaming (stream: false) : Délai d'expiration = délai de base initial + valeur Wait-Timeout.
- Requêtes streaming (stream: true) : Délai d'expiration > valeur Wait-Timeout. Le chronométrage des requêtes streaming démarre après le premier fragment ; le délai d'attente de la réponse initiale doit donc simplement excéder le temps de mise en file d'attente.
Exemple de code
Exemple de code
Unité de débit provisionnée (PTU)
Le service PTU fournit une puissance de calcul dédiée et réservée. Il évite la contention dans le pool de ressources public et constitue la solution privilégiée pour les exigences temps réel à haut débit.
Utilisez les PTU lorsque votre activité impose des exigences de débit déterministes (comme des engagements SLA) ou lorsque vous souhaitez un débit élevé et stable sans contrôle du trafic côté client.
Les PTU sont des ressources réservées facturées en continu, même si elles ne sont pas pleinement utilisées. Évaluez les spécifications requises en fonction de la charge réelle de pointe pour éviter le gaspillage.
Traitement par lots asynchrone (Batch API)
Pour les tâches sans exigences strictes de temps réel (nettoyage de données, analyses par lots), utilisez la Batch API afin de les soumettre pour un traitement différé. Ces tâches s'exécutent pendant les heures creuses, renvoient les résultats de manière asynchrone et ne sont pas soumises aux limites de débit en ligne.
Cette approche convient aux tâches hors ligne tolérant des délais de réponse allant de quelques heures à plusieurs jours : annotation de données, analyse de journaux, résumés par lots. Les coûts de la Batch API sont généralement inférieurs à ceux des appels API en temps réel.
Le délai de retour n'est pas garanti. Cette méthode ne convient pas aux services nécessitant des réponses immédiates. Récupérez les résultats par interrogation (polling) ou par rappel (callback) après la soumission.
Stratégies de contrôle du trafic côté client
Lorsque les solutions de la plateforme (telles que la mise en file d'attente côté serveur) ne suffisent pas, ajoutez un contrôle du trafic côté client. Le principe fondamental consiste à répartir uniformément les requêtes dans une fenêtre temporelle pour éviter les rafales. Après le démarrage du système ou une longue période d'inactivité, augmentez progressivement la concurrence.
Quatre stratégies sont présentées par ordre de complexité croissante. Chacune inclut la précédente et y ajoute des fonctionnalités :
- La nouvelle tentative de base offre uniquement une défense passive.
- La limitation du taux de requêtes ajoute une mise en file d'attente active.
- La mise en forme du trafic introduit en outre un contrôle au niveau des tokens et un envoi lissé.
- Le contrôle de congestion adaptatif ajuste dynamiquement le taux d'envoi en fonction des retours en temps réel.
Comparaison des performances de débit de chaque stratégie
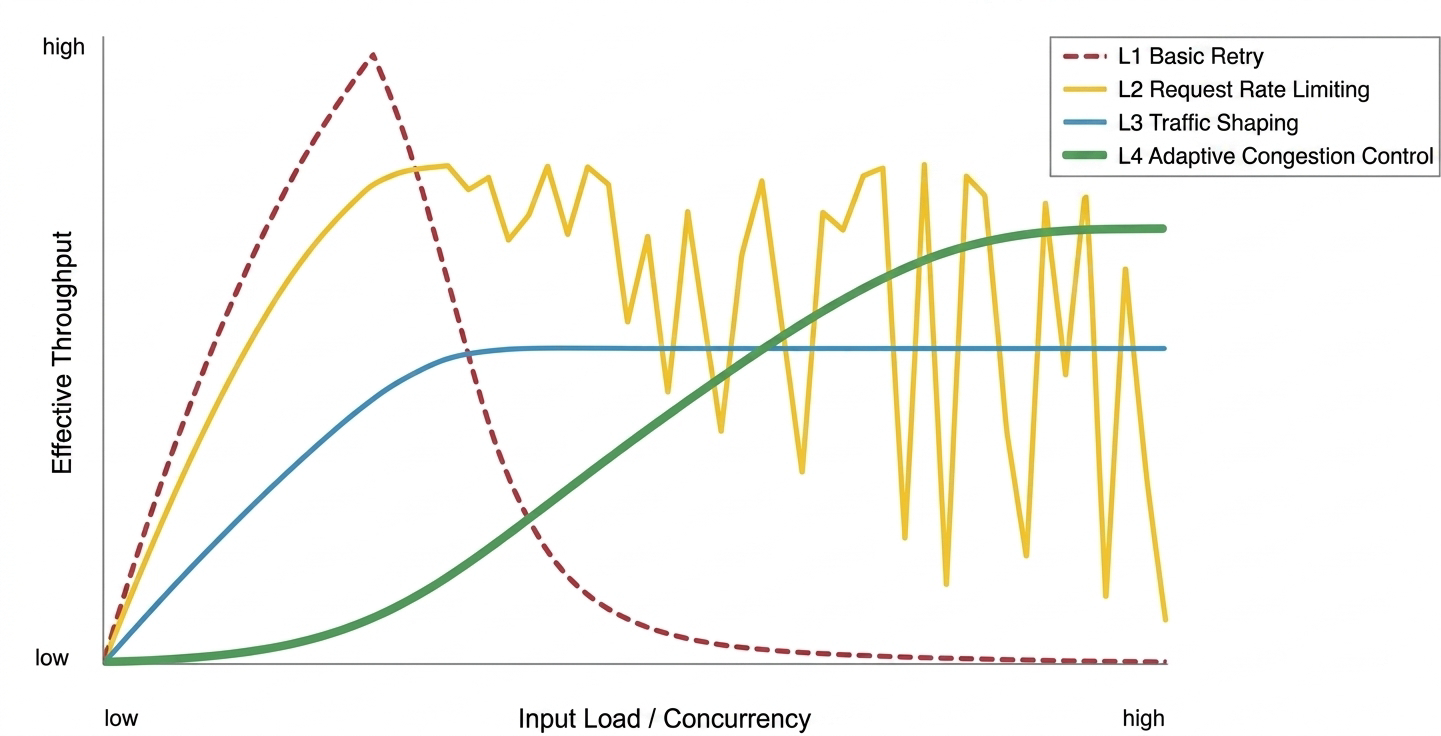
- Stratégie de nouvelle tentative de base : Efficace sous faible charge. Sujette à l'effondrement congestif sous forte concurrence, entraînant une chute brutale du débit.
- Stratégie de limitation du taux de requêtes : Protection robuste contre l'effondrement. Cependant, sous des charges mixtes avec des textes longs, le débit présente des fluctuations en dents de scie en raison de l'absence de contrôle des tokens.
- Stratégie de mise en forme du trafic : Haute stabilité. Permet d'obtenir un flux régulier en sacrifiant une partie du débit de pointe.
- Stratégie de contrôle de congestion adaptatif : Capable de converger dynamiquement vers un débit élevé et stable sous forte charge, mais implique une surcharge liée à la phase de test au démarrage.
Stratégie de nouvelle tentative de base
Conçue pour les tests personnels, les scripts locaux et les tâches d'arrière-plan peu fréquentes. Aucune limitation de débit n'est appliquée aux requêtes sortantes. Déclenche uniquement une nouvelle tentative avec backoff exponentiel et gigue aléatoire en cas d'erreurs 429 ou 5xx.
Aucun contrôle proactif du trafic n'est exercé. En cas de concurrence multithread, cette approche déclenche facilement la limitation de débit et provoque l'accumulation de requêtes en attente.
Exemple de code
Exemple de code
- Le temps d'attente double progressivement : Par exemple,
1s, 2s, 4s.... Cela évite les requêtes répétées sur une courte période. - Ajout d'une gigue aléatoire : Une valeur aléatoire (telle que
2s +/- 0.5s) répartit le trafic des nouvelles tentatives, empêchant ainsi un afflux secondaire (effet de troupeau).
Stratégie de limitation du taux de requêtes
Les nouvelles tentatives passives seules ne suffisent pas pour gérer le trafic réel. Des tentatives fréquentes augmentent la latence. Cette stratégie introduit un contrôle actif du trafic : vérifiez et régulez les requêtes avant leur envoi, organisant ainsi un trafic désordonné en une file d'attente respectant la limite RPM. Un lissage actif ajoute un léger délai de mise en file d'attente prévisible, bien inférieur au coût d'une boucle « erreur — attente — nouvelle tentative ». Un faible coût connu vaut mieux qu'un coût élevé inconnu.
Idéale pour les chatbots et autres services légers de type requête-réponse sensibles au délai du premier token.
La mise en file d'attente active côté client utilise deux niveaux de contrôle :
- Seau à jetons RPM : Limite le nombre total de requêtes par minute. La capacité du seau correspond au quota RPM ; les jetons se rechargent à un taux constant. Prend en charge l'emprunt : si les jetons sont insuffisants, une requête emprunte sur le quota futur, en respectant strictement l'ordre FIFO.
- Sémaphore de concurrence : Limite les requêtes simultanées pour empêcher une concurrence instantanée élevée de déclencher les limites RPS.
initial_tokens=rpm_limit), ce qui convient aux services en ligne devant traiter des requêtes immédiatement au démarrage. Si un seau plein déclenche la limitation de débit, réduisez la valeur initiale (par exemple, initial_tokens=0 pour un « démarrage à seau vide ») afin d'augmenter la charge plus progressivement.
Cette stratégie ne suit pas l'utilisation des tokens. Les tâches impliquant des textes longs peuvent tout de même épuiser le quota TPM.
Exemple de code
Exemple de code
Stratégie de mise en forme du trafic
Dans les scénarios par lots nécessitant un débit élevé et stable (ingestion RAG en temps réel, analyse massive de documents longs), la limitation du taux de requêtes présente un angle mort TPM. La mise en forme du trafic ajoute une double conscience des ressources (RPM & TPM) ainsi qu'un mécanisme de lissage convertissant un trafic irrégulier en un flux régulier.
Améliorations par rapport à la limitation du taux de requêtes :
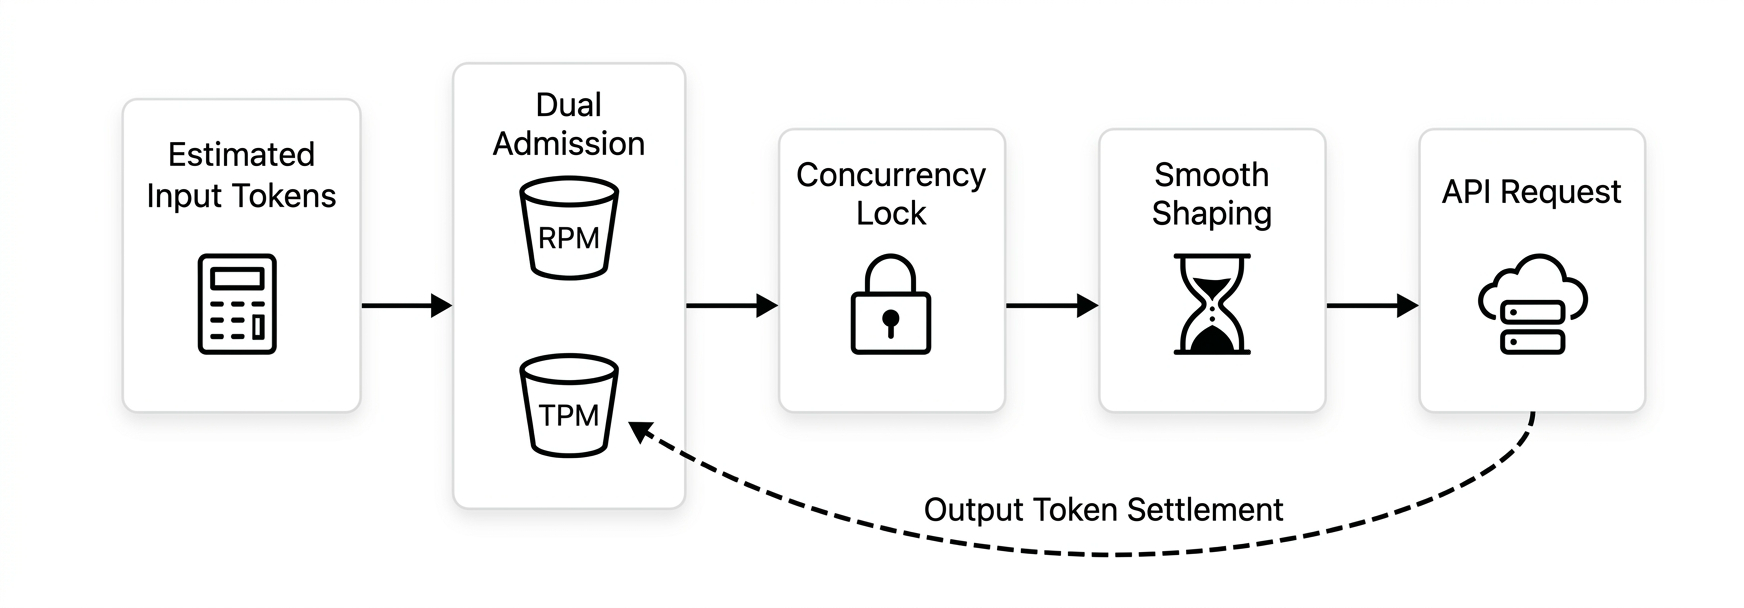
- Double contrôle des ressources (RPM & TPM) : Maintient des seaux à jetons pour le RPM et le TPM. Toutes les requêtes doivent passer les vérifications de quota pour les deux dimensions avant d'être envoyées.
- Pré-déduction pour l'entrée, règlement différé pour la sortie : La longueur de la sortie est inconnue avant la requête. Le seau TPM pré-déduit les tokens d'entrée lors de l'envoi et règle les tokens de sortie réels après l'achèvement. Même si le solde devient négatif, les requêtes suivantes attendent que le compteur redevienne positif, ce qui lisse naturellement le flux.
- Montée en charge continue : Lors d'un démarrage à froid, le taux d'émission des jetons augmente linéairement avec le temps, éliminant le risque de rafales initiales.
- Limiteur de débit lissant (Pacing) : Lisse le taux d'envoi en imposant un intervalle minimal entre les requêtes (pacing), réduisant ainsi le risque de déclencher les limites de débit.
initial_tokens=0) pour un démarrage sûr avec une complexité réduite. Le seau à jetons Python présenté ici sert d'illustration. En production, utilisez des bibliothèques de limitation de débit éprouvées telles que SmoothRateLimiter de Guava en Java.
Dans l'exemple de code, l'attente de lissage est placée à l'intérieur du verrou de concurrence. Plusieurs requêtes pourraient entrer en compétition pour le sémaphore simultanément après la fin de leur attente, regroupant à nouveau le trafic en sortie. Placer le lissage à l'intérieur du verrou réduit légèrement l'efficacité de la concurrence, mais garantit des intervalles d'envoi précis.
Le pipeline complet de mise en forme du trafic est le suivant : Estimation des tokens d'entrée → Double admission (RPM & TPM) → Verrou de concurrence → Mise en forme du trafic → Envoi → Règlement des tokens de sortie.
Exemple de code
Exemple de code
Stratégie de contrôle de congestion adaptatif
Adaptée aux charges de travail dynamiques à grande échelle : passerelles API, proxys complexes, systèmes multi-locataires.
- Paradoxe de performance : Si la charge est prévisible (comme le traitement par lots), des paramètres statiques optimaux surpassent le sondage dynamique qui nécessite « essais et convergence ».
- Surcharge de sondage : Les algorithmes dynamiques impliquent inévitablement une montée en charge au démarrage et des fluctuations exploratoires, ce qui constitue une surcharge inutile dans des scénarios connus.
- Coût de maintenance : La boucle de rétroaction fermée accroît la complexité du système et la difficulté du dépannage.
- EBP : Stocke le niveau historique le plus élevé atteint avec succès. Calcule le gain de sondage en simulant la tension d'un ressort basée sur la distance entre la concurrence actuelle et ce niveau (plus loin = plus rapide, plus proche = plus lent). Ajoute une petite poussée linéaire pour continuer à explorer même à saturation élevée.
- Détection de congestion TPT : Le temps de génération des LLM évolue selon la longueur de la sortie ; une latence élevée sur des textes longs ne signifie pas qu'il y a congestion. Le TPT (Time Per Token) filtre le bruit lié à la longueur du contenu. La congestion n'est déclarée que lorsque le TPT se dégrade significativement.
- Régulateur anti-rafale : Quelle que soit la cible EBP, le régulateur plafonne l'accélération de la croissance de la concurrence pour garantir une montée en charge progressive et éviter les changements brusques qui déclencheraient les limites de taux de croissance.
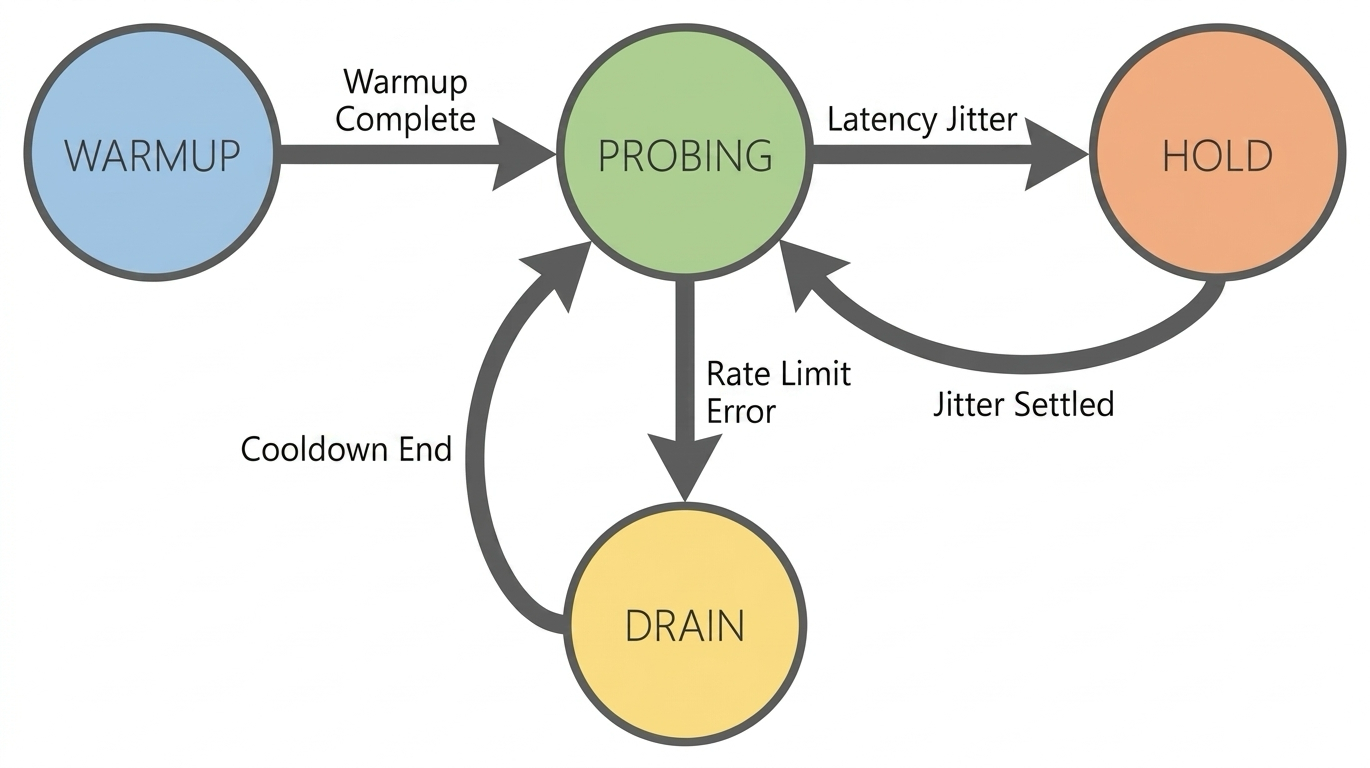
- Sondage guidé : Introduit les quotas RPM/TPM connus comme « limite supérieure directrice » pour éviter les collisions fréquentes causées par un sondage à l'aveugle.
- Source du signal (RTT → TPT) : Le BBR natif utilise le RTT. Dans les scénarios LLM, la latence liée à la longueur du contenu éclipse la gigue réseau. Le TPT élimine cette interférence.
- Amélioration du mécanisme de réponse (ProbeRTT → Hold) : Face aux fluctuations de latence, le système choisit de maintenir le niveau de concurrence actuel plutôt que de se retirer proactivement et de réduire le débit.
- Réponse à la limitation stricte (Packet Loss → 429 Drain) : Une fois qu'une erreur
429est déclenchée, le système entre dans un état Drain agressif et effectue une récupération rapide après une période de refroidissement.
- Bruit TPT : Le TPT est estimé comme « latence totale / tokens totaux ». La latence totale inclut l'aller-retour réseau, la mise en file d'attente et le délai du premier token ; elle est donc sensible à la gigue ou aux entrées longues, ce qui peut déclencher faussement l'état Hold.
- Famine des requêtes volumineuses : Utilise un réveil FIFO non strict pour les performances de planification. Lorsque les quotas sont rares, les requêtes à faible nombre de tokens peuvent préempter les ressources, obligeant les requêtes à grand nombre de tokens à attendre trop longtemps.
- Démarrage à froid : Nécessite une période de montée en charge pour construire un modèle statistique. Dans les tâches à faible charge ou de courte durée, le débit peut être inférieur à celui des trois premières stratégies.
Exemple de code
Exemple de code
Solutions de repli architecturales
Lorsque la configuration de la plateforme et le contrôle du trafic côté client ne suffisent toujours pas à répondre aux exigences de disponibilité ou de débit de pointe, ajoutez des mécanismes de repli au niveau architectural.
Repli de modèle
Lorsque le modèle principal ne peut pas répondre en raison d'une limitation de débit ou de problèmes de service, basculez automatiquement vers un modèle alternatif disposant d'un quota plus généreux.
Principes de conception du chemin de repli
- Choisissez des modèles de séries différentes : La limitation de débit s'applique par modèle. Utilisez un modèle différent comme repli ; par exemple, passez de
qwen3.6-plusàqwen3.6-flash. - Déclenchez le repli uniquement en cas d'erreur de limitation de débit : Effectuez le repli sur les erreurs
429, et non pour toutes les exceptions. Changer de modèle ne résoudra pas les délais d'attente réseau ni les erreurs de paramètres. - Validez le modèle de repli à l'avance : Assurez-vous qu'il prend en charge les fonctionnalités requises (Function Calling, sortie structurée, etc.) pour éviter des problèmes fonctionnels après le basculement.
Exemple de code
Exemple de code
Lissage des pics de charge via files d'attente de messages (MQ)
Pour les services d'arrière-plan ne nécessitant pas de réponses immédiates, introduisez un middleware de messagerie (RabbitMQ, Kafka) pour lisser les pics de charge. Le trafic en rafale entre d'abord dans la MQ ; les consommateurs extraient et traitent les messages à un rythme régulier correspondant au quota de limitation de débit. Cela découple les pics frontaux des appels backend.
Convient aux activités où les utilisateurs acceptent des résultats asynchrones : traitement de tickets, modération de contenu, annotation de données par lots.
Points clés de la conception :
- Contrôle du taux de consommation : Le côté consommateur doit utiliser la stratégie de limitation du taux de requêtes ou de mise en forme du trafic pour consommer les messages à un rythme régulier basé sur le quota RPM/TPM, plutôt que d'extraire les messages sans limites.
- Gestion des lettres mortes : Déplacez les messages ayant échoué après plusieurs tentatives vers une file d'attente de lettres mortes et déclenchez une alerte. Empêchez les tentatives infinies de bloquer la consommation.
- Propagation de la contre-pression : Lorsque l'arriéré de la MQ dépasse un seuil, propagez la pression en amont (par exemple, renvoyez un statut de mise en file d'attente) pour éviter une croissance illimitée de la file.
Considérations pour l'environnement de production
Les exemples de code utilisent une boucle monothread asyncio Python pour illustrer les algorithmes fondamentaux. Avant une utilisation en production à grande échelle, prenez en compte les points suivants.
-
Adaptation aux modèles non textuels
Les stratégies ci-dessus utilisent des modèles textuels comme exemples, mais les principes fondamentaux s'appliquent aux services multimodaux (génération d'images, synthèse vocale). Les unités diffèrent, mais l'essence reste la même : limiter le taux de soumission et la capacité de traitement.
- Les modèles tels que la reconnaissance vocale sont généralement contraints à la fois par le nombre de requêtes par unité de temps (comme le RPM) et par l'utilisation (comme la durée audio). Les stratégies sont fondamentalement les mêmes que pour les modèles textuels.
- Les modèles pour images et vidéos sont généralement contraints par le taux de soumission des tâches et le nombre de tâches simultanées. Adoptez la même approche que la stratégie de limitation du taux de requêtes : limitez le taux de soumission des tâches et utilisez un sémaphore pour contrôler la concurrence.
-
Atomicité dans les modèles concurrents
Exemple :
asyncioutilise une planification coopérative monothread, de sorte que les modifications d'état sont intrinsèquement atomiques au sein d'un seul processus. Production : Dans des environnements multithreads ou multiprocessus, assurez la sécurité concurrentielle du seau à jetons et de la fenêtre statistique. Les conditions de course compromettront le contrôle du trafic. - Limitation de débit distribuée Exemple : Tous les composants de contrôle du trafic résident en mémoire. Production : Dans les déploiements multi-instances, chaque instance effectue sa propre limitation indépendamment. L'utilisation totale peut dépasser la limite. Utilisez un compteur centralisé (tel que Redis) pour gérer l'utilisation sur tous les nœuds.
- Files d'attente prioritaires et prévention de la famine Exemple : Aucune différenciation de priorité. La stratégie de contrôle de congestion adaptatif utilise un réveil FIFO non strict pour les performances de planification. Production : Pour les requêtes haute/basse priorité, implémentez une file d'attente prioritaire pondérée afin de garantir la bande passante pour le trafic haute priorité. Réservez un quota minimal pour les files d'attente basse priorité afin d'éviter la famine.