

Déployez des modèles pré-entraînés de la plateforme ou vos propres modèles affinés pour obtenir un service d'inférence dédié et indépendant. Ce service répond aux exigences métier en matière de concurrence élevée, de faible latence et d'autres critères de performance.
Modes de facturation
Avant le déploiement, vous pouvez consulter le coût horaire estimé des différents modèles dans la console de déploiement dédié.
Provisioned Throughput (PTU, Provisioned Throughput Unit) (Débit élevé, hautes performances) | Model Unit (Métriques de performance personnalisées, isolation des ressources) | Consommation de tokens (Paiement à l'usage après fine-tuning/validation des résultats) | |||
|---|---|---|---|---|---|
Définition | Mode de déploiement qui réserve des ressources de la plateforme afin de garantir une capacité de débit TPM spécifique ; aucune limitation de taux n'est appliquée dans la limite du quota garanti. | Mode de déploiement qui configure la puissance de calcul en fonction de la durée d'utilisation et du nombre de Model Units, avec des ressources dédiées. | Mode de déploiement qui utilise les tokens d'entrée et les tokens de sortie générés par appel comme base de facturation de l'usage. | ||
Avantages |
|
| Aucun frais en cas de non-utilisation. | ||
Modèles pris en charge | Certains modèles prédéfinis | Certains modèles prédéfinis et tous les modèles affinés | Certains modèles affinés avec LoRA | ||
Cas d'usage |
|
| Validation des résultats d'un modèle affiné | ||
Schéma de facturation | 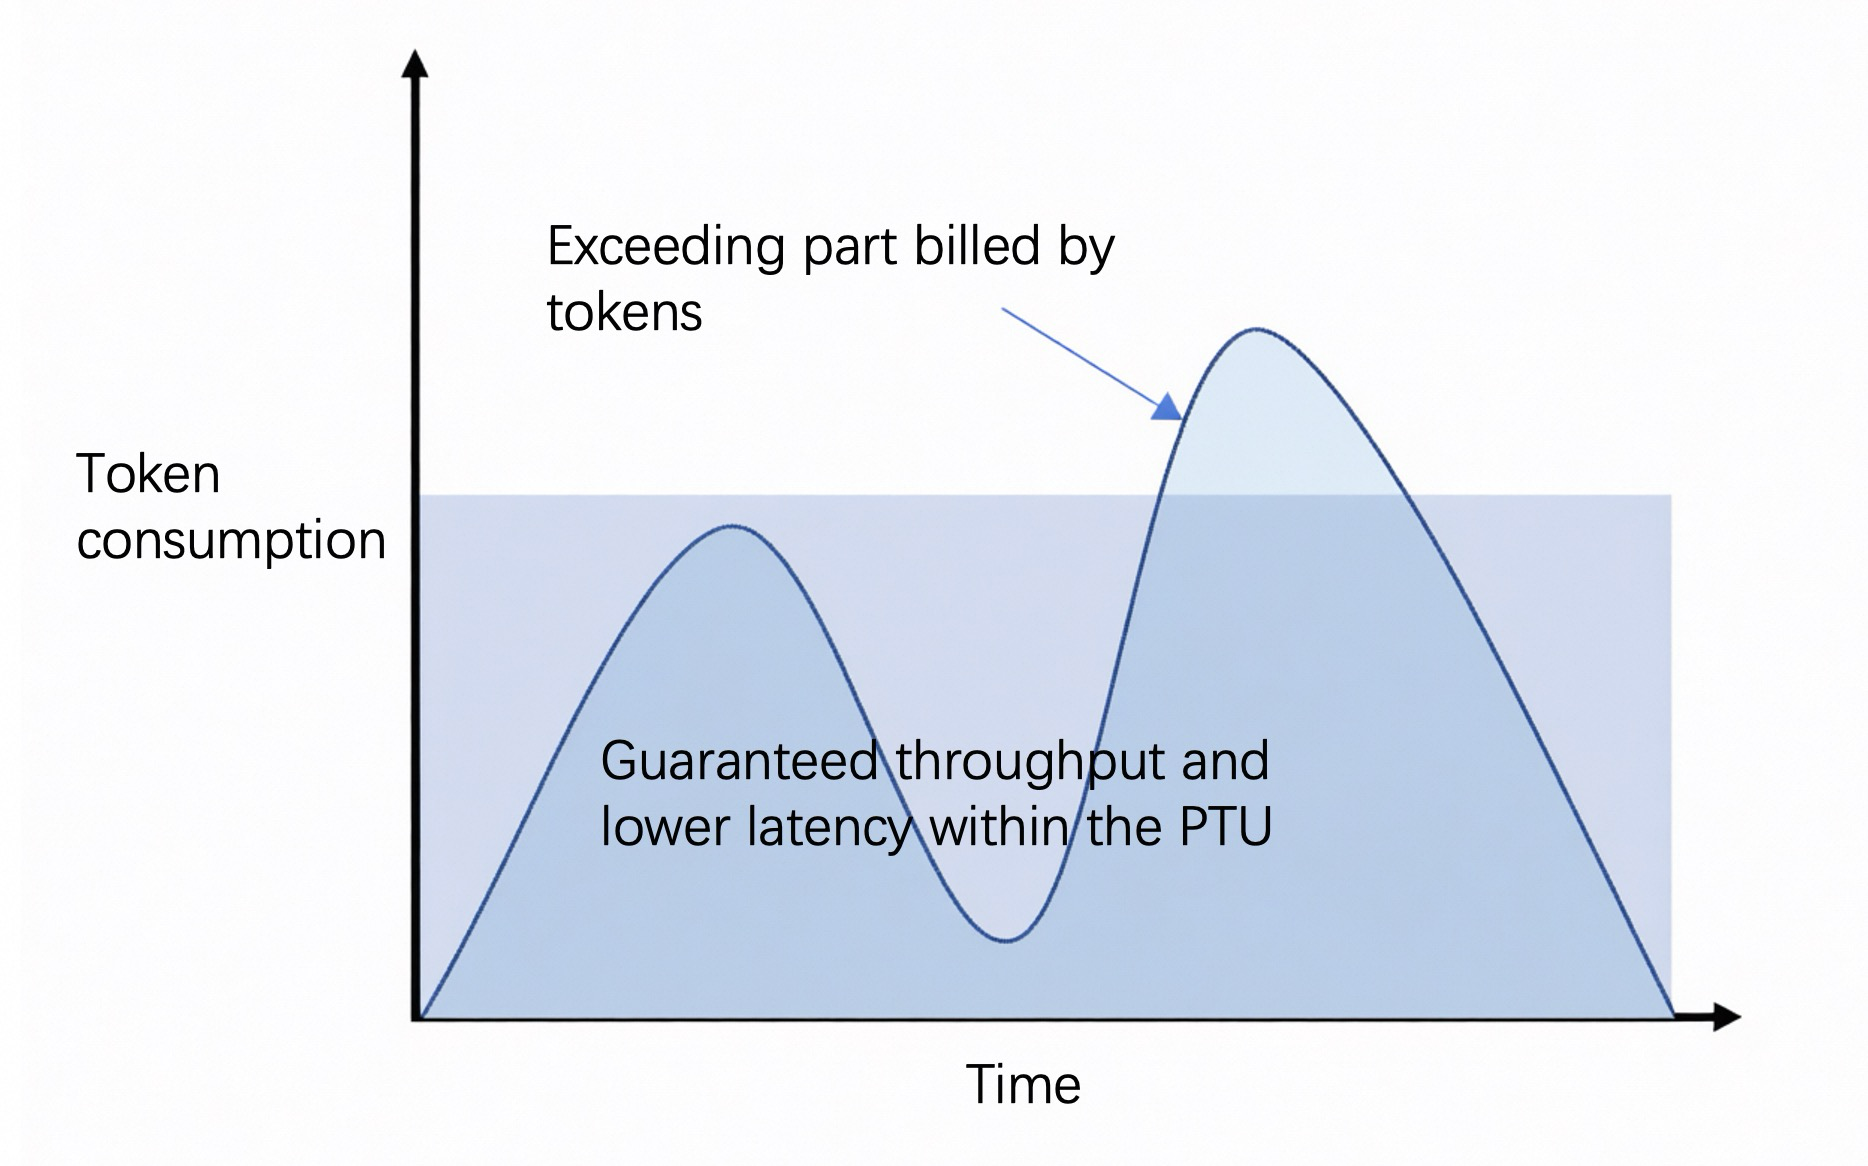 | 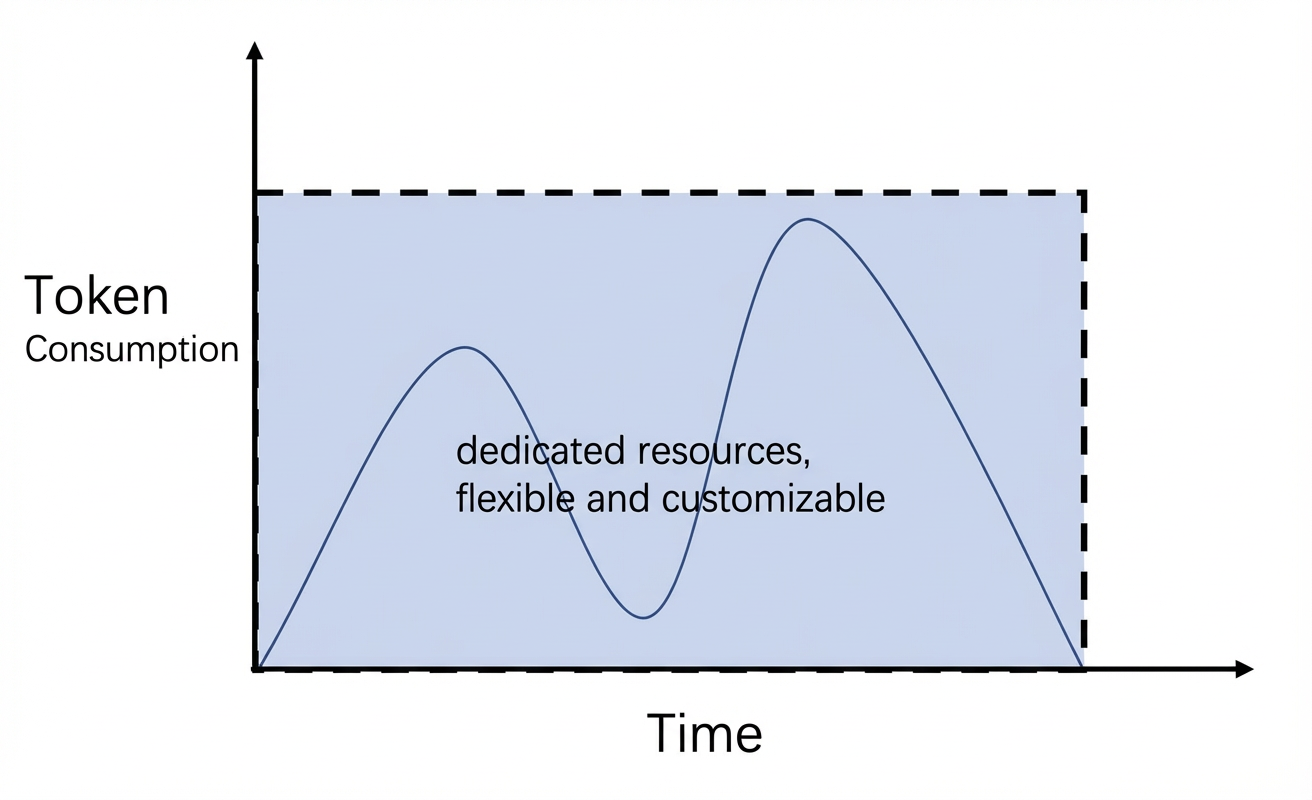 | 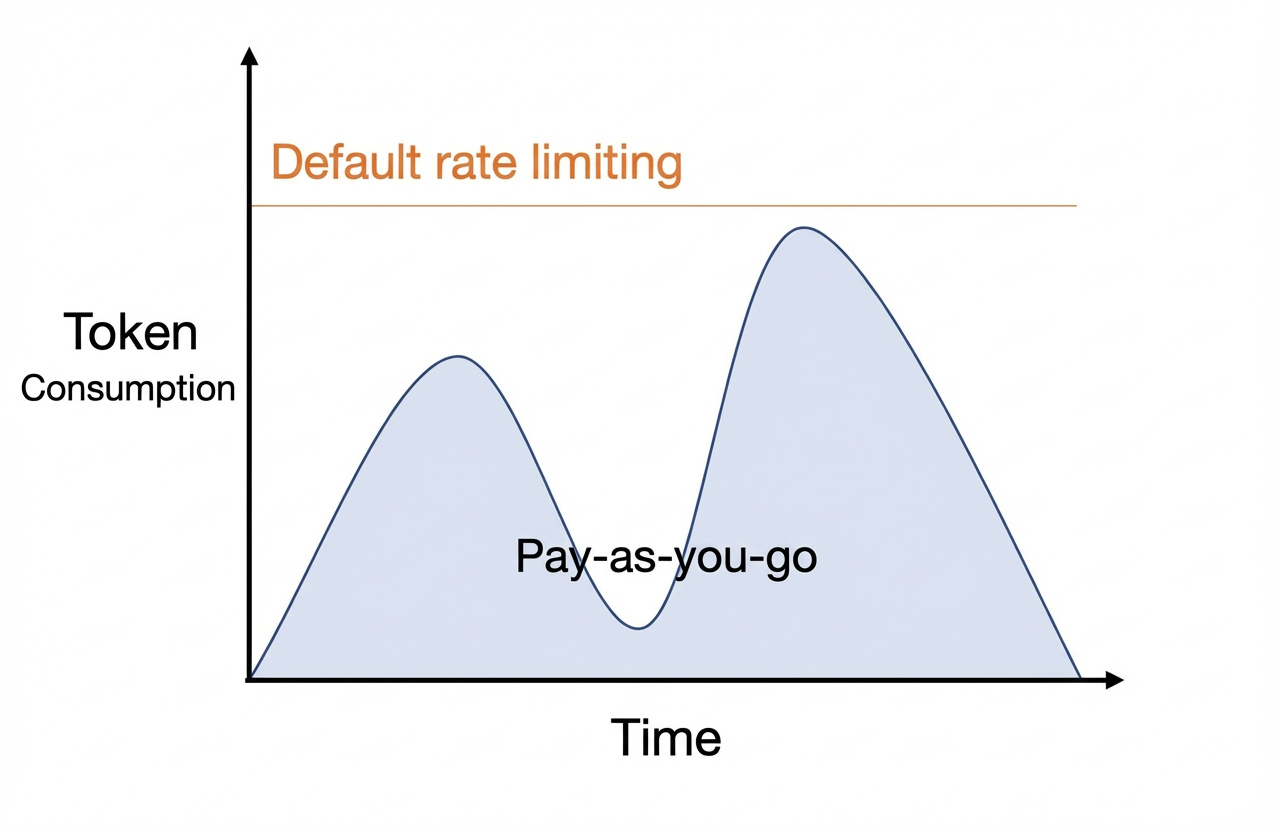 | ||
Mode de facturation | Selon la durée d'utilisation et le débit provisionné Paiement à l'usage, forfait journalier | Selon la durée d'utilisation et le nombre de Model Units Paiement à l'usage, forfait mensuel | Selon la consommation de tokens du modèle Paiement à l'usage | ||
Méthode de mise à l'échelle | Augmentation/diminution du débit en libre-service | Augmentation/diminution du nombre de Model Units en libre-service | Soumettez une demande dans la console et attendez la validation manuelle. | ||
Contraintes du produit |
| Après un achat prépayé, en cas d'annulation anticipée au cours du premier mois, le tarif journalier (≈ tarif mensuel / 30) sera facturé avec un coefficient de 1.2 |
| ||
Modes de déploiement
Pour connaître les modèles et les tarifs pris en charge par chaque mode de déploiement, consultez les pages correspondantes :
- Déploiement PTU Provisioned Throughput
- Déploiement avec capacité de calcul dédiée
- Déploiement avec paiement à l'usage par tokens
- Importation de modèles
Méthodes de déploiement
Vous pouvez déployer des modèles dans la console. Suivez les étapes suivantes :
En cas de message indiquant des permissions insuffisantes, consultez la section de résolution des problèmes de permissions du guide de déploiement par API.
- Connectez-vous à la console Model Studio. Dans le volet de navigation de gauche, choisissez Model Inference > Dedicated Deployment.
- Cliquez sur Deploy New Model.
-
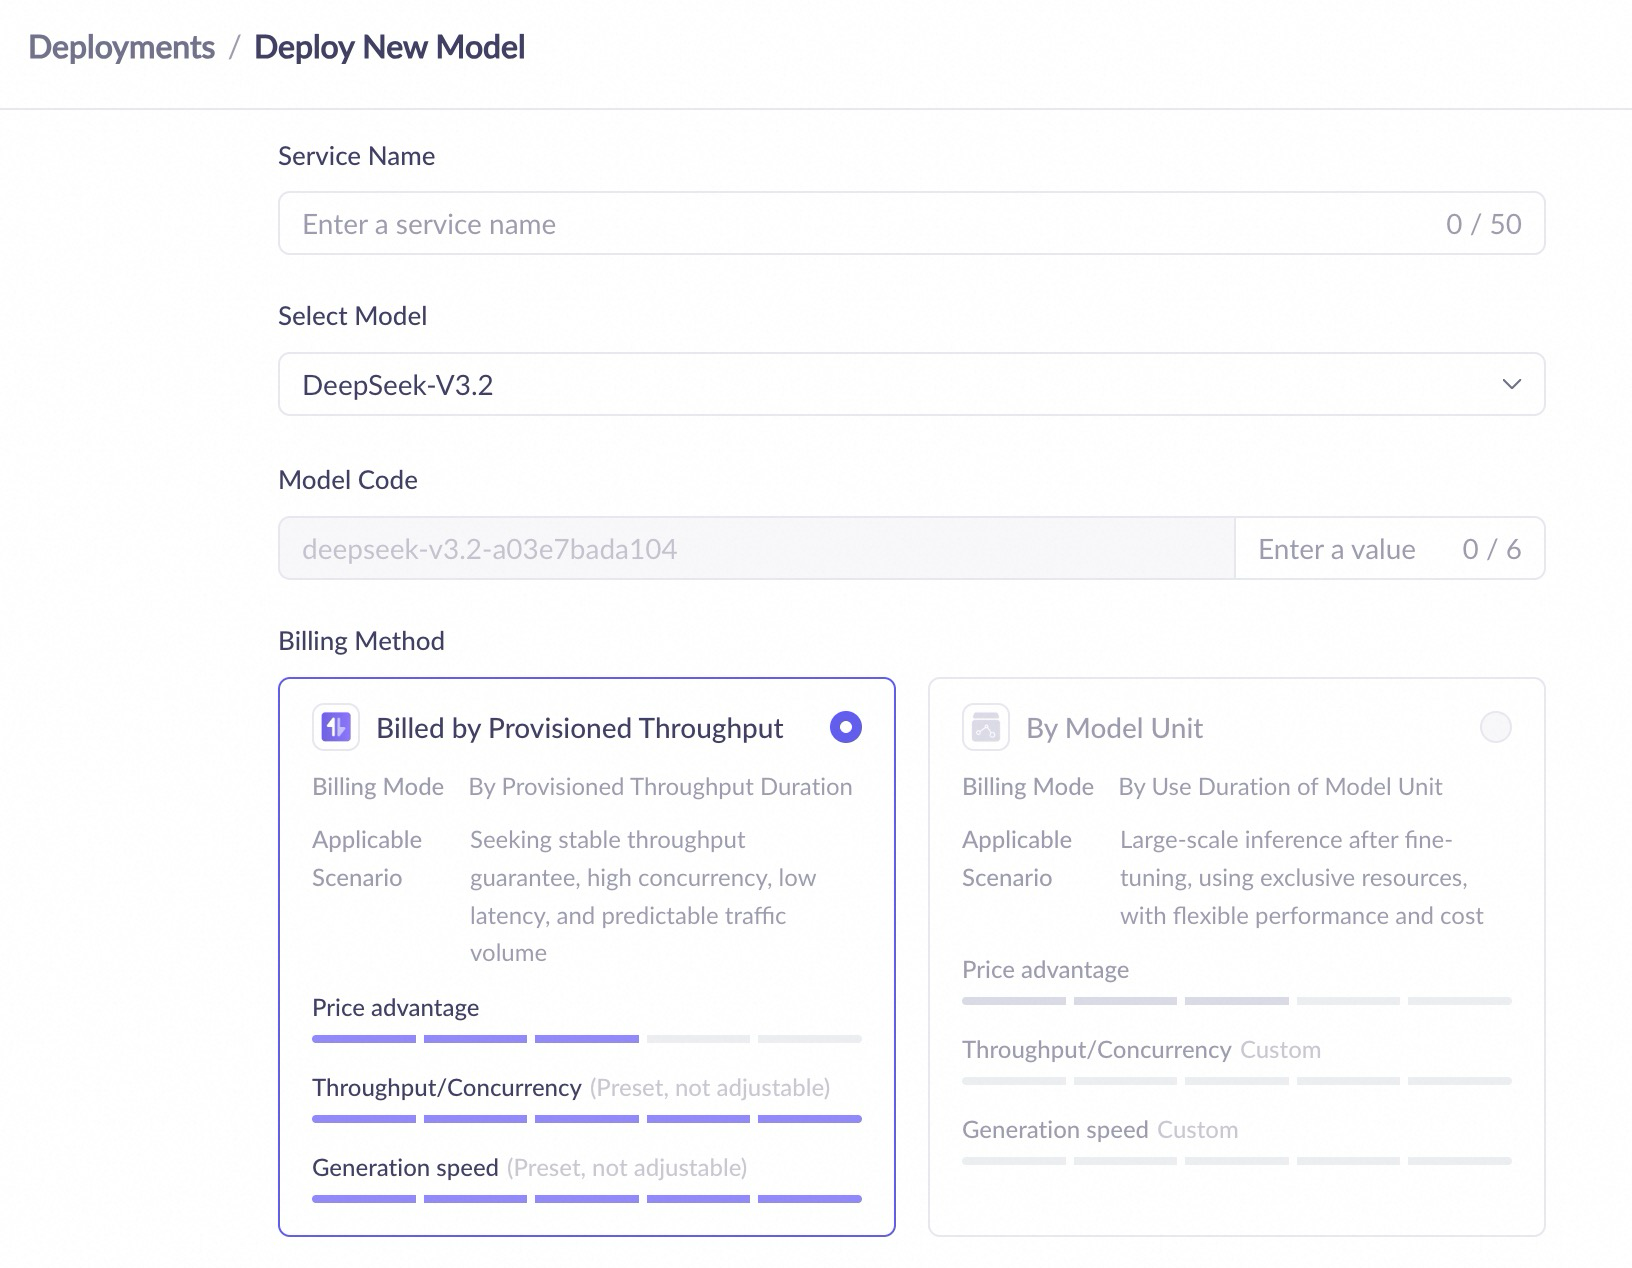
Saisissez un Service Name, complétez Select Model et Billing Method, conservez les autres paramètres par défaut, puis cliquez sur Confirm.
Vous devez avoir effectué le fine-tuning du modèle avant de pouvoir déployer la plupart des modèles.
- Revenez à la liste des déploiements. Lorsque l'état du déploiement passe à Running, le modèle est déployé avec succès.
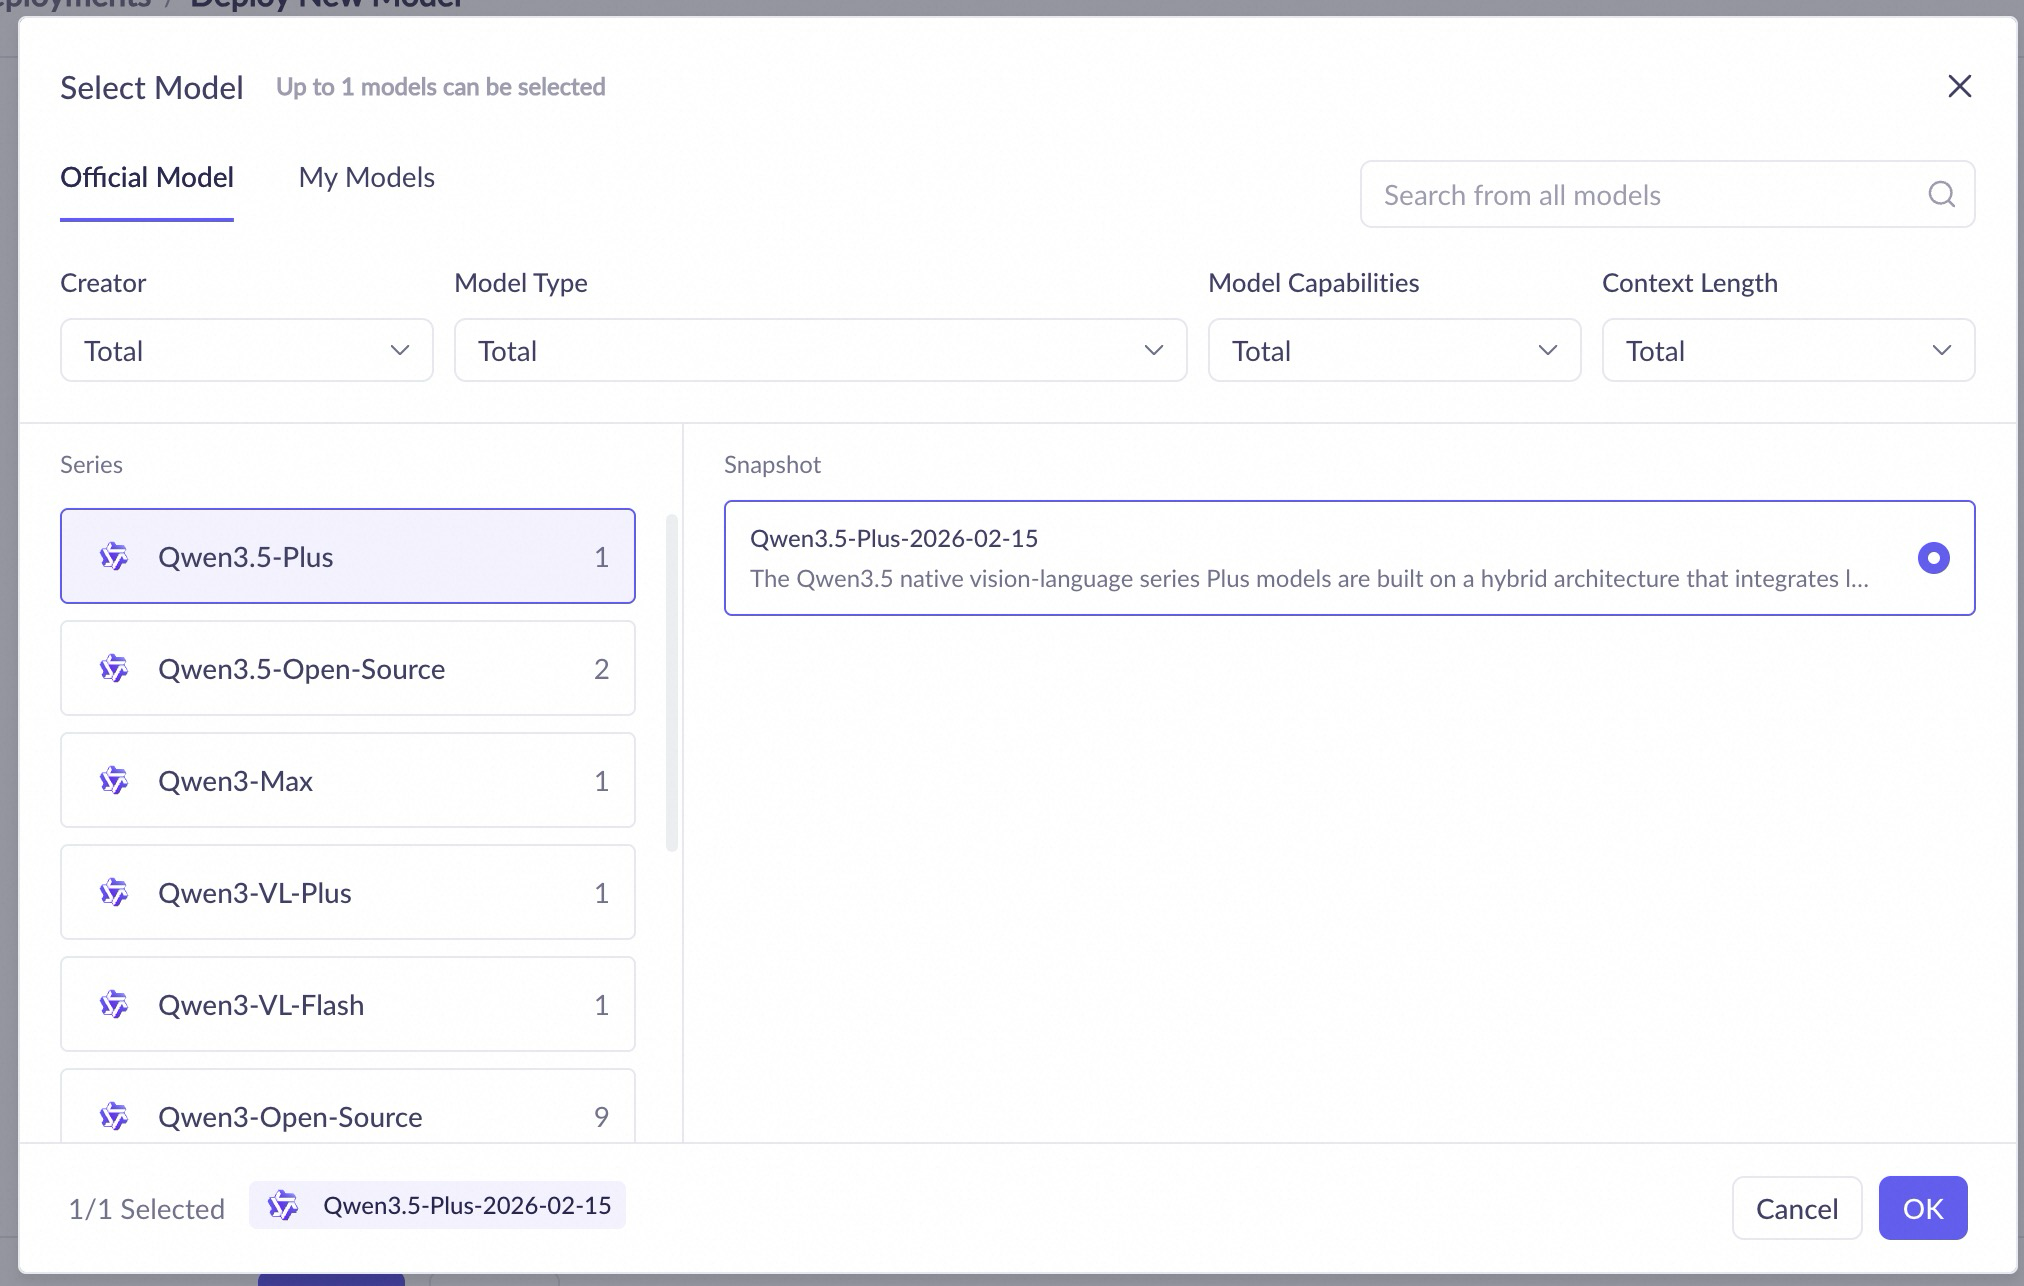
Page de liste des déploiements
Une fois le déploiement réussi, vous pouvez consulter et gérer tous les services de déploiement sur la page de liste des déploiements. Cette page contient les informations suivantes :
- Nom du service : nom du service de déploiement. Cliquez pour consulter les détails du déploiement.
- Nom du modèle : modèle utilisé pour le déploiement.
- Model Code : identifiant unique généré après le déploiement réussi du modèle, utilisé pour spécifier le modèle lors des appels API.
- État du déploiement/État de l'événement : comprend les états En attente de déploiement, Déploiement en cours, Running, Échec du déploiement, Mise hors ligne, Service suspendu, Arrêté, Suppression, Suspension d'abonnement/pour impayé, Reprise du service, Running (modification de configuration), Running (échec de modification), entre autres.
- Mode de facturation : mode de facturation du service de déploiement actuel.
- Détails du déploiement : informations de configuration telles que le type de Model Unit et le nombre de réplicas.
- Détails de limitation : affiche la configuration de limitation de débit du service de déploiement actuel, telles que les RPM (requêtes par minute) et TPM (tokens par minute).
- Période de service : affiche l'heure de création et l'heure d'expiration du service de déploiement.
- Opérations : selon l'état du déploiement et le mode de facturation, vous pouvez effectuer des opérations telles que Update, Monitor, Scale, Renew, Take offline, Delete et Try ; les instances Provisioned Throughput Unit (PTU) permettent également d'ajouter des packs de capacité sur la page Throughput Reservation.
Mettre un service de déploiement hors ligne
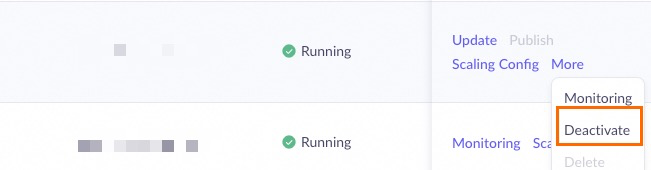
Accédez à la console de déploiement dédié, recherchez le service de déploiement à arrêter, puis cliquez sur l'opération correspondante selon le mode de facturation :
- Model Unit prépayé : cliquez sur Deactivate et confirmez.
- Postpaiement : cliquez sur Delete et confirmez.
FAQ
Puis-je téléverser et déployer mes propres modèles ?
Vous pouvez importer certains modèles open source dans la console My Models (Pékin) ; pour la liste détaillée des modèles pris en charge, consultez : Importation de modèles.
Par ailleurs, la plateforme d'intelligence artificielle d'Alibaba Cloud, PAI, offre la possibilité de déployer vos propres modèles. Vous pouvez consulter Déploiement de grands modèles de langage PAI-LLM pour découvrir la méthode de déploiement.
Comment passer à d'autres modes de facturation ?
Vous ne pouvez que libérer les ressources d'origine, puis créer de nouvelles ressources avec le mode de facturation souhaité.
Il est recommandé de procéder comme suit :
- Déployez de nouvelles ressources avec le mode de facturation souhaité.
- Basculez l'appel API et testez la disponibilité du service.
- Mettez hors ligne et libérez les ressources d'origine.