

Cette rubrique décrit les fonctionnalités d'entrées longues et de cache de préfixe des déploiements PTU (Provisioned Throughput), notamment les règles de consommation de quota, l'utilisation du Provisioned Throughput Quota Calculator et la description des champs de réponse de l'API.
Présentation
Le PTU (Provisioned Throughput Unit) est une méthode de déploiement de modèle qui réserve des ressources de la plateforme afin de garantir une capacité de débit TPM spécifique ; aucune limite de débit ne s'applique dans le quota garanti. Elle convient aux environnements de production à haut débit, à hautes performances et à forte charge, en offrant une capacité de débit stable, une latence plus faible et une meilleure certitude sur les ressources. Par rapport à la facturation par jeton, le TPS (jetons générés par seconde) augmente généralement d'environ 1,5 à 2,0 fois.
Cas d'utilisation :
- Service client intelligent pour applications bancaires (trafic stable, expérience concurrente garantie requise).
- Modération de contenu en temps réel pour les plateformes sociales (traitement stable de tâches de pipeline prévisibles requis).
- API de traduction sur le cloud public (garanties de service de base pour les utilisateurs d'offres standard).
Règles de facturation
费用 = 使用时长 × (输入 TPM 单价 × 输入 TPM + 输出 TPM 单价 × 输出 TPM)
La facturation postpayée est calculée à l'heure : l'unité de durée d'utilisation est l'heure et le prix unitaire est celui de la colonne « 1 heure continue » du tableau ci-dessous ; la facturation prépayée est calculée au jour : l'unité de durée d'utilisation est le jour et le prix unitaire est celui de la colonne « 1 jour continu » du tableau ci-dessous.
- Les commandes prépayées prennent effet en temps réel après le paiement, avec une période de validité de N jours se terminant à 23 h 59 le jour N. Si la commande est passée après 22 h 00, la date d'expiration est automatiquement prolongée d'un jour.
- Après l'expiration d'une commande prépayée, le service est arrêté avec un délai de 2 heures, et les ressources sont conservées pendant 14 heures après l'arrêt, puis libérées.
- Les commandes prépayées prennent en charge la résiliation anticipée ; la partie utilisée est remboursée avec un coefficient de 1,2. Pour plus de détails, consultez les Règles de remboursement pour les rétrogradations de configuration.
- Pour la facturation postpayée, si le compte est en arriéré, les ressources déployées continuent d'être conservées et facturées pendant 24 heures, pendant lesquelles le service reste utilisable normalement. Après 24 heures, le système cesse la facturation, le déploiement du modèle passe à l'état d'arriéré et les ressources sous-jacentes sont supprimées, mais la tâche de déploiement du modèle est conservée. Une fois l'arriéré réglé, le système réalloue les ressources et rétablit l'utilisation (les frais continuent de s'accumuler après le rétablissement). Si vous ne souhaitez pas continuer à engager des frais, vous pouvez supprimer la tâche de déploiement du modèle ; la facturation s'arrête après la suppression réussie.
- Dans ce cas (uniquement sous la stratégie « auto-overflow »), l'en-tête de réponse de l'API inclut :
x-dashscope-ptu-overflow:true. - Pour consulter les statistiques TPM, rendez-vous sur : Surveillance des modèles.
Modèles pris en charge et tarification
- Singapour
- Chine du Nord 2 (Pékin)
- Qwen
- DeepSeek
- Qwen-VL
- GLM
Nom du modèle | Code du modèle | Nombre maximal de jetons d’entrée | Entrée postpayée Par 10 K TPM/heure | Sortie postpayée Par 1 K TPM/heure | Entrée prépayée Par 10 K TPM/jour | Sortie prépayée Par 1 K TPM/jour |
|---|---|---|---|---|---|---|
Qwen3.8-Max | qwen3.8-max | 1M | $4.8 | $1.44 | $57.6 | $17.28 |
Qwen3.7-Flash-2026-07-15 Contactez votre gestionnaire de compte pour l’activer | qwen3.7-flash-2026-07-15 | 128K | $0.072 | $0.031 | $0.864 | $0.374 |
Qwen3.7-Max-2026-05-20 | qwen3.7-max-2026-05-20 | 256K | $1.92 | $1.8 | $72 | $21.6 |
Qwen3.7-Plus-2026-05-26 | qwen3.7-plus-2026-05-26 | 256K | $0.96 | $0.384 | $11.52 | $4.608 |
Qwen3.6-Plus-2026-04-02 | qwen3.6-plus-2026-04-02 | 128K | $1.2 | $0.72 | $14.4 | $8.64 |
Qwen3.5-Plus-2026-04-20 | qwen3.5-plus-2026-04-20 | 128K | $0.96 | $0.576 | $11.52 | $6.912 |
Entrées longues et mise en cache de préfixe
Les coefficients par paliers pour les entrées longues et les réductions liées au cache varient selon le modèle. Le tableau suivant liste les paramètres des modèles actuellement pris en charge :
Modèle | Type | Longueur d’entrée maximale | Réduction liée au cache | Coefficient par paliers pour les entrées longues |
|---|---|---|---|---|
glm-5.2 | PTU | (0, 1M) | 0.25 | 1 |
qwen3.8-flash | PTU | (0, 1M) | 0.125 | 1 |
qwen3.8-max | PTU | (0, 1M) | 0.125 | 1 |
qwen3.7-flash-2026-07-15 | PTU | (0, 1M) | 0.2 | Identique pour l’entrée et la sortie |
deepseek-v4-flash-0731 | PTU | (0, 1M) | 0.1 | 1 |
qwen3.7-plus-2026-05-26 | PTU | PTU | 1 million | 0.2 (les jetons atteignant le cache consomment 20 % de la capacité) |
glm-5.1 | PTU | PTU | 200K | 0.2 (les jetons atteignant le cache consomment 20 % de la capacité) |
deepseek-v4-pro | PTU | PTU | 256K | 0.08 (les jetons atteignant le cache consomment 8 % de la capacité) |
Autres modèles | PTU | PTU | Consultez la console | Consultez la console |
Exemples de calcul (avec glm-5.1)
Provisioned Throughput Quota Calculator
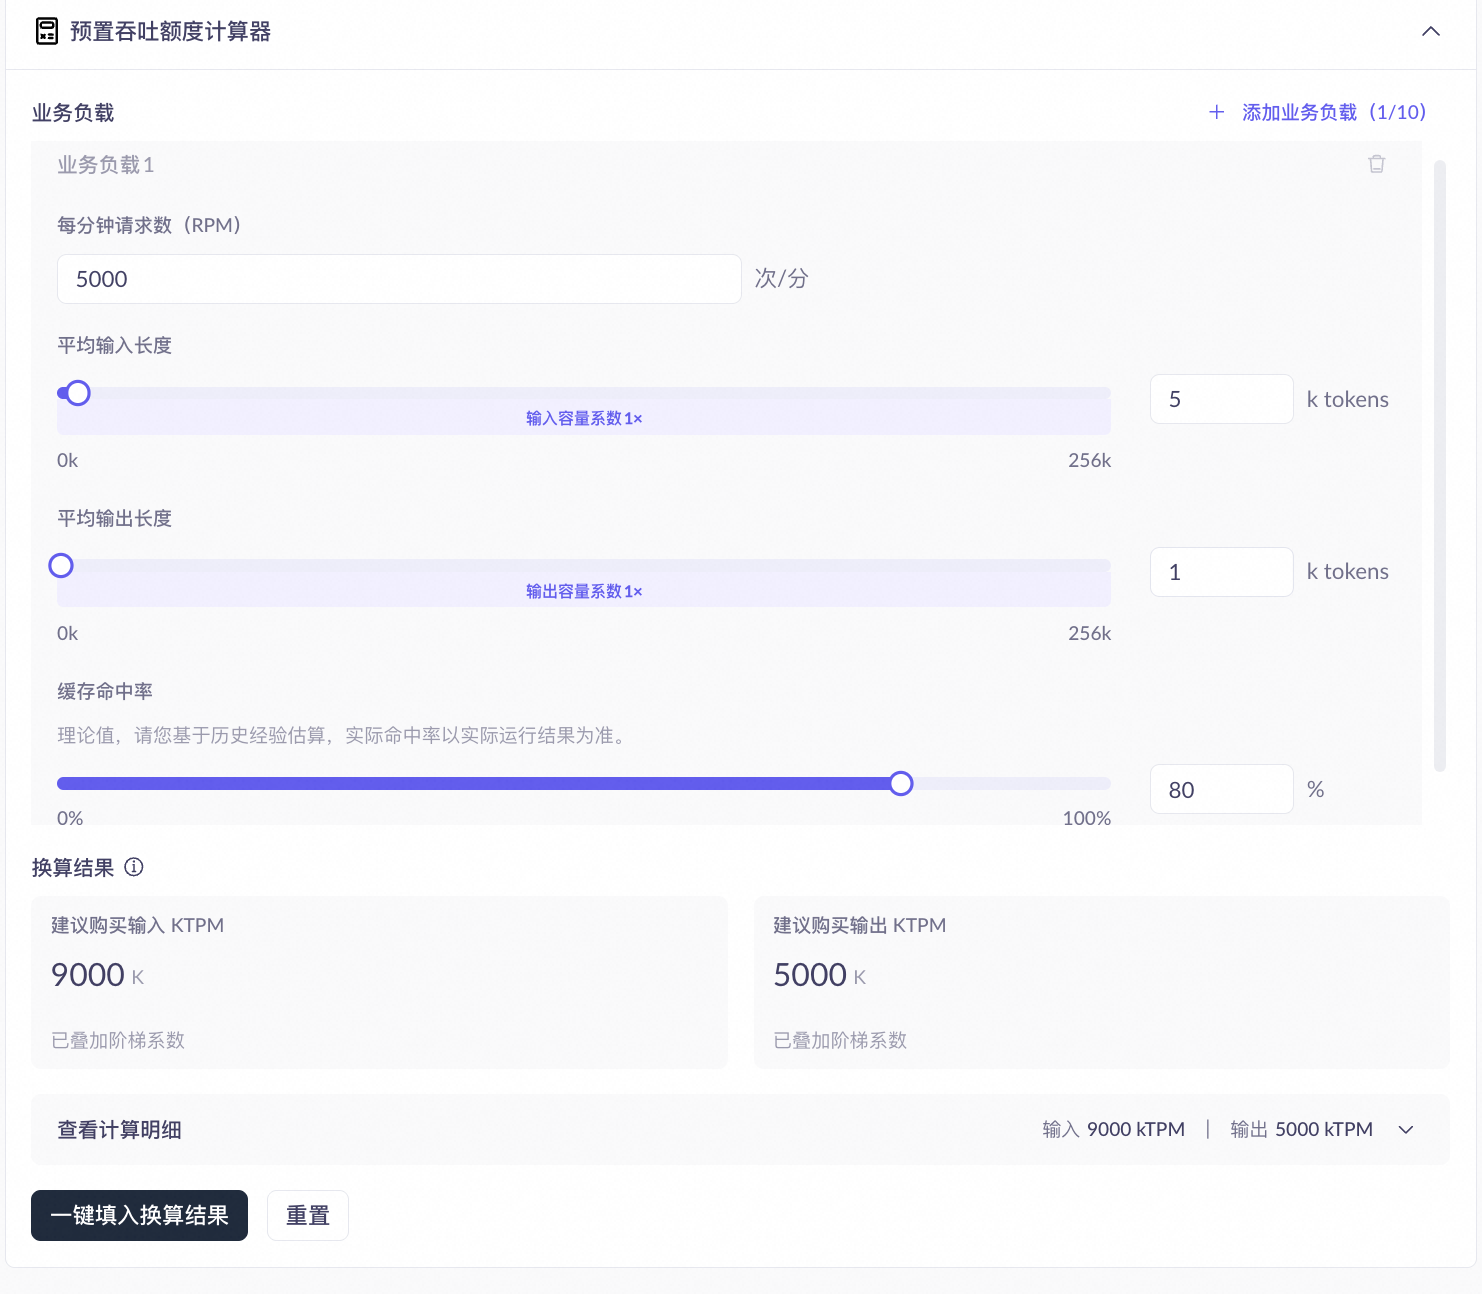
Paramètre | Description | Impact sur les résultats |
|---|---|---|
Requêtes par minute (RPM) | Nombre de requêtes par minute pendant les heures de pointe. | Plus le RPM est élevé, plus le KTPM d’entrée et de sortie recommandé augmente proportionnellement. |
Longueur d’entrée moyenne (jetons) | Nombre moyen de jetons d’entrée par requête. | Plus l’entrée est longue, plus le palier et le coefficient sont élevés, ce qui augmente le KTPM d’entrée recommandé. Les limites des paliers varient selon le modèle ; consultez la console pour les valeurs réelles. |
Longueur de sortie moyenne (jetons) | Nombre moyen de jetons de sortie par requête. | Plus la sortie est longue, plus le coefficient potentiel est élevé, ce qui augmente le KTPM de sortie recommandé. |
Taux de succès du cache (%) | Pourcentage de jetons de préfixe de requête qui atteignent le cache. Le taux de succès réel dépend de la répétition du contenu des requêtes ; reportez-vous aux résultats d’exécution réels. | Un taux de succès plus élevé ralentit la consommation de quota d’entrée, réduisant ainsi le KTPM d’entrée recommandé. Cela affecte uniquement le KTPM d’entrée, pas le KTPM de sortie. |
Champs de réponse de l'API
Les réponses de l'API pour les déploiements PTU incluent les champs suivants liés au quota, qui identifient la méthode de facturation et la consommation de quota :
Champ | Type | Description |
|---|---|---|
| String | Champ de réponse de niveau supérieur (cohérent sur tous les formats d’API). Une valeur |
| Integer | Jetons de quota PTU réellement consommés après conversion (inclut les coefficients par paliers et les réductions liées au cache). |
| Integer | Nombre de jetons qui ont atteint le cache de préfixe. Pour plus de détails, consultez le Cache de contexte. |
- Compatible OpenAI Chat
- OpenAI Responses
- Compatible Anthropic
- DashScope
Champ | Chemin JSON | Description |
|---|---|---|
|
| Nombre de jetons mis en cache côté entrée |
|
| Consommation de quota PTU côté entrée |
|
| Consommation de quota PTU côté sortie |
Surveillance et vérification
Vous pouvez surveiller les déploiements PTU via la fonctionnalité de surveillance des modèles sur la plateforme Model Studio. Les métriques suivantes sont pertinentes pour les entrées longues et la mise en cache :
- Utilisation du PTU : trois courbes indépendantes pour l'entrée, la sortie et la sortie en mode réflexion. Dans les scénarios d'entrées longues, les coefficients par paliers peuvent faire dépasser l'utilisation de 100 %. Il s'agit d'un comportement attendu.
- Utilisation des jetons et succès du cache : inclut la série de données
cached_tokenspour afficher la proportion de succès du cache par rapport au total des entrées. - Nombre d'appels dans le quota et hors quota : affiche la proportion de requêtes qui dépassent le quota PTU (sous la stratégie « auto-overflow », les requêtes basculent vers la facturation au paiement à l'utilisation ; sous la stratégie « use-only-PTU-capacity », des erreurs 429 sont renvoyées).
Mise à l'échelle
Cliquez sur le bouton Mise à l'échelle pour ajuster vous-même, manuellement, le débit (nombre d'instances). Pour les règles détaillées de réduction des frais et de remboursement, reportez-vous à : Règles de remboursement pour les rétrogradations de configuration.
FAQ
Q : Que se passe-t-il lorsque le quota PTU est dépassé ?
Q : Que se passe-t-il lorsque le quota PTU est dépassé ?
service_tier de la réponse de l'API est soit absent, soit renvoie default, et l'en-tête de réponse inclut x-dashscope-ptu-overflow:true, de sorte que le service n'est pas interrompu ; sous la stratégie « use-only-PTU-capacity », les requêtes qui dépassent le quota renvoient une erreur 429 et aucun frais supplémentaire n'est facturé.Q : Que se passe-t-il lorsqu'une seule entrée dépasse la limite du modèle ?
Q : Que se passe-t-il lorsqu'une seule entrée dépasse la limite du modèle ?
Q : Comment vérifier que la mise en cache fonctionne ?
Q : Comment vérifier que la mise en cache fonctionne ?
cached_tokens dans la réponse de l'API. Une valeur supérieure à 0 indique un succès du cache de préfixe. Les jetons atteignant le cache consomment le quota selon le coefficient de réduction du modèle (pour les taux de réduction spécifiques, consultez Entrées longues et mise en cache de préfixe). Vous pouvez également consulter les tendances dans le graphique d'utilisation des jetons sur la page de surveillance de la console.Q : Que faire si cached_tokens est toujours à 0 et que la mise en cache ne fonctionne pas ?
Q : Que faire si cached_tokens est toujours à 0 et que la mise en cache ne fonctionne pas ?
Q : Pourquoi l'utilisation dépasse-t-elle 100 % ?
Q : Pourquoi l'utilisation dépasse-t-elle 100 % ?