

Lorsque vous utilisez Wan pour la génération d'images , si le Guide des prompts texte-vers-vidéo/image-vers-vidéo ne répond pas à vos besoins de personnalisation en matière de styles spécifiques, de personnages IP ou d'effets visuels , recourez à l' affinage de modèle .
Périmètre
- Région prise en charge : Ce document s'applique uniquement à la région de Singapour. Vous devez utiliser une clé API provenant de cette région.
- Méthode d'affinage prise en charge : Affinage efficace SFT-LoRA.
-
Modèles pris en charge :
- Génération d'images (texte-vers-image / image-vers-image) : wan2.7-image-pro, wan2.7-image.
Comment affiner un modèle
- Texte-vers-image
- Image-vers-image
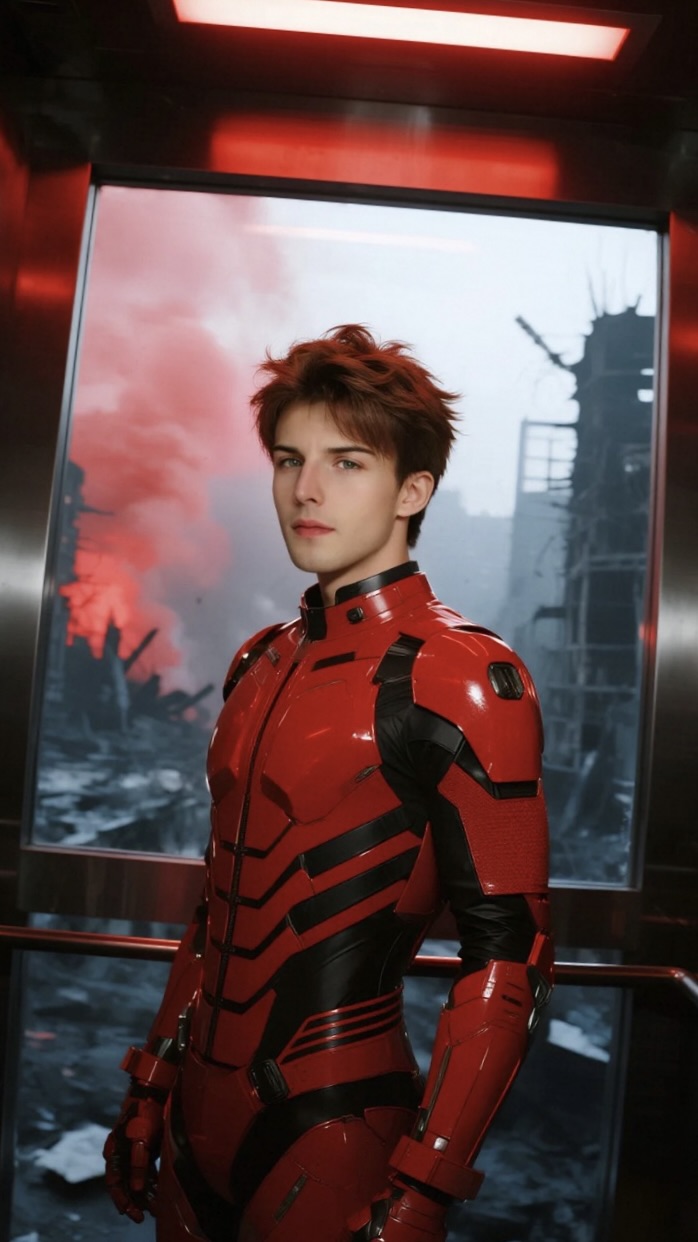
| Prompt d'entréeA person in a crowded morning rush hour subway car, holding onto the handrail, with blurred passengers in the background and tunnel lights visible through the windows, wearing an ordinary office worker white shirt and black trousers, standing facing the camera, half-body shot, realistic candid feel. | Image générée (avant affinage - texte-vers-image)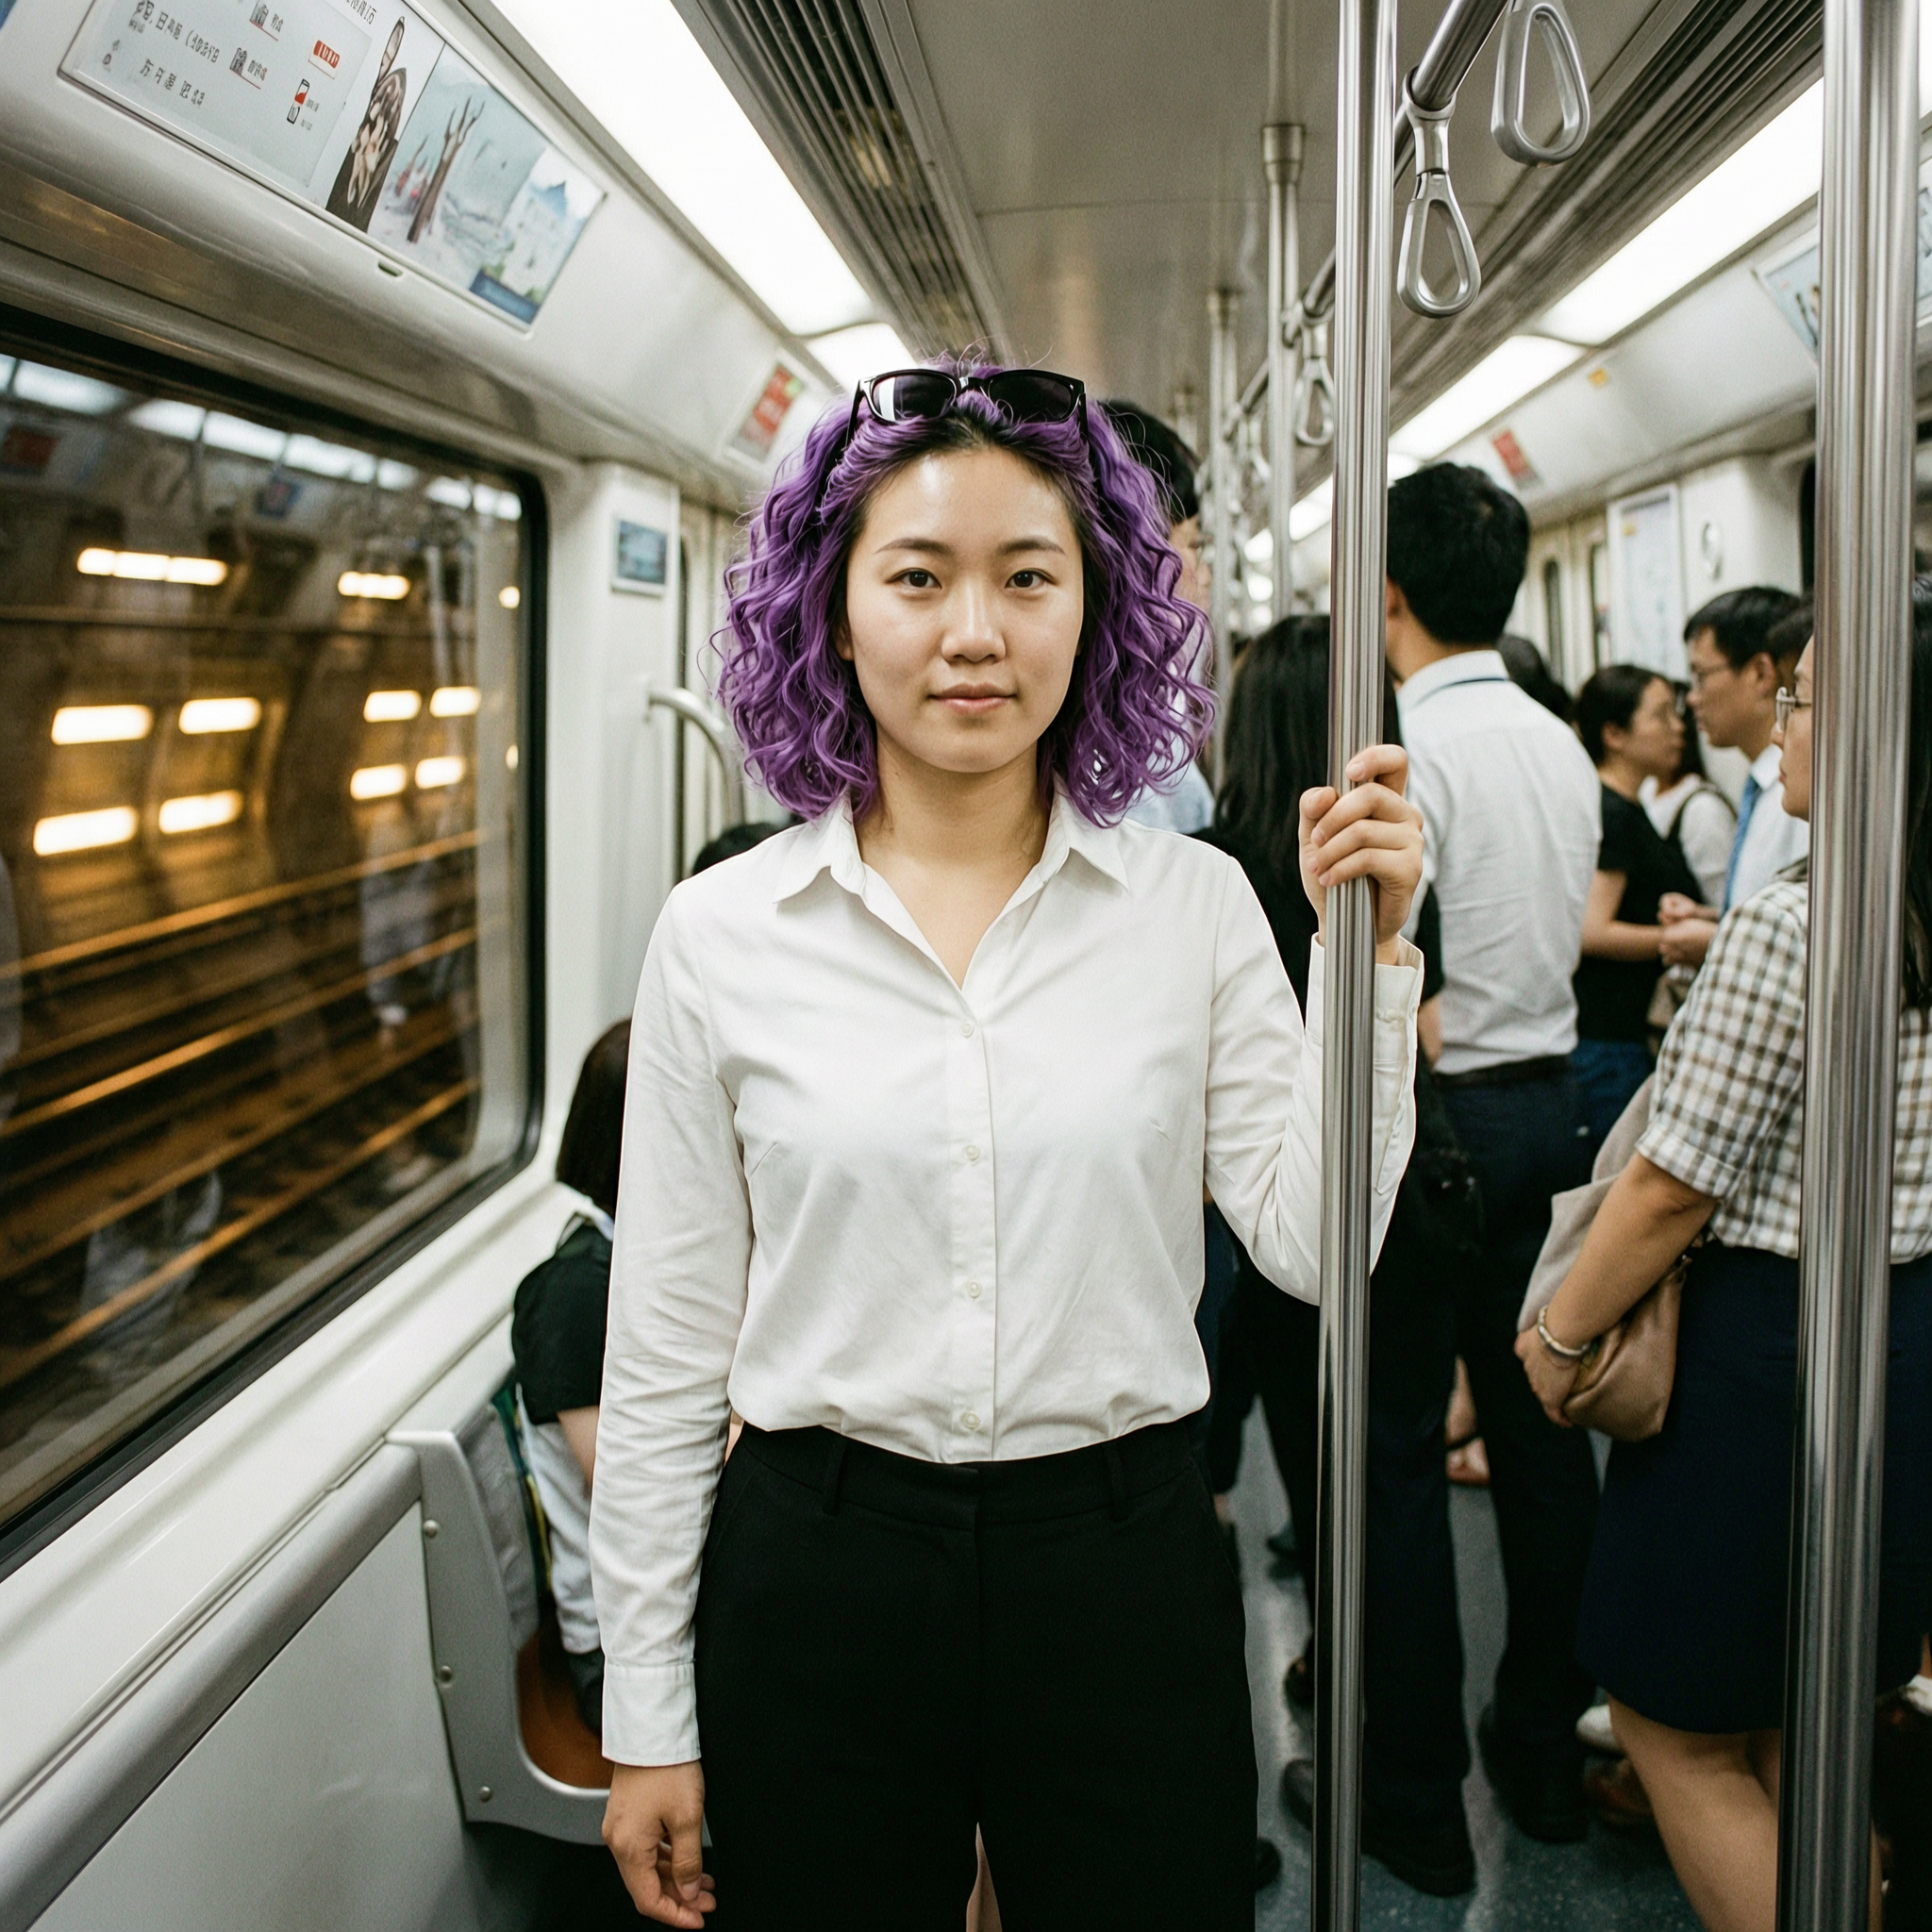 Sans image de référence, le modèle ne peut pas générer un personnage spécifique. | Image générée (après affinage)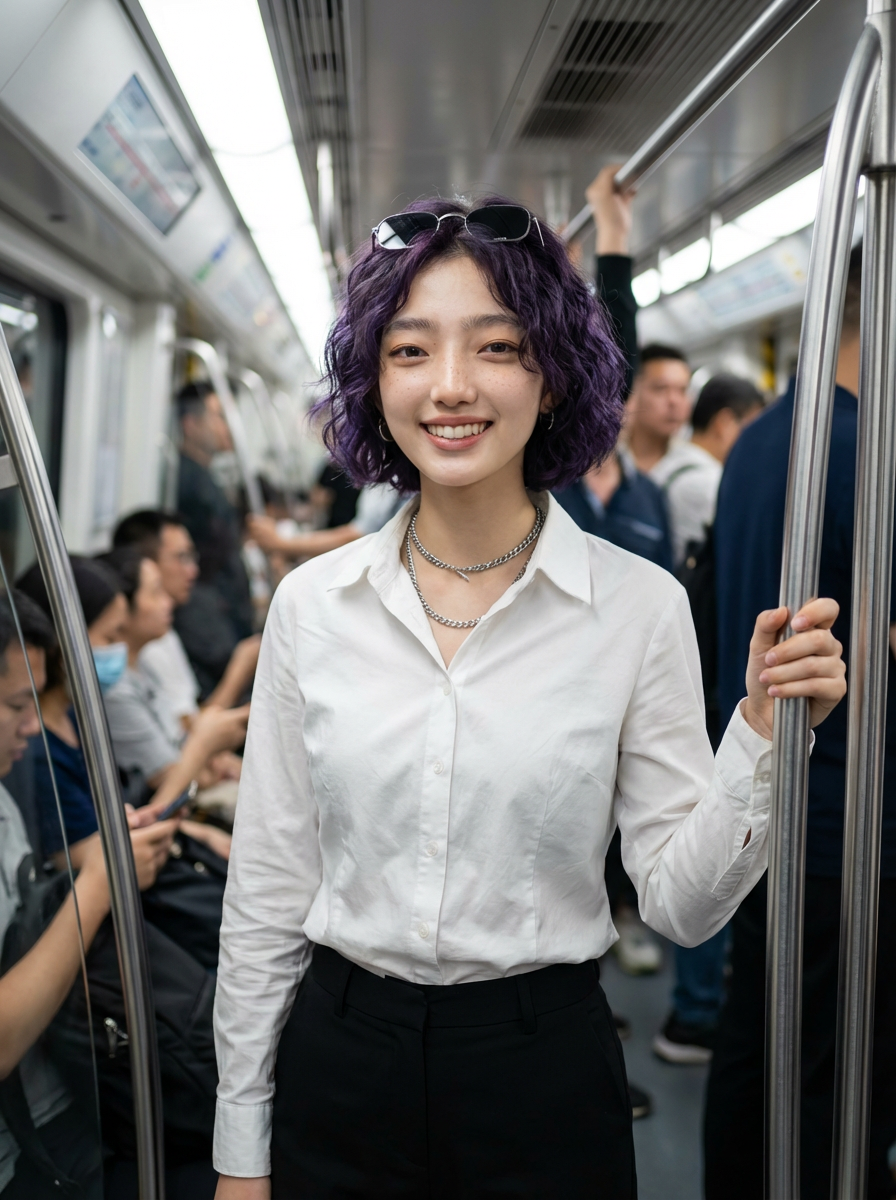 Après affinage, le modèle reproduit fidèlement le personnage spécifique issu du jeu d'entraînement. |
Étape 1 : Télécharger le jeu de données
Téléchargez votre jeu de données local (au format .zip) vers la plateforme Alibaba Cloud Model Studio et obtenez l'ID du fichier (file_idid).
Exemple de données d'entraînement : Pour le format, consultez la section Jeu d'entraînement.
- Génération d'images - texte-vers-image : wan-image-t2i-training-dataset.zip
- Génération d'images - image-vers-image : wan-image-i2i-training-dataset.zip
Cet exemple utilise le mode texte-vers-image et télécharge uniquement le jeu d'entraînement. Le système divise automatiquement une partie du jeu d'entraînement pour constituer le jeu de validation.
id. Il s'agit de l'identifiant unique du jeu de données téléchargé.
Étape 2 : Affiner le modèle
Étape 2.1 : Créer une tâche d'affinage
Utilisez l'ID de fichier obtenu à l'étape 1 pour lancer une tâche d'entraînement. Exemple de requête Remplacez<replace_with_training_dataset_file_id> par le id obtenu à l'étape précédente. Pour la référence complète des paramètres et les contraintes de format, consultez la section Hyperparamètres.
Hyperparamètres
Hyperparamètres
Paramètre | Type | Obligatoire | Description | Valeur recommandée |
|---|---|---|---|---|
max_steps | int | Oui | Nombre total d'étapes d'entraînement. Paramètre central qui détermine le nombre total d'itérations d'entraînement. Nous recommandons au moins 500 étapes pour garantir la convergence du modèle, et une valeur plus élevée pour les jeux de données volumineux. | 800 |
eval_steps | int | Oui | Intervalle de validation. La valeur doit être ≥ 0. Spécifie la fréquence (en étapes) à laquelle évaluer le modèle pendant l'entraînement. Un checkpoint est également sauvegardé à chaque intervalle. | 200 |
learning_rate | float | Oui | Taux d'apprentissage. Contrôle l'amplitude des mises à jour des poids du modèle. Une valeur trop élevée peut dégrader les performances du modèle, tandis qu'une valeur trop faible peut entraîner des changements insignifiants. Nous recommandons d'utiliser la valeur par défaut. | 3e-5 |
generation_type | string | Oui | Mode de génération. Utilisez | t2i |
max_pixels | string | Oui | Résolution maximale des images d'entraînement. Par exemple, « 1k » ou « 2k » (1K = 1024×1024, 2K = 2048×2048). Définit une limite supérieure sur le nombre total de pixels (largeur × hauteur) pour les images du jeu d'entraînement. Le système réduit uniquement les images qui dépassent cette valeur ; les images inférieures à la limite restent inchangées. Nous recommandons de maintenir la cohérence entre les trois paramètres liés à la résolution ( | texte-vers-image : « 2k » image-vers-image : « 1k » |
val_img_size | string | Oui | Résolution de génération des images de validation. Par exemple, « 1k » ou « 2k » (1K = 1024×1024, 2K = 2048×2048). Résolution cible pour les images générées lors de l'évaluation de validation. | texte-vers-image : « 2k » image-vers-image : « 1k » |
max_token_length | string | Oui | Longueur maximale des tokens par étape. Par exemple, « 1k » ou « 2k ». Ce paramètre, conjointement avec | texte-vers-image : « 2k » image-vers-image : « 1k » |
gradient_clip | float | Oui | Écrêtage du gradient. Seuil d'écrêtage de la norme globale du gradient pour tous les paramètres entraînables, utilisé pour empêcher l'explosion des gradients. Définissez à -1 pour désactiver l'écrêtage. | 0.5 |
weight_decay | float | Oui | Décroissance des poids. Coefficient de décroissance des poids découplé pour l'optimiseur AdamW. Il s'applique à tous les paramètres entraînables et sert de régularisation pour éviter le surapprentissage. | 0.02 |
lora_rank | int | Oui | Rang LoRA. Rang (dimension) des matrices de faible rang LoRA. Cette valeur détermine le nombre de paramètres entraînables pour l'affinage. Une valeur plus grande augmente la capacité d'ajustement du modèle mais ralentit l'entraînement. La valeur doit être une puissance de 2 (par exemple, 16, 32, 64). | 32 |
save_total_limit | int | Non | Limite de sauvegarde des checkpoints. Nombre maximal de checkpoints de modèle à sauvegarder. Le système conserve uniquement les N checkpoints les plus récents, où N correspond à cette valeur. | 10 |
split | float | Non | Ratio de division du jeu d'entraînement. La plage de valeurs est (0, 1). Ce paramètre prend effet uniquement lorsque | 0.9 |
- Texte-vers-image (t2i) : environ 77 minutes pour 300 étapes.
- Image-vers-image (i2i) : environ 110 minutes pour 300 étapes.
output :
job_id: L'ID de la tâche, utilisé pour interroger la progression.finetuned_output: Le nom du modèle affiné. Vous devez utiliser ce nom pour le déploiement et l'invocation ultérieurs.status: Le statut de l'entraînement. Après la création d'une tâche d'affinage, le statut initial est PENDING, indiquant que l'entraînement n'a pas encore commencé.
Étape 2.2 : Interroger le statut de la tâche d'affinage
Utilisez lejob_id obtenu à l'étape 2.1 pour interroger la progression de la tâche. Interrogez régulièrement l'API suivante jusqu'à ce que le status passe à SUCCEEDED.
Exemple de requête
Remplacez <replace_with_fine_tuning_job_id> dans l'URL par la valeur de job_id.
output :
status: Lorsque sa valeur passe à SUCCEEDED, l'entraînement du modèle est terminé et vous pouvez procéder au déploiement du modèle.usage: Le nombre total de tokens consommés pendant l'entraînement du modèle, utilisé à des fins de facturation.
Étape 3 : Déployer le modèle affiné
Étape 3.1 : Déployer le modèle en tant que service en ligne
Une fois que le statut de la tâche d'affinage passe à SUCCEEDED, déployez le modèle en tant que service en ligne. Exemple de requête Remplacez<replace_with_model_name> par la valeur finetuned_output issue de la sortie de la section Créer une tâche d'affinage.
output :
deployed_model: Le nom du modèle déployé, utilisé pour interroger le statut du déploiement et invoquer le modèle.status: Le statut du déploiement du modèle. Après le déploiement du modèle affiné, le statut initial est PENDING, indiquant que le déploiement n'a pas encore commencé.
Étape 3.2 : Interroger le statut du déploiement
Interrogez le statut du déploiement. Interrogez régulièrement l'API suivante jusqu'à ce que lestatus passe à RUNNING.
<replace_with_deployed_model> par la valeur deployed_model issue de la sortie de l'étape 3.1.
output :
status: Lorsque le statut passe à RUNNING, le modèle a été déployé avec succès et vous pouvez commencer à l'invoquer.deployed_model: Le nom du modèle déployé.
Étape 4 : Invoquer le modèle pour générer des images
Une fois le modèle déployé avec succès (le status du déploiement est RUNNING), vous pouvez commencer à effectuer des invocations.
type dans message.content.Étape 4.1 : Créer une tâche de génération d'images et obtenir le task_id
Étape 4.1 : Créer une tâche de génération d'images et obtenir le task_id
<replace_with_deployed_model> par la valeur deployed_model obtenue à l'étape précédente.- Texte-vers-image
- Image-vers-image
task_id pour interroger le résultat à l'étape suivante.| Champ | Type | Obligatoire | Description | Exemple |
|---|---|---|---|---|
| model | string | Oui | Nom du modèle. Vous devez utiliser un modèle affiné qui a été déployé avec succès et dont le statut est RUNNING. | wan2.7-image-pro-xxxxxxxxxxxx |
| input.messages[].content[].text | string | Oui | Prompt textuel. Nous recommandons d'inclure le mot déclencheur pour activer le style LoRA. | s86b5p, A person in a quiet private library on a peaceful afternoon... |
| parameters.size | string | Non | Résolution de l'image de sortie.
| 2K |
| parameters.n | integer | Non | Nombre d'images à générer. Valeurs valides : 1-4. Par défaut : 1. | 1 |
Étape 4.2 : Interroger les résultats par task_id
Étape 4.2 : Interroger les résultats par task_id
task_id jusqu'à ce que task_status passe à SUCCEEDED. Récupérez l'URL de l'image depuis output.choices[].message.content[].image.Exemple de requête
Remplacez 86ecf553-d340-4e21-xxxxxxxxx par votre task_id réel.
L'URL de l'image est valide pendant 24 heures. Téléchargez l'image rapidement.
Créer des jeux de données personnalisés
Outre l'utilisation des exemples de données fournis dans ce document pour découvrir le workflow de fine-tuning, vous avez la possibilité de constituer vos propres jeux de données pour cette opération.
Un jeu de données doit comporter un jeu d'entraînement (obligatoire) et un jeu de validation (facultatif ; le système peut le fractionner automatiquement à partir du jeu d'entraînement). Regroupez tous les fichiers au format .zip. Les noms de fichiers ne doivent contenir que des caractères anglais, des chiffres, des traits de soulignement ou des tirets.
Format du jeu de données
Jeu d'entraînement : obligatoire
- Text-to-image
- Image-to-image
- Multi-image-to-image
- Exemple de jeu d'entraînement : wan-image-t2i-training-dataset.zip
-
Structure du répertoire de l'archive Zip :
-
Fichier d'annotation (data.jsonl) : chaque ligne correspond à un échantillon d'entraînement et doit constituer un objet JSON valide.
- Le fichier data.jsonl doit adopter le format JSONL délimité par des lignes (un objet JSON indépendant par ligne). Le format tableau JSON (où le premier caractère du fichier est
[) est interdit. - Les fichiers contenus dans l'archive zip doivent suivre une structure plate. Les sous-répertoires sont interdits. Les noms de fichiers n'acceptent que des caractères anglais (les caractères chinois, les espaces et les caractères spéciaux sont proscrits).
Jeu de validation : facultatif
Le jeu de validation comprend un fichier d'annotation (data.jsonl) ainsi que des images de référence optionnelles (nécessaires uniquement en mode image-to-image). Aucune image cible n'est requise. À chaque point de contrôle d'évaluation, la tâche d'entraînement appelle automatiquement le service de modèle afin de générer des images d'aperçu à partir des prompts (et des images de référence) du jeu de validation.
-
Jeu de validation:
- Text-to-image : wan-image-t2i-valid-dataset.zip
- Image-to-image : wan-image-i2i-valid-dataset.zip
-
Structure du répertoire de l'archive Zip :
-
Fichier d'annotation (data.jsonl) : chaque ligne correspond à un échantillon de validation et doit constituer un objet JSON.
- Text-to-image
- Image-to-image
- Multi-image-to-image
Volume de données et limites
- Volume de données : nous recommandons de fournir au moins 25 images (50 ou plus pour obtenir de meilleurs résultats). Assurez-vous d'utiliser le même personnage ou le même style à travers diverses scènes et angles, tout en maintenant une cohérence dans les descriptions de contenu.
- Archive Zip : lors d'un téléchargement via l'API, la taille totale de l'archive ne doit pas dépasser 1 Go.
-
Exigences relatives aux images d'entraînement :
- Formats d'image pris en charge : BMP, JPEG, PNG et WEBP.
- La résolution des images ne doit pas excéder 4096×4096.
- La taille unitaire d'un fichier image est limitée à 20 Mo.
Collecte et nettoyage des données
1. Définir le scénario de fine-tuning
Wan prend en charge les scénarios de fine-tuning suivants pour la génération d'images :- Stylisation de personnage IP : entraîner le modèle à reproduire le style graphique d'un personnage spécifique, tel qu'un personnage d'anime ou une mascotte.
- Style visuel fixe : améliorer la capacité du modèle à restituer un style artistique précis, comme l'illustration flat design, la peinture à l'encre ou le pixel art.
- Génération de scènes spécifiques : reproduire des schémas de composition ou des modèles de scène particuliers, notamment pour des visuels de présentation produit ou des mises en page d'affiches.
2. Obtenir les ressources brutes
- Génération et sélection par IA : utilisez le modèle de base Wan pour produire des images en masse, puis sélectionnez manuellement les échantillons de haute qualité correspondant le mieux à l'effet recherché. Cette approche est la plus couramment employée.
- Photographie réelle : si votre objectif consiste à obtenir des scènes hautement réalistes (telles que de véritables photos de produits ou des portraits photographiques), privilégiez l'utilisation de prises de vue réelles.
- Rendu via logiciel 3D : pour les scènes exigeant un contrôle précis des détails ou des styles de rendu 3D, nous conseillons de créer les ressources sources à l'aide de logiciels 3D (comme Blender ou C4D).
3. Nettoyer les données
Dimension | Bonne pratique | Anti-modèle |
|---|---|---|
Cohérence | Les caractéristiques fondamentales doivent présenter une forte cohérence. Par exemple : lors de l'entraînement d'un « style d'illustration flat design », toutes les images doivent partager la même épaisseur de trait et la même palette chromatique. | Mélange de styles. Le jeu de données mêle des images de style empâté et de style flat design. Le modèle ne parvient pas à déterminer quel style apprendre. |
Diversité | Une grande diversité de sujets et de scènes est préférable. Couvrez différents sujets (hommes, femmes, personnes âgées, enfants, chats, chiens, bâtiments) et diverses compositions (plan large, gros plan, très gros plan). Variez également les résolutions et les ratios d'aspect autant que possible. | Scène ou sujet unique. Toutes les images montrent « une personne en rouge devant un mur blanc ». Le modèle risque d'associer erronément les « vêtements rouges » et le « mur blanc » au style lui-même, ce qui compromettra la génération dans d'autres contextes. |
Équilibre | Proportions équilibrées entre les types de données. Si plusieurs styles sont inclus, leurs quantités respectives doivent être approximativement égales. | Proportions fortement déséquilibrées. 90 % d'images portrait contre 10 % d'images paysage. Les performances du modèle risquent d'être médiocres lors de la génération d'images paysage. |
Propreté | Images nettes et sans artefacts. Privilégiez des ressources originales exemptes d'éléments perturbateurs. | Présence d'éléments perturbateurs. Les images contiennent des filigranes, des bordures noires apparentes ou du bruit numérique. Le modèle pourrait intégrer ces filigranes comme faisant partie intégrante du style. |
Résolution | Résolution modérée. Nous recommandons que la résolution des images d'entraînement n'excède pas 2048×2048. Des images trop volumineuses allongent inutilement la durée d'entraînement. | Variation excessive de la résolution. Mélanger des petites images de 256×256 et des grandes images de 4096×4096 dans le jeu d'entraînement nuit à la stabilité de l'apprentissage. |
Annotation d'images : rédaction des prompts
Dans le fichier d'annotation du jeu de données (data.jsonl), chaque image est associée à un prompt. Ce dernier décrit le contenu de l'image cible. La qualité du prompt conditionne directement l'apprentissage du modèle.
Formule de rédaction des prompts
Prompt = [Description du sujet] + [Description de l'arrière-plan] + [Mot déclencheur] + [Description du style]
Composant du prompt | Description | Recommandation | Exemple |
|---|---|---|---|
Description du sujet | Décrit les personnes ou les objets présents dans l'image | Obligatoire | Une jeune femme portant une longue chemise rouge de style chinois... |
Description de l'arrière-plan | Décrit l'environnement dans lequel se trouve le sujet | Obligatoire | L'arrière-plan est un mur de briques recouvert de lierre vert... |
Mot déclencheur | Un terme rare sans signification concrète | Recommandé | s86b5p ou m01aa |
Description du style | Décrit en détail le style artistique et les caractéristiques visuelles de l'image cible | Recommandé | Rendu en style d'illustration flat design avec des lignes fluides et épurées, des couleurs vives et uniformes pour accentuer le relief et l'esthétique moderne. |
À propos des mots déclencheurs
À propos des mots déclencheurs
- Qu'est-ce qu'un mot déclencheur ? Il agit comme une « ancre visuelle ». Étant donné que de nombreux styles visuels complexes (tels qu'une texture d'image singulière ou une palette chromatique spécifique) s'avèrent difficiles à décrire fidèlement par le texte, un mot déclencheur indique explicitement au modèle : lorsque tu rencontres s86b5p, tu dois impérativement générer ce style visuel précis.
- Pourquoi l'utiliser ? Le fine-tuning établit des correspondances entre le « texte » et les « caractéristiques de l'image ». Le mot déclencheur associe un « style indescriptible » à un terme unique, permettant ainsi au modèle de cibler précisément l'objectif.
-
Si nous disposons déjà d'un mot déclencheur, pourquoi continuer à décrire le style en détail ?
Ces deux éléments remplissent des fonctions distinctes et se complètent efficacement.
- Description du style : elle explique « à quoi l'image doit ressembler ». Elle renseigne le modèle sur le style artistique de base et les caractéristiques visuelles générales. Cette description reste généralement constante entre plusieurs échantillons.
- Mot déclencheur : il précise « l'apparence exacte du style ». Il incarne des caractéristiques visuelles uniques impossibles à transcrire fidèlement par des mots.
Évaluer les modèles à l'aide des jeux de validation
Spécifier le jeu de validation
Toute tâche de fine-tuning nécessite un jeu d'entraînement, tandis que le jeu de validation demeure facultatif. Vous pouvez opter pour un fractionnement automatique par le système ou télécharger manuellement un jeu de validation. Voici les méthodes disponibles :
Méthode 1 : aucun jeu de validation téléchargé (fractionnement automatique par le système)
Lors de l'appel de l'API de fine-tuning des modèles de génération vidéo et d'images, si aucun jeu de validation n'est fourni séparément (c'est-à-dire si le paramètrevalidation_file_ids est omis), le système extrait automatiquement un jeu de validation depuis le jeu d'entraînement selon le paramètre split, dont la valeur par défaut est 0,9. Ainsi, 90 % des données servent à l'entraînement et 10 % à la validation.
Méthode 2 : télécharger manuellement un jeu de validation (spécifié via validation_file_ids)
Si vous souhaitez utiliser vos propres données préparées pour évaluer les points de contrôle plutôt que de dépendre du fractionnement aléatoire du système, téléchargez un jeu de validation personnalisé. Remarque : dès lors que vous choisissez le téléchargement manuel, le système ignore totalement les règles de fractionnement automatique susmentionnées et se fie exclusivement aux données que vous avez fournies pour la validation.Procédure : télécharger manuellement un jeu de validation
Procédure : télécharger manuellement un jeu de validation
-
Préparer le jeu de validation : regroupez les données de validation dans un fichier
.zipdistinct. Reportez-vous à la section Format du jeu de validation. -
Télécharger le jeu de validation : appelez l'API de fine-tuning des modèles de génération vidéo et d'images pour envoyer ce fichier
.zipde validation et récupérer un ID de fichier dédié. -
Spécifier le jeu de validation lors de la création de la tâche : lors de l'appel de l'API de fine-tuning des modèles de génération vidéo et d'images, renseignez cet ID de fichier dans le paramètre
validation_file_ids.
Sélectionner le meilleur point de contrôle pour le déploiement
Pendant l'entraînement, le système sauvegarde périodiquement des « instantanés » du modèle (appelés points de contrôle). Par défaut, seul le dernier point de contrôle est exporté comme modèle final après fine-tuning. Toutefois, les points de contrôle intermédiaires peuvent offrir de meilleures performances que la version finale. Vous avez donc la possibilité de sélectionner celui qui vous satisfait le plus pour le déploiement.
Le système exécute les points de contrôle sur le jeu de validation et génère des images d'aperçu selon l'intervalle défini par le paramètre eval_steps des Hyperparamètres (hyper_parameters).
- Méthode d'évaluation : jugez les résultats en observant directement les images d'aperçu générées.
- Critères de sélection : identifiez le point de contrôle offrant les meilleurs rendus et le style le plus fidèle à vos attentes.
Procédure
Étape 1 : consulter les aperçus générés par les points de contrôle
Étape 1 : consulter les aperçus générés par les points de contrôle
Étape 1.1 : interroger la liste des points de contrôle validés
Cette API renvoie uniquement les points de contrôle ayant passé la validation et généré avec succès des images d'aperçu. Les points de contrôle ayant échoué n'apparaissent pas dans la liste.Exemple de requête<replace_with_fine_tuning_job_id>: remplacez intégralement cette valeur par le paramètre de sortiejob_idobtenu via l'API de fine-tuning des modèles de génération vidéo et d'images.
Étape 1.2 : consulter les résultats du jeu de validation pour un point de contrôle
Choisissez un point de contrôle dans la liste obtenue à l'étape précédente (par exemple, « checkpoint-160 ») afin de visualiser les images générées.Exemple de requête<replace_with_fine_tuning_job_id>: remplacez intégralement cette valeur par le paramètrejob_idissu de la sortie Créer une tâche de fine-tuning.<replace_with_checkpoint_to_export>: remplacez intégralement cette valeur par celle du point de contrôle, par exemple « checkpoint-160 ».
img_path et reste valide pendant 24 heures. Téléchargez rapidement les images pour examiner les résultats. Répétez cette étape afin de comparer plusieurs points de contrôle et d'identifier le plus satisfaisant.Étape 2 : exporter le point de contrôle et obtenir le nom du modèle pour le déploiement
Étape 2 : exporter le point de contrôle et obtenir le nom du modèle pour le déploiement
Étape 2.1 : exporter le modèle
En supposant que « checkpoint-160 » offre les meilleurs résultats, procédez à son exportation.Exemple de requête<replace_with_fine_tuning_job_id>: remplacez intégralement cette valeur par le paramètrejob_idissu de la sortie Créer une tâche de fine-tuning.<replace_with_checkpoint_to_export>: remplacez intégralement cette valeur par celle du point de contrôle, par exemple « checkpoint-160 ».<replace_with_exported_model_display_name>: remplacez intégralement cette valeur par un nom de modèle personnalisé destiné uniquement à l'affichage dans la console, par exemple « wan2.5-checkpoint-160 ». Ce nom doit être globalement unique. L'exportation sous un nom dupliqué n'est pas prise en charge. Pour plus de détails sur les paramètres, consultez la section 3. Exporter un point de contrôle.
output=true confirme la création réussie de la demande d'exportation.Étape 2.2 : récupérer le nouveau nom du modèle pour le déploiement
Interrogez l'état de l'ensemble des points de contrôle, vérifiez que l'exportation est terminée, puis récupérez le nouveau nom de modèle dédié (model_name) nécessaire au déploiement.Exemple de requête<replace_with_fine_tuning_job_id>: remplacez intégralement cette valeur par le paramètrejob_idissu de la sortie Créer une tâche de fine-tuning.
status passe à SUCCEEDED, l'exportation est confirmée. Le champ model_name retourné à ce stade correspond au nouveau nom du modèle après exportation.Étape 3 : déployer et appeler le modèle
Étape 3 : déployer et appeler le modèle
- Déploiement du modèle : renseignez le paramètre d'entrée
model_nameavec la valeur spécifique obtenue après l'exportation. - Appel du modèle : suivez la documentation de l'API pour invoquer le modèle déployé.
Facturation
-
Entraînement de modèle : Payant.
- Coût = Total des tokens d'entraînement × Prix unitaire. Consultez la rubrique Tarification de l'entraînement et du déploiement.
- Une fois l'entraînement terminé, vérifiez le nombre total de tokens consommés dans le champ
usagede l'API Retrieve a fine-tuning job.
generation_type
Résolution d'image
Nombre d'étapes courant
Consommation estimée de tokens
Coût estimé
t2i (texte vers image)
1K
500
6,400,000
$96
1,000
12,800,000
$192
2,000
25,600,000
$384
2K
500
11,610,000
$174.15
1,000
23,220,000
$348.3
2,000
46,440,000
$696.6
i2i (image vers image)
1K
500
11,610,000
$174.15
1,000
23,220,000
$348.3
2,000
46,440,000
$696.6
2K
500
16,000,000
$240
1,000
32,000,000
$480
2,000
64,000,000
$960
-
Déploiement et invocation de modèle : Le déploiement est gratuit. Les invocations sont facturées au tarif standard du modèle de base affiné.
Model ID
Prix de déploiement et d'invocation LoRA
wan2.7-image-pro
0,075 $/image
wan2.7-image
0,03 $/image
Référence API
API d'affinage des modèles de génération vidéo et d'images
FAQ
Q : Comment concevoir un mot déclencheur efficace ?
R : Respectez les règles suivantes :
- Privilégiez des combinaisons de caractères rares et dépourvues de sens sémantique réel, telles que s86b5p, m01aa ou EVEAven638123. Assurez-vous qu'elles n'ont aucune signification dans le vocabulaire du modèle de base.
- Évitez les mots anglais courants (comme beautiful, fire ou dance), car cela risquerait d'altérer la compréhension initiale de ces termes par le modèle.