

Pour la fonctionnalité image-vers-vidéo , si l' optimisation des prompts ou l'utilisation des effets vidéo officiels ne répondent pas à vos besoins personnalisés en matière d' actions, d'effets ou de styles spécifiques , recourez à l' affinage de modèle .
Périmètre d'application
- Région applicable : Les fonctionnalités décrites dans ce document sont disponibles uniquement dans la région Singapour. Utilisez une clé API créée dans cette région.
- Méthode d'affinage prise en charge : Affinage SFT-LoRA efficace.
-
Modèles compatibles avec l'affinage :
- Image-vers-vidéo (basé sur la première image) : wan2.7-i2v, wan2.6-i2v, wan2.5-i2v-preview, wan2.2-i2v-flash.
- Image-vers-vidéo (basé sur la première et la dernière image) : wan2.2-kf2v-flash.
Comment affiner un modèle
- Image-vers-vidéo (basé sur la première image)
- Image-vers-vidéo (basé sur la première et la dernière image)
Première image en entrée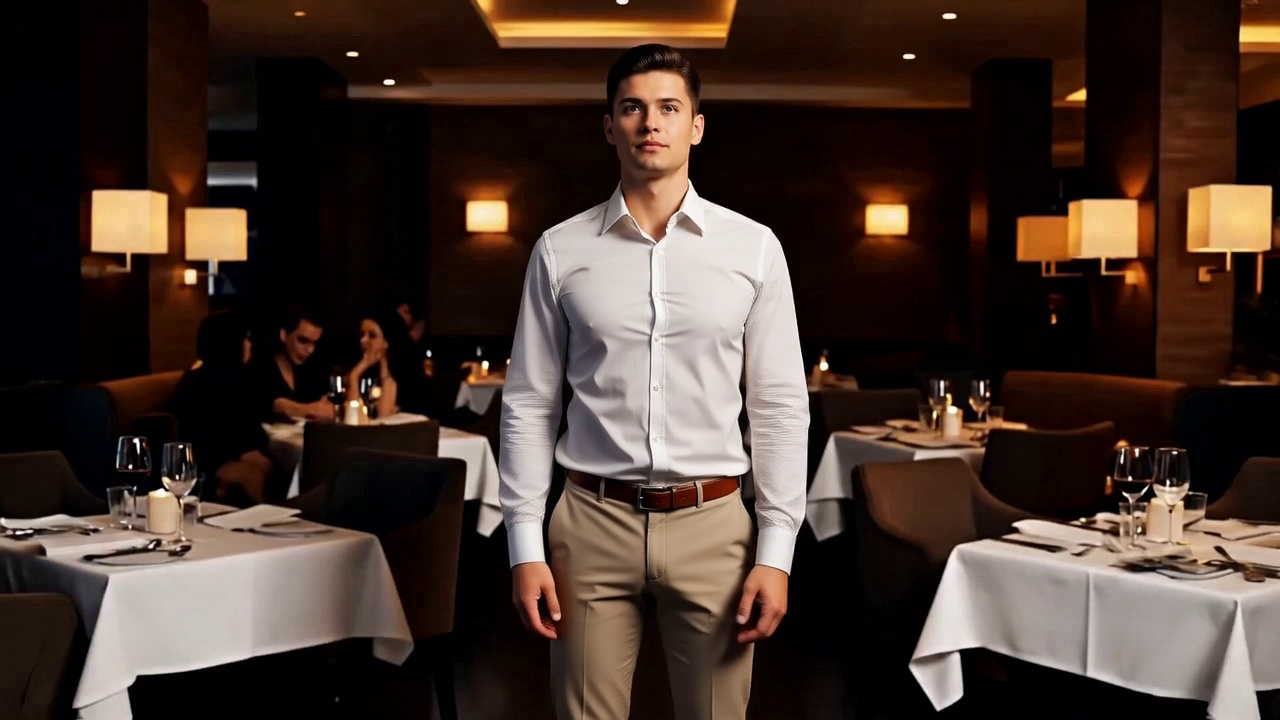 | Vidéo en sortie (avant affinage)Les prompts ne permettent pas de générer systématiquement un effet pluie de billets cohérent. Le mouvement n'est pas contrôlable. | Vidéo en sortie (après affinage)Le modèle affiné reproduit l'effet pluie de billets spécifique du jeu de données d'entraînement sans nécessiter de prompts. |
Étape 1 : Importer votre jeu de données
Importez votre jeu de données local (au format .zip) vers Alibaba Cloud Model Studio. Récupérez l'ID du fichier (file_idid).
Jeu de données d'entraînement exemple : Consultez l'ensemble d'entraînement pour plus de détails sur le format.
- Image-vers-vidéo (basé sur la première image) : wan-i2v-training-dataset.zip.
- Image-vers-vidéo (basé sur la première et la dernière image) : wan-kf2v-training-dataset.zip.
Cet exemple utilise le modèle image-vers-vidéo basé sur la première image. Importez uniquement l'ensemble d'entraînement. Le système en extrait automatiquement une partie pour constituer l'ensemble de validation. L'importation d'un jeu de données prend plusieurs minutes. La durée exacte dépend de la taille du fichier.
id. Il s'agit de l'identifiant unique de votre jeu de données importé.
Étape 2 : Affiner le modèle
Étape 2.1 Créer une tâche d'affinage
Lancez l'entraînement en utilisant l'ID de fichier obtenu à l'étape 1. Exemple de requête Remplacez intégralement<replace with training dataset file ID> par le id de l'étape précédente.
Hyperparamètres pour les modèles de génération vidéo
Ces hyperparamètres s'appliquent uniquement aux modèles de génération vidéo (série Wan). Si les performances du modèle sont insuffisantes ou si l'entraînement ne converge pas, envisagez d'ajuster n_epochs ou learning_rate. Un minimum de 800 étapes d'entraînement au total est recommandé.
| Paramètre | Type | Obligatoire | Description | Valeur recommandée |
|---|---|---|---|---|
| batch_size | int | Oui | Taille du lot. Nombre d'échantillons de données traités lors d'une seule itération d'entraînement.
| Varie selon le modèle |
| n_epochs | int | Oui | Nombre d'époques d'entraînement. Le nombre total d'étapes se calcule ainsi : étapes = n_epochs × ⌈taille du jeu de données / batch_size⌉. Un minimum de 800 étapes au total est recommandé.Exemple : Si le jeu de données contient 5 échantillons et que Le nombre recommandé d'époques s'ajuste automatiquement en fonction de la taille du jeu de données. Un nombre réduit d'échantillons nécessite davantage d'époques pour un apprentissage suffisant, tandis que les jeux de données plus volumineux contiennent plus d'échantillons par époque et requièrent donc moins d'époques. La valeur par défaut de 50 époques convient principalement aux très petits jeux de données (environ 2 échantillons). Pour les jeux de données de 50 à 60 vidéos, un entraînement d'environ 3 000 à 5 000 étapes est généralement recommandé. | 50 |
| learning_rate | float | Oui | Taux d'apprentissage. Contrôle l'amplitude des mises à jour des poids du modèle pendant l'entraînement. Une valeur trop élevée peut dégrader les performances du modèle, tandis qu'une valeur trop faible peut entraîner des modifications insignifiantes. | 2e-5 |
| eval_epochs | int | Oui | Intervalle de validation. Intervalle, en époques, auquel effectuer la validation et enregistrer un point de contrôle. La valeur doit être ≥ n_epochs/10. | 20 |
| max_pixels | int | Oui | Résolution maximale pour les vidéos d'entraînement (total de pixels = largeur × hauteur). Le système redimensionne uniquement les vidéos qui dépassent cette valeur.
| Varie selon le modèle |
| split | float | Non | Ratio de division de l'ensemble d'entraînement. Proportion du jeu de données utilisée pour l'entraînement, avec une plage valide de (0, 1). Ce paramètre est ignoré si validation_file_ids est spécifié. | 0,9 |
| max_split_val_dataset_sample | int | Non | Échantillons maximum pour l'ensemble de validation divisé automatiquement. La taille de l'ensemble de validation correspond à la plus petite des deux valeurs suivantes : le résultat de total_samples × (1 − split) ou la valeur de ce paramètre. | 5 |
| save_total_limit | int | Non | Limite d'enregistrement des points de contrôle. Nombre maximal de points de contrôle récents à conserver. Le système supprime les points de contrôle plus anciens une fois cette limite dépassée. | 10 |
| lora_rank | int | Non | Rang LoRA. Rang (dimension) des matrices de rang faible LoRA. Doit être une puissance de 2 (2n), telle que 16, 32 ou 64. | 32 |
| lora_alpha | int | Non | Alpha LoRA. Facteur d'échelle pour les poids LoRA. Doit être une puissance de 2 (2n), telle que 16, 32 ou 64. | 32 |
output :
job_id: ID de la tâche. Utilisez-le pour vérifier la progression.finetuned_output: Nom du nouveau modèle affiné. Utilisez ce nom pour le déploiement.status: Statut de l'entraînement. Après la création de la tâche, le statut initial est PENDING. L'entraînement n'a pas encore commencé.
Étape 2.2 Vérifier le statut de la tâche d'affinage
Utilisez lejob_id de l'étape 2.1 pour vérifier la progression. Interrogez cet endpoint jusqu'à ce que le status passe à SUCCEEDED.
<replace with fine-tuning job job_id> dans l'URL par la valeur de job_id.
output :
status: Lorsque cette valeur devient SUCCEEDED, l'entraînement est terminé. Vous pouvez déployer le modèle.usage: Total des tokens utilisés pour l'entraînement. Utilisé pour la facturation.
Étape 3 : Déployer le modèle affiné
Étape 3.1 Déployer le modèle en tant que service en ligne
Une fois que le statut de la tâche d'affinage est SUCCEEDED, déployez le modèle en tant que service en ligne. Exemple de requête Remplacez intégralement<replace with model name model_name> par la valeur de finetuned_output obtenue lors de la création de la tâche d'affinage.
output :
deployed_model: Nom du modèle déployé. Utilisez-le pour vérifier le statut du déploiement et appeler le modèle.status: Statut du déploiement. Après le déploiement du modèle affiné, le statut initial est PENDING. Le déploiement n'a pas encore commencé.
Étape 3.2 Vérifier le statut du déploiement
Interrogez cet endpoint jusqu'à ce que lestatus passe à RUNNING.
<replace with deployed_model> par la valeur de deployed_model obtenue à l'étape 3.1.
Exemple de réponse
Vérifiez ces deux paramètres dans le champ output :
status: Lorsque le statut devient RUNNING, le modèle est déployé avec succès. Vous pouvez commencer à l'appeler.deployed_model: Nom du modèle déployé.
Étape 4 : Appeler le modèle pour générer des vidéos
Une fois le modèle déployé avec succès (lorsque le status du déploiement est RUNNING), vous pouvez commencer à appeler le modèle.
Étape 4.1 : Créer une tâche de génération vidéo et obtenir le task_id
Étape 4.1 : Créer une tâche de génération vidéo et obtenir le task_id
<replace with deployed_model name> par la valeur deployed_model obtenue à l'étape précédente.- Image-vers-vidéo (basé sur la première image)
- Image-vers-vidéo (basé sur la première et la dernière image)
Appel du modèle Wan2.7
Appel du modèle Wan2.7
Appel du modèle Wan2.6/Wan2.5/Wan2.2
Appel du modèle Wan2.6/Wan2.5/Wan2.2
task_id pour interroger les résultats à l'étape suivante.duration), consultez la documentation API.| Champ | Type | Obligatoire | Description | Valeur d'exemple |
|---|---|---|---|---|
| model | string | Oui | Nom du modèle.Vous devez utiliser un modèle affiné qui est déployé avec succès et dont le statut est RUNNING. | xxxx-ft-202511111122-xxxx |
| input.prompt | string | Non | Prompt textuel.La prise en compte de ce paramètre dépend du réglage aigc_config.use_input_prompt :
| |
| parameters.resolution | string | Non | Résolution de la vidéo générée.Modèles wan2.2 et wan2.5 : 480P, 720P. La valeur par défaut est 720P.Modèles wan2.6 : 720P, 1080P. La valeur par défaut est 720P.Modèles wan2.7 : 720P, 1080P. La valeur par défaut est 1080P. | 720P |
| parameters.prompt_extend | boolean | Non | Activer la réécriture de prompt.Lors de l'appel d'un modèle LoRA affiné, désactivez cette option. Définissez-la sur false. | false |
Étape 4.2 : Interroger les résultats à l'aide du task_id
Étape 4.2 : Interroger les résultats à l'aide du task_id
task_id jusqu'à ce que task_status devienne SUCCEEDED. Récupérez ensuite l'URL de la vidéo.Exemple de requête
Remplacez 86ecf553-d340-4e21-xxxxxxxxx par le véritable task_id.
L'URL de la vidéo est valide pendant 24 heures. Téléchargez la vidéo rapidement.
Constituer un jeu de données personnalisé
Outre l'utilisation des jeux de données exemples de ce guide, vous pouvez constituer votre propre jeu de données pour l'affinage.
Votre jeu de données doit inclure un ensemble d'entraînement (obligatoire) et peut inclure un ensemble de validation (facultatif, prend en charge la division automatique à partir de l'ensemble d'entraînement). Regroupez tous les fichiers dans un fichier .zip. N'utilisez que des lettres anglaises, des chiffres, des traits de soulignement ou des traits d'union dans les noms de fichiers.
Format du jeu de données
Ensemble d'entraînement : Obligatoire
- Image-vers-vidéo (basé sur la première image)
- Image-vers-vidéo (basé sur la première et la dernière image)
- Ensemble d'entraînement exemple : wan-i2v-training-dataset.zip.
-
Structure du répertoire ZIP :
-
Fichier d'annotation (data.jsonl) : Chaque ligne correspond à un échantillon d'entraînement. Il doit s'agir d'un objet JSON. Structure :
Ensemble de validation : Facultatif
- Image-vers-vidéo (basé sur la première image)
- Image-vers-vidéo (basé sur la première et la dernière image)
- Ensemble de validation exemple : wan-i2v-valid-dataset.zip.
-
Structure du répertoire ZIP :
-
Fichier d'annotation (data.jsonl) : Chaque ligne correspond à un échantillon de validation. Il doit s'agir d'un objet JSON. Structure :
Volume de données et limites
- Volume de données : Fournissez au moins 10 échantillons. Davantage de données d'entraînement améliore les résultats. Nous recommandons 20 à 100 échantillons pour des performances stables.
- Archive ZIP : Lors de l'importation via l'API, la taille totale doit être ≤ 1 Go.
-
Exigences pour les images d'entraînement :
- Formats : BMP, JPEG, PNG, WEBP.
- Résolution ≤ 4096×4096.
- Aucune limite stricte sur la taille individuelle des fichiers (le système effectue un prétraitement automatique).
-
Exigences pour les vidéos d'entraînement :
- Formats : MP4, MOV.
- Résolution ≤ 4096×4096.
- Aucune limite stricte sur la taille individuelle des fichiers (le système effectue un prétraitement automatique).
- Durée par vidéo : 2 à 5 secondes recommandées pour les modèles wan2.2 ; 2 à 10 secondes recommandées pour les modèles wan2.5 ; 2 à 10 secondes recommandées pour les modèles wan2.6 et wan2.7.
Collecte et nettoyage des données
1. Définir le scénario d'affinage
Wanxiang prend en charge l'affinage pour la fonctionnalité image-vers-vidéo dans les scénarios suivants :- Effets vidéo fixes : Enseigner au modèle un changement visuel spécifique, tel qu'un carrousel ou un changement de costume magique.
- Actions de personnage fixes : Améliorer la capacité du modèle à reproduire des mouvements corporels spécifiques, tels que des pas de danse ou des techniques d'arts martiaux.
- Mouvements de caméra fixes : Reproduire une cinématographie complexe, telle que des travellings avant/arrière, des panoramiques, des inclinaisons ou des plans orbitaux.
2. Collecter les ressources brutes
- Génération IA et filtrage : Utilisez le modèle de base Wanxiang pour générer des vidéos par lots. Sélectionnez manuellement les échantillons de haute qualité qui correspondent le mieux à votre effet cible. C'est la méthode la plus courante.
- Tournage réel : Si vous avez besoin d'un haut niveau de réalisme pour des scènes interactives (par exemple, étreintes, poignées de main), utilisez des séquences réelles.
- Rendu logiciel 3D : Pour les effets ou animations abstraites nécessitant un contrôle précis, utilisez un logiciel 3D (par exemple, Blender, Cinema 4D).
3. Nettoyer les données
Dimension | Exigences positives | Exemple négatif |
|---|---|---|
Cohérence | Les caractéristiques principales doivent être hautement uniformes. Exemple : Pour entraîner une « rotation à 360 degrés », toutes les vidéos doivent tourner dans le sens horaire à peu près à la même vitesse. | Directions mélangées. Le jeu de données contient à la fois des rotations horaires et antihoraires. Le modèle ne sait pas quelle direction apprendre. |
Diversité | Plus il y a de variété dans les sujets et les scènes, mieux c'est. Couvrez différents sujets (hommes, femmes, enfants, animaux, bâtiments) et compositions (gros plans, plans larges, plongées, contre-plongées). Variez également la résolution et le rapport d'aspect. | Scène ou sujet unique. Toutes les vidéos montrent « une personne en vêtements rouges tournant devant un mur blanc ». Le modèle peut considérer à tort les « vêtements rouges » et le « mur blanc » comme faisant partie de l'effet. Il échoue lorsque les vêtements changent. |
Équilibre | Les types de données doivent être équilibrés. Si plusieurs styles existent, leurs quantités doivent être à peu près égales. | Déséquilibre sévère. 90 % sont des vidéos portrait, 10 % sont des vidéos paysage. Le modèle risque d'être moins performant sur les vidéos paysage. |
Pureté | Visuels propres et clairs. Utilisez des ressources originales sans interférences. | Éléments perturbateurs. Les vidéos contiennent des sous-titres, des logos, des filigranes, des bandes noires évidentes ou du bruit. Le modèle risque d'apprendre le filigrane comme faisant partie de l'effet. |
Durée | Durée des ressources ≤ durée cible. Si vous souhaitez des vidéos de 5 secondes, rognez les ressources à 4-5 secondes. | Ressources trop longues. Vous voulez des vidéos de 5 secondes mais fournissez au modèle des ressources de 8 secondes. Cela conduit à un apprentissage incomplet de l'action et à une sensation saccadée. |
Annotation vidéo : Rédiger des prompts pour les vidéos
Dans le fichier d'annotation du jeu de données (data.jsonl), chaque vidéo possède un prompt correspondant. Le prompt décrit le contenu de la vidéo. La qualité du prompt détermine directement ce que le modèle apprend.
| Exemple de promptLa vidéo commence par une jeune femme debout devant un mur de briques couvert de lierre. Elle a de longs cheveux lisses brun roux, porte une robe blanche sans manches, un collier argenté brillant et arbore un sourire. L'arrière-plan est un mur de briques couvert de vignes vertes, d'apparence rustique et naturelle. Puis l'effet pluie de billets s86b5p commence, d'innombrables billets de banque américains de grande taille (fond beige/motifs vert foncé) tombent comme une pluie torrentielle, frappant densément et entourant la personne. Les billets continuent de tomber, elle tend les bras vers le haut, le cou légèrement incliné en arrière, l'expression surprise, complètement immergée dans cette folle pluie d'argent. |
Formule de rédaction de prompt
Prompt = [Description du sujet] + [Description de l'arrière-plan] + [Mot déclencheur] + [Description du mouvement]
Élément du prompt | Description | Conseils | Exemple |
|---|---|---|---|
Description du sujet | Décrire les personnes ou objets présents dans le cadre | Obligatoire | La vidéo commence par une jeune femme... |
Description de l'arrière-plan | Décrire l'environnement où se trouve le sujet | Obligatoire | L'arrière-plan est un mur de briques couvert de vignes vertes... |
Mot déclencheur | Un mot rare et dénué de sens | Recommandé | s86b5p ou m01aa |
Description du mouvement | Décrire en détail les changements dynamiques pendant l'effet | Recommandé | D'innombrables billets de banque américains de grande taille (fond beige/motifs vert foncé) tombent comme une pluie torrentielle... |
À propos des mots déclencheurs
À propos des mots déclencheurs
- Qu'est-ce qu'un mot déclencheur ? Il agit comme une « ancre visuelle ». De nombreux mouvements complexes (par exemple, une trajectoire de danse unique ou un effet lumineux) sont difficiles à décrire par du texte. Un mot déclencheur force le modèle à générer cet effet visuel précis lorsqu'il rencontre ce mot.
- Pourquoi l'utiliser ? L'affinage établit une correspondance entre le texte et les caractéristiques vidéo. Le mot déclencheur lie un effet difficile à décrire à un mot unique afin que le modèle puisse cibler précisément l'objectif.
-
Si nous avons un mot déclencheur, pourquoi décrire le mouvement en détail ?
Ils jouent des rôles différents et fonctionnent mieux ensemble.
- La description du mouvement explique ce qui se passe dans la scène. Elle indique au modèle les actions physiques de base et la logique. Les descriptions de mouvement sont généralement cohérentes d'un échantillon à l'autre.
- Le mot déclencheur explique à quoi ressemble spécifiquement l'action. Il représente des changements et des caractéristiques uniques que les mots ne peuvent pas décrire.
Comment rédiger de bons prompts
Suivre les règles de cohérence pour les descriptions d'effets
Pour tous les échantillons contenant le même effet, gardez la partie description du mouvement aussi cohérente que possible. Appliquez cette règle aux ensembles d'entraînement et de validation.-
Objectif : Lorsque le modèle voit
s86b5psuivi de la même description fixe et observe toujours une pluie de billets, il apprend que s86b5p = effet visuel pluie de billets. -
Exemple : Que le sujet soit une « jeune femme » ou un « homme en costume », le prompt se termine de la même manière pour l'effet pluie de billets : « ...puis l'effet pluie de billets s86b5p commence, d'innombrables billets de banque américains tombent comme une pluie torrentielle... »
Type d'échantillon
Contenu du prompt (Notez la cohérence dans les parties soulignées)
Échantillon d'entraînement 1
La vidéo commence par une jeune femme debout devant un mur de briques... (description de l'environnement omise)...
Puis l'effet pluie de billets s86b5p commence, d'innombrables billets de banque américains de grande taille (fond beige/motifs vert foncé) tombent comme une pluie torrentielle, frappant densément et l'entourant. Les billets continuent de tomber, elle tend les bras vers le haut, le cou légèrement incliné en arrière, l'expression surprise, complètement immergée dans cette folle pluie d'argent.Échantillon d'entraînement 2
La vidéo commence par un homme en costume dans un restaurant haut de gamme... (description de l'environnement omise)...
Puis l'effet pluie de billets s86b5p commence, d'innombrables billets de banque américains de grande taille (fond beige/motifs vert foncé) tombent comme une pluie torrentielle, frappant densément et l'entourant. Les billets continuent de tomber, il tend les bras vers le haut, le cou légèrement incliné en arrière, l'expression surprise, complètement immergé dans cette folle pluie d'argent.Échantillon de validation 1
La vidéo commence par un jeune enfant debout devant un paysage urbain... (description de l'environnement omise)...
Puis l'effet pluie de billets s86b5p commence, d'innombrables billets de banque américains de grande taille (fond beige/motifs vert foncé) tombent comme une pluie torrentielle, frappant densément et l'entourant. Les billets continuent de tomber tandis que la caméra zoome lentement, il tend les bras vers le haut, le cou légèrement incliné en arrière, l'expression surprise, complètement immergé dans cette folle pluie d'argent.
Utiliser l'IA pour générer des prompts
Pour obtenir des prompts de haute qualité, utilisez des grands modèles linguistiques multimodaux tels que Qwen-VL pour vous assister.-
Utiliser l'IA pour générer des descriptions initiales
-
Brainstorming libre (trouver l'inspiration) : Si vous ne savez pas comment décrire l'effet, laissez l'IA explorer librement.
- Envoyez «
Describe the video content in detail» et observez la sortie du modèle. - Concentrez-vous sur les termes que le modèle utilise pour la trajectoire de mouvement (par exemple, « tombent comme une pluie torrentielle », « la caméra zoome lentement »). Ces termes peuvent servir pour une optimisation ultérieure.
- Envoyez «
-
Prompting à format fixe (standardiser la sortie) : Une fois que vous avez une idée approximative, concevez un format fixe pour guider l'IA afin qu'elle génère des prompts correspondant à votre modèle.
Exemple de code
Voir compréhension visuelle pour les détails de l'appel API.
-
Brainstorming libre (trouver l'inspiration) : Si vous ne savez pas comment décrire l'effet, laissez l'IA explorer librement.
-
Extraire des modèles d'effets
- Exécutez le processus plusieurs fois sur des échantillons ayant le même effet. Identifiez les expressions fréquentes et précises utilisées pour décrire l'effet. Extrayez une « description d'effet » générique.
- Copiez et collez cette description d'effet standardisée dans tous les échantillons pour cet effet.
- Conservez les descriptions uniques de « sujet » et d'« arrière-plan » pour chaque échantillon. Remplacez uniquement la partie « description d'effet » par le modèle unifié.
- Révision manuelle L'IA peut avoir des hallucinations ou commettre des erreurs de détection. Comme étape finale, effectuez une vérification manuelle. Par exemple, confirmez que les descriptions de l'entité et de l'arrière-plan correspondent à la scène réelle.
Évaluer le modèle à l'aide d'un ensemble de validation
Spécifier un ensemble de validation
Une tâche d'affinage nécessite un ensemble d'entraînement. Un ensemble de validation est facultatif. Vous pouvez choisir de laisser le système diviser automatiquement ou importer manuellement. Spécifiez comme suit :
Méthode 1 : Aucun ensemble de validation importé (division automatique par le système)
Lorsque vous créez une tâche d'affinage, si vous n'importez pas d'ensemble de validation séparé, c'est-à-dire si le paramètrevalidation_file_ids n'est pas transmis, le système divise automatiquement une partie de l'ensemble d'entraînement pour l'utiliser comme ensemble de validation en fonction des deux hyperparamètres suivants :
split: Proportion des données d'entraînement à diviser. Par exemple, 0,9 signifie 90 % pour l'entraînement et 10 % pour la validation.max_split_val_dataset_sample: Nombre maximal d'échantillons pour l'ensemble de validation divisé automatiquement.
taille du jeu de données × (1 - split) et max_split_val_dataset_sample.
-
Exemple : Supposons que vous importiez uniquement un ensemble d'entraînement de 100 échantillons, split=0,9 (10 % pour la validation), et max_split_val_dataset_sample=5.
- Division théorique : 100 × 10 % = 10 échantillons.
- Division réelle : min(10, 5)=5. Le système utilise donc uniquement 5 échantillons pour l'ensemble de validation.
Méthode 2 : Importer manuellement un ensemble de validation (utilisation de validation_file_ids)
Si vous préférez évaluer les points de contrôle en utilisant vos propres données préparées plutôt que de vous fier aux divisions aléatoires du système, importez un ensemble de validation personnalisé. Remarque : Une fois l'importation manuelle choisie, le système ignore les règles de division automatique ci-dessus et valide uniquement avec vos données importées.Étapes : Importer manuellement un ensemble de validation
Étapes : Importer manuellement un ensemble de validation
-
Préparer l'ensemble de validation : Regroupez les données de validation dans un fichier
.zipautonome. Voir format de l'ensemble de validation. -
Importer l'ensemble de validation : Appelez l'API importer le jeu de données pour importer ce fichier
.zip. Obtenez un ID de fichier dédié. -
Spécifier l'ensemble de validation lors de la création de la tâche : Lors de l'appel de l'API créer une tâche d'affinage, placez cet ID de fichier dans le paramètre
validation_file_ids.
Sélectionner le meilleur point de contrôle pour le déploiement
Pendant l'entraînement, le système enregistre des « instantanés » périodiques (points de contrôle). Par défaut, le système produit le point de contrôle final comme modèle affiné. Cependant, les points de contrôle intermédiaires peuvent surpasser la version finale. Vous pouvez choisir le meilleur pour le déploiement.
Le système exécute les points de contrôle sur l'ensemble de validation et génère des vidéos d'aperçu à des intervalles définis par l'hyperparamètre eval_epochs.
- Évaluation : Jugez en regardant directement les vidéos d'aperçu.
- Critères de sélection : Choisissez le point de contrôle offrant la meilleure qualité visuelle et aucune distorsion de mouvement.
Procédure
Étape 1 : Voir les résultats d'aperçu des points de contrôle
Étape 1 : Voir les résultats d'aperçu des points de contrôle
Étape 1.1 Lister les points de contrôle validés
Cette API renvoie uniquement les points de contrôle ayant passé la validation et généré avec succès des vidéos d'aperçu. Les points de contrôle ayant échoué ne sont pas listés.Exemple de requête<replace_with_fine-tuning_job_id>: Remplacez intégralement par lejob_idde l'API créer une tâche d'affinage.
Étape 1.2 Voir les résultats de validation d'un point de contrôle
Sélectionnez un point de contrôle dans la liste ci-dessus (par exemple, « checkpoint-160 ») et visualisez son résultat vidéo.Exemple de requête<replace_with_fine-tuning_job_id>: Remplacez intégralement par lejob_idde la création de la tâche d'affinage.<replace_with_selected_checkpoint>: Remplacez intégralement par la valeur du point de contrôle, par exemple « checkpoint-160 ».
video_path. Elle est valide pendant 24 heures. Téléchargez-la et examinez-la rapidement. Répétez cette étape pour comparer plusieurs points de contrôle et trouver le meilleur.Étape 2 : Exporter le point de contrôle et obtenir le nom du modèle pour le déploiement
Étape 2 : Exporter le point de contrôle et obtenir le nom du modèle pour le déploiement
Étape 2.1 Exporter le modèle
Supposons que « checkpoint-160 » donne le meilleur résultat. Exportez-le maintenant.Exemple de requête<replace_with_fine_tuning_job_id>: Remplacez intégralement par lejob_idde la création de la tâche d'affinage.<replace_with_checkpoint_to_export>: Remplacez intégralement par la valeur du point de contrôle, par exemple « checkpoint-160 ».<replace_with_exported_model_name_for_console_display>: Remplacez intégralement par un nom de modèle personnalisé pour l'affichage dans la console, par exemple « wan2.5-checkpoint-160 ». Ce nom doit être globalement unique. Les noms en double ne sont pas autorisés. Pour des conseils sur les paramètres, voir exporter le point de contrôle.
output=true signifie que la demande d'exportation a été créée avec succès.Étape 2.2 Interroger le nouveau nom du modèle après déploiement
Interrogez tous les statuts des points de contrôle pour confirmer la fin de l'exportation et obtenir le nom unique du modèle (model_name) pour le déploiement.Exemple de requête<replace_with_fine-tuning_job_id>: Remplacez intégralement par lejob_idde la création de la tâche d'affinage.
status devient SUCCEEDED, l'exportation a réussi. Le champ model_name est le nouveau nom du modèle pour le déploiement et les appels.Étape 3 : Déployer et appeler le modèle
Étape 3 : Déployer et appeler le modèle
- Déploiement du modèle : Dans le paramètre d'entrée
model_name, saisissez la valeur spécifique obtenue après l'exportation. - Appel du modèle : Suivez la documentation API pour appeler le modèle déployé.
Mise en production
En production, si le modèle entraîné initialement est peu performant (par exemple, visuels déformés, effets faibles, mouvements imprécis), ajustez selon ces dimensions :
1. Vérifier les données et les prompts
- Cohérence des données : La cohérence est cruciale. Vérifiez l'absence de « mauvais échantillons » avec des directions opposées ou des styles très différents.
- Nombre d'échantillons : Augmentez les données de haute qualité à 20+ échantillons.
- Prompt : Assurez-vous que les mots déclencheurs sont des termes rares et dénués de sens (par exemple, s86b5p). Évitez les mots courants (par exemple, running) qui causent des interférences.
-
n_epochs (époques d'entraînement)
- Par défaut : 50. Utilisez la valeur par défaut sauf nécessité. En cas d'ajustement, suivez la règle : « Étapes totales d'entraînement ≥ 800 ».
-
Formule des étapes totales :
steps = n_epochs × ceiling (taille ensemble entraînement / batch_size). -
Formule du minimum n_epochs :
n_epochs = 800 / ceiling (taille jeu de données / batch_size). -
Exemple : Supposons un ensemble d'entraînement de 5 échantillons, utilisant le modèle Wan2.5 (batch_size=2).
- Étapes par époque : 5 / 2 = 2,5, arrondi à 3. Total époques : n_epochs = 800 / 3 ≈ 267. C'est le minimum recommandé. Vous pouvez l'augmenter selon vos besoins.
Facturation
-
Entraînement du modèle : Payant.
- Coût = Total des tokens d'entraînement × Prix unitaire. Voir facturation de l'entraînement de modèle.
- Après l'entraînement, vérifiez le total des tokens consommés dans le champ
usagede l'API interroger le statut de la tâche d'affinage.
- Déploiement du modèle : Gratuit.
-
Appels de modèle : Payants.
- Facturé selon le prix d'appel standard du modèle de base affiné. Voir tarification des modèles.
Référence API
API d'affinage des modèles de génération vidéo et d'imageFAQ
Q : Comment sont calculés les volumes de données des ensembles d'entraînement et de validation ?
R : L'ensemble d'entraînement est obligatoire, l'ensemble de validation est facultatif. Les méthodes de calcul sont les suivantes :-
Lorsqu'aucun ensemble de validation n'est fourni : L'ensemble d'entraînement importé constitue la « taille totale du jeu de données ». Le système divise automatiquement une partie des données pour la validation.
- Taille de l'ensemble de validation =
min(taille totale jeu de données × (1 − split), max_split_val_dataset_sample). Pour un exemple, voir spécifier un ensemble de validation. - Taille de l'ensemble d'entraînement =
taille totale jeu de données − taille ensemble validation.
- Taille de l'ensemble de validation =
-
Lorsqu'un ensemble de validation est importé manuellement : Le système ne divise plus l'ensemble de validation à partir des données d'entraînement.
- Taille de l'ensemble d'entraînement = Volume de données de l'ensemble d'entraînement importé.
- Taille de l'ensemble de validation = Volume de données de l'ensemble de validation importé.
Q : Comment concevoir un bon mot déclencheur ?
R : Suivez ces règles :- Utilisez des combinaisons de lettres dénuées de sens, telles que sksstyle, a8z2_bbb.
- Évitez les mots anglais courants (par exemple, beautiful, fire, dance). Cela empêche de polluer la compréhension originale de ces mots par le modèle.
Q : L'affinage peut-il modifier la résolution ou la durée de la vidéo ?
R : Non. L'affinage apprend le « contenu » et la « dynamique », pas les « spécifications ». Le format vidéo de sortie (résolution, fréquence d'images, durée maximale) reste déterminé par le modèle de base. - Vous pouvez utiliser les valeurs par défaut pour learning_rate (taux d'apprentissage) et batch_size (taille du lot). Ces valeurs ne nécessitent généralement pas de modification.