

Les modèles de compréhension visuelle répondent à des questions en s'appuyant sur les images ou vidéos que vous fournissez. Ils acceptent une ou plusieurs images en entrée et conviennent à diverses tâches telles que le sous-titrage d'images, la réponse aux questions visuelles et la localisation d'objets.
Premiers pas
Prérequis
- Obtenez une clé API et configurez-la comme variable d'environnement.
- Pour effectuer des appels avec un SDK, installez le SDK. Le SDK DashScope Python doit être en version 1.24.6 ou ultérieure, et le SDK DashScope Java en version 2.21.10 ou ultérieure.
- Compatibilité OpenAI
- DashScope
- Python
- Node.js
- Java
- curl
Réponse
Performances des modèles
Questions-réponses sur les images
Décrivez le contenu d'une image, ou classez-la et étiquetez-la en identifiant par exemple des personnes, des lieux, des animaux ou des végétaux.
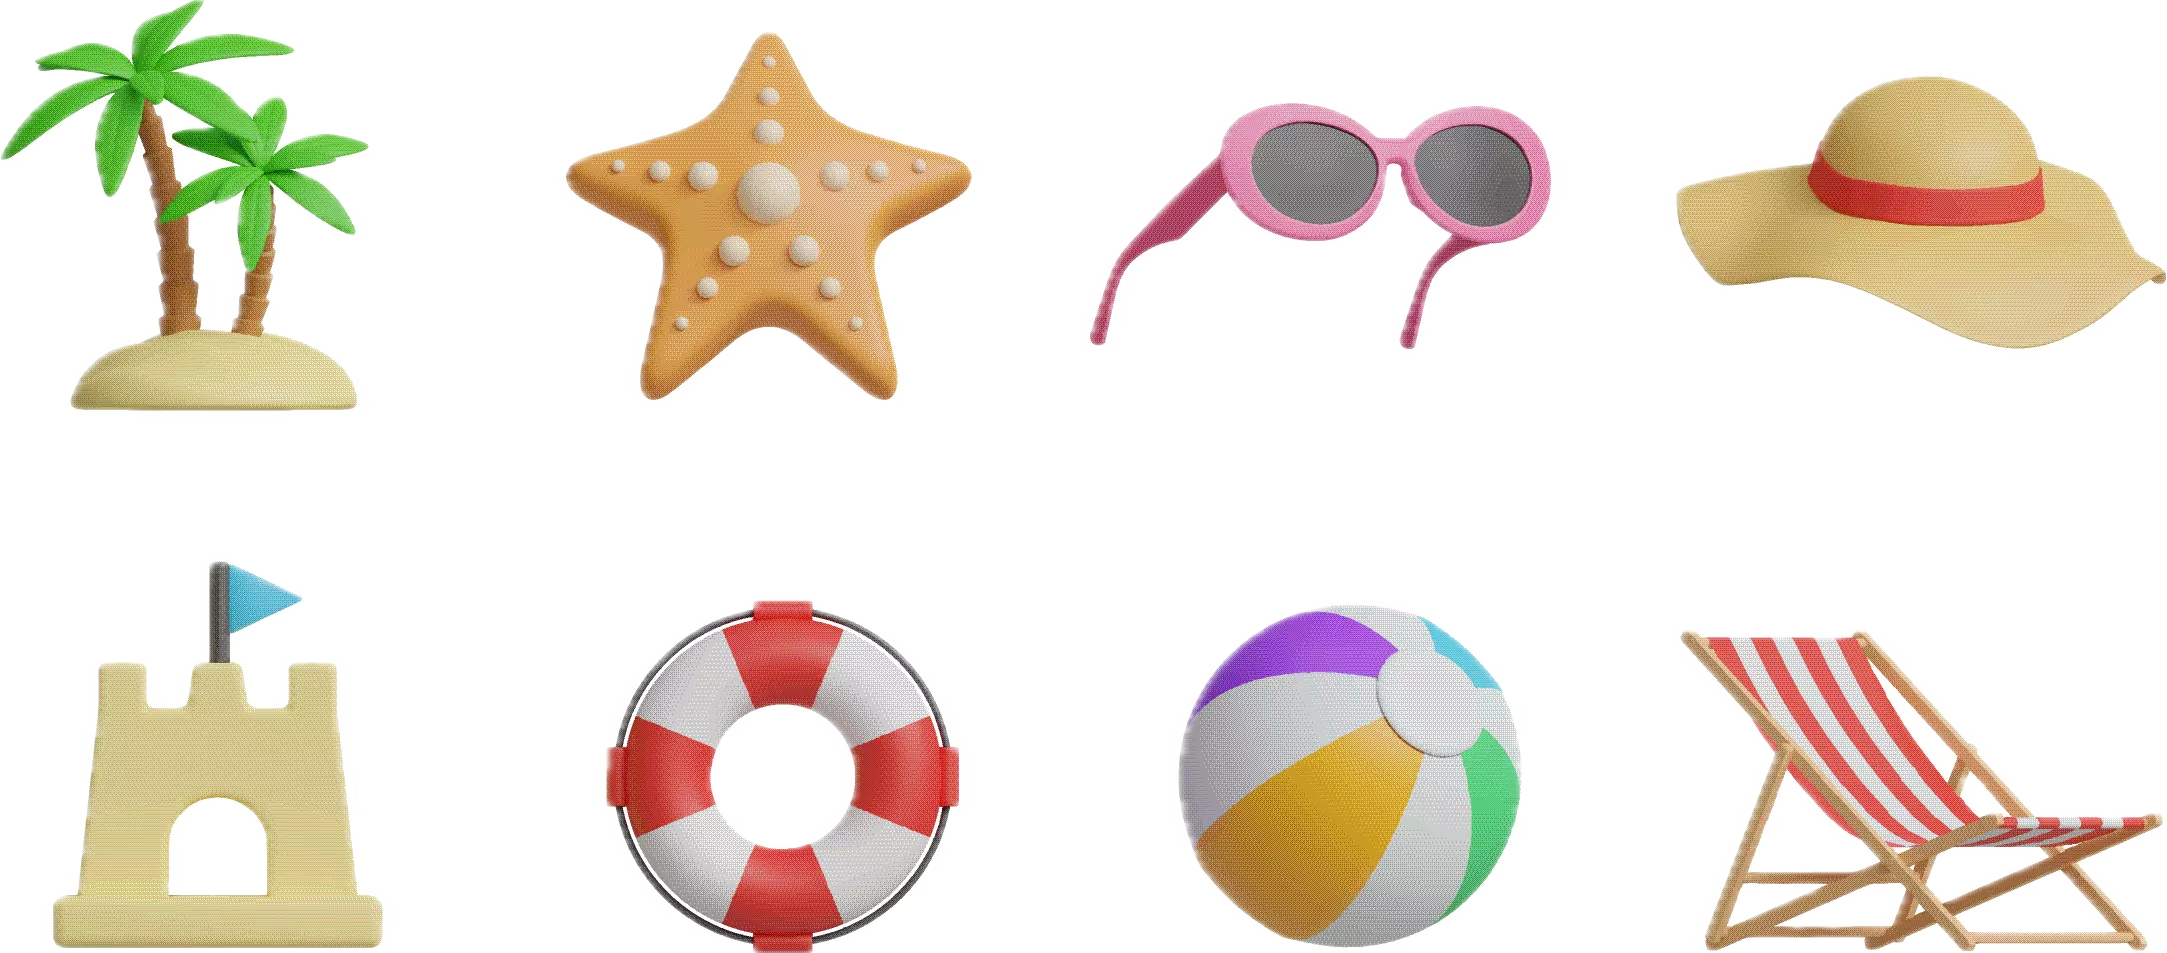 Quel objet de cette image dois-je utiliser si le soleil est trop fort ? | Si le soleil est trop fort, utilisez les lunettes de soleil roses sur l'image. Les lunettes de soleil atténuent la lumière intense, réduisent les dommages causés aux yeux par les UV et contribuent à protéger la vue et à améliorer le confort visuel en plein soleil. |
|---|
Écriture créative
Générez des descriptions textuelles vivantes à partir du contenu d'une image ou d'une vidéo. Cette fonctionnalité convient aux scénarios créatifs tels que la rédaction d'histoires, la conception de textes publicitaires ou l'écriture de scripts pour vidéos courtes.
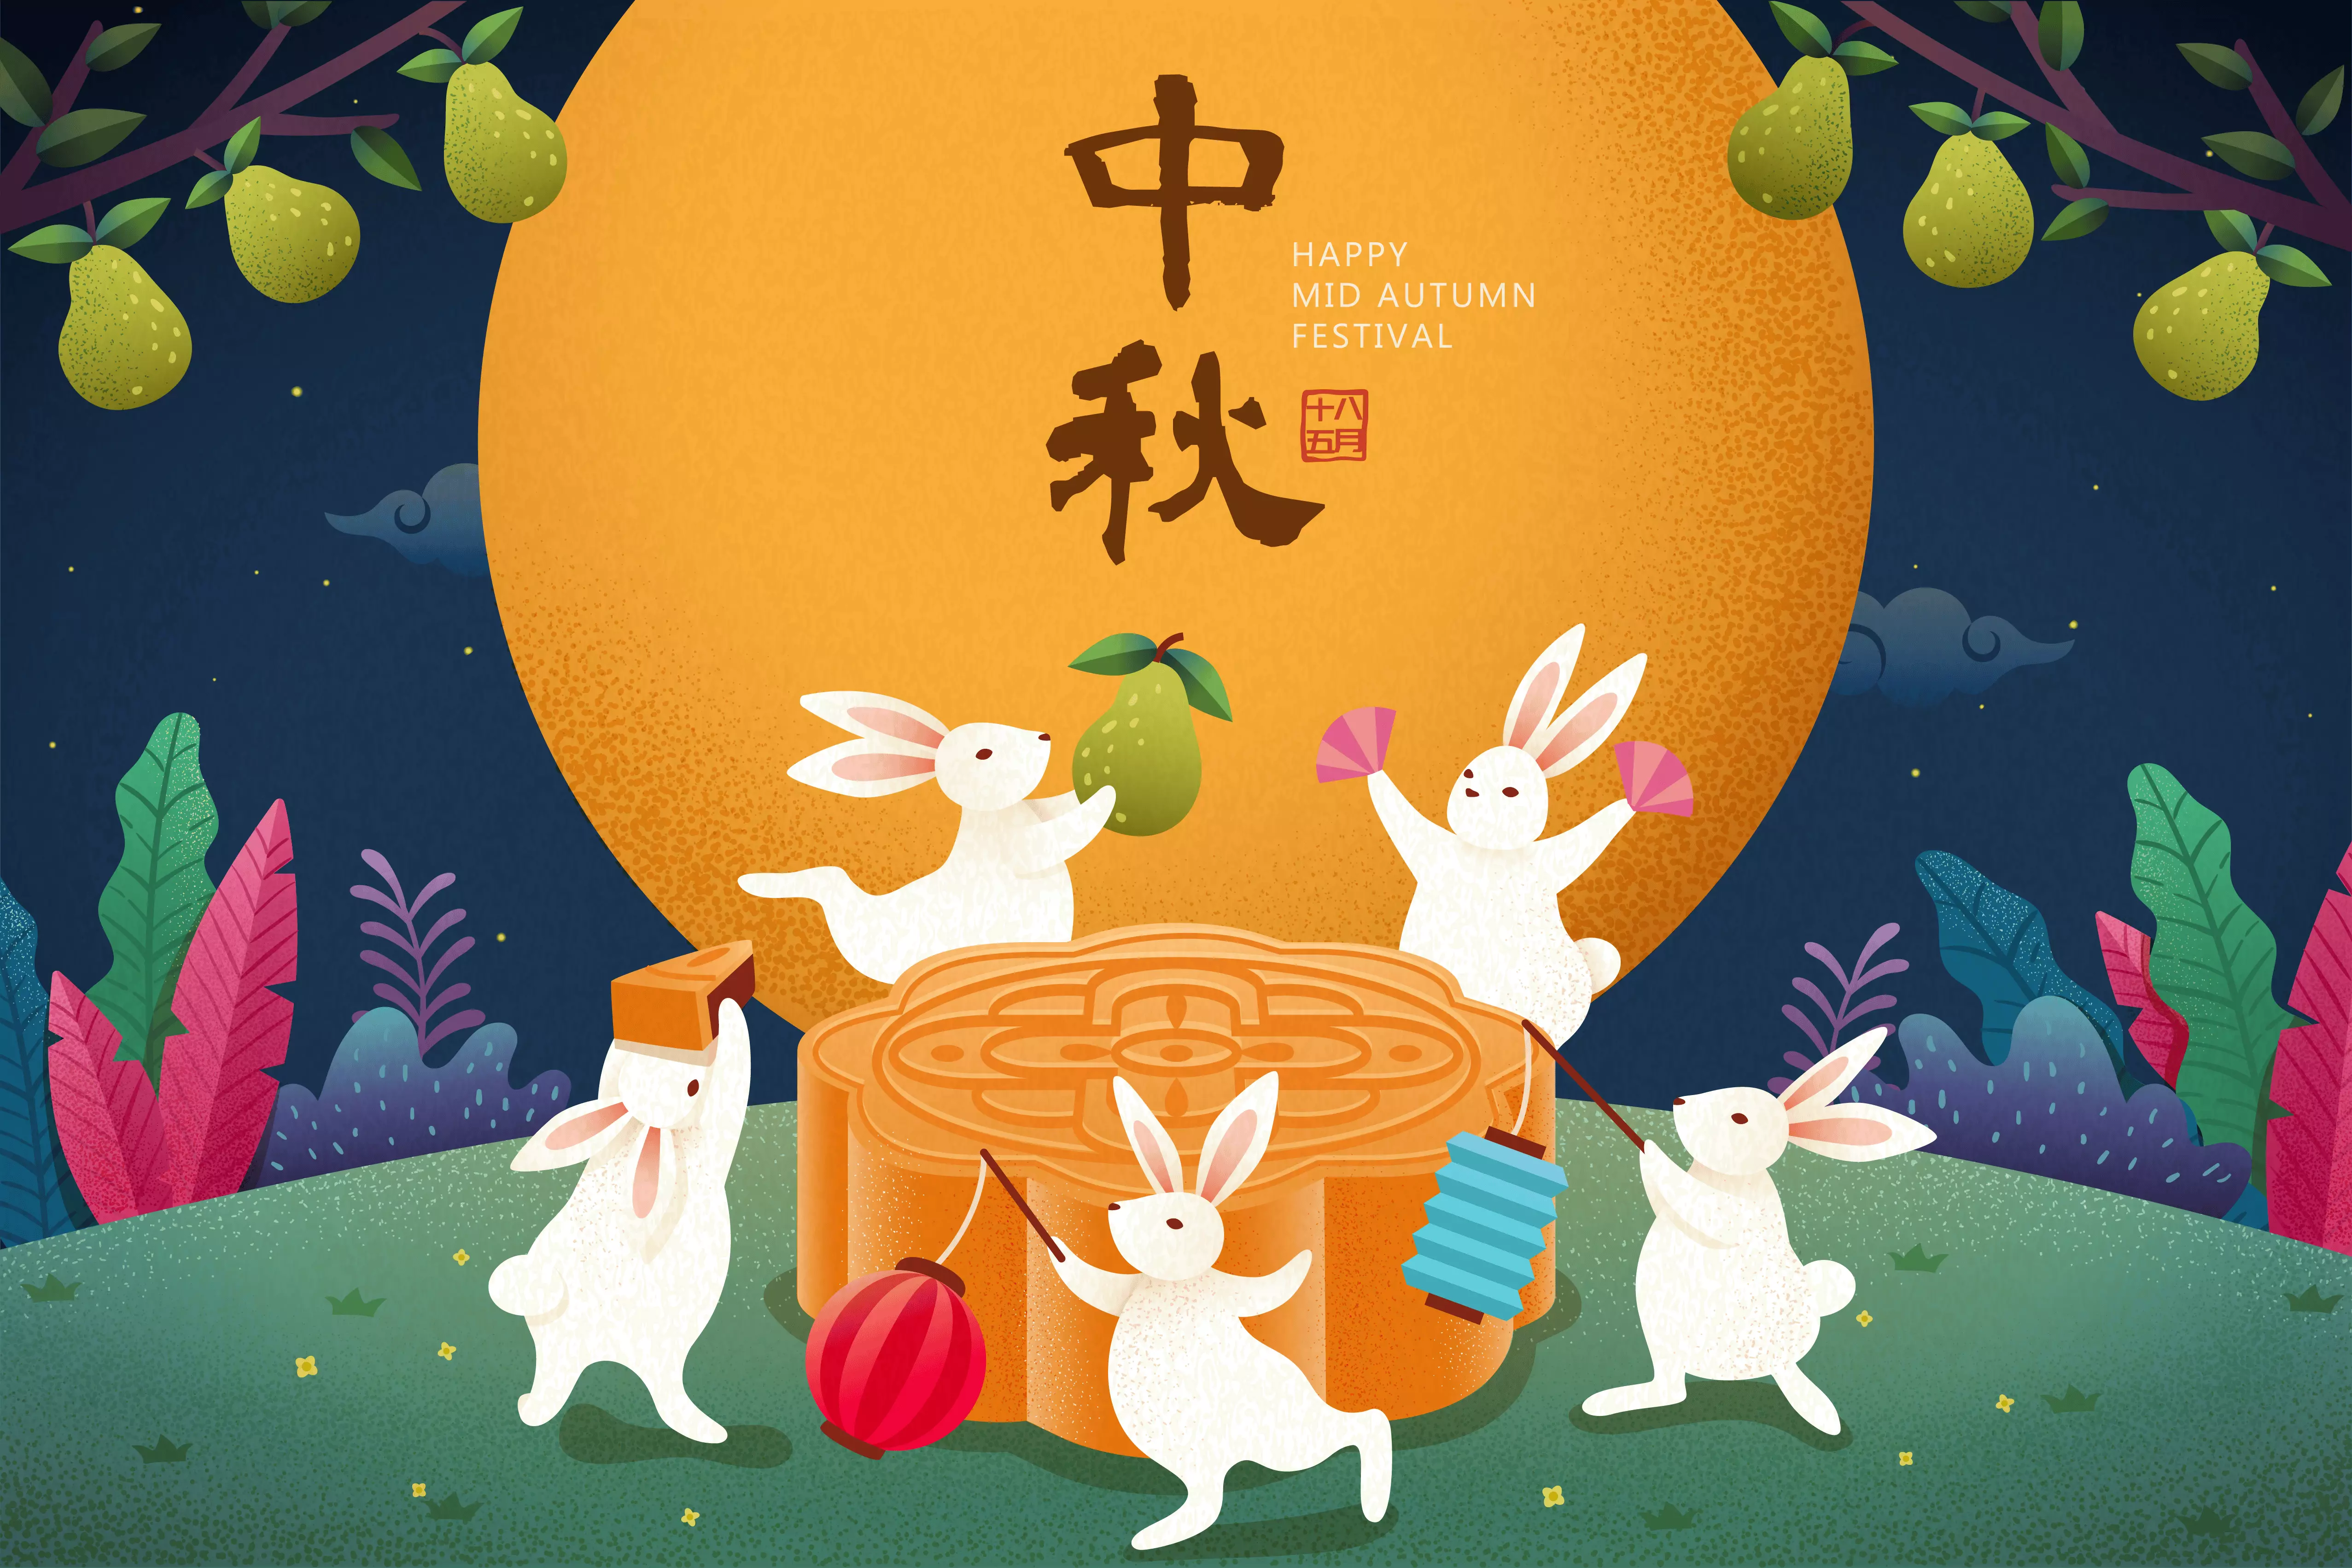 Rédigez une publication intéressante pour les réseaux sociaux à partir du contenu de l'image. | Bien sûr. Cette image évoque la fête de la mi-automne en associant habilement des éléments classiques et modernes. À partir de ses principaux éléments, voici plusieurs propositions de publications dans différents styles. Style poétique Ce soir, la lune brille pour tous, mais qui sait où se poseront les pensées d'automne ? Chang'e s'envole vers la lune et le Lapin de jade prépare son remède. La poésie des anciens s'illumine ce soir. Puisse cette lune éclairer votre retour et porter mes pensées les plus sincères. Joyeuse fête de la mi-automne ! Vœux chaleureux La lune est pleine, les familles réunies : la nuit de la mi-automne est la plus douce. Contemplez les feux d'artifice et la pleine lune, savourez un gâteau de lune et faites un vœu de bonne santé. Puissent tous nos souhaits se réaliser. Joyeuse fête de la mi-automne à tous et bonheur à vos familles ! |
Reconnaissance de texte et extraction d'informations
Reconnaissez du texte et des formules dans des images, ou extrayez des informations à partir de reçus, de certificats et de formulaires. La sortie au format texte structuré est prise en charge.
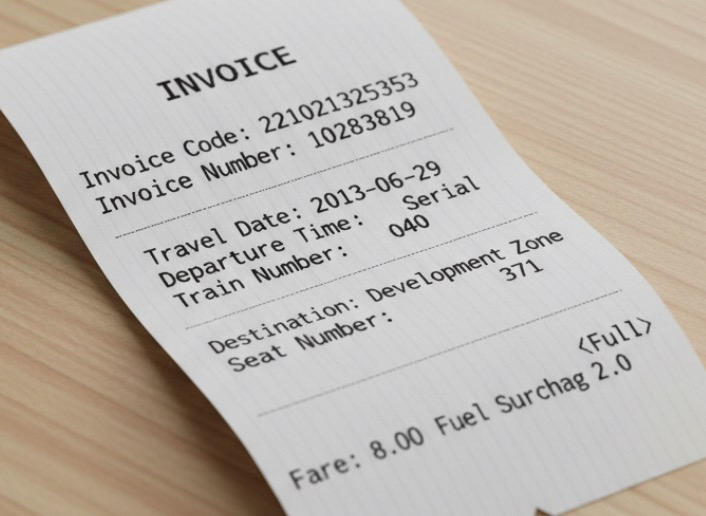 Extrayez de l'image les champs suivants: ['Invoice Code', 'Invoice Number', 'Destination', 'Fuel Surcharge', 'Fare', 'Date', 'Departure Time', 'Train Number', 'Seat Number']. Fournissez la réponse au format JSON. | { "Invoice Code": "221021325353", "Invoice Number": "10283819", "Destination": "Development Zone", "Fuel Surcharge": "2.0", "Fare": "8.00<Full>", "Date": "2013-06-29", "Departure Time": "Rolling", "Train Number": "040", "Seat Number": "371" } |
Résolution de problèmes multidisciplinaires
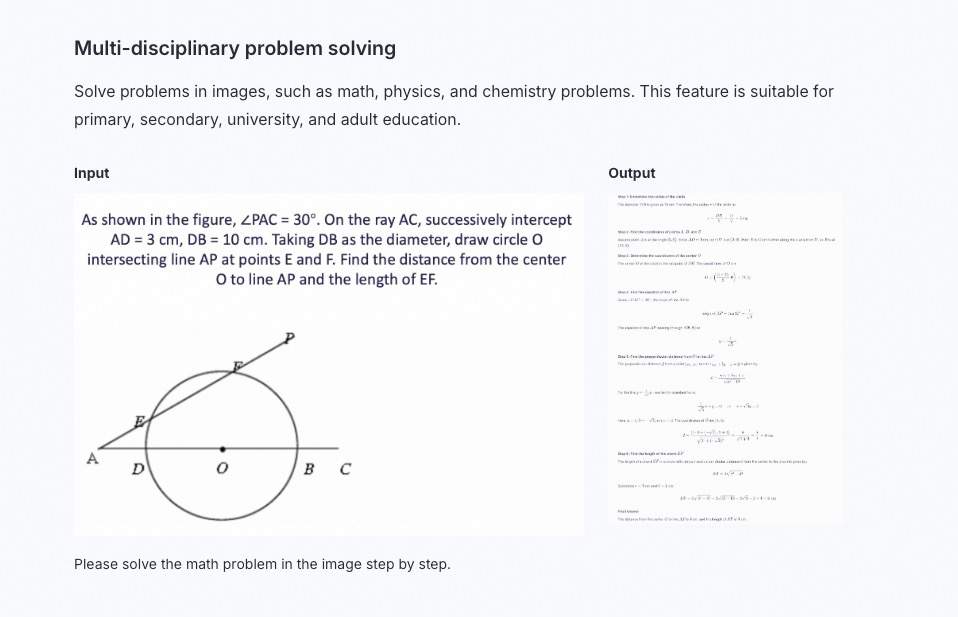
Résolvez des problèmes de mathématiques, de physique, de chimie et d'autres disciplines à partir d'images. Cette fonctionnalité convient à l'enseignement primaire et secondaire, universitaire et à la formation des adultes.
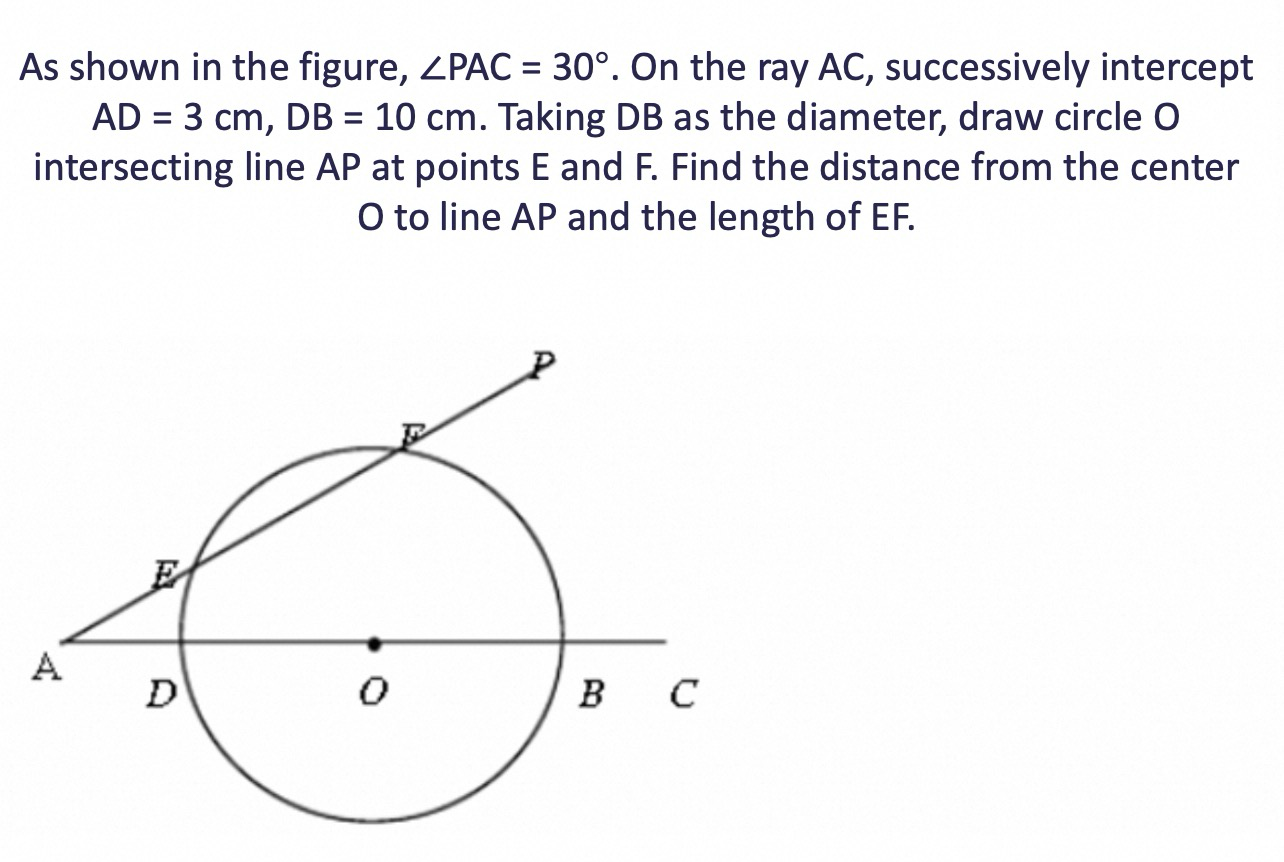 Résolvez pas à pas le problème mathématique présenté dans l'image. | 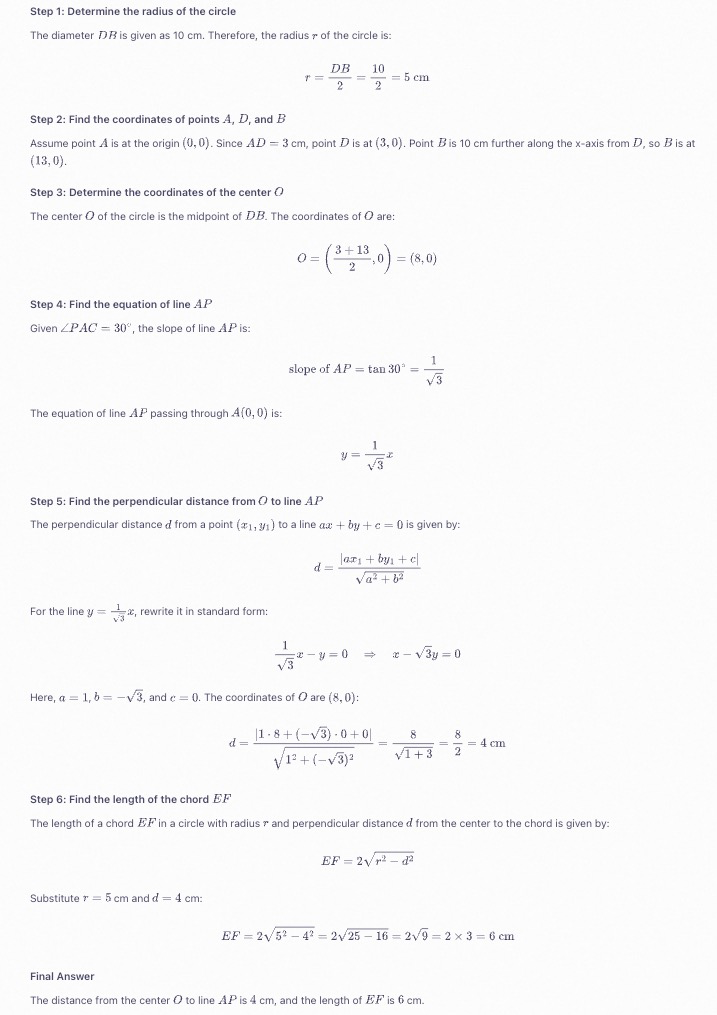 |
|---|
Programmation visuelle
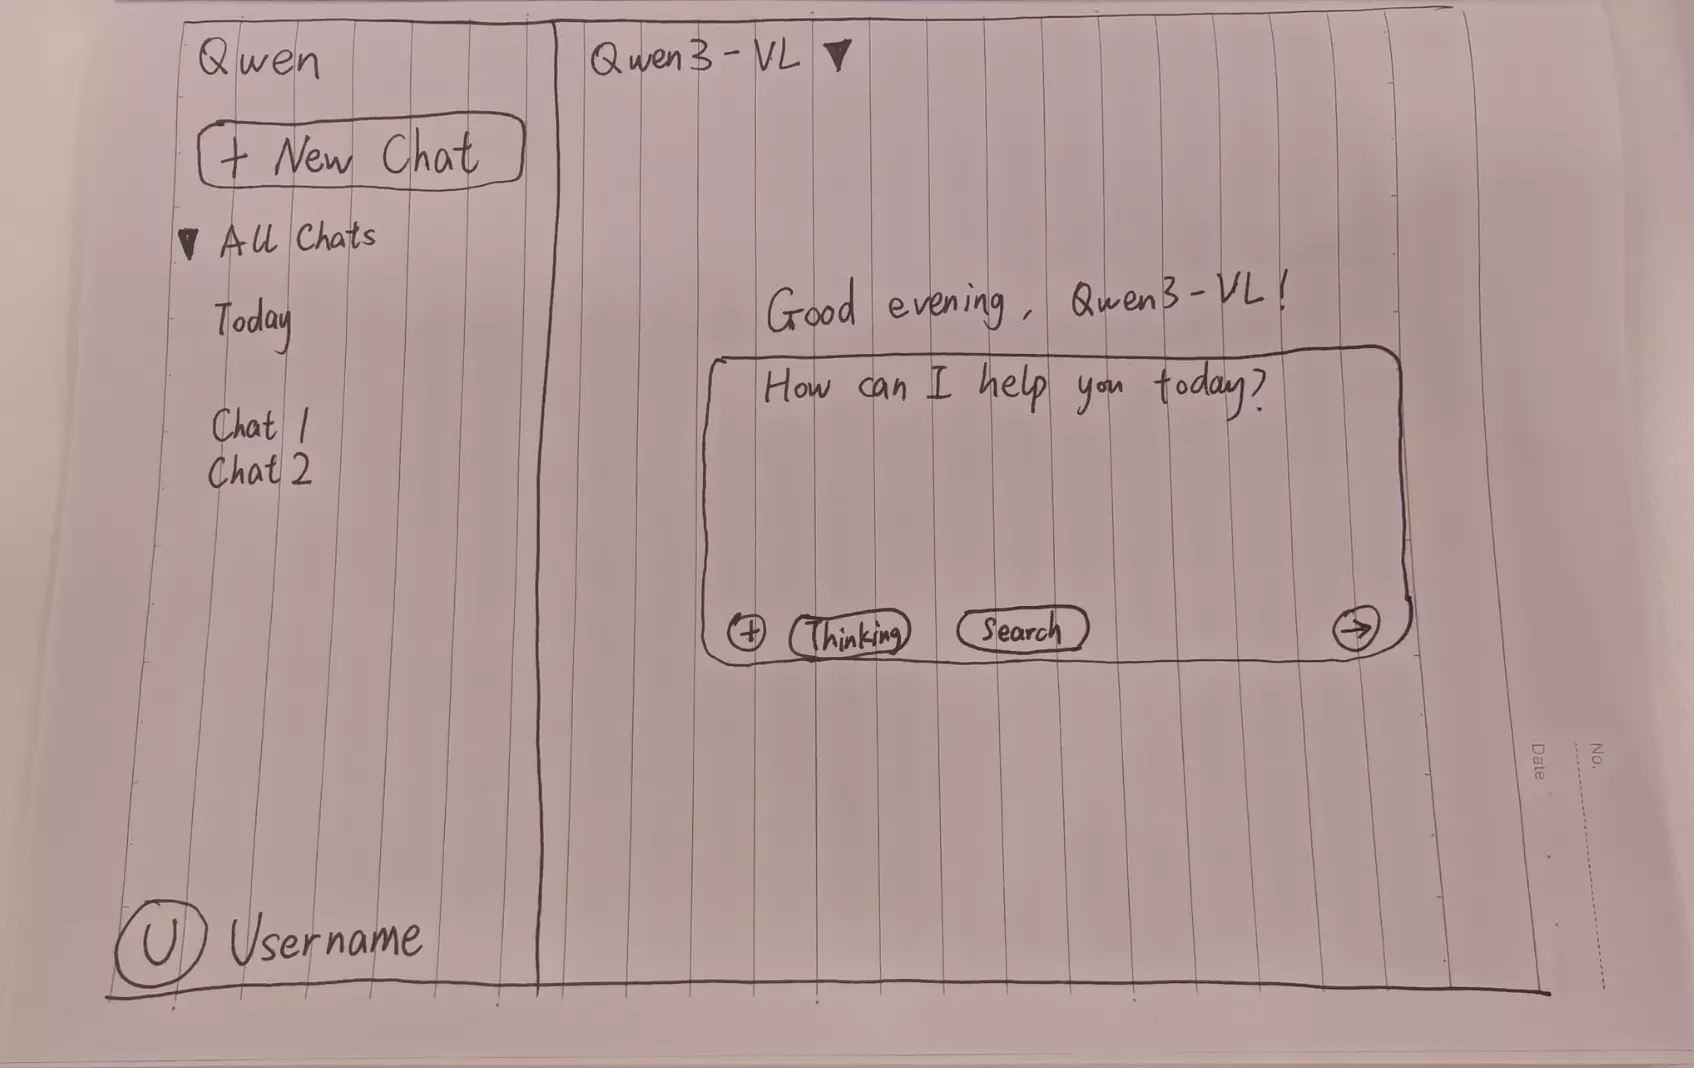
Générez du code à partir d'images ou de vidéos. Utilisez cette fonctionnalité pour produire du code HTML, CSS et JS à partir de maquettes de conception, de captures d'écran de sites web, et bien plus encore.
Créez une page web en HTML et CSS à partir de mon croquis. La couleur principale doit être le noir. |
Aperçu de la page web |
|---|

Localisation d'objets
La localisation 2D et 3D est prise en charge. Cette fonctionnalité permet de déterminer l'orientation d'un objet, les changements de perspective et les relations d'occlusion. La localisation 3D constitue une nouvelle capacité introduite dans le modèle Qwen3-VL.
La localisation d'objets du modèle Qwen2.5-VL est fiable pour les résolutions comprises entre 480 × 480 et 2560 × 2560. En dehors de cette plage, la précision peut diminuer et les cadres de détection peuvent parfois être décalés.
Pour savoir comment représenter les résultats de localisation sur l'image d'origine, consultez la FAQ.
Localisation 2D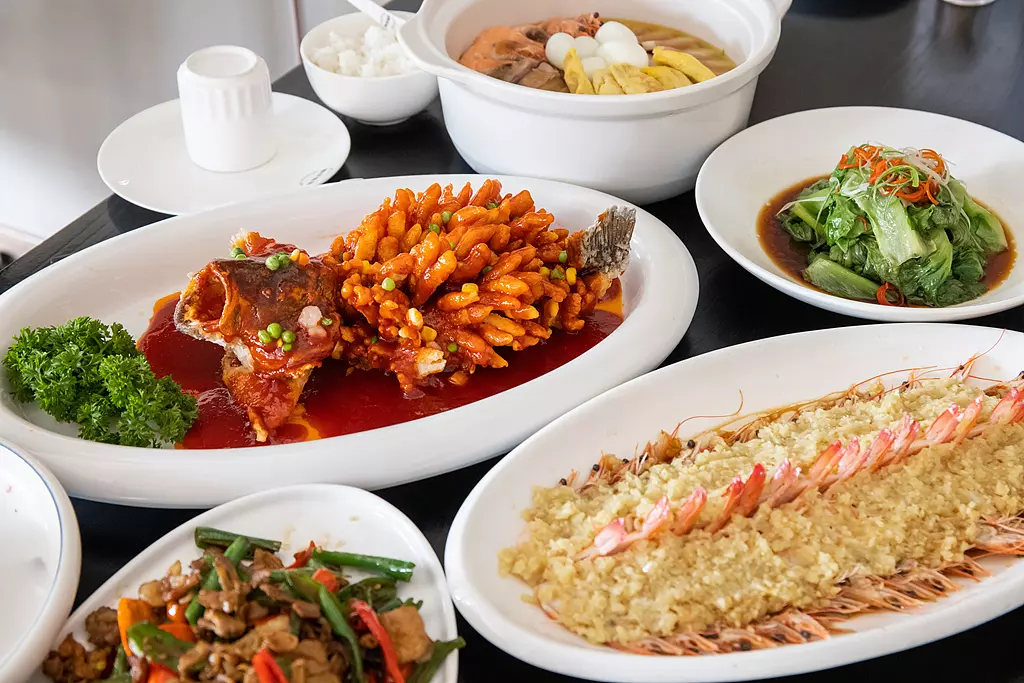
| Visualisation des résultats de localisation 2D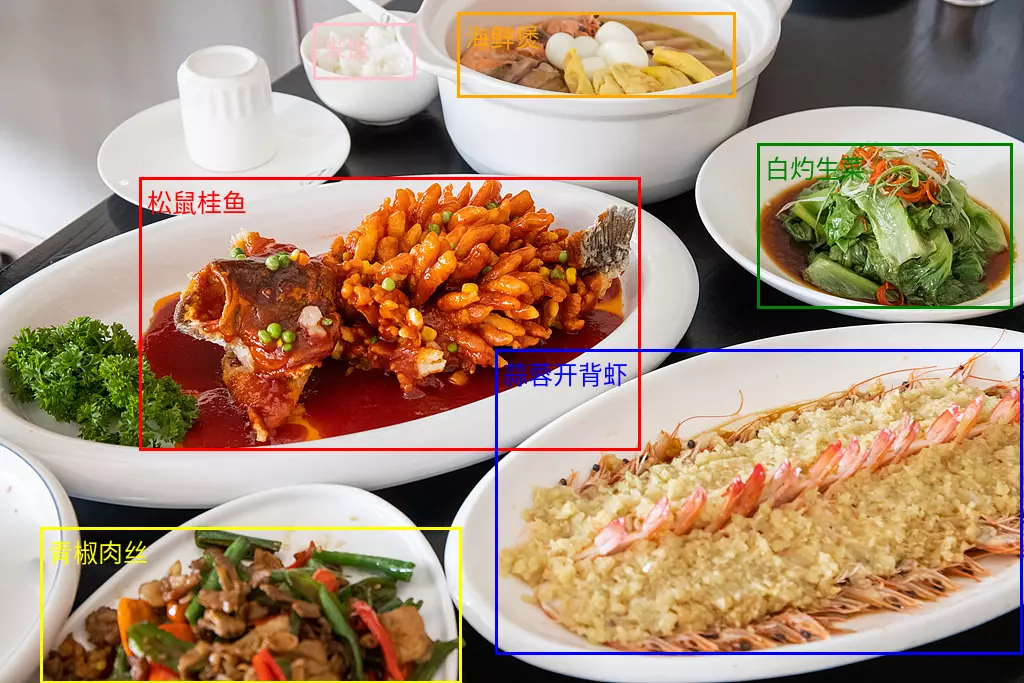 |
Localisation 3D 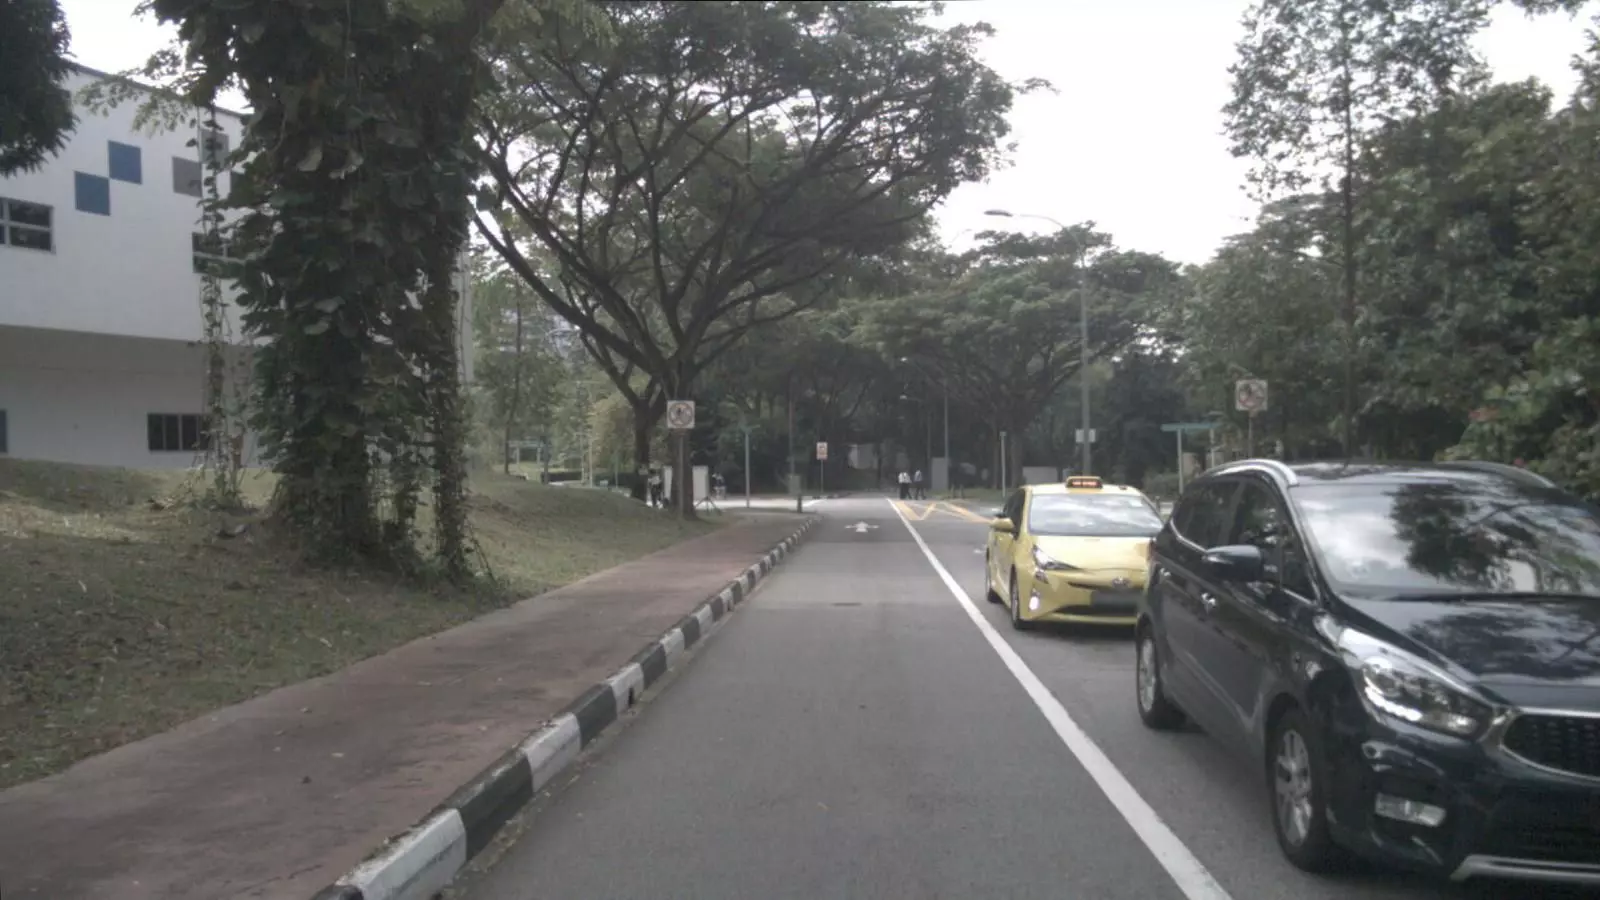 [{"bbox_3d": [x_center, y_center, z_center, x_size, y_size, z_size, roll, pitch, yaw], "label": "category"}]. |
Visualisation des résultats de localisation 3D 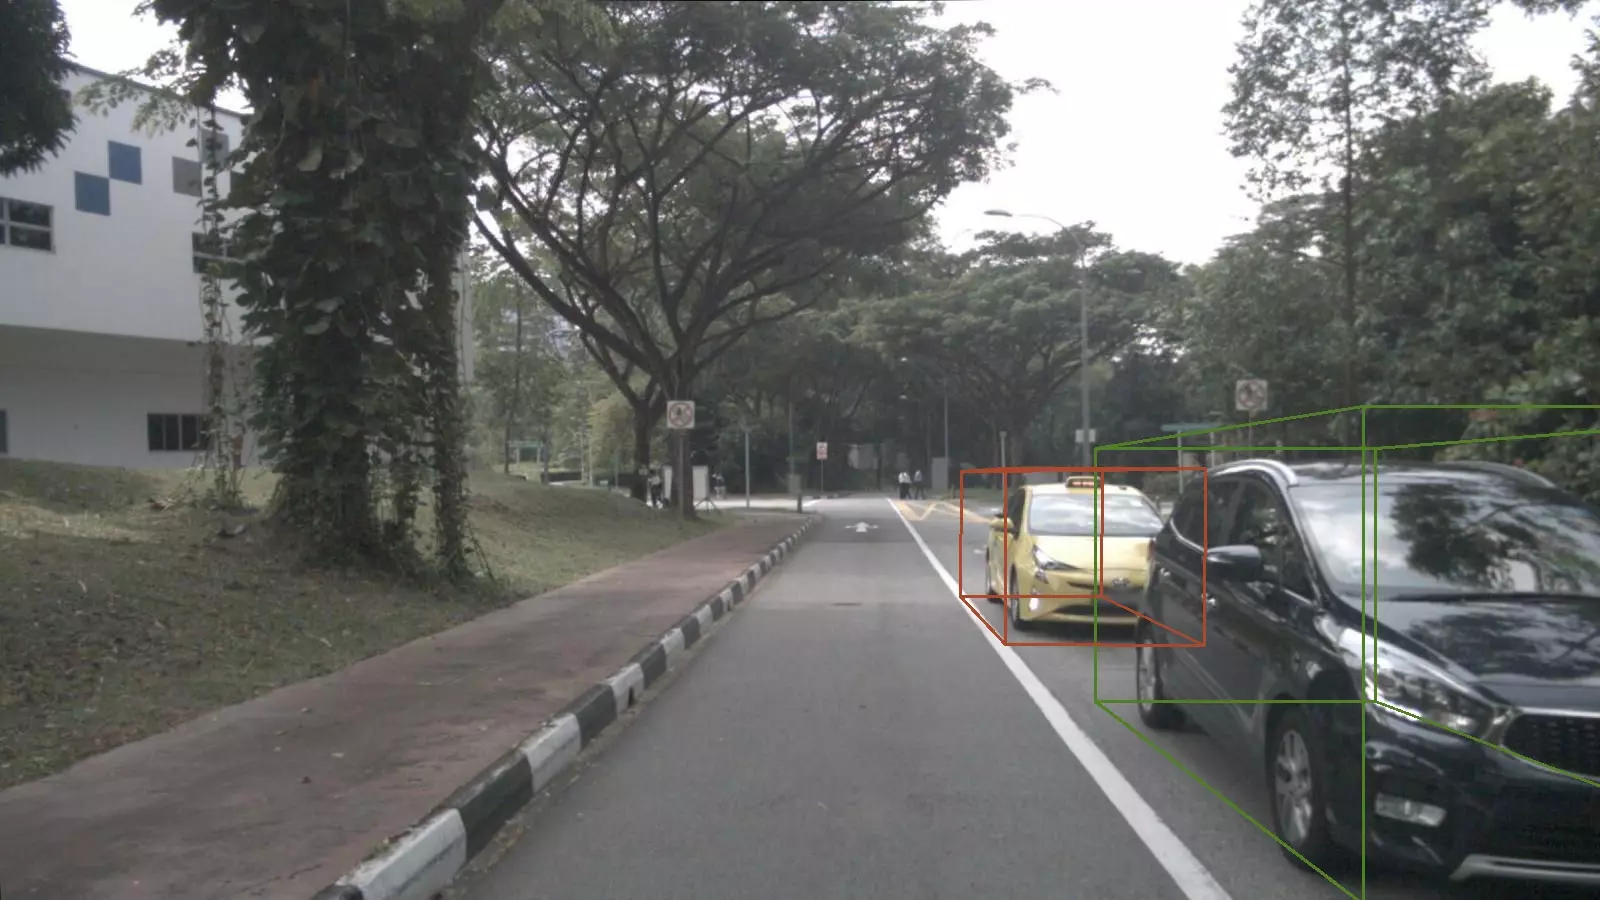 |
Analyse de documents
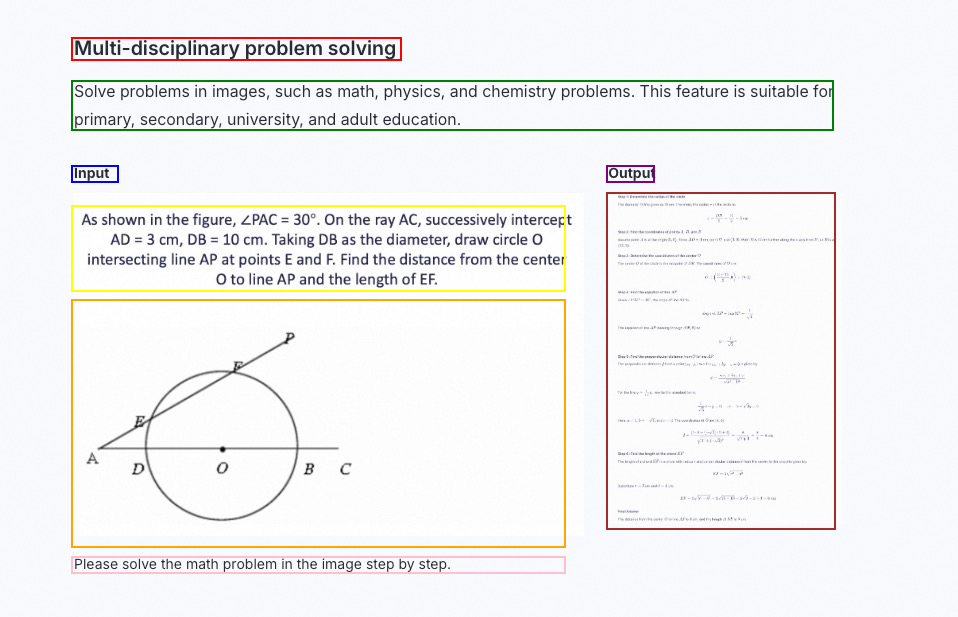
Analysez des documents sous forme d'image (tels que des copies numérisées ou des PDF image) pour les convertir au format QwenVL HTML ou QwenVL Markdown. Ce format permet non seulement de reconnaître le texte avec précision, mais aussi d'obtenir les informations de position d'éléments tels que les images et les tableaux. Le modèle Qwen3-VL ajoute la capacité d'analyse vers le format Markdown.
Les prompts recommandés sont les suivants :qwenvl html(pour une sortie HTML) ouqwenvl markdown(pour une sortie Markdown).
qwenvl markdown. |
Visualisation des résultats |
|---|
Compréhension vidéo
Analysez le contenu d'une vidéo pour localiser des événements spécifiques et obtenir leurs horodatages, ou générez des résumés de périodes clés.
| Décrivez la suite d'actions de la personne dans la vidéo. Renvoyez l'heure de début (start_time), l'heure de fin (end_time) et l'événement (event) au format JSON. Utilisez HH:mm:ss pour l'horodatage. | {"events": [{"start_time": "00:00:00","end_time": "00:00:05","event": "The person walks towards the table holding a cardboard box and places it on the table."},{"start_time": "00:00:05","end_time": "00:00:15","event": "The person picks up a scanner and scans the label on the cardboard box."},{"start_time": "00:00:15","end_time": "00:00:21","event": "The person puts the scanner back in its place and then picks up a pen to record information in a notebook."}]} |
Fonctionnalités principales
Activer ou désactiver le mode de réflexion
-
Les modèles des séries
qwen3.8,qwen3.7,qwen3.6,qwen3.5etqwen3-vl-plussont des modèles à réflexion hybride. Ils peuvent réfléchir avant de répondre ou répondre directement. Le paramètreenable_thinkingpermet d'activer ou de désactiver le mode de réflexion :true: active le mode de réflexion. La valeur par défaut des modèles des sériesqwen3.8,qwen3.7,qwen3.6etqwen3.5esttrue.false: désactive le mode de réflexion. La valeur par défaut des modèles de la sérieqwen3-vl-plusestfalse.
-
Les modèles dont le nom se termine par
thinkingfonctionnent uniquement en mode de réflexion. Ils réfléchissent toujours avant de répondre et ce comportement ne peut pas être désactivé.
- Compatibilité OpenAI
- DashScope
enable_thinking n'est pas un paramètre standard OpenAI. Si vous utilisez le SDK Python OpenAI, transmettez-le via extra_body.Entrée de plusieurs images
Les modèles de compréhension visuelle permettent de transmettre plusieurs images dans une seule requête, ce qui est utile pour des tâches telles que la comparaison de produits et le traitement de documents multipages. Pour cela, incluez simplement plusieurs objets image dans le tableau content du user message.
- Compatibilité OpenAI
- DashScope
- Python
- Node.js
- curl
Réponse
Compréhension vidéo
Les modèles de compréhension visuelle analysent le contenu vidéo fourni sous forme de liste d'images (frames vidéo) ou de fichier vidéo. Les exemples suivants illustrent comment traiter des vidéos en ligne ou des listes d'images spécifiées par une URL. Pour plus d'informations sur les limites vidéo ou le nombre d'images transmissibles dans une liste, consultez Limites vidéo.
Pour améliorer la compréhension des fichiers vidéo, utilisez les versions latest ou les versions snapshot récentes des modèles.
- Fichiers vidéo
- Liste d'images
-
fps : contrôle la fréquence d'extraction des images. Une image est extraite toutes les
1/fpssecondes. Les valeurs sont comprises dans [0.1, 10] et la valeur par défaut est 2.0.- Pour les scènes avec des mouvements rapides, augmentez fps pour capturer davantage de détails.
- Pour les scènes statiques ou les longues vidéos, réduisez fps pour améliorer les performances.
- max_frames : nombre maximal d'images à extraire d'une vidéo. Le système calcule le nombre total d'images à partir de la valeur fps de la vidéo. Si ce nombre dépasse la limite, il échantillonne automatiquement les images à intervalles réguliers pour respecter celle-ci. Ce paramètre est disponible uniquement avec le SDK DashScope.
- Compatibilité OpenAI
- DashScope
Lorsque vous envoyez directement un fichier vidéo au modèle de compréhension visuelle avec le SDK OpenAI ou HTTP, définissez le paramètre"type"du message utilisateur sur"video_url".
Transmettre un fichier local (encodage Base64 ou chemin de fichier)
Les modèles de compréhension visuelle acceptent deux méthodes pour charger des fichiers locaux : l'encodage Base64 et le chargement direct par chemin de fichier. Choisissez la méthode appropriée selon la taille du fichier et le type de SDK utilisé. Pour obtenir des recommandations, reportez-vous à Comment choisir une méthode de chargement de fichier. Quelle que soit la méthode retenue, les fichiers doivent respecter les exigences décrites dans Limitations relatives aux images.
- Téléverser avec un encodage Base64
- Téléverser avec un chemin de fichier
Étapes pour transmettre une chaîne encodée en Base64 (exemple d'image)
Étapes pour transmettre une chaîne encodée en Base64 (exemple d'image)
-
Encodez le fichier : convertissez l'image locale en Base64.
Exemple de code pour convertir une image en encodage Base64
-
Construisez une Data URL au format suivant :
data:[MIME_type];base64,{base64_image}.- Remplacez
MIME_typepar le type de média réel. Il doit correspondre à la valeurMIME Typedu tableau Formats d'image pris en charge, par exempleimage/jpegouimage/png. base64_imageest la chaîne Base64 générée à l'étape précédente.
- Remplacez
-
Appelez le modèle : transmettez
Data URLavec le paramètreimageouimage_url.
- Image
- Fichier vidéo
- Liste d'images
- Transmettre avec un chemin de fichier
- Entrée encodée en Base64
Traitement des images haute résolution
Précision du traitement des images. Pour qwen4-max. Valeur par défaut : high.
Lorsque max_pixels est omis :
high: traite l’image à sa résolution d’origine, jusqu’à16777216pixels.low: limite l’image à2621440pixels.auto: identique àlow.
max_pixels remplace la limite de pixels choisie par detail. Le maximum est 16777216. Dans Chat Completions, placez max_pixels au même niveau que image_url ; dans DashScope, au même niveau que image.
Pour les images haute résolution, high utilise généralement plus de tokens d’entrée que low.
Avec Chat Completions, définissez detail dans image_url ou au même niveau. Avec DashScope, définissez-le au même niveau que image.
vl_high_resolution_images ou ajustez max_pixels pour augmenter le nombre de tokens visuels. Cela permet de conserver davantage de détails dans l'image et d'améliorer la compréhension.
Consultez les pixels par token visuel, la limite de tokens et la limite de pixels pour chaque modèle
Consultez les pixels par token visuel, la limite de tokens et la limite de pixels pour chaque modèle
Si le nombre de pixels de l'image d'entrée dépasse la limite du modèle, l'image est réduite pour respecter cette limite.
Modèle | Pixels par token | vl_high_resolution_images | max_pixels | Limite de tokens | Limite de pixels |
Modèles des séries |
|
|
|
|
|
| Personnalisable. La valeur par défaut est | Déterminé par |
| ||
Série open source |
|
|
|
|
|
| Personnalisable. La valeur par défaut est | Déterminé par |
|
-
Lorsque
vl_high_resolution_images=true, l'API utilise une politique de résolution fixe et ignoremax_pixels. Ce mode convient à la reconnaissance de petits caractères, de petits objets et de détails riches dans les images. -
Lorsque
vl_high_resolution_images=false, la limite finale de pixels dépend du paramètremax_pixels.- Pour réduire la consommation de tokens visuels lorsque le coût est prioritaire, conservez la valeur par défaut de
max_pixelsou réduisez-la.max_pixelsinflue surtout sur le nombre de tokens visuels et le coût de l'appel. Nos tests n'ont pas montré d'effet significatif de sa réduction sur le temps de réponse de bout en bout. - Si vous souhaitez examiner certains détails et acceptez un traitement plus lent, augmentez
max_pixelsselon vos besoins.
- Pour réduire la consommation de tokens visuels lorsque le coût est prioritaire, conservez la valeur par défaut de
- Compatibilité OpenAI
- DashScope
vl_high_resolution_images n'est pas standard dans l'API OpenAI. La méthode pour le transmettre varie selon les SDK :- SDK Python : le paramètre doit être transmis dans le dictionnaire
extra_body. - SDK Node.js : le paramètre peut être transmis directement au niveau supérieur.
Autres utilisations
Limites
Limites des fichiers d'entrée
- Limites des images
- Limites des vidéos
-
Résolution de l'image :
-
Taille minimale : la largeur et la hauteur de l'image doivent toutes deux dépasser
10pixels. -
Rapport hauteur/largeur : le rapport du côté long au côté court ne doit pas dépasser
200:1, pour l'image d'origine comme pour l'image redimensionnée.Pour connaître la logique de redimensionnement, consultez la fonction
smart_resizedans Calculer les tokens d'image. -
Nombre maximal de pixels :
- Maintenez la résolution dans la limite de
8K (7680x4320). Une résolution supérieure peut entraîner un délai d'expiration de l'API à cause de fichiers volumineux et de transferts réseau longs. - Redimensionnement automatique : le modèle ajuste les dimensions avec
max_pixelsetmin_pixels. Une résolution élevée n'améliore pas la précision de détection, mais augmente le risque d'échec. Redimensionnez les images à une taille raisonnable côté client avant de les téléverser.
- Maintenez la résolution dans la limite de
-
Taille minimale : la largeur et la hauteur de l'image doivent toutes deux dépasser
-
Formats d'image pris en charge
-
Pour les résolutions inférieures à 4K
(3840x2160), les formats suivants sont pris en charge :Format d'image
Extensions courantes
Type MIME
BMP
.bmp
image/bmp
JPEG
.jpe, .jpeg, .jpg
image/jpeg
PNG
.png
image/png
TIFF
.tif, .tiff
image/tiff
WEBP
.webp
image/webp
HEIC
.heic
image/heic
-
Pour les résolutions comprises entre
4K (3840x2160)et8K (7680x4320), seuls JPEG, JPG et PNG sont pris en charge.
-
Pour les résolutions inférieures à 4K
-
Taille de l'image :
Les limites suivantes s'appliquent à chaque image individuellement. Pour les entrées multi-images, chaque image est évaluée indépendamment et les tailles ne sont pas cumulées.
- URL publique : une image ne doit pas dépasser
20 MBpour les séries Qwen4-Max, Qwen3.8, Qwen3.7, Qwen3.6, Qwen3.5 et Qwen3-VL. Pour les autres modèles, la limite est10 MB. - Chemin local : une image ne doit pas dépasser
10 MB. - Encodage Base64 (API compatible OpenAI) : pour les séries Qwen4-Max, Qwen3.8, Qwen3.7, Qwen3.6, Qwen3.5 et Qwen3-VL, le fichier d'origine avant encodage ne doit pas dépasser
20 MB. Pour les autres modèles, la limite est10 MB. Dans les deux cas, la chaîne Data URI obtenue ne doit pas dépasser20 MB. - Encodage Base64 (API compatible Anthropic) : l'ensemble du corps de la requête ne doit pas dépasser
6 MB. Plusieurs images partagent ce quota.
Pour compresser un fichier, consultez Comment compresser une image ou une vidéo à la taille requise ?.
- URL publique : une image ne doit pas dépasser
-
Nombre d'images : le nombre maximal d'images en entrée multiple dépend du mode de transmission :
-
URL publiques ou chemins locaux :
- Séries Qwen3.8-Max, Qwen3.8-Flash et Qwen3.7-Plus : jusqu'à 2,048 images
- Séries Qwen3.7-Flash, Qwen3.6-Plus, Qwen3.6-Flash, Qwen3.5-Plus, Qwen3.5-Flash, Qwen3-VL, Qwen-VL et QVQ : jusqu'à 256 images
- Pour la série Qwen-Omni, consultez Multimodal intégral.
- Chaînes encodées en Base64 : jusqu'à 250 images
-
URL publiques ou chemins locaux :
Le nombre total de tokens des images est également soumis à la limite d'entrée du modèle. La somme des tokens des images et du texte ne doit pas dépasser cette limite.
Modes de transmission des fichiers
-
URL publique : fournissez une adresse accessible publiquement via HTTP ou HTTPS. Pour améliorer la stabilité et les performances, téléversez le fichier dans OSS pour obtenir une URL publique. Model Studio ne peut pas accéder aux endpoints internes OSS, dont l'adresse contient
-internal, commehttps://<bucket>.oss-cn-hangzhou-internal.aliyuncs.com/image.jpg. Avec une adresse interne, le téléchargement échoue etInvalidParameterest renvoyé avec le messageFailed to download multimodal content. Utilisez un endpoint public OSS, commehttps://<bucket>.oss-cn-hangzhou.aliyuncs.com/image.jpg, ou une URL OSS présignée. - Encodage Base64 : convertissez le fichier en chaîne Base64, puis transmettez-la.
- Chemin local (SDK DashScope uniquement) : transmettez le chemin d'un fichier local.
Pour choisir un mode de transmission, consultez Comment choisir une méthode de téléversement ?.
Utilisation en production
- Prétraitement des images et vidéos : les modèles imposent des limites de taille. Pour compresser les fichiers, consultez Méthodes de compression des images et vidéos.
-
Traitement de fichiers texte : les modèles de compréhension visuelle traitent uniquement les images et les vidéos, et non les fichiers TXT, Word (.doc/.docx), PDF ou autres fichiers textuels. Utilisez l'une des solutions suivantes :
- Convertissez le fichier texte en images. Une bibliothèque telle que pdf2image pour Python permet de convertir chaque page en image de haute qualité. Transmettez ensuite les images au modèle avec l'entrée multiple.
- Utilisez Qwen-Long, qui permet de téléverser des documents et de converser en transmettant leurs informations via
file-id.
-
Tolérance aux pannes et stabilité
- Délais d'expiration : sans streaming, une erreur de délai d'expiration survient si la génération n'est pas terminée en 300 secondes. Le contenu déjà généré est renvoyé dans le corps de la réponse. Un en-tête contenant
x-dashscope-partialresponse: trueindique ce dépassement. Utilisez le mode partiel, pris en charge par certains modèles : ajoutez le contenu généré au tableaumessageset renvoyez la requête pour poursuivre la génération. Consultez Poursuivre une génération incomplète. - Délai d'expiration côté client : le délai de 300 secondes décrit ci-dessus concerne le serveur et diffère du délai par défaut du SDK. Pour une grande image, par exemple de 4000 x 4000 pixels, une requête peut dépasser le délai du SDK et être interrompue par une erreur
APITimeoutErroravant d'atteindre la limite serveur. Utilisezwith_optionsdans le SDK OpenAI Python pour augmenter le délai côté client :
- Délais d'expiration : sans streaming, une erreur de délai d'expiration survient si la génération n'est pas terminée en 300 secondes. Le contenu déjà généré est renvoyé dans le corps de la réponse. Un en-tête contenant
- Sortie en streaming : définissez
stream=Truepour recevoir le contenu progressivement au lieu d'attendre une réponse complète. Cela évite les dépassements du délai client liés aux appels longs sans streaming lors du traitement de grandes images :
- Nouvelles tentatives : prévoyez une stratégie adaptée, par exemple un délai exponentiel, pour gérer les fluctuations réseau ou une indisponibilité temporaire du service.
Facturation et limitation du débit
-
Facturation : le coût total dépend du nombre de tokens d'entrée et de sortie. Consultez les tarifs dans la console Model Studio.
- Composition des tokens : les tokens d'entrée comprennent le texte et les images ou vidéos converties en tokens. Les tokens de sortie correspondent au texte généré. En mode de réflexion, le raisonnement est aussi comptabilisé en sortie. S'il n'est pas renvoyé, la facturation applique les tarifs du mode sans réflexion.
-
Calculer les tokens des images et vidéos : utilisez le code suivant pour estimer leur consommation. L'estimation est indicative ; la consommation réelle est celle de la réponse de l'API.
Calculer les tokens pour les images et vidéos
- Images
- Vidéos
Formule :Image Tokens = h_bar * w_bar / token_pixels + 2-
h_bar, w_bar: hauteur et largeur de l'image redimensionnée. Avant le traitement, le modèle réduit l'image selon une limite de pixels déterminée parmax_pixelsetvl_high_resolution_images. Consultez Traiter des images haute résolution. -
token_pixels: nombre de pixels correspondant à chaquetokenvisuel. Il varie selon le modèle :qwen3.8-series,qwen3.7-series,qwen3.6-series,qwen3.5-series,Qwen3-VL: chaquetokencorrespond à32x32pixels.QVQet autres modèlesQwen2.5-VL: chaque token correspond à28x28pixels.
32×32pixels. Le nombre minimal de pixels est65536. Définissezmodel="qwen4-max"dans le code ci-dessous pour utiliser ses règles dedetailet de pixels ; unmax_pixelsexplicite est prioritaire.
- Consulter les factures : consultez les factures ou rechargez votre compte depuis la page Expenses and Costs de la console Alibaba Cloud.
- Limitation du débit : pour connaître les limites des modèles de compréhension visuelle, consultez Limitation du débit.
- Quota gratuit (région Singapore uniquement) : les modèles de compréhension visuelle bénéficient d'un quota gratuit de 1 million de tokens. Sa validité de 90 jours commence à l'activation de Model Studio ou à l'approbation de votre demande d'accès au modèle.
Référence API
Pour plus d'informations sur les paramètres d'entrée et de sortie du modèle de compréhension visuelle, reportez-vous à génération de texte.
FAQ
Comment choisir une méthode de téléversement ?
Comment choisir une méthode de téléversement ?
Type de fichier | Spécifications du fichier | SDK DashScope (Python, Java) | API compatible OpenAI / HTTP DashScope |
|---|---|---|---|
Image | Supérieure à 7 Mo et inférieure à 10 Mo | Indiquer le chemin local | Seules les URL publiques sont prises en charge. Utilisez Alibaba Cloud Object Storage Service. |
Inférieure à 7 Mo | Indiquer le chemin local | Encodage Base64 | |
Vidéo | Supérieure à 100 Mo | Seules les URL publiques sont prises en charge. Utilisez Alibaba Cloud Object Storage Service. | Seules les URL publiques sont prises en charge. Utilisez Alibaba Cloud Object Storage Service. |
Supérieure à 7 Mo et inférieure à 100 Mo | Indiquer le chemin local | Seules les URL publiques sont prises en charge. Utilisez Alibaba Cloud Object Storage Service. | |
Inférieure à 7 Mo | Indiquer le chemin local | Encodage Base64 |
L'encodage Base64 augmente le volume des données. Le fichier d'origine doit être inférieur à 7 MB.
Utilisez Base64 ou un chemin local pour éviter les délais d'expiration des téléchargements côté serveur et améliorer la stabilité.
Comment compresser une image ou une vidéo à la taille requise ?
Comment compresser une image ou une vidéo à la taille requise ?
Méthodes de compression d'image
Méthodes de compression d'image
- Outils en ligne : utilisez par exemple CompressJPEG pour compresser les images.
- Logiciels locaux : utilisez par exemple Photoshop pour ajuster la qualité à l'exportation.
- Exemple de code :
Méthodes de compression vidéo
Méthodes de compression vidéo
- Outils en ligne : utilisez par exemple FreeConvert pour compresser les vidéos.
- Logiciels locaux : utilisez par exemple HandBrake.
- Exemple de code : utilisez FFmpeg. Pour plus d'informations, consultez le site officiel de FFmpeg.
Comment dessiner les cadres de détection sur l'image d'origine après la localisation des objets par le modèle ?
Comment dessiner les cadres de détection sur l'image d'origine après la localisation des objets par le modèle ?
- Qwen2.5-VL : les coordonnées renvoyées sont des valeurs absolues en pixels, relatives à l'angle supérieur gauche de l'image redimensionnée. Pour dessiner les cadres, consultez qwen2_5_vl_2d.py.
- Séries Qwen3-VL, Qwen3.5, Qwen3.6 et Qwen3.7 (par exemple qwen3.5-plus, qwen3.6-plus et qwen3.7-plus) : les coordonnées renvoyées sont relatives et normalisées dans l'intervalle
[0, 999]. Consultez qwen3_vl_2d.py pour la localisation 2D ou qwen3_vl_3d.zip pour la localisation 3D.