

Les jeux de données constituent la base de l'entraînement et de l'évaluation des modèles. La fonctionnalité Data Management d'Alibaba Cloud Model Studio vous aide à créer et gérer efficacement vos jeux de données.
Aperçu des jeux de données
La fonctionnalité Data Management d'Alibaba Cloud Model Studio gère de manière centralisée tous les jeux de données liés aux grands modèles dans votre espace de travail professionnel. Les jeux de données se divisent en Training Set (utilisé pour réglage fin du modèle, prenant en charge SFT/DPO/CPT) et Evaluation Set (utilisé pour évaluation du modèle).
Les ensembles d'entraînement prennent en charge quatre scénarios : génération de texte, compréhension multimodale, image vers vidéo (première image) et image vers vidéo (première et dernière image). Les ensembles d'évaluation ne prennent en charge que le scénario de génération de texte. Le type de jeu de données est immuable après sa création ; choisissez-le avec soin en fonction de votre utilisation ultérieure.
Les noms des jeux de données peuvent comporter jusqu'à 50 caractères (les caractères chinois, anglais, les chiffres, les traits de soulignement, les tirets et les points sont pris en charge) et les descriptions jusqu'à 200 caractères. Il est impossible de créer ou de publier des jeux de données vides. Le nombre de jeux de données créables et la quantité de données importables sont illimités.
Les méthodes d'entraînement DPO/CPT et le montage du stockage cloud sont disponibles uniquement dans la région de Pékin.
Méthodes d'entraînement et scénarios
Les ensembles d'entraînement prennent en charge trois méthodes d'entraînement, chacune ayant des scénarios applicables et des exigences minimales en matière de données différentes :
- SFT (Supervised Fine-Tuning) : réglage fin par instruction qui permet au modèle de résoudre des tâches spécifiques. Nous recommandons au moins mille entrées. Disponible sur tous les sites.
- DPO (Direct Preference Optimization) : entraînement d'alignement des préférences. Nous recommandons au moins cent entrées.
- CPT (Continual Pre-Training) : injection de connaissances spécifiques à un domaine. Nous recommandons au moins 50 millions de tokens de données.
Méthode d'entraînement | Objectif | Volume de données recommandé | Disponibilité du site |
|---|---|---|---|
SFT | Réglage fin supervisé (réglage fin par instruction) | Plus de 1 000 entrées | Tous les sites |
DPO | Optimisation directe des préférences (alignement des préférences) | Plus de 100 entrées | Région de Pékin |
CPT | Pré-entraînement continu (connaissances du domaine) | 50 millions de tokens | Région de Pékin |
Méthodes d'importation
Les jeux de données prennent en charge trois méthodes d'importation, chacune ayant des scénarios applicables et des prérequis différents :
- Upload Local File : aucun prérequis ; téléchargez directement des fichiers locaux, adapté aux petits lots de données.
- OSS Import : ajoutez le tag
bailian-datahub-access=readau bucket cible ; adapté aux grands lots de données. Non pris en charge pour les ensembles d'évaluation. - Log Backflow : extrait automatiquement les données d'entraînement des journaux d'inférence SLS ; nécessite l'autorisation d'un rôle lié au service, formant une boucle d'amélioration inférence → données → réglage fin.
Méthode d'importation | Prérequis | Scénario applicable | Ensemble d'évaluation pris en charge |
|---|---|---|---|
Téléchargement local | Aucun | Petits lots de données | Pris en charge |
Importation OSS | Tag de bucket bailian-datahub-access=read | Grands lots de données | Non pris en charge |
Log Backflow | Autorisation + Clé API/filtre de modèle | Construire des données d'entraînement à partir des journaux d'inférence | Pris en charge |
Data Preparation
La préparation de données de haute qualité est essentielle pour obtenir de bons résultats lors du réglage fin du modèle. Pour les volumes de données recommandés pour chaque méthode d'entraînement (génération de texte SFT/DPO/CPT), consultez les Règles de téléchargement des données de réglage.
Il n'existe pas de volumes de données recommandés officiels pour les ensembles d'entraînement de compréhension multimodale et d'image vers vidéo ; préparez suffisamment d'échantillons en fonction de votre scénario réel.
Format des données et modèles
Pour les spécifications de format des fichiers de données de chaque scénario d'entraînement (texte SFT/compréhension multimodale (image/vidéo → texte), DPO, CPT, ensembles d'évaluation), consultez les Règles de téléchargement des données de réglage.
Sur la page de création de jeu de données Data Management, téléchargez le modèle de données correspondant au scénario ; préparer les données selon la structure du modèle permet d'éviter les échecs d'importation. Les ensembles d'évaluation prennent en charge le format mono-tour Text generation (prompt&completion) et le format de dialogue multi-tours Text generation (ChatML-messages) ; pour les spécifications détaillées des champs et des exemples, consultez Règles de téléchargement des données de réglage - Format du jeu d'évaluation.
Pour les stratégies de diversité et d'augmentation des données, consultez la documentation sur le réglage fin du modèle. Pour les ensembles d'évaluation, préparez un ensemble indépendant de données non chevauchantes afin d'évaluer objectivement la généralisation du modèle.
Créer un jeu de données
Avant de créer un jeu de données, assurez-vous que les prérequis suivants sont remplis : le service Model Studio est activé ; pour l'importation OSS, ajoutez le tag bailian-datahub-access=read au bucket cible ; pour le Log Backflow, autorisez un rôle lié au service.
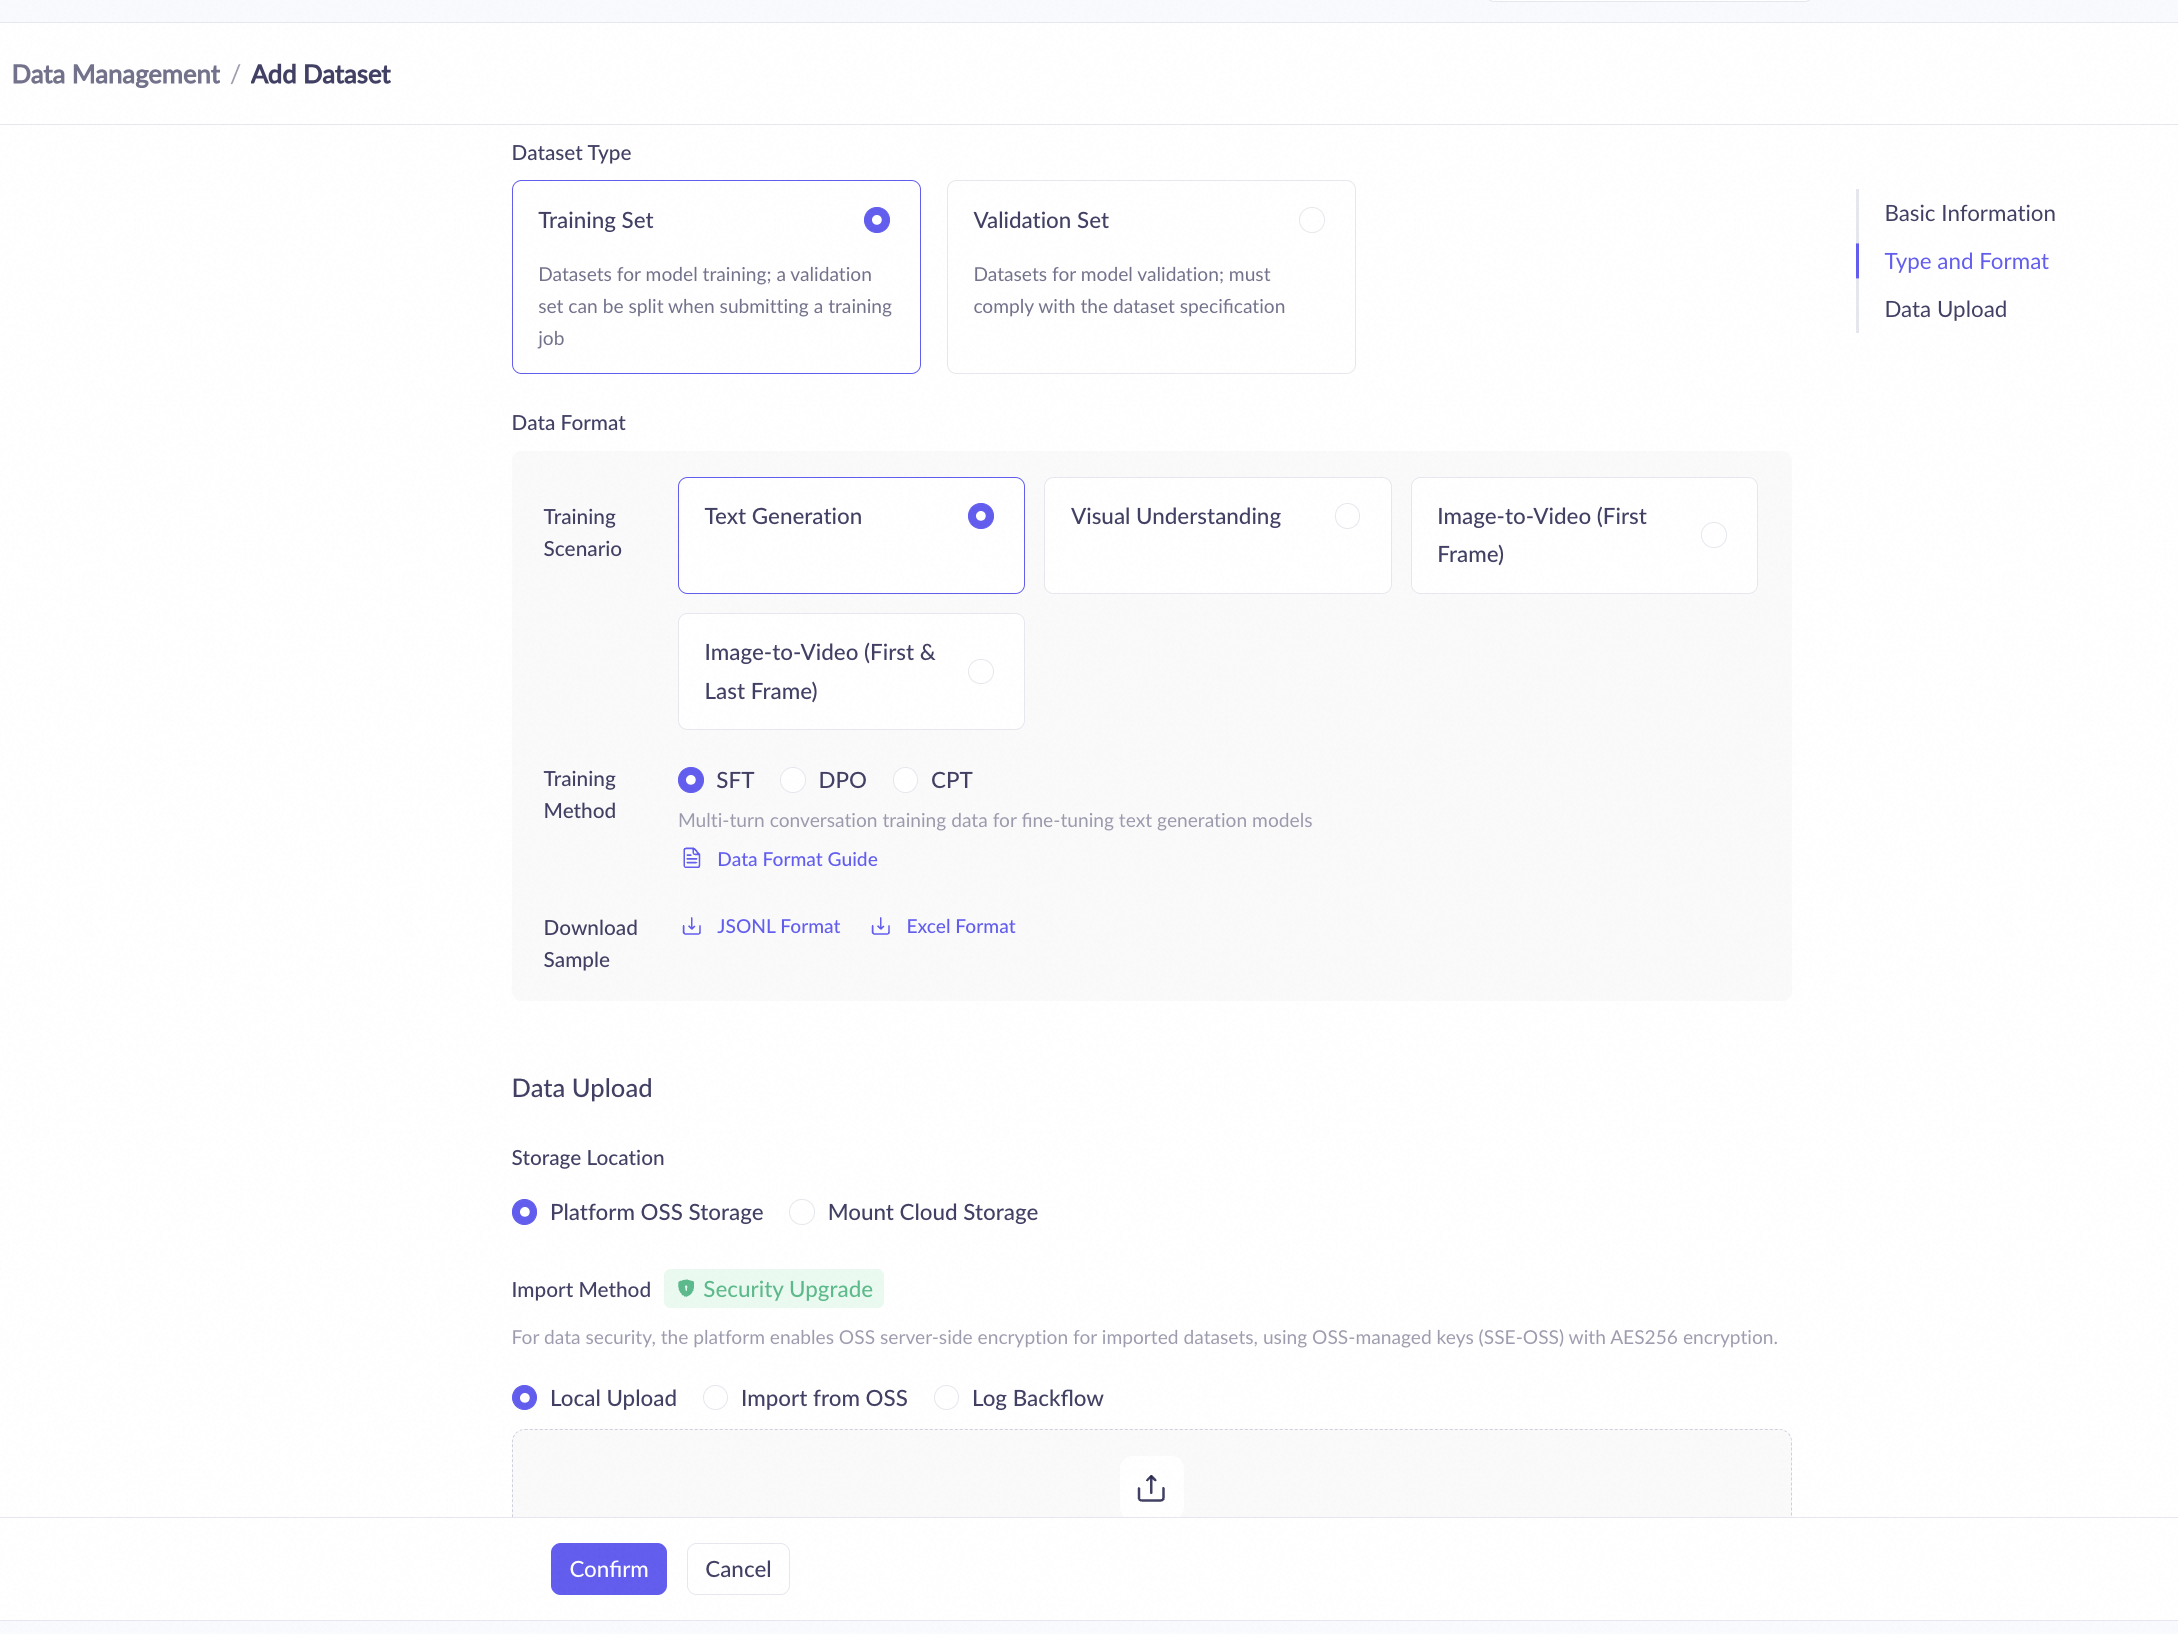
Sur la page de liste Data ManagementData Management > Dataset, cliquez sur Add Dataset, puis suivez ces étapes :
- Saisissez un nom de jeu de données (jusqu'à 50 caractères) et une description (jusqu'à 200 caractères, facultative).
- Sélectionnez un type de jeu de données : Training Set ou Evaluation Set (ne peut pas être modifié après la création).
- Sélectionnez un scénario d'entraînement : les ensembles d'entraînement prennent en charge la génération de texte, la compréhension multimodale, l'image vers vidéo (première image) et l'image vers vidéo (première et dernière image) ; pour les ensembles d'évaluation, sélectionnez ici le format d'échantillon : Text generation (ChatML-messages) (dialogue multi-tours ; prend en charge jsonl, xls et xlsx, 200 Mo maximum par fichier) ou Text generation (prompt&completion) (mono-tour ; xls et xlsx uniquement, 20 Mo maximum par fichier). La page de création fournit le téléchargement de modèles d'exemple pour les formats correspondants.
- Sélectionnez une méthode d'entraînement : SFT, DPO ou CPT (uniquement requis pour les ensembles d'entraînement ; les ensembles d'évaluation n'ont pas cette configuration).
- Sélectionnez un emplacement de stockage : Platform OSS storage (gratuit, sans limite de volume de données) ou Mount Cloud Storage (non disponible pour les ensembles d'évaluation).
- Sélectionnez une méthode d'importation et téléchargez les données : téléchargement local, importation OSS ou Log Backflow (voir les descriptions des onglets ci-dessous).
- Cliquez sur Submit ; le jeu de données est publié immédiatement, ce qui achève la création.
Paramètre | Description | Obligatoire | Description de la valeur |
|---|---|---|---|
Nom du jeu de données | Identifiant du jeu de données | true | Jusqu'à 50 caractères ; chinois/anglais/chiffres/trait de soulignement/tiret/point |
Description du jeu de données | Description du jeu de données | Jusqu'à 200 caractères | |
Type de jeu de données | Ensemble d'entraînement ou ensemble d'évaluation ; ne peut pas être modifié après la création | true | Training Set/Evaluation Set |
Scénario d'entraînement | Scénario d'entraînement auquel les données s'appliquent | true | Génération de texte/Compréhension multimodale/Image vers vidéo (première image)/Image vers vidéo (première et dernière image) |
Méthode d'entraînement | Type d'algorithme d'entraînement | true | SFT/DPO/CPT |
Emplacement de stockage | Méthode de stockage du jeu de données | true | Platform OSS storage/Montage du stockage cloud |
Méthode d'importation | Source d'importation des données | true | Téléchargement local/Importation OSS/Log Backflow |
- Téléchargement local
- Importation OSS
- Log Backflow
Gestion des versions
Un jeu de données peut comporter plusieurs versions indépendantes, dont les numéros de version s'incrémentent automatiquement. Sur la page de détail du jeu de données, cliquez sur Add Version pour créer une nouvelle version.
Lors de l'ajout d'une version, le mode de création nouvelle est utilisé ; toutes les données doivent être réimportées. Le mode d'héritage qui modifie incrémentiellement les données de la version précédente n'est plus pris en charge.
- Create Mode : réimportez toutes les données ; adapté aux mises à jour à grande échelle.
Gestion des jeux de données
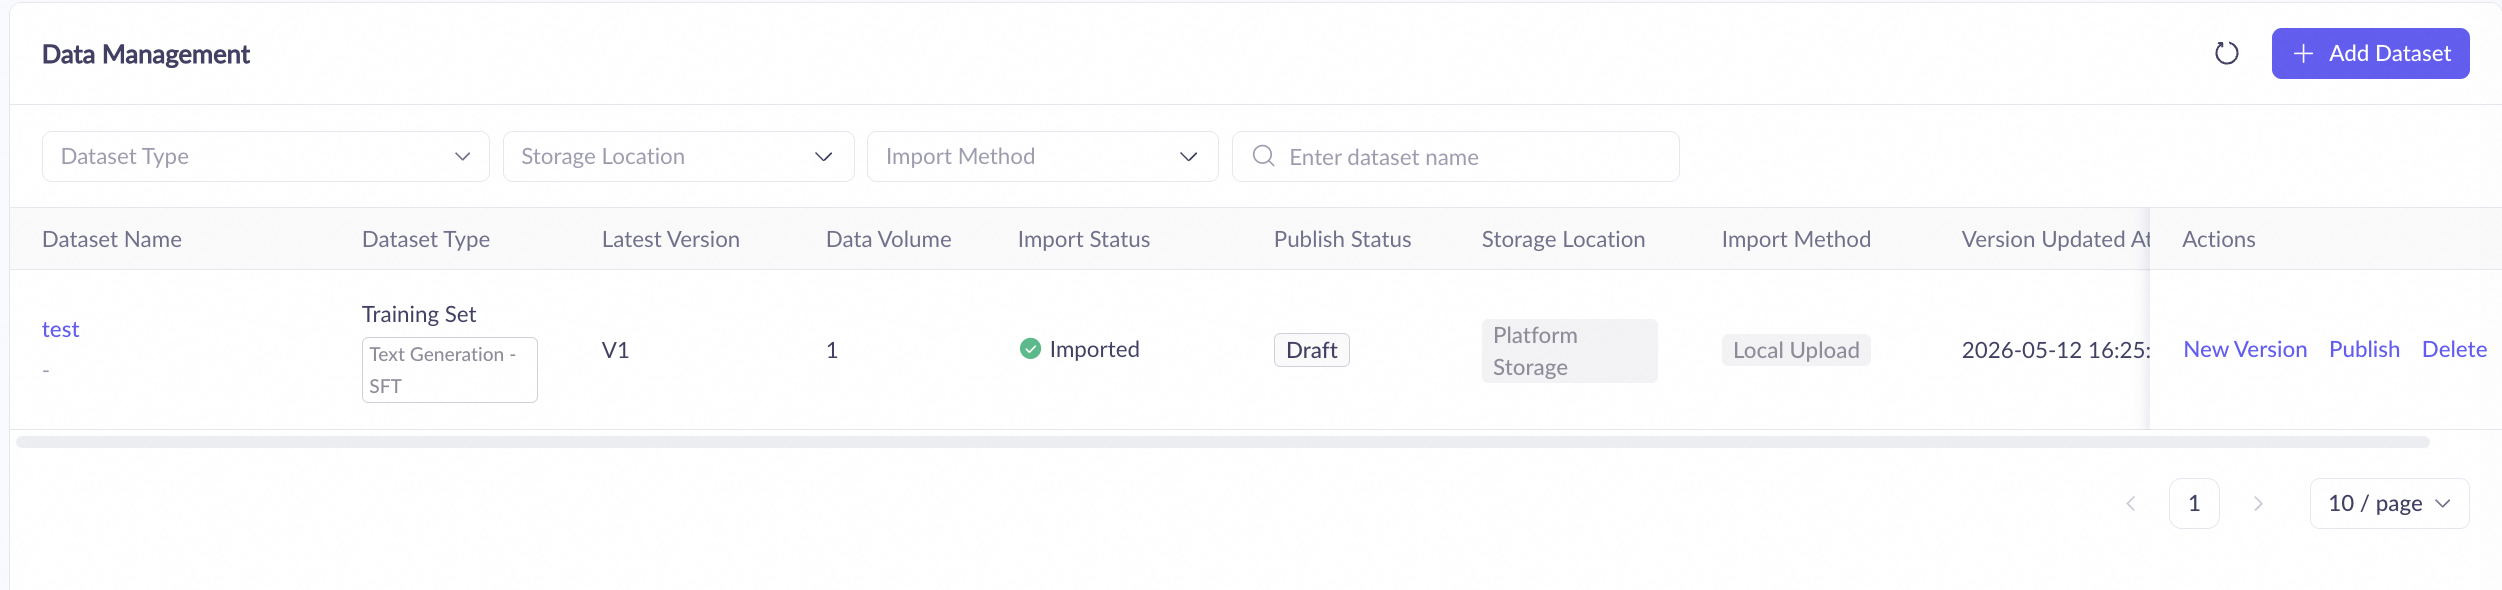
Sur la page de liste Data ManagementData Management > Dataset, vous pouvez consulter tous les jeux de données, filtrer par type (ensemble d'entraînement/ensemble d'évaluation) et rechercher par nom. Les jeux de données en cours d'importation actualisent automatiquement leur statut toutes les 5 secondes ; aucune actualisation manuelle n'est nécessaire.
Publication et suppression
La commande Publish est irréversible ; les versions publiées ne peuvent pas être modifiées. La commande Delete sur une version publiée est également irréversible ; seules les versions brouillons historiques peuvent être supprimées. La suppression d'un jeu de données entier entraîne la suppression de toutes ses versions. Toutes ces opérations sont irréversibles ; procédez avec prudence.
Modification et exportation
Seules les versions brouillons historiques peuvent être modifiées en ligne (le contenu Prompt/Completion est modifiable) ; les nouveaux jeux de données sont publiés immédiatement après soumission et ne génèrent plus de versions brouillons ; la modification n'est pas disponible pour les versions publiées. Lors de l'exportation des jeux de données, chaque type possède un format différent : les ensembles d'entraînement SFT sont exportés au format .jsonl, les ensembles d'entraînement multimodaux au format .zip et les ensembles d'évaluation au format .xlsx. L'exportation de jeux de données vides n'est pas prise en charge.
Facturation
La fonctionnalité Data Management est gratuite, mais le stockage des jeux de données et les ressources en aval engendrent des frais ; consultez la page de facturation de Model Studio pour plus de détails.
- Platform OSS storage : les frais sont basés sur la page de facturation de Model Studio.
- Mount Cloud Storage : les frais sont facturés sur le compte OSS de l'utilisateur.
- Log Backflow : les frais SLS encourus sont facturés sur le compte du produit SLS.
Étapes suivantes
Une fois un jeu de données créé et publié, il peut être utilisé dans les scénarios en aval suivants :
- Une fois un ensemble d'entraînement publié, il est utilisé pour réglage fin du modèle (SFT/DPO/CPT).
- Une fois un ensemble d'évaluation publié, il est utilisé pour évaluation du modèle.