Si les performances d'un modèle ne répondent pas à vos attentes après l'application de méthodes d'optimisation telles que le prompt engineering ou les appels de plugins, vous pouvez recourir au fine-tuning de modèle dans Alibaba Cloud Model Studio. Stratégie centrale pour améliorer les performances, le fine-tuning renforce considérablement les capacités d'un modèle dans des secteurs industriels ou des scénarios métier spécifiques. Il permet également d'aligner les sorties sur les préférences humaines et de réduire la latence. Trois méthodes d'entraînement sont disponibles : le supervised fine-tuning (SFT), le continual pre-training (CPT) et le direct preference optimization (DPO).
Présentation du fine-tuning de modèle
Le fine-tuning de modèle constitue une méthode essentielle pour optimiser les performances d'un modèle. Il permet notamment :
- D'améliorer les performances du modèle pour des secteurs d'activité ou des besoins métier spécifiques
- De réduire la latence de sortie du modèle
- De limiter les hallucinations du modèle
- D'aligner le modèle sur les valeurs ou les préférences humaines
- De remplacer des modèles de grande taille par des modèles légers après fine-tuning
Processus de fine-tuning de modèle

Modèles pris en charge
Modèles pris en charge
Modèles pris en charge
- Singapour
- Chine du Nord 2 (Pékin)
- Génération de texte
- Compréhension visuelle (Qwen-VL)
Nom du modèle | Code du modèle | Entraînement SFT tous paramètres (sft) | Entraînement SFT efficace (efficient_sft) |
|---|---|---|---|
Qwen3-14B | qwen3-14b | × | Supported |
Comparaison des méthodes d'ajustement
Fonctionnalité | CPT (Continual Pre-training) | SFT (Supervised Fine-tuning) | DPO (Direct Preference Optimization) |
|---|---|---|---|
Résumé | Complète les connaissances (Injecte des connaissances métier) | Apprend à exécuter des tâches (Suit les instructions) | Exécute mieux les tâches (S'aligne sur les préférences humaines) |
Données d'entrée | Plus de 10 millions de tokens Texte métier non étiqueté | Plus de 1 000 entrées Paires « question-réponse » de haute qualité | Plus de 100 ensembles Paires de réponses « meilleure-moins bonne » pour la même instruction |
Objectif principal | Adaptation au domaine. Acquisition d'un vocabulaire spécialisé et de faits spécifiques. | Enseigne au modèle les formats de conversation et les capacités d'exécution de tâches. | Aligne davantage les sorties du modèle sur les valeurs et préférences humaines. |
Méthode d'apprentissage | Apprentissage auto-supervisé (Prédit le mot suivant) | Apprentissage supervisé (Imite la vérité terrain) | Apprentissage direct par préférence (Augmente la probabilité de bonnes réponses et diminue celle des mauvaises) |
Étape du modèle | Généralement avant le SFT | Après le CPT et avant le DPO | Généralement après le SFT, comme étape finale d'alignement. |
Comparaison des modes d'entraînement
Entraînement tous paramètres | Entraînement efficace (LoRA, recommandé) | |
|---|---|---|
Scénarios | • Le modèle doit acquérir de nouvelles capacités • Obtention de performances globales optimales. | • Optimisation des performances du modèle pour des scénarios spécifiques. • Scénarios sensibles aux coûts et au temps. |
Durée d'entraînement | Plus longue, avec une convergence plus lente. | Plus courte, avec une convergence plus rapide. |
Facturation
| Mode de facturation | Paiement à l'utilisation basé sur le volume de données d'entraînement |
| Formule de facturation | Frais d'entraînement du modèle = (Total des tokens dans les données d'entraînement + Total des tokens dans les données d'entraînement mixtes) × Nombre d'époques × Prix unitaire d'entraînement (Unité de facturation minimale : 1 token)Consultez les frais d'entraînement estimés en bas de la Model Fine-tuning console et cliquez sur Computing Details pour afficher le nombre total de tokens d'entraînement, le nombre d'époques et le prix unitaire d'entraînement. |
Prix unitaire de l'entraînement
Prix unitaire de l'entraînement
- Singapour
- Chine du Nord 2 (Pékin)
- Qwen
- Qwen-VL
Service de modèle | Code du modèle | Tarif |
|---|---|---|
Qwen3-14B | qwen3-14b | 0,0016 $/1 000 tokens |
Avant d'affiner un modèle
-
Bien que l'affinage des modèles de génération de texte permette d'obtenir d'excellents résultats dans des scénarios métier spécifiques, cette approche présente les limites suivantes :
- Durée importante : Cela inclut la création d'un jeu de données CPT à grande échelle (au moins 50 millions de tokens), la constitution d'un jeu de données SFT efficace (plus de 1 000 entrées), la collecte d'un nombre suffisant de cas négatifs (plus de 100) pour élaborer un jeu de données DPO pertinent destiné à la facturation du déploiement de modèle, ainsi que la lenteur des itérations d'optimisation du modèle.
- Coût élevé : Un modèle affiné ne peut être utilisé qu'après son déploiement, et la facturation du déploiement de modèle est onéreuse.
-
Alibaba Cloud Model Studio recommande d'essayer en premier lieu le Prompt Engineering ou le Function Calling pour personnaliser votre application. L'affinage de modèle constitue généralement le « dernier recours » pour améliorer les performances. En effet :
- Dans de nombreuses tâches, un modèle peut initialement offrir des résultats médiocres, mais l'application de techniques de prompt appropriées permet d'améliorer ces résultats sans nécessiter d'affinage.
- L'optimisation itérative des prompts et des plugins s'avère plus agile et plus rentable que les itérations d'affinage, car l'affinage peut exiger une nouvelle collecte, un nettoyage et une optimisation des données, ainsi que le recueil de cas négatifs et la réalisation d'enquêtes clients.
- Même si vous décidez finalement de procéder à un affinage, le travail initial sur l'ingénierie des prompts et l'optimisation des plugins ne sera pas perdu. Ces travaux préliminaires peuvent être entièrement réutilisés lors de la constitution du jeu de données d'affinage.
Prise en main
Affiner un modèle via la console
| Étapes d'affinage | Capture d'écran de la console |
|---|---|
| Étape 1 : Sur la page Model Fine-tuning, cliquez sur Create Training Task. | 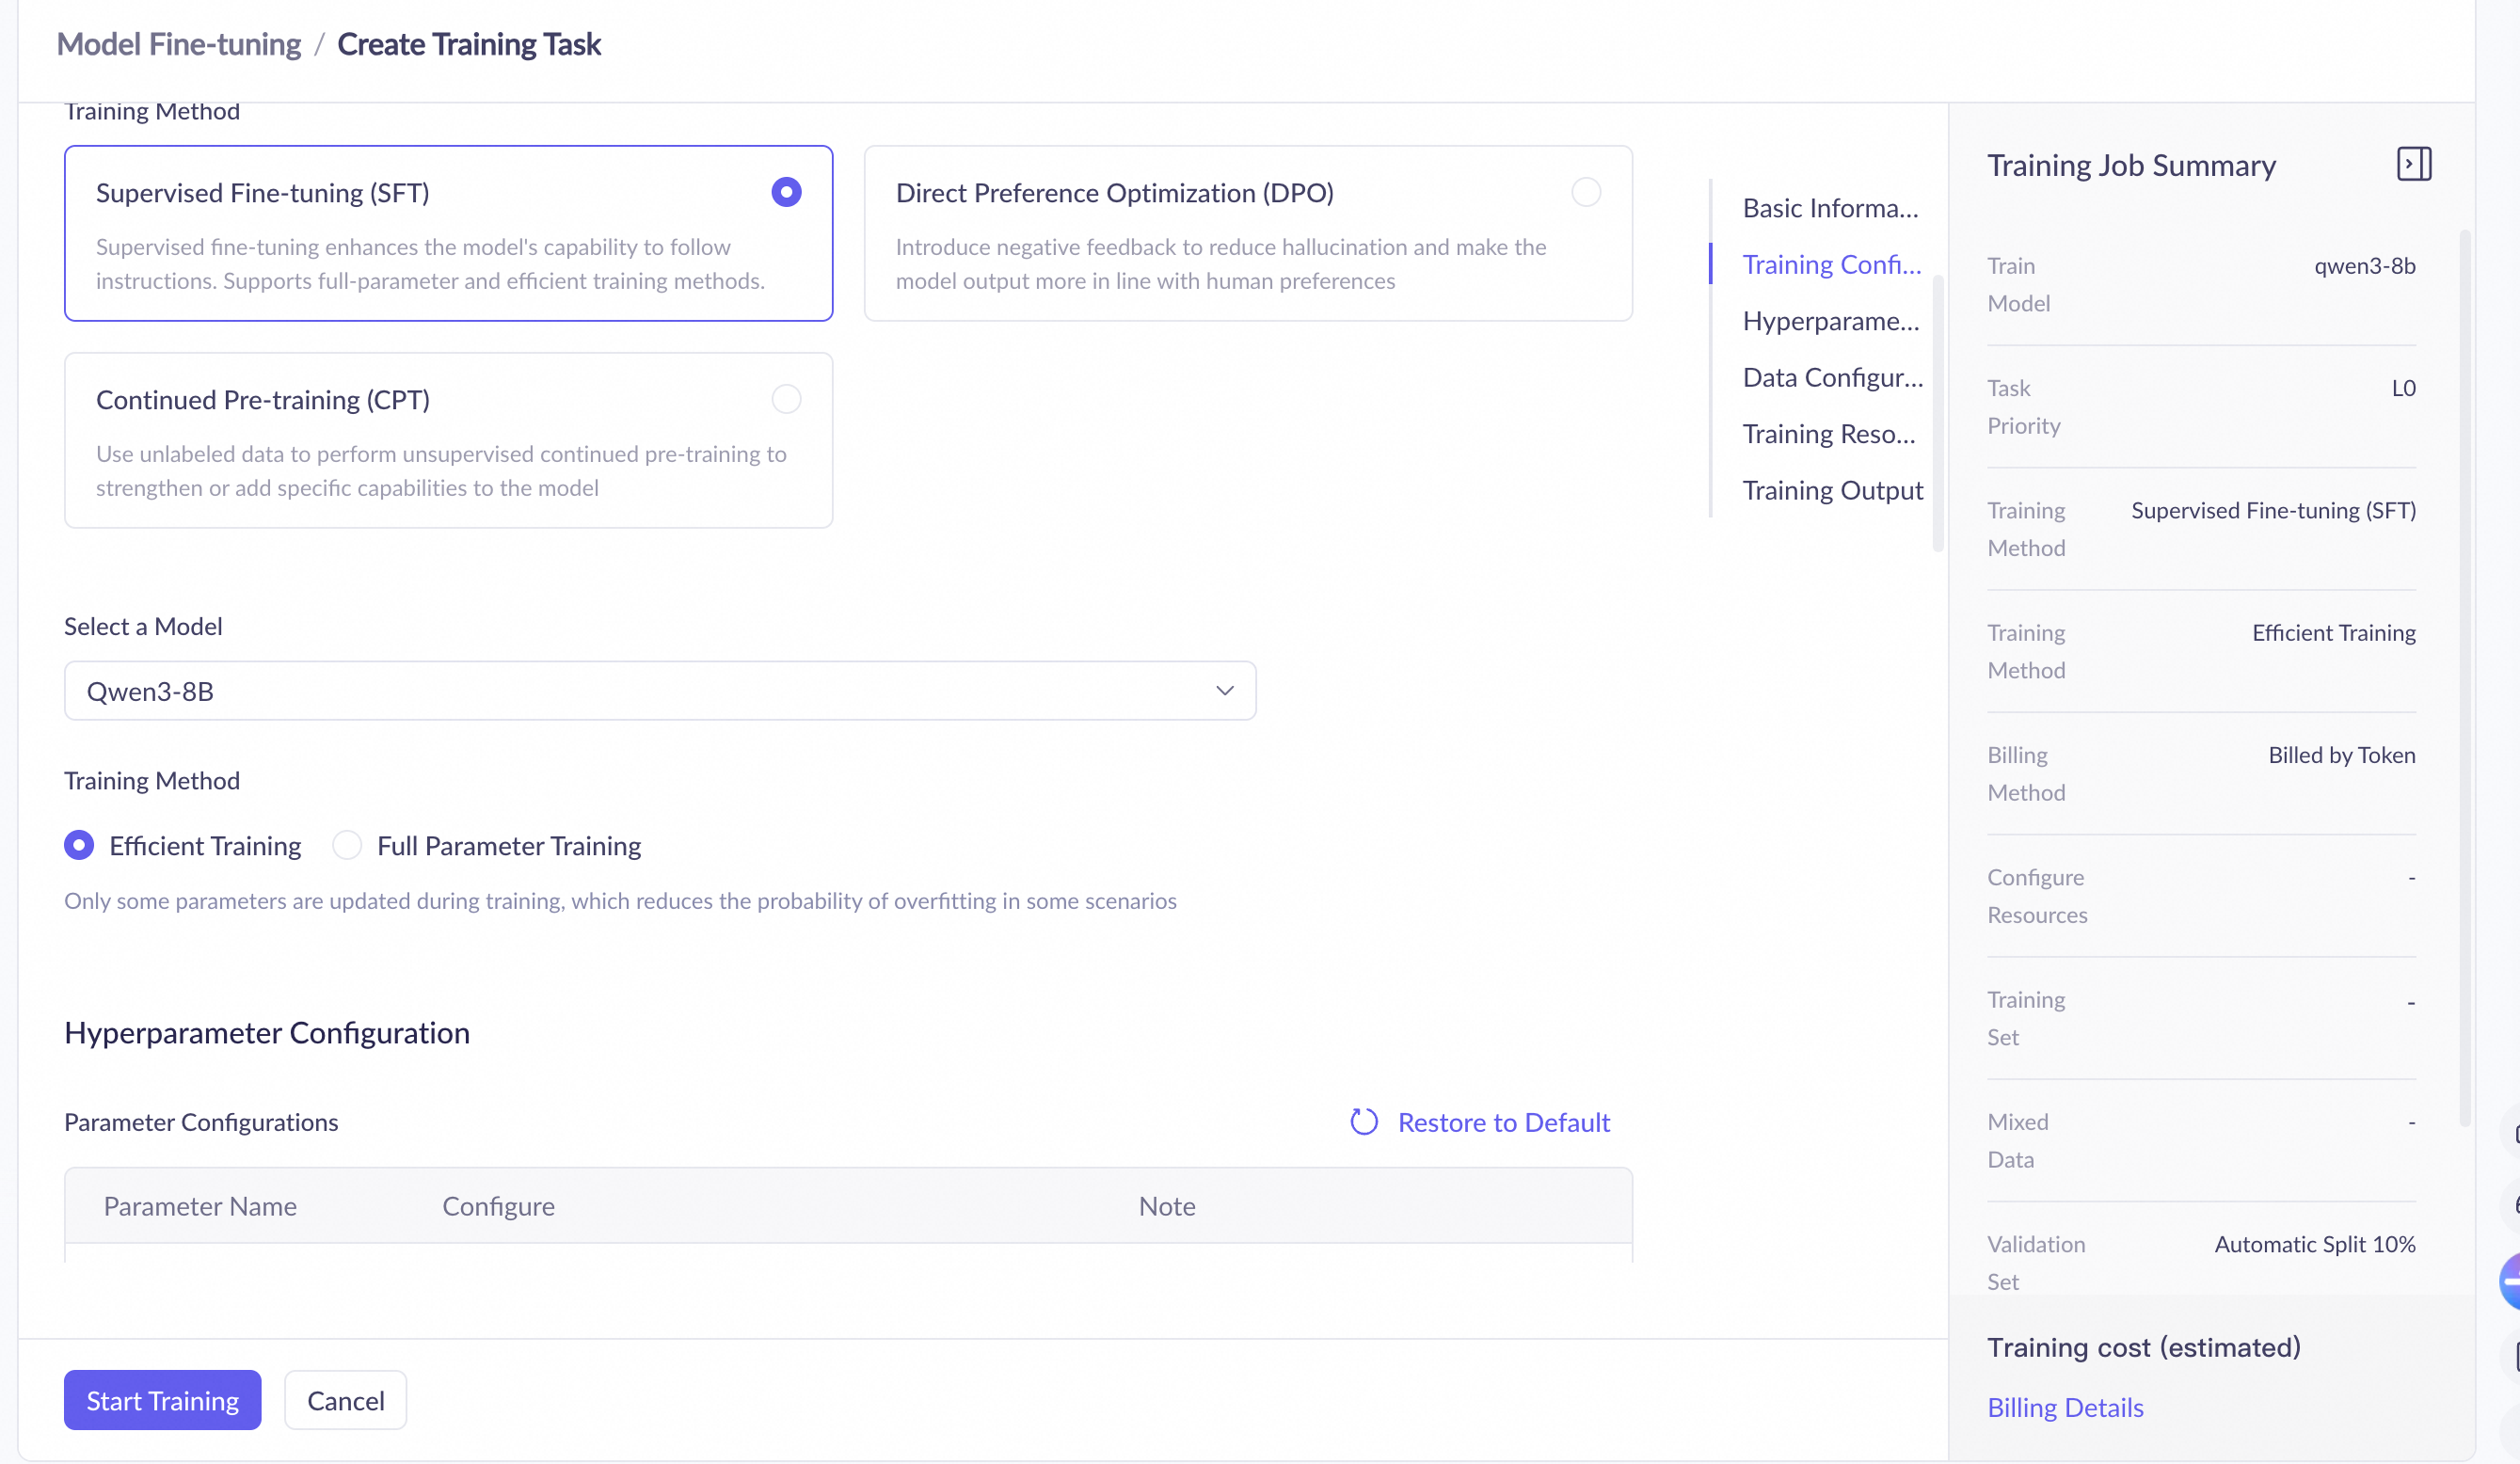 |
Étape 2 : Configurer l'entraînement
| |
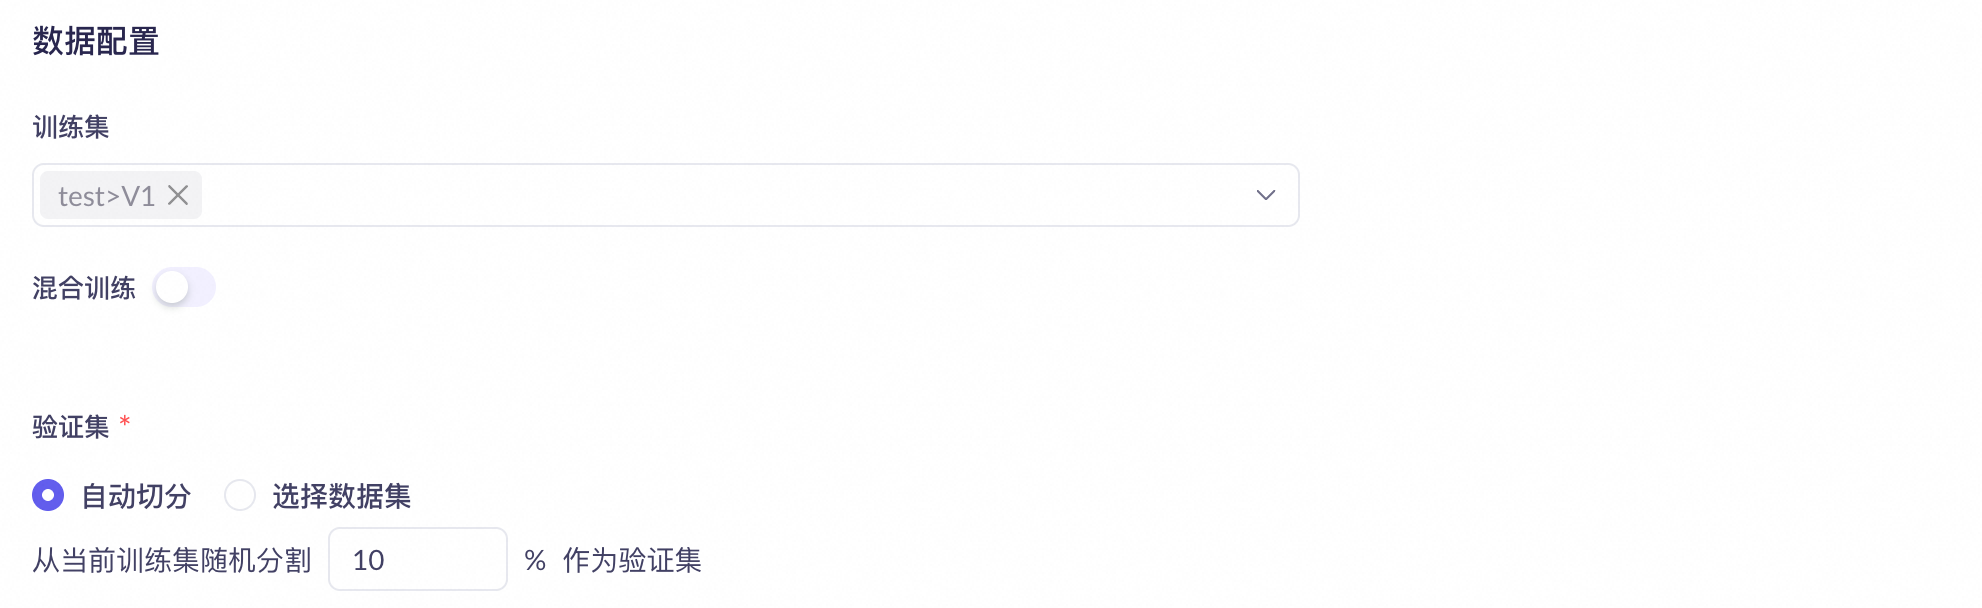
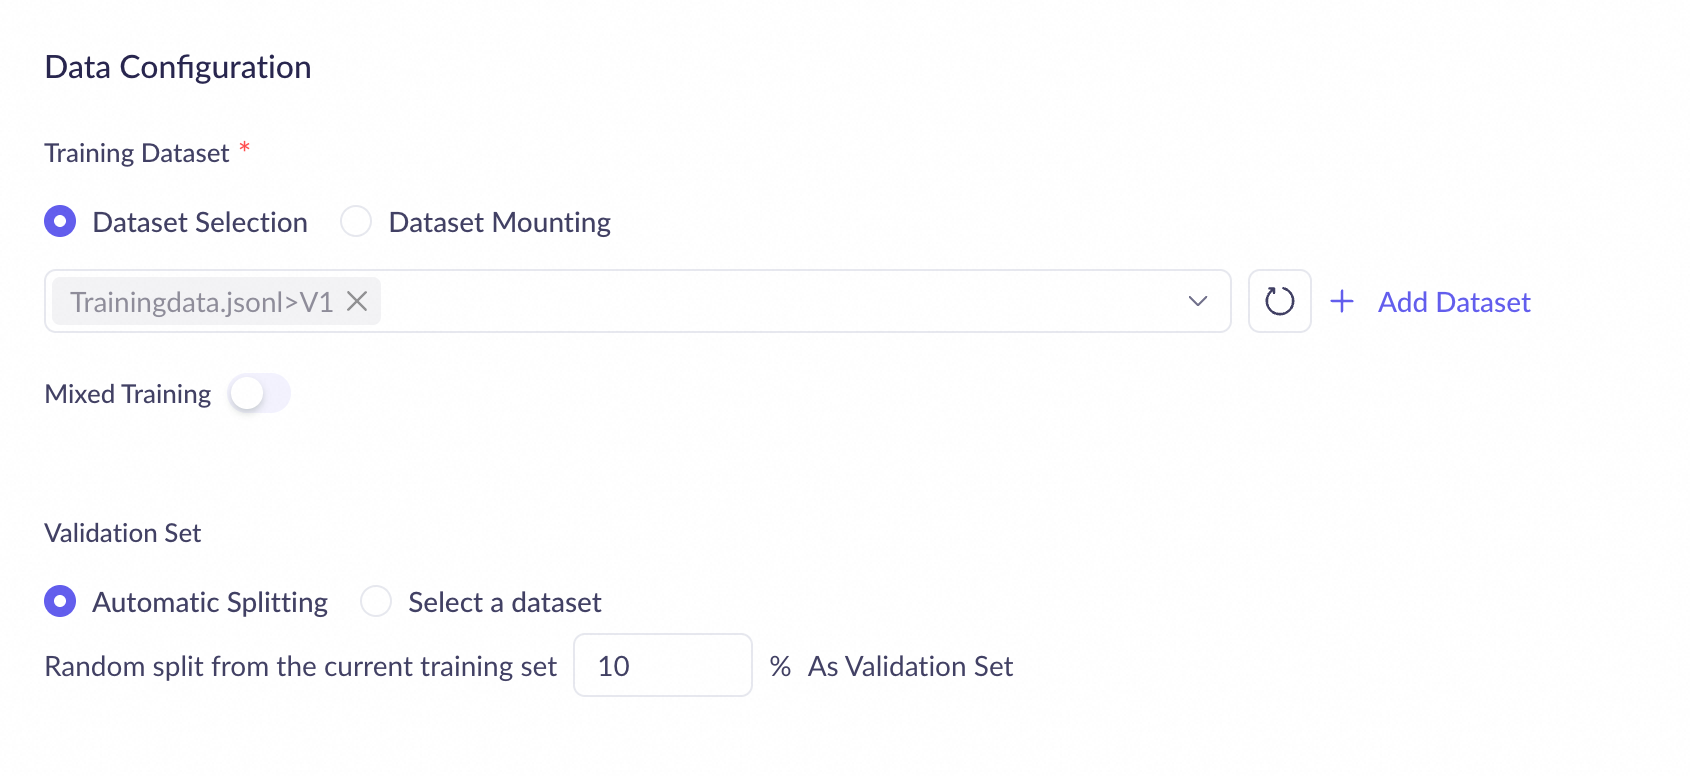
Étape 3 : Configurer les données
|  |
Étape 4 : Configurer les paramètres de sauvegarde des snapshots de paramètres du modèle (checkpoint)
Une fois l'affinage du modèle terminé, vous pouvez exporter un snapshot de paramètres sur la plateforme Model Studio. Vous pouvez ensuite déployer le modèle sur Model Studio à partir de ce snapshot de paramètres.Les snapshots de paramètres exportés sont stockés dans le stockage cloud et ne peuvent être ni consultés ni téléchargés. | 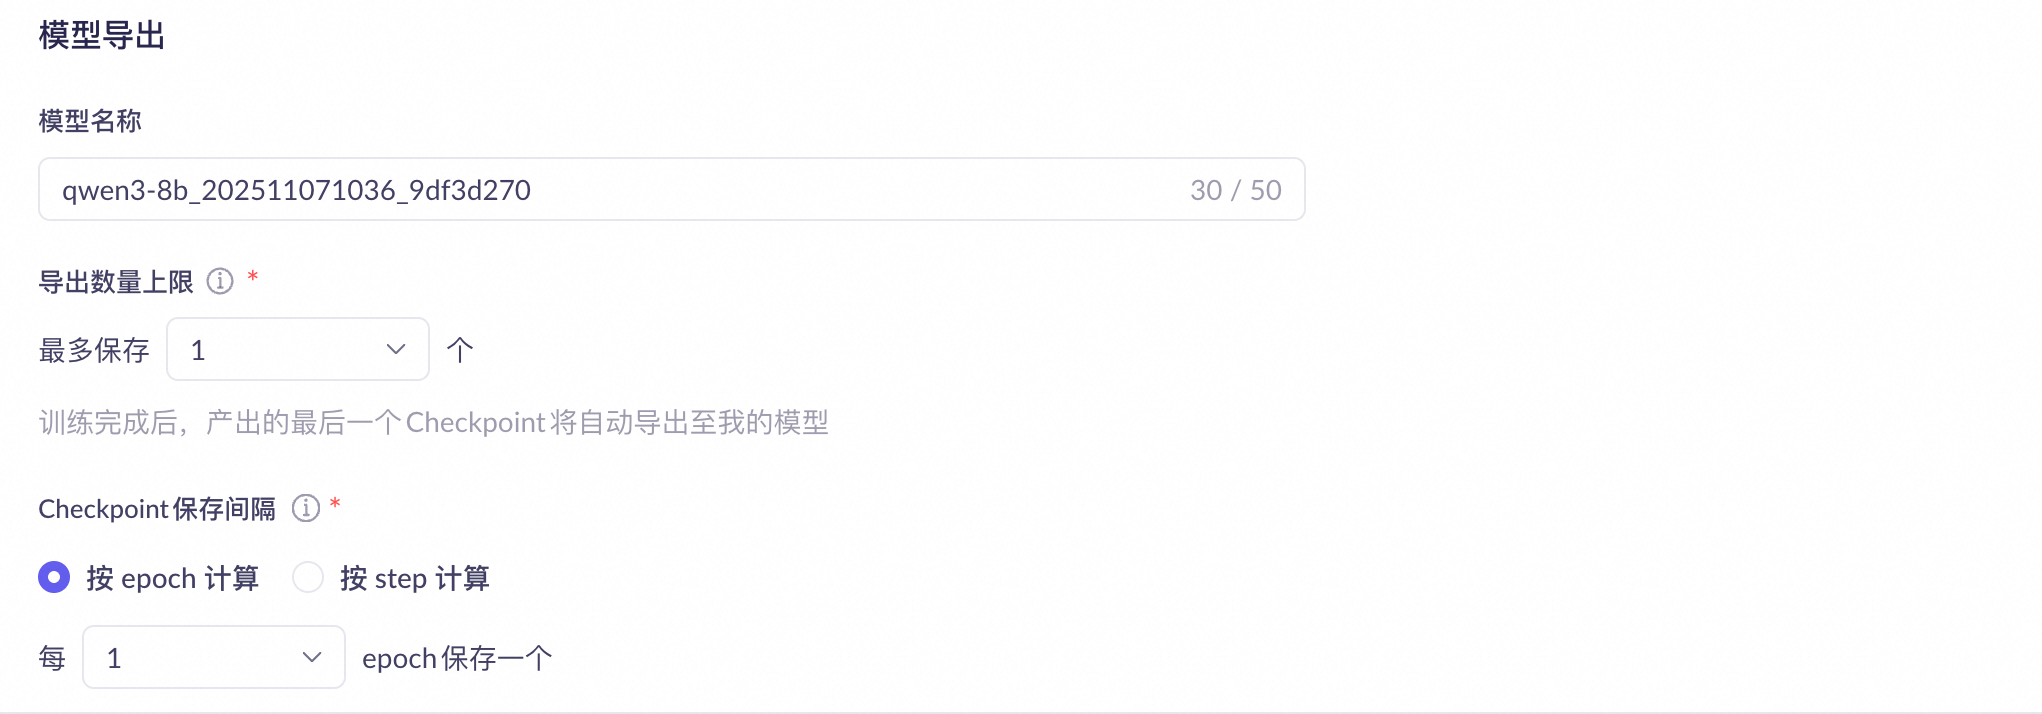 |
| Étape 5 : Cliquez sur « Start Training » et attendez la fin de l'entraînement du modèle. | |
| Étape 6 : Utilisez la fonctionnalité Model Deployment d'Alibaba Cloud Model Studio pour déployer le modèle personnalisé entraîné. Après le déploiement, vous pouvez évaluer le modèle affiné. Pour plus d'informations, consultez Déploiement de modèle. | |
Processus typique d'affinage
Les trois méthodes d'affinage proposées par Model Studio ne s'excluent pas mutuellement ; elles sont progressives et complémentaires.
CPT (facultatif) → SFT → DPO (facultatif)
-
CPT (Continual Pre-Training) - Complète les connaissances (Les modèles généraux possèdent des connaissances vastes mais peu profondes, qui peuvent ne pas répondre aux exigences de précision et de profondeur des domaines spécialisés)
- Modèle financier :
Apprend la terminologie financière - Modèle médical :
Mémorise la pathologie médicamenteuse - Modèle juridique :
Comprend les articles de loi et la jurisprudence
- Modèle financier :
-
SFT (Supervised Fine-Tuning) - Apprend à exécuter des tâches
- Bot de service client :
Apprend les procédures de service client - Assistant de code :
Apprend les paradigmes de programmation - Appel d'outils (Agent) :
Apprend à utiliser MCP
- Bot de service client :
-
DPO (Direct Preference Optimization) - Exécute mieux les tâches
- Sécurité et responsabilité :
Rejette les suggestions nuisibles - Concision et efficacité :
Fournit des réponses concises - Objectivité et neutralité :
Évalue de manière juste et objective
- Sécurité et responsabilité :
Format des données d'affinage
- Jeu d'entraînement SFT
Les paramètres OpenAInameetweightne sont pas pris en charge. Toutes les sorties assistant seront entraînées.
"loss_weight", qui définit l'importance relative de cette ligne pendant l'entraînement. (Plage : de 0.0 à 1.0. Une valeur plus élevée indique une importance supérieure.)Ce paramètre est disponible en avant-première sur invitation. Pour l'utiliser, contactez votre gestionnaire de compte.
Conseils pour la constitution des jeux de données
Exigences relatives à la taille du jeu de données
Pour le CPT, le jeu de données nécessite au moins 50 millions de tokens de données de pré-entraînement de haute qualité. Pour le SFT, il faut au moins 1 000 entrées de données d'affinage de haute qualité. Pour le DPO, le jeu de données requiert généralement plusieurs centaines d'entrées de données de préférences humaines. Si les résultats de l'évaluation du modèle après affinage des données ne sont pas satisfaisants, le moyen le plus simple d'améliorer les performances consiste à collecter davantage de données pour l'entraînement.
Si vous manquez de données, nous vous recommandons de créer une application agent et d'utiliser un index de base de connaissances pour renforcer les capacités du modèle. Dans de nombreux scénarios métier complexes, vous pouvez également combiner l'affinage de modèle et la récupération via base de connaissances.
Par exemple, dans un scénario de service client, vous pouvez utiliser l'affinage de modèle pour corriger le ton de l'agent, ses styles d'expression et sa conscience de soi. Les connaissances professionnelles liées au scénario peuvent être introduites dynamiquement dans le contexte du modèle via une base de connaissances.
Alibaba Cloud Model Studio recommande de commencer par créer et tester une application de génération augmentée par récupération (RAG). Après avoir collecté suffisamment de données d'application, vous pourrez alors utiliser l'affinage de modèle pour améliorer encore les performances du modèle.
Vous pouvez également recourir aux stratégies suivantes pour enrichir votre jeu de données :
- Utilisez un grand modèle linguistique (LLM) pour simuler la génération de contenu adapté à des scénarios métier spécifiques, afin de produire davantage de données pour l'affinage. (Nous recommandons de sélectionner un modèle plus volumineux et performant pour la génération.)
- Acquérez davantage de données par divers moyens, tels que la collecte à partir de scénarios d'application, l'extraction Web, les réseaux sociaux et forums en ligne, les jeux de données publics, les partenaires et ressources sectorielles, ainsi que les contributions des utilisateurs.
Diversité et équilibre des données
Les exigences en matière d'affinage de modèle varient selon le scénario. Par exemple, le professionnalisme est crucial pour des scénarios métier spécifiques, tandis que la polyvalence prime dans les scénarios de questions-réponses. Vous devez concevoir des cas d'utilisation des données en fonction des modules métier ou des contextes d'usage dont le modèle a la charge. Ainsi, l'efficacité de l'entraînement dépend non seulement du volume de données, mais aussi du professionnalisme et de la diversité des données adaptées au scénario visé.
À titre d'exemple, dans un scénario de conversation IA intelligente, un jeu de données professionnel et diversifié devrait couvrir les cas métier suivants :
Activité spécifique | Scénarios/activités diversifiés |
|---|---|
Service client e-commerce | Notifications promotionnelles, conseil avant-vente, accompagnement pendant la vente, service après-vente, suivi post-vente, gestion des réclamations, etc. |
Services financiers | Conseil en prêt, conseils en investissement et gestion de patrimoine, services de carte de crédit, gestion de comptes bancaires, etc. |
Santé en ligne | Consultation sur les symptômes, prise de rendez-vous, instructions de visite, renseignements sur les médicaments, conseils de santé, etc. |
Secrétaire IA | Informations informatiques, informations administratives, informations RH, demandes sur les avantages sociaux, consultations du calendrier de l'entreprise, etc. |
Assistant de voyage | Planification de voyage, guides d'entrée et de sortie, conseil en assurance voyage, présentations des coutumes et cultures locales, etc. |
Conseiller juridique d'entreprise | Examen de contrats, protection de la propriété intellectuelle, vérifications de conformité, questions-réponses sur le droit du travail, conseil en transactions transfrontalières, analyse juridique de cas individuels, etc. |
Séparation des jeux d'entraînement et de validation
Le réglage fin du modèle s'effectue directement dans la console.
- Séparez automatiquement un jeu de données d'entraînement complet et échantillonnez aléatoirement une petite quantité de données pour constituer un jeu de validation.
- Choisissez d'importer un jeu de données distinct.