

Este tutorial explica cómo usar el AOQ SDK con qwen-audio-3.1-asr-flash-streaming para implementar la entrada por voz.
Descripción de la solución
En una interacción típica de entrada por voz, el usuario hace clic en el botón de entrada por voz y empieza a hablar de inmediato. Los resultados se muestran en el campo de entrada en tiempo real. La implementación del cliente tiene los siguientes puntos clave:
- Captura inmediata: Inicie la captura de audio y el almacenamiento de datos PCM en un búfer en cuanto se haga clic, mientras solicita credenciales y establece la conexión de forma asíncrona. La conexión tarda un tiempo y el usuario puede estar hablando durante ese periodo; por eso, almacene el audio primero y envíelo después.
- Alcance el audio actual al doble de velocidad: Tras establecer la conexión y recibir el evento que indica que el modelo está listo, envíe el audio almacenado al doble de velocidad. Cuando alcance el audio actual, cambie al envío en tiempo real.
- Audio por el canal Data: qwen-audio-3.1-asr-flash-streaming utiliza el protocolo Inference (run-task / finish-task). Este escenario requiere almacenar el audio antes de enviarlo al doble de velocidad. Use
sendDataMsgpara transmitir audio como mensajes JSON. El servidor AOQ admite este formato de mensajes de audio JSON y los convierte automáticamente en datos binarios para reenviarlos al modelo. - Resultados intermedios y finales: El modelo devuelve resultados de reconocimiento continuamente. Muestre los resultados intermedios (
sentence_end: false) en tiempo real y agregue los finales (sentence_end: true) al campo de entrada.
Preparación
Requisitos previos
- Active Alibaba Cloud Model Studio y obtenga una API key conforme a Obtener y configurar una API key. Guárdela solo en el AppServer. No la incluya en el código del cliente ni la registre en el repositorio de código.
- Use
{WorkspaceId}.cn-beijing.maas.aliyuncs.compara China (Beijing) o{WorkspaceId}.ap-southeast-1.maas.aliyuncs.compara Singapur como{endpoint}. Sustituya el marcador por el ID real del workspace y use la API key de la región y el workspace correspondientes. - Obtenga el AOQ Client SDK más reciente en Descarga del SDK.
- Configure un AppServer según los Pasos de autenticación de AOQ para Qwen-Audio-ASR-Streaming. Antes de cada conexión nueva, el cliente debe obtener credenciales de conexión nuevas de AppServer.
Importar el SDK
Descargue el AOQ Client SDK más reciente en Descarga del SDK e importe el correspondiente a su plataforma. Los ejemplos del cliente usan Android. Las demás plataformas utilizan el mismo diseño de interfaces y flujo de eventos.
- Android
- iOS
- HarmonyOS
- Linux (Python)
-
Coloque
libPluginOpus.sodel complemento Opus enapp/src/main/jniLibs/armeabi-v7a/yapp/src/main/jniLibs/arm64-v8a/según la ABI. ColoqueAoqClientSdk-release.aarenapp/libsy configure las dependencias y ABI admitidas enapp/build.gradle: -
Declare estos permisos en
AndroidManifest.xml: -
Solicite el permiso
RECORD_AUDIOen tiempo de ejecución antes de usar el micrófono.
Obtener un token en el AppServer
AppServer llama a la API de asignación de Model Studio y devuelve el token, SID, los endpoints de Relay y la demás información que requiere el SDK para establecer una conexión.
| Campo de respuesta | Campo del SDK |
|---|---|
aoqTokenForClient | AoqConnectConfig.token |
sid | AoqConnectConfig.sid |
clientRelayCertFingerprint | AoqConnectConfig.certFingerprint |
clientRelayEndpoints | AoqConnectConfig.relayEndpoints |
extraInfo.workspaceIdHash | AoqConnectConfig.workspaceIdHash |
Implementación del cliente
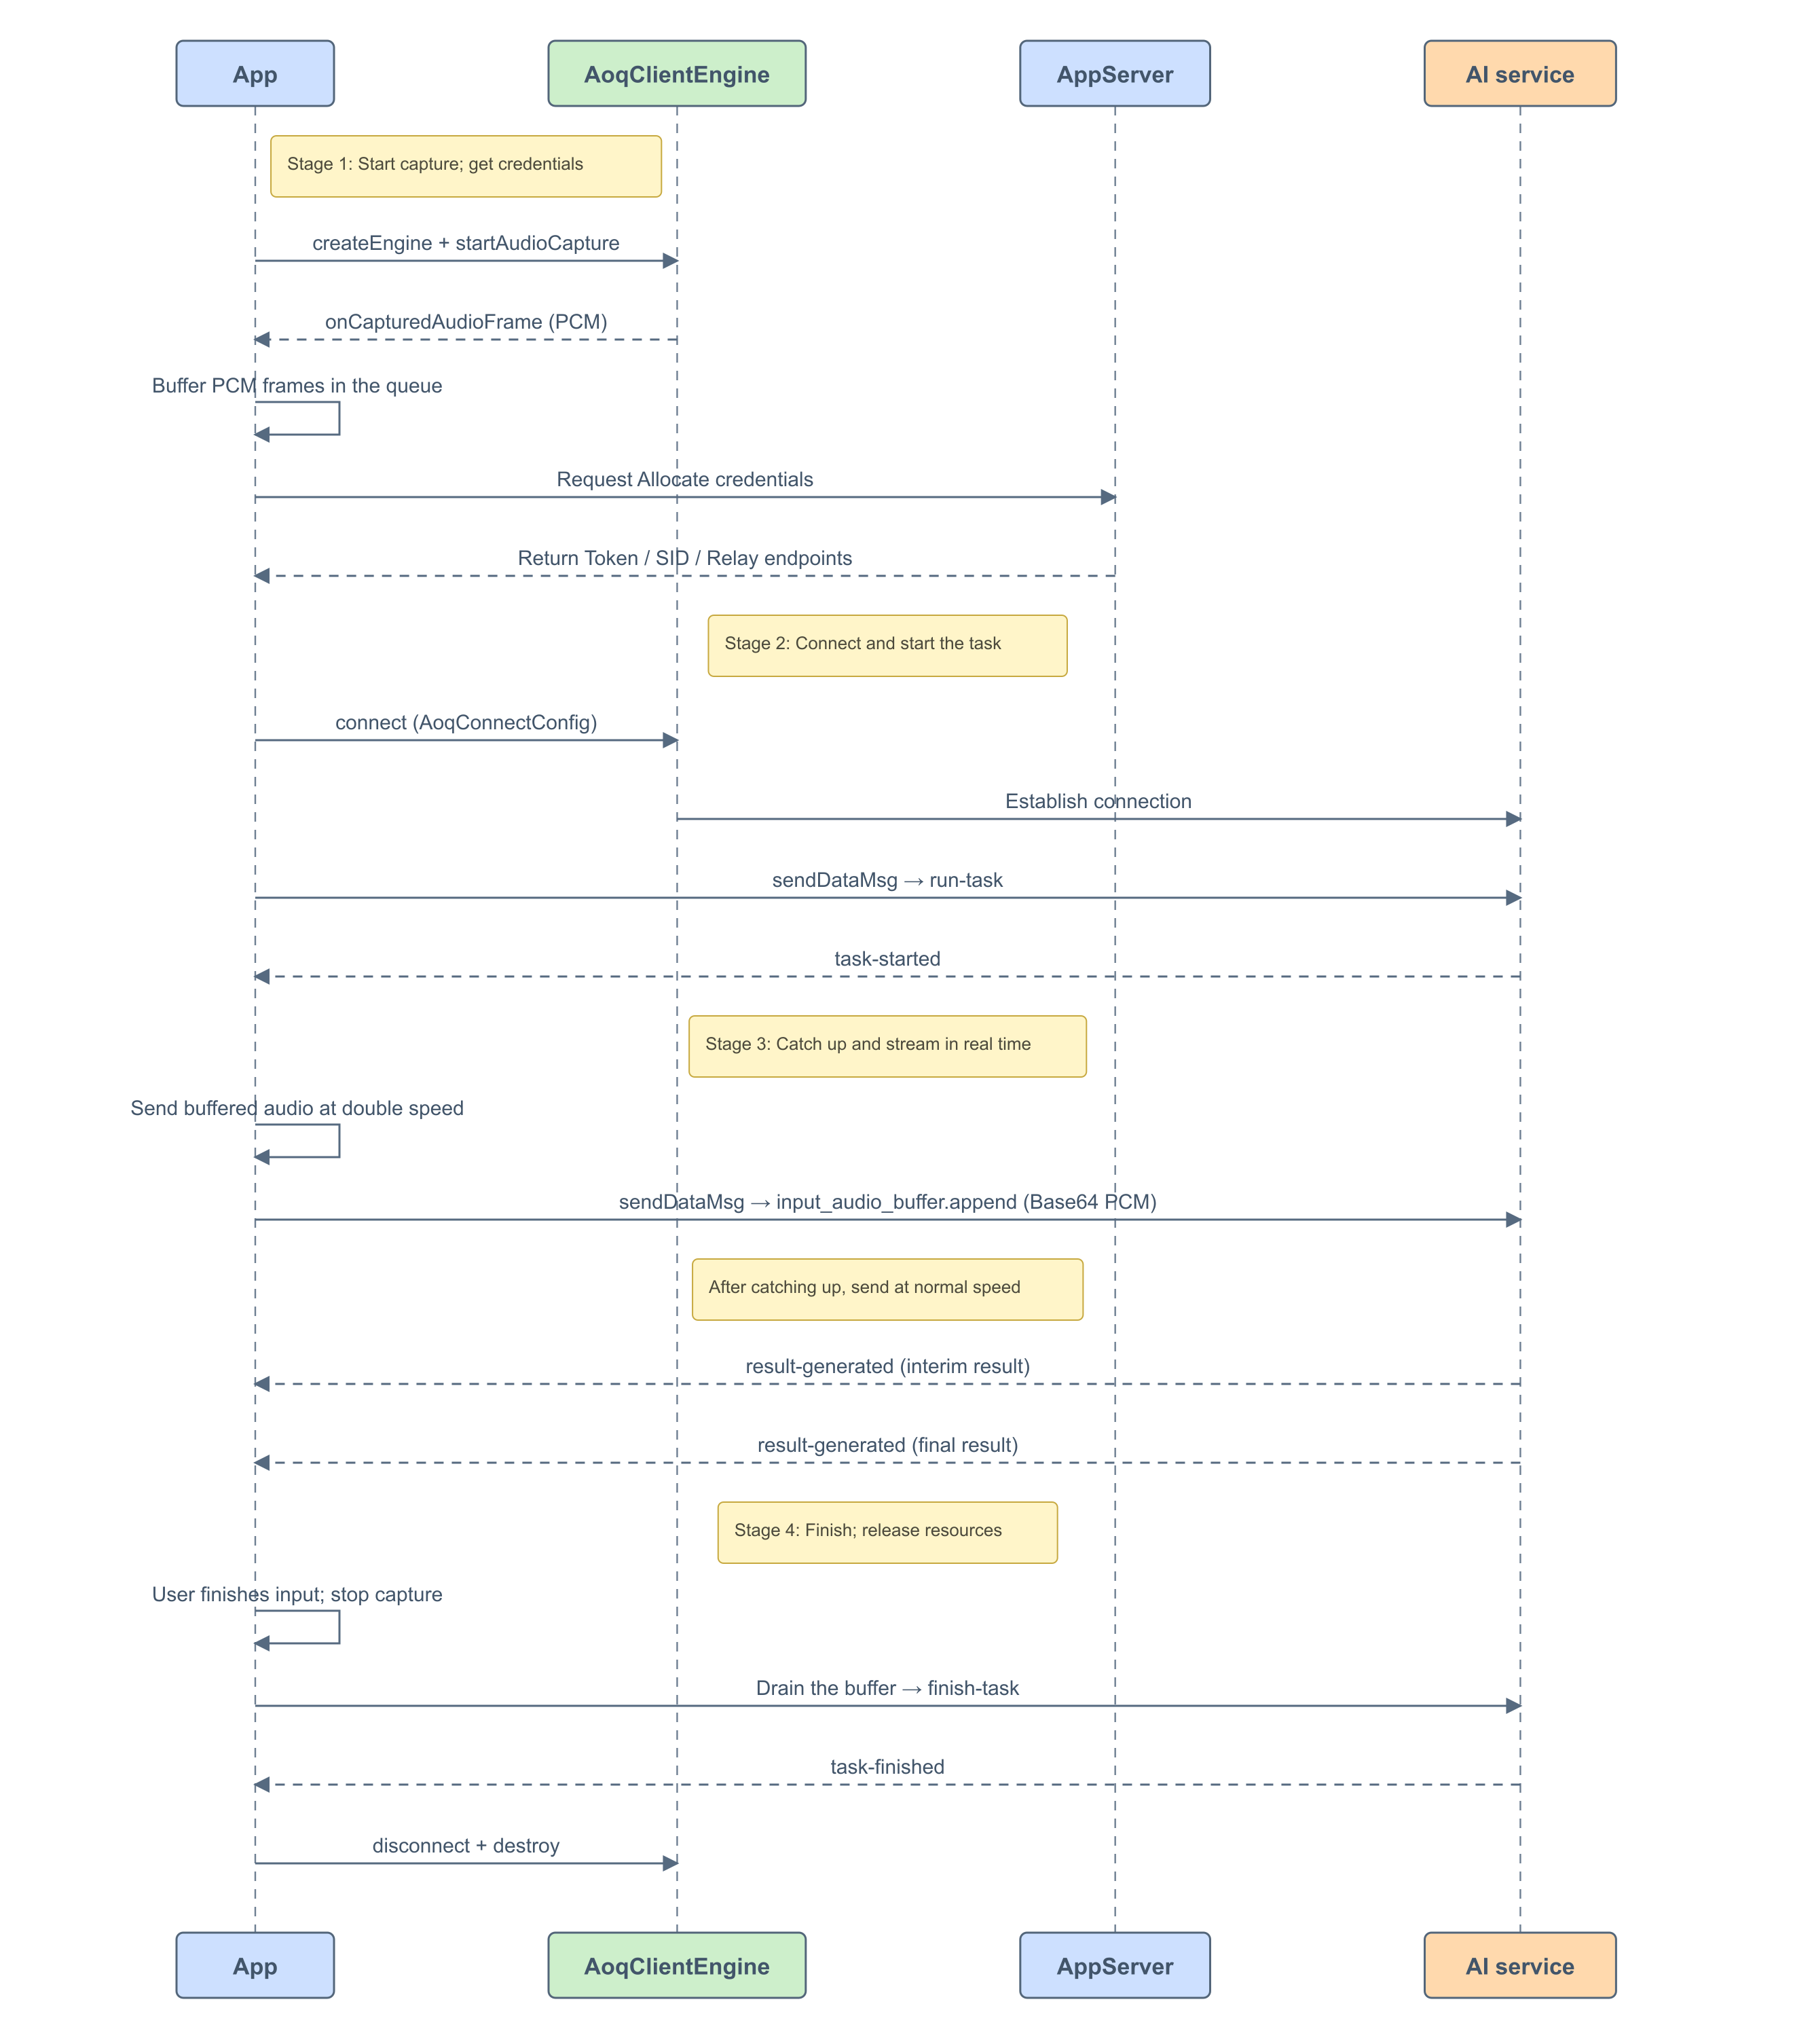
1. Crear el motor y registrar callbacks
Cree una instancia AoqClientEngine y registre los callbacks de estado de conexión y mensajes Data. Envíe run-task tras establecer la conexión. El callback de mensajes Data procesa los eventos del servidor.
2. Configurar la codificación de audio e iniciar la captura
Configure PCM (16 kHz, mono), registre un callback de captura con setAudioFrameObserver para obtener PCM y llame a enableSendMediaStream(Audio, false) para desactivar el envío de medios de audio (el audio se envía por Data). Finalmente, llame a startAudioCapture() para iniciar la captura.
Este ejemplo usa la captura interna del AOQ SDK y obtiene PCM mediante onCapturedAudioFrame. También puede implementar su propia captura, por ejemplo con AudioRecord de Android. Agregue el PCM a la cola del búfer; la lógica de envío posterior es idéntica.
- Forma A: Captura interna del SDK
- Forma B: Captura propia
El ejemplo llama a
startAudioCapture, obtiene PCM mediante onCapturedAudioFrame y lo copia al búfer de la aplicación. Registre el callback de captura sin procesar AoqAudioSourceCaptured para almacenar audio antes de establecer la conexión.3. Configurar credenciales y pistas y establecer la conexión
Complete AoqConnectConfig con las credenciales del AppServer. Publique las pistas Audio + Data y suscríbase a Data. La declaración de Audio es necesaria para conectarse, aunque el envío de medios de audio está desactivado. El audio real se transmite por el canal Data.
Se debe publicar la pista Audio: El modelo ASR requiere declarar Audio al conectar; de lo contrario, la conexión falla. Los datos se envían por Data en mensajes
input_audio_buffer.append, no por el canal de medios de audio. Llame a enableSendMediaStream(Audio, false) antes de conectar para impedir que el SDK envíe automáticamente el audio capturado.4. Enviar run-task para iniciar el reconocimiento
Tras conectarse, genere un task_id nuevo para cada ronda de entrada por voz, por ejemplo con UUID.randomUUID().toString(). En el callback de conexión correcta, envíe el siguiente JSON mediante sendDataMsg. Envíe run-task solo una vez por ronda.
El evento run-task tiene la siguiente estructura. El ID de tarea es un ejemplo; sustitúyalo por el ID generado para la ronda actual. Consulte Eventos del cliente.
sendDataMsg:
5. Enviar el audio almacenado al doble de velocidad tras task-started
Analice el JSON en onDataMsg. Cambie el estado de envío a listo únicamente al recibir el siguiente evento para la tarea actual.
task_id de las respuestas coincida con la tarea actual; un task-started duplicado no debe iniciar otro ciclo de envío.
Formato de los mensajes de audio: El protocolo Inference de qwen-audio-3.1-asr-flash-streaming (Eventos del cliente) solo define dos eventos de control: run-task y finish-task. El audio no se envía como evento JSON. Sin embargo, el canal Data de AOQ requiere mensajes JSON de audio. Para ello, AOQ encapsula el audio en un evento input_audio_buffer.append en la capa del SDK:
| Campo | Tipo | Descripción |
|---|---|---|
type | string | Valor fijo: input_audio_buffer.append |
event_id | string | Identificador único del evento para correlación y deduplicación |
audio | string | Datos de audio PCM codificados en Base64 |
sendDataMsg. El servidor AOQ decodifica audio como PCM binario y lo reenvía al modelo ASR según el protocolo del modelo. El cliente no necesita gestionar la encapsulación de tramas binarias. Asegúrese de que el formato PCM (frecuencia de muestreo, canales y profundidad de bits) coincida con format y sample_rate declarados en run-task.
input_audio_buffer.append y envíelo mediante sendDataMsg:
onDataMsg. Inicie el envío de audio al recibir task-started y analice los resultados en result-generated. Consulte Eventos del servidor.
6. Procesar y mostrar los resultados
result-generated contiene la oración reconocida y campos como text y sentence_end. Muestre los resultados intermedios en tiempo real y agregue los finales al campo de entrada. Consulte Eventos del servidor para sus definiciones.
7. Enviar finish-task para finalizar el reconocimiento
Cuando el usuario termine la entrada, llame primero a engine.stopAudioCapture() para detener la captura. Espere hasta enviar todo el PCM restante del búfer y envíe finish-task para notificar al servidor que se envió todo el audio. Consulte Eventos del cliente para las definiciones.
task_id debe coincidir con el del run-task de la ronda actual.sendDataMsg:
8. Desconectar y destruir el motor
Después de recibir task-finished, libere los recursos como se indica a continuación si ya no necesita reutilizar la conexión. Libere los recursos también en caso de error o tiempo de espera agotado.
Notas de uso
- Espere
task-startedantes de enviar audio; de lo contrario, los datos se descartan. - Envíe
finish-tasksolo cuando el búfer esté vacío (queue.size() == 0) para que el modelo procese el último segmento. - No desconecte inmediatamente después de
task-finished. Puede reutilizar la conexión para otra tarea con untask_idnuevo. - Ignore los paquetes heartbeat (
heartbeat: true) deresult-generated; no los trate como resultados de reconocimiento.
Escenarios habituales
Varias rondas de reconocimiento en una conexión
La conexión sigue disponible después de task-finished. El cliente puede enviar run-task de nuevo con otro task_id para iniciar la siguiente ronda sin reconectar. Esto permite la entrada de voz continua y reduce la latencia de conexiones repetidas.
Implementar la captura propia
Este ejemplo utiliza la captura interna del AOQ SDK (startAudioCapture + onCapturedAudioFrame), pero también puede implementar la suya. Agregue PCM (16 kHz, mono, 16 bits) a PcmQueue. La lógica de envío acelerado del búfer y de transmisión posterior es idéntica.