

Los conjuntos de datos son la base del entrenamiento y la evaluación de modelos. La función de Gestión de datos de Alibaba Cloud Model Studio le ayuda a crear y gestionar conjuntos de datos de manera eficiente.
Resumen del conjunto de datos
La función de Gestión de datos de Alibaba Cloud Model Studio gestiona centralizadamente todos los conjuntos de datos relacionados con grandes modelos en su espacio de trabajo empresarial. Los conjuntos de datos se dividen en Conjunto de entrenamiento (utilizado para ajuste fino de modelos, compatible con SFT/DPO/CPT) y Conjunto de evaluación (utilizado para Evaluación de modelos).
Los conjuntos de entrenamiento admiten cuatro escenarios de entrenamiento: generación de texto, comprensión multimodal, imagen a video (primer fotograma) e imagen a video (primer y último fotograma). Los conjuntos de evaluación solo admiten el escenario de generación de texto. El tipo de conjunto de datos no se puede cambiar después de su creación; elija cuidadosamente según su uso posterior.
Los nombres de los conjuntos de datos pueden tener hasta 50 caracteres de longitud (se admiten chino, inglés, dígitos, guiones bajos, guiones y puntos), y las descripciones hasta 200 caracteres. No se admite la creación ni la publicación de conjuntos de datos vacíos. No hay límite en la cantidad de conjuntos de datos que puede crear, ni un límite superior en la cantidad de datos que puede importar.
Los métodos de entrenamiento DPO/CPT y el montaje de almacenamiento en la nube solo son compatibles en la región de Pekín.
Métodos y escenarios de entrenamiento
Los conjuntos de entrenamiento admiten tres métodos de entrenamiento con diferentes escenarios aplicables y requisitos mínimos de datos:
- SFT (ajuste fino supervisado): ajuste fino por instrucciones que permite al modelo resolver tareas específicas. Se recomiendan al menos mil entradas. Disponible en todos los sitios.
- DPO (optimización directa de preferencias): entrenamiento de alineación de preferencias. Se recomiendan al menos cien entradas.
- CPT (preentrenamiento continuo): inyección de conocimiento de dominio. Se recomiendan al menos 50 millones de tokens de datos.
Método de entrenamiento | Propósito | Volumen de datos recomendado | Disponibilidad del sitio |
|---|---|---|---|
SFT | Ajuste fino supervisado (ajuste fino de instrucciones) | 1,000+ entradas | Todos los sitios |
DPO | Optimización directa de preferencias (alineación de preferencias) | 100+ entradas | Región de Pekín |
CPT | Preentrenamiento continuo (conocimiento de dominio) | 50 millones de tokens | Región de Pekín |
Métodos de importación
Los conjuntos de datos admiten tres métodos de importación con diferentes escenarios aplicables y requisitos previos:
- Cargar archivo local: sin requisitos previos; cargue directamente archivos locales, adecuado para pequeños lotes de datos.
- Importación de OSS: agregue la etiqueta
bailian-datahub-access=readal bucket de destino; adecuado para grandes lotes de datos. No compatible con conjuntos de evaluación. - Reflujo de registros: extrae automáticamente datos de entrenamiento de los registros de inferencia de SLS; requiere autorizar un rol vinculado al servicio, formando un ciclo de mejora de inferencia → datos → ajuste fino.
Método de importación | Requisitos previos | Escenario aplicable | Conjunto de evaluación admitido |
|---|---|---|---|
Carga local | Ninguno | Pequeños lotes de datos | Compatible |
Importación OSS | Etiqueta de bucket bailian-datahub-access=read | Grandes lotes de datos | No compatible |
Reflujo de registros | Autorización + filtro de Clave API/modelo | Crear datos de entrenamiento a partir de registros de inferencia | Compatible |
Preparación de datos
Preparar datos de alta calidad es clave para los resultados del ajuste fino del modelo. Para conocer los volúmenes de datos recomendados para cada método de entrenamiento (generación de texto SFT/DPO/CPT), consulte las Reglas de carga de datos de ajuste.
No existen volúmenes de datos recomendados oficialmente para conjuntos de entrenamiento de comprensión multimodal y de imagen a video; prepare muestras suficientes según su escenario real.
Formato de datos y plantillas
Para las especificaciones de formato de archivos de datos de cada escenario de entrenamiento (texto SFT/comprensión multimodal (imagen/video → texto), DPO, CPT, conjuntos de evaluación), consulte las Reglas de carga de datos de ajuste.
En la página de creación de conjuntos de datos de Gestión de datos, descargue la plantilla de datos correspondiente al escenario; preparar los datos según la estructura de la plantilla puede evitar fallos de importación. Los conjuntos de evaluación admiten el formato de una sola vuelta Generación de texto (prompt&completion) y el formato de conversación multivuelta Generación de texto (ChatML-messages); para las especificaciones de campos detalladas y ejemplos, consulte Reglas de carga de datos de ajuste - Formato del conjunto de evaluación.
Para estrategias de diversidad y aumento de datos, consulte la documentación de ajuste fino de modelos. Para los conjuntos de evaluación, prepare un conjunto independiente de datos sin superposición para evaluar objetivamente la capacidad de generalización del modelo.
Crear un conjunto de datos
Antes de crear un conjunto de datos, se deben cumplir los siguientes requisitos previos: el servicio Model Studio debe estar activado; para la importación de OSS, agregue la etiqueta bailian-datahub-access=read al bucket de destino; para el reflujo de registros, autorice un rol vinculado al servicio.
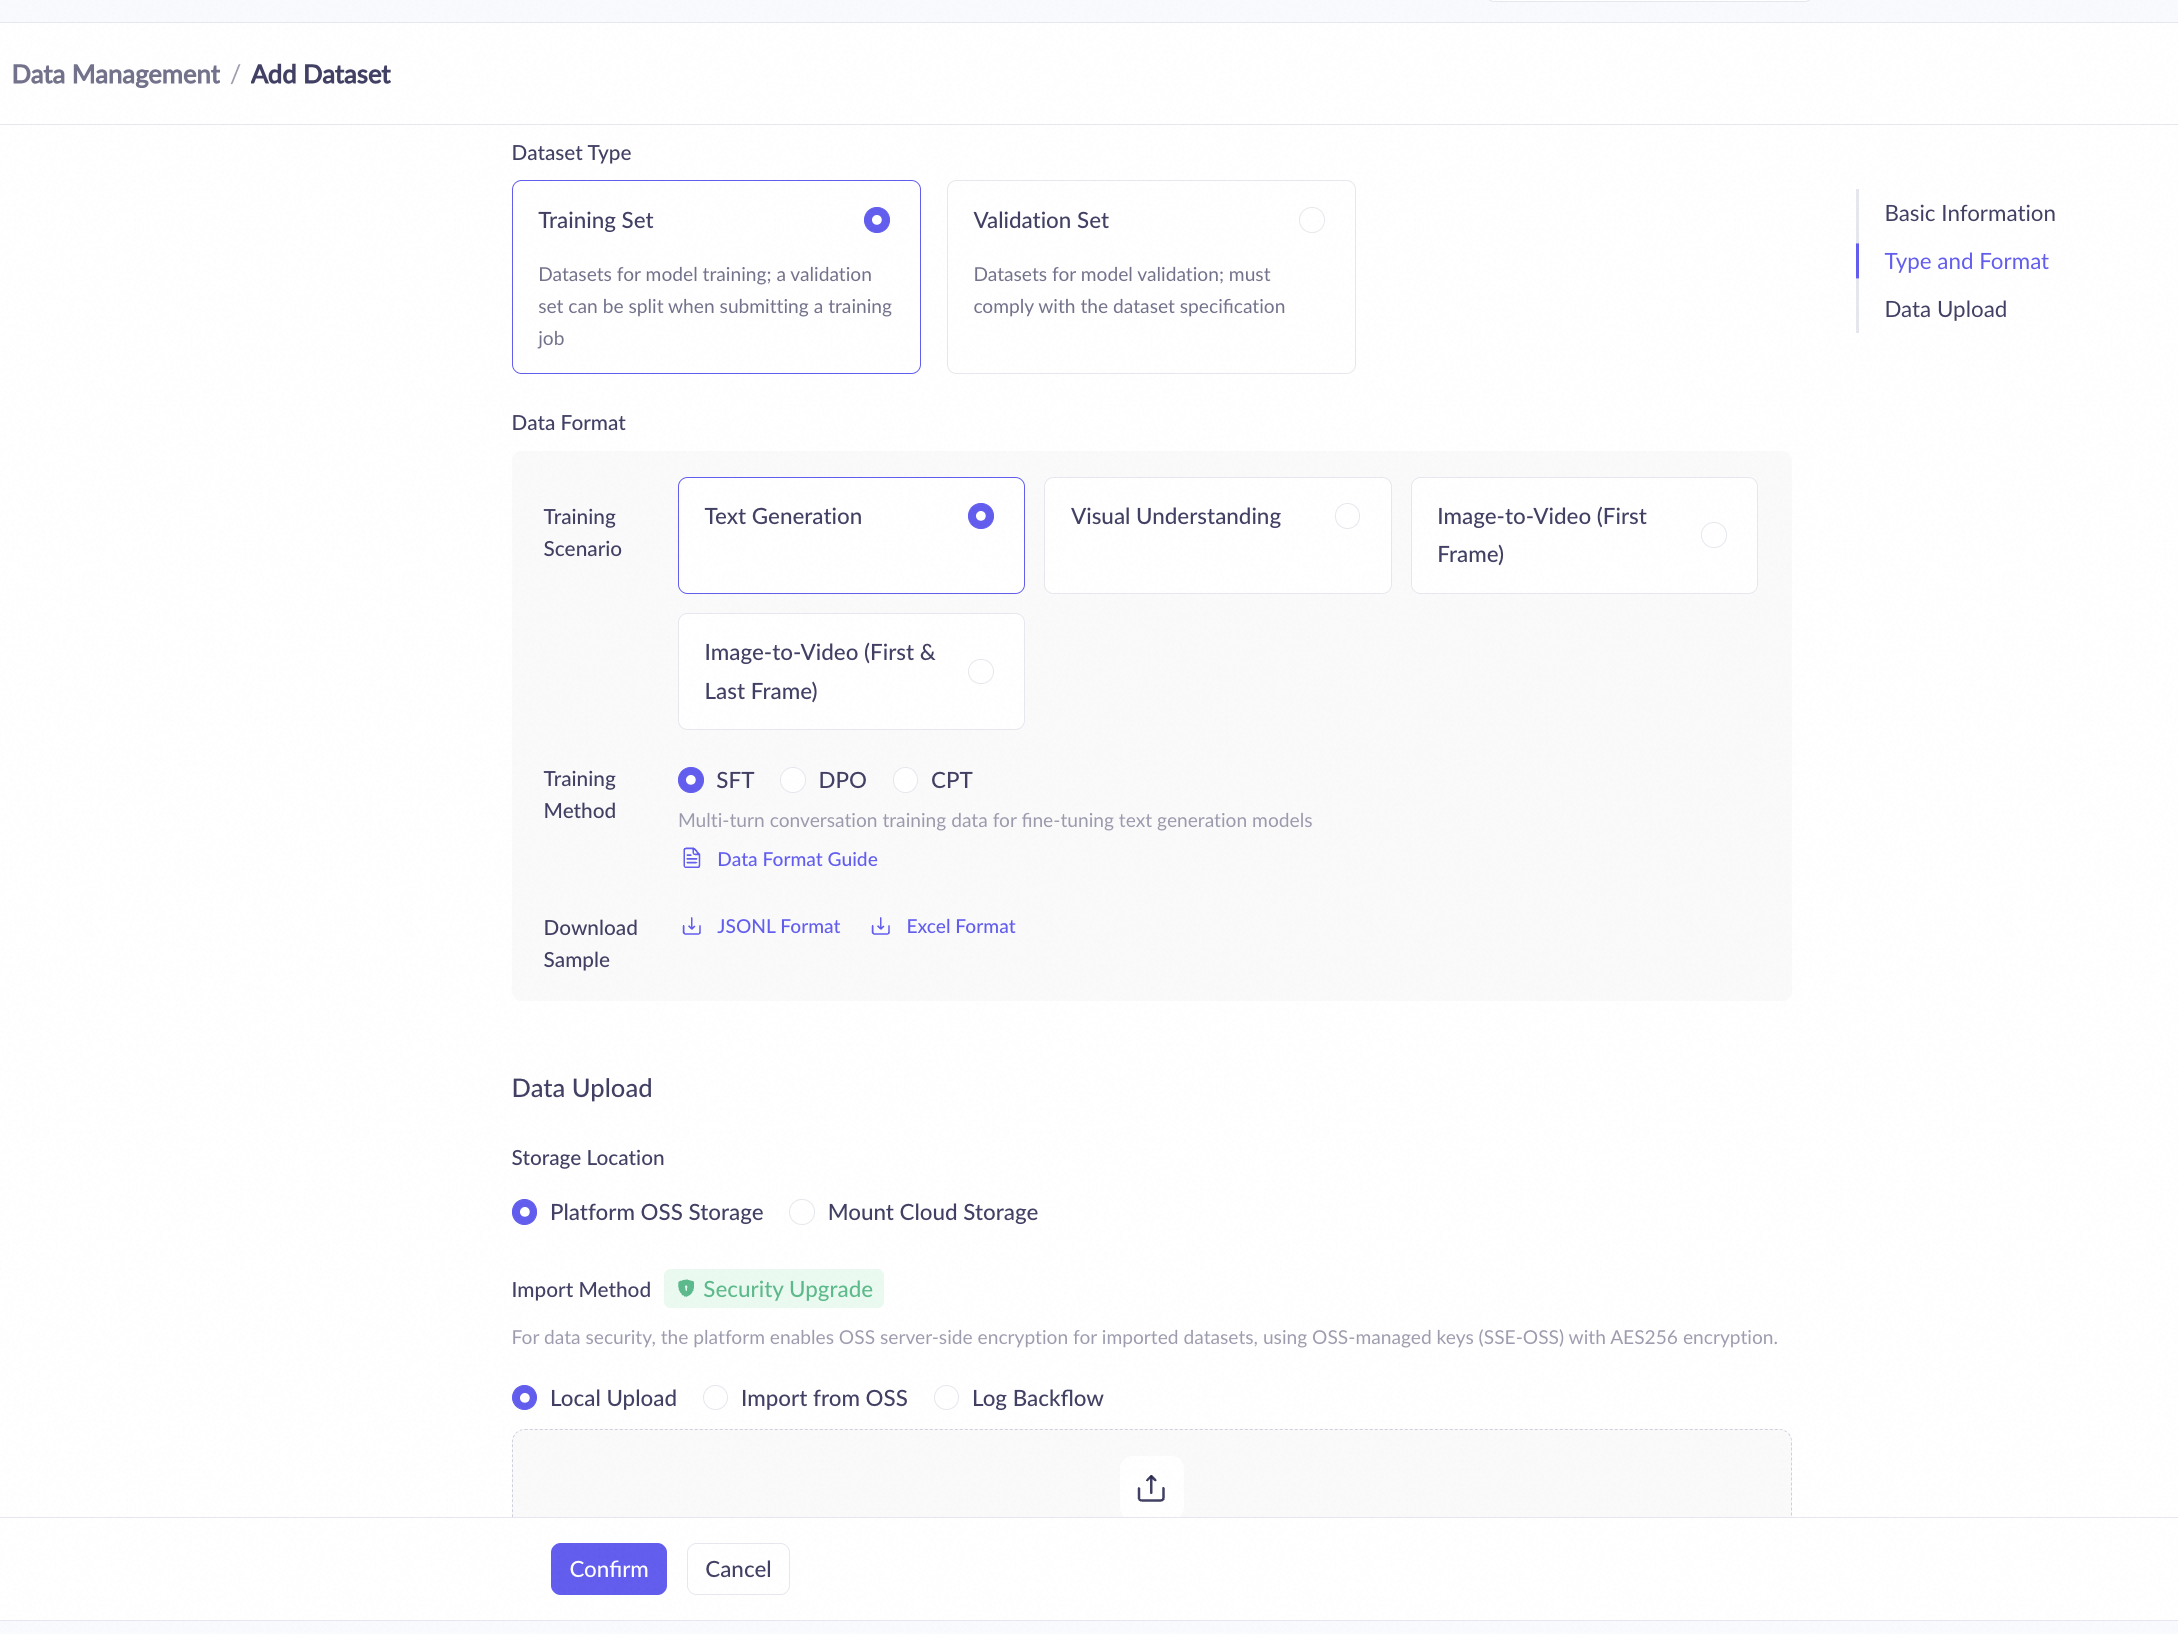
En la página de lista de Data Management > Dataset, haga clic en Add Dataset y siga estos pasos:
- Introduzca un nombre de conjunto de datos (hasta 50 caracteres) y una descripción (hasta 200 caracteres, opcional).
- Seleccione un tipo de conjunto de datos: Conjunto de entrenamiento o Conjunto de evaluación (no se puede cambiar después de la creación).
- Seleccione un escenario de entrenamiento: los conjuntos de entrenamiento admiten generación de texto, comprensión multimodal, imagen a video (primer fotograma) o imagen a video (primer y último fotograma), entre otros; para los conjuntos de evaluación, seleccione aquí el formato de muestra: Generación de texto (ChatML-messages) (conversación multivuelta, admite jsonl, xls y xlsx, hasta 200 MB por archivo) o Generación de texto (prompt&completion) (una sola vuelta, solo xls y xlsx, hasta 20 MB por archivo). La página de creación ofrece plantillas de muestra de ambos formatos para su descarga.
- Seleccione un método de entrenamiento: SFT, DPO o CPT (solo necesario para los conjuntos de entrenamiento; los conjuntos de evaluación no tienen esta configuración).
- Seleccione una ubicación de almacenamiento: Almacenamiento OSS de plataforma (gratuito, sin límite de volumen de datos) o Montaje de almacenamiento en la nube (no disponible para conjuntos de evaluación).
- Seleccione un método de importación y cargue datos: carga local, importación de OSS o reflujo de registros (consulte las descripciones de las pestañas a continuación).
- Haga clic en Submit; el conjunto de datos se publica inmediatamente, completando así la creación.
Parámetro | Descripción | Obligatorio | Descripción del valor |
|---|---|---|---|
Nombre del conjunto de datos | Identificador del conjunto de datos | true | Hasta 50 caracteres; chino/inglés/dígitos/guion bajo/guion/punto |
Descripción del conjunto de datos | Descripción del conjunto de datos | Hasta 200 caracteres | |
Tipo de conjunto de datos | Conjunto de entrenamiento o conjunto de evaluación; no se puede cambiar después de la creación | true | Conjunto de entrenamiento/Conjunto de evaluación |
Escenario de entrenamiento | Escenario de entrenamiento al que se aplican los datos | true | Generación de texto/Comprensión multimodal/Imagen a video (primer fotograma)/Imagen a video (primer y último fotograma) |
Método de entrenamiento | Tipo de algoritmo de entrenamiento | true | SFT/DPO/CPT |
Ubicación de almacenamiento | Método de almacenamiento del conjunto de datos | true | Almacenamiento OSS de plataforma/Montaje de almacenamiento en la nube |
Método de importación | Fuente de importación de datos | true | Carga local/Importación de OSS/Reflujo de registros |
- Carga local
- Importación OSS
- Reflujo de registros
Gestión de versiones
Un conjunto de datos puede tener múltiples versiones independientes, con números de versión que se incrementan automáticamente. En la página de detalles del conjunto de datos, haga clic en Add Version para crear una nueva versión.
Al agregar una versión se utiliza el modo de creación, que requiere reimportar todos los datos; el modo de herencia que modifica los datos incrementalmente basándose en la versión anterior ya no es compatible.
- Modo Crear: reimportar todos los datos; adecuado para actualizaciones a gran escala.
Gestión de conjuntos de datos
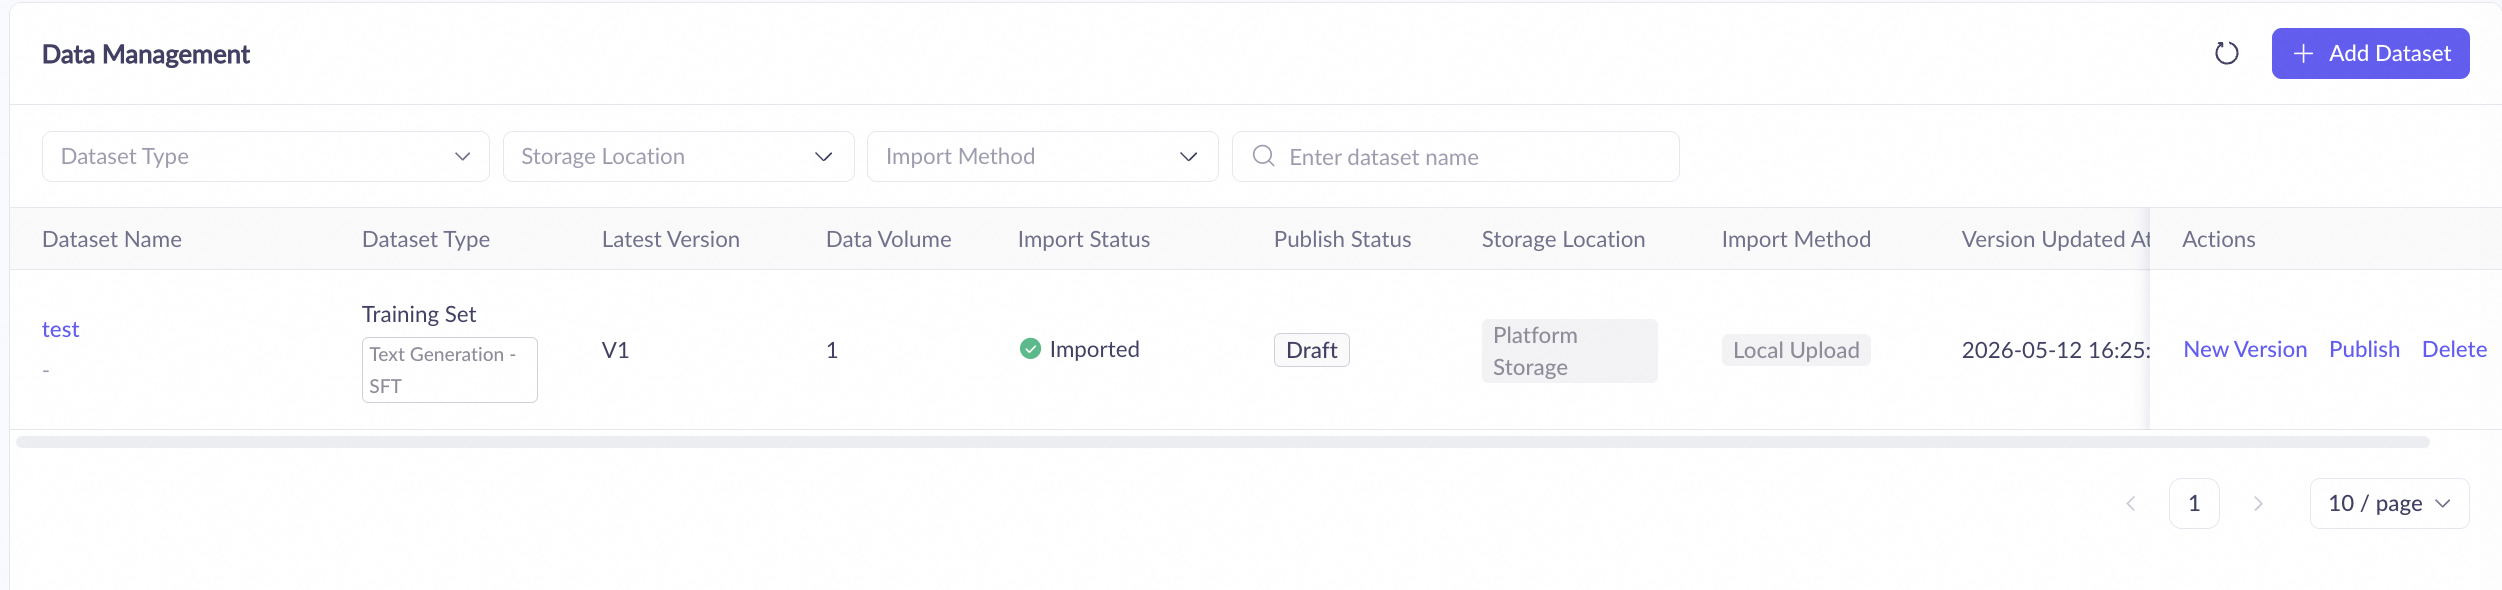
En la página de lista de Data Management > Dataset, puede ver todos los conjuntos de datos, filtrar por tipo (conjunto de entrenamiento/conjunto de evaluación) y buscar por nombre. Los conjuntos de datos que se están importando actualizan automáticamente su estado cada 5 segundos; no es necesaria ninguna actualización manual.
Publicar y eliminar
Publicar es irreversible; las versiones publicadas ya no se pueden editar. Eliminar una versión publicada también es irreversible; solo se pueden eliminar las versiones en borrador creadas históricamente. Eliminar un conjunto de datos completo borra todas sus versiones. Todas estas operaciones son irreversibles; proceda con precaución.
Editar y exportar
Solo las versiones en borrador creadas históricamente se pueden editar en línea (el contenido Prompt/Completion es editable); los nuevos conjuntos de datos se publican inmediatamente al enviarlos y ya no generan versiones en borrador, y la edición no está disponible para las versiones publicadas. Al exportar conjuntos de datos, cada tipo tiene un formato diferente: los conjuntos de entrenamiento SFT se exportan como .jsonl, los conjuntos de entrenamiento multimodales como .zip y los conjuntos de evaluación como .xlsx. No se admite la exportación de conjuntos de datos vacíos.
Facturación
La función de Gestión de datos es gratuita, pero el almacenamiento de conjuntos de datos y los recursos posteriores generan cargos; consulte la página de facturación de Model Studio para obtener más detalles.
- Almacenamiento OSS de plataforma: los cargos se basan en la página de facturación de Model Studio.
- Montaje de almacenamiento en la nube: los cargos se facturan a la propia cuenta OSS del usuario.
- Reflujo de registros: los cargos de SLS incurridos se facturan a la cuenta del producto SLS.
Siguientes pasos
Después de crear y publicar un conjunto de datos, se puede utilizar en los siguientes escenarios posteriores:
- Después de publicar un conjunto de entrenamiento, se utiliza para ajuste fino de modelos (SFT/DPO/CPT).
- Después de publicar un conjunto de evaluación, se utiliza para Evaluación de modelos.