

Las API de Model Studio limitan el volumen de solicitudes, el uso de tokens y la tasa de crecimiento. Aplique estas estrategias para maximizar el rendimiento y mantener la disponibilidad.
- Soluciones de configuración de plataforma (cambios mínimos de código): Cola del lado del servidor, PTU y Batch API.
- Estrategias de control de tráfico del lado del cliente (cambios en el código del cliente): Cuatro estrategias con complejidad de ingeniería creciente, desde el reintento básico hasta el control de congestión adaptativo.
- Soluciones de respaldo arquitectónico (cambios en la arquitectura del sistema): Modelo de respaldo y desplazamiento de carga pico mediante colas de mensajes (MQ).
429 ahora, vaya a Diagnóstico de errores y recomendaciones de estrategia para identificar la causa. Para errores por ráfagas de tráfico, pruebe primero la cola del lado del servidor, ya que solo requiere un encabezado de solicitud.
Mecanismo de limitación de tasa de la plataforma
La plataforma aplica límites de tasa a cada modelo de forma independiente a nivel de cuenta raíz. Tras activarse, el servicio suele reanudarse en un minuto. Para conocer las condiciones de limitación de tasa y el uso actual por modelo, consulte Limitación de tasa y Monitoreo de modelos. Se aplican tres tipos de reglas de limitación de tasa:
- Límites de cuota a nivel de minuto (RPM / TPM): El número máximo de solicitudes por minuto (RPM) y el uso máximo de tokens por minuto (TPM).
- Límites de frecuencia instantánea (RPS / TPS): Máximo de solicitudes por segundo (RPS) y máximo de uso de tokens por segundo (TPS). Llamadas densas a la API o consumo de tokens en un solo segundo pueden activar la limitación de tasa.
- Límites de tasa de crecimiento (Ráfaga de tráfico): Un aumento repentino en el volumen de solicitudes o uso de tokens activa la limitación de tasa. El umbral se ajusta dinámicamente. Aumente las solicitudes gradualmente para evitar activar este límite.
Diagnóstico de errores y recomendaciones de estrategia
El mismo código de error puede activarse por diferentes dimensiones de limitación de tasa. Una concurrencia elevada también puede saturar el servidor y provocar tiempos de espera agotados. La estrategia de control de congestión adaptativa puede ayudar a mitigar este problema.
Código de error (DashScope / OpenAI) | Dimensión de activación | Diagnóstico de características | Estrategia recomendada |
|---|---|---|---|
Throttling.RateQuota / limit_requests | Tasa de solicitudes excedida | Errores intermitentes. La tasa de éxito disminuye con el tiempo. | Cubeta de tokens: Controla la cuota de solicitudes por unidad de tiempo. |
Tasa de solicitudes excedida | Errores concentrados al inicio o durante picos de concurrencia. | Semáforo de concurrencia o limitador de tasa de suavizado: Aumenta el intervalo entre solicitudes. | |
Throttling.AllocationQuota / insufficient_quota | Uso de tokens excedido | Errores intermitentes al procesar textos largos. | Cubeta de tokens dual: Limita simultáneamente las cuotas de RPM y TPM. |
Uso de tokens excedido | El consumo instantáneo de tokens es demasiado alto durante el procesamiento concurrente de textos largos. | ||
Throttling.BurstRate / limit_burst_rate | Tasa de crecimiento de tráfico excedida | Gran volumen repentino de solicitudes después del inicio o tras recuperarse de un estado inactivo. | Recomendamos probar primero la cola del lado del servidor. Alternativamente, utilice un cubo de tokens con un valor inicial bajo, como |
Soluciones de configuración de plataforma
Estas soluciones dependen de las capacidades de la plataforma y requieren cambios mínimos o nulos en el código del lado del cliente.
Cola del lado del servidor (recomendado)
Para la limitación de tasa por ráfagas de tráfico, Model Studio acepta un límite superior del tiempo de espera en el encabezado de la solicitud. Tras recibir la solicitud, el servidor la reintenta cuando hay oportunidad dentro de ese intervalo hasta que comienza a procesarla o terminan los reintentos del intervalo. El valor es solo un límite superior; el servidor no espera a alcanzarlo antes de reintentar. Esto mejora significativamente las tasas de éxito durante ráfagas de tráfico en comparación con una respuesta 429 inmediata.
X-DashScope-Wait-Timeout al encabezado de la solicitud:
Campo de encabezado | Ejemplo | Descripción |
|---|---|---|
X-DashScope-Wait-Timeout | 90 | Límite superior del intervalo de espera en cola para solicitudes en ráfaga, en segundos. El servidor reintenta la solicitud dentro de este intervalo en lugar de esperar a alcanzar el valor.
|
- Solicitudes sin streaming (stream: false): Tiempo de espera = tiempo de espera base original + valor Wait-Timeout.
- Solicitudes con streaming (stream: true): Timeout > valor de Wait-Timeout. Las solicitudes con streaming comienzan a contar el tiempo tras el primer fragmento, por lo que el tiempo de espera de respuesta inicial solo necesita superar el tiempo de espera en cola.
Ejemplo de código
Ejemplo de código
Unidad de rendimiento aprovisionado (PTU)
El servicio PTU proporciona potencia de cómputo dedicada y reservada. Evita la contienda en el pool de recursos públicos y es la solución preferida para requisitos de alto throughput en tiempo real.
Utilice PTU cuando su negocio tenga requisitos deterministas de throughput (como compromisos de SLA) o cuando want un throughput alto y estable sin control de tráfico del lado del cliente.
Las PTU son recursos reservados que se facturan continuamente, incluso cuando no se utilizan por completo. Evalúe las especificaciones requeridas basándose en la carga pico real para evitar desperdicios.
Procesamiento por lotes asíncrono (Batch API)
Para tareas sin requisitos estrictos de tiempo real (limpieza de datos, análisis por lotes), utilice la Batch API para enviarlas a procesamiento por lotes. Las tareas se ejecutan durante horas de baja demanda, devuelven resultados de forma asíncrona y no están sujetas a límites de tasa en línea.
Adecuado para tareas offline que toleran tiempos de retorno de horas a días: anotación de datos, análisis de registros, resúmenes por lotes. Los costos de la Batch API suelen ser inferiores a los de las llamadas a la API en tiempo real.
El tiempo de retorno no está garantizado. No es adecuado para servicios que requieren respuestas inmediatas. Recupere los resultados mediante sondeo o callback después de la envío.
Estrategias de control de tráfico del lado del cliente
Cuando las soluciones de plataforma (como la cola del lado del servidor) no son suficientes, añada control de tráfico en el lado del cliente. El principio fundamental es: distribuir las solicitudes uniformemente dentro de una ventana de tiempo para evitar ráfagas. Después del inicio del sistema o de un periodo prolongado de inactividad, aumente la concurrencia gradualmente.
Cuatro estrategias en orden creciente de complejidad. Cada una incluye la anterior y se suma a ella:
- El reintento básico solo proporciona defensa pasiva.
- La limitación de tasa de solicitudes añade colas activas.
- El modelado de tráfico introduce además control a nivel de token y envío suave.
- El control de congestión adaptativa ajusta dinámicamente la tasa de envío basándose en retroalimentación en tiempo real.
Comparación del rendimiento de throughput de cada estrategia
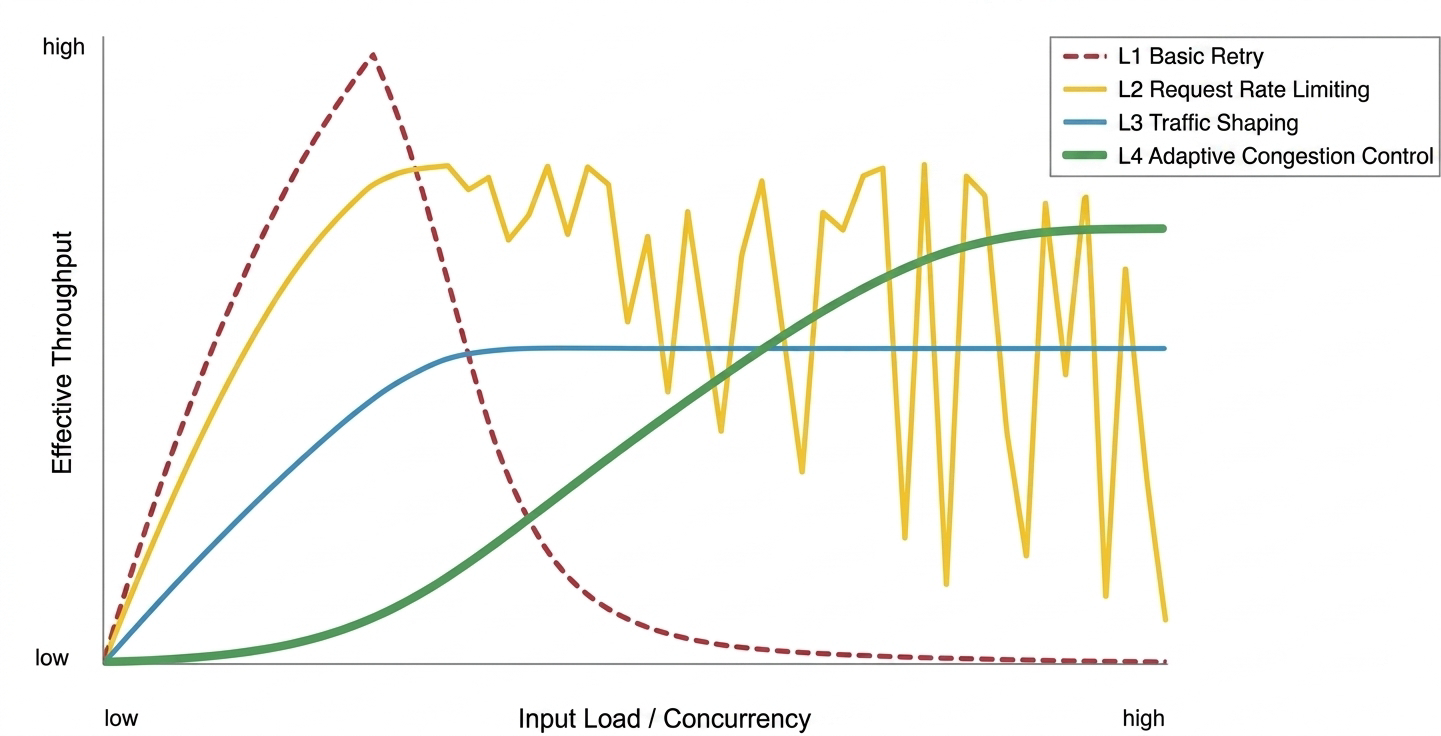
- Estrategia básica de reintentos: Eficaz bajo baja carga. Propensa al colapso por congestión bajo alta concurrencia, causando una caída abrupta en el throughput.
- Estrategia de limitación de tasa de solicitudes: Fuerte protección contra colapsos. Sin embargo, bajo cargas de trabajo mixtas con textos largos, el throughput muestra fluctuaciones en forma de diente de sierra debido a la falta de control de tokens.
- Estrategia de modelado de tráfico: Alta estabilidad. Logra una salida suave sacrificando parte del rendimiento pico.
- Estrategia adaptativa de control de congestión: Puede converger dinámicamente a un punto estable de alto throughput bajo carga elevada, pero tiene overhead de sondeo durante el arranque en frío.
Estrategia de reintento básico
Adecuado para pruebas personales, scripts locales y tareas en segundo plano de baja frecuencia. Sin límite de tasa en solicitudes salientes. Solo activa reintentos con retroceso exponencial y jitter aleatorio ante errores 429 o 5xx.
Sin control proactivo de tráfico. Bajo concurrencia multihilo, esto activa fácilmente la limitación de tasa y causa acumulación de solicitudes.
Ejemplo de código
Ejemplo de código
- El tiempo de espera se duplica progresivamente: Por ejemplo,
1s, 2s, 4s.... Esto evita solicitudes repetidas en un periodo corto. - Añadir jitter aleatorio: Un valor aleatorio (como
2s +/- 0.5s) distribuye el tráfico de reintentos, evitando una inundación secundaria (efecto de manada).
Estrategia de limitación de tasa de solicitudes
Los reintentos pasivos por sí solos no pueden manejar el tráfico real. Los reintentos frecuentes aumentan la latencia. Esta estrategia introduce control activo de tráfico: verifica y regula las solicitudes antes de enviarlas, organizando el tráfico desordenado en una cola que respeta el límite de RPM. El suavizado activo añade un pequeño retraso de cola predecible, muy inferior al costo de un ciclo de "error — espera — reintento". Un costo pequeño conocido supera a uno grande desconocido.
Adecuado para chatbots y otros servicios ligeros de solicitud-respuesta sensibles al tiempo hasta el primer token.
La cola activa del lado del cliente utiliza dos niveles de control:
- Cubeta de tokens RPM: Limita el total de solicitudes por minuto. La capacidad de la cubeta equivale a la cuota de RPM; los tokens se rellenan a una tasa constante. Admite préstamos: si los tokens son insuficientes, una solicitud toma prestado de la cuota futura, estrictamente en orden FIFO.
- Semáforo de concurrencia: Limita las solicitudes concurrentes para evitar que una alta concurrencia instantánea active los límites de RPS.
initial_tokens=rpm_limit), adecuado para servicios en línea que necesitan procesar solicitudes inmediatamente al iniciarse. Si un cubo lleno activa la limitación de tasa, reduzca el valor inicial (por ejemplo, initial_tokens=0 para un "inicio con cubo vacío") para aumentar la tasa de manera más gradual.
Esta estrategia no rastrea el uso de tokens. Las tareas de texto largo aún pueden agotar la cuota de TPM.
Ejemplo de código
Ejemplo de código
Estrategia de modelado de tráfico
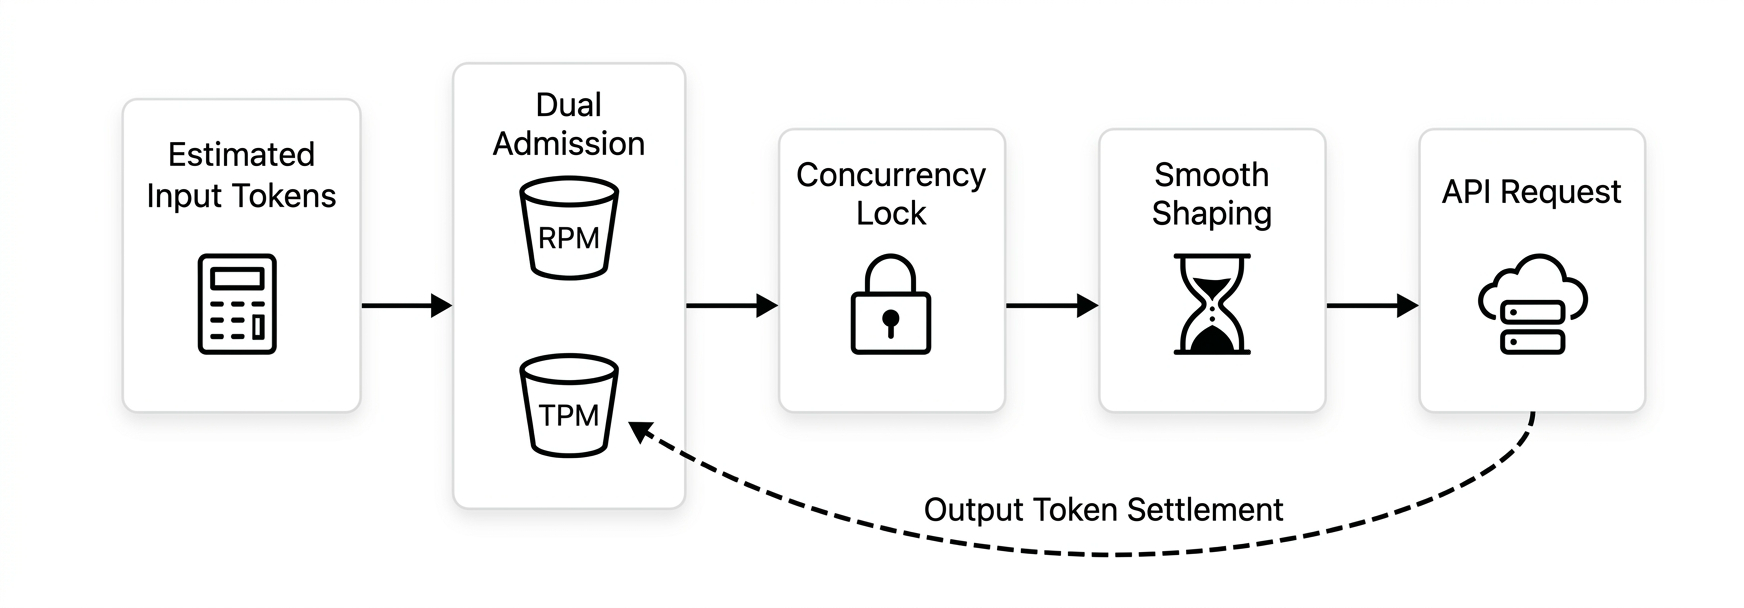
En escenarios por lotes que requieren un rendimiento alto y estable (ingesta RAG en tiempo real, análisis masivo de documentos largos), la limitación de tasa de solicitudes tiene un punto ciego de TPM. El modelado de tráfico añade conciencia dual de recursos (RPM y TPM) y un mecanismo de modelado que convierte el tráfico irregular en un flujo uniforme.
Mejoras sobre la limitación de tasa de solicitudes:
- Control dual de recursos (RPM y TPM): Mantiene cubetas de tokens tanto para RPM como para TPM. Todas las solicitudes deben pasar las verificaciones de cuota para ambas dimensiones antes de ser enviadas.
- Prededucción para entrada, liquidación posterior para salida: La longitud de la salida es desconocida antes de la solicitud. El cubo de TPM prededuce los tokens de entrada al enviar y liquida los tokens de salida reales tras la finalización. Incluso si los tokens pasan a negativo, las solicitudes posteriores esperan a que el recuento sea positivo, suavizando naturalmente el flujo.
- Calentamiento continuo: Durante un arranque en frío, la tasa de emisión de tokens aumenta linealmente con el tiempo, eliminando el riesgo de ráfagas iniciales.
- Limitador de tasa de suavizado (Pacing): Suaviza la tasa de envío imponiendo un intervalo mínimo entre solicitudes (pacing), reduciendo el riesgo de activar límites de tasa.
initial_tokens=0) para un comienzo seguro con menor complejidad. El cubo de tokens de Python aquí es solo demostrativo. En producción, utilice bibliotecas maduras de limitación de tasa como SmoothRateLimiter de Guava en Java.
En el ejemplo de código, la espera de suavizado se coloca dentro del bloqueo de concurrencia. Varias solicitudes podrían competir por el semáforo simultáneamente después de que finalice su espera, reagrupando el tráfico a la salida. El suavizado dentro del bloqueo reduce ligeramente la eficiencia de la concurrencia, pero garantiza intervalos de envío precisos.
El pipeline completo de modelado de tráfico es: Estimate input tokens → Dual admission (RPM & TPM) → Concurrency lock → Traffic shaping → Send → Settle output tokens.
Ejemplo de código
Ejemplo de código
Estrategia de control de congestión adaptativa
Adecuada para cargas de trabajo dinámicas y a gran escala: puertas de enlace API, proxies complejos, sistemas multiinquilino.
- Paradoja del rendimiento: Si la carga es predecible (como en el procesamiento por lotes), los parámetros estáticos óptimos superan al sondeo dinámico que requiere "prueba y convergencia".
- Overhead de sondeo: Los algoritmos dinámicos implican inevitablemente un aumento gradual durante el arranque en frío y fluctuaciones exploratorias, lo cual representa un overhead innecesario en escenarios conocidos.
- Costo de mantenimiento: La retroalimentación de ciclo cerrado aumenta la complejidad del sistema y la dificultad de resolución de problemas.
- EBP: Almacena el nivel máximo histórico exitoso. Calcula la ganancia de sondeo simulando la tensión de un resorte según la distancia entre la concurrencia actual y dicho nivel (más lejos = más rápido, más cerca = más lento). Añade un pequeño impulso lineal para seguir explorando incluso bajo alta saturación.
- Detección de congestión TPT: El tiempo de generación del LLM escala con la longitud de la salida; una latencia alta en textos largos no indica congestión. El TPT (Tiempo por Token) filtra el ruido derivado de la longitud del contenido. La congestión solo se declara cuando el TPT se degrada significativamente.
- Regulador de tasa anti-ráfaga: Independientemente del objetivo EBP, el regulador limita la aceleración del crecimiento de concurrencia para asegurar un aumento gradual y evitar cambios escalonados que activen límites de tasa de crecimiento.
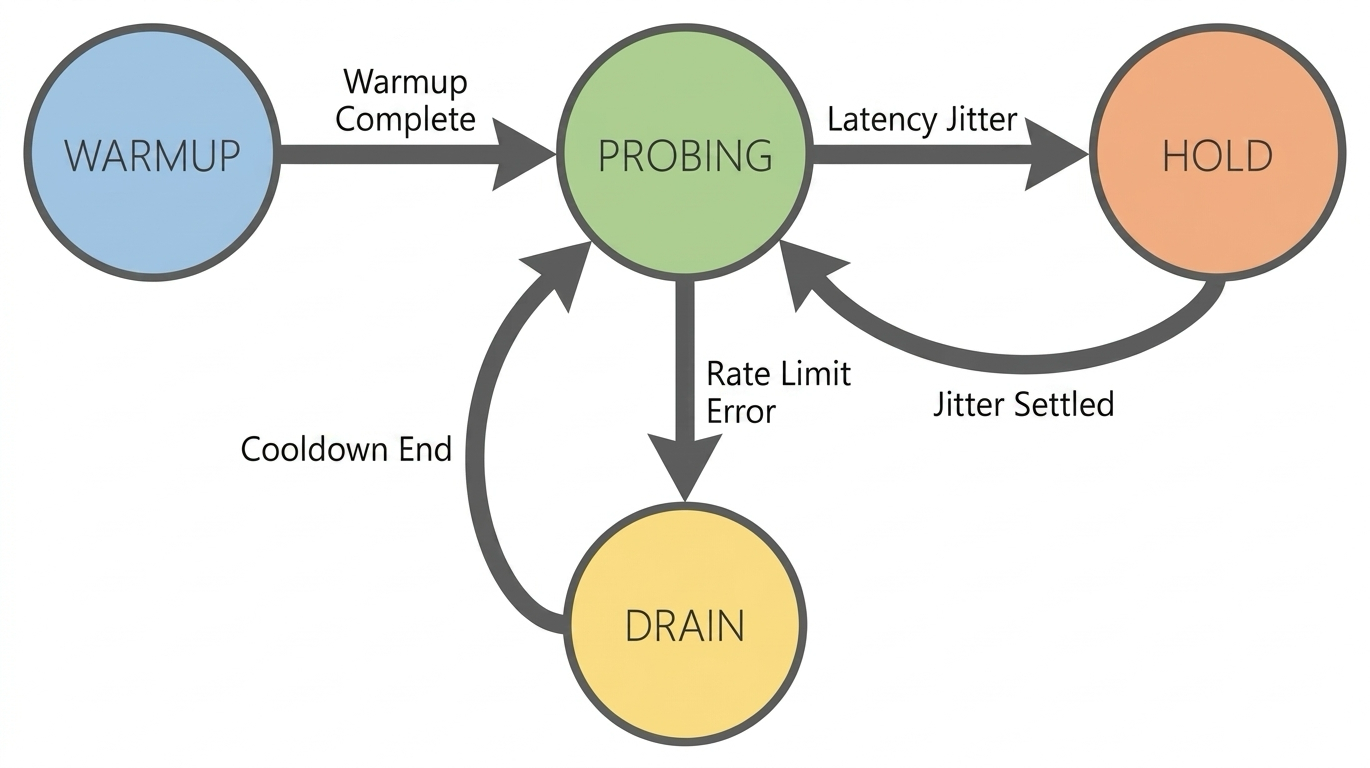
- Sondeo guiado: Introduce cuotas conocidas de RPM/TPM como un "límite superior guía" para evitar colisiones frecuentes causadas por sondeos a ciegas.
- Fuente de señal (RTT → TPT): BBR nativo usa RTT. En escenarios de LLM, la latencia por longitud de contenido eclipsa el jitter de red. TPT elimina esa interferencia.
- Mejora del mecanismo de respuesta (ProbeRTT → Hold): Ante fluctuaciones de latencia, opta por mantener el nivel actual de concurrencia en lugar de retroceder proactivamente y reducir el throughput.
- Respuesta estricta al límite de tasa (Pérdida de paquetes → Drenaje 429): Una vez que se activa un error
429, entra en un estado agresivo de Drenaje y realiza una recuperación rápida tras un periodo de enfriamiento.
- Ruido en TPT: TPT se estima como "latencia total / tokens totales". La latencia total incluye ida y vuelta de red, espera en cola y tiempo hasta el primer token, siendo susceptible a jitter o entradas largas, lo cual puede activar falsamente el estado Hold.
- Inanición de solicitudes grandes: Utiliza una activación FIFO no estricta para el rendimiento de la programación. Cuando las cuotas son escasas, las solicitudes de pocos tokens pueden acaparar recursos, provocando que las solicitudes de muchos tokens esperen demasiado.
- Arranque en frío: Requiere un periodo de calentamiento para construir un modelo estadístico. En tareas de baja carga o de corta duración, el throughput puede ser menor que en las tres primeras estrategias.
Ejemplo de código
Ejemplo de código
Soluciones de respaldo arquitectónico
Cuando la configuración de la plataforma y el control de tráfico del lado del cliente aún no pueden cumplir con los requisitos de disponibilidad o throughput pico, añada mecanismos de respaldo a nivel de arquitectura.
Respaldo de modelo
Cuando el modelo principal no puede responder debido a limitaciones de tasa o problemas de servicio, recurra automáticamente a un modelo alternativo con una cuota más generosa.
Principios de diseño de ruta de respaldo
- Elegir modelos de diferentes series: La limitación de tasa es por modelo. Utilice un modelo diferente como respaldo; por ejemplo, cambie de
qwen3.6-plusaqwen3.6-flash. - Activar el respaldo solo en errores de límite de tasa: Realice el respaldo ante errores
429, no ante todas las excepciones. Cambiar de modelo no solucionará tiempos de espera de red ni errores de parámetros. - Valide el modelo de respaldo con antelación: Asegúrese de que admita las funciones requeridas (Function Calling, salida estructurada, etc.) para evitar problemas funcionales tras el respaldo.
Ejemplo de código
Ejemplo de código
Desplazamiento de carga pico mediante colas de mensajes (MQ)
Para servicios backend que no requieren respuestas inmediatas, introduzca un middleware de mensajería (RabbitMQ, Kafka) para el desplazamiento de carga pico. El tráfico repentino ingresa primero al MQ; los consumidores extraen y procesan a una tasa constante acorde con la cuota de limitación de tasa. Esto desacopla los picos del frontend de las llamadas al backend.
Adecuado para negocios donde los usuarios aceptan resultados asíncronos: procesamiento de tickets, moderación de contenido, anotación de datos por lotes.
Puntos clave de diseño:
- Control de tasa del consumidor: El lado del consumidor debe usar la estrategia de limitación de tasa de solicitudes o de modelado de tráfico para consumir mensajes a una tasa constante basada en la cuota de RPM/TPM, en lugar de extraer mensajes sin límites.
- Manejo de mensajes muertos: Mueva los mensajes que fallan tras múltiples reintentos a una cola de mensajes muertos y active una alerta. Evite que los reintentos infinitos bloqueen el consumo.
- Propagación de contrapresión: Cuando la acumulación en MQ supera un umbral, propague la presión hacia arriba (por ejemplo, devuelva un estado de espera) para evitar un crecimiento ilimitado de la cola.
Consideraciones para entorno de producción
Los ejemplos de código utilizan un bucle de un solo hilo con asyncio de Python para demostrar algoritmos centrales. Antes de su uso en producción a gran escala, considere lo siguiente.
-
Adaptación a modelos no textuales
Las estrategias anteriores utilizan modelos de texto como ejemplos, pero los principios fundamentales se aplican a servicios multimodales (generación de imágenes, síntesis de voz). Las unidades difieren, pero la esencia es la misma: limitar la tasa de envío y la capacidad de procesamiento.
- Modelos como el reconocimiento de voz suelen estar restringidos tanto por el número de solicitudes por unidad de tiempo (como RPM) como por el uso (como duración de audio). Las estrategias son básicamente las mismas que para los modelos de texto.
- Los modelos para imágenes y videos suelen estar restringidos por la tasa de envío de tareas y el número de tareas concurrentes. Puede utilizar el mismo enfoque que la estrategia de limitación de tasa de solicitudes: limite la tasa de envío de tareas y utilice un semáforo para controlar la concurrencia.
-
Atomicidad en modelos concurrentes
Ejemplo:
asyncioutiliza programación cooperativa de un solo hilo, por lo que las modificaciones de estado son inherentemente atómicas dentro de un solo proceso. Producción: En entornos multihilo o multiproceso, garantice la seguridad de concurrencia de la cubeta de tokens y la ventana de estadísticas. Las condiciones de carrera romperán el control de tráfico. - Limitación de tasa distribuida Ejemplo: Todos los componentes de control de tráfico están en memoria. Producción: En despliegues de múltiples instancias, cada instancia limita la tasa independientemente. El uso total puede exceder el límite. Utilice un contador centralizado (como Redis) para gestionar el uso en todos los nodos.
- Colas prioritarias y prevención de inanición Ejemplo: Sin diferenciación de prioridad. La estrategia adaptativa de control de congestión utiliza activación FIFO no estricta para el rendimiento de la programación. Producción: Para solicitudes de alta/baja prioridad, implemente una cola de prioridad ponderada para garantizar ancho de banda al tráfico de alta prioridad. Reserve una cuota mínima para las colas de baja prioridad para evitar la inanición.