

Al utilizarlo para imagen a video, si la optimización de prompts o la llamada a los efectos de video oficiales no satisfacen sus requisitos personalizados para acciones, efectos o estilos específicos, utilice el ajuste fino del modelo.
Ámbito de aplicación
- Región aplicable: Las funciones descritas en este documento están disponibles solo en la región de Singapore. Debe utilizar una clave de API creada en esta región.
- Método de ajuste fino admitido: Ajuste fino SFT-LoRA eficiente.
-
Modelos admitidos para ajuste fino:
- Imagen a video (basado en primer fotograma): wan2.7-i2v, wan2.6-i2v, wan2.5-i2v-preview, wan2.2-i2v-flash.
- Imagen a video (basado en primer y último fotograma): wan2.7-i2v (requiere configurar el hiperparámetro
task_typeenkf2v), wan2.2-kf2v-flash.
Cómo ajustar finamente un modelo
- Imagen a video (basado en el primer fotograma)
- Imagen a video (basado en el primer y último fotograma)
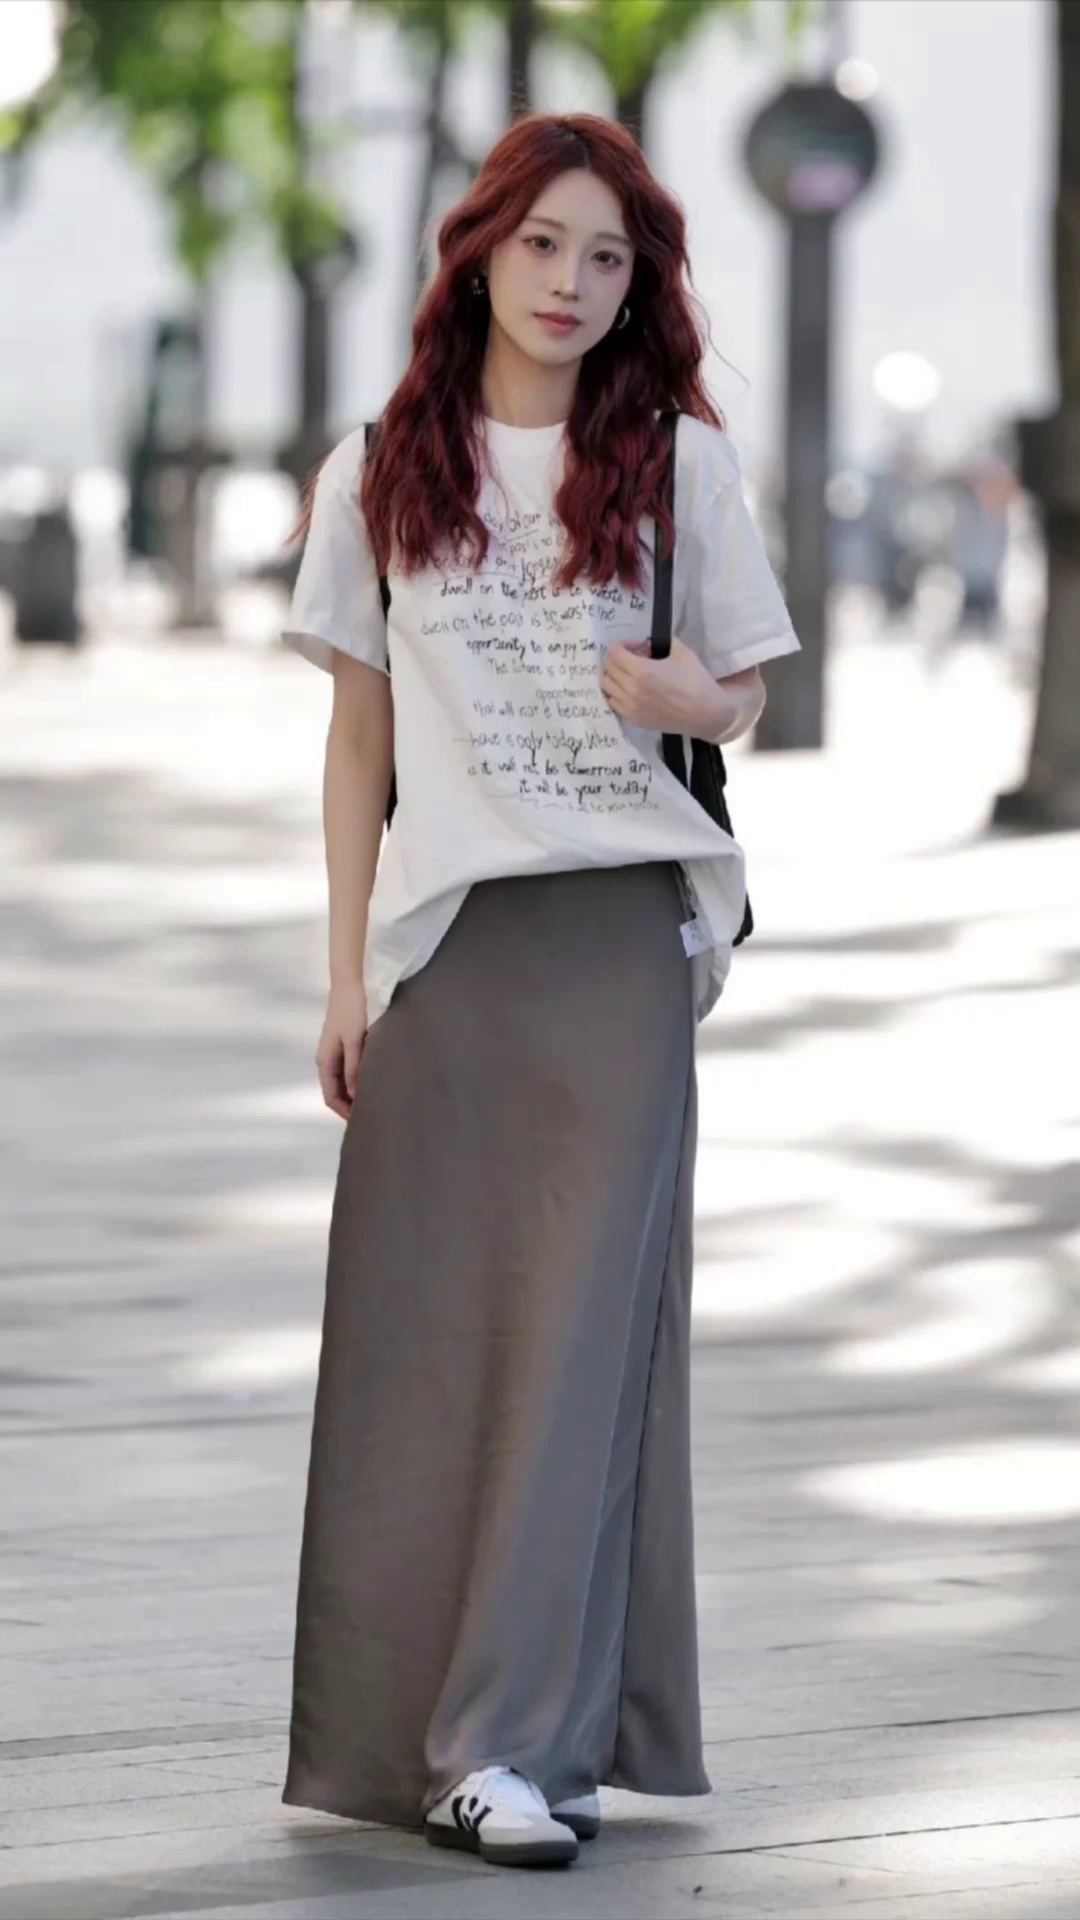
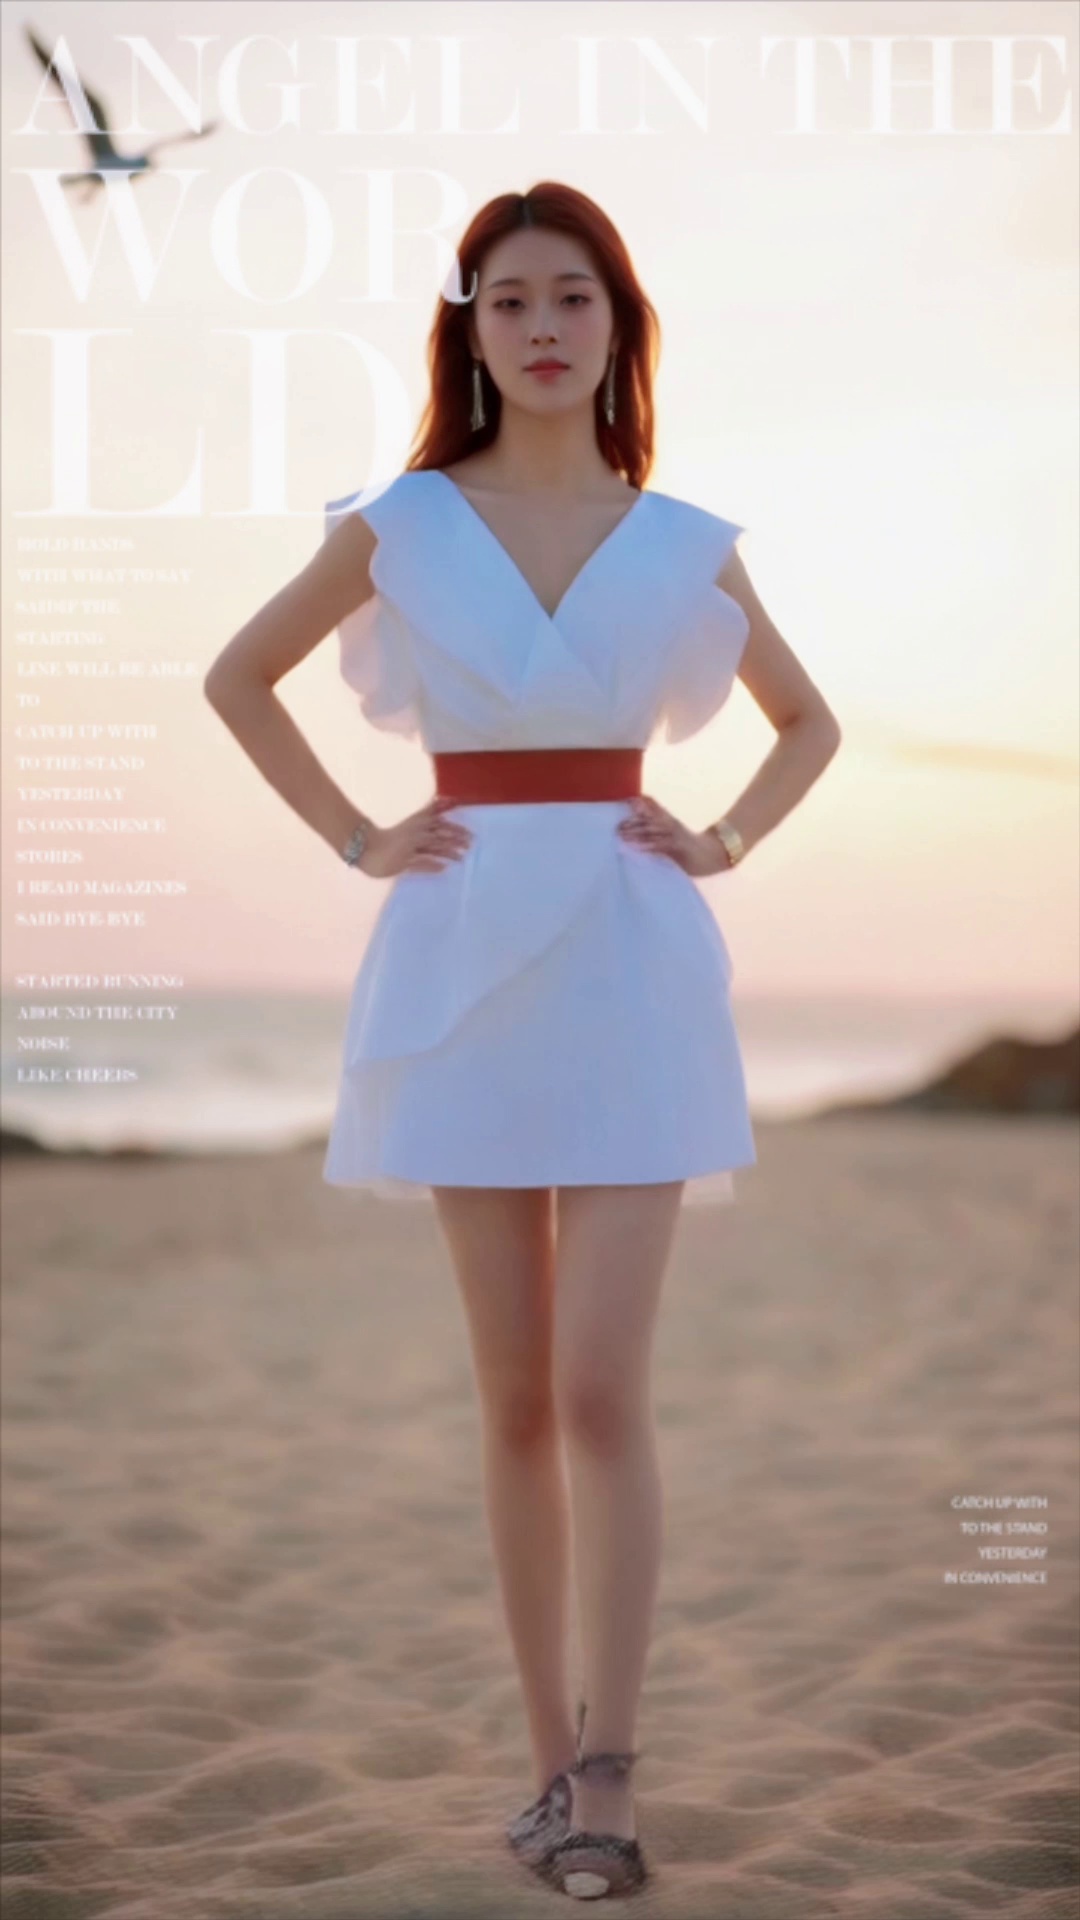
Imagen del primer fotograma de entrada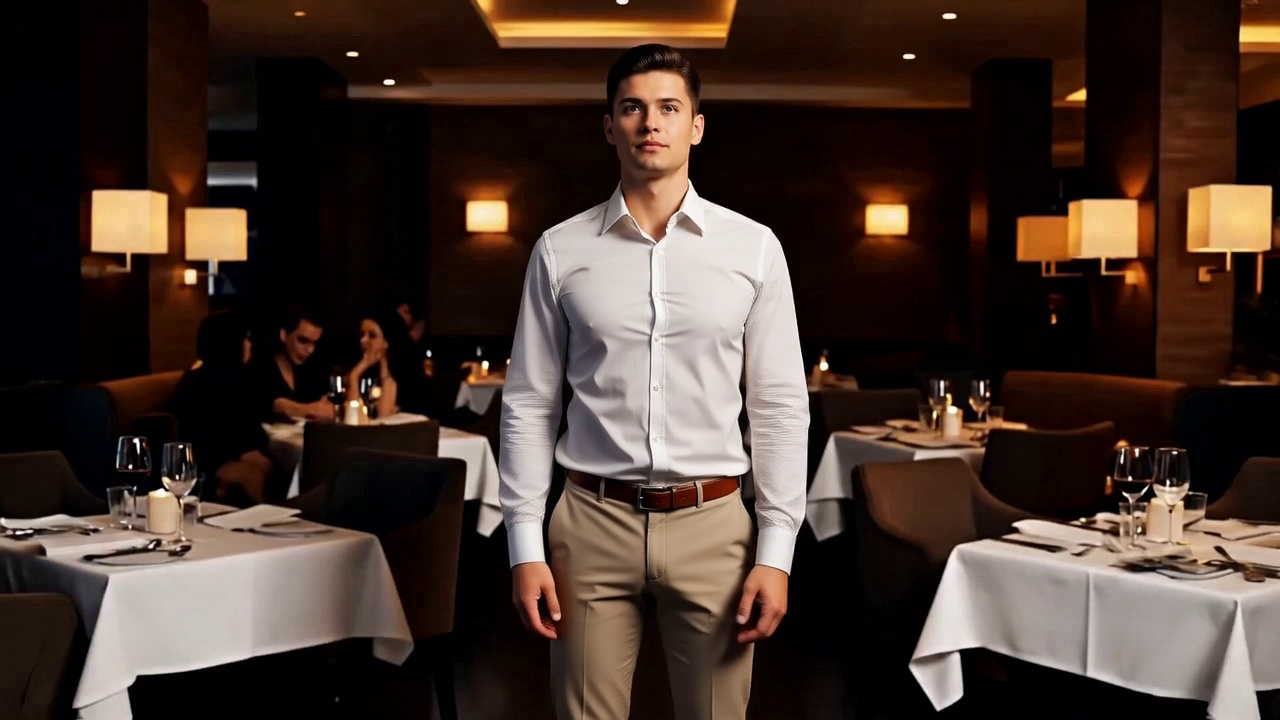 | Video de salida (antes del ajuste fino)No puede generar un efecto de lluvia de dinero consistente cada vez usando prompts. El movimiento no es controlable. | Video de salida (después del ajuste fino)El modelo ajustado reproduce el efecto específico de lluvia de dinero del conjunto de datos de entrenamiento sin prompts. |
Paso 1: Cargar su conjunto de datos
Cargue su conjunto de datos local (en formato .zip) en Alibaba Cloud Model Studio. Obtenga el ID de archivo (id).
Conjunto de datos de entrenamiento de muestra: Consulte el conjunto de entrenamiento para detalles sobre el formato.
- Imagen a video (basado en primer fotograma): wan-i2v-training-dataset.zip.
- Imagen a video (basado en primer y último fotograma): wan-kf2v-training-dataset.zip.
Este ejemplo utiliza el modelo de imagen a video basado en el primer fotograma. Solo cargue el conjunto de entrenamiento. El sistema divide automáticamente una parte del mismo como conjunto de validación. Cargar un conjunto de datos tarda varios minutos. El tiempo exacto depende del tamaño del archivo.
id. Este es el identificador único para su conjunto de datos cargado.
Paso 2: Ajustar finamente el modelo
Paso 2.1 Crear un trabajo de ajuste fino
Inicie el entrenamiento utilizando el ID de archivo del Paso 1. Ejemplo de solicitud Reemplace<replace with training dataset file ID> completamente con el id del paso anterior.
- Imagen a video (basado en el primer fotograma)
- Imagen a video (basado en el primer y último fotograma)
| Campo | Tipo | Obligatorio | Descripción | Valor recomendado |
|---|---|---|---|---|
| task_type | string | No | Tipo de tarea de ajuste fino. Solo es efectivo para el modelo wan2.7-i2v; otros modelos no necesitan configurar este parámetro.
| i2v |
| batch_size | int | Sí | Tamaño del lote. El número de muestras de datos enviadas al modelo para entrenamiento a la vez.Este parámetro es una configuración por instancia. Recomendamos utilizar el valor predeterminado para cada modelo. No lo ajuste a menos que sea necesario.
El número real de instancias en ejecución para un trabajo de entrenamiento está determinado por la programación de la plataforma. La salida de Paso Global en los registros de entrenamiento puede diferir de los resultados estimados, pero esto no cambia la cantidad total de datos de entrenamiento ni afecta el rendimiento final del modelo. | Dependiente del modelo |
| n_epochs | int | Sí | Épocas de entrenamiento. steps = n_epochs x ceiling(dataset size / batch_size). El total de pasos debe ser >= 800.Ejemplo: el conjunto de datos tiene 5 muestras, batch_size=4, pasos por época = ceiling(5/4) = 2, mínimo n_epochs = 800/2 = 400. El número recomendado de épocas de entrenamiento se ajusta automáticamente según el volumen de datos. Menos datos requieren más épocas para aprender suficientemente; más datos significan que cada época contiene más muestras, por lo que se necesitan menos épocas. 50 épocas es adecuado principalmente para conjuntos de datos muy pequeños de aproximadamente 2 muestras; cuando el volumen de datos alcanza 50-60 videos, generalmente se recomienda entrenar aproximadamente 3000-5000 pasos. | 50 |
| learning_rate | float | Sí | Tasa de aprendizaje. Controla la magnitud de las actualizaciones de los pesos del modelo. Un valor demasiado alto puede degradar el modelo; uno demasiado bajo puede resultar en cambios insignificantes. | 2e-5 |
| eval_epochs | int | Sí | Intervalo de evaluación. El valor debe ser >= n_epochs/10. Especifica cuántas épocas transcurren entre cada evaluación y guardado de punto de control. | 20 |
| max_pixels | int | Sí | Resolución máxima para los videos de entrenamiento (píxeles totales = ancho x alto). El sistema solo escala los videos que superan este valor.
| Dependiente del modelo |
| split | float | No | Proporción de división del conjunto de entrenamiento. Rango de valores: (0,1). Solo tiene efecto cuando no se especifica validation_datasets. | 0.9 |
| max_split_val_dataset_sample | int | No | Número máximo de muestras de validación de la división automática. Recuento de validación = min(total x (1 - split), este valor). | 5 |
| save_total_limit | int | No | Número máximo de puntos de control a conservar. El sistema solo retiene los últimos N puntos de control. | 10 |
| lora_rank | int | No | Dimensión de la matriz de bajo rango LoRA. El valor debe ser 2n (16/32/64). | 32 |
| lora_alpha | int | No | Coeficiente de escalado de peso LoRA. El valor debe ser 2n (16/32/64). | 32 |
output:
job_id: ID de trabajo. Úselo para verificar el progreso.finetuned_output: Nombre del nuevo modelo ajustado. Use este nombre para el despliegue.status: Estado del entrenamiento. Después de crear el trabajo, el estado inicial es PENDING. El entrenamiento aún no ha comenzado.
Paso 2.2 Verificar el estado del trabajo de ajuste fino
Utilice eljob_id del Paso 2.1 para verificar el progreso. Consulte este endpoint periódicamente hasta que status sea SUCCEEDED.
<replace with fine-tuning job job_id> en la URL completamente con el valor de job_id.
output:
status: Cuando este valor sea SUCCEEDED, el entrenamiento habrá finalizado. Puede desplegar el modelo.usage: Total de tokens utilizados para el entrenamiento. Se utiliza para la facturación.
Paso 3: Desplegar el modelo ajustado finamente
Paso 3.1 Desplegar el modelo como un servicio en línea
Después de que el estado del trabajo de ajuste fino sea SUCCEEDED, despliegue el modelo como un servicio en línea. Ejemplo de solicitud Reemplace<replace with model name model_name> completamente con el valor de finetuned_output de creación del trabajo de ajuste fino.
output:
deployed_model: Nombre del modelo desplegado. Úselo para verificar el estado del despliegue y llamar al modelo.status: Estado de la implementación. Después de implementar el modelo ajustado, el estado inicial es PENDING. La implementación aún no ha comenzado.
Paso 3.2 Verificar el estado del despliegue
Sondee este endpoint hasta questatus sea RUNNING.
<replace with deployed_model> completamente con el valor de deployed_model del Paso 3.1.
Ejemplo de respuesta
Verifique estos dos parámetros en el campo output:
status: Cuando el estado cambia a RUNNING, el modelo se ha implementado correctamente. Puede comenzar a invocarlo.deployed_model: Nombre del modelo desplegado.
Paso 4: Llamar al modelo para generar videos
Después de una implementación exitosa del modelo (cuando el status de implementación es RUNNING), puede comenzar a invocar el modelo.
Paso 4.1: Crear una tarea de generación de video y obtener el task_id
Paso 4.1: Crear una tarea de generación de video y obtener el task_id
<replace with deployed_model name> con el valor de deployed_model generado en el paso anterior.- Imagen a video (basado en el primer fotograma)
- Imagen a video (basado en el primer y último fotograma)
Llamada al modelo Wan2.7
Llamada al modelo Wan2.7
Llamada al modelo Wan2.6/Wan2.5/Wan2.2
Llamada al modelo Wan2.6/Wan2.5/Wan2.2
task_id para consultar los resultados en el siguiente paso.duration), consulte la documentación de la API.Campo | Tipo | Obligatorio | Descripción | Valor de ejemplo |
|---|---|---|---|---|
model | string | Sí | Nombre del modelo. Debe usar un modelo ajustado que esté desplegado correctamente y tenga un estado RUNNING. | xxxx-ft-202511111122-xxxx |
input.prompt | string | No | Indicador de texto. Si este parámetro surte efecto depende de la configuración aigc_config.use_input_prompt:
| - |
parameters.resolution | string | No | Resolución del video generado. Modelos wan2.2 y wan2.5: 480P, 720P. El valor predeterminado es 720P. Modelos wan2.6: 720P, 1080P. El valor predeterminado es 720P. Modelos wan2.7: 720P, 1080P. El valor predeterminado es 1080P. | 720P |
parameters.prompt_extend | boolean | No | Habilitar la reescritura de indicadores. Al llamar a un modelo LoRA ajustado, desactive esto. Establézcalo en false. | false |
Paso 4.2: Consultar resultados usando el task_id
Paso 4.2: Consultar resultados usando el task_id
task_id hasta que task_status sea SUCCEEDED. Luego obtenga la URL del video.Ejemplo de solicitud
Reemplace 86ecf553-d340-4e21-xxxxxxxxx con el task_id real.
La URL del video es válida por 24 horas. Descargue el video oportunamente.
Crear un conjunto de datos personalizado
Además de usar los conjuntos de datos de muestra en esta guía, puede crear su propio conjunto de datos para el ajuste fino.
Su conjunto de datos debe incluir un conjunto de entrenamiento (obligatorio) y puede incluir un conjunto de validación (opcional, admite la división automática desde el conjunto de entrenamiento). Empaquete todos los archivos en un archivo .zip. Utilice solo letras inglesas, números, guiones bajos o guiones en los nombres de archivo.
Formato del conjunto de datos
Conjunto de entrenamiento: Obligatorio
- Imagen a video (basado en el primer fotograma)
- Imagen a video (basado en el primer y último fotograma)
- Conjunto de entrenamiento de muestra: wan-i2v-training-dataset.zip.
- Estructura de directorios ZIP:
- Archivo de anotaciones (data.jsonl): Cada línea es una muestra de entrenamiento. Debe ser un objeto JSON. Estructura:
Conjunto de validación: Opcional
- Imagen a video (basado en el primer fotograma)
- Imagen a video (basado en el primer y último fotograma)
- Conjunto de validación de muestra: wan-i2v-valid-dataset.zip.
- Estructura de directorios ZIP:
- Archivo de anotaciones (data.jsonl): Cada línea es una muestra de validación. Debe ser un objeto JSON. Estructura:
Escala y límites de datos
- Volumen de datos: Proporcione al menos 10 muestras. Más datos de entrenamiento producen mejores resultados. Recomendamos 20–100 muestras para un rendimiento estable.
- Archivo ZIP: Al cargar mediante API, tamaño total ≤ 1 GB.
-
Requisitos de imágenes de entrenamiento:
- Formatos: BMP, JPEG, PNG, WEBP.
- Resolución ≤ 4096×4096.
- No hay límite estricto en el tamaño individual del archivo (el sistema preprocesa automáticamente).
-
Requisitos de video de entrenamiento:
- Formatos: MP4, MOV.
- Resolución ≤ 4096×4096.
- No hay límite estricto en el tamaño individual del archivo (el sistema preprocesa automáticamente).
- Duración por video: se recomiendan 2–5 segundos para modelos wan2.2; 2–10 segundos para modelos wan2.5; 2–10 segundos para modelos wan2.6 y wan2.7.
Recopilación y limpieza de datos
1. Definir el escenario de ajuste fino
Wanxiang admite el ajuste fino para imagen a video en estos escenarios:- Efectos de video fijos: Enseñar al modelo un cambio visual específico, como un carrusel o un cambio mágico de vestuario.
- Acciones de personaje fijas: Mejorar la capacidad del modelo para reproducir movimientos corporales específicos, como pasos de baile o técnicas de artes marciales.
- Movimiento de cámara fijo: Replicar cinematografía compleja, como tomas de acercamiento, alejamiento, paneo, inclinación u órbita.
2. Recopilar activos sin procesar
- Generación y filtrado con IA: Utilice el modelo base Wanxiang para generar videos por lotes. Seleccione manualmente muestras de alta calidad que coincidan mejor con su efecto objetivo. Este es el método más común.
- Filmación en el mundo real: Si necesita un alto realismo para escenas interactivas (por ejemplo, abrazos, apretones de manos), utilice grabaciones reales.
- Renderizado con software 3D: Para efectos o animaciones abstractas que requieren un control preciso, utilice software 3D (por ejemplo, Blender, Cinema 4D).
3. Limpie los datos
Dimensión | Requisitos positivos | Ejemplo negativo |
|---|---|---|
Consistencia | Las características principales deben ser altamente uniformes. Ejemplo: Para entrenar "rotación de 360 grados", todos los videos deben rotar en sentido horario aproximadamente a la misma velocidad. | Direcciones mixtas. El conjunto de datos contiene rotaciones tanto en sentido horario como antihorario. El modelo no sabe qué dirección aprender. |
Diversidad | Mayor variedad en sujetos y escenas es mejor. Cubra diferentes sujetos (hombres, mujeres, niños, animales, edificios) y composiciones (primeros planos, planos generales, ángulos picados, ángulos contrapicados). Varíe también la resolución y la relación de aspecto. | Escena o sujeto único. Todos los videos muestran "una persona con ropa roja girando frente a una pared blanca". El modelo podría tratar erróneamente "ropa roja" y "pared blanca" como parte del efecto. Falla cuando cambia la ropa. |
Equilibrio | Los tipos de datos deben estar equilibrados. Si existen múltiples estilos, sus cantidades deben ser aproximadamente iguales. | Desequilibrio severo. 90% son videos verticales, 10% son videos horizontales. El modelo puede tener un rendimiento deficiente en videos horizontales. |
Pureza | Visuales limpios y claros. Utilice activos originales sin interferencias. | Elementos de interferencia. Los videos contienen subtítulos, logotipos, marcas de agua, barras negras evidentes o ruido. El modelo podría aprender la marca de agua como parte del efecto. |
Duración | Duración del activo ≤ duración objetivo. Si usted want videos de 5 segundos, recorte los recursos a 4–5 segundos. | Activos demasiado largos. Usted want videos de 5 segundos pero alimenta al modelo con recursos de 8 segundos. Esto provoca un aprendizaje incompleto de la acción y una sensación de entrecortamiento. |
Anotación de video: Escribir prompts para videos
En el archivo de anotaciones del conjunto de datos (data.jsonl), cada video tiene un prompt correspondiente. El prompt describe el contenido del video. La calidad del prompt determina directamente lo que aprende el modelo.
| Ejemplo de promptEl video comienza con una mujer joven parada frente a un muro de ladrillos cubierto de hiedra. Tiene cabello largo y liso de color castaño rojizo, viste un vestido blanco sin mangas, un collar plateado brillante y una sonrisa en su rostro. El fondo es un muro de ladrillos cubierto de enredaderas verdes, con apariencia rústica y natural. Entonces comienza el efecto de lluvia de dinero s86b5p, innumerables billetes de dólares estadounidenses de gran tamaño (fondo beige/patrones verde oscuro) caen como una lluvia torrencial, golpeándola densamente y rodeándola. Los billetes continúan cayendo, ella estira los brazos hacia arriba, el cuello ligeramente inclinado hacia atrás, expresión de sorpresa, completamente inmersa en esta salvaje lluvia de dinero. |
Fórmula de redacción de indicadores
Prompt = [Descripción del sujeto] + [Descripción del fondo] + [Palabra desencadenante] + [Descripción del movimiento]
Elemento del indicador | Descripción | Orientación | Ejemplo |
|---|---|---|---|
Descripción del sujeto | Describir personas u objetos presentes en el encuadre | Obligatorio | El video comienza con una mujer joven... |
Descripción del fondo | Describir el entorno donde se encuentra el sujeto | Obligatorio | El fondo es una pared de ladrillos cubierta de enredaderas verdes... |
Palabra desencadenante | Una palabra rara y sin significado | Recomendado | s86b5p o m01aa |
Descripción de movimiento | Describa en detalle los cambios dinámicos durante el efecto | Recomendado | Incontables billetes de dólares estadounidenses de gran tamaño (fondo beige/patrones verde oscuro) caen como una lluvia torrencial... |
Acerca de las palabras desencadenantes
Acerca de las palabras desencadenantes
- ¿Qué es una palabra clave de activación? Actúa como un "ancla visual". Muchos movimientos complejos (por ejemplo, una trayectoria de baile única o un efecto de luz) son difíciles de describir con texto. Una palabra desencadenante obliga al modelo a generar ese efecto visual exacto cuando ve la palabra.
- ¿Por qué usarlo? El ajuste fino crea un mapeo entre el texto y las características del video. La palabra desencadenante vincula un efecto difícil de describir con una palabra única para que el modelo pueda fijarse en el objetivo.
-
Si tenemos una palabra desencadenante, ¿por qué describir el movimiento en detalle?
Cumplen diferentes funciones y funcionan mejor juntos.
- La descripción del movimiento explica lo que sucede en la escena. Indica al modelo las acciones físicas básicas y la lógica. Las descripciones de movimiento suelen ser consistentes en todas las muestras.
- La palabra desencadenante explica cómo se ve específicamente la acción. Representa cambios y características únicas que las palabras no pueden describir.
Cómo escribir buenos prompts
Siga las reglas de consistencia para las descripciones de efectos
Para todas las muestras que contengan el mismo efecto, mantenga la parte de descripción del movimiento lo más consistente posible. Aplique esta regla tanto a los conjuntos de entrenamiento como de validación.-
Propósito: Cuando el modelo ve
s86b5pseguido de la misma descripción fija y siempre observa lluvia de dinero, aprende que s86b5p = efecto visual de lluvia de dinero. -
Ejemplo: Ya sea que el sujeto sea una “mujer joven” o un “hombre trajeado”, el prompt termina de la misma manera para el efecto de lluvia de dinero: “...entonces comienza el efecto de lluvia de dinero s86b5p, innumerables billetes de dólares estadounidenses caen como una lluvia torrencial...”
Tipo de muestra
Contenido del prompt (Note la consistencia en las partes subrayadas)
Muestra de entrenamiento 1
El video comienza con una mujer joven parada frente a un muro de ladrillos... (descripción del entorno omitida)...
Entonces comienza el efecto de lluvia de dinero s86b5p, innumerables billetes de dólares estadounidenses de gran tamaño (fondo beige/patrones verde oscuro) caen como una lluvia torrencial, golpeándola densamente y rodeándola. Los billetes continúan cayendo, ella estira los brazos hacia arriba, el cuello ligeramente inclinado hacia atrás, expresión de sorpresa, completamente inmersa en esta salvaje lluvia de dinero.Muestra de entrenamiento 2
El video comienza con un hombre trajeado en un restaurante de alta gama... (descripción del entorno omitida)...
Entonces comienza el efecto de lluvia de dinero s86b5p, innumerables billetes de dólares estadounidenses de gran tamaño (fondo beige/patrones verde oscuro) caen como una lluvia torrencial, golpeándolo densamente y rodeándolo. Los billetes continúan cayendo, él estira los brazos hacia arriba, el cuello ligeramente inclinado hacia atrás, expresión de sorpresa, completamente inmerso en esta salvaje lluvia de dinero.Muestra de validación 1
El video comienza con un niño pequeño parado frente a un paisaje urbano... (descripción del entorno omitida)...
Entonces comienza el efecto de lluvia de dinero s86b5p, innumerables billetes de dólares estadounidenses de gran tamaño (fondo beige/patrones verde oscuro) caen como una lluvia torrencial, golpeándolo densamente y rodeándolo. Los billetes continúan cayendo mientras la cámara hace zoom lentamente, él estira los brazos hacia arriba, el cuello ligeramente inclinado hacia atrás, expresión de sorpresa, completamente inmerso en esta salvaje lluvia de dinero.
Usar IA para generar prompts
Para obtener prompts de alta calidad, utilice modelos de lenguaje grande multimodales como Qwen-VL para asistirle.-
Use IA para generar descripciones iniciales
-
Lluvia de ideas libre (encontrar inspiración): Si no está seguro de cómo describir el efecto, deje que la IA explore libremente.
- Envíe "
Describe the video content in detail" y observe la salida del modelo. - Concéntrese en los términos que utiliza el modelo para la trayectoria de movimiento (por ejemplo, "caer como una lluvia torrencial", "la cámara hace zoom lentamente"). Estos términos pueden utilizarse para optimizaciones posteriores.
- Envíe "
-
Prompts de formato fijo (estandarizar la salida): Una vez que tenga una idea aproximada, diseñe un formato fijo para guiar a la IA a generar prompts que coincidan con su plantilla.
Código de ejemplo
Consulte comprensión visual para obtener detalles sobre la llamada a la API.
-
Lluvia de ideas libre (encontrar inspiración): Si no está seguro de cómo describir el efecto, deje que la IA explore libremente.
-
Extraer plantillas de efectos
- Ejecute el proceso varias veces en muestras con el mismo efecto. Identifique frases precisas y de alta frecuencia utilizadas para describir el efecto. Extraiga una "descripción del efecto" genérica.
- Copie y pegue esta descripción estandarizada del efecto en todas las muestras para ese efecto.
- Mantenga descripciones únicas de "sujeto" y "fondo" para cada muestra. Reemplace únicamente la parte de "descripción del efecto" con la plantilla unificada.
- Revisión manual La IA puede tener alucinaciones o cometer errores de detección. Como paso final, realice una revisión manual. Por ejemplo, confirme que las descripciones de la entidad y el fondo coinciden con la escena real.
Evaluar el modelo usando un conjunto de validación
Especificar un conjunto de validación
Un trabajo de ajuste fino requiere un conjunto de entrenamiento. Un conjunto de validación es opcional. Puede elegir dejar que el sistema split automatically o upload manually. Especifíquelo de la siguiente manera:
Método 1: No se cargó conjunto de validación (el sistema divide automáticamente)
Cuando usted crea un trabajo de ajuste fino, si no carga un conjunto de validación por separado, lo que significa que no se pasa el parámetrovalidation_file_ids, el sistema divide automáticamente una parte del conjunto de entrenamiento para usarla como conjunto de validación basándose en los siguientes dos hiperparámetros:
split: Proporción de datos de entrenamiento a dividir. Por ejemplo, 0.9 significa 90% para entrenamiento y 10% para validación.max_split_val_dataset_sample: Número máximo de muestras para el conjunto de validación dividido automáticamente.
dataset size × (1 - split) y max_split_val_dataset_sample.
-
Ejemplo: Suponga que carga solo un conjunto de entrenamiento con 100 muestras, split=0.9 (10% para validación) y max_split_val_dataset_sample=5.
- División teórica: 100 × 10% = 10 muestras.
- División real: min(10, 5)=5. Por lo tanto, el sistema usa solo 5 muestras para el conjunto de validación.
Método 2: Cargar un conjunto de validación manualmente (usando validation_file_ids)
Si prefiere evaluar los puntos de control utilizando sus propios datos preparados en lugar de depender de divisiones aleatorias del sistema, cargue un conjunto de validación personalizado. Nota: Una vez que elija la carga manual, el sistema ignores las reglas de división automática anteriores y valida únicamente con los datos que usted haya cargado.Pasos: Cargar un conjunto de validación manualmente
Pasos: Cargar un conjunto de validación manualmente
- Prepare el conjunto de validación: Empaquete los datos de validación en un archivo
.zipindependiente. Consulte formato del conjunto de validación. - Cargar el conjunto de validación: Llame a la API de carga de conjunto de datos para cargar este archivo
.zip. Obtenga un ID de archivo dedicado. - Especifique el conjunto de validación al crear el trabajo: Al llamar a la API de creación de trabajo de ajuste fino, coloque este ID de archivo en el parámetro
validation_file_ids.
Seleccionar el mejor punto de control para el despliegue
Durante el entrenamiento, el sistema guarda "instantáneas" periódicas (puntos de control). Por defecto, el sistema genera el punto de control final como el modelo ajustado. Pero los puntos de control intermedios pueden superar en rendimiento a la versión final. Puede elegir el mejor para su implementación.
El sistema ejecuta puntos de control en el conjunto de validación y genera videos de vista previa a intervalos definidos por el hiperparámetro eval_epochs.
- Evaluación: Juzgue viendo directamente los videos de vista previa.
- Criterios de selección: Elija el punto de control con la mejor calidad visual y sin distorsión de movimiento.
Procedimiento
Paso 1: Ver resultados de vista previa para los puntos de control
Paso 1: Ver resultados de vista previa para los puntos de control
Paso 1.1 Listar puntos de control validados
Esta API devuelve únicamente los puntos de control que pasaron la validación y generaron correctamente videos de vista previa. Los puntos de control fallidos no se listan.Ejemplo de solicitud<replace_with_fine-tuning_job_id>: Reemplace completamente con eljob_idde la API de creación de trabajo de ajuste fino.
Paso 1.2 Ver los resultados de validación de un punto de control
Seleccione un punto de control de la lista anterior (por ejemplo, "checkpoint-160") y vea su resultado de video.Ejemplo de solicitud<replace_with_fine-tuning_job_id>: Reemplace completamente con eljob_idde la creación del trabajo de ajuste fino.<replace_with_selected_checkpoint>: Reemplace completamente con el valor del punto de control, por ejemplo, "checkpoint-160".
video_path. Es válida durante 24 horas. Descárguelo y revíselo rápidamente. Repita este paso para comparar múltiples puntos de control y encontrar el mejor.Paso 2: Exportar el punto de control y obtener el nombre del modelo para la implementación
Paso 2: Exportar el punto de control y obtener el nombre del modelo para la implementación
Paso 2.1 Exportar el modelo
Suponga que "checkpoint-160" ofrece el mejor resultado. Ahora expórtelo.Ejemplo de solicitud<replace_with_fine_tuning_job_id>: Reemplace completamente con eljob_idde la creación del trabajo de ajuste fino.<replace_with_checkpoint_to_export>: Reemplace completamente con el valor del punto de control, por ejemplo, "checkpoint-160".<replace_with_exported_model_name_for_console_display>: Reemplace completamente con un nombre de modelo personalizado para mostrar en la consola, por ejemplo, “wan2.5-checkpoint-160”. Este nombre debe ser globalmente único. No se permiten nombres duplicados. Para obtener orientación sobre los parámetros, consulte exportar punto de control.
output=true significa que la solicitud de exportación se creó correctamente.Paso 2.2 Consultar el nuevo nombre del modelo después de la implementación
Consulte los estados de todos los puntos de control para confirmar la finalización de la exportación y obtener el nombre único del modelo (model_name) para su implementación.Ejemplo de solicitud<replace_with_fine-tuning_job_id>: Reemplace completamente con eljob_idde la creación del trabajo de ajuste fino.
status cambie a SUCCEEDED, la exportación habrá sido exitosa. El campo model_name es el nuevo nombre del modelo para su implementación y llamadas.Paso 3: Implementar y llamar al modelo
Paso 3: Implementar y llamar al modelo
model_name, siga estos pasos:- Implementación del modelo: En el parámetro de entrada
model_name, introduzca el valor específico obtenido después de la exportación. - Llamada al modelo: Siga la documentación de la API para invocar el modelo implementado.
Puesta en marcha
En producción, si el modelo entrenado inicialmente tiene un rendimiento deficiente (por ejemplo, visuales distorsionados, efectos débiles, movimiento inexacto), ajuste siguiendo estas dimensiones:
1. Verificar datos e indicadores
- Consistencia de datos: La consistencia es crítica. Revise si hay "muestras defectuosas" con direcciones opuestas o estilos muy diferentes.
- Recuento de muestras: Aumente los datos de alta calidad a 20+ muestras.
- Prompt: Asegúrese de que las palabras desencadenantes sean términos raros y sin significado (por ejemplo, s86b5p). Evite palabras comunes (por ejemplo, correr) que causen interferencia.
-
n_epochs (épocas de entrenamiento)
- Predeterminado: 50. Utilice el valor predeterminado a menos que sea necesario. Si lo ajusta, siga la regla: "Pasos totales de entrenamiento ≥ 800".
-
Fórmula de pasos totales:
steps = n_epochs × ceiling (training set size / batch_size). -
Fórmula mínima de n_epochs:
n_epochs = 800 / ceiling (dataset size / batch_size). -
Ejemplo: Suponga un conjunto de entrenamiento de 5 muestras, utilizando el modelo Wan2.5 (batch_size=4).
- Pasos por época: 5 / 4 = 1.25, redondeado hacia arriba a 2. Épocas totales: n_epochs = 800 / 2 = 400. Este es el mínimo recomendado. Puede aumentarlo según sea necesario.
-
batch_size (tamaño de lote)
- Tamaño del lote. El número de muestras de datos enviadas al modelo para entrenamiento a la vez.
- Este parámetro es una configuración por instancia. Recomendamos utilizar el valor predeterminado para cada modelo. No lo ajuste a menos que sea necesario.
- wan2.7-i2v: Valor recomendado: 1.
- wan2.5-i2v-preview: Valor recomendado: 4.
- wan2.2-i2v-flash: Valor recomendado: 4.
- wan2.2-kf2v-flash: Valor recomendado: 4.
El número real de instancias en ejecución para un trabajo de entrenamiento está determinado por la programación de la plataforma. La salida de Paso Global en los registros de entrenamiento puede diferir de los resultados estimados, pero esto no cambia la cantidad total de datos de entrenamiento ni afecta el rendimiento final del modelo.
- learning_rate (tasa de aprendizaje): Utilice el valor predeterminado (2e-5). Por lo general, no requiere modificación.
Facturación
-
Entrenamiento del modelo: Con costo.
- Costo = Total de tokens de entrenamiento × Precio unitario. Consulte facturación de entrenamiento de modelos.
- Después del entrenamiento, verifique el total de tokens consumidos en el campo
usagede la API de consulta de estado del trabajo de ajuste fino.
- Despliegue del modelo: Gratis.
-
Llamadas al modelo: Con costo.
- Se factura según el precio de llamada estándar del modelo base ajustado. Consulte precios de modelos.
Referencia de API
API de ajuste fino de modelos de generación de video e imágenes
FAQ
P: ¿Cómo se calculan los volúmenes de datos de los conjuntos de entrenamiento y validación?
R: El conjunto de entrenamiento es obligatorio, el conjunto de validación es opcional. Los métodos de cálculo son los siguientes:
-
Cuando no se proporciona un conjunto de validación: El conjunto de entrenamiento cargado constituye el "tamaño total del conjunto de datos". El sistema divide automáticamente una parte de los datos para la validación.
- Tamaño del conjunto de validación =
min(total dataset size × (1 − split), max_split_val_dataset_sample). Para ver un ejemplo, consulte especificar un conjunto de validación. - Tamaño del conjunto de entrenamiento =
total dataset size − validation set size.
- Tamaño del conjunto de validación =
-
Cuando se carga manualmente un conjunto de validación: El sistema ya no divide el conjunto de validación a partir de los datos de entrenamiento.
- Tamaño del conjunto de entrenamiento = Volumen de datos del conjunto de entrenamiento cargado.
- Tamaño del conjunto de validación = Volumen de datos del conjunto de validación cargado.
P: ¿Cómo diseño una buena palabra clave de activación?
R: Siga estas reglas:
- Use combinaciones de letras sin significado, como sksstyle, a8z2_bbb.
- Evite palabras comunes en inglés (por ejemplo, beautiful, fire, dance). Esto evita contaminar la comprensión original que tiene el modelo de estas palabras.