

Los modelos de comprensión visual pueden responder preguntas basándose en las imágenes o videos que usted proporcione. Admiten entradas de una o varias imágenes y son adecuados para diversas tareas, como la generación de descripciones de imágenes, la respuesta a preguntas visuales y la localización de objetos.
Introducción
Requisitos previos
- Obtenga una clave API y configúrela como una variable de entorno.
- Para realizar llamadas utilizando un SDK, instale el SDK. El SDK de Python de DashScope debe ser versión 1.24.6 o posterior, y el SDK de Java de DashScope debe ser versión 2.21.10 o posterior.
- Compatible con OpenAI
- DashScope
- Python
- Node.js
- Java
- curl
Respuesta
Rendimiento del modelo
Preguntas y respuestas sobre imágenes
Describa el contenido de una imagen o clasifíquela y etiquétela, como identificar personas, lugares, animales y plantas.
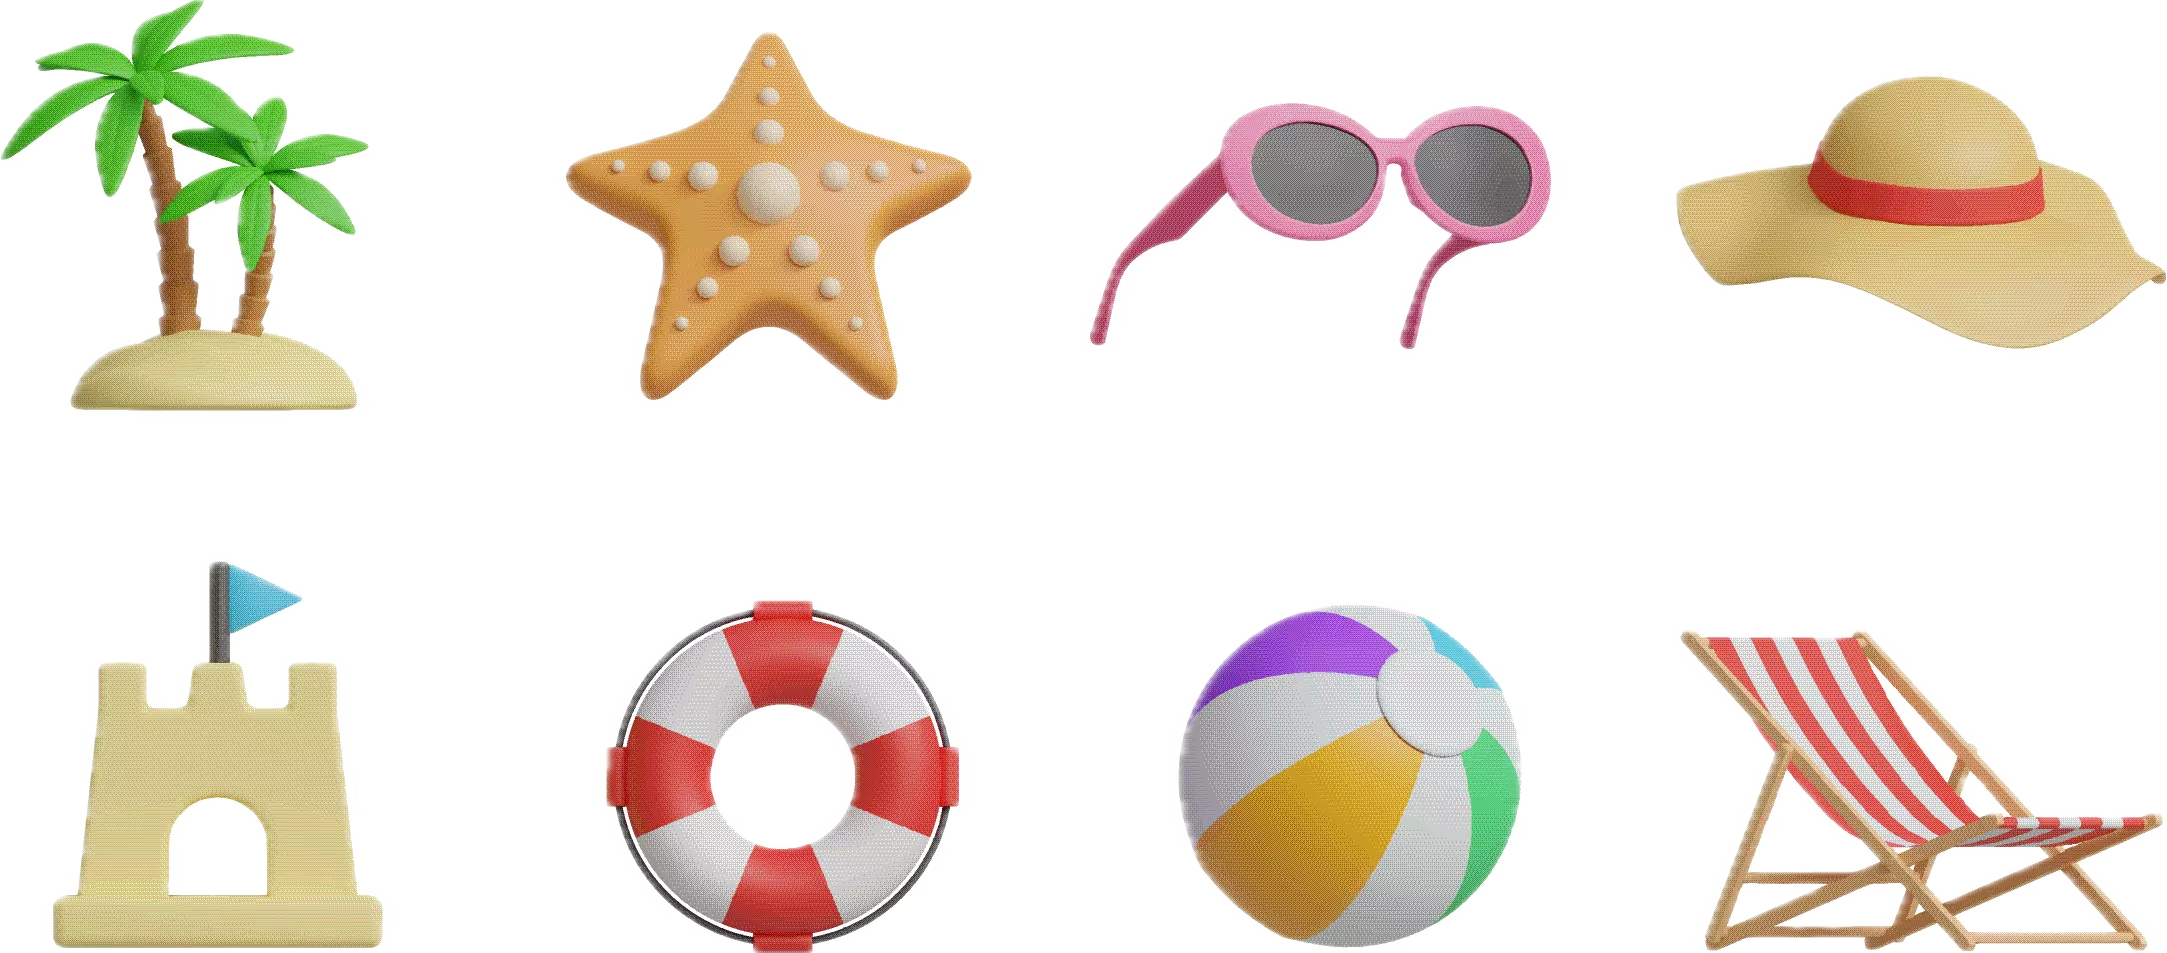 ¿Qué objeto de esta imagen debería usar si el sol es demasiado brillante? | Si el sol es demasiado brillante, debe usar los lentes de sol rosas que aparecen en la imagen. Los lentes de sol pueden bloquear eficazmente la luz intensa, reducir el daño por rayos UV en sus ojos y ayudar a proteger su visión, mejorando así la comodidad visual bajo la luz solar intensa. |
|---|
Escritura creativa
Genere descripciones de texto vívidas basadas en el contenido de imágenes o videos, adecuado para escenarios creativos como escritura de historias, redacción publicitaria y guiones de videos cortos.
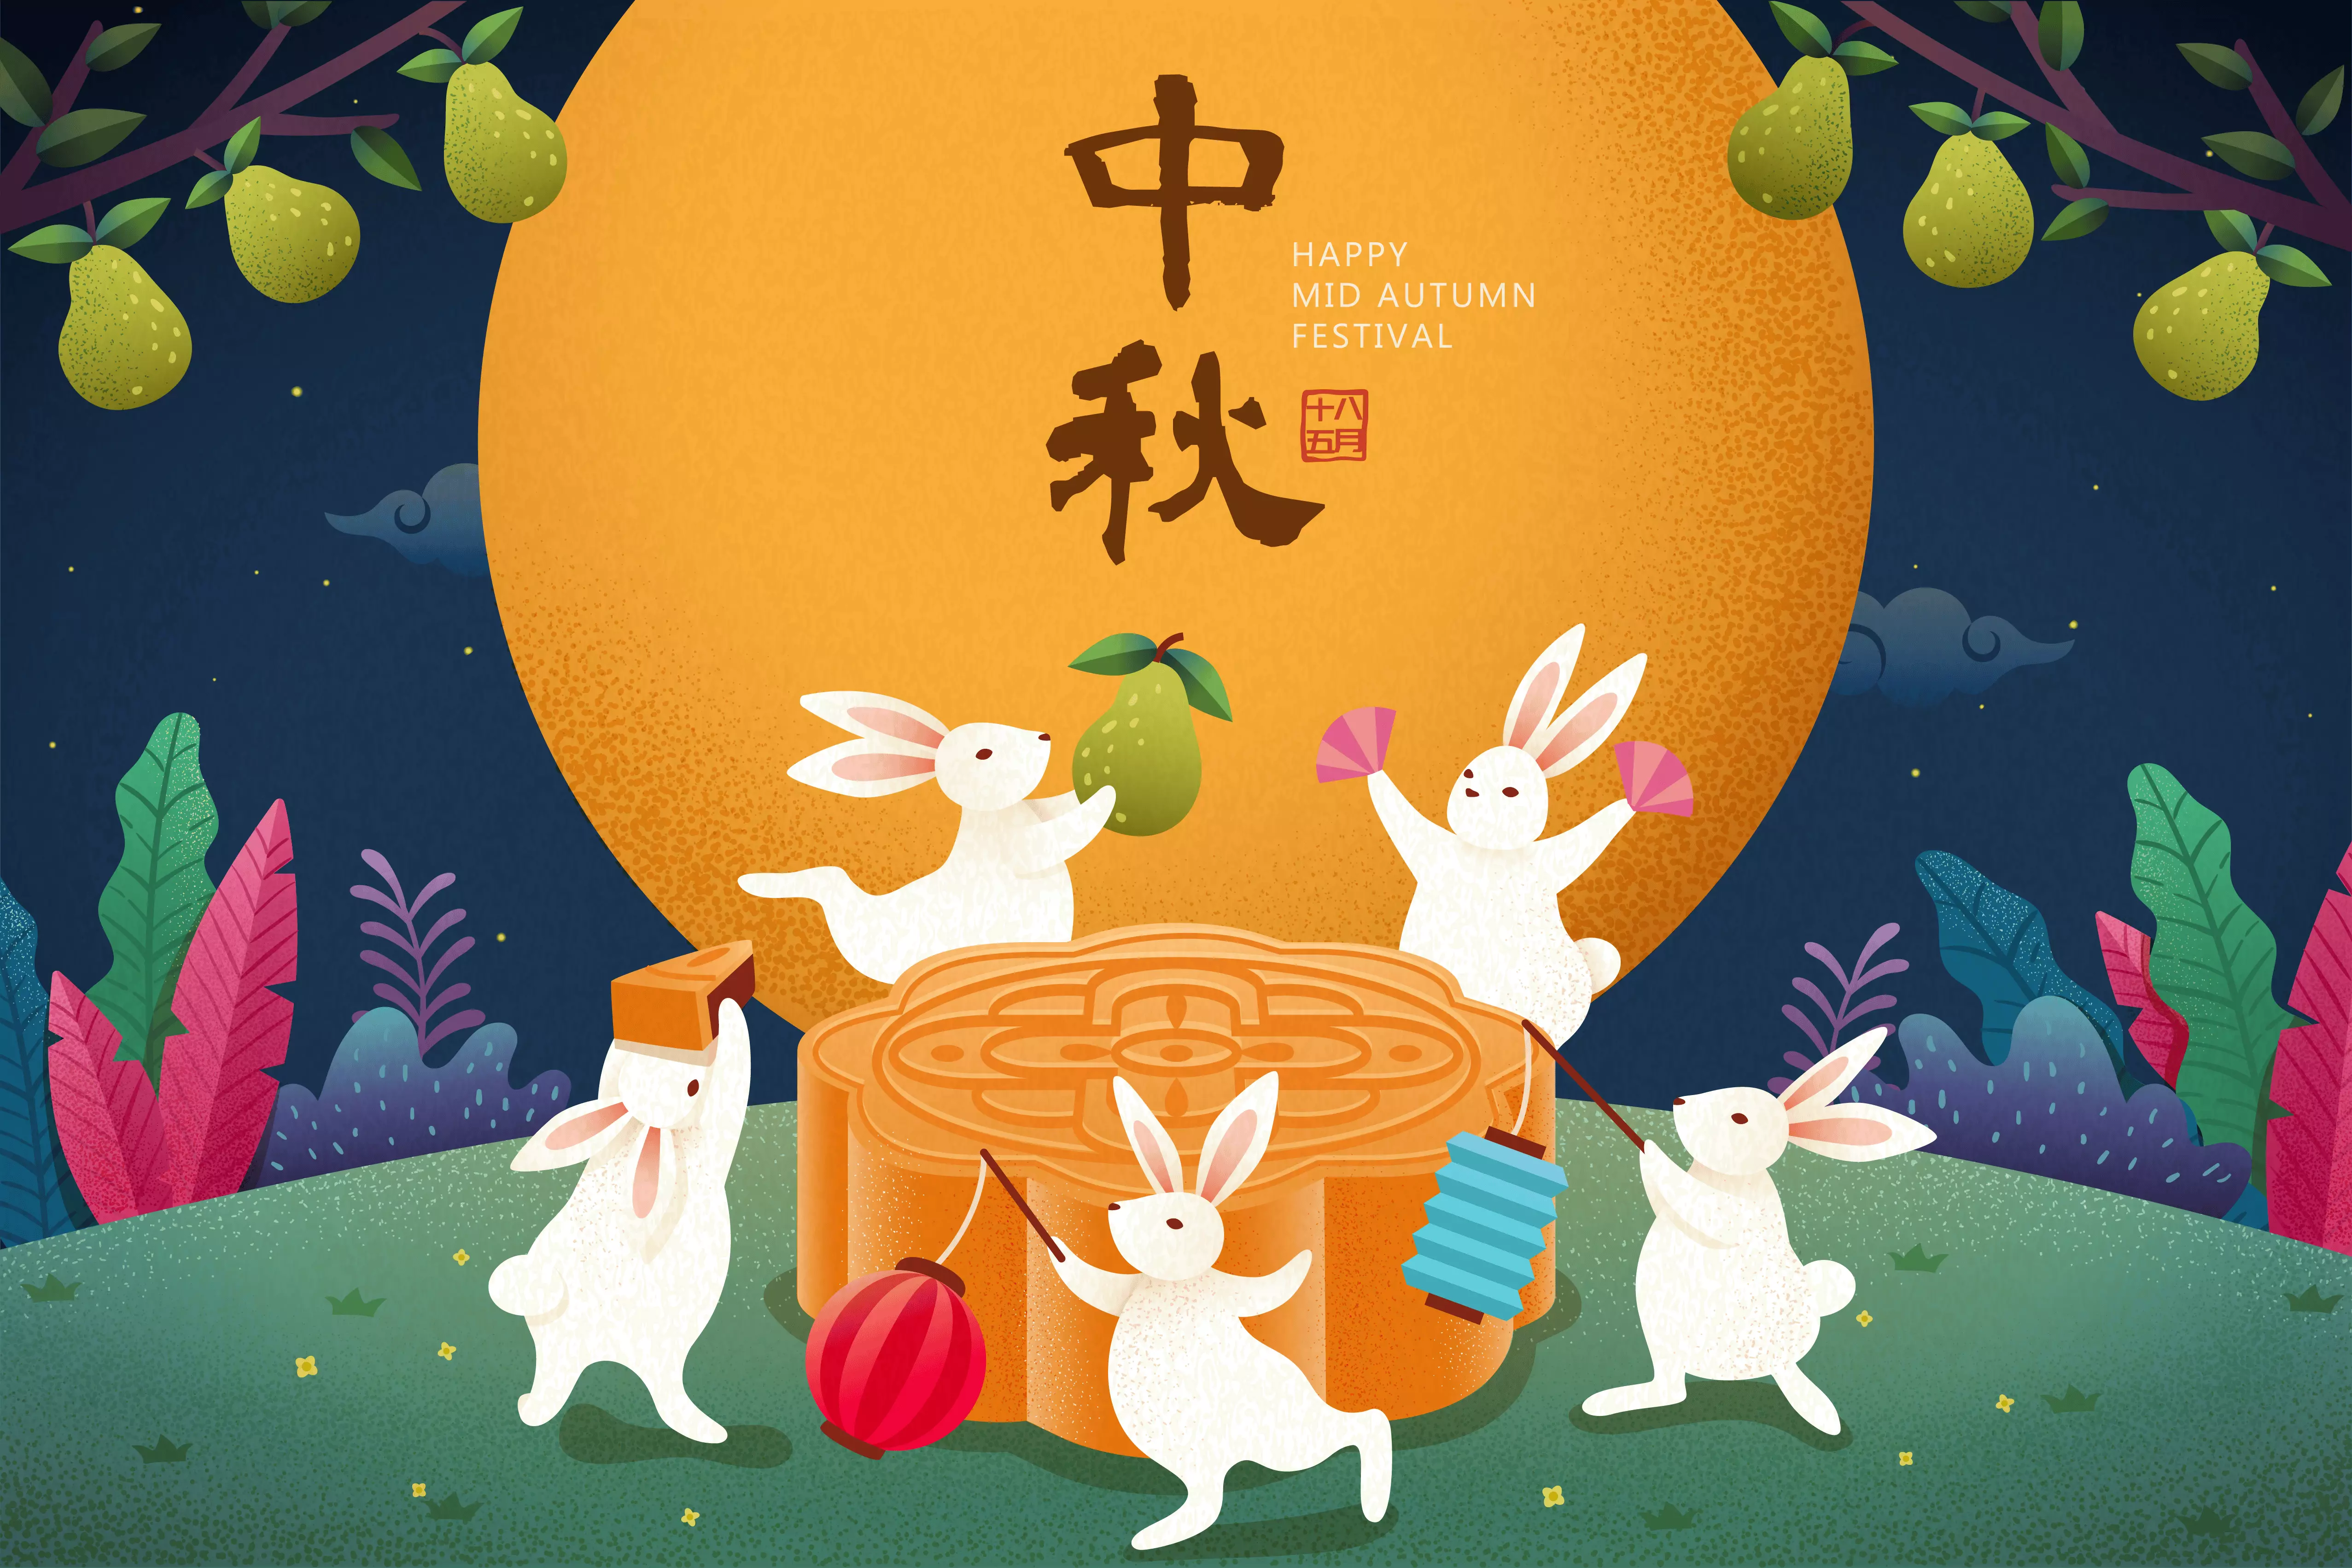 Por favor, escriba una publicación interesante para redes sociales basada en el contenido de la imagen. | Claro. Esta imagen está llena de una rica atmósfera del Festival del Medio Otoño, combinando hábilmente elementos clásicos y modernos. Basándome en los elementos principales de la imagen, he preparado varias publicaciones para redes sociales en diferentes estilos para que usted elija. Estilo poético y hermoso Esta noche, la luna brilla para todos, pero ¿quién sabe dónde caerán los pensamientos otoñales? Chang'e vuela hacia la luna y el Conejo de Jade prepara medicinas. El romance de los antiguos se ilumina esta noche. ¡Que esta luna brillante ilumine su camino a casa y lleve mis pensamientos más profundos! ¡Feliz Festival del Medio Otoño! Estilo de buenos deseos La luna está llena y las personas se reúnen. La noche del Medio Otoño es la más gentil. Observe los fuegos artificiales florecer, admire la luna llena en el cielo, dé un bocado a un pastel lunar y want buena salud. Que todo aquello que usted y yo want se haga true. ¡Feliz Festival del Medio Otoño a todos, y que sus familias sean felices! |
Reconocimiento de texto y extracción de información
Reconozca texto y fórmulas en imágenes, o extraiga información de recibos, certificados y formularios. Admite salida de texto formateado.
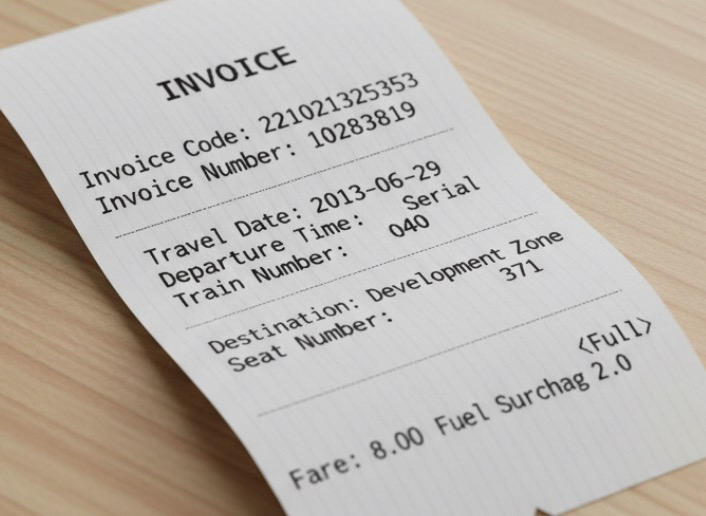 Extraiga lo siguiente de la imagen: ['Invoice Code', 'Invoice Number', 'Destination', 'Fuel Surcharge', 'Fare', 'Date', 'Departure Time', 'Train Number', 'Seat Number']. Por favor, genere la salida en formato JSON. | { "Invoice Code": "221021325353", "Invoice Number": "10283819", "Destination": "Development Zone", "Fuel Surcharge": "2.0", "Fare": "8.00<Full>", "Date": "2013-06-29", "Departure Time": "Rolling", "Train Number": "040", "Seat Number": "371" } |
Resolución de problemas multidisciplinarios
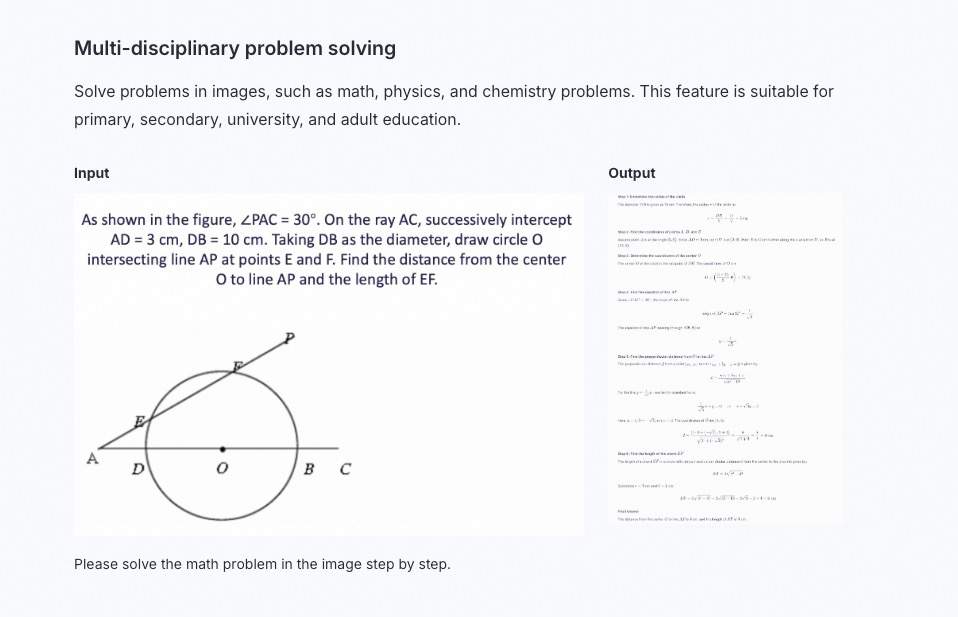
Resuelva problemas de matemáticas, física, química y otras materias en imágenes. Adecuado para educación K-12, universitaria y de adultos.
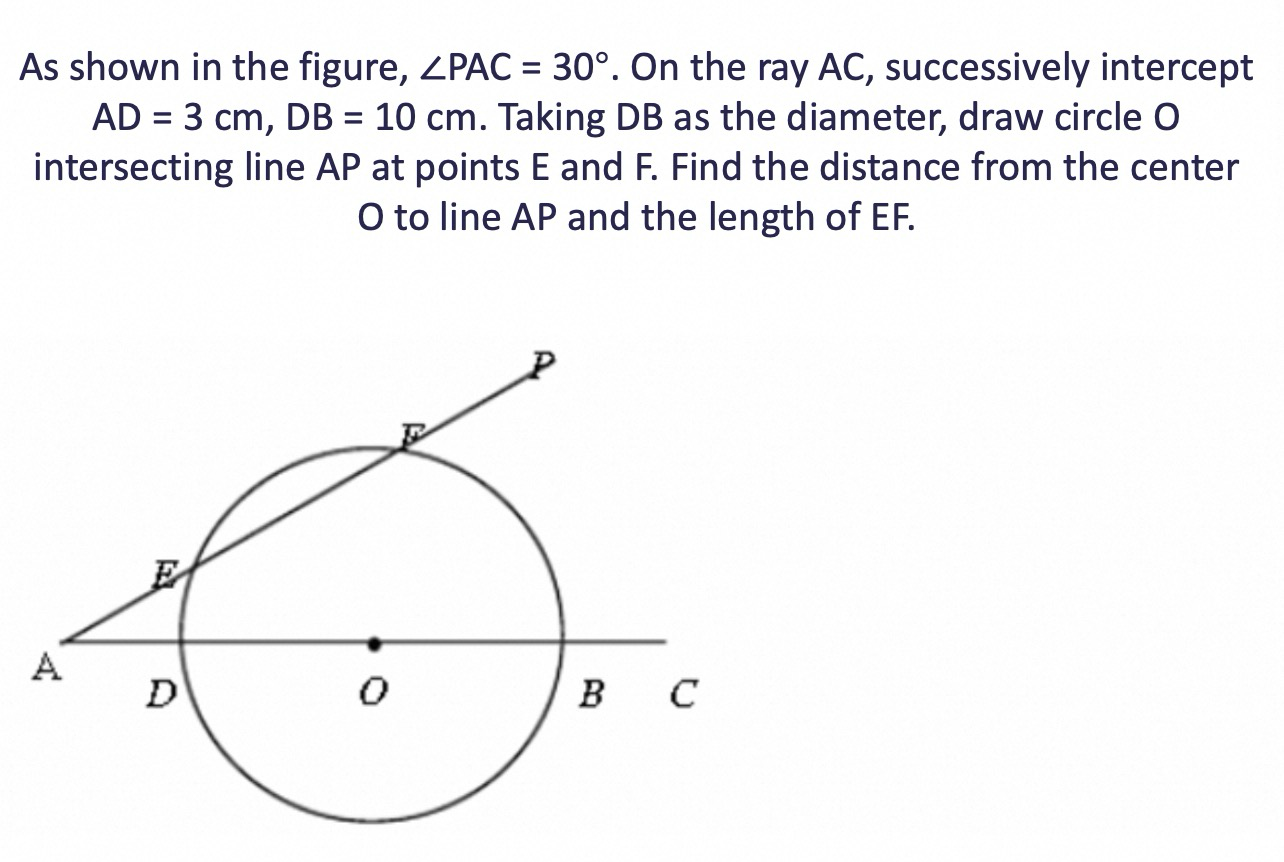 Resuelva el problema matemático del gráfico paso a paso. | 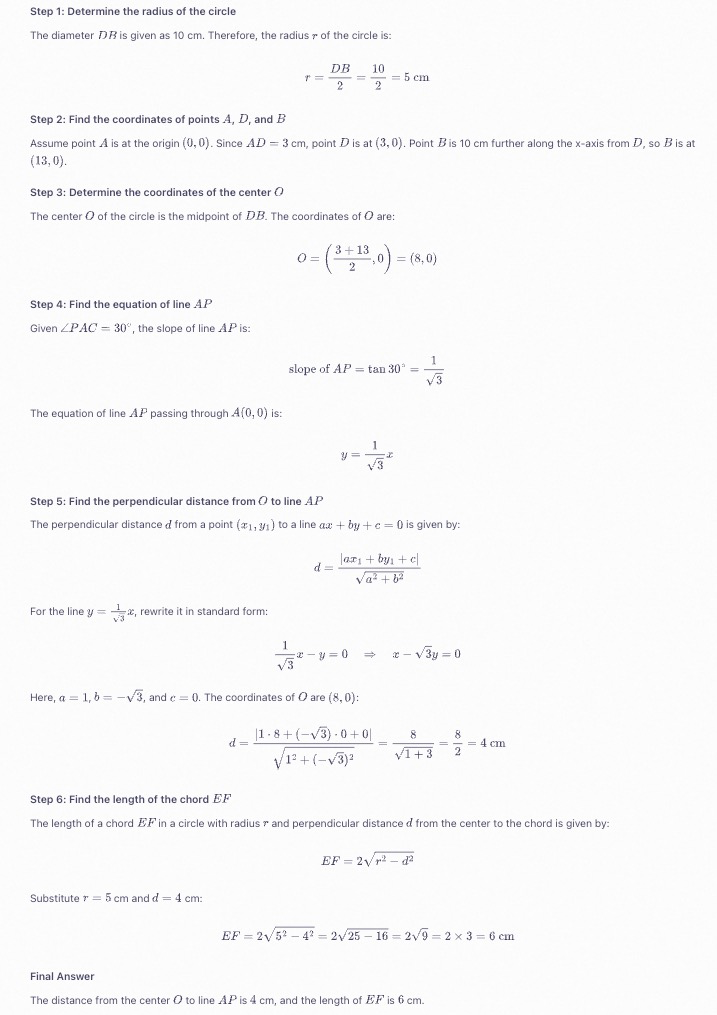 |
|---|
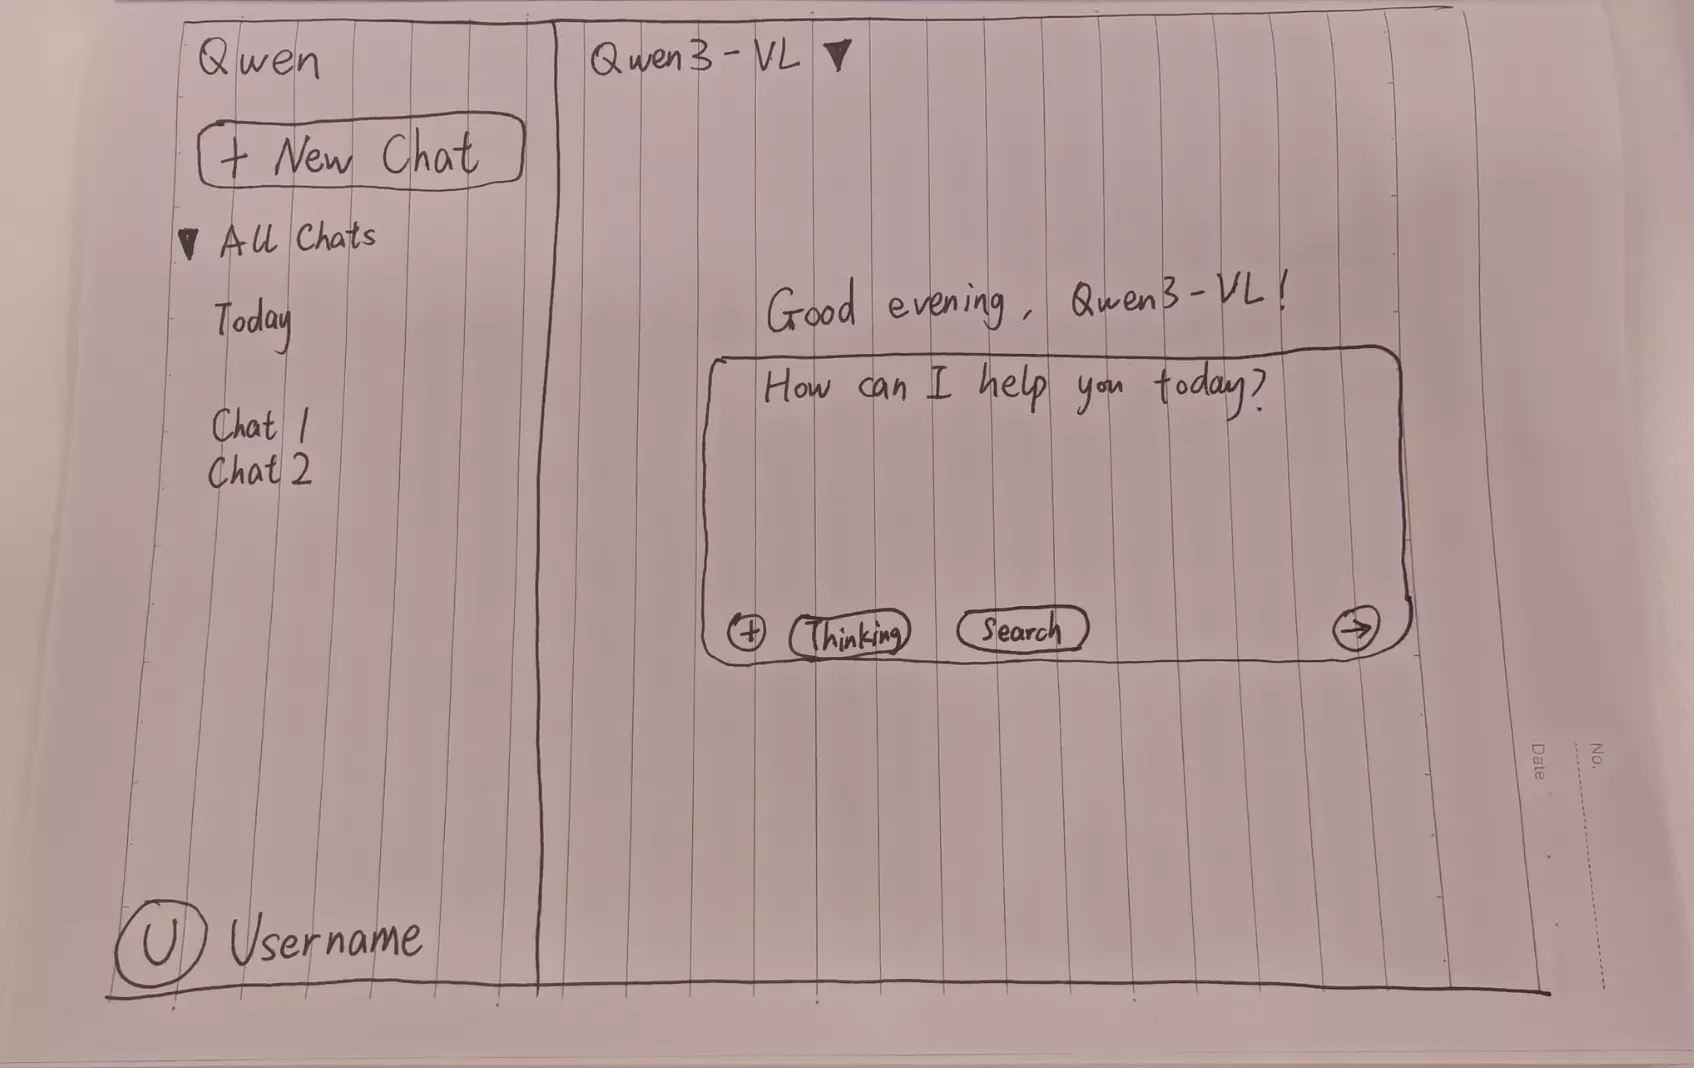
Programación visual
Genere código a partir de imágenes o videos. Puede utilizar esta función para generar código HTML, CSS y JS a partir de borradores de diseño, capturas de pantalla de sitios web y más.
Cree una página web usando HTML y CSS basada en mi boceto. El color principal debe ser negro. |
Vista previa de página web |
|---|

Localización de objetos
Admite localización 2D y 3D. Puede utilizar esta función para determinar la orientación del objeto, cambios de perspectiva y relaciones de oclusión. La localización 3D es una nueva capacidad añadida al modelo Qwen3-VL.
El rendimiento de localización de objetos del modelo Qwen2.5-VL es robusto dentro del rango de resolución de 480 × 480 a 2560 × 2560. Fuera de este rango, la precisión de detección puede disminuir, con deriva ocasional del cuadro de detección.
Para obtener información sobre cómo dibujar los resultados de localización en la imagen original, consulte FAQ.
Localización 2D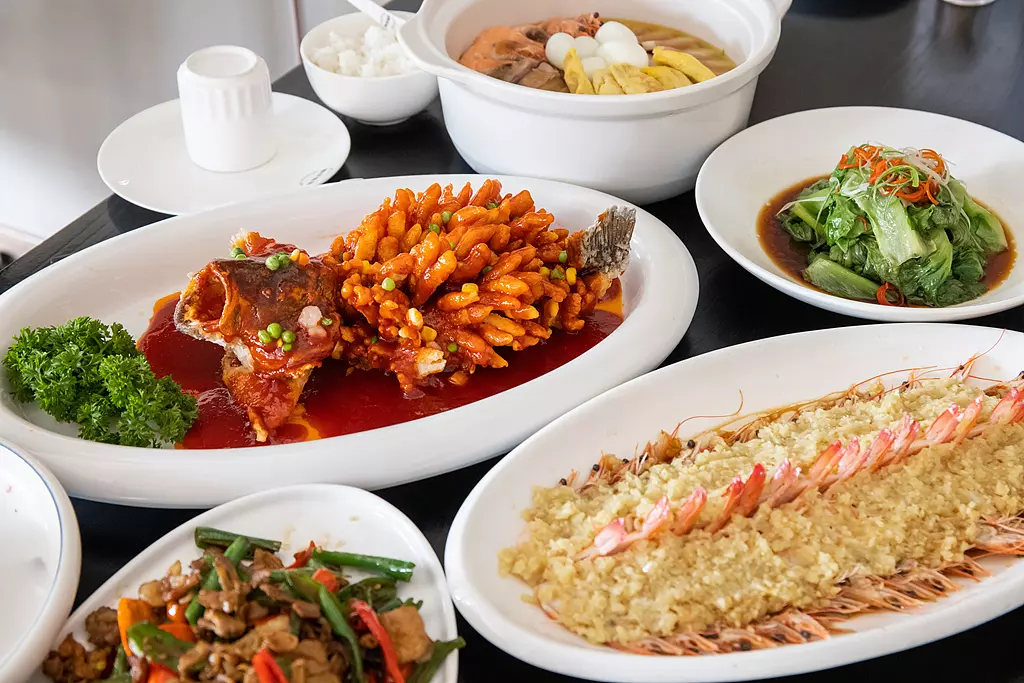
| Visualización de resultados de localización 2D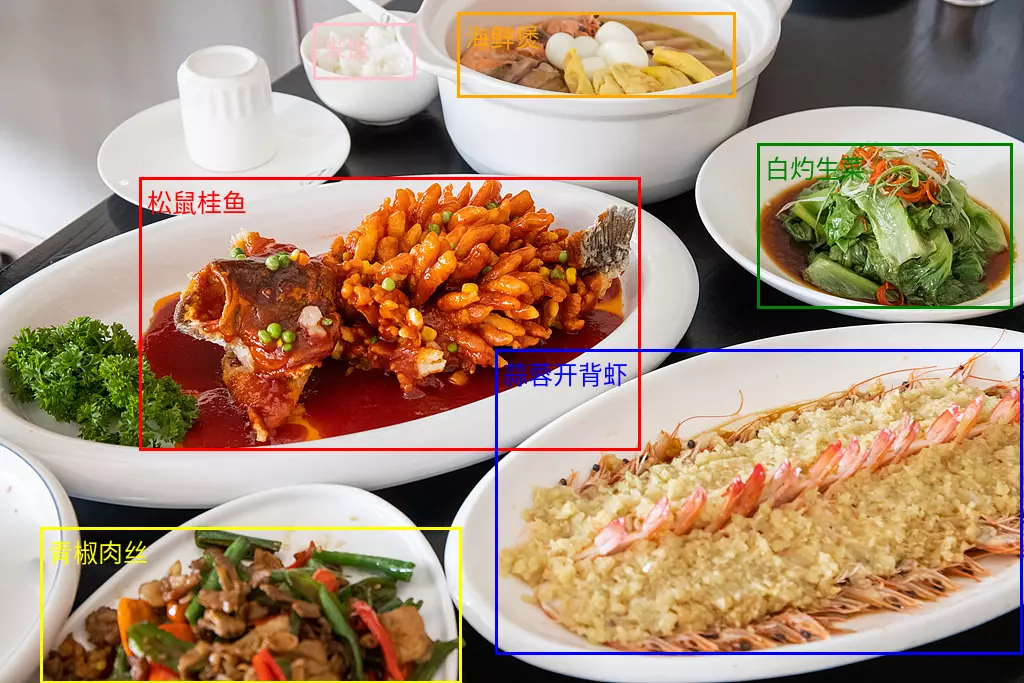 |
Localización 3D 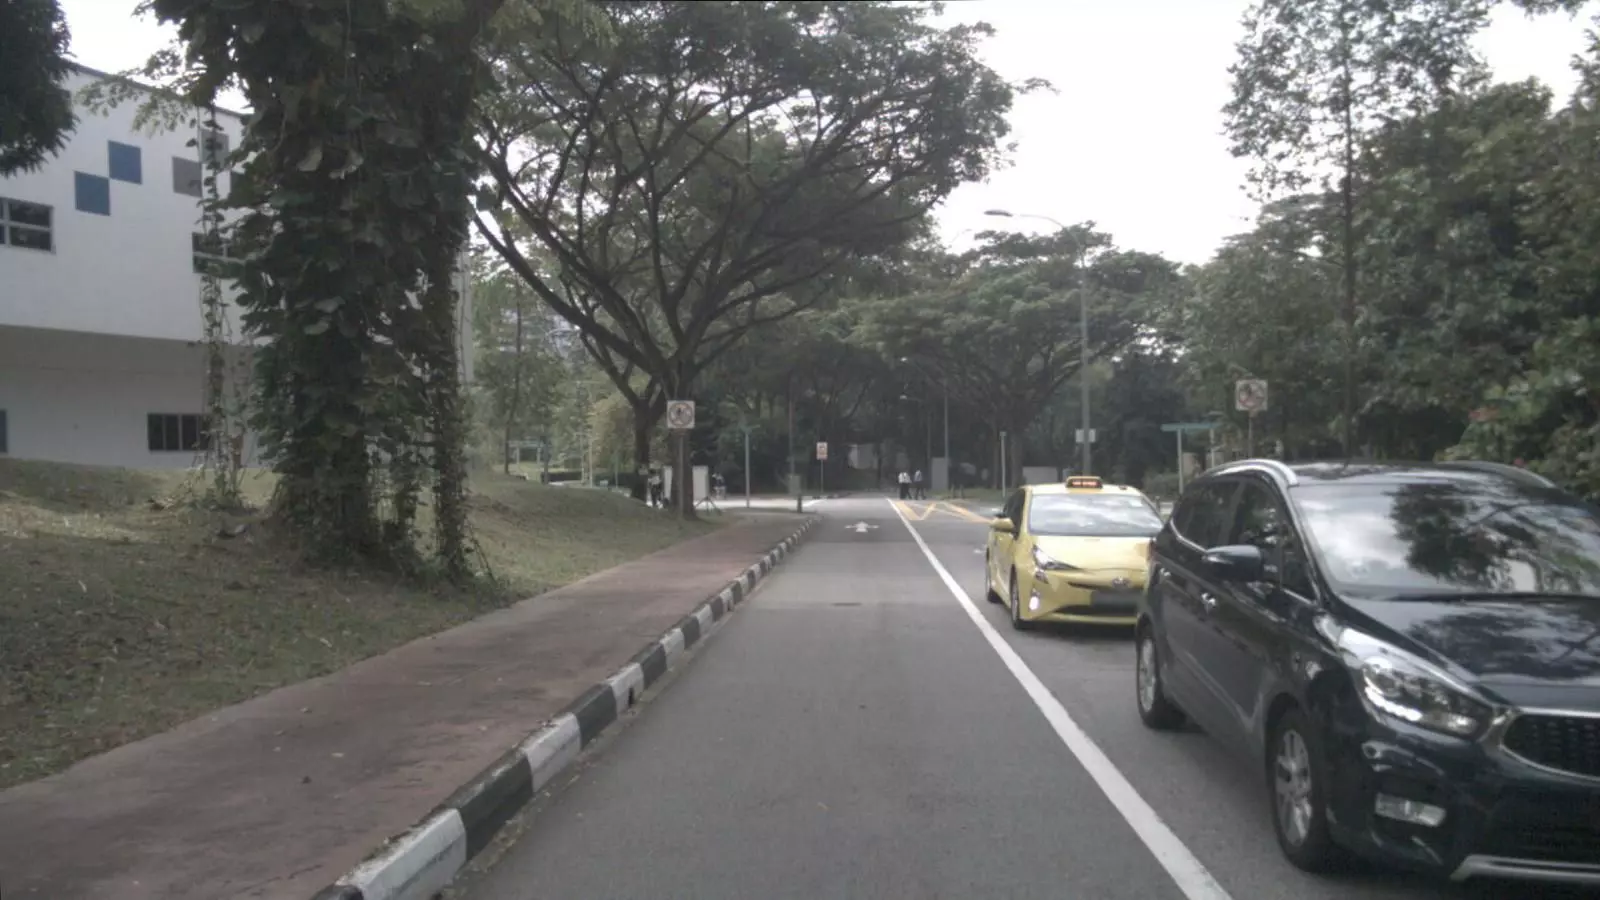 [{"bbox_3d": [x_center, y_center, z_center, x_size, y_size, z_size, roll, pitch, yaw], "label": "category"}]. |
Visualización de resultados de localización 3D 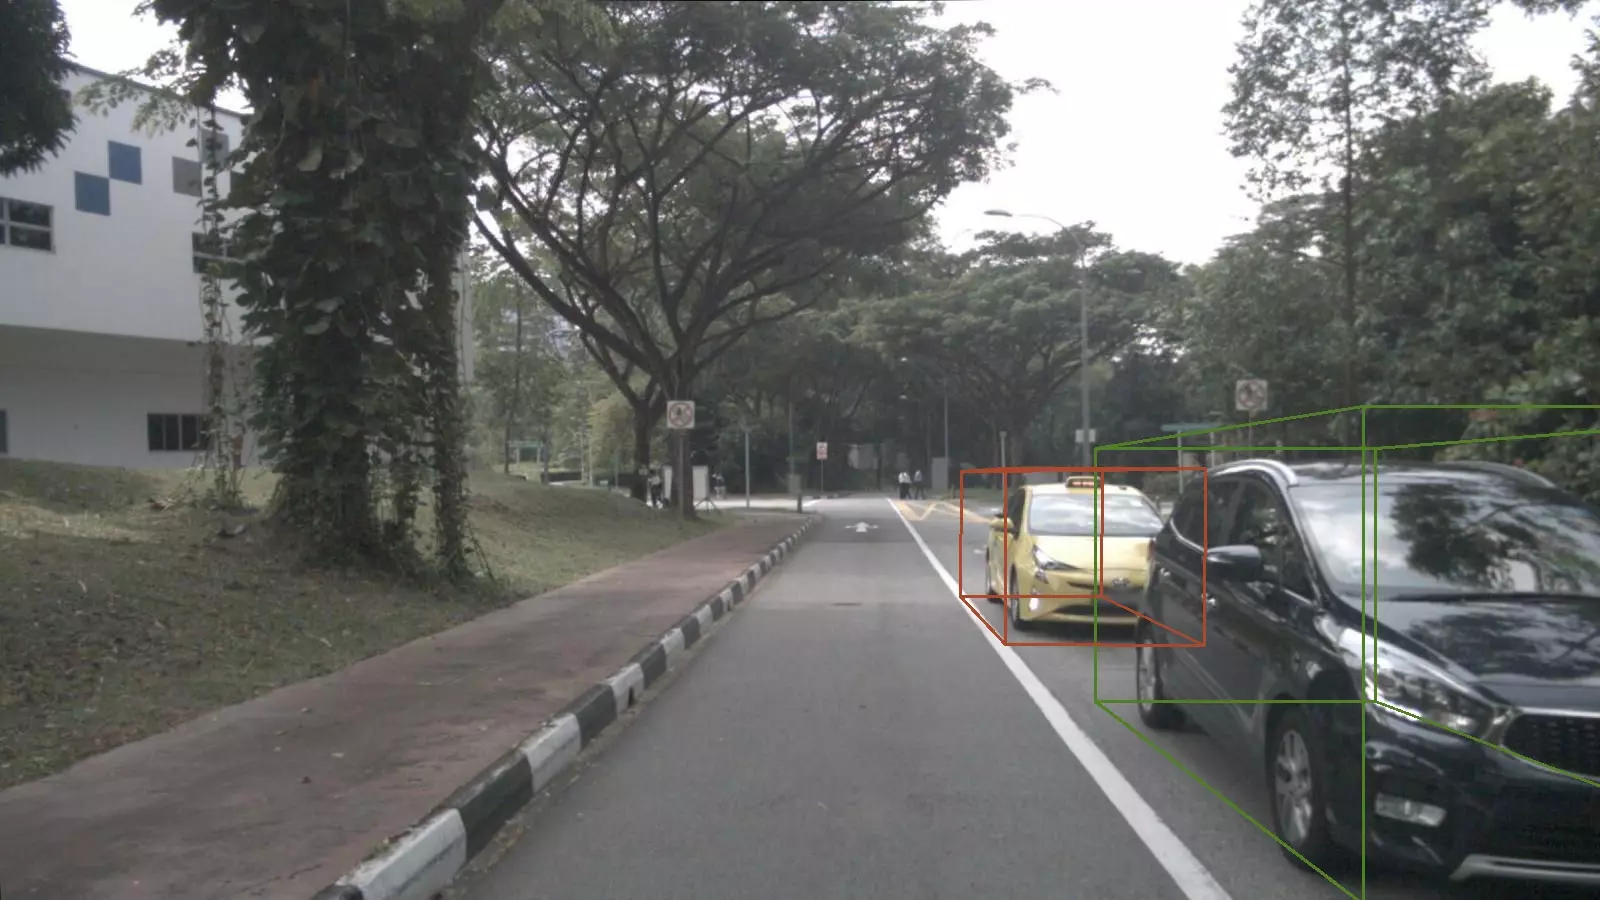 |
Análisis de documentos
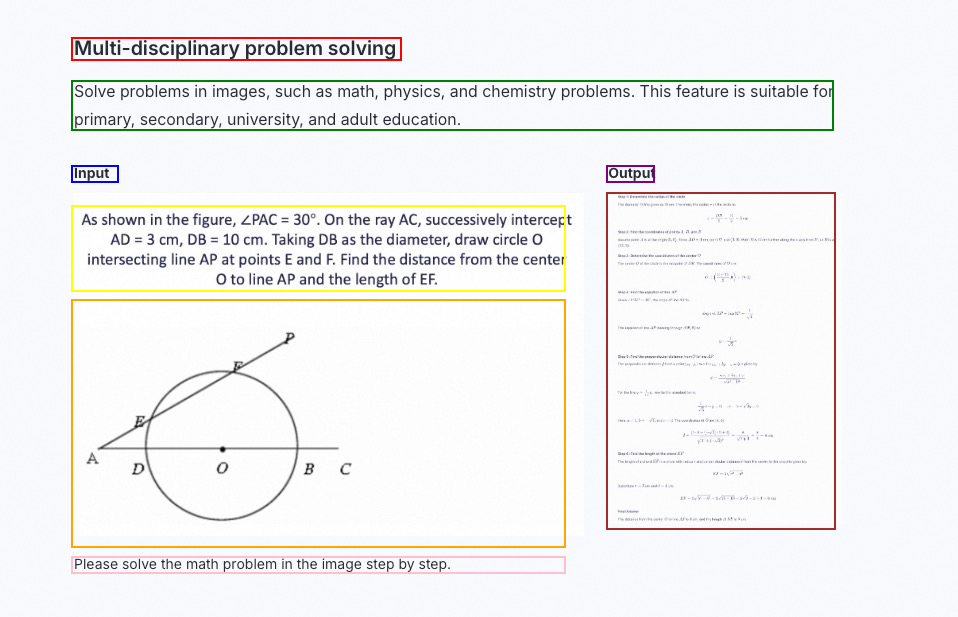
Analice documentos basados en imágenes (como copias escaneadas o PDFs de imágenes) para convertirlos al formato QwenVL HTML o QwenVL Markdown. Este formato no solo reconoce el texto con precisión, sino que también obtiene la información de posición de elementos como imágenes y tablas. El modelo Qwen3-VL añade la capacidad de analizar y convertir al formato Markdown.
Los prompts recomendados son los siguientes:qwenvl html(para analizar en formato HTML) oqwenvl markdown(para analizar en formato Markdown).
Markdown de qwenvl. |
Visualización de resultados |
|---|
Comprensión de video
Analice el contenido del video, como localizar eventos específicos y obtener marcas de tiempo, o generar resúmenes de períodos clave.
| Por favor, describa la serie de acciones de la persona en el video. Genere la hora de inicio (start_time), hora de fin (end_time) y evento (event) en formato JSON. Utilice HH:mm:ss para la marca de tiempo. | {"events": [{"start_time": "00:00:00","end_time": "00:00:05","event": "La persona camina hacia la mesa sosteniendo una caja de cartón y la coloca sobre la mesa."},{"start_time": "00:00:05","end_time": "00:00:15","event": "La persona toma un escáner y escanea la etiqueta de la caja de cartón."},{"start_time": "00:00:15","end_time": "00:00:21","event": "La persona vuelve a colocar el escáner en su lugar y luego toma un bolígrafo para registrar información en un cuaderno."}]} |
Características principales
Habilitar o deshabilitar el modo de pensamiento
-
Las series de modelos
qwen3.8,qwen3.7,qwen3.6,qwen3.5yqwen3-vl-plusson modelos de pensamiento híbrido. Pueden pensar antes de responder o responder directamente. Utilice el parámetroenable_thinkingpara controlar si se habilita el modo de pensamiento:true: Habilita el modo de pensamiento. El valor predeterminado para los modelos de las seriesqwen3.8,qwen3.7,qwen3.6yqwen3.5estrue.false: Desactiva el modo de pensamiento. El valor predeterminado para los modelos de la serieqwen3-vl-plusesfalse.
-
Los modelos con el sufijo
thinkingson modelos exclusivos de pensamiento. Siempre piensan antes de responder y esta función no se puede desactivar.
- Compatible con OpenAI
- DashScope
enable_thinking no es un parámetro estándar de OpenAI. Si utiliza el SDK de Python de OpenAI, páselo a través de extra_body.Entradas de múltiples imágenes
Los modelos de comprensión visual admiten pasar múltiples imágenes en una sola solicitud, lo cual puede utilizarse para tareas como comparación de productos y procesamiento de documentos de varias páginas. Para hacerlo, simplemente incluya múltiples objetos de imagen en el arreglo content del user message.
- Compatible con OpenAI
- DashScope
- Python
- Node.js
- curl
Respuesta
Comprensión de video
Los modelos de comprensión visual pueden entender el contenido de video proporcionado como una lista de imágenes (fotogramas de video) o como un archivo de video. Los siguientes ejemplos muestran cómo entender videos en línea o listas de imágenes especificadas mediante una URL. Para obtener más información sobre los límites de video o la cantidad de imágenes que se pueden pasar en una lista de imágenes, consulte Límites de video.
Para obtener un mejor rendimiento al comprender archivos de video, utilice las versiones más recientes o las versiones snapshot recientes de los modelos.
- Archivos de video
- Lista de imágenes
-
fps: Controla la frecuencia de extracción de fotogramas. Se extrae un fotograma cada 1/fps segundos. El rango de valores es [0.1, 10], y el valor predeterminado es 2.0.
- Para escenas con movimiento rápido, establezca un valor de fps más alto para capturar más detalles.
- Para escenas estáticas o videos largos, establezca un valor de fps más bajo para mejorar el rendimiento.
- max_frames: El número máximo de fotogramas a extraer de un video. El sistema calcula el total de fotogramas basándose en los fps del video. Si el número total de fotogramas supera este límite, el sistema muestrea automáticamente los fotogramas de manera uniforme para cumplir con el límite. Este parámetro solo está disponible al utilizar el SDK de DashScope.
- Compatible con OpenAI
- DashScope
Cuando envía un archivo de video directamente al modelo de comprensión visual utilizando el SDK de OpenAI o HTTP, establezca el parámetro"type"en el mensaje del usuario en"video_url".
Pasar un archivo local (codificación Base64 o ruta de archivo)
Los modelos de comprensión visual admiten dos métodos para cargar archivos locales: codificación Base64 y carga directa mediante ruta de archivo. Puede elegir un método de carga según el tamaño del archivo y el tipo de SDK. Para recomendaciones, consulte Cómo elegir un método de carga de archivos. Ambos métodos deben cumplir con los requisitos de archivo descritos en Limitaciones de imágenes.
- Subir mediante codificación Base64
- Subir mediante ruta de archivo
Pasos para pasar una cadena codificada en Base64 (ejemplo de imagen)
Pasos para pasar una cadena codificada en Base64 (ejemplo de imagen)
-
Codificar el archivo: Convierta la imagen local a una codificación Base64.
Código de ejemplo para convertir una imagen a codificación Base64
-
Construya una Data URL con el siguiente formato:
data:[MIME_type];base64,{base64_image}.- Reemplace
MIME_typecon el tipo de medio real. Asegúrese de que coincida con el valorMIME Typeen la tabla Formatos de imagen admitidos, comoimage/jpegoimage/png. base64_imagees la cadena Base64 generada en el paso anterior.
- Reemplace
-
Llamar al modelo: Pase la
Data URLutilizando el parámetroimageoimage_url.
- Imagen
- Archivo de video
- Lista de imágenes
- Pasar mediante ruta de archivo
- Entrada codificada en Base64
Procesar imágenes de alta resolución
La API del modelo de comprensión visual tiene un límite en la cantidad de tokens visuales para una sola imagen codificada. Con las configuraciones predeterminadas, las imágenes de alta resolución se comprimen, lo que puede causar pérdida de detalles y afectar la precisión de la comprensión. Habilite vl_high_resolution_images o ajuste max_pixels para aumentar la cantidad de tokens visuales. Esto conserva más detalles de la imagen y mejora la comprensión.
Ver los píxeles por token visual, el límite de tokens y el límite de píxeles para cada modelo
Ver los píxeles por token visual, el límite de tokens y el límite de píxeles para cada modelo
Si el recuento de píxeles de la imagen de entrada supera el límite de píxeles del modelo, la imagen se reduce para ajustarse al límite.
Modelo | Píxeles por token | vl_high_resolution_images | max_pixels | Límite de tokens | Límite de píxeles |
Modelos de las series |
|
|
|
|
|
| Personalizable. El valor predeterminado es | Determinado por |
| ||
Modelos de las series de código abierto |
|
|
|
|
|
| Personalizable. El valor predeterminado es | Determinado por |
|
-
Cuando
vl_high_resolution_images=true, la API utiliza una política de resolución fija e ignora la configuración demax_pixels. Esto es adecuado para reconocer texto fino, objetos pequeños o detalles ricos en imágenes. -
Cuando
vl_high_resolution_images=false, el límite final de píxeles depende del valor del parámetromax_pixels.- Para escenarios sensibles a costos donde usted want reducir el consumo de tokens visuales: Utilice el valor predeterminado de
max_pixelso establézcalo en un valor menor. - Si usted want centrarse en ciertos detalles y puede aceptar una velocidad de procesamiento menor, aumente el valor de
max_pixelssegún sea necesario.
- Para escenarios sensibles a costos donde usted want reducir el consumo de tokens visuales: Utilice el valor predeterminado de
- Compatible con OpenAI
- DashScope
vl_high_resolution_images no es un parámetro estándar de OpenAI. El método para pasarlo varía según los diferentes SDKs de lenguaje:- Python SDK: Debe pasarse a través del diccionario
extra_body. - Node.js SDK: Se puede pasar directamente como un parámetro de nivel superior.
Más usos
Límites
Límites de archivos de entrada
- Límites de imagen
- Límites de video
-
Resolución de imagen:
-
Tamaño mínimo: Tanto el ancho como el alto de la imagen deben ser mayores que
10píxeles. -
Relación de aspecto: La relación entre el lado largo y el lado corto tanto para las imágenes originales como para las escaladas no debe exceder
200:1.Para obtener información sobre la lógica de escalado de imágenes, consulte la función
smart_resizeen Calcular tokens de imagen -
Píxeles máximos:
- Mantenga la resolución de la imagen dentro de
8K (7680x4320). Las imágenes con una resolución mayor pueden causar tiempos de espera en las llamadas API debido a tamaños de archivo grandes y tiempos prolongados de transmisión de red. - Escalado automático: El modelo puede ajustar el tamaño de la imagen mediante
max_pixelsymin_pixels. Proporcionar imágenes de alta resolución no mejora la precisión de la detección; por el contrario, aumenta el riesgo de fallos en las llamadas. Escale las imágenes a un tamaño razonable en el cliente antes de cargarlas.
- Mantenga la resolución de la imagen dentro de
-
Tamaño mínimo: Tanto el ancho como el alto de la imagen deben ser mayores que
-
Formatos de imagen compatibles
-
Para resoluciones inferiores a 4K
(3840x2160), se admiten los siguientes formatos de imagen:Formato de imagen
Extensiones comunes
Tipo MIME
BMP
.bmp
image/bmp
JPEG
.jpe, .jpeg, .jpg
image/jpeg
PNG
.png
image/png
TIFF
.tif, .tiff
image/tiff
WEBP
.webp
image/webp
HEIC
.heic
image/heic
-
Para resoluciones entre
4K (3840x2160)y8K (7680x4320), solo se admiten los formatos JPEG, JPG y PNG.
-
Para resoluciones inferiores a 4K
-
Tamaño de imagen:
El cuerpo total de la solicitud para todas las interfaces no debe exceder
64 MB; al pasar múltiples imágenes, estas comparten esta cuota global del cuerpo de la solicitud. Los dominios de DashScope limitan el cuerpo de la solicitud a 16 MiB; utilice en su lugar el dominio del espacio de trabajo{WorkspaceId}.{region}.maas.aliyuncs.com.- Cuando se pasa como URL pública: Una sola imagen no puede exceder
20 MBpara los modelos de las series Qwen3.8, Qwen3.7, Qwen3.6, Qwen3.5 y Qwen3-VL. Para otros modelos, una sola imagen no puede exceder10 MB. - Cuando se pasa como una ruta local: Una sola imagen no puede exceder
10 MB. - Cuando se pasa como codificación Base64: Para las series de modelos Qwen3.8, Qwen3.7, Qwen3.6, Qwen3.5 y Qwen3-VL, el archivo de imagen original antes de la codificación no puede exceder
20 MB. Para otros modelos, no puede exceder10 MB. La cadena Data URI resultante no puede exceder20 MBen la API compatible con OpenAI y DashScope, o32 MBen la API compatible con Anthropic.
Para comprimir un archivo, consulte Cómo comprimir una imagen o video al tamaño requerido.
- Cuando se pasa como URL pública: Una sola imagen no puede exceder
-
Límite de cantidad de imágenes: El número máximo de imágenes admitido para la entrada de múltiples imágenes varía según el método de entrada:
-
Cuando se pasan como URLs públicas o rutas locales:
- Series Qwen3.8-Max, Qwen3.8-Flash, Qwen3.7-Plus: Hasta 2,048 imágenes
- Qwen3.7-Flash, Qwen3.6-Plus, Qwen3.6-Flash, Qwen3.5-Plus, Qwen3.5-Flash, Qwen3-VL, Qwen-VL, serie QVQ: Hasta 256 imágenes
- Para la serie Qwen-Omni, consulte Omni-modal.
- Cuando se pasan como cadenas codificadas en Base64: Hasta 250 imágenes
-
Cuando se pasan como URLs públicas o rutas locales:
El número total de tokens para todas las imágenes también está limitado por el límite máximo de tokens de entrada del modelo. El recuento total de tokens para todas las imágenes y texto no debe exceder la entrada máxima del modelo.
Métodos de entrada de archivos
-
URL pública: Proporcione una dirección de archivo accesible públicamente que admita el protocolo HTTP o HTTPS. Para una estabilidad y un rendimiento óptimos, suba el archivo a OSS para obtener una URL pública. Model Studio no puede acceder a los endpoints internos de OSS, cuyas direcciones contienen
-internal, comohttps://<bucket>.oss-cn-hangzhou-internal.aliyuncs.com/image.jpg. Si pasa una dirección interna, la descarga del archivo fallará y se devolveráInvalidParametercon el mensajeFailed to download multimodal content. Utilice en su lugar un endpoint público de OSS, comohttps://<bucket>.oss-cn-hangzhou.aliyuncs.com/image.jpg, o una URL de OSS prefirmada. - Codificación Base64: Convierta el archivo a una cadena codificada en Base64 y luego pásela.
- Ruta de archivo local (solo DashScope SDK): Pase la ruta de un archivo local.
Para recomendaciones sobre cómo elegir un método de entrada de archivos, consulte ¿Cómo elijo un método de carga de archivos?
Uso en un entorno de producción
- Preprocesamiento de imágenes y videos: Los modelos de comprensión visual tienen límites de tamaño para los archivos de entrada. Para comprimir archivos, consulte Métodos de compresión de imágenes o videos.
-
Procesamiento de archivos de texto: Los modelos de comprensión visual solo admiten archivos de imagen y video. No admiten el procesamiento de archivos TXT, Word (.doc/.docx), PDF u otros archivos basados en texto. Utilice una de las siguientes soluciones alternativas:
- Convierta el archivo de texto a un formato de imagen. Utilice una biblioteca de procesamiento de imágenes, como pdf2image para Python, para convertir el archivo página por página en múltiples imágenes de alta calidad. Luego, pase las imágenes al modelo utilizando el método de entrada de múltiples imágenes.
- Utilice Qwen-Long, que admite cargar documentos y realizar conversaciones pasando información a través de
file-id.
-
Tolerancia a fallos y estabilidad
- Manejo de tiempos de espera: En llamadas sin streaming, ocurre un error de tiempo de espera si el modelo no termina de generar la salida dentro de 300 segundos. Cuando ocurre un tiempo de espera, el contenido generado se devuelve en el cuerpo de la respuesta. Un encabezado de respuesta que contiene
x-dashscope-partialresponse: trueindica que la respuesta agotó el tiempo de espera. Utilice la función de modo parcial, que es compatible con algunos modelos. Agregue el contenido generado al arreglomessagesy envíe la solicitud nuevamente. Esto permite que el Modelo de Lenguaje Grande (LLM) continúe generando contenido. Para obtener más información, consulte Continuar la generación a partir de una salida incompleta. - Configuración de tiempo de espera del lado del cliente: El tiempo de espera mencionado anteriormente es un tiempo de espera del lado del servidor que ocurre cuando el modelo no termina de generar la salida dentro de 300 segundos. Es diferente del tiempo de espera predeterminado del lado del cliente del SDK. Cuando procesa imágenes grandes, como una imagen de 4000 x 4000 píxeles, una solicitud puede tardar más que el tiempo de espera predeterminado del lado del cliente del SDK e interrumpirse con un
APITimeoutError, incluso si no se ha alcanzado el límite de 300 segundos del lado del servidor. Para evitar esto, utilicewith_optionsen el SDK de Python de OpenAI para extender el tiempo de espera del lado del cliente:
- Manejo de tiempos de espera: En llamadas sin streaming, ocurre un error de tiempo de espera si el modelo no termina de generar la salida dentro de 300 segundos. Cuando ocurre un tiempo de espera, el contenido generado se devuelve en el cuerpo de la respuesta. Un encabezado de respuesta que contiene
- Salida en streaming: Configure
stream=Truepara que el modelo devuelva el contenido de forma incremental en lugar de esperar una única respuesta completa. Esto evita los tiempos de espera del lado del cliente causados por llamadas sin streaming de larga duración cuando procesa imágenes grandes:
- Mecanismo de reintento: Diseñe una lógica de reintento de llamadas API razonable, como retroceso exponencial, para manejar fluctuaciones de red o indisponibilidad temporal del servicio.
Facturación y limitación de tasa
-
Facturación:El costo total se calcula en función del número total de tokens de entrada y salida. Los precios de entrada y salida están disponibles en la consola de Model Studio.
- Composición de tokens: Los tokens de entrada consisten en tokens de texto y tokens convertidos desde imágenes o videos. Los tokens de salida son el texto generado por el modelo. En el modo de pensamiento, el proceso de razonamiento del modelo también se cuenta como tokens de salida. Si el proceso de pensamiento no se genera en el modo de pensamiento, la facturación sigue los precios del modo sin pensamiento.
-
Calcular tokens para imágenes y videos:Utilice el siguiente código para calcular el consumo de tokens para imágenes o videos. El resultado estimado es solo para referencia. El uso real se basa en la respuesta de la API.
Calcular tokens para imágenes y videos
- Imágenes
- Videos
Fórmula:Image Tokens = h_bar * w_bar / token_pixels + 2-
h_bar, w_bar: La altura y el ancho de la imagen escalada. Antes de procesar una imagen, el modelo realiza un preprocesamiento para reducirla a un límite de píxeles específico. Este límite depende de los valores de los parámetrosmax_pixelsyvl_high_resolution_images. Para obtener más información, consulte Procesar imágenes de alta resolución. -
token_pixels: El valor de píxel correspondiente a cadatokenvisual. Esto varía según el modelo:qwen3.8-series,qwen3.7-series,qwen3.6-series,qwen3.5-series,Qwen3-VL:Cadatokencorresponde a32x32píxeles.QVQy otros modelosQwen2.5-VL:Cada token corresponde a28x28píxeles.
- Ver facturas:Vea facturas o recargue su cuenta en la página Gastos y Costos en la Consola de Administración de Alibaba Cloud.
- Limitación de tasa:Para más información sobre las condiciones de limitación de tasa para modelos de comprensión visual, consulte Limitación de tasa.
- Cuota gratuita (solo región de Singapur): Se proporciona una cuota gratuita de 1 millón de tokens para los modelos de comprensión visual. El periodo de validez de 90 días comienza a partir de la fecha en que usted habilita Model Studio o se aprueba su solicitud de modelo.
Referencia de API
Para más información sobre los parámetros de entrada y salida del modelo de comprensión visual, consulte generación de texto.
FAQ
¿Cómo elijo un método de subida de archivos?
¿Cómo elijo un método de subida de archivos?
Tipo de archivo | Especificaciones de archivo | DashScope SDK (Python, Java) | Compatible con OpenAI / HTTP de DashScope |
|---|---|---|---|
Imagen | Mayor que 7 MB y menor que 10 MB | Pasar la ruta local | Solo se admiten URLs de red pública. Utilice Alibaba Cloud Object Storage Service |
Menos de 7 MB | Pasar la ruta local | Codificación Base64 | |
Video | Mayor que 100 MB | Solo se admiten URLs de red pública. Utilice Alibaba Cloud Object Storage Service | Solo se admiten URLs de red pública. Utilice Alibaba Cloud Object Storage Service |
Mayor que 7 MB y menor que 100 MB | Pasar la ruta local | Solo se admiten URLs de red pública. Utilice Alibaba Cloud Object Storage Service | |
Menos de 7 MB | Pasar la ruta local | Codificación Base64 |
La codificación Base64 aumenta el tamaño de los datos. El tamaño del archivo original debe ser menor que 7 MB.
Utilice Base64 o una ruta local para evitar tiempos de espera de descarga en el servidor y mejorar la estabilidad.
¿Cómo comprimo una imagen o video al tamaño requerido?
¿Cómo comprimo una imagen o video al tamaño requerido?
Métodos de compresión de imágenes
Métodos de compresión de imágenes
- Herramientas en línea: Utilice herramientas en línea como CompressJPEG para comprimir imágenes.
- Software local: Utilice software como Photoshop para ajustar la calidad al exportar.
- Implementación de código:
Métodos de compresión de videos
Métodos de compresión de videos
- Herramientas en línea: Utilice herramientas en línea como FreeConvert para comprimir videos.
- Software local: Utilice software como HandBrake.
- Implementación de código: Utilice la herramienta FFmpeg. Para más información, consulte el sitio web oficial de FFmpeg.
Después de que el modelo genera resultados de ubicación de objetos, ¿cómo dibujo cuadros de detección en la imagen original?
Después de que el modelo genera resultados de ubicación de objetos, ¿cómo dibujo cuadros de detección en la imagen original?
- Qwen2.5-VL: Las coordenadas devueltas son valores absolutos en píxeles, relativos a la esquina superior izquierda de la imagen escalada. Para dibujar marcos de detección, consulte el código en qwen2_5_vl_2d.py.
- Las series Qwen3-VL, Qwen3.5, Qwen3.6 y Qwen3.7 (como qwen3.5-plus, qwen3.6-plus y qwen3.7-plus): Las coordenadas devueltas son relativas y están normalizadas en el rango
[0, 999]. Para dibujar marcos de detección, consulte el código en qwen3_vl_2d.py (posicionamiento 2D) o qwen3_vl_3d.zip (posicionamiento 3D).