

Este tutorial utiliza Android para mostrar cómo integrar el SDK del cliente AOQ con qwen3.8-livetranslate-flash-realtime para la traducción de voz en tiempo real. Otras plataformas utilizan flujos de integración y manejo de eventos del modelo similares con sus métodos correspondientes del SDK. Todos los ejemplos del lado cliente que se muestran a continuación usan Java.
Para conocer las capacidades del modelo, consulte Traducción de voz y de audio y video en tiempo real. Para conocer las funciones de los medios y los eventos del modelo, consulte Conexión mediante AOQ.
Descargar el SDK
Para obtener el SDK del cliente AOQ y el complemento de audio Opus, consulte Descarga del SDK. Los ejemplos de transmisión de audio en este tutorial utilizan Opus, por lo que también debe importar el complemento para su plataforma. Para conocer las regiones compatibles, idiomas, precios y límites de tasa, consulte Traducción de voz y audio/video en tiempo real.
Importar el SDK
- Android
- iOS
- HarmonyOS
Coloque Si el proyecto principal ya contiene bibliotecas nativas con los mismos nombres, verifique sus versiones y dependencias antes de empaquetarlas para evitar incluir diferentes versiones de la misma biblioteca.Declare los permisos en Solicite el permiso
AoqClientSdk-release.aar en app/libs/. Coloque libPluginOpus.so en app/libs/armeabi-v7a/ y app/libs/arm64-v8a/, según el ABI.Declare la dependencia en app/build.gradle:AndroidManifest.xml:RECORD_AUDIO en tiempo de ejecución y obtenga la autorización del usuario. La traducción únicamente de voz no requiere permiso de cámara. Declare y solicite CAMERA solo cuando habilite la mejora visual.Los ejemplos en Java utilizan las siguientes importaciones:Obtener un token a través de su AppServer
No almacene la clave API de Model Studio en el cliente. Su AppServer utiliza la clave API para la región y área de trabajo correspondiente para solicitar credenciales temporales para cada conexión de traducción. Devuelve las credenciales mediante HTTPS a un cliente que haya pasado la autenticación de su aplicación.
Configure un AppServer según los Pasos de autenticación de AOQ para Qwen-LiveTranslate-Realtime. La traducción en tiempo real usa el protocolo Realtime. Especifique lo siguiente al solicitar las credenciales:
BAILIAN_ENDPOINT como el punto final para su área de trabajo: {WorkspaceId}.cn-beijing.maas.aliyuncs.com o {WorkspaceId}.ap-southeast-1.maas.aliyuncs.com. Lea DASHSCOPE_API_KEY desde una variable de entorno del lado servidor o desde un servicio de gestión de secretos.
clientIp en el cuerpo de la solicitud para la programación del punto de acceso.
Asigne los campos de respuesta a AoqConnectConfig en el cliente:
| Campo de respuesta de la puerta de enlace | Campo del SDK | Descripción |
|---|---|---|
aoqTokenForClient | token | Token temporal para esta conexión |
sid | sid | Identificador de esta sesión |
clientRelayCertFingerprint | certFingerprint | Utilice la huella digital del certificado exactamente como se devuelve |
clientRelayEndpoints | relayEndpoints | Convierta la lista completa de puntos de acceso a la estructura del SDK |
extraInfo.workspaceIdHash | workspaceIdHash | Utilice el valor devuelto. Si está ausente, siga los requisitos del SDK |
Implementar la traducción de voz en tiempo real
Flujo de interacción
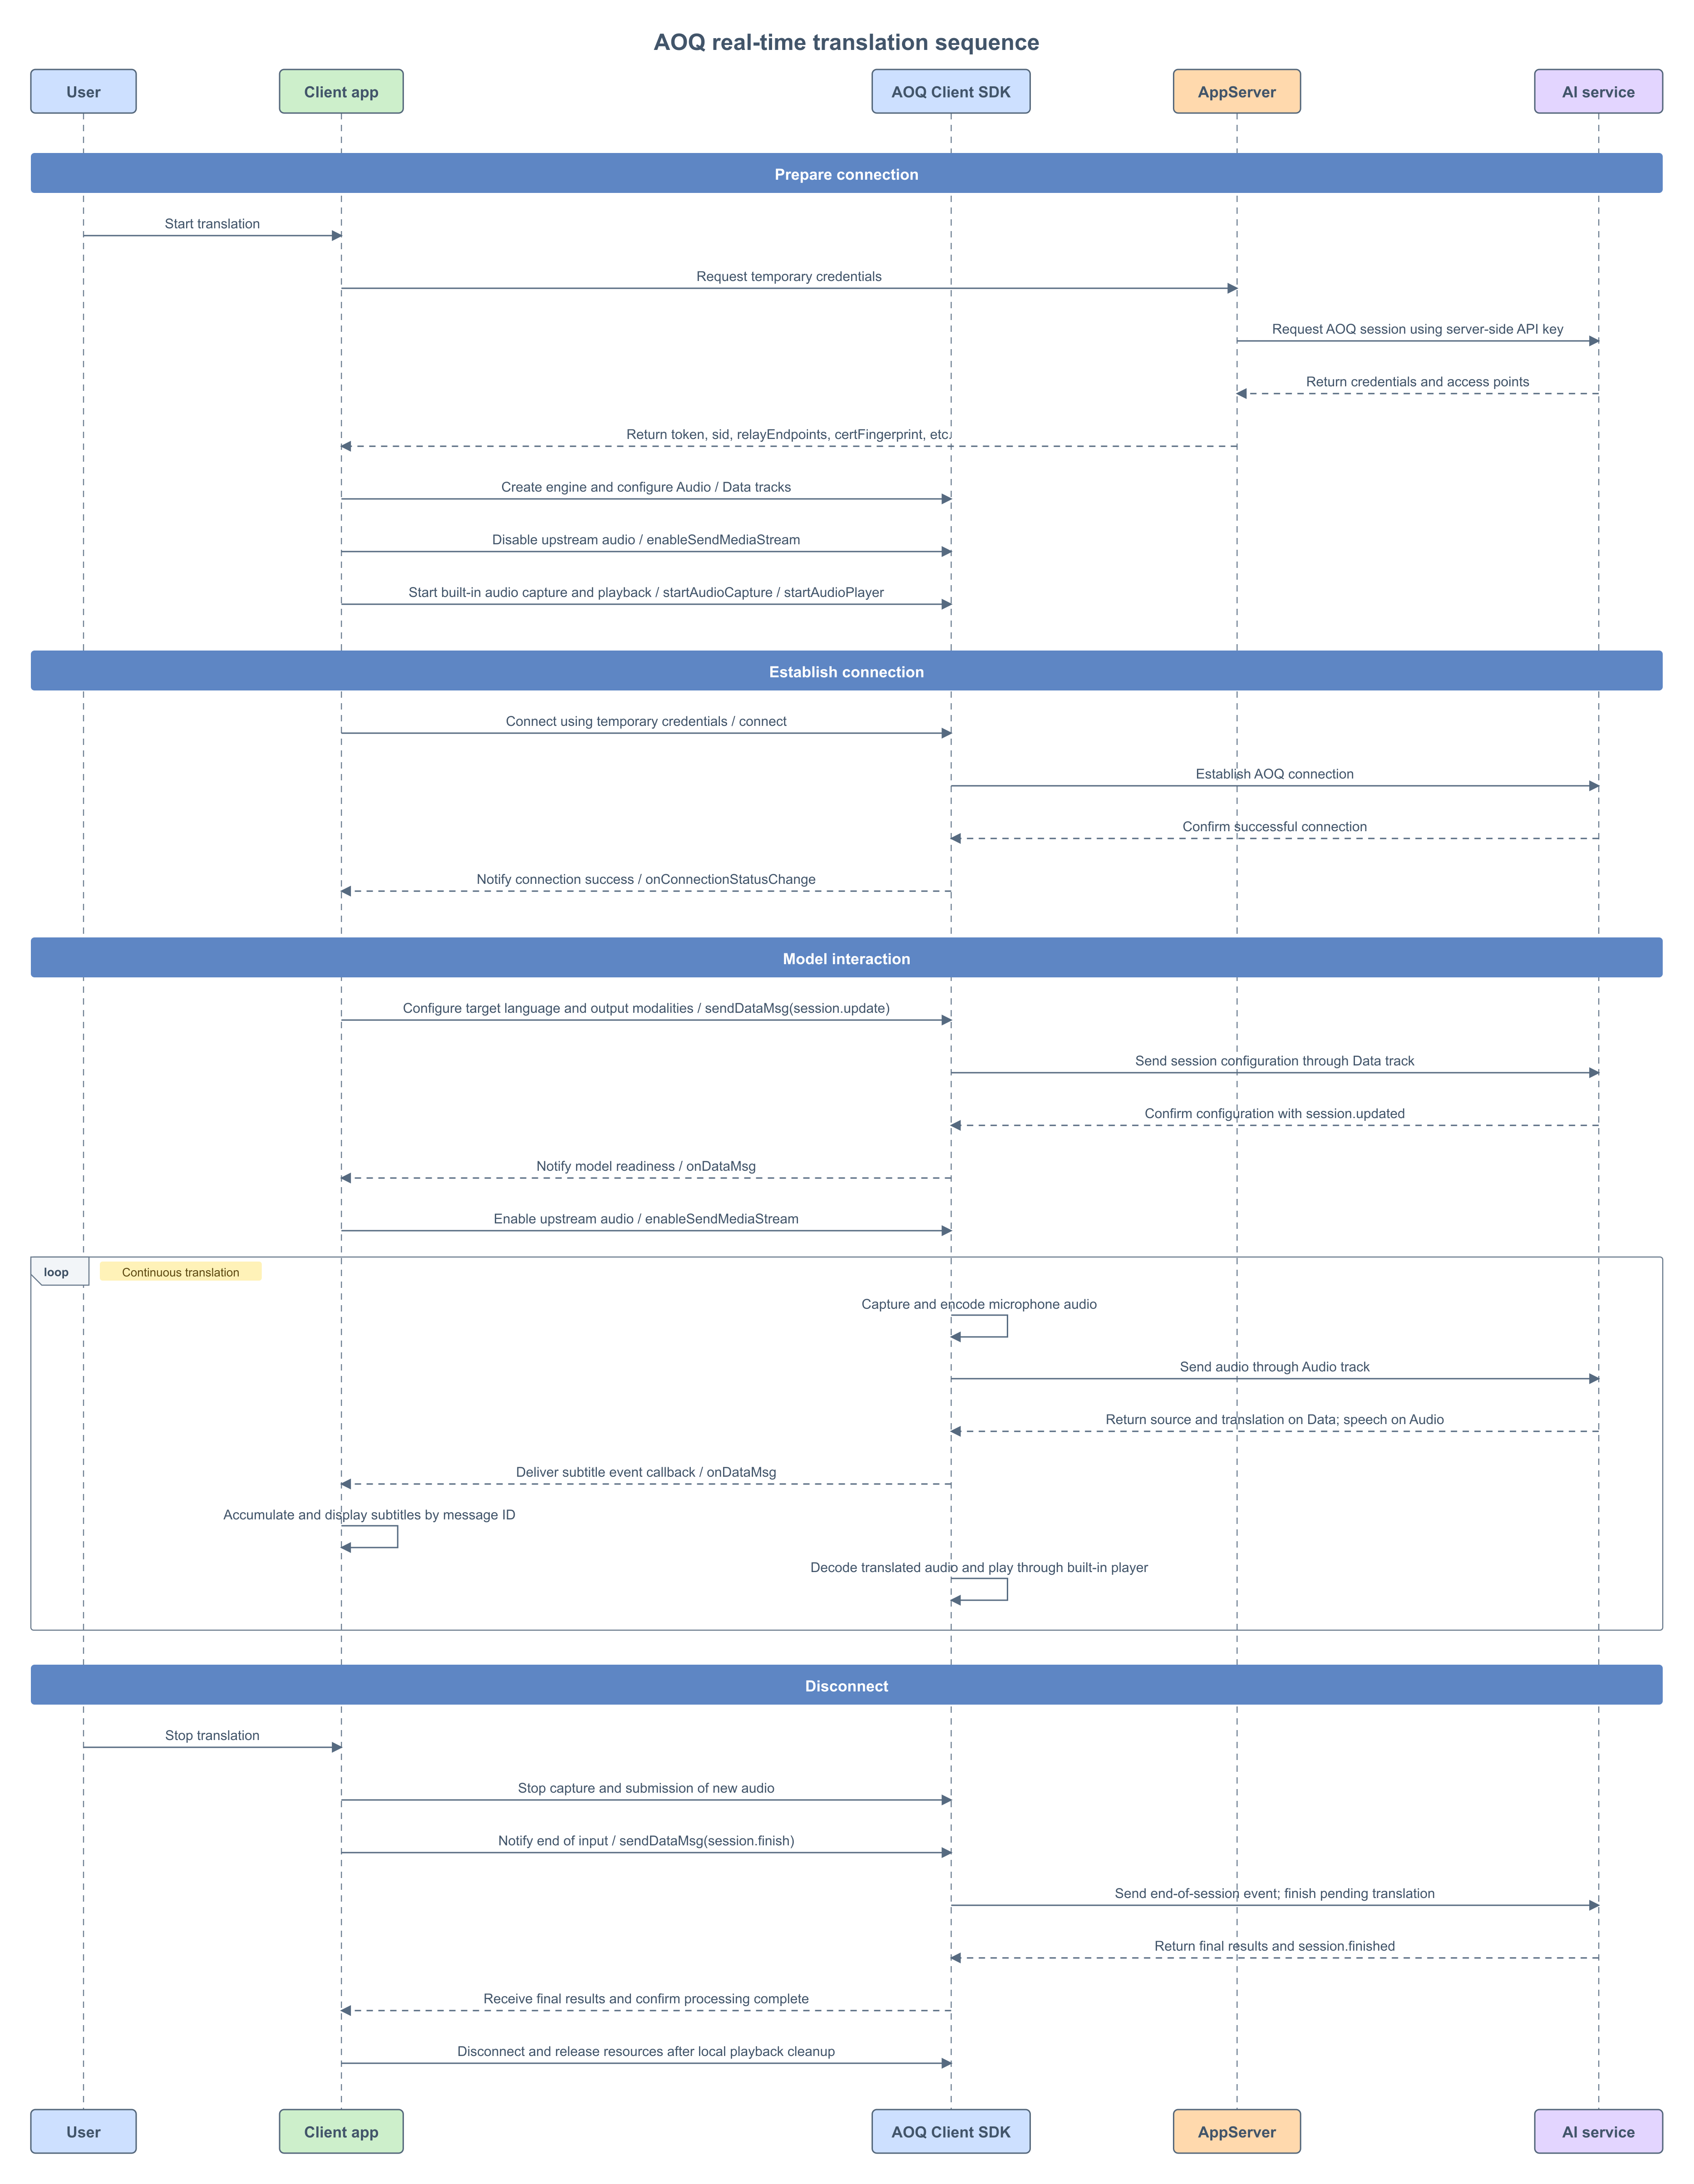
Crear el motor y establecer devoluciones de llamada
Llame a createEngine para crear el motor y registrar devoluciones de llamada para el estado de conexión, mensajes de datos y errores. Su aplicación debe mantener los objetos del motor y del oyente durante toda la sesión.
AoqClientListener para recibir eventos de conexión, mensajes del modelo y dispositivos multimedia, y páselo al crear el motor.
Iniciar la captura y reproducción de audio
Después de obtener el permiso del micrófono, prepare la captura y reproducción de audio. Desactive la transmisión de audio antes de iniciar la captura para evitar que el motor envíe medios automáticamente después de conectarse.
Iniciar la captura no significa que el modelo esté listo para recibir audio. Solicite al usuario que hable únicamente después de recibir session.updated y habilitar correctamente la transmisión. Este tutorial no implementa el almacenamiento en búfer de audio antes de la conexión.
Configurar códecs y establecer la conexión
El escenario principal requiere las siguientes pistas:
| Dirección | Pista | Propósito |
|---|---|---|
| Publicar | Audio | Enviar voz al modelo |
| Publicar | Datos | Enviar configuración de sesión y eventos de finalización |
| Suscribirse | Audio | Recibir voz traducida |
| Suscribirse | Datos | Recibir texto original, texto traducido y eventos de estado |
connect significa que la llamada fue aceptada. Espere a que onConnectionStatusChange informe una conexión exitosa antes de enviar la configuración del modelo.
Configurar la sesión de traducción
Después de conectarse, envíe el siguiente evento session.update a través de la pista de Datos. Esta configuración utiliza la voz predeterminada y no habilita la clonación de voz:
session.update, consulte Eventos del cliente de traducción en tiempo real.
Codifique el JSON como bytes UTF-8 y envíelo con sendDataMsg.
Habilitar la transmisión de medios después de recibir session.updated
Analice el tipo de evento en onDataMsg.
El siguiente fragmento enruta eventos de control. Para eventos de texto original y texto traducido, consulte Eventos del servidor. Después de recibir session.finished, establezca el estado de finalización de su aplicación y use el método de liberación descrito en "Desconectar y destruir el motor" para finalizar la limpieza.
Diferencias entre AOQ y WebSocket: este ejemplo envía y recibe audio directamente mediante las pistas Audio. No envíe
input_audio_buffer.append para volver a cargar el mismo audio, ni copie el ejemplo de WebSocket e inicie otro reproductor al recibir response.audio.delta. El audio traducido se maneja mediante la suscripción de audio y el reproductor del SDK. La pista Data transporta subtítulos y eventos del modelo. Para conocer el uso de las pistas de medios y Data, consulte Conexión mediante AOQ.Finalizar la entrada y esperar la traducción final
Cuando el usuario detenga la traducción, siga este orden:
- Detenga la captura para que no se envíe nueva entrada.
- Después de finalizar la entrada, deshabilite el audio de subida y envíe
session.finishuna vez. Mantenga activa la conexión AOQ, la suscripción de Datos y la reproducción de audio. - Continúe recibiendo el texto original final, el texto traducido y la voz traducida. Espere a
session.finished. - Desconecte y libere recursos según su política local de finalización de reproducción.
session.finish, consulte Eventos del cliente de traducción en tiempo real. Para los campos y significado de session.finished, consulte Eventos del servidor de traducción en tiempo real.
Desconectar y destruir el motor
Después de recibir session.finished, el servidor ha finalizado el procesamiento de esta sesión. Esto no significa que el altavoz local haya terminado de reproducir el último segmento de audio. Si su aplicación debe reproducir todo el discurso traducido, complete la reproducción local antes de ejecutar los siguientes métodos.