Se você encontrar recuperação incompleta de conhecimento ou conteúdo impreciso ao usar o recurso de geração aumentada por recuperação (RAG) no Alibaba Cloud Model Studio, consulte as sugestões e exemplos neste tópico para melhorar o desempenho do RAG.
1. Fluxo de trabalho de RAG
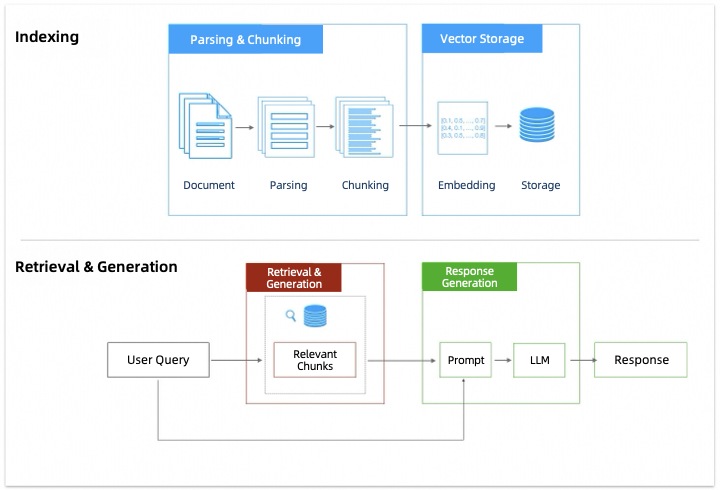
RAG (Geração Aumentada por Recuperação) é uma técnica que combina recuperação de informações com geração de texto. Ela permite que um modelo use informações relevantes de uma base de conhecimento externa ao gerar respostas.
Seu fluxo de trabalho inclui várias etapas principais, incluindo análise e fragmentação, armazenamento vetorial, recuperação e recall, e geração de resposta.
2. Otimizar o desempenho do RAG
2,1 Preparação
Primeiro, garanta que os documentos importados para Model Studio knowledge base atendam aos seguintes requisitos:
- Incluir conhecimento relevante: Se a base de conhecimento não tiver informações relevantes, o modelo pode falhar ao responder perguntas relacionadas. Para resolver isso, update the knowledge base e adicione o conhecimento necessário.
-
Usar formato Markdown (recomendado): Arquivos PDF frequentemente têm layouts complexos, o que pode levar a resultados de análise ruins. Converta PDFs para um formato de texto como Markdown, DOC ou DOCX primeiro. Por exemplo, use DashScopeParse para converter um PDF para Markdown e, em seguida, use um modelo para limpar a formatação. Consulte o capítulo de RAG do curso ACP de modelo grande da Alibaba Cloud.
How should I handle illustrations in documents?
Atualmente, a base de conhecimento não consegue analisar conteúdo de vídeo ou áudio em documentos.
- Usar redação clara, estrutura razoável e sem estilos especiais: O layout do seu documento também afeta significativamente o desempenho do RAG. Para detalhes, consulte How should documents be formatted to benefit RAG?.
- Corresponder ao idioma do prompt: Se os prompts dos usuários forem principalmente em um idioma, como inglês, garanta que o conteúdo do documento esteja no mesmo idioma. Se necessário, como para termos técnicos no documento, use dois ou mais idiomas.
-
Desambiguação de entidades: Unifica diferentes expressões para a mesma entidade em um documento. Por exemplo, "ML" e "Machine Learning" podem ser padronizados como "Machine Learning".
Insira o documento em um modelo e peça para ele padronizar os termos. Se o documento for longo, divida-o em várias partes e insira-as uma por uma.
2,2 Análise e fragmentação
Esta seção descreve apenas os itens de configuração no Model Studio para otimizar a fase de fragmentação do RAG.Primeiro, a base de conhecimento analisa e fragmenta os documentos importados. O objetivo principal da fragmentação é reduzir o ruído durante o processo subsequente de vetorização, preservando a integridade semântica. Portanto, a estratégia de fragmentação de documentos selecionada ao criar uma base de conhecimento tem um impacto significativo no desempenho do RAG. Se o método de fragmentação for inadequado, pode levar aos seguintes problemas:
Trechos curtos | Trechos longos | Truncamento semântico |
|---|---|---|
 | 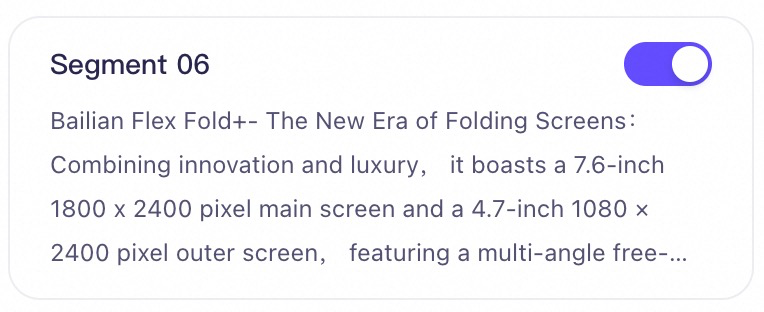 | 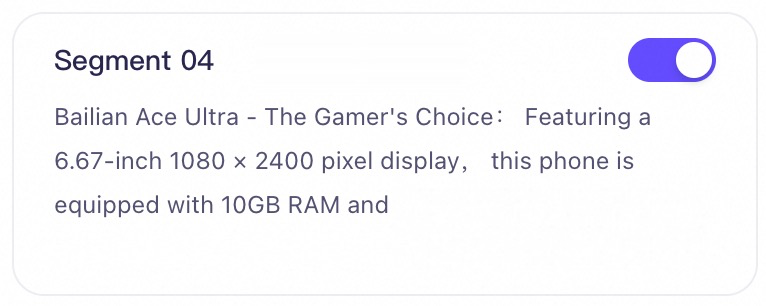 |
Trechos curtos podem carecer de informações semânticas, causando falha na recuperação. | Trechos longos podem incluir tópicos irrelevantes, fazendo com que o processo de recall retorne informações ruidosas ou irrelevantes. | O truncamento semântico forçado pode causar conteúdo ausente durante o recall. |
- Ao criar uma base de conhecimento, selecione intelligent chunking para o método de fragmentação de documentos.
- Após importar documentos com sucesso para a base de conhecimento, revise e corrija manualmente o conteúdo dos trechos de texto.
2,2,1 Fragmentação inteligente
Escolher o tamanho ideal de trecho de texto para sua base de conhecimento pode ser desafiador porque depende de múltiplos fatores, como:
- Tipo de documento: Para literatura profissional, trechos mais longos frequentemente ajudam a reter mais contexto. Para postagens de redes sociais, trechos mais curtos podem capturar a semântica com mais precisão.
- Complexidade do prompt: Geralmente, se o prompt de um usuário for complexo e específico, trechos mais longos podem ser necessários. Caso contrário, trechos mais curtos podem ser mais apropriados.
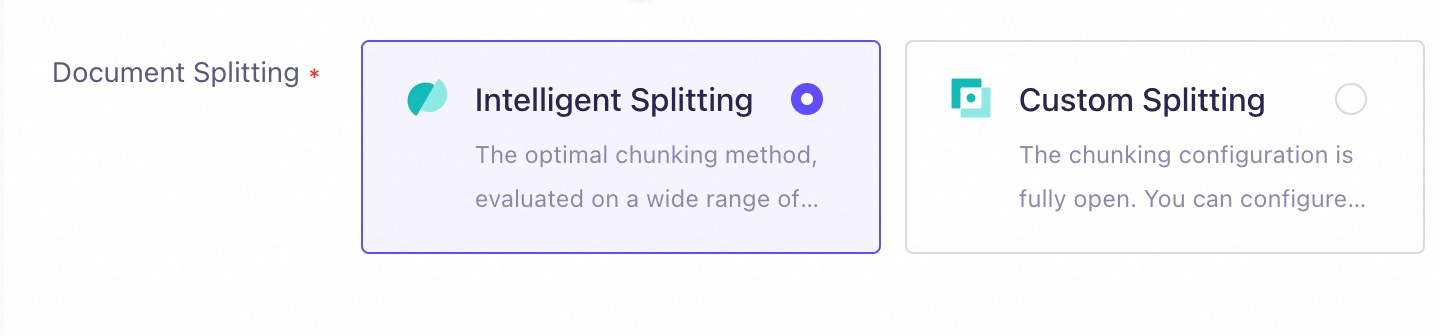
- Primeiro usa delimitadores de frases integrados para dividir o documento em parágrafos.
- Com base nos parágrafos divididos, seleciona adaptativamente limites de fragmentação com base na relevância semântica (fragmentação semântica), em vez de usar um tamanho fixo.
2,2,2 Corrigir conteúdo do trecho
Naturalmente, durante o processo real de fragmentação, divisões inesperadas ou outros problemas ainda podem ocorrer (por exemplo, spaces no texto às vezes são analisados como %20 após a fragmentação).
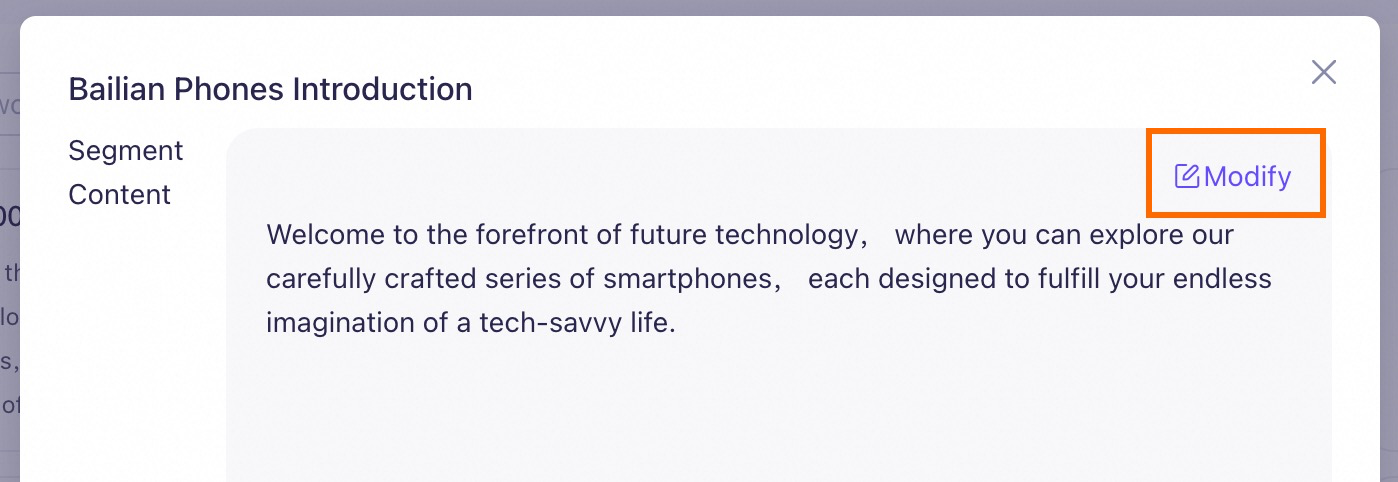
Observe que esta ação modifica apenas os trechos de texto na base de conhecimento, não o documento original ou tabela de dados no seu gerenciamento de dados (armazenamento temporário). Portanto, se você reimportar o documento, deverá realizar a verificação e correção manual novamente.
2,3 Recuperação e recall
Esta seção descreve apenas os itens de configuração no Model Studio para otimizar a fase de recuperação e recall.O principal desafio na fase de recuperação e recall é encontrar os trechos de texto mais relevantes na base de conhecimento que contenham a resposta.
| Tipo de problema | Estratégia de melhoria |
|---|---|
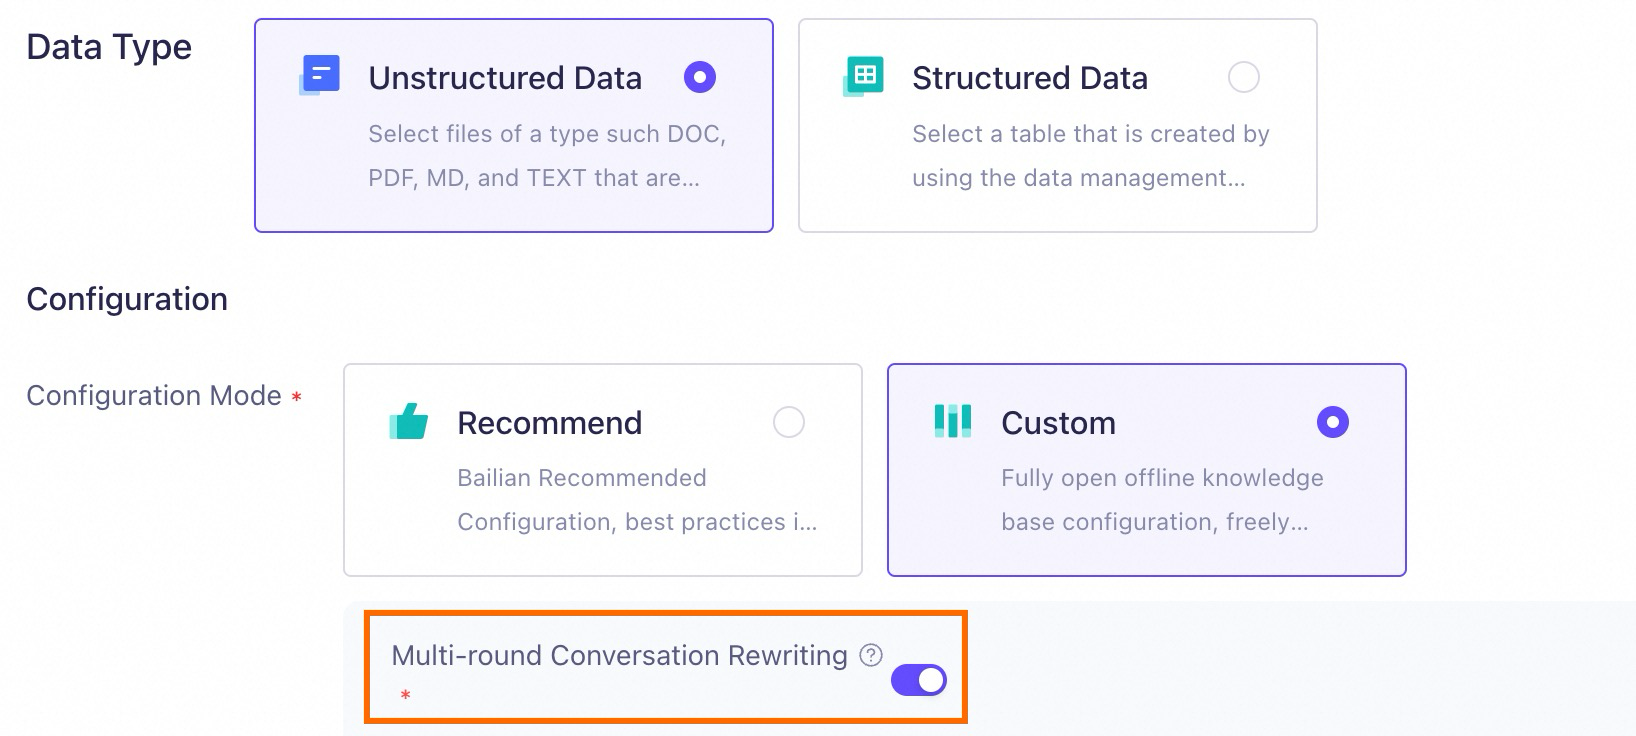
| Em cenários de conversa de múltiplas rodadas, o prompt do usuário pode estar incompleto ou ambíguo. | Ative multi-turn conversation rewriting. A base de conhecimento automaticamente reescreve o prompt do usuário para ser mais completo, melhorando a correspondência de conhecimento. |
| A base de conhecimento contém documentos de várias categorias. Quando uma busca é focada na Categoria A, os resultados de recall também incluem trechos de texto de outras categorias, como a Categoria B. | Add tags aos documentos. Durante a recuperação, a base de conhecimento primeiro filtra documentos relevantes com base em tags antes de pesquisar.Apenas bases de conhecimento de busca de documentos suportam adicionar tags aos documentos. |
| A base de conhecimento contém vários documentos com estruturas semelhantes, por exemplo, todos contêm uma seção "Visão Geral dos Recursos". Você deseja pesquisar na seção "Visão Geral dos Recursos" do Documento A, mas os resultados de recall incluem informações de outros documentos semelhantes. | Use metadata extraction. A base de conhecimento executa uma busca estruturada com metadados antes da recuperação vetorial para encontrar com precisão o documento alvo e extrair as informações relevantes.Apenas bases de conhecimento de busca de documentos suportam metadados de documentos. |
| Os resultados de recall estão incompletos e não incluem todos os trechos de texto relevantes. | Reduza similarity threshold e aumente number of recalled chunks para recuperar informações que foram perdidas anteriormente. |
| Os resultados de recall contêm uma grande quantidade de trechos de texto irrelevantes. | Aumente o limiar de similaridade para excluir informações com baixa similaridade ao prompt do usuário. |
2,3,1 Reescrita de conversa em múltiplas rodadas
Em uma conversa de múltiplas rodadas, um usuário pode fazer uma pergunta com um prompt curto, como "Model Studio Phone X1". Isso pode fazer com que o sistema RAG não tenha o contexto necessário durante a recuperação pelos seguintes motivos:
- Um product telefônico frequentemente tem várias gerações à venda ao mesmo tempo.
- Para a mesma geração de um product, o fabricante geralmente oferece várias opções de armazenamento, como 128 GB e 256 GB. ...
2,3,2 Filtragem por tag
Esta seção aplica-se apenas a bases de conhecimento de busca de documentos .Ao usar um aplicativo de música, filtre músicas por artista para encontrar rapidamente todas as músicas desse artista. Da mesma forma, adicionar tags aos seus documentos não estruturados introduz informações estruturadas adicionais. Ao recuperar da base de conhecimento, a aplicação pode primeiro filtrar documentos com base em tags, o que melhora a precisão e a eficiência da recuperação. O Model Studio suporta os dois métodos a seguir para definir tags:
- Defina tags ao carregar documentos: Para etapas do console, consulte Import data.
-
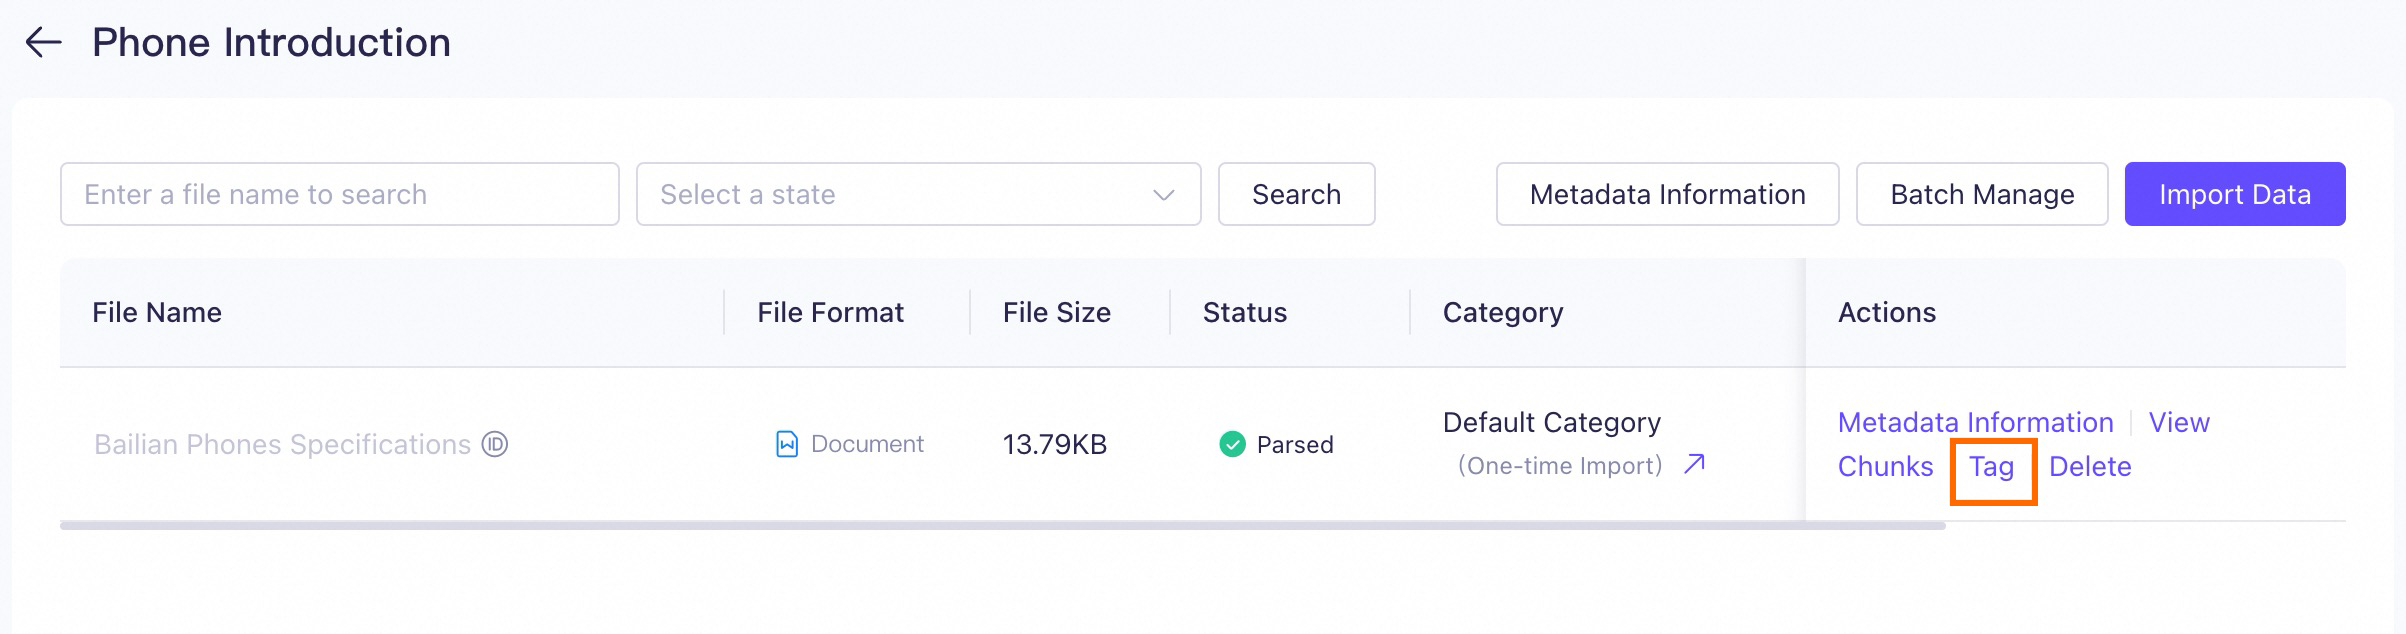
Edite tags na página Data Management: Para documentos carregados, clique em Tag à direita do documento para editar suas tags .
-
Quando você call a Model Studio application by using an API, especifique tags no parâmetro de solicitação
tags. -
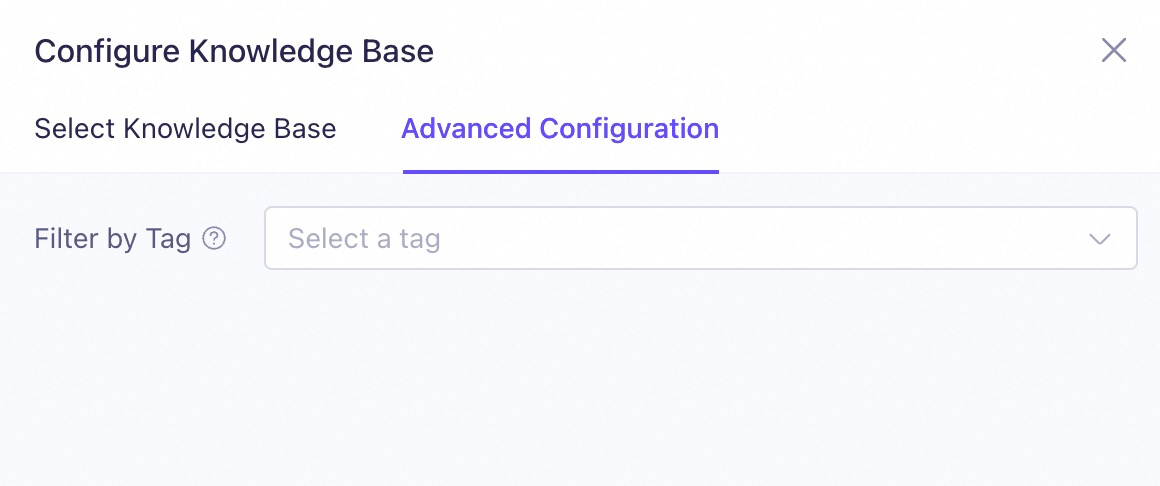
Defina tags ao editar uma aplicação no console. No entanto, este método é aplicável apenas a agent applications.
Observe que esta configuração aplica-se a todas as perguntas e respostas subsequentes do usuário para esta aplicação de agente.
2,3,3 Extração de metadados
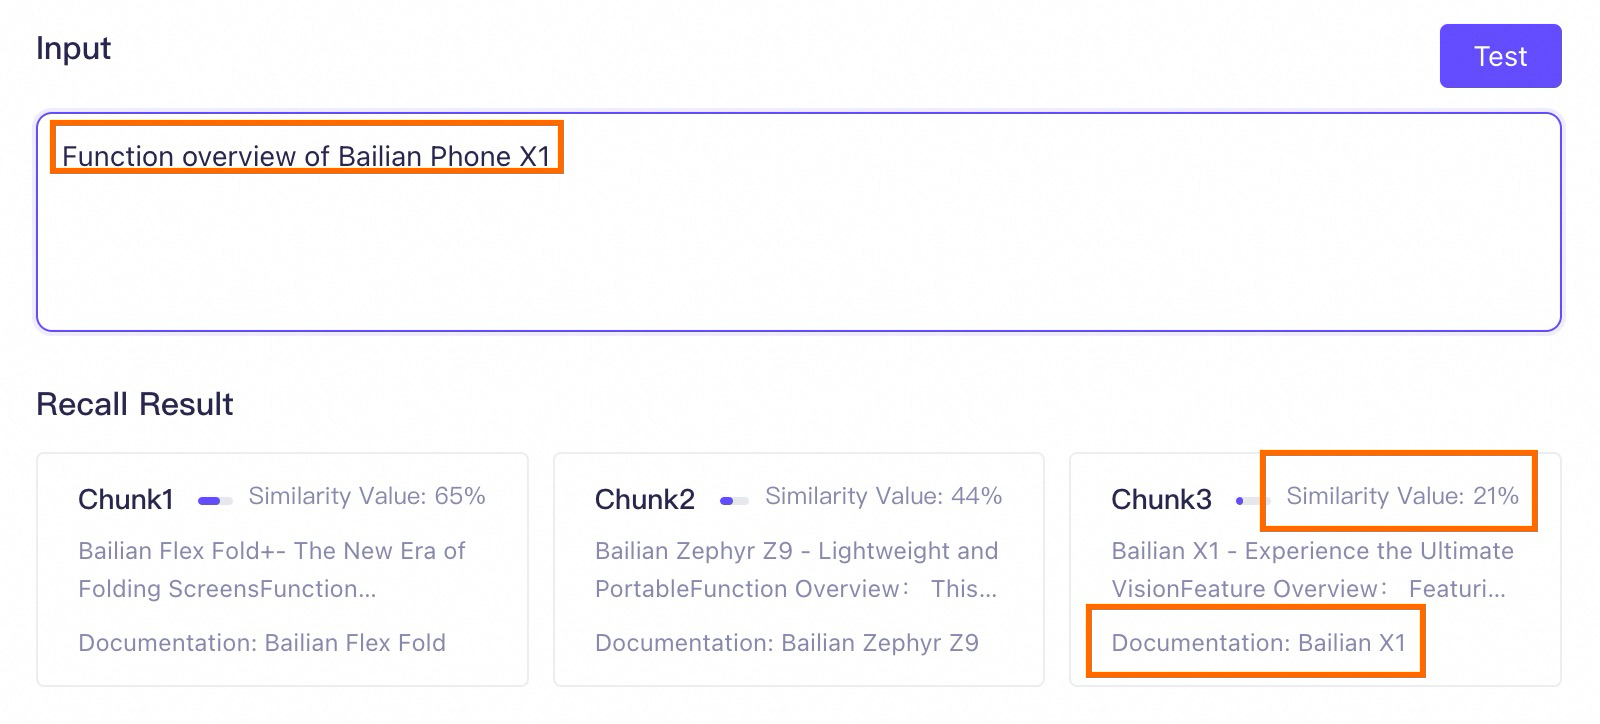
Esta seção aplica-se apenas a bases de conhecimento de busca de documentos .Incorporar metadados em trechos de texto pode aprimorar efetivamente o contexto de cada trecho. Em cenários específicos, esse método pode melhorar significativamente o desempenho do RAG de bases de conhecimento de busca de documentos . Considere o seguinte cenário: Uma base de conhecimento contém muitos manuais de products telefônicos. Os nomes dos documentos são os modelos dos telefones (como Model Studio X1 e Model Studio Zephyr Z9), e todos os documentos incluem um capítulo "Visão Geral dos Recursos". Se os metadados não estiverem ativados para esta base de conhecimento, um usuário pode inserir o seguinte prompt para recuperação:
Os resultados do teste de recuperação garantem a classificação, mas a pontuação absoluta de similaridade serve apenas como referência. Quando a diferença nos valores absolutos é pequena (dentro de 5%), a probabilidade de recall pode ser considerada a mesma.
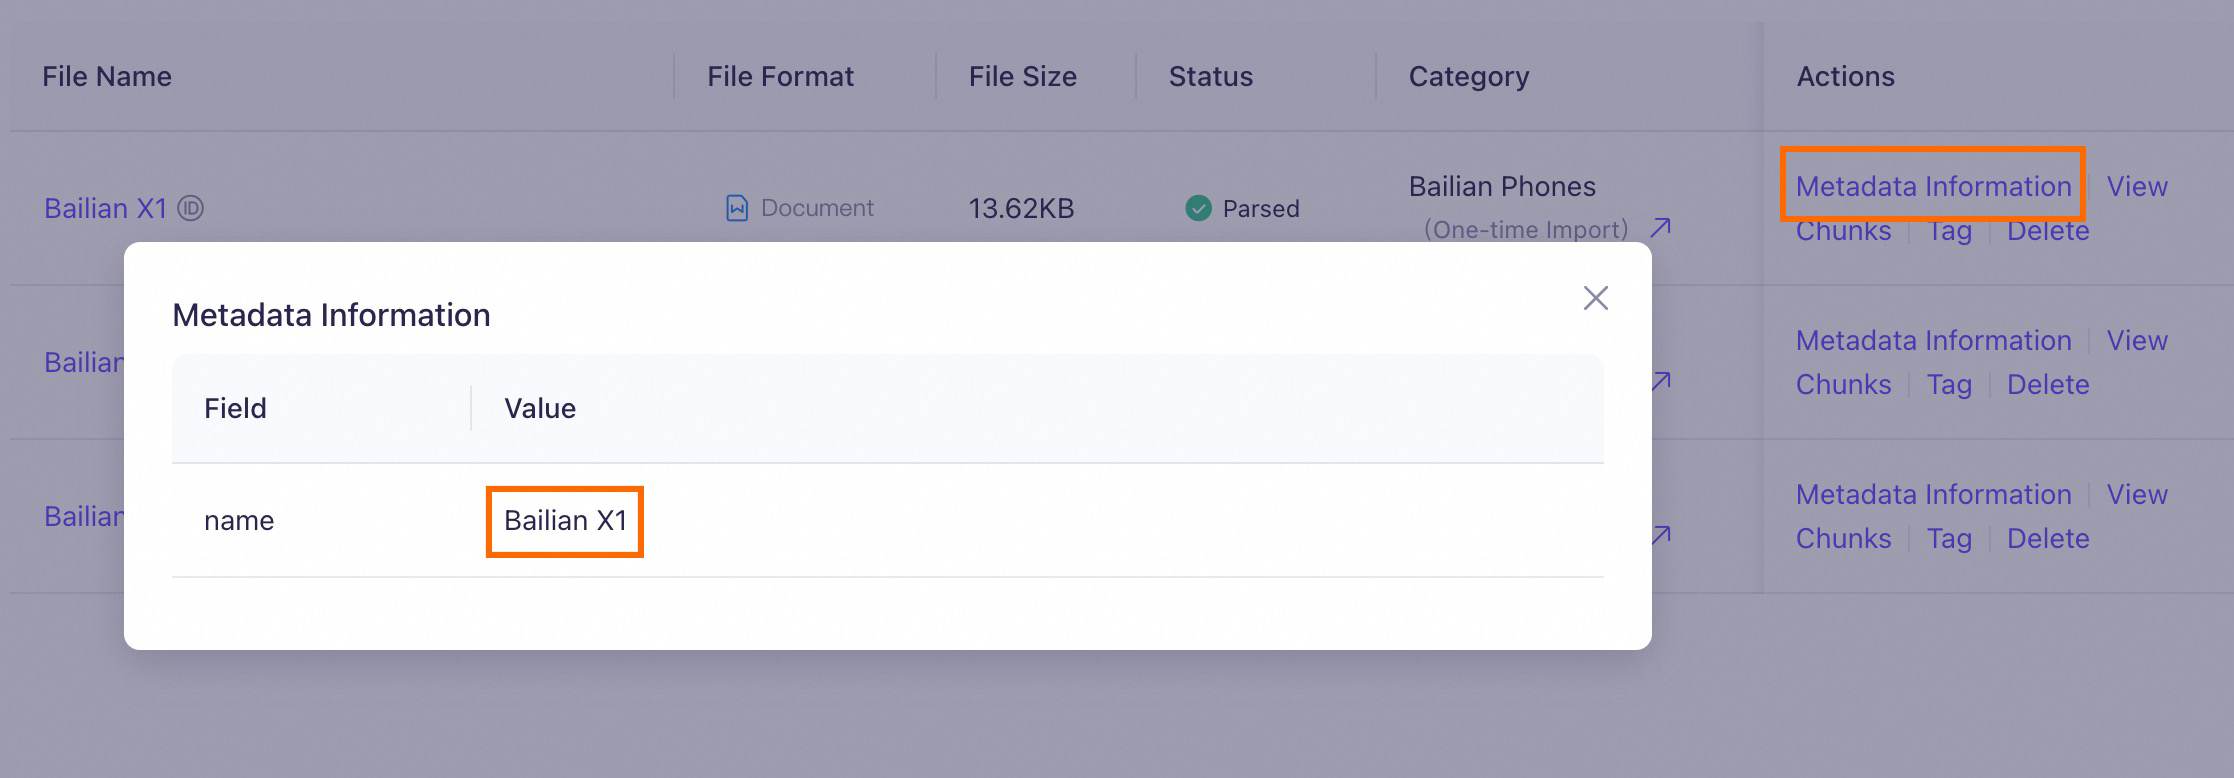
- Extrair metadados {"key": "name", "value": "Model Studio Phone X1"} do prompt.
- Com base nos metadados extraídos, encontrar todos os trechos de texto que contenham os metadados "Model Studio Phone X1".
- Em seguida, realizar uma busca vetorial (semântica) para encontrar os trechos de texto mais relevantes.
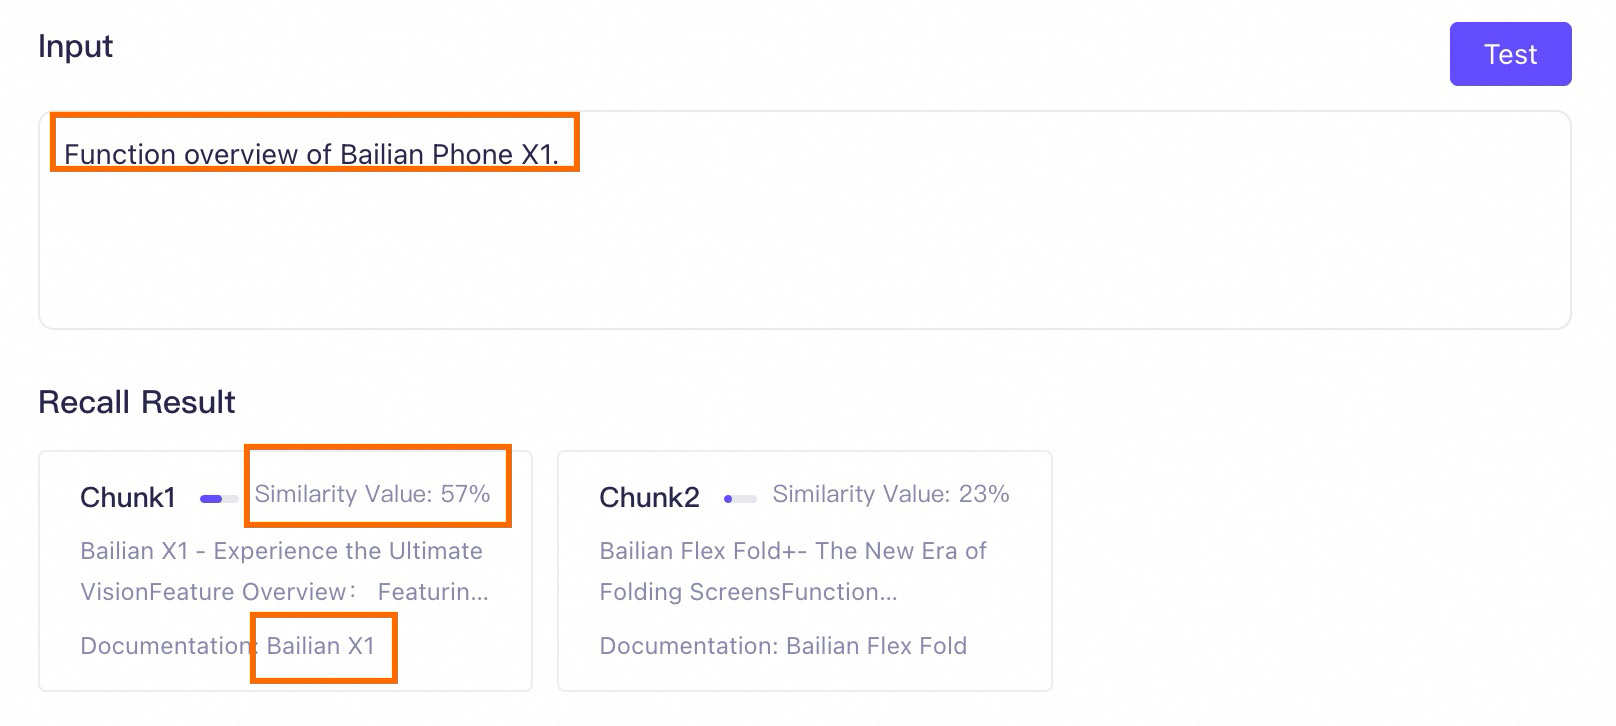
2,3,4 Limiar de similaridade
Quando a base de conhecimento encontra trechos de texto relacionados ao prompt do usuário, ela primeiro os envia para o modelo Rank (configurado em Custom parameter settings ao criar a base de conhecimento) para reordenação. O limiar de similaridade é então usado para filtrar os trechos de texto reordenados. Apenas trechos de texto com pontuação de similaridade que exceda esse limiar podem ser fornecidos ao modelo.
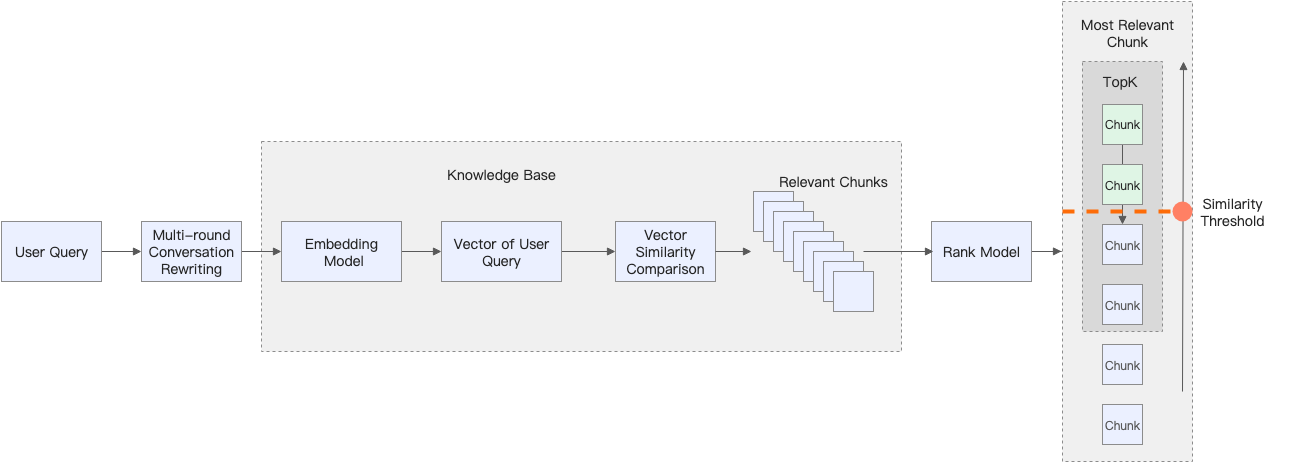
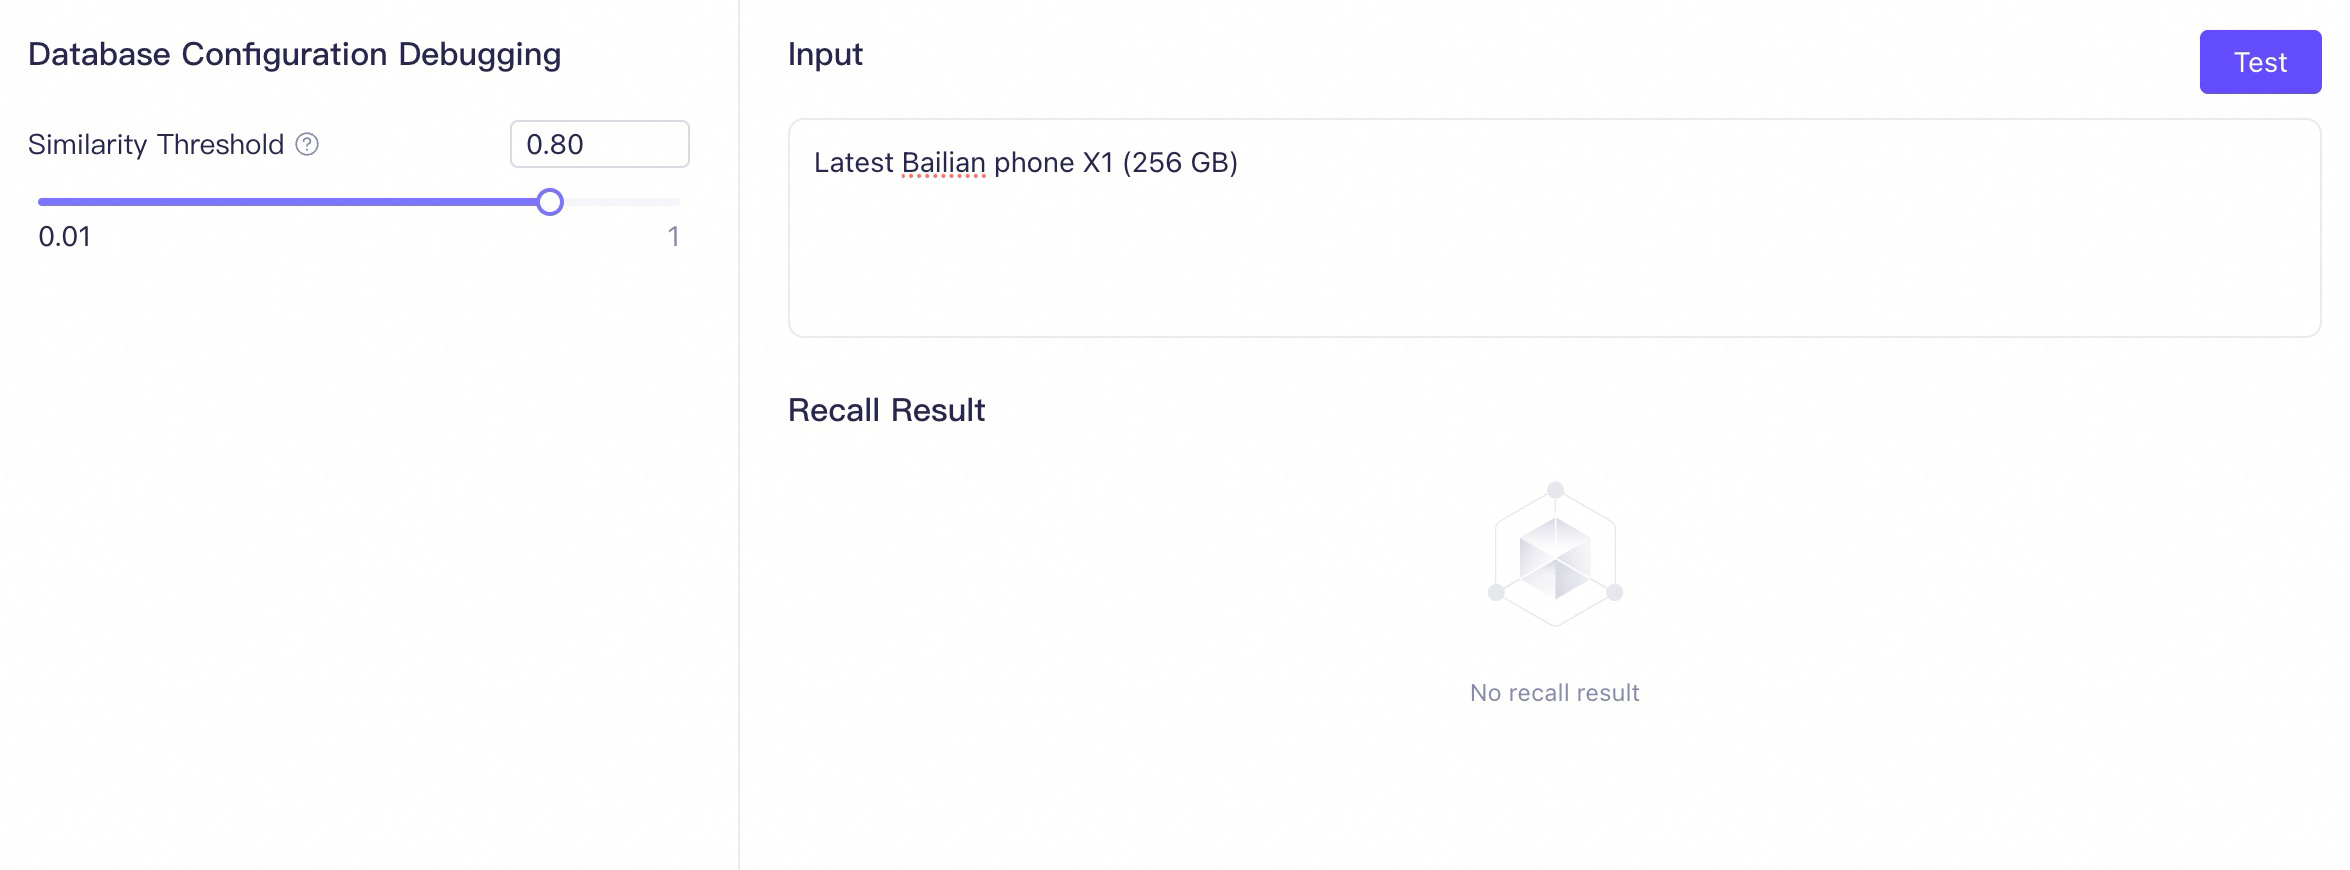
Etapas recomendadas para teste de recuperação | |
|  |
2,3,5 Número de trechos recuperados
O número de trechos recuperados é o valor K na estratégia de recall multicanal. Após a filtragem pelo limiar de similaridade, se o número de trechos de texto exceder K, o sistema seleciona os K trechos de texto com as maiores pontuações de similaridade para fornecer ao modelo. Devido a isso, um valor K inadequado pode fazer com que o RAG perca trechos de texto corretos, o que afeta a capacidade do modelo de gerar uma resposta completa.
Por exemplo, um usuário recupera informações com o seguinte prompt:

Muitos experimentos mostram que, em cenários como "Liste...", "Resuma..." e "Compare X e Y...", fornecer mais trechos de texto de alta qualidade (por exemplo, K=20) ao modelo é mais eficaz do que fornecer apenas os 10 ou 5 principais. Embora isso possa introduzir ruído, se a qualidade do trecho de texto for alta, um modelo capaz geralmente consegue lidar com isso.Ajuste o Number of Recalled Chunks ao editar uma aplicação no Model Studio.
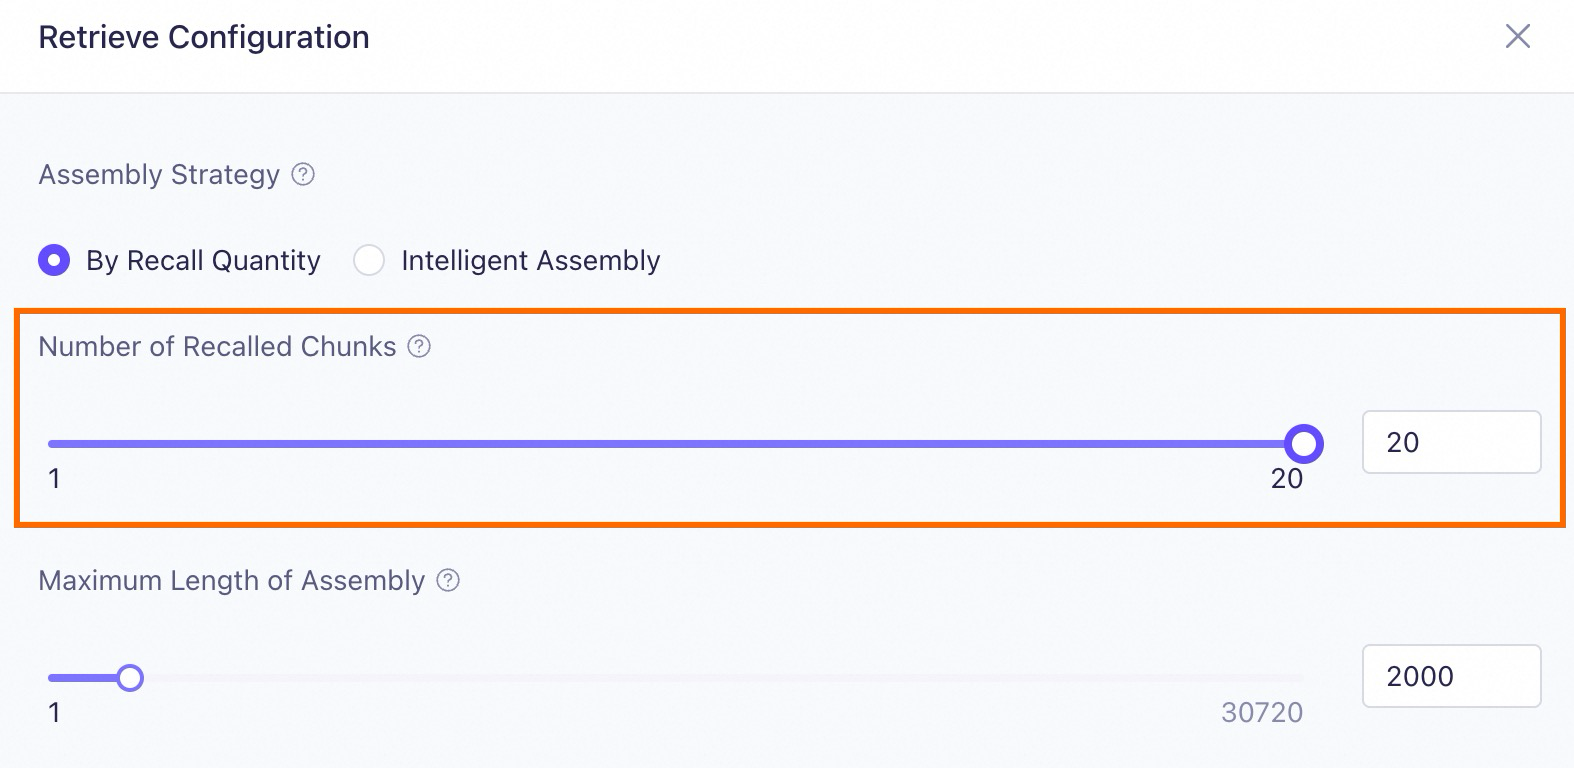
2,4 Geração de resposta
Esta seção descreve apenas os itens de configuração que o Model Studio suporta para otimização na fase de geração de resposta.Neste ponto, o modelo pode gerar a resposta final com base no prompt do usuário e no conteúdo recuperado da base de conhecimento. No entanto, o resultado retornado ainda pode não atender às suas expectativas.
Tipo de problema | Estratégia de melhoria |
|---|---|
O modelo não entende a relação entre o conhecimento e o prompt do usuário. A resposta parece ser costurada a partir de pedaços díspares de texto. | Select a suitable model para entender efetivamente a relação entre o conhecimento e o prompt do usuário. |
O resultado retornado não segue as instruções ou não é abrangente. | |
O resultado retornado não é preciso o suficiente. Contém o conhecimento geral do próprio modelo e não é totalmente fundamentado na base de conhecimento. | Enable rejection para restringir respostas apenas ao conhecimento recuperado da base de conhecimento. |
Para prompts semelhantes, você deseja que os resultados sejam consistentes ou variados. |
2,4,1 Seleção de modelo
Diferentes modelos grandes têm capacidades diferentes em áreas como seguimento de instruções, suporte a idiomas, texto longo e compreensão de conhecimento. Isso pode levar à seguinte situação:
Model A falhou em entender efetivamente a relação entre o conhecimento recuperado e o prompt, e a resposta gerada não conseguiu abordar com precisão o prompt do usuário. Mudar para Model B, que tem mais parâmetros ou capacidades especializadas mais fortes, pode resolver esse problema.
Selecione Select Model ao editar uma aplicação no Model Studio com base nas suas necessidades reais.
Qwen-Max e Qwen-Plus. Esses modelos grandes comerciais têm as capacidades e melhorias mais recentes em comparação com suas versões open-source.
- Para consultas e resumos simples de informações, modelos grandes com um pequeno número de parâmetros são suficientes, como
Qwen-Turbo. - Se quiser que o RAG realize raciocínio lógico mais complexo, selecione um modelo grande com mais parâmetros e capacidades de raciocínio mais fortes, como
Qwen-Max. - Se sua consulta exigir referência a muitos trechos de documentos, selecione um modelo grande com um comprimento de contexto mais longo, como
Qwen-Plus. - Se construir uma aplicação RAG para um domínio especializado, como o domínio jurídico, use um modelo treinado para esse domínio específico, como
Qwen-Legal.
2,4,2 Otimização de modelo de prompt
Influencie o comportamento de um modelo e melhore o desempenho do RAG projetando o prompt que orienta como ele usa o conhecimento recuperado.
A seguir estão três métodos comuns de otimização:
Método 1: Restringir o conteúdo de saída
Forneça informações contextuais, instruções e o formato de saída esperado no modelo de prompt para instruir o modelo. Por exemplo, adicione a seguinte instrução de saída:
| Modelo de prompt | Resultado |
|---|---|
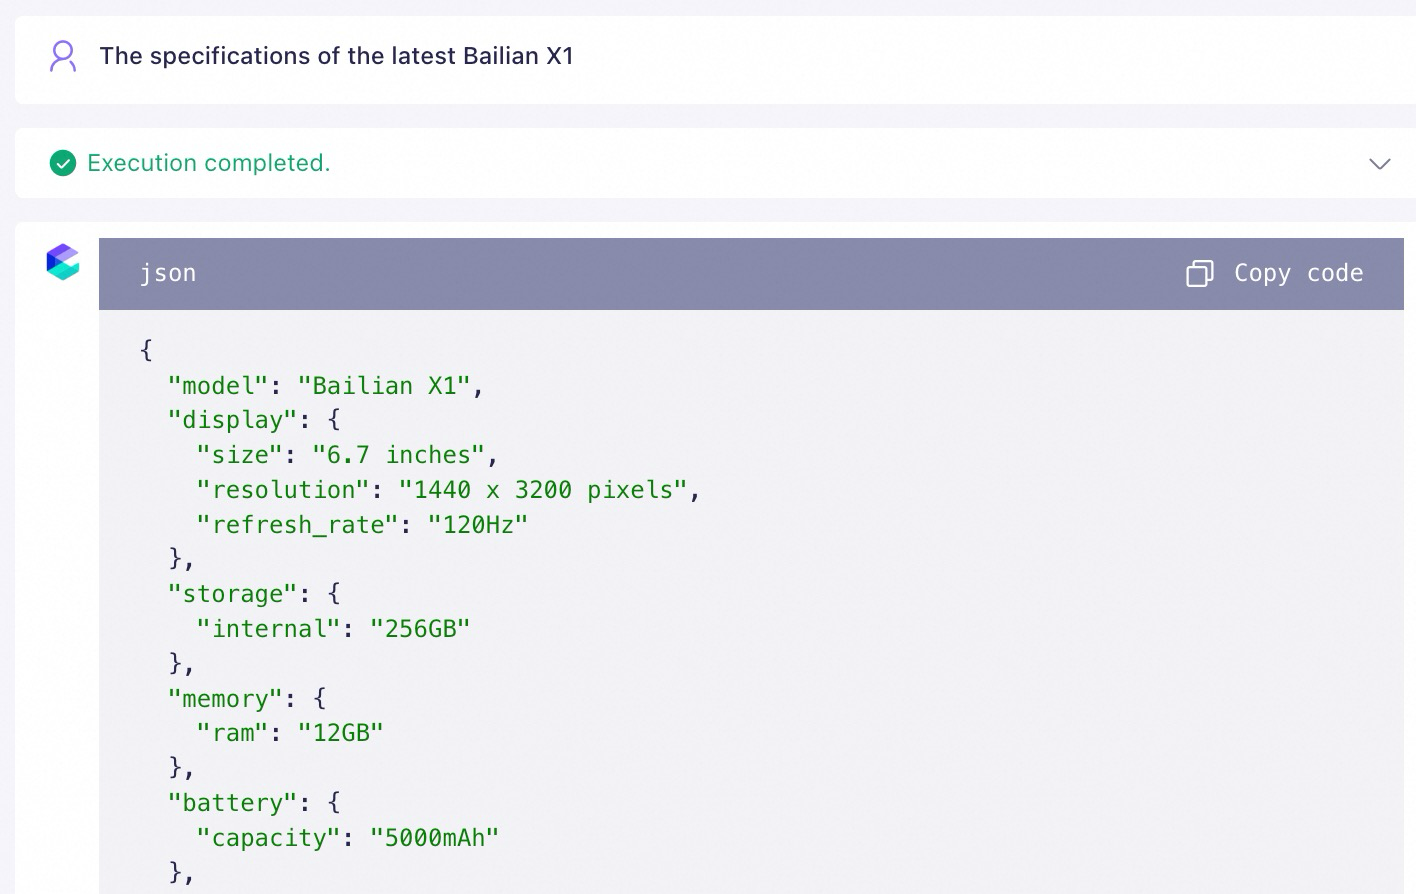 | |
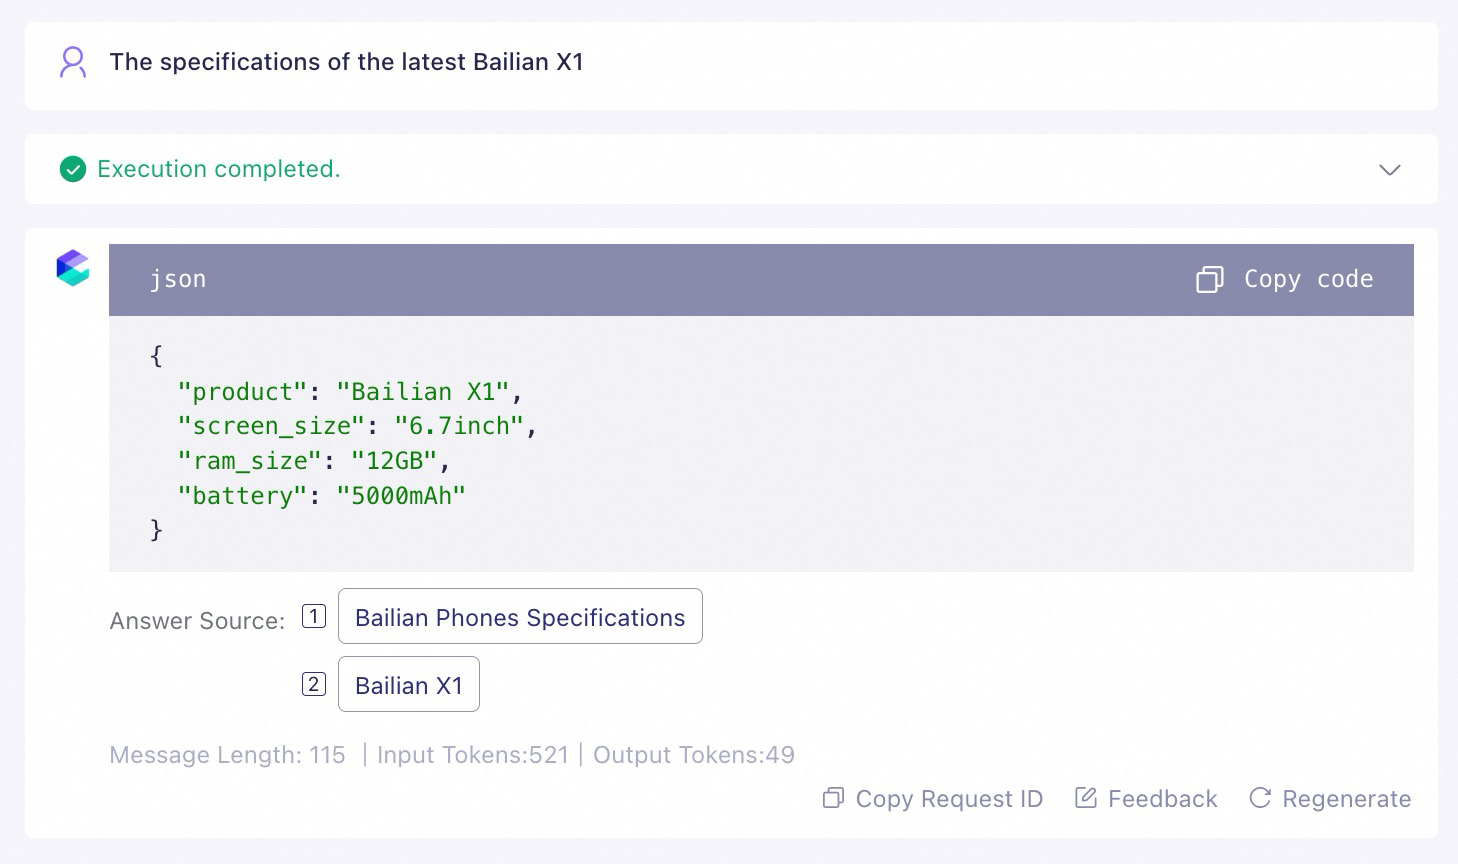 |
${documents}.
Além disso, para garantir os melhores resultados, certifique-se de que a variável ${documents} apareça apenas uma vez no seu modelo de prompt. Para referência, veja o exemplo correto à esquerda abaixo.
2,4,3 Rejeição
Se desejar que os resultados retornados pela sua aplicação Model Studio sejam estritamente baseados no conhecimento recuperado da base de conhecimento, e excluir a influência do conhecimento geral do próprio modelo, defina o escopo da resposta como Knowledge Base Only ao editar a aplicação.
Para casos em que nenhum conhecimento relevante é encontrado na base de conhecimento, defina uma resposta fixa automática.
Answer scope: Knowledge Base + LLM Knowledge | Answer scope: Knowledge Base Only |
 |  |
O resultado retornado pela aplicação Model Studio será uma combinação de conhecimento recuperado da base de conhecimento e o conhecimento geral do próprio modelo. | O resultado retornado pela aplicação Model Studio será estritamente baseado no conhecimento recuperado da base de conhecimento. |
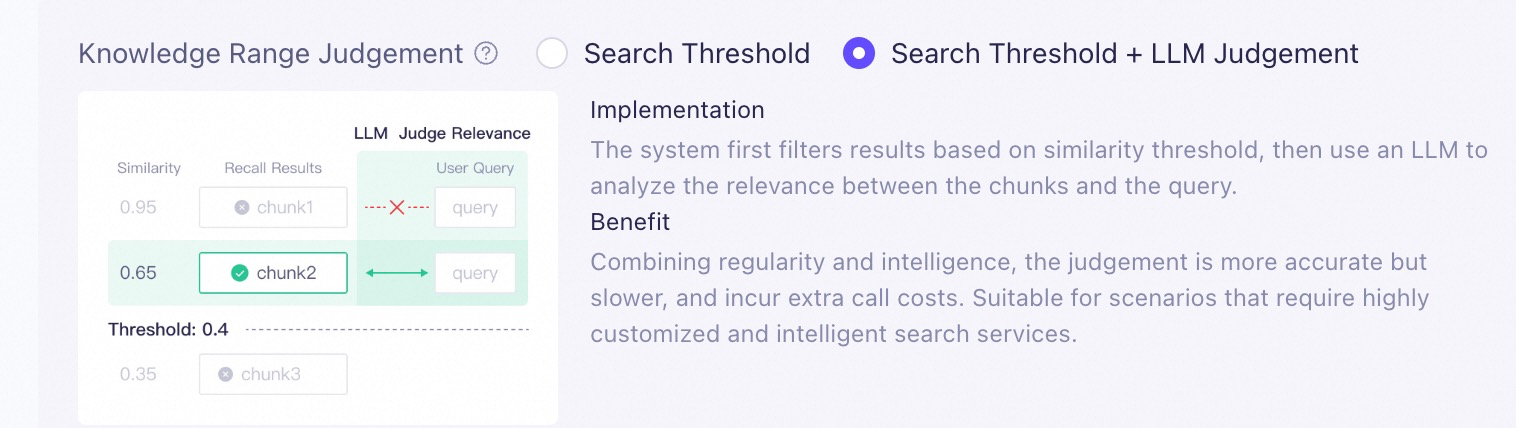
Sorry, no relevant phone models were found.
Consulta bem-sucedida | Consulta mal-sucedida |
|---|---|
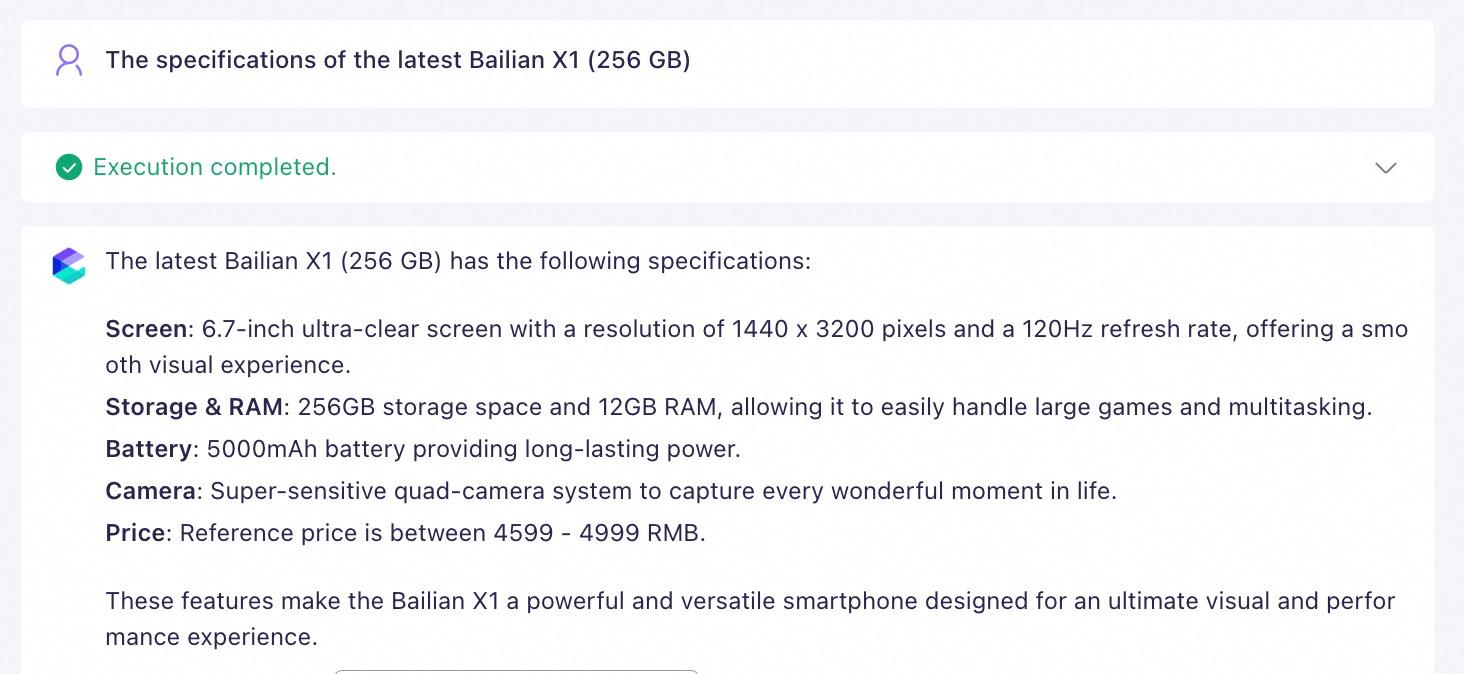 | 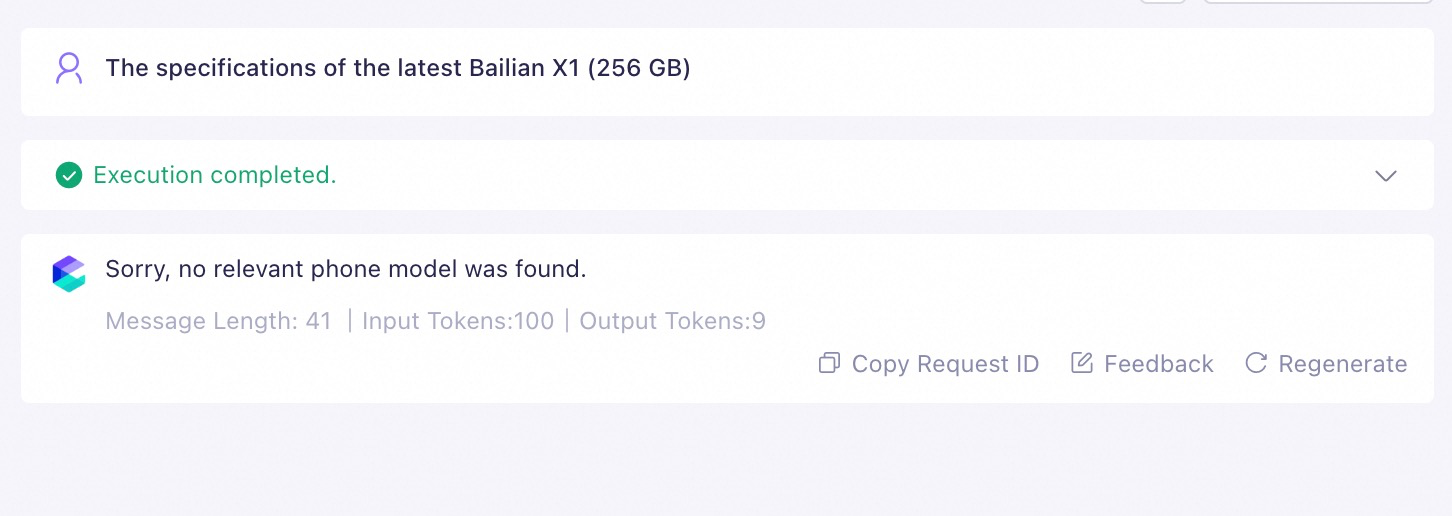 |
2,4,4 Parâmetros do modelo
Para controlar se o modelo fornece respostas consistentes ou variadas para prompts semelhantes, modifique Configure Parameters para ajustar os parâmetros do modelo ao editar a aplicação.
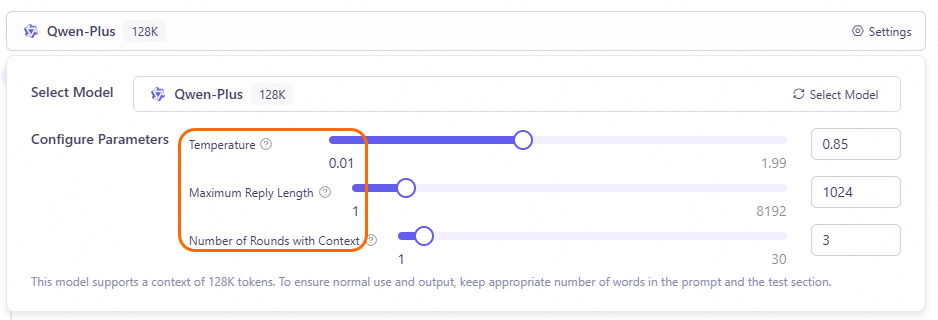
- Texto diversificado é adequado para escrita criativa (como romances e textos publicitários), brainstorming e cenários de aplicações de chat.
- Texto determinístico é adequado para cenários com respostas claras (como análise de problemas, questões de múltipla escolha e busca de fatos) ou que exigem redação precisa (como documentos técnicos, textos legais, reportagens e artigos acadêmicos).
3. FAQ
Como os documentos devem ser formatados para beneficiar o RAG?
Como os documentos devem ser formatados para beneficiar o RAG?
- Use níveis de título claros. Garanta que o conteúdo sob cada título seja claro e autocontido.
- Evite marcas d'água.
- Evite aninhar níveis de lista sob um item no meio de uma lista.
- Evite tabelas e imagens sempre que possível, pois tabelas complexas podem afetar a qualidade da análise.


- O conteúdo sob cada título é claro e relativamente independente.
- Sem marcas d'água.
- Uma lista aparece sob o título, mas não contém listas aninhadas.
- Sem tabelas ou imagens.