

Uma base de conhecimento complementa um LLM com dados privados e informações atualizadas. Por meio da geração aumentada por recuperação (RAG), o LLM melhora a precisão das respostas ao recuperar primeiro o conteúdo relevante da base de conhecimento antes de gerar uma resposta.
Aplicação sem base de conhecimento dedicada Sem uma base de conhecimento dedicada, um LLM não consegue responder com precisão a perguntas específicas de domínio. Por exemplo, quando um usuário envia "Por favor, ajude-me a escolher o melhor celular com câmera do Alibaba Cloud Model Studio, com orçamento de 3.000 yuans" na interface de chat, o assistente de IA não pode fornecer recomendações precisas de produtos devido à falta de uma base de conhecimento relevante. | Aplicação com base de conhecimento dedicada Com uma base de conhecimento dedicada, um LLM responde com precisão a perguntas específicas de domínio. 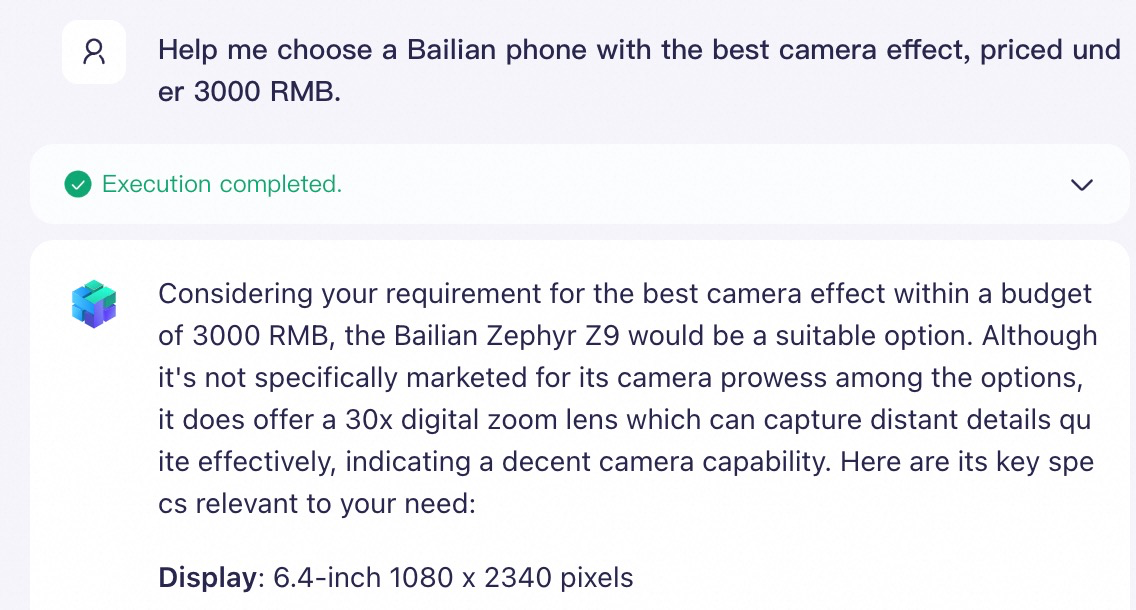 |
Modelos suportados
Os modelos a seguir podem ser usados com uma base de conhecimento. Configure o Qwen para usar uma base de conhecimento
- Qwen-Max/Plus/Turbo
- QwenVL-Max/Plus
- Versão open source do Qwen (por exemplo, Qwen2.5)
Para obter uma lista atualizada dos modelos disponíveis, consulte a página Application Management ao criar uma aplicação.
Início rápido
Este guia de início rápido mostra como criar uma aplicação de perguntas e respostas com LLM sem código para responder a questões específicas de domínio, usando "celulares do Alibaba Cloud Model Studio" como exemplo.
1. Criar uma base de conhecimento
- Acesse a página Knowledge Base e clique em Create Knowledge Base. Insira um Name e uma Description, mantenha as demais configurações com os valores padrão e clique em Next Step.
- Selecione a Default Category e faça upload do arquivo Alibaba Cloud Model Studio Phone Series Product Introduction.docx. Clique em Next Step e, em seguida, clique em Complete.
2. Integrar com aplicações de negócios
Após criar uma base de conhecimento, associe-a a uma aplicação do Alibaba Cloud Model Studio ou a uma aplicação externa dentro do mesmo workspace para processar solicitações de recuperação.
- Agent application
- Workflow application
- External application
- Acesse a página App Center, localize sua agent application, clique em Configure no cartão correspondente e selecione um modelo para a aplicação.
-
Clique no ícone + ao lado de Document Knowledge Base para adicionar a base de conhecimento recém-criada. Mantenha os valores padrão para o limiar de similaridade e peso.
(Opcional) Limiar de similaridade: Filtrar resultados de recuperação
Uma base de conhecimento utiliza busca semântica para encontrar texto conceitualmente relevante em seus dados ou arquivos privados, mesmo sem palavras-chave correspondentes.Por exemplo, um usuário envia a seguinte consulta:Qual celular da Alibaba Cloud é melhor para fotografia?A resposta real (por exemplo, "Qwen Vivid 7...") não contém nenhuma palavra-chave da consulta.Na tabela abaixo, a similaridade de palavras-chave é calculada usando o índice de Jaccard , e a similaridade semântica é a similaridade de cosseno calculada pelo modelo
text-embedding-v4.
Limiar de similaridade: Apenas textos com pontuação de similaridade semântica superior a este valor são recuperados. Definir esse limiar muito alto pode filtrar textos relevantes.Texto recuperado
Similaridade de palavras-chave
Similaridade semântica
Qwen Vivid 7: Uma nova experiência em fotografia inteligente
0
0,43
Alibaba Cloud Model Studio Ace Ultra: A escolha para gamers
0,17
0,32
Alibaba Cloud Model Studio Flex Fold+: Uma nova era de telas dobráveis
0,25
0,24
(Opcional) Peso: Influenciar a ordem de recuperação de múltiplas bases de conhecimento
Quando uma agent application está associada a várias bases de conhecimento, atribua um peso a cada uma com base na importância da fonte de informação. Durante a recuperação de múltiplas fontes, se chunks de diferentes bases de conhecimento tiverem a mesma pontuação de similaridade, o sistema prioriza chunks da base de conhecimento com maior peso.- Limitação principal: O peso só tem efeito entre bases de conhecimento do mesmo tipo. Por exemplo, o peso de uma base de conhecimento de busca de documentos não afeta a ordem de recuperação de uma base de conhecimento de consulta de dados, e vice-versa.
- Funcionamento: O sistema calcula primeiro a relevância da consulta do usuário em relação ao conteúdo de cada base de conhecimento para identificar os chunks mais relevantes. Em seguida, multiplica a pontuação de similaridade de cada chunk pelo peso de sua base de conhecimento correspondente. Após o reranking baseado nessas pontuações ponderadas, os resultados são fornecidos ao LLM como contexto, garantindo que chunks com maiores pontuações ponderadas tenham prioridade na resposta final.
-
Na caixa de entrada à direita, insira uma pergunta. O LLM usará a base de conhecimento para gerar uma resposta.
Por exemplo: "Ajude-me a escolher o celular do Alibaba Cloud Model Studio com a melhor câmera por menos de 3.000 CNY."
Estratégia de geração em lote: Quando você precisa que uma agent application gere um grande volume de conteúdo a partir de uma base de conhecimento, como perguntas de quiz ou resumos, uma única solicitação pode retornar menos itens do que o solicitado porque o comprimento de saída de uma resposta do LLM é limitado. Divida a solicitação em vários lotes de cerca de 30 itens cada e conclua-os em múltiplos turnos. Por exemplo, envie primeiro "Gere as perguntas 1-30 com base na base de conhecimento" e, após a conclusão desse lote, envie "Continue com as perguntas 31-60". Referência medida: uma única solicitação para 100 perguntas retornou apenas cerca de 24 perguntas, enquanto três lotes de 30 perguntas cada retornaram todas as 30 perguntas por lote, totalizando 90 perguntas. O número real de itens gerados varia conforme o modelo selecionado e o comprimento do conteúdo, portanto use seus próprios testes como referência final.
3. Otimizar o desempenho de RAG (Opcional)
Caso receba resultados incompletos ou imprecisos no processo de perguntas e respostas, consulte Otimização de desempenho de RAG.
Guia prático
Na página de base de conhecimento, visualize e gerencie todas as bases de conhecimento no workspace atual.
ID da base de conhecimento: O ID de cada base de conhecimento, utilizado para chamadas de API.
- Criar uma base de conhecimento
- Atualizar uma base de conhecimento
- Editar base de conhecimento
- Excluir uma base de conhecimento
- Alterar configuração
- Teste de acerto
- Na página de base de conhecimento, clique em Create Knowledge Base.
-
Informações básicas
Selecione um Knowledge Base Type conforme seu caso de uso. Uma única base de conhecimento suporta apenas um tipo. Se selecionar o tipo document search, escolha também um caso de uso: Basic document Q&A, Rich-text Reply.
- Basic document Q&A: Ideal para busca semântica em documentos de texto simples.
- Rich-text Reply: Recomendado para casos de uso que exigem respostas contendo texto e imagens.
Não é possível alterar o tipo da base de conhecimento após sua criação.
-
Document search
-
Casos de uso:
- Projetado para recuperar informações de dados não estruturados, como documentos corporativos internos e manuais de produtos. Dados não estruturados são informações não organizadas em um modelo ou esquema predefinido, podendo incluir texto, tabelas e imagens.
- Se seus arquivos contêm imagens que devem ser incluídas nas respostas da aplicação, selecione document search.
-
Fonte de dados: Faça upload de arquivos locais ou importe-os do Object Storage Service (OSS).
Criação de busca de documentos
-
Selecionar dados: Especifique uma fonte de dados (arquivos ou conteúdo) para a base de conhecimento. O sistema importa o conteúdo da fonte para a base de conhecimento visando a recuperação. Utilize upload local ou importação da nuvem (selecionando uma categoria ou arquivo existente).
-
Upload local: Carregue arquivos diretamente do seu computador. Expanda o painel retrátil abaixo para saber como selecionar um método de parsing.
Métodos de parsing
Configure a estratégia de parsing conforme suas necessidades. Se não tiver certeza sobre qual opção escolher, recomendamos usar as configurações padrão.- Digital Parsing: Não analisa ilustrações ou gráficos nos arquivos. Este é o método de parsing mais rápido. Um documento de texto simples de 10 a 20 páginas é geralmente processado em alguns segundos a 1 minuto.
- Intelligent Document Parsing: Reconhece e extrai texto de ilustrações nos arquivos para gerar resumos textuais. Esses resumos, juntamente com outro conteúdo não imagético, são divididos em chunks e vetorizados para recuperação. Este método é relativamente rápido. Um documento de 10 a 20 páginas com ilustrações leva normalmente de 1 a 5 minutos para ser processado.
- LLM Parsing: Permite que aplicações usando o modelo Qwen-VL respondam a perguntas sobre o conteúdo de ilustrações e gráficos nos arquivos. Para ativar o reconhecimento e compreensão desse conteúdo, selecione LLM Parsing. Como este método chama um LLM para compreensão profunda, um documento de 10 a 20 páginas com gráficos leva tipicamente de 2 a 10 minutos para ser processado.
- Parsing Qwen-VL: Projetado especificamente para arquivos de imagem. Especifique um modelo Qwen-VL e forneça um prompt para orientar o reconhecimento e extração do layout e elementos da imagem. Uma única imagem é geralmente processada em alguns segundos a 1 minuto.
- Importação da nuvem: Importe arquivos existentes de Object Storage Service (OSS).
-
Upload local: Carregue arquivos diretamente do seu computador. Expanda o painel retrátil abaixo para saber como selecionar um método de parsing.
-
Configuração de índice: Define como os dados importados são processados e armazenados, afetando diretamente o desempenho da recuperação.
Dentre as configurações a seguir, apenas o armazenamento vetorial com AnalyticDB for PostgreSQL (ADB-PG) pode gerar custos. Todas as outras configurações são gratuitas.
- Extração de metadados
- Montagem de cabeçalho Excel
- Método de chunking
- Reescrita de conversa em múltiplas rodadas
- Modelo de embedding
- Modelo de reranking
- Limiar de similaridade
- Contagem máxima de recuperação
- Armazenamento vetorial
Metadados consistem em atributos adicionais para dados não estruturados, integrados aos chunks como pares chave-valor.- Finalidade: Metadados fornecem contexto importante para chunks e podem melhorar significativamente a precisão da recuperação da base de conhecimento. Por exemplo, considere uma base de conhecimento contendo milhares de arquivos de introdução de produtos onde o nome do arquivo é o nome do produto. Quando um usuário busca por "visão funcional do Produto A", se o corpo de todos os arquivos contiver "visão funcional", mas nenhum mencionar "Produto A", a base de conhecimento poderá recuperar muitos chunks irrelevantes. No entanto, se você adicionar o nome do produto como metadado a todos os chunks, a base de conhecimento filtrará com precisão os chunks relacionados ao "Produto A" que também contenham "visão funcional". Isso melhora a precisão da recuperação e reduz o consumo de tokens de entrada do LLM.
- Uso: Ao chamar uma aplicação via API, especifique
metadatano parâmetro de solicitaçãometadata_filter. Quando a aplicação recupera informações da base de conhecimento, ela filtra primeiro os arquivos relevantes com base nosmetadataespecificados. - Nota: Não é possível configurar a extração de metadados após a criação da base de conhecimento.
Configuração de metadados
Ative Metadata extraction e clique em Settings para anexar metadados uniformes ou personalizados a todos os arquivos na base de conhecimento. Durante o chunking, os metadados de cada arquivo são integrados aos respectivos chunks.Novo modelo de metadados
Métodos de extração de valores-
Constante: Anexa um atributo fixo a todos os arquivos na base de conhecimento.
Conforme mostrado no exemplo anterior, se todos os arquivos na base de conhecimento tiverem o mesmo autor, defina uma constante para um campo chamado
author. -
Variável: Anexa um atributo variável a cada arquivo na base de conhecimento. Os atributos suportados atualmente são
file_nameecat_name. Se selecionarfile_name, o Alibaba Cloud Model Studio anexa o nome do arquivo aos seus metadados, conforme o exemplo anterior. Se selecionarcat_name, o Alibaba Cloud Model Studio anexa o nome da categoria que contém o arquivo aos metadados do arquivo. -
LLM: O sistema compara o conteúdo do arquivo com a regra Entity Description configurada, extrai as informações relevantes e as anexa como atributo de metadado.
Conforme mostrado no modelo de metadados do exemplo anterior, para extrair todos os anos que aparecem em cada arquivo como atributos de arquivo, configure um campo LLM chamado
Na caixa de entrada Entity Description, insiradate. A descrição da entidade é configurada da seguinte forma:informações de data, extraia apenas o anoe clique em OK. -
RegEx: O sistema compara o conteúdo textual de cada arquivo na base de conhecimento com a expressão regular especificada. O conteúdo correspondente à expressão é extraído e adicionado como atributo aos metadados do arquivo.
Conforme mostrado no modelo de metainformações do exemplo acima, se precisar extrair todas as referências que aparecem em cada arquivo (assumindo que uma referência seja qualquer texto começando com '《' e terminando com '》'), configure um campo de expressão regular chamado
Defina o valor da expressão regular comoreference. A expressão regular é configurada da seguinte forma:《.*?》. -
Busca por palavras-chave: O sistema pesquisa palavras-chave predefinidas em cada arquivo e adiciona as palavras-chave correspondentes como atributos aos metadados do arquivo.
Por exemplo, no modelo de metadados do exemplo anterior, as palavras-chave predefinidas são:
Como o arquivo contém apenas as palavras-chave "financiamento", "indústria", "verde" e "capital", o sistema extrai apenas essas quatro palavras-chave como valor para o atributo
keywordsdo arquivo.
Criação de compreensão visual
Ao selecionar o caso de uso visual understanding (rich-text documents), a base de conhecimento usa um modelo de embedding multimodal para compreender visualmente os documentos e preservar as informações originais de layout, em vez de usar métodos tradicionais de fragmentação.Restrições de formato de arquivo
Na área de upload de arquivos da aba Select data, passe o mouse sobre View format requirements para visualizar os requisitos.Diferenças na configuração de índice
A configuração de índice para o caso de uso de compreensão visual difere daquela para Basic document Q&A:- Modelo de embedding: O modelo qwen3-vl-embedding é selecionado automaticamente e não pode ser alterado após a criação.
- Reescrita de conversa em múltiplas rodadas: Pode ser ativada ou desativada.
- Limiar de similaridade: O padrão é 0,20.
- Contagem máxima final de recuperação: O padrão é 5.
- Método de fragmentação: A compreensão visual não usa métodos tradicionais de fragmentação, como fragmentação inteligente ou personalizada. Em vez disso, ela compreende toda a página do documento com base na indexação visual.
Restrições de edição
- O modelo de embedding (qwen3-vl-embedding) e o tipo de armazenamento vetorial (built-in) não podem ser alterados após a criação.
- Você pode alterar a edição da base de conhecimento apenas uma vez por dia.
-
Selecionar dados: Especifique uma fonte de dados (arquivos ou conteúdo) para a base de conhecimento. O sistema importa o conteúdo da fonte para a base de conhecimento visando a recuperação. Utilize upload local ou importação da nuvem (selecionando uma categoria ou arquivo existente).
-
Casos de uso:
-
Data query
-
Casos de uso:
- Ideal para construir sistemas de Q&A baseados em dados estruturados (dados organizados de acordo com um esquema de tabela predefinido), como assistentes para consultar FAQs, dados de produtos ou informações de pessoal.
-
Se seus dados consistem em pares completos de perguntas e respostas de FAQ, selecione Data Query. Por exemplo, se um arquivo Excel contiver duas colunas,
QuestioneAnswer, uma base de conhecimento Data Query pode usar a colunaQuestionpara recuperação e a colunaAnswercomo contexto para a resposta do LLM.Este processamento específico por coluna não está disponível no tipo de base de conhecimento de busca de documentos.
- É possível importar vários arquivos Excel, mas seus esquemas de tabela devem ser idênticos.
-
Integração de fonte de dados: Faça upload de arquivos XLS ou XLSX locais .
Criação de Data query
-
Selecionar dados: Especifique uma fonte de dados (arquivos ou conteúdo) para a base de conhecimento. O sistema importa o conteúdo da fonte para a base de conhecimento para recuperação. Use upload local ou importação cloud.
A fonte de dados não pode ser alterada após a criação da base de conhecimento. Uma única base de conhecimento suporta apenas uma fonte de dados.
- Upload local: Faça upload de tabelas de dados nos formatos XLS ou XLSX do seu computador. A primeira linha deve ser o cabeçalho da tabela.
- Importação cloud (selecionar tabela de dados): Selecione uma tabela de dados existente de um conector de dados do Alibaba Cloud Model Studio .
-
Configuração de índice: Define como os dados importados são processados e armazenados, o que afeta diretamente o desempenho da recuperação.
Entre as configurações a seguir, apenas o armazenamento vetorial com AnalyticDB for PostgreSQL (ADB-PG) pode gerar taxas. Todas as outras configurações são gratuitas.
- Configurações de recuperação e resposta
- Reescrita de conversa em múltiplas rodadas
- Modelo de embedding
- Modelo de reranking
- Limiar de similaridade
- Contagem máxima de recuperação
- Armazenamento vetorial
- Used for Retrieval: Se ativado, a base de conhecimento executa a recuperação nesta coluna.
- Used for Model Reply: Se ativado, os resultados da recuperação desta coluna são fornecidos ao LLM como contexto para geração de resposta. Por exemplo, se você ativar Used for Retrieval para as colunas "Nome", "Gênero", "Cargo" e "Idade", mas ativar Used for Model Reply apenas para as colunas "Nome" e "Cargo", a base de conhecimento recuperará dados de todas as quatro colunas. No entanto, apenas o conteúdo das colunas "Nome" e "Cargo" dos dados recuperados será fornecido ao LLM como contexto para sua resposta. Como a coluna "Idade" não está ativada para respostas do modelo, o LLM associado a esta base de conhecimento não pode responder à pergunta "Qual é a idade de Zhang San?".
-
Selecionar dados: Especifique uma fonte de dados (arquivos ou conteúdo) para a base de conhecimento. O sistema importa o conteúdo da fonte para a base de conhecimento para recuperação. Use upload local ou importação cloud.
-
Casos de uso:
-
Image Q&A
-
Casos de uso:
- Mais indicado para construir aplicações de recuperação multimodal que suportam busca por imagem e busca por imagem mais texto, como assistentes de descoberta de produtos ou assistentes visuais de Q&A.
-
Integração de fonte de dados: Faça upload de arquivos XLS ou XLSX locais .
Arquivos XLS e XLSX devem conter URLs de imagem publicamente acessíveis para criar índices de imagem. Para detalhes, consulte as instruções de criação abaixo.
Criação de Image Q&A
-
Selecionar dados: Especifique uma fonte de dados (arquivos ou conteúdo) para importar para a base de conhecimento para recuperação. Use upload local ou importação cloud (selecione uma tabela de dados existente de um conector de dados).
A fonte de dados não pode ser alterada após a criação, e uma única base de conhecimento suporta apenas uma fonte de dados.
-
Upload local: Faça upload de tabelas de dados nos formatos XLS ou XLSX diretamente do seu computador.
- Requisito de campo: A tabela de dados deve conter pelo menos um campo do tipo
image_urlpara gerar o índice de imagem. - Processo de construção: A base de conhecimento acessa a URL da imagem no campo
image_url, extrai recursos visuais e os converte em vetores para armazenamento. - Processo de recuperação: A base de conhecimento compara o vetor gerado a partir da imagem carregada pelo usuário com os vetores de imagem armazenados e retorna os registros mais relevantes.
- Requisito de campo: A tabela de dados deve conter pelo menos um campo do tipo
- Importação cloud (selecionar uma tabela de dados): Selecione uma tabela de dados existente dos dados do seu aplicativo no Alibaba Cloud Model Studio.
-
Upload local: Faça upload de tabelas de dados nos formatos XLS ou XLSX diretamente do seu computador.
-
Configuração de índice: Define como os dados importados são processados e armazenados, o que afeta diretamente o desempenho da recuperação.
Entre as configurações a seguir, apenas o armazenamento vetorial com AnalyticDB for PostgreSQL (ADB-PG) pode gerar taxas. Todas as outras configurações são gratuitas.
- Configurações de recuperação e resposta
- Reescrita de conversa em múltiplas rodadas
- Modelo de embedding
- Modelo de reranking
- Limiar de similaridade
- Contagem máxima de recuperação
- Armazenamento vetorial
- Used for Retrieval: Se ativado, a base de conhecimento executa a recuperação nesta coluna.
- Used for Model Reply: Se ativado, os resultados da recuperação desta coluna são fornecidos ao LLM como contexto para geração de resposta. Por exemplo, se você ativar Used for Retrieval para as colunas "Nome", "Gênero", "Cargo" e "Idade", mas ativar Used for Model Reply apenas para as colunas "Nome" e "Cargo", a base de conhecimento recuperará dados de todas as quatro colunas. No entanto, apenas o conteúdo das colunas "Nome" e "Cargo" dos dados recuperados será fornecido ao LLM como contexto para sua resposta. Como a coluna "Idade" não está ativada para respostas do modelo, o LLM associado a esta base de conhecimento não pode responder à pergunta "Qual é a idade de Zhang San?".
-
Selecionar dados: Especifique uma fonte de dados (arquivos ou conteúdo) para importar para a base de conhecimento para recuperação. Use upload local ou importação cloud (selecione uma tabela de dados existente de um conector de dados).
-
Casos de uso:
 para baixar os dados no formato XLSX.
 no canto superior esquerdo da tabela de dados e confirme o prompt para sincronizar o conteúdo mais recente da tabela de dados com a base de conhecimento.
 em seu cartão e, em seguida, clique em Edit. Observação: Modifique a configuração de uma base de conhecimento apenas uma vez por dia civil. Tentativas subsequentes serão rejeitadas silenciosamente.
 Ícone: Para uma base de conhecimento de Q&A de imagens, o sistema primeiro converte a imagem de entrada em um vetor e recupera segmentos relevantes. Em seguida, envia esses segmentos junto com a pergunta para um LLM gerar uma resposta. Para bases de conhecimento de busca de documentos, consulta de dados , o sistema não usa a imagem carregada para recuperação. No entanto, uma base de conhecimento de busca de documentos configurada para "compreensão visual" usa a imagem para recuperação, suportando modos de consulta apenas texto, apenas imagem e imagem+texto. Essa consulta combinada pode melhorar a relevância da recuperação.

Cotas e limites
- Para informações sobre fontes de dados suportadas, capacidade e outros limites para uma base de conhecimento, consulte Cotas e limites da base de conhecimento.
-
Os seguintes limites se aplicam ao associar bases de conhecimento a uma aplicação do Model Studio:
- Busca de documentos: Até 5
- Consulta de dados: Até 5
- Q&A de Imagens: Até 1
Faturamento
O uso do recurso de base de conhecimento é gratuito, mas podem ser aplicadas cobranças ao chamar uma aplicação do Alibaba Cloud Model Studio que utilize esse recurso.
| Etapa | Faturamento | |
|---|---|---|
| Criar uma base de conhecimento | Gratuito. | |
| Integrar a aplicações de negócios | Ao chamar uma aplicação do Alibaba Cloud Model Studio, os trechos de texto recuperados da base de conhecimento aumentam a contagem de tokens de entrada do LLM, o que eleva as taxas de inferência do modelo. Para mais informações, consulte Itens faturáveis e preços.Nota: Não há cobrança se você utilizar apenas a Retrieve API para recuperação, sem usar uma aplicação do Alibaba Cloud Model Studio para gerar uma resposta. | |
| Gestão e O&M | Gratuito. | |
Referência de API
- Consulte o diretório de APIs (Base de Conhecimento) para obter a lista completa de APIs de base de conhecimento e seus parâmetros.
- Consulte o guia da API de Base de Conhecimento para instruções detalhadas de uso e exemplos de código.
FAQ
Criação de base de conhecimento
P: Posso excluir um arquivo ou tabela de dados dos Dados da Aplicação após importá-lo para uma base de conhecimento?
P: Posso excluir um arquivo ou tabela de dados dos Dados da Aplicação após importá-lo para uma base de conhecimento?
- Para bases de conhecimento de busca de documentos: Sim. Os arquivos em uma base de conhecimento são independentes de sua origem nos Dados da Aplicação. Excluir o arquivo de origem não afeta os dados importados.
- Para bases de conhecimento de consulta de dados e Perguntas e Respostas com Imagens: Não. Excluir os dados de origem interrompe funcionalidades como sincronização de dados e visualização da base de conhecimento.
P: O que fazer se uma chamada de API de base de conhecimento retornar o código de erro BailianIndexServiceNotOpen?
P: O que fazer se uma chamada de API de base de conhecimento retornar o código de erro BailianIndexServiceNotOpen?
BailianIndexServiceNotOpen indica que o serviço de base de conhecimento do Model Studio não foi ativado. Faça login no console do Model Studio, acesse a página Data > Knowledge Base e clique em Activate Now para ativar o serviço. Em seguida, tente realizar a chamada de API novamente.Tratamento de imagens e conteúdo multimodal
P: Meu arquivo contém ilustrações que desejo incluir nas respostas da aplicação do Model Studio. Como proceder?
P: Meu arquivo contém ilustrações que desejo incluir nas respostas da aplicação do Model Studio. Como proceder?
- Busca de documentos
- Perguntas e Respostas com Imagens
Método 1 (Apenas para aplicações de agente)
Método 1 (Apenas para aplicações de agente)
-
Ao criar uma base de conhecimento, defina o Knowledge Base Type como document search e a opção With Illustrations como With Illustrations.
Ao selecionar With Illustrations, a base de conhecimento extrai resumos das ilustrações presentes no arquivo. O modelo de linguagem grande decide então se deve inserir uma imagem com base na relevância do resumo para a pergunta do usuário.
-
Ao criar ou editar uma aplicação de agente, selecione o modelo Qwen-Plus ou Qwen-Plus-Latest (testes indicam que esses modelos oferecem o melhor desempenho). Clique no botão + à direita de Document Knowledge Base e adicione a base de conhecimento criada na etapa anterior.
O comprimento de recall deve ser menor que o comprimento do documento. Caso contrário, o sistema retorna o documento inteiro e ignora a lógica de With Illustrations.
Nota: Os recursos "With Illustrations" e "Show Answer Source" não podem ser ativados simultaneamente.
-
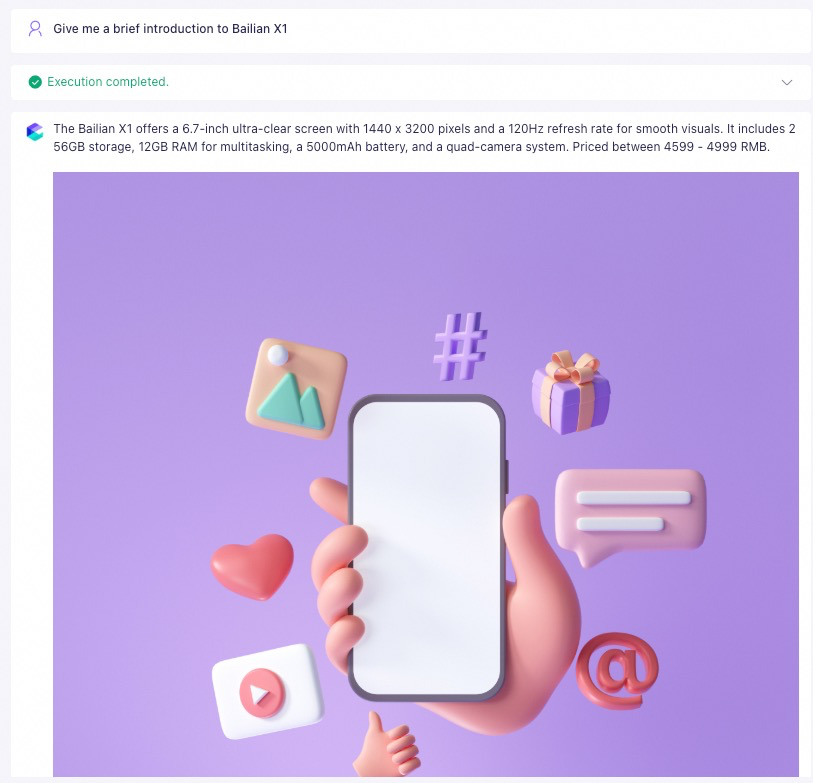
Resultado real de perguntas e respostas:
Método 2 (Para aplicações de agente e workflow)
Método 2 (Para aplicações de agente e workflow)
- Faça upload da imagem para um local publicamente acessível e obtenha sua URL completa. Recomendamos o uso do OSS. Para instruções, consulte Fazer upload de uma imagem para o OSS e usar sua URL de arquivo.
-
Insira a URL completa no arquivo. Caminhos relativos não são suportados. Não incorpore arquivos de imagem diretamente no documento (por exemplo, copiando e colando ou inserindo uma imagem local via menu). As imagens devem ser referenciadas por meio de suas URLs publicamente acessíveis.
Se uma imagem falhar ao ser exibida, verifique se a URL no trecho está completa. Remova espaços extras ou caracteres especiais que possam causar erros de análise. Edite o trecho diretamente para fazer essas correções.
Exemplo de referência correta de imagem em um arquivo Modelo de prompt de exemplo Resultado real de perguntas e respostas 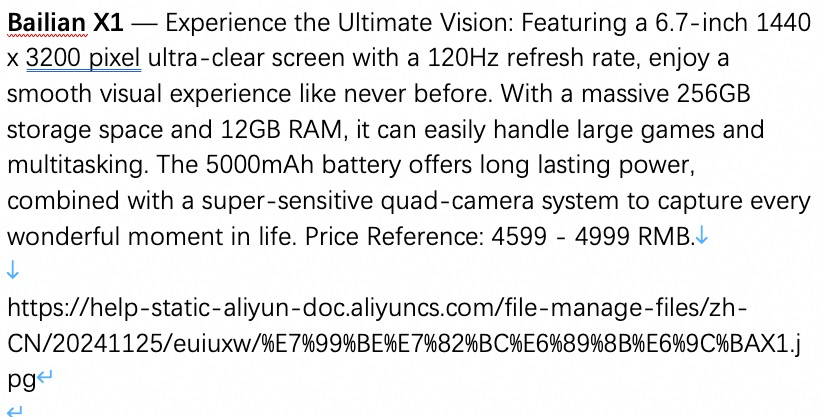
Exemplo de referência incorreta de imagem em um arquivo Modelo de prompt de exemplo Resultado real de perguntas e respostas 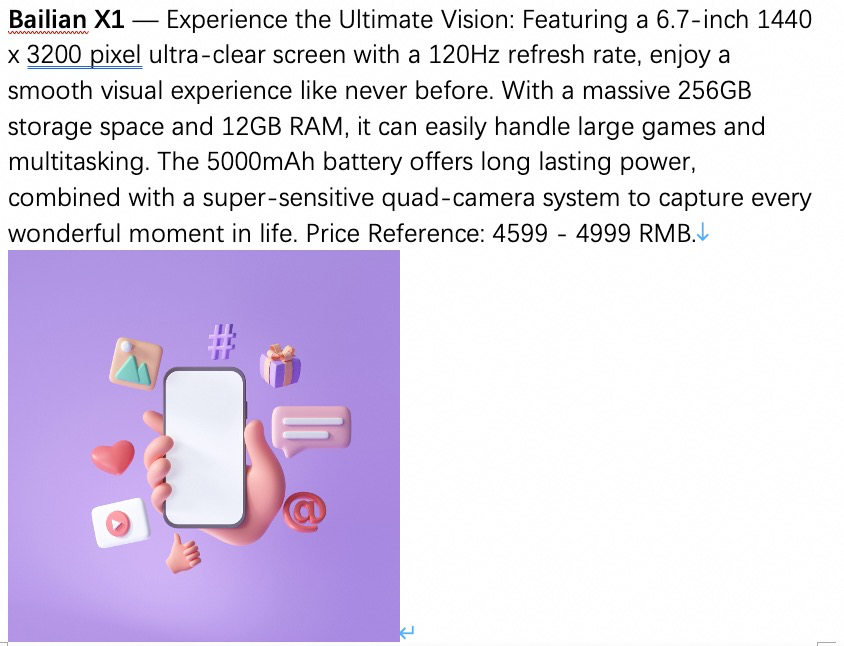
Na interface de teste de chat, após inserir um prompt, a resposta da IA retorna apenas conteúdo de texto simples, sem imagens.Explicação: Quando uma imagem é incorporada diretamente em um arquivo, a aplicação do Model Studio não a exibe na resposta.
Permissões e segurança
P: O que fazer se eu receber um erro de "Missing permissions for this module" ao gerenciar uma base de conhecimento?
P: O que fazer se eu receber um erro de "Missing permissions for this module" ao gerenciar uma base de conhecimento?
Administrator ou incluir pelo menos as permissões Application Data-Actions e Knowledge Base-Actions.P: Uma base de conhecimento é privada? Outras organizações ou usuários podem acessá-la?
P: Uma base de conhecimento é privada? Outras organizações ou usuários podem acessá-la?
P: A Alibaba Cloud usará as bases de conhecimento da minha conta para responder a perguntas de outros usuários?
P: A Alibaba Cloud usará as bases de conhecimento da minha conta para responder a perguntas de outros usuários?
Migração e exportação
P: Como exportar uma base de conhecimento para minha máquina local?
P: Como exportar uma base de conhecimento para minha máquina local?