

Ce tutoriel utilise Android pour montrer comment intégrer le SDK client AOQ avec qwen3.8-livetranslate-flash-realtime afin d'assurer une traduction vocale en temps réel. Les autres plateformes utilisent des flux d'intégration et de gestion des événements modèles similaires, avec leurs méthodes SDK respectives. Tous les exemples côté client ci-dessous utilisent Java.
Pour les capacités du modèle, consultez Traduction vocale et audio/vidéo en temps réel. Pour les rôles des médias et des événements du modèle, consultez Connexion AOQ.
Télécharger le SDK
Pour le SDK client AOQ et le plugin audio Opus, consultez Téléchargement du SDK. Les exemples de transmission audio de ce tutoriel utilisent Opus, vous devez donc également importer le plugin correspondant à votre plateforme. Pour les régions prises en charge, les langues, les tarifs et les limites de débit, voir Traduction vocale et audio/vidéo en temps réel.
Importer le SDK
- Android
- iOS
- HarmonyOS
Placez Si le projet hôte contient déjà des bibliothèques natives portant les mêmes noms, vérifiez leurs versions et dépendances avant leur empaquetage afin d'éviter d'inclure différentes versions d'une même bibliothèque.Déclarez les autorisations dans Demandez l'autorisation
AoqClientSdk-release.aar dans app/libs/. Placez libPluginOpus.so dans app/libs/armeabi-v7a/ et app/libs/arm64-v8a/, selon l'ABI.Déclarez la dépendance dans app/build.gradle :AndroidManifest.xml :RECORD_AUDIO au moment de l'exécution et obtenez l'autorisation de l'utilisateur. La traduction vocale seule ne nécessite pas l'autorisation de la caméra. Déclarez et demandez l'autorisation CAMERA uniquement lorsque vous activez l'amélioration visuelle.Les exemples Java utilisent les importations suivantes :Obtenir un jeton via votre AppServer
Ne stockez pas la clé API Model Studio sur le client. Votre AppServer utilise la clé API correspondant à la région et à l'espace de travail pour demander des informations d'identification temporaires pour chaque connexion de traduction. Il renvoie ces informations d'identification via HTTPS à un client ayant passé l'authentification de votre application.
Configurez un AppServer selon les Étapes d’authentification AOQ de Qwen-LiveTranslate-Realtime. La traduction en temps réel utilise le protocole Realtime. Indiquez les éléments suivants lors de la demande d’informations de connexion :
BAILIAN_ENDPOINT comme point de terminaison de votre espace de travail : {WorkspaceId}.cn-beijing.maas.aliyuncs.com ou {WorkspaceId}.ap-southeast-1.maas.aliyuncs.com. Lisez DASHSCOPE_API_KEY depuis une variable d'environnement côté serveur ou un service de gestion des secrets.
clientIp dans le corps de la requête pour la planification du point d'accès.
Mappez les champs de réponse vers AoqConnectConfig sur le client :
| Champ de réponse de la passerelle | Champ du SDK | Description |
|---|---|---|
aoqTokenForClient | token | Jeton temporaire pour cette connexion |
sid | sid | Identifiant de cette session |
clientRelayCertFingerprint | certFingerprint | Utilisez l'empreinte du certificat exactement telle qu'elle est retournée |
clientRelayEndpoints | relayEndpoints | Convertissez la liste complète des points d'accès en structure du SDK |
extraInfo.workspaceIdHash | workspaceIdHash | Utilisez la valeur retournée. Si elle est absente, suivez les exigences du SDK |
Implémenter la traduction vocale en temps réel
Flux d'interaction
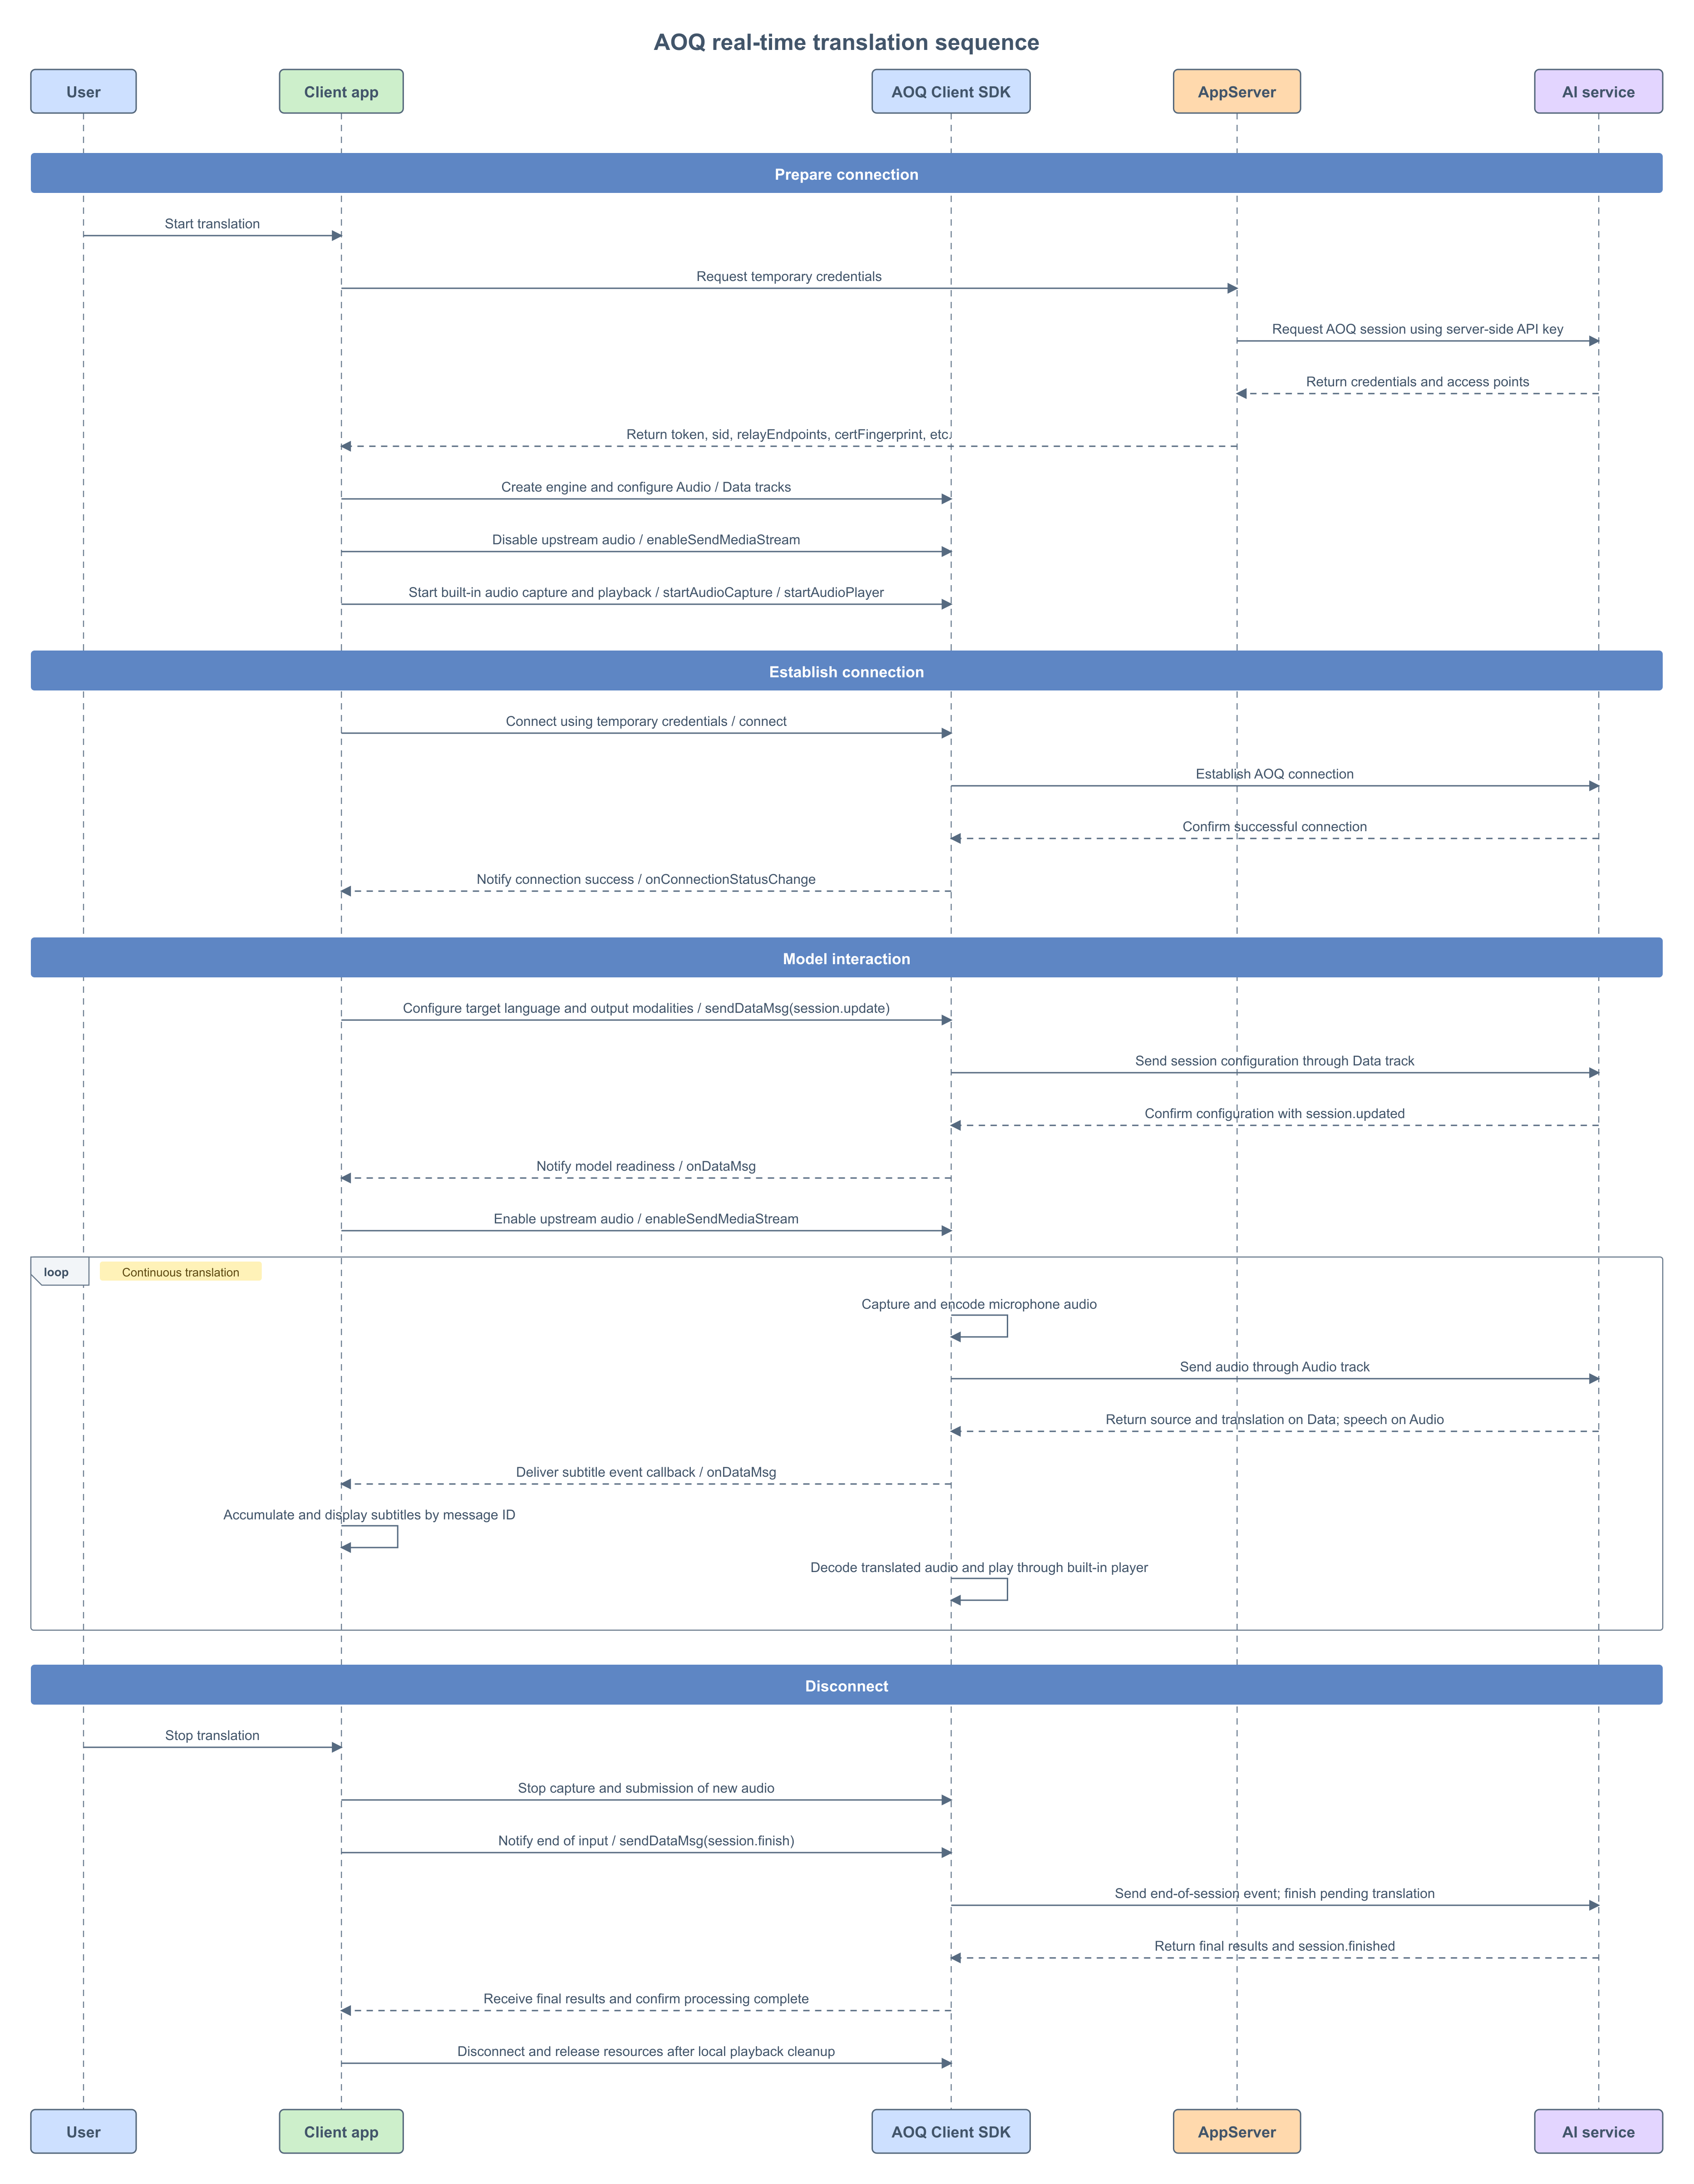
Créer le moteur et définir les rappels
Appelez createEngine pour créer le moteur et enregistrer les rappels pour l'état de la connexion, les messages Data et les erreurs. Votre application doit conserver les objets moteur et écouteur pendant toute la durée de la session.
AoqClientListener pour recevoir les événements de connexion, de message du modèle et de périphérique multimédia, et transmettez-le lors de la création du moteur.
Démarrer la capture et la lecture audio
Après avoir obtenu l'autorisation du microphone, préparez la capture et la lecture audio. Désactivez la transmission audio avant de démarrer la capture pour empêcher le moteur d'envoyer automatiquement du contenu multimédia après la connexion.
Démarrer la capture ne signifie pas que le modèle est prêt à recevoir de l'audio. Incitez l'utilisateur à parler uniquement après avoir reçu session.updated et activé avec succès la transmission. Ce tutoriel n'implémente pas la mise en mémoire tampon audio avant la connexion.
Configurer les codecs et établir la connexion
Le scénario principal nécessite les pistes suivantes :
| Direction | Piste | Objectif |
|---|---|---|
| Publier | Audio | Envoyer la parole au modèle |
| Publier | Données | Envoyer la configuration de session et les événements de fin |
| S'abonner | Audio | Recevoir la parole traduite |
| S'abonner | Données | Recevoir le texte source, le texte traduit et les événements d'état |
connect signifie que l'appel a été accepté. Attendez que onConnectionStatusChange signale une connexion réussie avant d'envoyer la configuration du modèle.
Configurer la session de traduction
Après la connexion, envoyez l'événement suivant session.update via la piste Data. Cette configuration utilise la voix par défaut et n'active pas le clonage vocal :
session.update, voir Événements client de traduction en temps réel.
Codez le JSON en octets UTF-8 et envoyez-le avec sendDataMsg.
Activer la transmission multimédia après réception de session.updated
Analysez le type d'événement dans onDataMsg.
L'extrait de code suivant achemine les événements de contrôle. Pour les événements de texte source et texte traduit, voir Événements serveur. Après avoir reçu session.finished, définissez l'état de fin de votre application et utilisez la méthode de libération décrite dans « Déconnexion et destruction du moteur » pour effectuer le nettoyage.
Différences entre AOQ et WebSocket : cet exemple envoie et reçoit l’audio directement sur les pistes Audio. N’envoyez pas
input_audio_buffer.append pour transmettre une deuxième fois le même audio, et ne copiez pas l’exemple WebSocket en démarrant un autre lecteur à la réception de response.audio.delta. L’audio traduit est géré par l’abonnement audio et le lecteur du SDK. La piste Data transporte les sous-titres et les événements du modèle. Pour l’utilisation des pistes de médias et Data, consultez Connexion AOQ.Terminer l'entrée et attendre la traduction finale
Lorsque l'utilisateur arrête la traduction, suivez cet ordre :
- Arrêtez la capture afin qu'aucune nouvelle entrée ne soit soumise.
- Après avoir finalisé l'entrée, désactivez l'audio montant et envoyez
session.finishune seule fois. Conservez la connexion AOQ, l'abonnement Data et la lecture audio actifs. - Continuez à recevoir le texte source final, le texte traduit et la parole traduite. Attendez
session.finished. - Déconnectez-vous et libérez les ressources selon votre politique locale de fin de lecture.
session.finish, voir Événements client de traduction en temps réel. Pour les champs et le sens de session.finished, voir Événements serveur de traduction en temps réel.
Déconnecter et détruire le moteur
Après réception de session.finished, le serveur a terminé le traitement de cette session. Cela ne signifie pas que le haut-parleur local a terminé la lecture du dernier segment audio. Si votre application doit lire toute la parole traduite, terminez la lecture locale avant d'exécuter les méthodes suivantes.