

Qwen-OCR es un modelo de comprensión visual que extrae texto y datos estructurados de imágenes: documentos escaneados, tablas, recibos y más. Maneja múltiples idiomas y admite tareas avanzadas de OCR: extracción de información, análisis de tablas, reconocimiento de fórmulas y análisis de documentos.
Ejemplos
| Imagen de entrada | Resultado del reconocimiento |
|---|---|
Reconocimiento de múltiples idiomas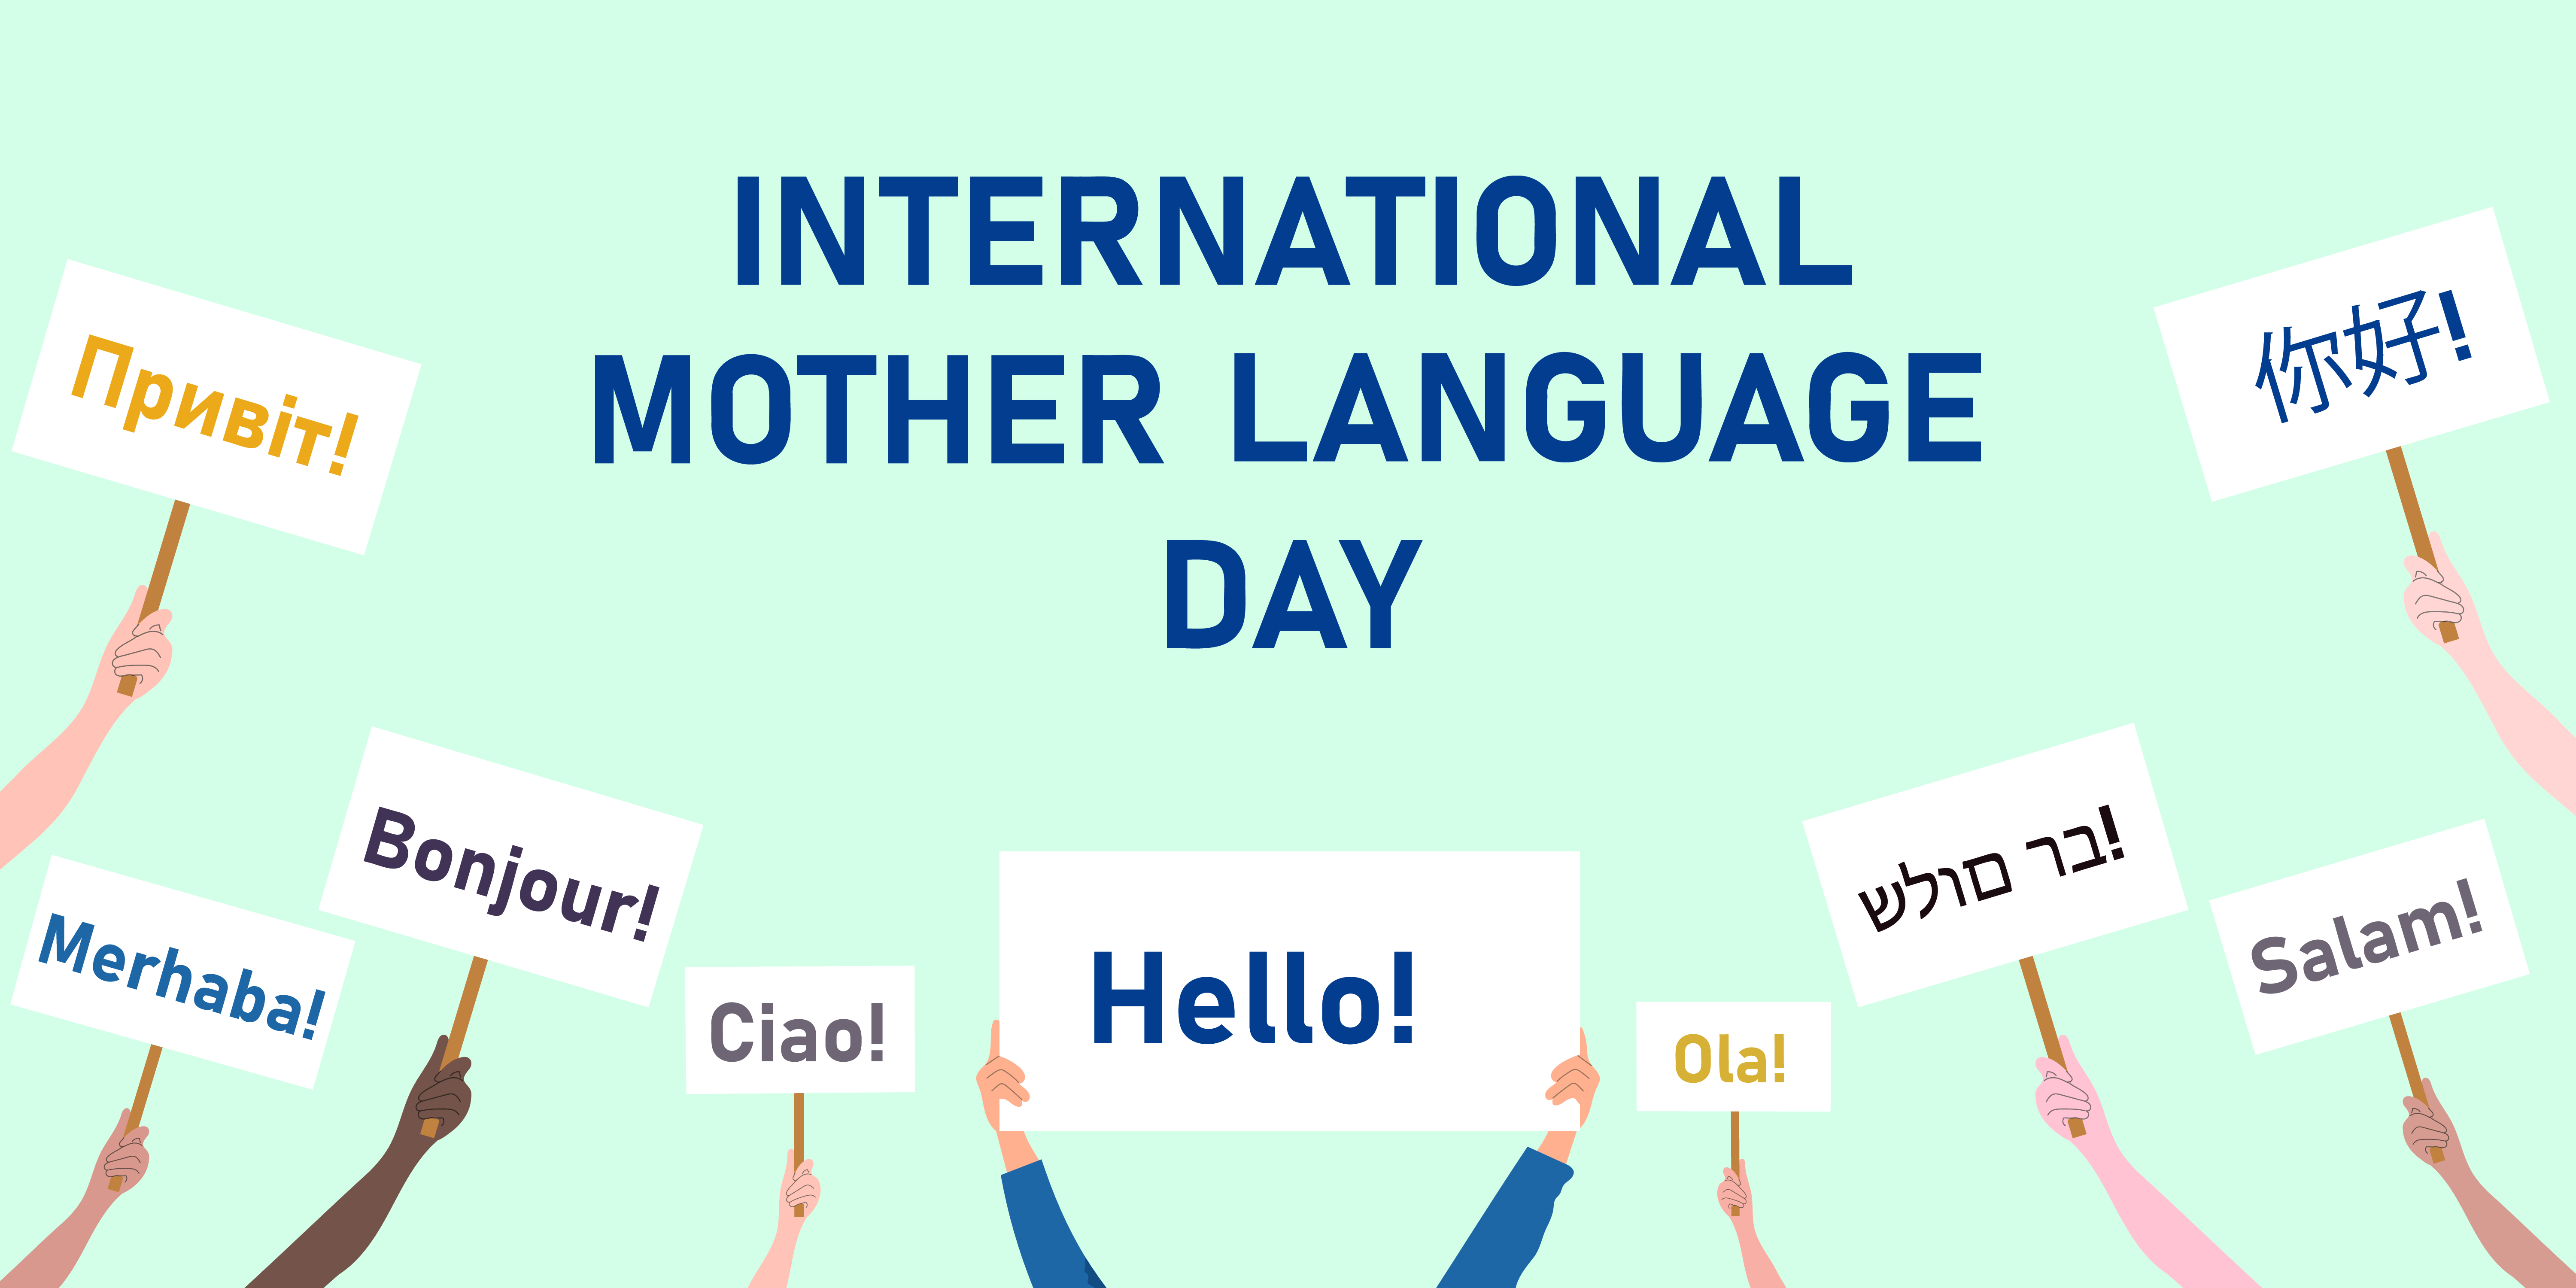 | INTERNATIONALMOTHER LANGUAGEDAYПривет!你好!Bonjour!Merhaba!Ciao!Hello!Ola!בר מולדSalam! |
Reconocer imágenes inclinadas | Introducción del productoFilamentos de fibra importados de Corea del Sur.6941990612023N.º de artículo: 2023 |
Localizar posición del texto La tarea de reconocimiento de alta precisión admite la localización de texto. | Visualización de la localización Consulte las Preguntas frecuentes sobre cómo dibujar el cuadro delimitador de cada línea de texto en la imagen original. |
Selección de modelo
Qwen-OCR proporciona los siguientes modelos. Elija según sus requisitos empresariales:
- Qwen3.5-OCR: Construido sobre la arquitectura Qwen3.5, con mejoras integrales en el análisis de documentos, la localización de texto y la extracción de información clave. Admite conversaciones de múltiples turnos y análisis de documentos PDF. Mejora significativamente la extracción de información de certificados comerciales (como tarjetas de identificación y licencias de conducir). Para consultar los tipos de certificados admitidos, vea Tipos de certificados y documentos admitidos. Incluye el modelo
qwen3.5-ocr. - Qwen-VL-OCR: Construido sobre la arquitectura Qwen3-VL. Admite tareas integradas que incluyen análisis de documentos, localización de texto (reconocimiento de alta precisión), extracción de información, análisis de tablas, reconocimiento de fórmulas, reconocimiento general de texto y reconocimiento multilingüe. También admite corrección de rotación de imágenes. Incluye los modelos
qwen-vl-ocr(estable) (más reciente) yqwen-vl-ocr-2025-11-20. - Versiones anteriores (no recomendadas): Estas versiones son inferiores a los modelos más nuevos tanto en funciones como en rendimiento. Recomendamos migrar a
qwen3.5-ocr. Incluye modelosqwen-vl-ocr-2024-10-28.
En los modelos qwen-vl-ocr, models, the , el parámetro max_tokens (longitud máxima de salida) tiene un valor predeterminado de 4096. Para aumentar este valor a un rango de 4097 a 8192, póngase en contacto con su gerente comercial y proporcione la siguiente información: su ID de cuenta de Alibaba Cloud, tipo de imagen (como imágenes de documentos, imágenes de comercio electrónico o contratos), nombre del modelo, consultas por segundo (QPS) estimadas y solicitudes diarias totales, y el porcentaje de solicitudes donde la longitud de salida del modelo excede los 4096 tokens.
Experiencia en línea: Visite la consola de Model Studio, seleccione la región objetivo en la esquina superior derecha y vaya a Modelos de visión para probar los modelos Qwen-OCR.
Preparativos
- Crear una clave API y configurarla como variable de entorno.
-
Si utiliza el SDK de OpenAI o el SDK de DashScope, instale la última versión del SDK. Versiones mínimas: SDK de Python de DashScope 1.22.2, SDK de Java 2.21.8.
-
SDK de DashScope
- Ventajas: Acceso completo a funciones avanzadas — corrección de rotación de imagen, tareas OCR integradas — con una API simple.
- Ideal para: Proyectos que necesitan el conjunto completo de funciones.
-
SDK compatible con OpenAI
- Ventajas: Reemplazo directo para integraciones existentes del SDK de OpenAI.
- Limitaciones: Las funciones avanzadas, como la corrección de rotación de imagen y las tareas OCR integradas, no se exponen directamente como parámetros. Simúlelas elaborando prompts y analizando la salida.
- Ideal para: Proyectos que ya utilizan OpenAI y no necesitan funciones exclusivas de DashScope.
-
SDK de DashScope
Introducción
El siguiente ejemplo extrae campos estructurados de una imagen de boleto de tren (URL) y devuelve los resultados como JSON. Para archivos locales, consulte cómo pasar un archivo local. Para restricciones de entrada, consulte limitaciones de imagen.
- Compatible con OpenAI-Chat
- Compatible con OpenAI-Response
- DashScope
Respuesta de ejemplo
Respuesta de ejemplo
Llamada a tareas integradas
Los modelos (excepto qwen-vl-ocr-2024-10-28) incluyen tareas integradas para escenarios comunes de OCR.
Cómo llamar a una tarea integrada:
- DashScope SDK: Configure el parámetro
ocr_optionspara llamar a tareas integradas. A partir deqwen3.5-ocr, las tareas integradas funcionan junto con su Prompt personalizado (ya no lo sobrescriben), y los resultados de las tareas integradas se devuelven en el campoocr_result. Los modelos anteriores utilizan unPromptinterno fijo. - SDK compatible con OpenAI: Pase el
Promptespecífico de la tarea manualmente en su mensaje.
task, un Prompt fijo, un formato de salida y un ejemplo de salida:
- Reconocimiento de alta precisión
- Extracción de información
- Análisis de tablas
- Análisis de documentos
- Reconocimiento de fórmulas
- Reconocimiento general de texto
- Reconocimiento multilingüe
qwen-vl-ocr-2025-11-20 o la versión más reciente (recomendado). Características:- Reconoce y extrae contenido de texto.
- Detecta la posición del texto localizando líneas de texto y generando sus coordenadas.
Para dibujar cuadros delimitadores en la imagen original utilizando las coordenadas devueltas, consulte las Preguntas frecuentes .
| Valor de task | Prompt especificado | Formato de salida y ejemplo |
|---|---|---|
advanced_recognition | Localice todas las líneas de texto y devuelva las coordenadas del rectángulo rotado ([cx, cy, width, height, angle]). |
|
Respuesta de ejemplo
Respuesta de ejemplo
Análisis de documentos PDF
qwen3.5-ocr admite pasar archivos PDF directamente a través de la Response API para el análisis de documentos, sin necesidad de dividir manualmente el PDF en imágenes. La longitud de salida no está limitada por la longitud máxima de salida del modelo, lo que permite el análisis completo de documentos largos. Solo se admite la Response API; la Chat API no es compatible. Límites de archivos PDF: no más de 100 MB. El límite de páginas depende de task en ocr_options: hasta 50 páginas cuando task se establece en document_parsing, y hasta 10 páginas cuando task no se establece o se configura en otra tarea.
Los siguientes ejemplos utilizan la API Response para pasar archivos PDF para el análisis de documentos.
Para modelos anteriores (qwen-vl-ocr-2025-11-20y previos) que no admiten la Response API, utilice una biblioteca de procesamiento de imágenes comopdf2imagedePythonpara convertir cada página del PDF en una imagen y, a continuación, utilice el método de entrada de múltiples imágenes para el reconocimiento página por página.
Para más usos de la API Responses de OpenAI (como recuperar y gestionar respuestas completadas del modelo), consulte Compatible con OpenAI - Responses.
Pasar un archivo local (codificación Base64 o ruta de archivo)
Cargue archivos locales mediante codificación Base64 o una ruta de archivo directa. Seleccione el método según el tamaño del archivo y el tipo de SDK; consulte Cómo seleccionar un método de carga de archivos. Ambos métodos deben cumplir con los requisitos de archivo en Límites de imagen.
- Usar codificación Base64
- Usar ruta de archivo
Pasos para pasar una cadena codificada en Base64
Pasos para pasar una cadena codificada en Base64
-
Codifique el archivo: Convierta la imagen local en una cadena codificada en Base64.
Código de ejemplo para convertir una imagen en una cadena codificada en Base64
-
Construya una Data URL con el siguiente formato:
data:[MIME_type];base64,{base64_image}.- Reemplace
MIME_typecon el tipo de medio real. Asegúrese de que el tipo coincida con el valorMIME Typeen la tabla Límites de imagen, comoimage/jpegoimage/png. base64_imagees la cadena codificada en Base64 generada en el paso anterior.
- Reemplace
-
Llamada al modelo: Pase la
Data URLutilizando el parámetroimageoimage_urlpara llamar al modelo.
- Pasar una ruta de archivo
- Pasar una cadena codificada en Base64
El paso de una ruta de archivo solo se admite para llamadas realizadas con los SDK de Python y Java de DashScope. Este método no es compatible con DashScope HTTP ni métodos compatibles con OpenAI.
Más usos
Limitaciones
Límites de imagen
- Dimensiones y relación de aspecto: Tanto el ancho como el alto de la imagen deben ser superiores a 10 píxeles. La relación de aspecto no debe exceder 200:1 o 1:200.
- Píxeles totales: El modelo escala automáticamente las imágenes, por lo que no hay un límite estricto en el número total de píxeles. Sin embargo, una imagen no puede exceder 15.68 millones de píxeles.
-
Formatos de imagen compatibles
-
Para imágenes con una resolución inferior a 4K
(3840x2160), se admiten los siguientes formatos:Formato de imagen
Extensiones comunes
Tipo MIME
BMP
.bmp
image/bmp
JPEG
.jpe, .jpeg, .jpg
image/jpeg
PNG
.png
image/png
TIFF
.tif, .tiff
image/tiff
WEBP
.webp
image/webp
HEIC
.heic
image/heic
-
Para imágenes con una resolución de
4K(3840x2160)a8K(7680x4320), solo se admiten los formatos JPEG, JPG y PNG.
-
Para imágenes con una resolución inferior a 4K
-
Tamaño de imagen:
- Si proporciona una imagen mediante una URL pública o una ruta local:
qwen3.5-ocradmite imágenes de hasta20 MB; otras versiones admiten hasta10 MB. - Si proporciona los datos en codificación Base64, la cadena codificada no puede exceder
10 MB.
Consulte también: ¿Cómo comprimo una imagen o video al tamaño requerido? .
- Si proporciona una imagen mediante una URL pública o una ruta local:
Límites del modelo
-
Mensaje del sistema: Qwen-OCR utiliza un
System Messageinterno fijo y no acepta uno personalizado. Pase todas las instrucciones en elUser Message. -
Conversaciones de múltiples turnos: A partir de
qwen3.5-ocr, se admiten conversaciones de múltiples turnos; puede enviar mensajes de texto de seguimiento sin una URL de imagen.qwen-vl-ocr-2025-11-20y versiones anteriores procesan únicamente el mensaje más reciente y no conservan el contexto. - Riesgo de alucinación: El modelo puede alucinar si el texto en una imagen es demasiado pequeño o tiene baja resolución. Además, no se garantiza la precisión de las respuestas a preguntas no relacionadas con la extracción de texto.
-
Error al procesar archivos de texto:
- Para archivos que contienen datos de imagen, siga las recomendaciones en Puesta en marcha para transformarlos en una secuencia de imágenes antes de procesarlos.
- Para archivos con texto sin formato o datos estructurados, utilice Qwen-Long, un modelo que puede analizar texto largo.
Tipos de certificados y documentos admitidos
La tarea de extracción de información admite la extracción de datos estructurados de los siguientes certificados, recibos y permisos.
- Pasaportes y documentos de viaje: pasaporte chino, pasaporte de Macao, permiso de viaje continental para residentes de Hong Kong y Macao, permiso de viaje continental para residentes de Taiwán y permiso de regreso a casa para residentes de Hong Kong y Macao.
- Documentos vehiculares y facturas de venta: licencia de conducir, placa de identificación del vehículo, certificado de conformidad del vehículo, certificado de registro del vehículo, factura de venta de vehículos automotores y factura de venta de vehículos usados.
- Facturas y recibos fiscales: factura ordinaria IVA (rollo), factura especial de monto fijo, factura general impresa por máquina, certificado de pago de impuestos y recibo de ingresos no tributarios centrales.
- Recibos de transporte: boleto de tren de alta velocidad 12306, boleto de tren, boleto de barco, recibo de peaje de autopista y factura impresa por máquina de autopista.
- Tarjetas financieras y recibos: tarjeta de crédito, letra de aceptación bancaria electrónica, recibo de pago y tarjeta de seguridad social.
- Licencias comerciales y permisos: licencia comercial, licencia de negocio de alimentos, licencia de producción de alimentos, licencia de negocio farmacéutico y licencia de negocio de dispositivos médicos.
- Certificado inmobiliario: certificado de propiedad inmobiliaria.
- Tarjetas de identificación internacionales: ID de Hong Kong, ID de Macao, ID de Indonesia, ID de Tailandia, ID de Vietnam, ID de Malasia, ID de Filipinas, ID de India, ID de Turquía, ID de Pakistán, ID de México, ID del Reino Unido e ID de EE. UU.
- Pasaportes internacionales y licencias de conducir: pasaporte indio, pasaporte de Singapur, pasaporte tailandés, pasaporte estadounidense, pasaporte australiano, pasaporte de los EAU, licencia de conducir filipina, licencia de conducir japonesa y licencia de conducir estadounidense.
Facturación y limitación de tasa
-
Facturación: Qwen-OCR es un modelo multimodal. El costo total se calcula de la siguiente manera: (Número de tokens de entrada × Precio unitario de entrada) + (Número de tokens de salida × Precio unitario de salida). Consulte las facturas o recargue su cuenta en la consola de Gastos y costos.
-
Cálculo de tokens de imagen: Utilice el siguiente código para estimar el uso de tokens de imagen. La facturación real se basa en la respuesta de la API.
Código de ejemplo para estimar tokens de imagen
Fórmula: Tokens de imagen =(h_bar * w_bar) / token_pixels + 2.-
h_bar * w_barrepresenta las dimensiones de la imagen escalada. El modelo preprocesa la imagen escalándola a un límite de píxeles específico. Este límite depende del valor del parámetromax_pixels. -
token_pixelsrepresenta el valor de píxeles porToken.- Para
qwen3.5-ocr,qwen-vl-ocryqwen-vl-ocr-2025-11-20, este valor es fijo en32*32(que es1024). - Para otros modelos, este valor es fijo en
28*28(que es784).
- Para
-
-
Cálculo de tokens de imagen: Utilice el siguiente código para estimar el uso de tokens de imagen. La facturación real se basa en la respuesta de la API.
- Limitación de tasa: Para los límites de tasa de Qwen-OCR, consulte Limitación de tasa.
- Cuota gratuita (solo Singapur): Qwen-OCR proporciona una cuota gratuita de 1 millón de tokens. Esta cuota es válida por 90 días, a partir de la fecha en que active Model Studio o se apruebe su solicitud para utilizar el modelo.
Puesta en marcha
-
Preprocesamiento de imagen:
-
Asegúrese de que las imágenes de entrada sean claras, estén uniformemente iluminadas y no estén excesivamente comprimidas:
- Almacene y transmita imágenes en un formato sin pérdida (por ejemplo, PNG) para evitar la pérdida de información.
- Para mejorar la definición de la imagen, utilice algoritmos de eliminación de ruido, como filtrado de media o mediana, para suavizar imágenes con ruido.
- Para corregir la iluminación desigual, utilice algoritmos como la ecualización adaptativa del histograma para ajustar el brillo y el contraste.
-
Imágenes sesgadas: Establezca
enable_rotate: trueen el SDK de DashScope para corregir la rotación antes del reconocimiento. -
Imágenes muy pequeñas o muy grandes: Utilice
min_pixelsymax_pixelspara controlar el escalado de imágenes.min_pixels: Amplía las imágenes pequeñas para mejorar el detalle. Mantenga el valor predeterminado.max_pixels: Evita que las imágenes de gran tamaño consuman demasiados tokens. El valor predeterminado cubre la mayoría de los casos. Auméntelo cuando se omita texto pequeño; esto incrementa el uso de tokens.
-
Asegúrese de que las imágenes de entrada sean claras, estén uniformemente iluminadas y no estén excesivamente comprimidas:
- Validación de resultados: Los resultados de reconocimiento del modelo pueden contener errores. Para operaciones comerciales críticas, implemente un proceso de revisión manual o agregue reglas de validación para verificar la precisión de la salida del modelo. Por ejemplo, utilice la validación de formato para números de tarjetas de identificación y tarjetas bancarias.
- Procesamiento por lotes: Para cargas de trabajo de alto volumen y no en tiempo real, utilice la API Batch para procesar trabajos de forma asíncrona a menor costo.
FAQ
¿Cómo elegir un método de carga de archivos?
¿Cómo elegir un método de carga de archivos?
Tipo | Especificaciones | DashScope SDK (Python, Java) | Compatible con OpenAI / HTTP de DashScope |
|---|---|---|---|
Imagen | Mayor que 7 MB y menor que 10 MB | Pasar la ruta local | Solo se admiten URL públicas. Utilice Object Storage Service. |
Menos de 7 MB | Pasar la ruta local | Codificación Base64 |
La codificación Base64 aumenta el tamaño de los datos. El tamaño del archivo original debe ser inferior a 7 MB.
El uso de una ruta local o la codificación Base64 ayuda a prevenir tiempos de espera de descarga en el servidor y mejora la estabilidad.
¿Cómo dibujo cuadros de detección en la imagen original después de que el modelo genera resultados de localización de texto?
¿Cómo dibujo cuadros de detección en la imagen original después de que el modelo genera resultados de localización de texto?
La respuesta está vacía o contiene etiquetas de estilo frontend después de pasar un Prompt personalizado. ¿Qué debo hacer?
La respuesta está vacía o contiene etiquetas de estilo frontend después de pasar un Prompt personalizado. ¿Qué debo hacer?
qwen3.5-ocr, si su Prompt personalizado contiene una estructura HTML completa, como <html><body>...</body></html>, el modelo puede seguir esa estructura y devolver el resultado de OCR en formato HTML en lugar de texto sin formato. La respuesta entonces parece vacía o aparenta contener etiquetas de estilo frontend. Una etiqueta simple, como una sola <br>, no activa este comportamiento.Para resolver este problema, utilice uno de los siguientes métodos:- Verifique si su Prompt contiene una estructura de etiquetas HTML completa. Si es así, reemplácela con una instrucción de texto sin formato e inténtelo de nuevo. Por ejemplo, cambie
<html><body>Extract all text from the image</body></html>porExtract all text from the image. - Si no está seguro de si su Prompt afecta el formato de salida, omita el campo
textpara utilizar el Prompt predeterminado del modelo. - Utilice el modelo
qwen3.7-plusen su lugar. Este modelo devuelve un resultado de texto sin formato incluso cuando pasa el mismo Prompt que contiene una estructura HTML.