

El modelo de edición universal de video Wanxiang admite entradas multimodales (texto, imagen y video) y proporciona cinco capacidades principales: referencia de múltiples imágenes, repintado de video, edición local, extensión de video y expansión de video.
Ámbito de aplicación
- Los modelos compatibles varían según la región. Los recursos están aislados entre regiones. Para consultar los modelos compatibles en cada región, consulte la consola de Model Studio.
- Al realizar una llamada, asegúrese de que su modelo, URL de endpoint y clave de API pertenezcan todos a la misma región. Las llamadas entre regiones fallarán.
El código de ejemplo en este tema aplica a la región de Singapur.
Capacidades principales
Referencia de múltiples imágenes
Introducción a la función: Admite hasta 3 imágenes de referencia, que pueden incluir sujetos y fondos (como personas, animales, ropa y escenas). El modelo fusiona múltiples imágenes para generar contenido de video coherente.
Parámetros:
function: Debe establecerse enimage_reference.ref_images_url: Una matriz de URLs. Puede introducir de 1 a 3 imágenes de referencia.obj_or_bg: Identifica cada imagen como sujeto (obj) o fondo (bg). La longitud debe ser la misma queref_images_url.
| Prompt de entrada | Imagen de referencia de entrada 1 (sujeto de referencia) | Imagen de referencia de entrada 2 (fondo de referencia) | Video de salida |
| En el video, una chica sale de las profundidades de un antiguo bosque brumoso. Sus pasos son ligeros, y la cámara captura cada uno de sus momentos llenos de gracia. Cuando se detiene y mira a su alrededor hacia el frondoso bosque, una sonrisa de sorpresa y alegría aparece en su rostro. Este momento, capturado en el juego de luces y sombras, registra su maravilloso encuentro con la naturaleza. | 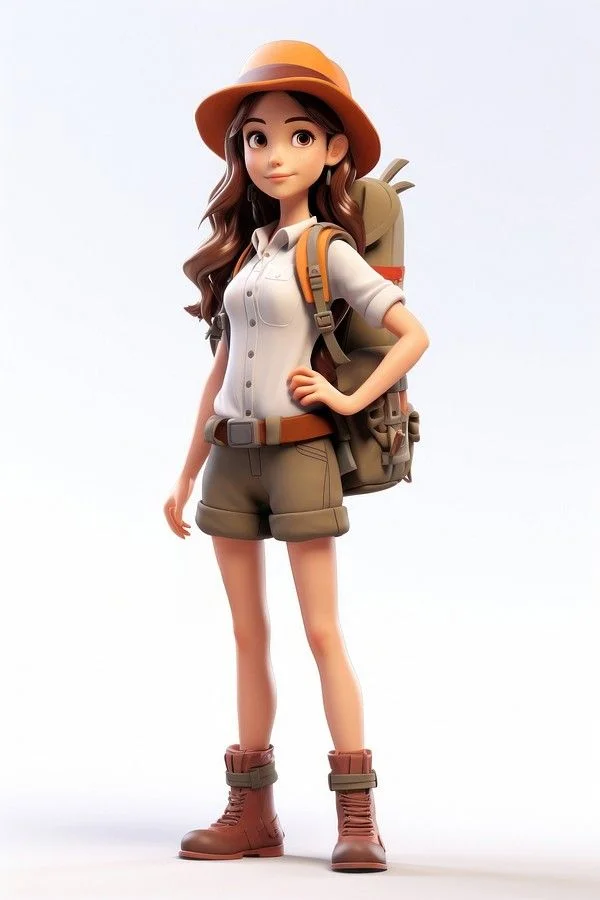 | 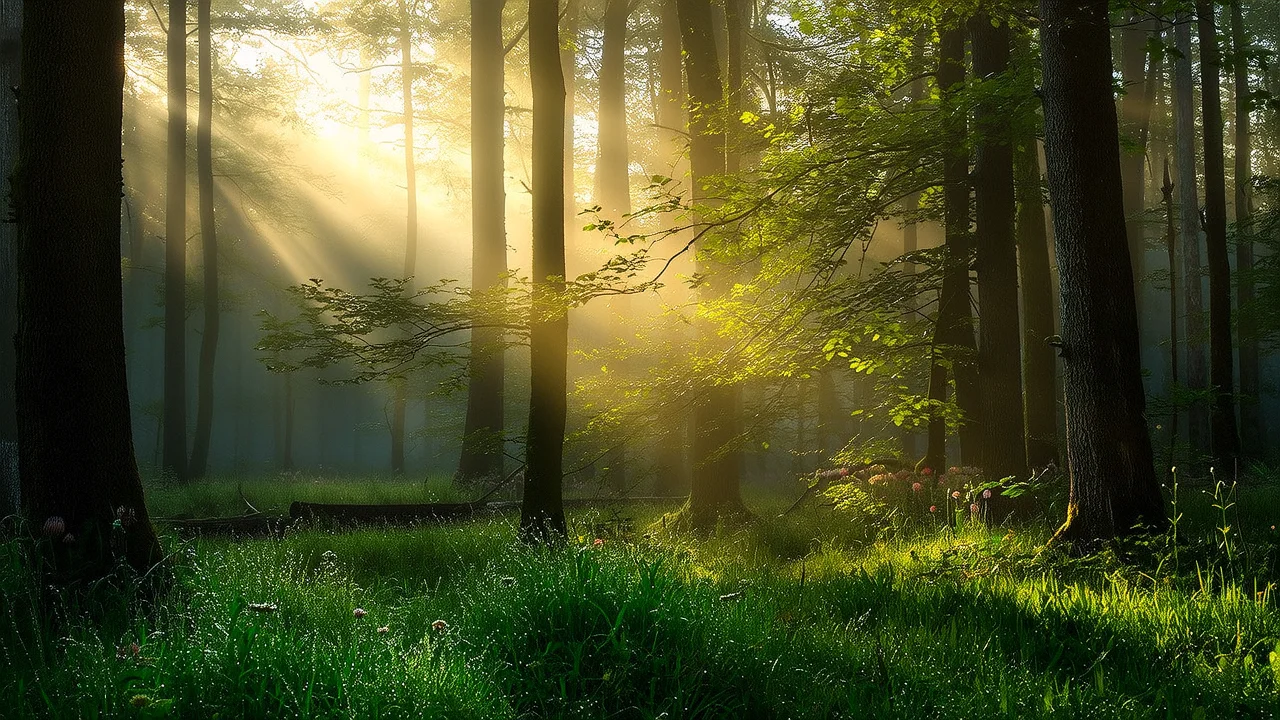 |
- curl
- Python
- Java
Paso 1: Cree una tarea para obtener un ID de tareaPaso 2: Recupere el resultado basado en el ID de tareaReemplace
{task_id} con el valor task_id devuelto por la llamada a la API anterior. El task_id es válido para consultas durante 24 horas. Reemplace {WorkspaceId} con su ID de espacio de trabajo real.Repintado de video
Introducción a la función: Extrae la pose y las acciones del sujeto, la composición y los contornos de movimiento, o la estructura del boceto de un video de entrada. Luego genera un nuevo video con las mismas características dinámicas basándose en un prompt de texto. También puede reemplazar el sujeto en el video original usando una imagen de referencia.
Parámetros:
-
function: Debe establecerse envideo_repainting. -
video_url: Obligatorio. La URL del video de entrada (formato MP4, ≤50 MB, ≤5 segundos). -
control_condition: Obligatorio. Establece el método para la extracción de características del video, lo cual determina qué características del video original se conservan en el nuevo video.posebodyface: Extrae expresiones faciales y movimientos corporales (conserva los detalles de las expresiones faciales).posebody: Extrae solo movimientos corporales, excluyendo el rostro (controla solo acciones corporales).depth: Extrae contornos de composición y movimiento (conserva la estructura de la escena).scribble: Extrae la estructura del boceto (conserva los detalles de los bordes del boceto).
-
strength: Opcional. Controla la fuerza de la extracción de características. El rango es [0.0, 1.0]. El valor predeterminado es 1.0. Un valor mayor acerca más la salida al video original, mientras que un valor menor permite mayor libertad creativa. -
ref_images_url: Opcional. Proporcione la URL de una imagen de referencia para reemplazar el sujeto en el video de entrada.
| Prompt de entrada | Video de entrada | Video de salida |
| El video muestra un automóvil negro estilo steampunk conducido por un caballero, adornado con engranajes y tuberías de cobre. El fondo es una fábrica de dulces impulsada por vapor con elementos retro, creando una escena vintage y lúdica. |
- curl
- Python
- Java
Paso 1: Cree una tarea para obtener un ID de tareaPaso 2: Recupere el resultado basado en el ID de tareaReemplace
{task_id} con el valor task_id devuelto por la llamada a la API anterior. El task_id es válido para consultas durante 24 horas. Reemplace {WorkspaceId} con su ID de espacio de trabajo real.Edición local
Introducción a la función: Realiza edición de grano fino en áreas específicas de un video. Admite agregar, eliminar o modificar elementos, y reemplazar sujetos o fondos. Puede cargar una imagen de máscara para especificar el área de edición, y el modelo rastreará automáticamente el objetivo y fusionará el contenido generado.
Parámetros:
-
function: Debe establecerse envideo_edit. -
video_url: Obligatorio. La URL del video de entrada original. -
mask_image_url: Opcional. Elija entre este ymask_video_url. Recomendamos usar este parámetro. Puede ingresar la URL de una imagen de máscara donde el área blanca representa la parte a editar y el área negra permanece sin cambios. -
mask_frame_id: Opcional. Se usa conmask_image_urlpara especificar a qué fotograma del video corresponde la máscara (el valor predeterminado es el primer fotograma). -
mask_type: Opcional. Especifica el comportamiento del área de edición:tracking(predeterminado): El área de edición sigue automáticamente la trayectoria de movimiento del objeto objetivo.fixed: El área de edición permanece en una posición fija.
-
expand_ratio: Opcional. Efectivo solo cuandomask_typeestracking.- Función: Establece la relación con la que el área de la máscara se expande hacia afuera. El rango de valores es [0.0, 1.0], y el valor predeterminado es 0.05.
- Descripción: Un valor más pequeño hace que la máscara se ajuste más al objetivo. Un valor más grande amplía el rango de la máscara.
-
ref_images_url: Opcional. Proporcione la URL de una imagen de referencia para reemplazar el contenido en el área de edición con el contenido de la imagen de referencia.
| Prompt de entrada | Video de entrada | Imagen de máscara de entrada | Video de salida |
| El video muestra un café francés de estilo parisino donde un león con traje bebe café elegantemente. Sostiene una taza de café en una mano, bebiendo con una expresión relajada. El café está decorado con buen gusto, con tonos suaves y una iluminación cálida que ilumina el área donde se encuentra el león. | 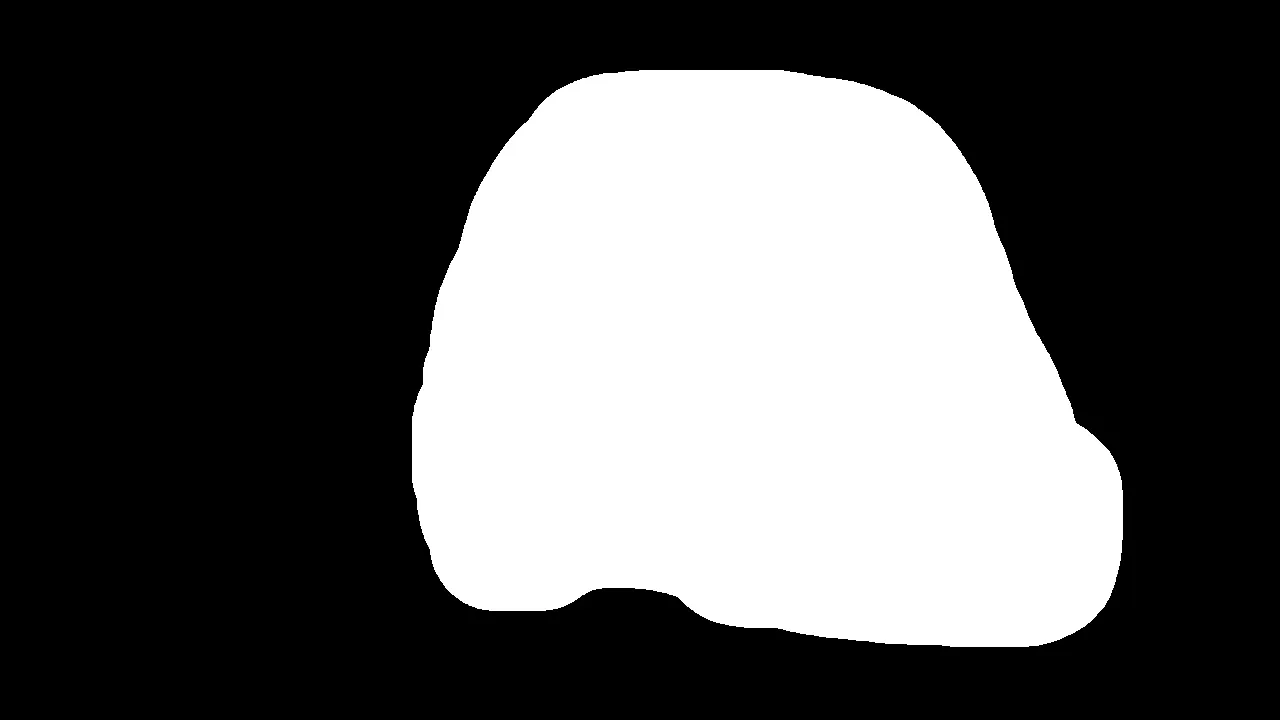 El área blanca indica el área de edición. |
- curl
- Python
- Java
Paso 1: Cree una tarea para obtener un ID de tareaPaso 2: Recupere el resultado basado en el ID de tareaReemplace
{task_id} con el valor task_id devuelto por la llamada a la API anterior. El task_id es válido para consultas durante 24 horas. Reemplace {WorkspaceId} con su ID de espacio de trabajo real.Extensión de video
Introducción a la función: Predice y genera contenido posterior continuo basándose en una imagen o clip de video de entrada. Admite la extensión hacia adelante desde el "primer fotograma/primer clip" o la extensión hacia atrás desde el "último fotograma/último clip". La duración total del video final generado es fija en 5 segundos.
Parámetros:
-
function: Debe establecerse envideo_extension. -
prompt: Obligatorio. Describe el contenido extendido deseado. -
first_clip_url: Opcional. Puede ingresar la URL del primer clip de video (≤3 segundos). El modelo generará el resto del video basándose en este clip. -
last_clip_url: Opcional. Puede ingresar la URL del último clip de video (≤3 segundos). El modelo generará la parte anterior del video basándose en este clip. -
first_frame_url: Opcional. Puede ingresar la URL de la imagen del primer fotograma. El video se extenderá hacia adelante desde este fotograma. -
last_frame_url: Opcional. Puede ingresar la URL de la imagen del último fotograma. El video se extenderá hacia atrás desde este fotograma.Nota: Usted debe proporcionar al menos uno de los siguientes cuatro parámetros como entrada: first_clip_url, last_clip_url, first_frame_url o last_frame_url.
| Prompt de entrada | Primer clip de entrada (1 segundo) | Video de salida (extendido a 5 segundos) |
| Un perro con gafas de sol anda en patineta por la calle, caricatura 3D. |
- curl
- Python
- Java
Paso 1: Cree una tarea para obtener un ID de tareaPaso 2: Recupere el resultado basado en el ID de tareaReemplace
{task_id} con el valor task_id devuelto por la llamada a la API anterior. El task_id es válido para consultas durante 24 horas. Reemplace {WorkspaceId} con su ID de espacio de trabajo real.Expansión de video
Introducción a la función: Expande el contenido del video en las direcciones superior, inferior, izquierda y derecha basándose en un prompt y una relación especificada, manteniendo la coherencia del sujeto del video y la fusión natural del fondo.
Parámetros:
function: Debe establecerse envideo_outpainting.video_url: Obligatorio. La URL del video de entrada original.top_scale: Opcional. La relación de expansión hacia arriba. El rango es [1.0, 2.0]. El valor predeterminado es 1.0 (sin expansión).bottom_scale: Opcional. La relación de expansión hacia abajo. El rango es [1.0, 2.0]. El valor predeterminado es 1.0.left_scale: Opcional. La relación de expansión hacia la izquierda. El rango es [1.0, 2.0]. El valor predeterminado es 1.0.right_scale: Opcional. La relación de expansión hacia la derecha. El rango es [1.0, 2.0]. El valor predeterminado es 1.0.
Ejemplo: Establecer left_scale en 1.5 significa que el lado izquierdo del fotograma se expandirá a 1.5 veces su ancho original.
| Prompt de entrada | Video de entrada | Video de salida |
| Una dama elegante toca el violín con pasión, con una orquesta sinfónica completa detrás de ella. |
- curl
- Python
- Java
Paso 1: Cree una tarea para obtener un ID de tareaPaso 2: Recupere el resultado basado en el ID de tareaReemplace
{task_id} con el valor task_id devuelto por la llamada a la API anterior. El task_id es válido para consultas durante 24 horas. Reemplace {WorkspaceId} con su ID de espacio de trabajo real.Cómo introducir imágenes y videos
Imágenes de entrada
- Número de imágenes: Puede proporcionar la cantidad de imágenes correspondientes a la función seleccionada.
-
Métodos de entrada:
- URL pública: Admite el protocolo HTTP o HTTPS. Ejemplo: https://xxxx/xxx.png.

Videos de entrada
- Número de videos: Puede proporcionar la cantidad de videos correspondientes a la función seleccionada.
-
Métodos de entrada:
- URL pública: Admite el protocolo HTTP o HTTPS. Ejemplo: https://xxxx/xxx.mp4.
Videos de salida
- Número de videos: 1.
- Especificaciones del video: La resolución total es fija en 720P, con una tasa de fotogramas de 30 fps, en formato MP4 (codificación H.264).
- Validez de la URL del video: 24 horas.
-
Dimensiones del video: Varían según la función seleccionada.
-
Referencia de múltiples imágenes / Edición local:
- La resolución de salida es fija en 720P.
- El ancho y alto específicos están determinados por el parámetro de solicitud size.
-
Repintado de video / Extensión de video / Expansión de video:
- Si la resolución del video de entrada es ≤ 720P: La salida mantiene la resolución original.
- Si la resolución del video de entrada es > 720P: La salida se reduce a 720P manteniendo la relación de aspecto.
-
Referencia de múltiples imágenes / Edición local:
Facturación y limitación de tasa
- Para obtener más información sobre la cuota gratuita del modelo y las tarifas de facturación, consulte Precios del modelo.
- Para obtener más información sobre los límites de tasa del modelo, consulte la serie Wanxiang.
-
Descripción de facturación:
- No se le cobra por las entradas. La facturación se basa en la duración en segundos del video generado exitosamente.
- Las llamadas fallidas al modelo o los errores de procesamiento no generan ningún cargo y no consumen la cuota gratuita para nuevos usuarios.
- La edición de video universal también admite planes de ahorro.
Documentación de la API
Referencia de la API de edición de video universal
FAQ
P: ¿Cuántas imágenes admite como máximo la función de referencia de múltiples imágenes?
R: Admite hasta 3 imágenes de referencia. Si proporciona más de 3, solo las primeras 3 se utilizan como entrada. Recomendamos usar un fondo sólido para la imagen del sujeto para resaltar mejor al sujeto, y una imagen de fondo que no contenga ningún sujeto.
P: ¿Cuándo debo desactivar la reescritura de prompts para el repintado de video?
R: Cuando la descripción de texto no coincide con el contenido del video de entrada, el modelo puede malinterpretarlo. Recomendamos desactivar manualmente la reescritura de prompts estableciendo prompt_extend=false, y proporcionar una descripción clara y específica de la escena en el prompt para mejorar la consistencia y precisión de la generación.
P: En la función de edición local, ¿cuál es la diferencia entre una imagen de máscara y un video de máscara?
R: Debe proporcionar mask_image_url o mask_video_url. Recomendamos usar una imagen de máscara. Solo necesita especificar el área de edición para un fotograma, y el sistema rastreará automáticamente el objetivo.