

Este tema describe las capacidades de entrada larga y caché de prefijos de las implementaciones PTU (Rendimiento Aprovisionado), incluidas las reglas de consumo de cuotas, cómo utilizar la Calculadora de Cuota de Rendimiento Aprovisionado y descripciones de campos de respuesta de la API.
Visión general
PTU (Unidad de Rendimiento Aprovisionado) es un método de implementación de modelos que reserva recursos de la plataforma para garantizar una capacidad de rendimiento TPM específica; no se aplica limitación de tasa dentro de la cuota garantizada. Es adecuado para entornos de producción de alto rendimiento, alta carga y alto desempeño, proporcionando una capacidad de rendimiento estable, menor latencia y mayor certeza de recursos. En comparación con la facturación basada en tokens, los TPS (tokens generados por segundo) suelen aumentar aproximadamente de 1.5 a 2.0 veces.
Casos de uso:
- Servicio al cliente inteligente para aplicaciones bancarias (tráfico estable, requiere experiencia concurrente garantizada).
- Moderación de contenido en tiempo real para plataformas sociales (requiere procesamiento estable de tareas de canalización predecibles).
- API de traducción en la nube pública (proporciona garantías de servicio base para usuarios de paquetes estándar).
Reglas de facturación
费用 = 使用时长 × (输入 TPM 单价 × 输入 TPM + 输出 TPM 单价 × 输出 TPM)
El pospago se calcula por hora: la unidad de duración de uso es horas y el precio unitario se toma de la columna "1 hora continua" en la tabla siguiente; el prepago se calcula por día: la unidad de duración de uso es días y el precio unitario se toma de la columna "1 día continuo" en la tabla siguiente.
- Los pedidos prepago entran en vigor en tiempo real después del pago, con un período de validez de N días que finaliza a las 23:59 del día N. Si el pedido se realiza después de las 22:00, la fecha de vencimiento se extenderá automáticamente por 1 día.
- Después de que expire un pedido prepago, el servicio se detendrá con un retraso de 2 horas, y los recursos se conservarán durante 14 horas después de la detención y luego se liberarán.
- Los pedidos de prepago admiten terminación anticipada; la parte utilizada se liquida con un coeficiente de 1.2x para reembolso. Para más detalles, consulte Reglas de reembolso por reducción de configuración.
- Para la facturación pospago, si la cuenta tiene saldos pendientes, los recursos implementados seguirán retenidos y facturándose durante 24 horas, tiempo durante el cual el servicio aún podrá utilizarse con normalidad. Después de 24 horas, el sistema detiene la facturación, la implementación del modelo entra en estado de saldo pendiente y los recursos subyacentes se eliminarán, pero la tarea de implementación del modelo se conservará. Una vez pagados los saldos pendientes, el sistema reasignará los recursos y restaurará el uso (las tarifas continuarán acumulándose después de la restauración). Si no desea seguir incurriendo en tarifas, puede eliminar la tarea de implementación del modelo y la facturación se detendrá tras la eliminación exitosa.
- En este caso (solo bajo la estrategia de "desbordamiento automático"), el encabezado de respuesta de la API incluirá:
x-dashscope-ptu-overflow:true. - Para estadísticas de TPM, vaya a: Monitoreo de modelos.
Modelos admitidos y precios
- Singapore
- Norte de China 2 (Beijing)
- Qwen
- DeepSeek
- Qwen-VL
- GLM
Nombre del modelo | Código del modelo | Token máximo de entrada | Entrada pospago Por 10K TPM/hora | Salida pospago Por 1K TPM/hora | Entrada prepago Por 10K TPM/día | Salida prepago Por 1K TPM/día |
|---|---|---|---|---|---|---|
Qwen3.8-Max | qwen3.8-max | 1M | $4.8 | $1.44 | $57.6 | $17.28 |
Qwen3.7-Flash-2026-07-15 Contacte a su gerente de cuentas para activar | qwen3.7-flash-2026-07-15 | 128K | $0.072 | $0.031 | $0.864 | $0.374 |
Qwen3.7-Max-2026-05-20 | qwen3.7-max-2026-05-20 | 256K | $1.92 | $1.8 | $72 | $21.6 |
Qwen3.7-Plus-2026-05-26 | qwen3.7-plus-2026-05-26 | 256K | $0.96 | $0.384 | $11.52 | $4.608 |
Qwen3.6-Plus-2026-04-02 | qwen3.6-plus-2026-04-02 | 128K | $1.2 | $0.72 | $14.4 | $8.64 |
Qwen3.5-Plus-2026-04-20 | qwen3.5-plus-2026-04-20 | 128K | $0.96 | $0.576 | $11.52 | $6.912 |
Entrada larga y caché de prefijos
Los coeficientes escalonados de entrada larga y los descuentos por caché varían según el modelo. La siguiente tabla enumera los parámetros para los modelos admitidos actualmente:
Modelo | Tipo | Longitud máxima de entrada | Descuento por caché | Coeficiente escalonado de entrada larga |
|---|---|---|---|---|
glm-5.2 | PTU | (0, 1M) | 0.25 | 1 |
qwen3.8-flash | PTU | (0, 1M) | 0.125 | 1 |
qwen3.8-max | PTU | (0, 1M) | 0.125 | 1 |
qwen3.7-flash-2026-07-15 | PTU | (0, 1M) | 0.2 | Igual para entrada y salida |
deepseek-v4-flash-0731 | PTU | (0, 1M) | 0.1 | 1 |
qwen3.7-plus-2026-05-26 | PTU | PTU | 1 millón | 0.2 (porción de aciertos de caché calculada al 20% de capacidad) |
glm-5.1 | PTU | PTU | 200K | 0.2 (porción de aciertos de caché calculada al 20% de capacidad) |
deepseek-v4-pro | PTU | PTU | 256K | 0.08 (porción de aciertos de caché calculada al 8% de capacidad) |
Otros modelos | PTU | PTU | Consulte la consola | Consulte la consola |
Ejemplos de cálculo (usando glm-5.1)
Calculadora de cuotas de rendimiento aprovisionado
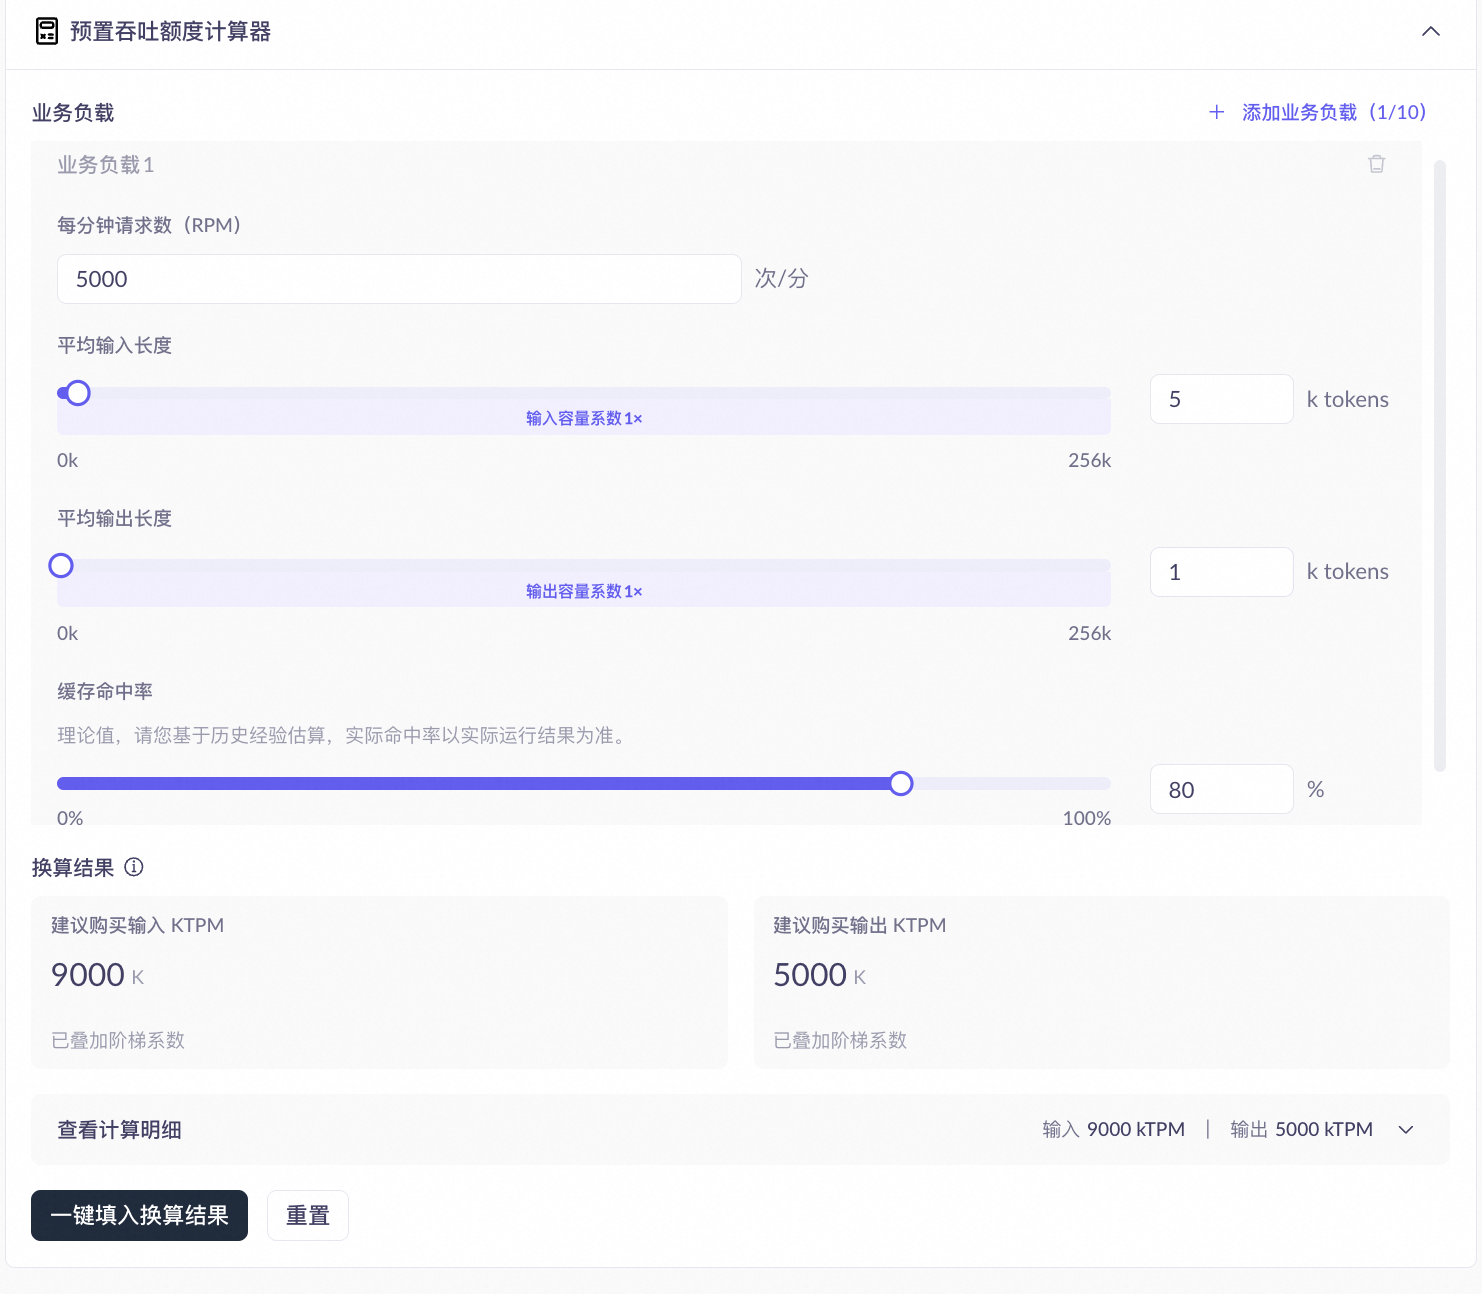
Parámetro | Descripción | Impacto en los resultados |
|---|---|---|
Requests per minute (RPM) | Número de solicitudes por minuto durante las horas pico de actividad. | Cuanto mayor sea el RPM, más aumentará proporcionalmente el KTPM recomendado de entrada y salida. |
Average input length (tokens) | Número promedio de tokens de entrada por solicitud. | Cuanto más larga sea la entrada, mayores serán el nivel y el coeficiente, y mayor será el KTPM de entrada recomendado. Los límites de nivel varían según el modelo; consulte la consola para obtener los valores reales. |
Average output length (tokens) | Número promedio de tokens de salida por solicitud. | Cuanto más larga sea la salida, mayor será el coeficiente posible y mayor será el KTPM de salida recomendado. |
Cache hit rate (%) | El porcentaje de tokens de prefijo de solicitud que acertaron en la caché. La tasa de aciertos real depende de la repetición del contenido de la solicitud; consulte los resultados reales de ejecución. | Una tasa de aciertos más alta ralentiza el consumo de cuota de entrada, reduciendo el KTPM de entrada recomendado. Afecta solo al KTPM de entrada, no al KTPM de salida. |
Campos de respuesta de API
Las respuestas de API para implementaciones PTU incluyen los siguientes campos relacionados con cuotas que identifican el método de facturación y el consumo de cuota:
Campo | Tipo | Descripción |
|---|---|---|
| String | Un campo de respuesta de nivel superior (consistente en todos los formatos de API). Un valor de |
| Integer | Los tokens de cuota PTU reales consumidos después de la conversión (incluye coeficientes escalonados y descuentos por caché). |
| Integer | El número de tokens que acertaron en la caché de prefijos. Para más detalles, consulte Caché de contexto. |
- Compatible con OpenAI Chat
- Respuestas de OpenAI
- Compatible con Anthropic
- DashScope
Campo | Ruta JSON | Descripción |
|---|---|---|
|
| Recuento de tokens en caché del lado de entrada |
|
| Consumo de cuota PTU del lado de entrada |
|
| Consumo de cuota PTU del lado de salida |
Monitoreo y verificación
Puede monitorear las implementaciones PTU a través de la función de monitoreo de modelos en la plataforma Model Studio. Las siguientes métricas son relevantes para la entrada larga y el almacenamiento en caché:
- Utilización de PTU: Tres curvas independientes para entrada, salida y salida en modo de pensamiento. En escenarios de entrada larga, los coeficientes escalonados pueden causar que la utilización supere el 100%. Este es un comportamiento esperado.
- Uso de tokens y aciertos de caché: Incluye la serie de datos
cached_tokenspara mostrar la proporción de aciertos de caché en relación con la entrada total. - Recuentos de llamadas dentro y fuera de la cuota: Muestra la proporción de solicitudes que exceden la cuota PTU (bajo la estrategia de desbordamiento automático, las solicitudes pasan a la facturación de pago por uso; bajo la estrategia de usar-solo-capacidad-PTU, se devuelven errores 429).
Escalado
Haga clic en el botón Scaling para ajustar manualmente el rendimiento (número de instancias) mediante autoservicio. Para obtener detalles sobre las reglas de reducción de tarifas y reembolsos, consulte: Reglas de reembolso para degradaciones de configuración.
Además, puede configurar una política de escalado automático (incluidos umbrales de escalado, recuento mínimo/máximo de réplicas, escalado programado, etc.) a través del botón de configuración de escalado en la columna de operaciones.
FAQ
P: ¿Qué sucede cuando se excede la cuota de PTU?
P: ¿Qué sucede cuando se excede la cuota de PTU?
service_tier en la respuesta de la API no se devuelve o devuelve default, y el encabezado de respuesta incluye x-dashscope-ptu-overflow:true, por lo que el servicio no se interrumpe; bajo la estrategia de "usar-solo-capacidad-PTU", las solicitudes que exceden la cuota devuelven un error 429 y no se cobran tarifas adicionales.P: ¿Qué sucede cuando una sola entrada supera el límite del modelo?
P: ¿Qué sucede cuando una sola entrada supera el límite del modelo?
P: ¿Cómo verifico que el almacenamiento en caché funciona correctamente?
P: ¿Cómo verifico que el almacenamiento en caché funciona correctamente?
cached_tokens en la respuesta de la API. Un valor mayor que 0 indica un acierto en la caché de prefijos. Los tokens con aciertos de caché consumen cuota según el coeficiente de descuento del modelo (para tasas de descuento específicas, consulte Entrada larga y caché de prefijos). También puede ver las tendencias en el gráfico de uso de tokens en la página de monitoreo de la consola.P: ¿Qué hago si cached_tokens siempre es 0 y el almacenamiento en caché no funciona?
P: ¿Qué hago si cached_tokens siempre es 0 y el almacenamiento en caché no funciona?
P: ¿Por qué la utilización supera el 100%?
P: ¿Por qué la utilización supera el 100%?