Si vous rencontrez des problèmes de récupération incomplète des connaissances ou de contenu inexact avec la fonctionnalité de génération augmentée par récupération (RAG) dans Alibaba Cloud Model Studio, suivez les suggestions et exemples présentés dans cette rubrique pour améliorer les performances RAG.
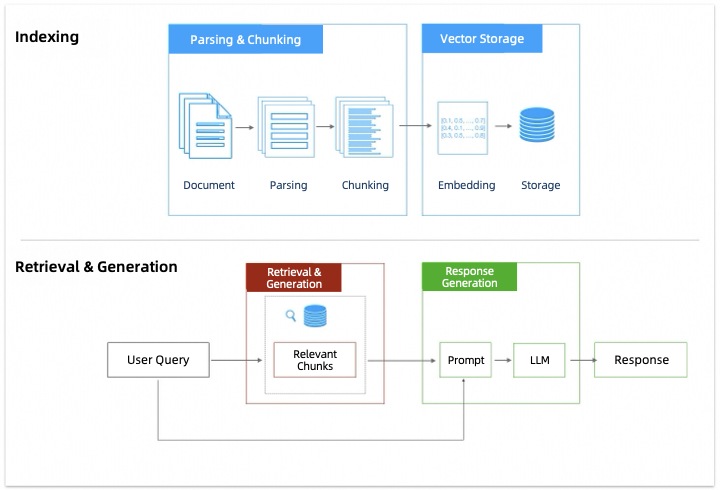
1. Flux de travail RAG
La génération augmentée par récupération (RAG, Retrieval-Augmented Generation) est une technique qui combine la recherche d'informations avec la génération de texte. Elle permet à un modèle d'utiliser des informations pertinentes issues d'une base de connaissances externe lors de la génération de réponses.
Son flux de travail comprend plusieurs étapes clés, notamment l'analyse et le découpage, le stockage vectoriel, la récupération et le rappel, ainsi que la génération de réponses.
2. Optimisation des performances RAG
2,1 Préparation
Tout d'abord, assurez-vous que les documents importés dans la base de connaissances Model Studio répondent aux exigences suivantes :
- Inclure les connaissances pertinentes : Si la base de connaissances ne contient pas les informations nécessaires, le modèle risque de ne pas pouvoir répondre aux questions connexes. Pour résoudre ce problème, mettez à jour la base de connaissances et ajoutez les connaissances requises.
-
Utiliser le format Markdown (recommandé) : Les fichiers PDF ont souvent des mises en page complexes, ce qui peut entraîner une mauvaise qualité d'analyse. Convertissez d'abord les fichiers PDF dans un format textuel tel que Markdown, DOC ou DOCX. Par exemple, utilisez DashScopeParse pour convertir un fichier PDF au format Markdown, puis utilisez un modèle pour nettoyer la mise en forme. Consultez le chapitre RAG du cours ACP sur les grands modèles Alibaba Cloud.
Comment dois-je traiter les illustrations dans les documents ?
La base de connaissances ne peut pas actuellement analyser le contenu vidéo ou audio présent dans les documents.
- Utiliser une formulation claire, une structure raisonnable et éviter les styles spéciaux : La mise en page de votre document affecte également considérablement les performances RAG. Pour plus de détails, consultez la section Comment formater les documents pour optimiser le RAG ?.
- Faire correspondre la langue des invites : Si les invites des utilisateurs sont principalement rédigées dans une langue donnée, comme l'anglais, assurez-vous que le contenu de vos documents est rédigé dans la même langue. Si nécessaire, par exemple pour les termes techniques du document, vous pouvez utiliser deux langues ou plus.
-
Désambiguïsation des entités : Unifiez les différentes expressions désignant la même entité dans un document. Par exemple, « ML » et « Machine Learning » peuvent être normalisés en « Machine Learning ».
Vous pouvez soumettre le document à un modèle et lui demander de normaliser les termes. Si le document est long, divisez-le en plusieurs parties et traitez-les une par une.
2,2 Analyse et découpage
Cette section décrit uniquement les éléments de configuration disponibles dans Model Studio pour optimiser l'étape de découpage RAG.Dans un premier temps, la base de connaissances analyse et découpe les documents que vous importez. L'objectif principal du découpage est de réduire le bruit lors du processus de vectorisation ultérieur tout en préservant l'intégrité sémantique. Par conséquent, la stratégie de découpage que vous sélectionnez lors de la création d'une base de connaissances a un impact significatif sur les performances RAG. Si la méthode de découpage est inadaptée, elle peut entraîner les problèmes suivants :
Tronçons courts | Tronçons longs | Troncature sémantique |
|---|---|---|
 | 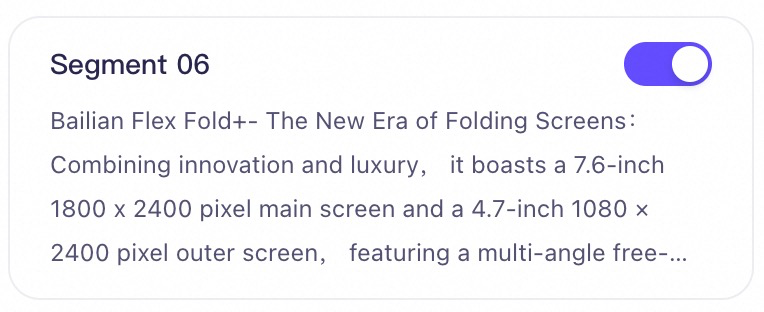 | 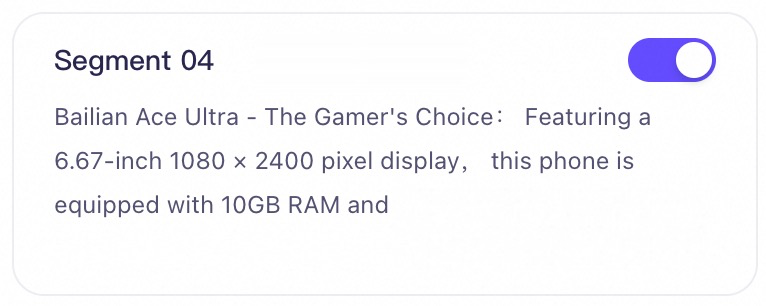 |
Les tronçons courts peuvent manquer d'informations sémantiques, ce qui entraîne l'échec de la récupération. | Les tronçons longs peuvent inclure des sujets non pertinents, ce qui amène le processus de rappel à renvoyer des informations bruitées ou hors sujet. | Une troncature sémantique forcée peut entraîner une perte de contenu lors du rappel. |
- Lors de la création d'une base de connaissances, sélectionnez intelligent chunking comme méthode de découpage des documents.
- Après avoir importé avec succès les documents dans la base de connaissances, examinez manuellement le contenu des tronçons de texte et corrigez-le si nécessaire.
2.2.1 Découpage intelligent
Le choix de la longueur optimale des tronçons de texte pour votre base de connaissances peut s'avérer difficile, car cela dépend de plusieurs facteurs, tels que :
- Type de document : Pour la littérature professionnelle, des tronçons plus longs aident souvent à conserver davantage de contexte. Pour les publications sur les réseaux sociaux, des tronçons plus courts permettent de capturer la sémantique avec plus de précision.
- Complexité de l'invite : En général, si l'invite d'un utilisateur est complexe et spécifique, vous aurez peut-être besoin de tronçons plus longs. Dans le cas contraire, des tronçons plus courts pourraient être plus appropriés.
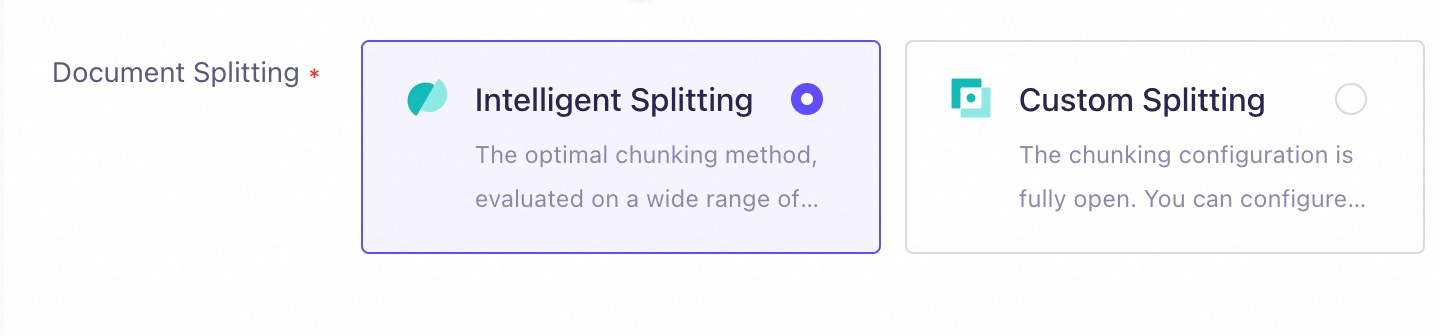
- Utilise d'abord des délimiteurs de phrases intégrés pour diviser le document en paragraphes.
- Sur la base des paragraphes divisés, sélectionne de manière adaptative les limites des tronçons en fonction de la pertinence sémantique (découpage sémantique), au lieu d'utiliser une longueur fixe.
2.2.2 Correction du contenu des tronçons
Bien entendu, lors du processus réel de découpage, des divisions inattendues ou d'autres problèmes peuvent toujours survenir (par exemple, les espaces dans le texte sont parfois analysés sous la forme %20 après le découpage).
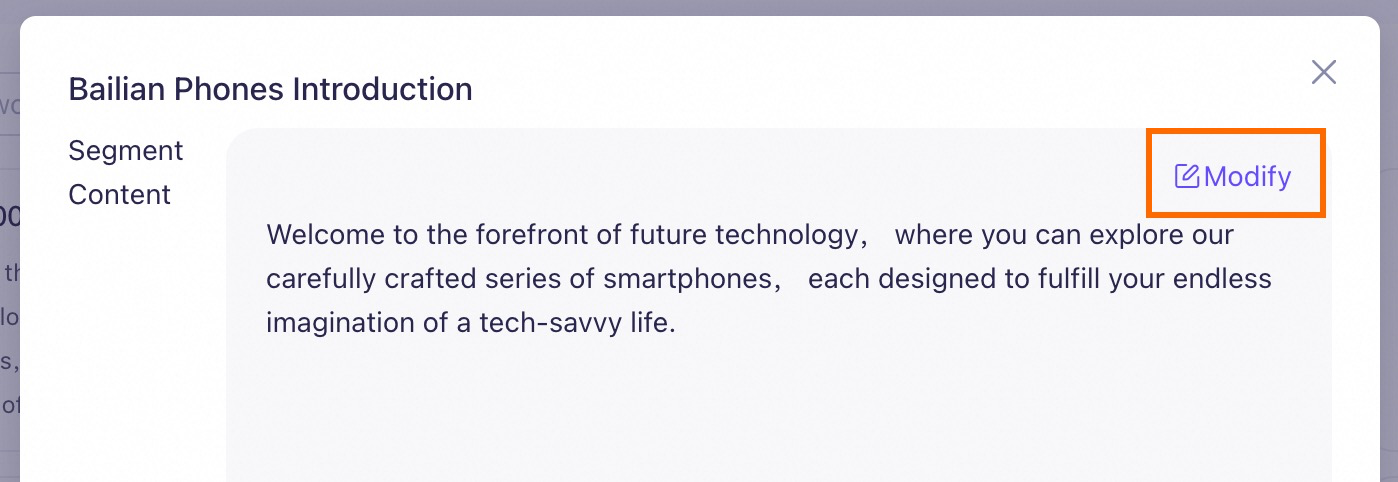
Notez que cette action modifie uniquement les tronçons de texte dans la base de connaissances, et non le document original ou la table de données dans votre gestion des données (stockage temporaire). Par conséquent, si vous réimportez le document, vous devrez effectuer à nouveau la vérification et la correction manuelles.
2,3 Récupération et rappel
Cette section décrit uniquement les éléments de configuration disponibles dans Model Studio pour optimiser l'étape de récupération et de rappel.Le principal défi lors de l'étape de récupération et de rappel consiste à trouver les tronçons de texte les plus pertinents dans la base de connaissances contenant la réponse.
| Type de problème | Stratégie d'amélioration |
|---|---|
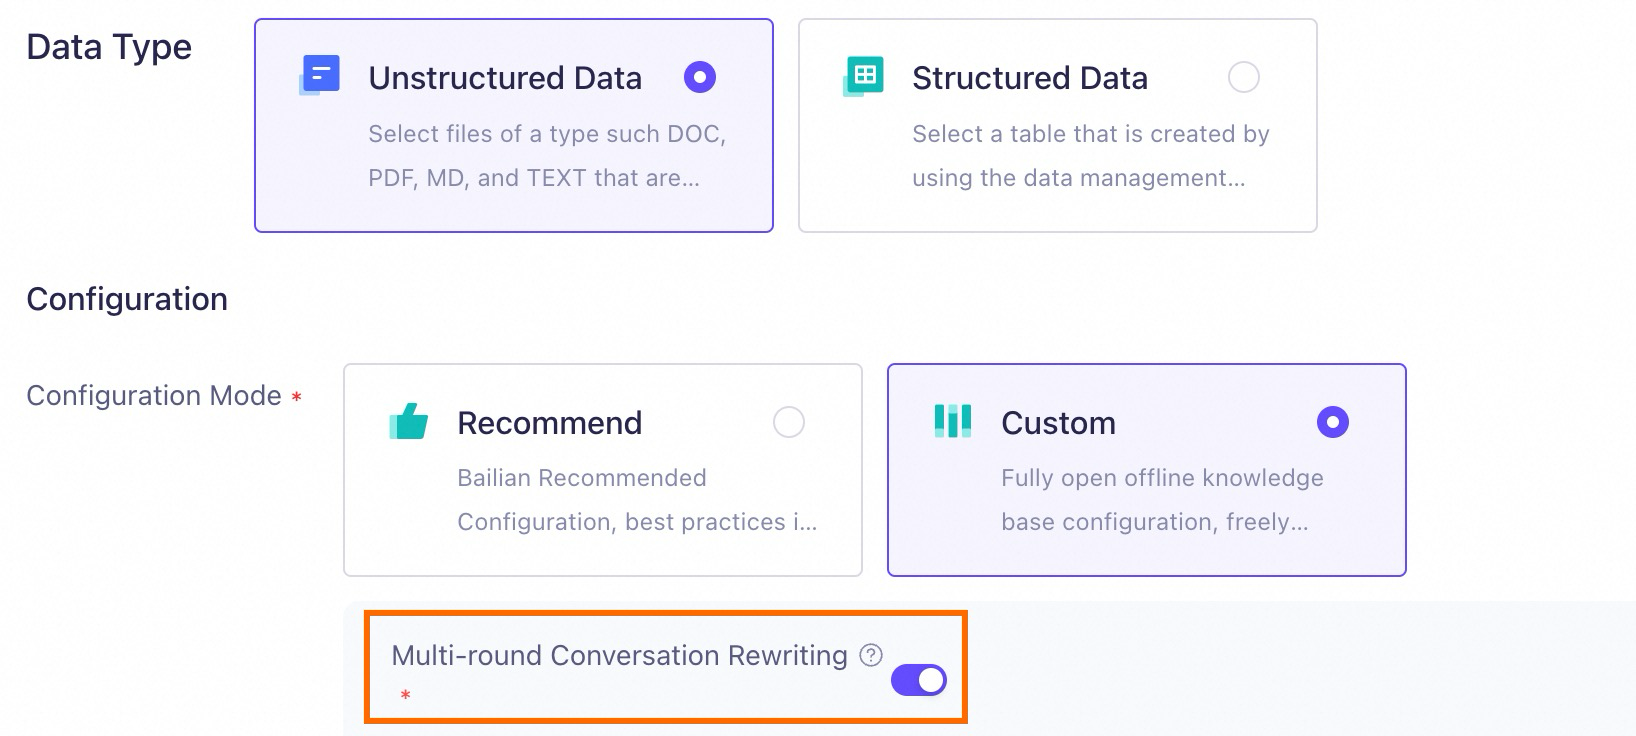
| Dans les scénarios de conversation multi-tours, l'invite de l'utilisateur peut être incomplète ou ambiguë. | Activez la réécriture des conversations multi-tours. La base de connaissances réécrit automatiquement l'invite de l'utilisateur pour la rendre plus complète, améliorant ainsi la correspondance des connaissances. |
| La base de connaissances contient des documents de plusieurs catégories. Lorsqu'une recherche se concentre sur la catégorie A, les résultats de rappel incluent également des tronçons de texte d'autres catégories, telles que la catégorie B. | Ajoutez des tags aux documents. Lors de la récupération, la base de connaissances filtre d'abord les documents pertinents en fonction des tags avant d'effectuer la recherche.Seules les bases de connaissances de recherche documentaire prennent en charge l'ajout de tags aux documents. |
| La base de connaissances contient plusieurs documents ayant des structures similaires, par exemple, ils comportent tous une section « Feature Overview ». Vous souhaitez effectuer une recherche dans la section « Feature Overview » du document A, mais les résultats de rappel incluent des informations provenant d'autres documents similaires. | Utilisez l'extraction de métadonnées. La base de connaissances effectue une recherche structurée avec les métadonnées avant la récupération vectorielle afin de trouver précisément le document cible et d'en extraire les informations pertinentes.Seules les bases de connaissances de recherche documentaire prennent en charge les métadonnées de document. |
| Les résultats de rappel sont incomplets et n'incluent pas tous les tronçons de texte pertinents. | Abaissez le seuil de similarité et augmentez le nombre de tronçons rappelés afin de récupérer les informations précédemment omises. |
| Les résultats de rappel contiennent un grand nombre de tronçons de texte non pertinents. | Augmentez le seuil de similarité pour exclure les informations présentant une faible similarité avec l'invite de l'utilisateur. |
2.3.1 Réécriture des conversations multi-tours
Lors d'une conversation multi-tours, un utilisateur peut poser une question avec une invite courte, telle que « Model Studio Phone X1 ». Cela peut empêcher le système RAG de disposer du contexte nécessaire lors de la récupération pour les raisons suivantes :
- Un produit téléphonique possède souvent plusieurs générations vendues simultanément.
- Pour une même génération de produit, le fabricant propose généralement plusieurs options de stockage, telles que 128 Go et 256 Go. ...
2.3.2 Filtrage par tags
Cette section s'applique uniquement aux bases de connaissances de recherche documentaire .Lorsque vous utilisez une application musicale, vous pouvez filtrer les chansons par artiste pour trouver rapidement toutes les chansons de cet artiste. De la même manière, l'ajout de tags à vos documents non structurés introduit des informations structurées supplémentaires. Lors de la récupération depuis la base de connaissances, l'application peut d'abord filtrer les documents en fonction des tags, ce qui améliore la précision et l'efficacité de la récupération. Model Studio prend en charge les deux méthodes suivantes pour définir des tags :
- Définir des tags lors du téléchargement des documents : Pour les étapes dans la console, consultez la section Import data.
-
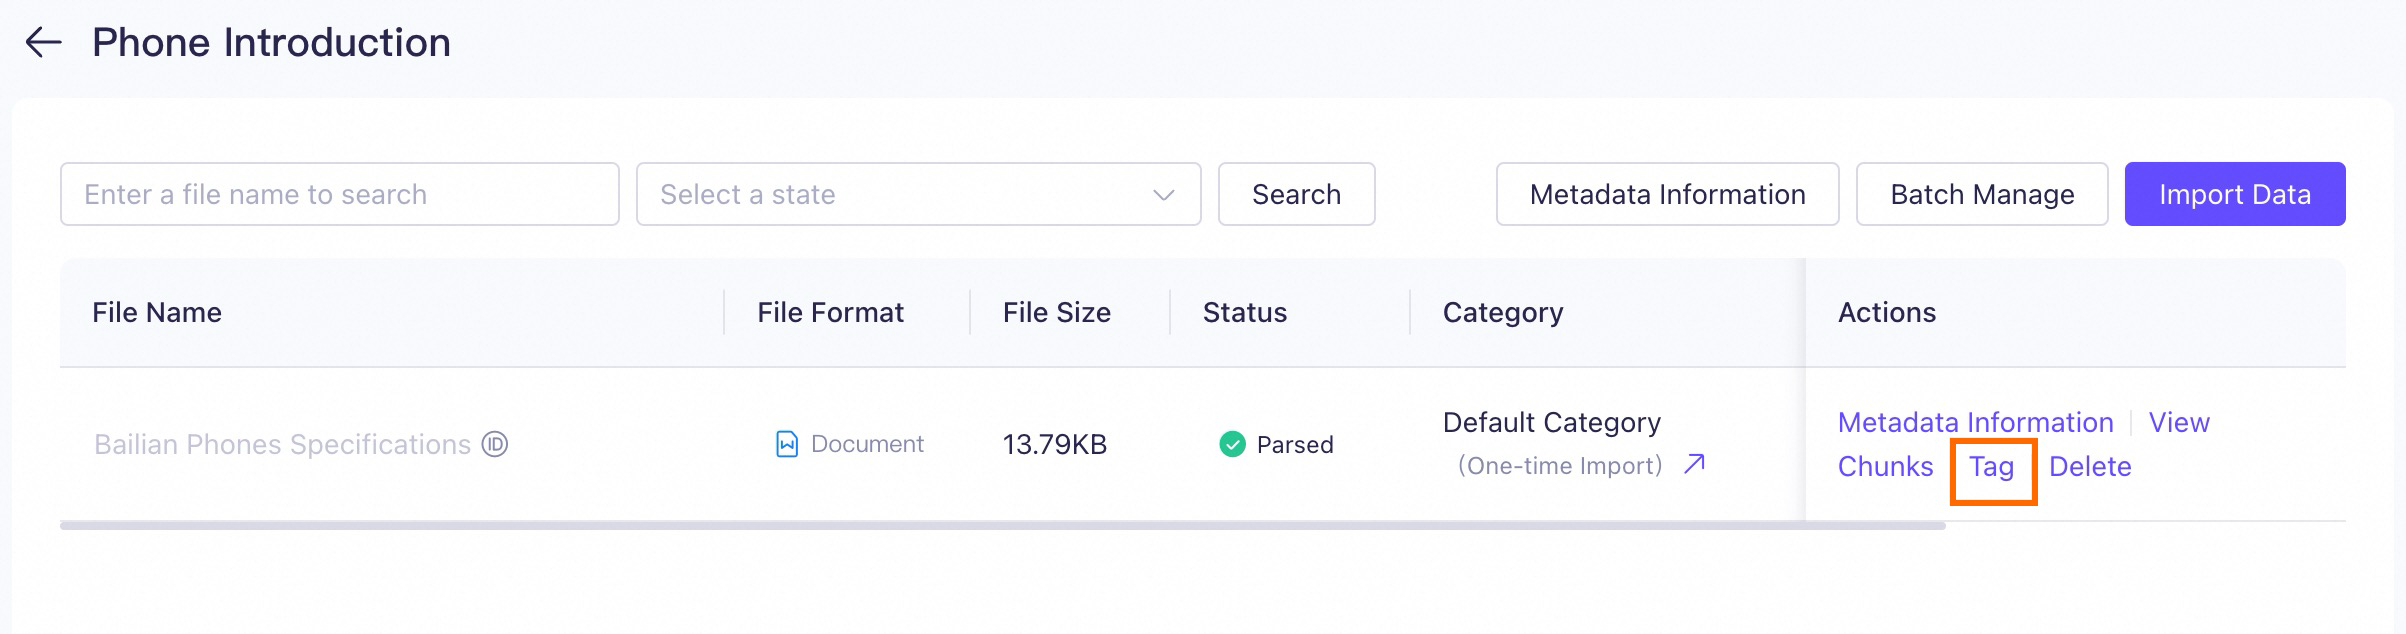
Modifier les tags sur la page Data Management : Pour les documents téléchargés, cliquez sur Tag à droite du document pour modifier ses tags .
-
Lorsque vous appelez une application Model Studio via une API, vous pouvez spécifier des tags dans le paramètre de requête
tags. -
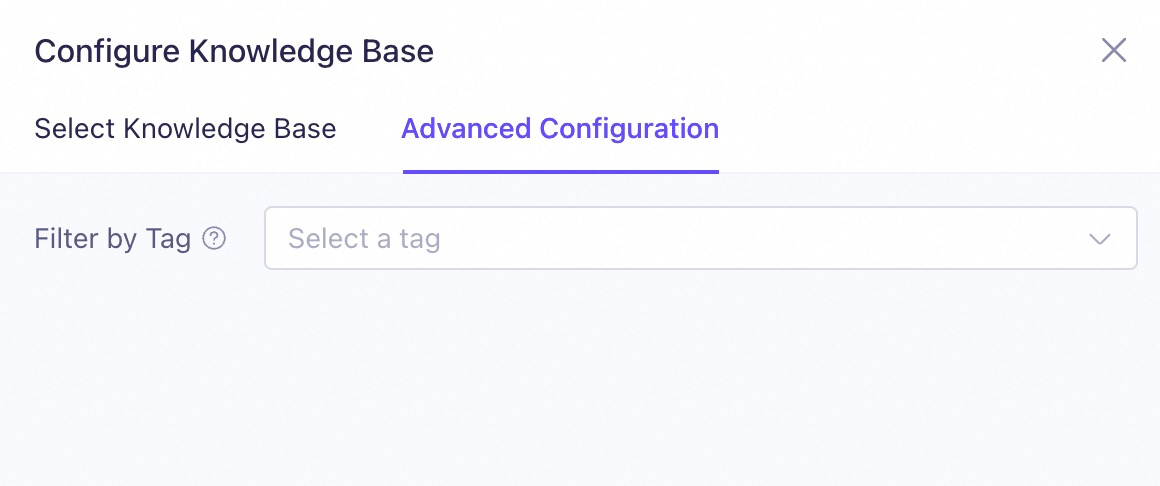
Définissez des tags lors de la modification d'une application dans la console. Toutefois, cette méthode s'applique uniquement aux agent applications.
Notez que ce paramètre s'applique à toutes les questions et réponses utilisateur ultérieures pour cette agent application.
2.3.3 Extraction de métadonnées
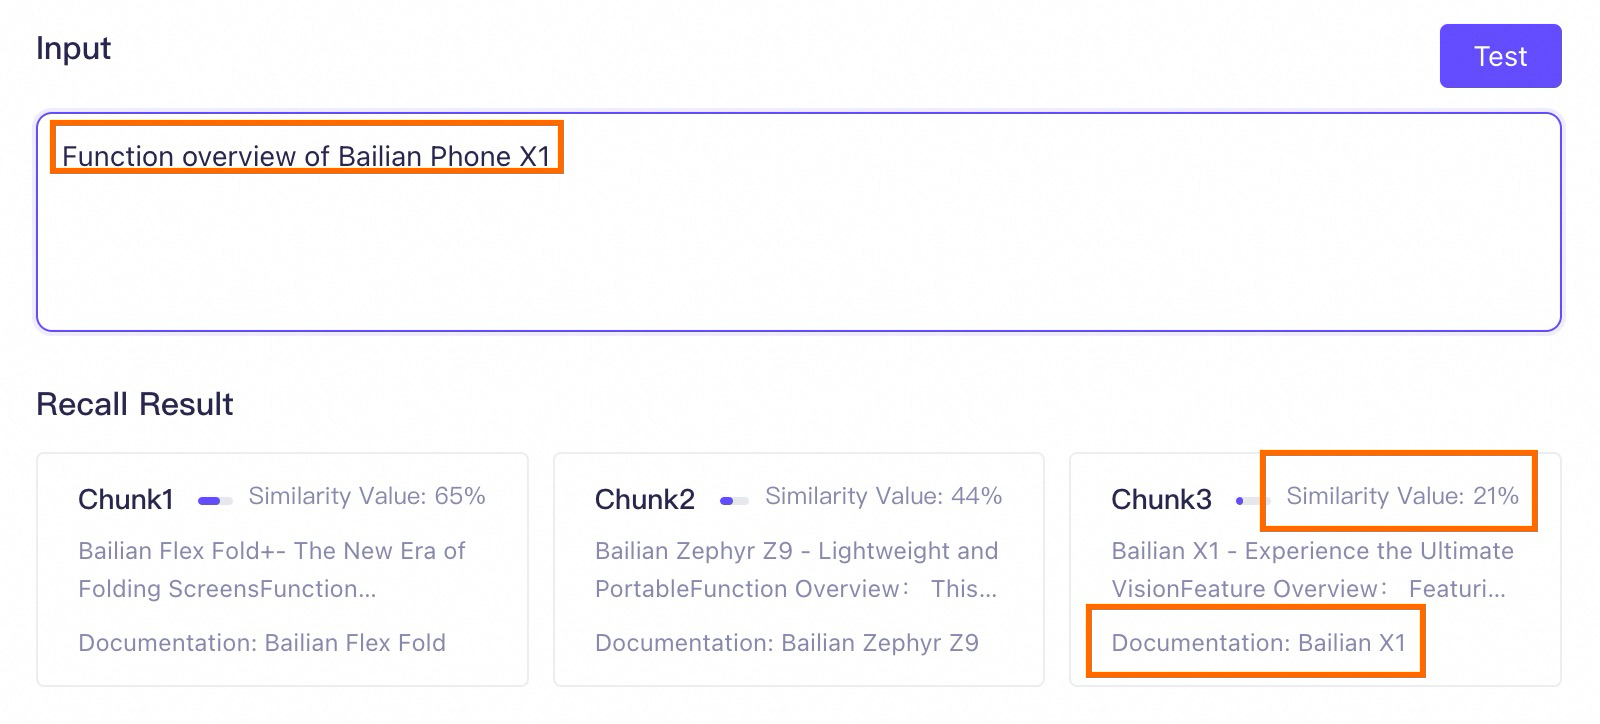
Cette section s'applique uniquement aux bases de connaissances de recherche documentaire .L'intégration de métadonnées dans les tronçons de texte peut efficacement enrichir le contexte de chaque tronçon. Dans des scénarios spécifiques, cette méthode peut améliorer considérablement les performances RAG des bases de connaissances de recherche documentaire . Prenons le scénario suivant : Une base de connaissances contient de nombreux manuels de produits téléphoniques. Les noms des documents correspondent aux modèles de téléphone (tels que Model Studio X1 et Model Studio Zephyr Z9), et tous les documents incluent un chapitre « Feature Overview ». Si les métadonnées ne sont pas activées pour cette base de connaissances, un utilisateur peut saisir l'invite suivante pour la récupération :
Les résultats du test de récupération garantissent le classement, mais le score de similarité absolu est fourni à titre indicatif uniquement. Lorsque la différence entre les valeurs absolues est faible (inférieure à 5 %), la probabilité de rappel peut être considérée comme identique.
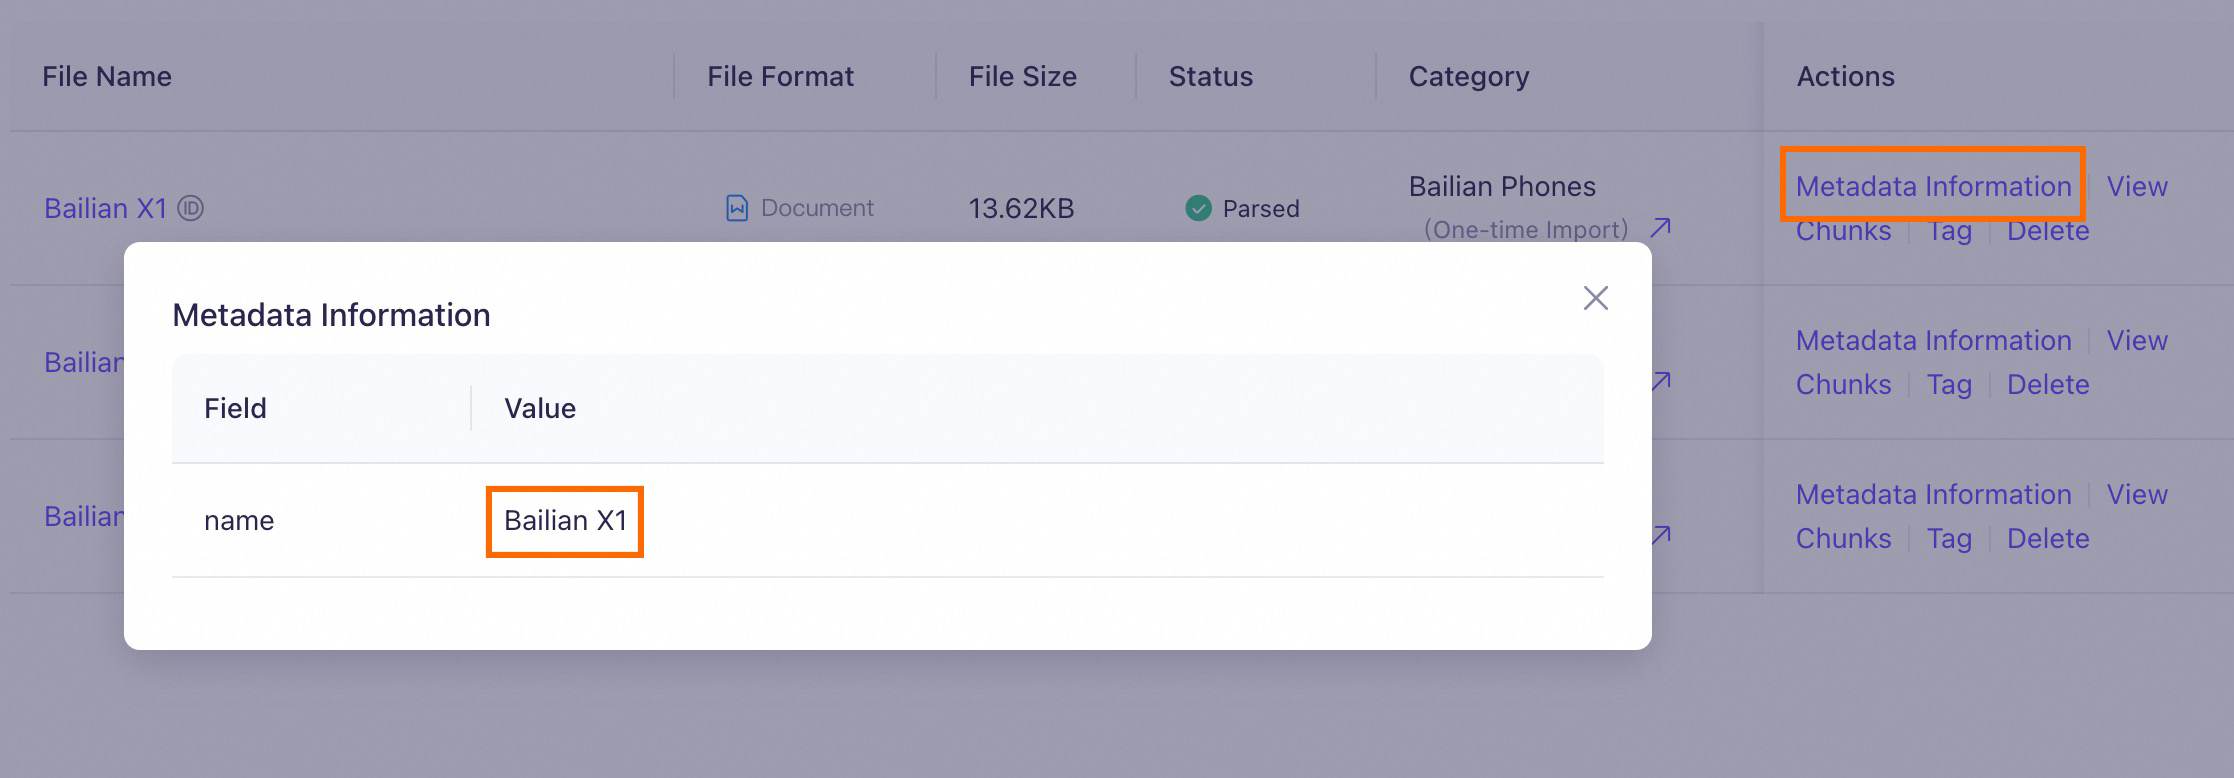
- Extrayez les métadonnées {"key": "name", "value": "Model Studio Phone X1"} de l'invite.
- Sur la base des métadonnées extraites, trouvez tous les tronçons de texte contenant les métadonnées « Model Studio Phone X1 ».
- Ensuite, effectuez une recherche vectorielle (sémantique) pour trouver les tronçons de texte les plus pertinents.
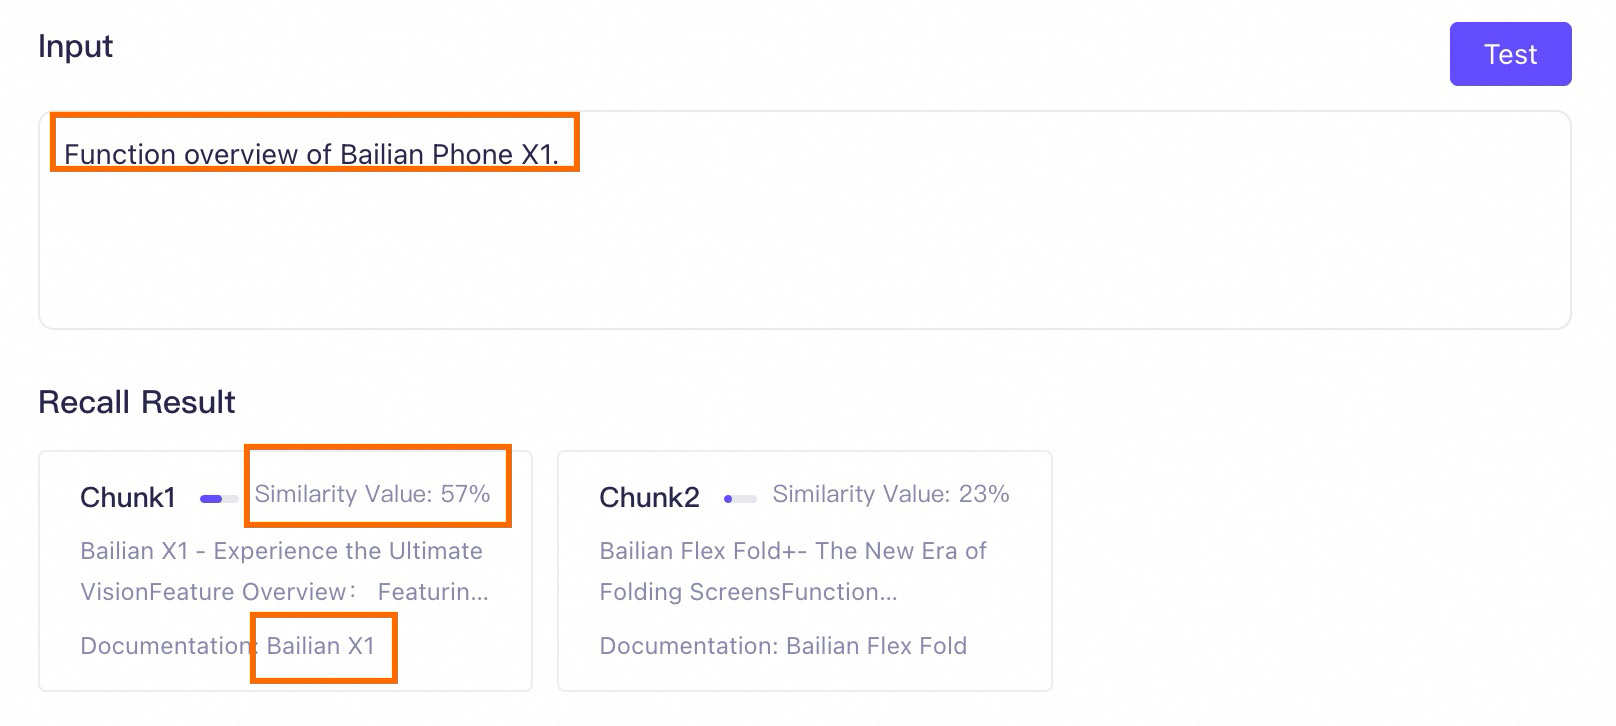
2.3.4 Seuil de similarité
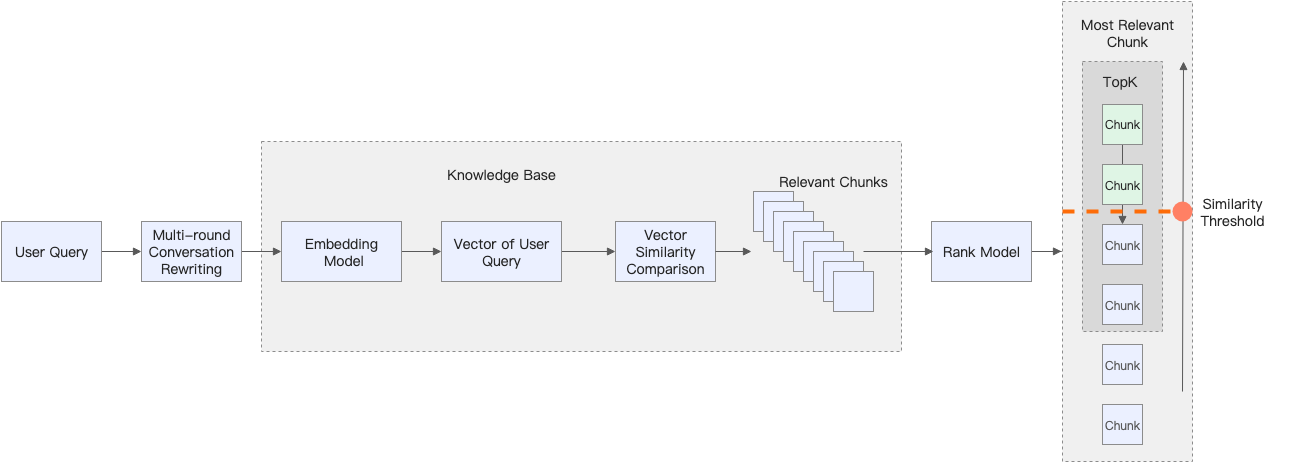
Lorsque la base de connaissances trouve des tronçons de texte liés à l'invite de l'utilisateur, elle les envoie d'abord au modèle Rank (configuré dans Custom parameter settings lors de la création de la base de connaissances) pour les reclasser. Le seuil de similarité est ensuite utilisé pour filtrer les tronçons de texte reclassés. Seuls les tronçons de texte dont le score de similarité dépasse ce seuil peuvent être fournis au modèle.
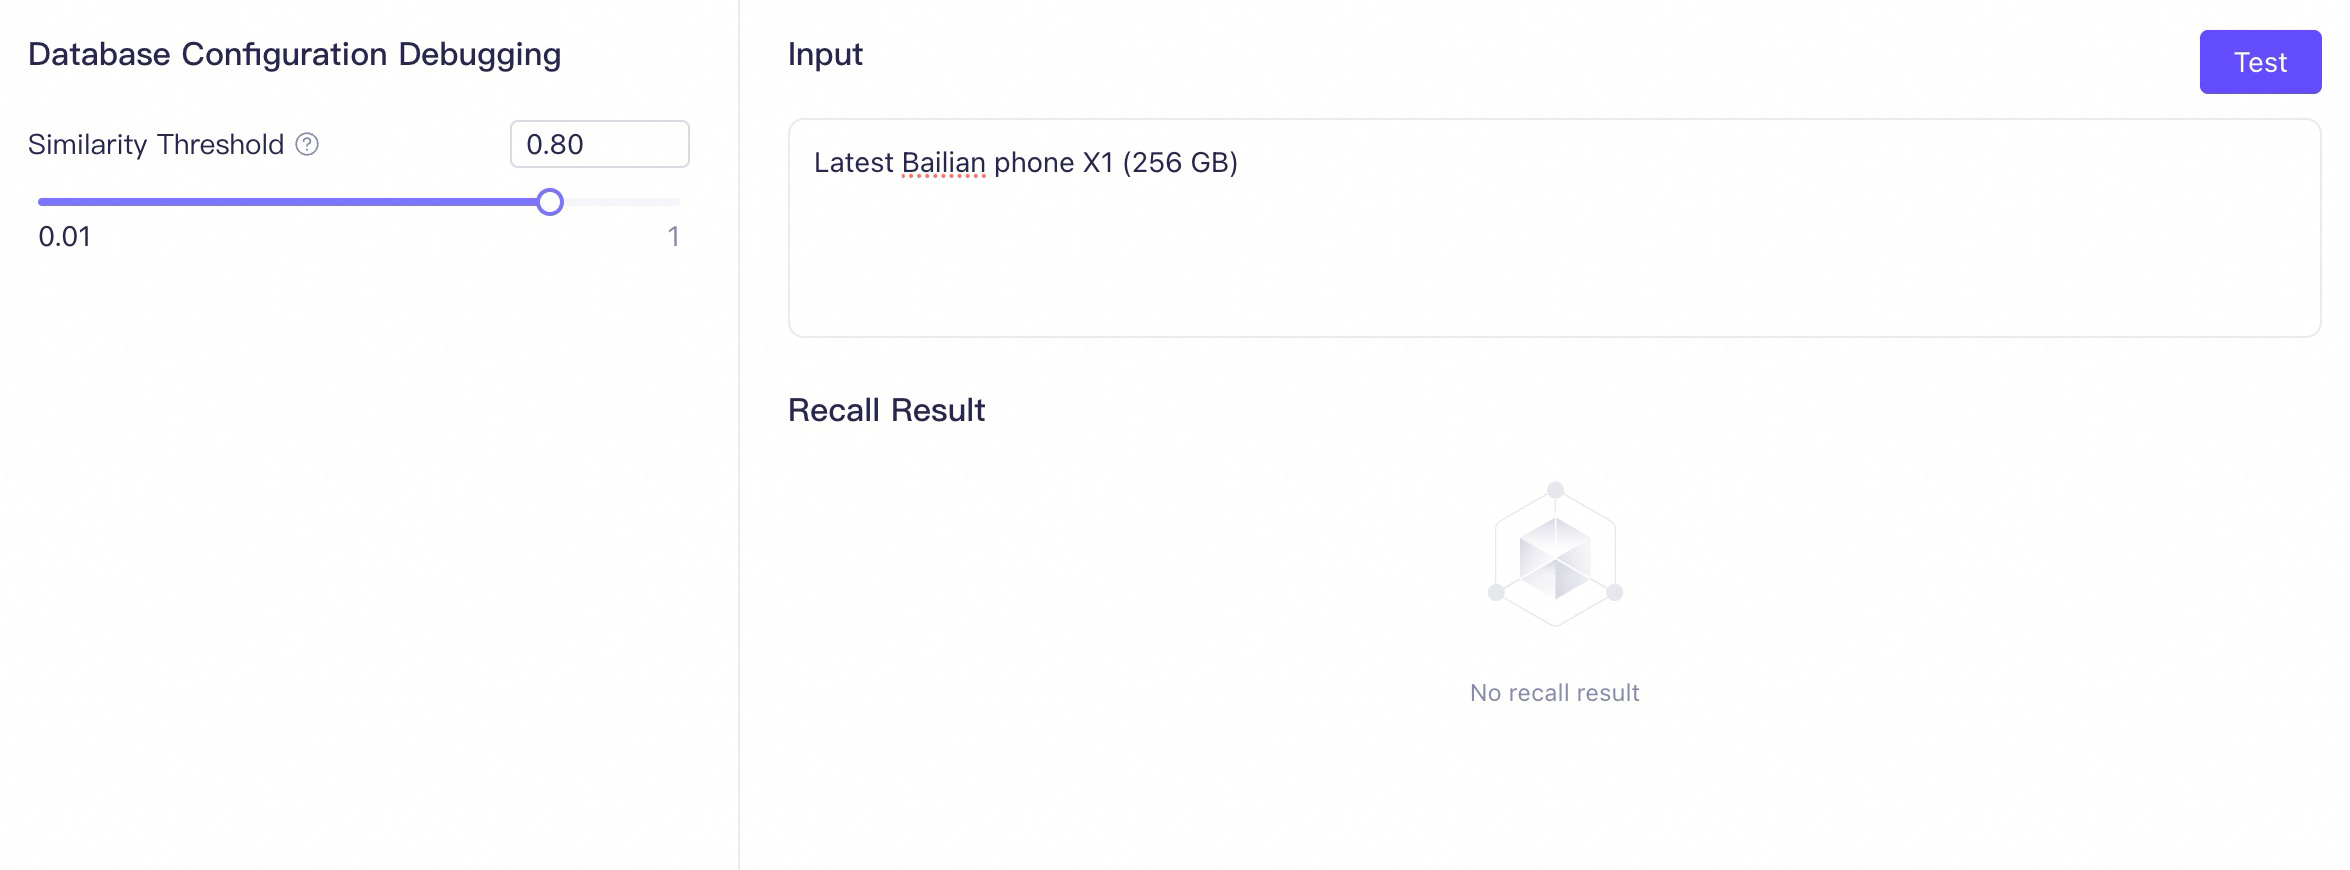
| Étapes recommandées pour les tests de récupération | |
|  |
2.3.5 Nombre de blocs rappelés
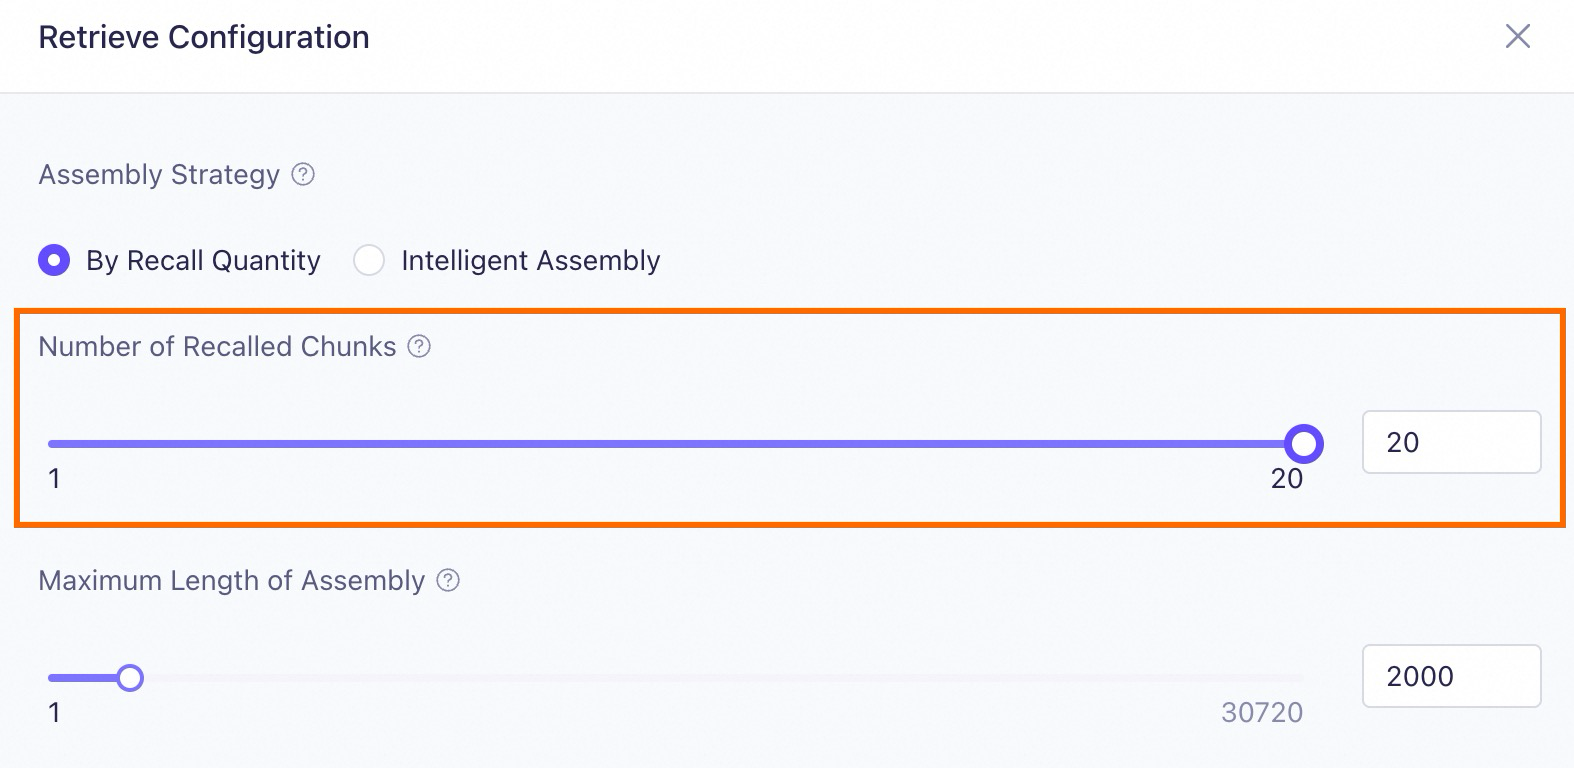
Le nombre de blocs rappelés correspond à la valeur K dans la stratégie de rappel multicanaux. Après le filtrage basé sur le seuil de similarité, si le nombre de blocs de texte dépasse K, le système sélectionne les K blocs de texte présentant les scores de similarité les plus élevés pour les fournir au modèle. Par conséquent, une valeur K inappropriée peut entraîner l'omission de blocs de texte pertinents par le RAG, ce qui affecte la capacité du modèle à générer une réponse complète.
Par exemple, un utilisateur récupère des informations avec l'invite suivante :

De nombreuses expériences montrent que dans des scénarios tels que « Lister... », « Résumer... » et « Comparer X et Y... », il est plus efficace de fournir davantage de blocs de texte de haute qualité (par exemple, K=20) au modèle que de se limiter aux 10 ou 5 premiers. Bien que cela puisse introduire du bruit, si la qualité des blocs de texte est élevée, un modèle performant peut généralement le gérer.Vous pouvez ajuster le Number of Recalled Chunks lors de la modification d'une application dans Alibaba Cloud Model Studio.
2,4 Génération de réponses
Cette rubrique décrit uniquement les éléments de configuration qu'Alibaba Cloud Model Studio prend en charge pour l'optimisation lors de l'étape de génération de réponses.À ce stade, le modèle peut générer la réponse finale en se basant sur l'invite de l'utilisateur et le contenu récupéré depuis la base de connaissances. Toutefois, le résultat renvoyé peut encore ne pas répondre à vos attentes.
Type de problème | Stratégie d'amélioration |
|---|---|
Le modèle ne comprend pas la relation entre les connaissances et l'invite de l'utilisateur. La réponse semble être constituée de morceaux de texte disparates assemblés. | Sélectionnez un modèle adapté pour comprendre efficacement la relation entre les connaissances et l'invite de l'utilisateur. |
Le résultat renvoyé ne suit pas les instructions ou n'est pas exhaustif. | |
Le résultat renvoyé n'est pas assez précis. Il contient les connaissances générales propres au modèle et ne s'appuie pas entièrement sur la base de connaissances. | Activez le rejet pour limiter les réponses aux seules connaissances récupérées depuis la base de connaissances. |
Pour des invites similaires, vous souhaitez que les résultats soient soit cohérents, soit variés. |
2.4.1 Sélection du modèle
Les différents grands modèles présentent des capacités variables dans des domaines tels que le respect des instructions, la prise en charge des langues, la gestion de textes longs et la compréhension des connaissances. Cela peut conduire à la situation suivante :
Le Model A n'a pas réussi à comprendre efficacement la relation entre les connaissances récupérées et l'invite, et la réponse générée ne pouvait pas traiter avec précision l'invite de l'utilisateur. Le passage au Model B, qui dispose de plus de paramètres ou de capacités spécialisées plus puissantes, peut résoudre ce problème.
Vous pouvez Select Model lors de la modification d'une application dans Alibaba Cloud Model Studio, en fonction de vos besoins réels.
Qwen-Max et Qwen-Plus. Ces grands modèles commerciaux disposent des dernières capacités et améliorations par rapport à leurs versions open source.
- Pour les requêtes d'informations simples et la synthèse, les grands modèles avec un petit nombre de paramètres suffisent, tels que
Qwen-Turbo. - Si vous souhaitez que le RAG effectue un raisonnement logique plus complexe, sélectionnez un grand modèle avec plus de paramètres et des capacités de raisonnement plus puissantes, tel que
Qwen-Max. - Si votre requête nécessite de référencer de nombreux extraits de documents, vous devez sélectionner un grand modèle avec une longueur de contexte plus importante, tel que
Qwen-Plus. - Si vous construisez une application RAG pour un domaine spécialisé, tel que le domaine juridique, utilisez un modèle entraîné spécifiquement pour ce domaine, tel que
Qwen-Legal.
2.4.2 Optimisation du modèle d'invite
Vous pouvez influencer le comportement d'un modèle et améliorer les performances du RAG en concevant l'invite qui guide l'utilisation des connaissances récupérées.
Voici trois méthodes d'optimisation courantes :
Méthode 1 : Contraintes sur le contenu de sortie
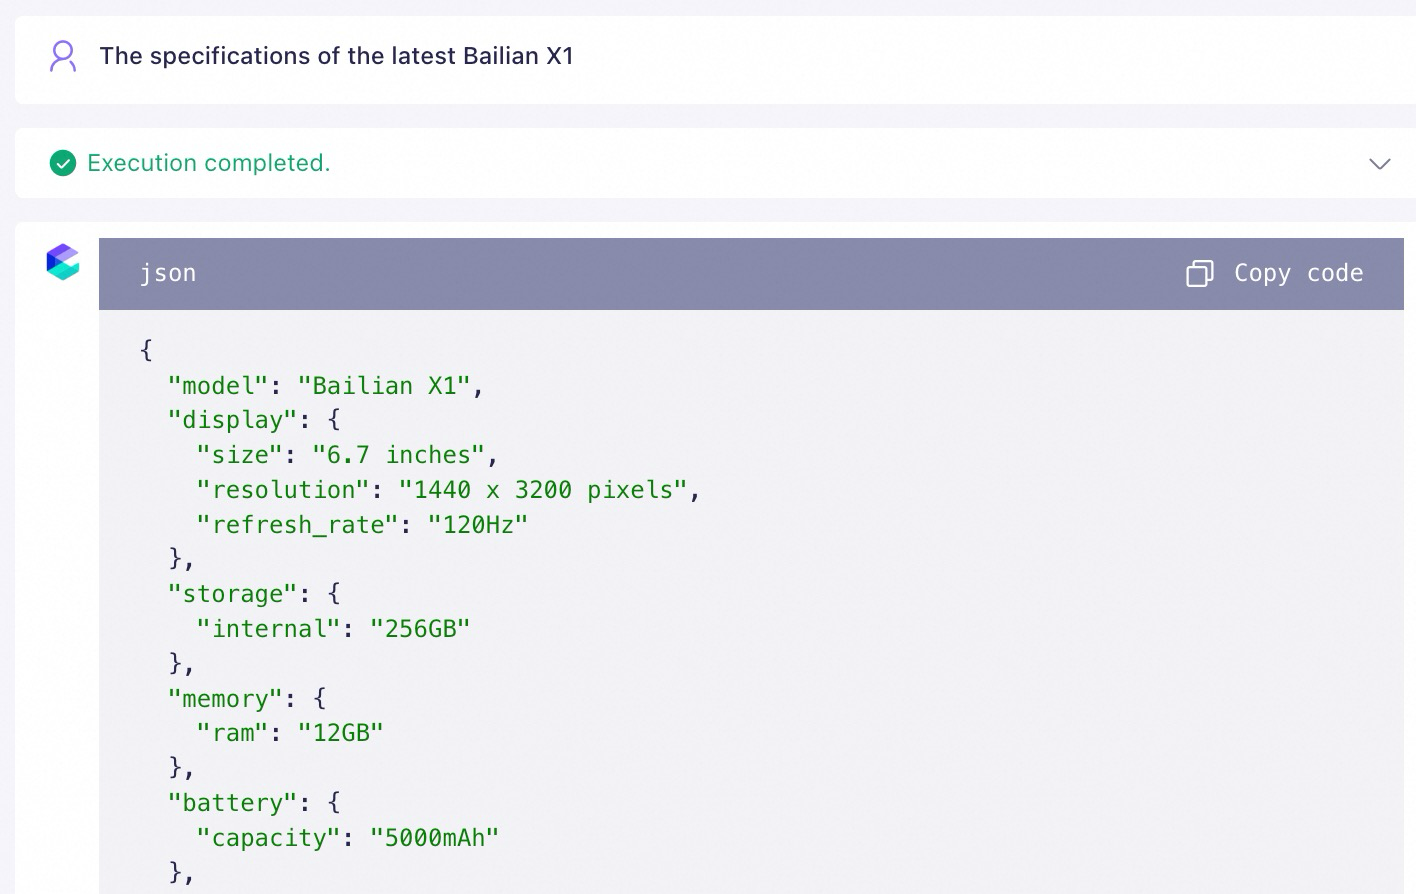
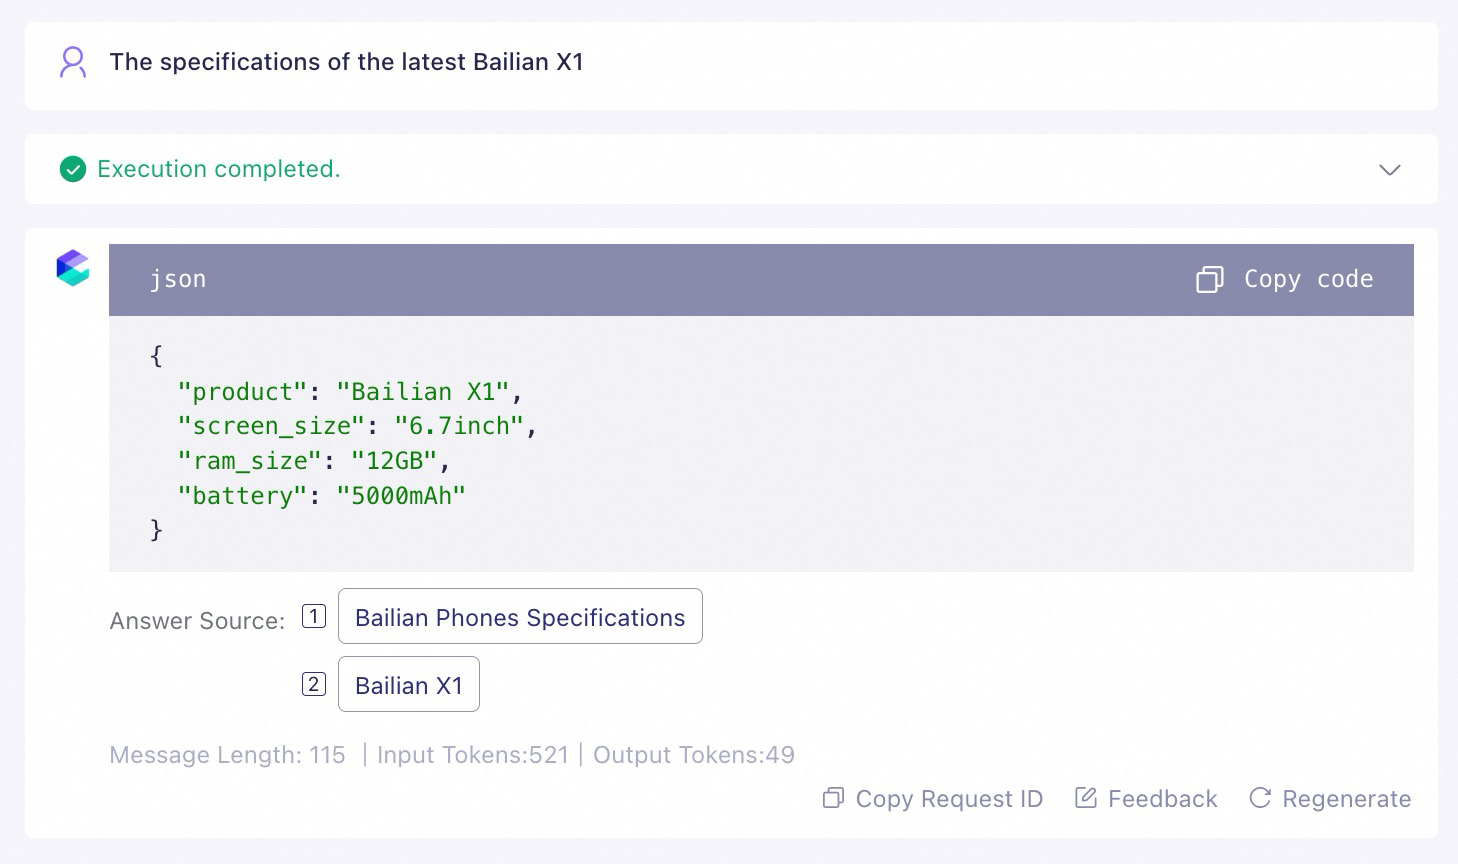
Vous pouvez fournir des informations contextuelles, des instructions et le format de sortie attendu dans le modèle d'invite pour guider le modèle. Par exemple, vous pouvez ajouter l'instruction de sortie suivante :
| Modèle d'invite | Résultat |
|---|---|
 | |
 |
${documents}.
De plus, pour garantir les meilleurs résultats, assurez-vous que la variable ${documents} n'apparaît qu'une seule fois dans votre modèle d'invite. Reportez-vous à l'exemple correct ci-dessous à gauche.
2.4.3 Rejet
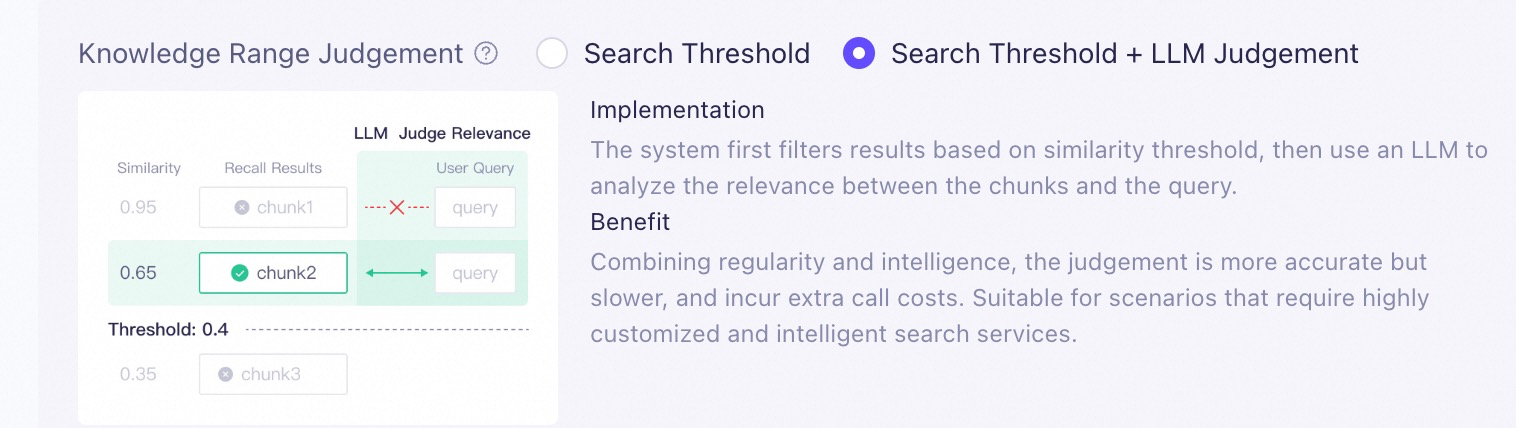
Si vous souhaitez que les résultats renvoyés par votre application Alibaba Cloud Model Studio soient strictement basés sur les connaissances récupérées depuis la base de connaissances, et exclure l'influence des connaissances générales propres au modèle, vous pouvez définir la portée de la réponse sur Knowledge Base Only lors de la modification de l'application.
Dans les cas où aucune connaissance pertinente n'est trouvée dans la base de connaissances, vous pouvez également définir une réponse automatique fixe.
Portée de la réponse : Knowledge Base + LLM Knowledge | Portée de la réponse : Knowledge Base Only |
 |  |
Le résultat renvoyé par l'application Alibaba Cloud Model Studio sera une combinaison des connaissances récupérées depuis la base de connaissances et des connaissances générales propres au modèle. | Le résultat renvoyé par l'application Alibaba Cloud Model Studio sera strictement basé sur les connaissances récupérées depuis la base de connaissances. |
Sorry, no relevant phone models were found.
Requête réussie | Requête infructueuse |
|---|---|
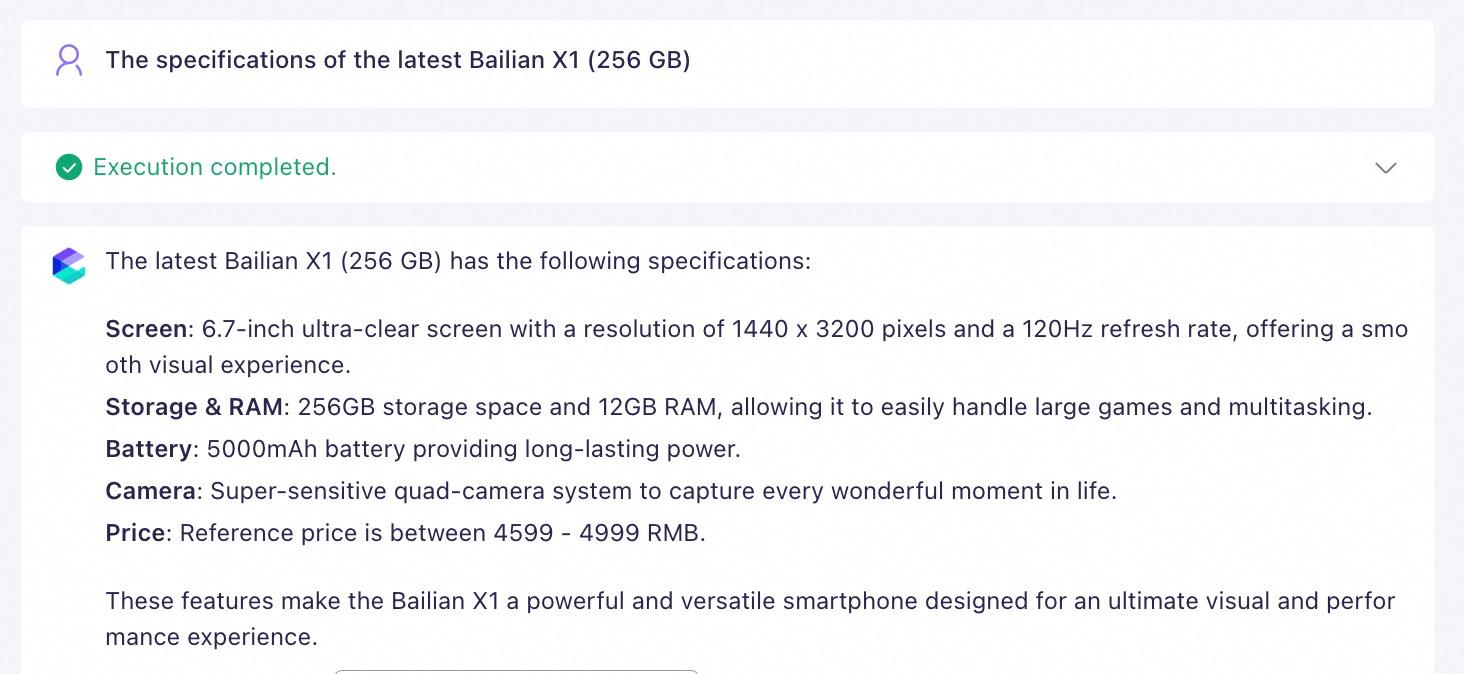 | 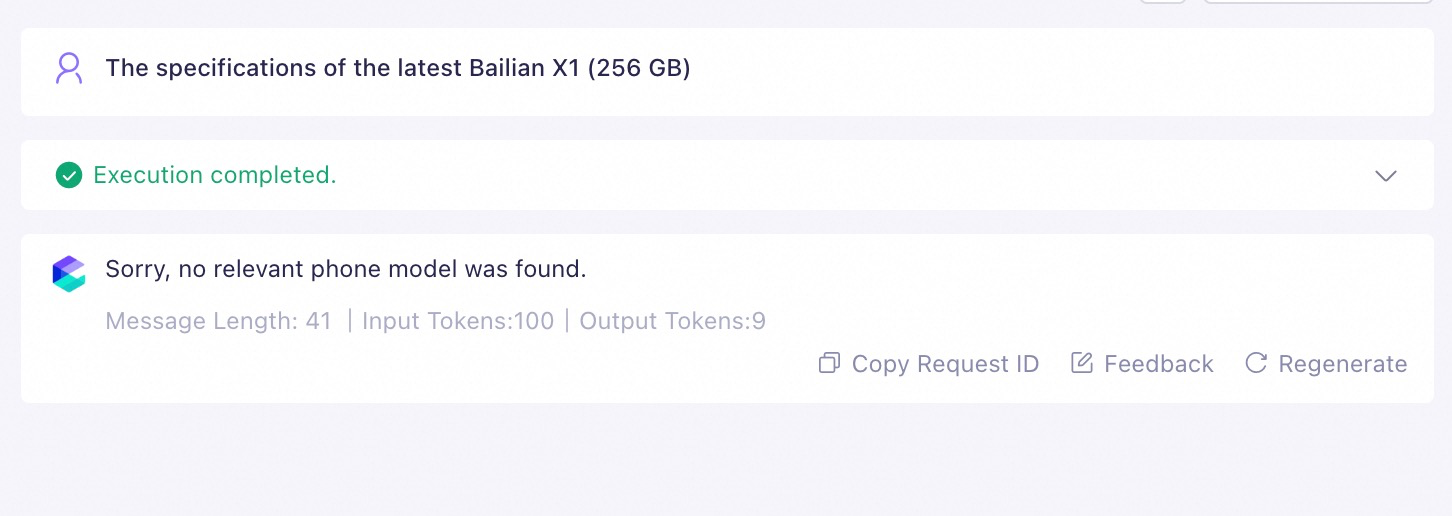 |
2.4.4 Paramètres du modèle
Pour contrôler si le modèle fournit des réponses cohérentes ou variées à des invites similaires, vous pouvez modifier les Configure Parameters afin d'ajuster les paramètres du modèle lors de la modification de l'application.
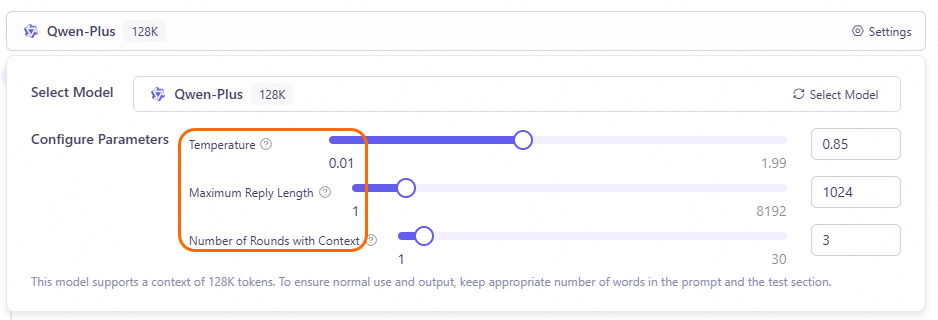
- Un texte diversifié convient à la rédaction créative (comme les romans et les publicités), au brainstorming et aux scénarios d'applications de chat.
- Un texte déterministe convient aux scénarios avec des réponses claires (comme l'analyse de problèmes, les questions à choix multiples et la recherche de faits) ou nécessitant une formulation précise (comme les documents techniques, les textes juridiques, les articles de presse et les publications académiques).
3. FAQ
Comment formater les documents pour optimiser le RAG ?
Comment formater les documents pour optimiser le RAG ?
- Utilisez des niveaux de titres clairs. Assurez-vous que le contenu sous chaque titre est clair et autonome.
- Évitez les filigranes.
- Évitez d'imbriquer des niveaux de liste sous un élément au milieu d'une liste.
- Évitez autant que possible les tableaux et les images, car les tableaux complexes peuvent affecter la qualité de l'analyse.


- Le contenu sous chaque titre est clair et relativement indépendant.
- Aucun filigrane.
- Une liste apparaît sous le titre, mais elle ne contient pas de listes imbriquées.
- Aucun tableau ni image.