

Une base de connaissances enrichit un LLM avec des données privées et des informations actualisées. Grâce à la génération augmentée par récupération (RAG), le LLM améliore la précision de ses réponses en récupérant d'abord le contenu pertinent depuis la base de connaissances avant de générer une réponse.
Application sans base de connaissances dédiée Sans base de connaissances dédiée, un LLM ne peut pas répondre avec précision aux questions spécifiques à un domaine. Par exemple, lorsqu'un utilisateur envoie « Aidez-moi à choisir le meilleur téléphone photo sur Alibaba Cloud Model Studio, avec un budget de 3 000 yuans » dans l'interface de chat, l'assistant IA ne peut pas fournir de recommandations de produits précises en raison de l'absence de base de connaissances pertinente. | Application avec une base de connaissances dédiée Avec une base de connaissances dédiée, un LLM peut répondre avec précision aux questions spécifiques à un domaine. 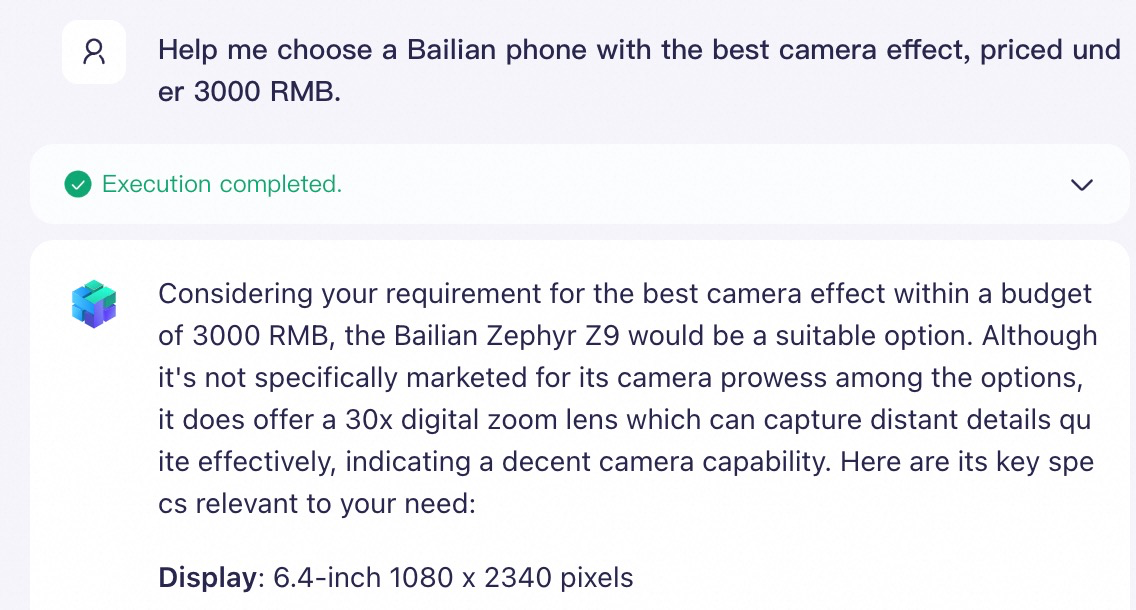 |
Modèles pris en charge
Les modèles suivants peuvent être utilisés avec une base de connaissances. Configurer Qwen pour utiliser une base de connaissances
- Qwen-Max/Plus/Turbo
- QwenVL-Max/Plus
- Version open source Qwen (par exemple, Qwen2,5)
Pour obtenir la liste actualisée des modèles disponibles, consultez la page Application Management lors de la création d'une application.
Démarrage rapide
Ce guide de démarrage rapide explique comment créer une application LLM de questions-réponses sans code pour répondre à des questions spécifiques à un domaine, en prenant l'exemple des « téléphones Alibaba Cloud Model Studio ».
1. Créer une base de connaissances
- Accédez à la page Base de connaissances et cliquez sur Create Knowledge Base. Saisissez un Name et une Description, laissez les autres paramètres avec leurs valeurs par défaut et cliquez sur Next Step.
- Sélectionnez la catégorie Default Category et téléchargez le fichier Alibaba Cloud Model Studio Phone Series Product Introduction.docx. Cliquez sur Next Step, puis sur Complete.
2. Intégrer avec des applications métier
Après avoir créé une base de connaissances, vous pouvez l'associer à une application Alibaba Cloud Model Studio ou à une application externe au sein du même espace de travail pour traiter les requêtes de récupération.
- Agent application
- Workflow application
- External application
- Accédez à la page App Center, localisez votre application agent, cliquez sur Configure sur sa carte et sélectionnez un modèle pour l'application.
-
Cliquez sur l'icône + à côté de Document Knowledge Base pour ajouter la base de connaissances que vous venez de créer. Vous pouvez conserver les valeurs par défaut pour le seuil de similarité et le poids.
(Facultatif) Seuil de similarité : Filtrer les résultats de récupération
Une base de connaissances utilise la recherche sémantique pour trouver du texte conceptuellement pertinent dans vos données ou fichiers privés, même sans correspondance de mots-clés.Par exemple, un utilisateur soumet la requête suivante :Which Alibaba Cloud phone is best for photography?La réponse réelle (par exemple, « Qwen Vivid 7... ») ne contient aucun mot-clé de la requête.Dans le tableau ci-dessous, la similarité par mots-clés est calculée à l'aide de l' indice de Jaccard , et la similarité sémantique est la similarité cosinus calculée par le modèle
text-embedding-v4.
Seuil de similarité : Seul le texte dont le score de similarité sémantique est supérieur à cette valeur est récupéré. Définir ce seuil trop haut peut entraîner le filtrage de textes pertinents.Retrieved text
Keyword similarity
Semantic similarity
Qwen Vivid 7: A new experience in smart photography
0
0,43
Alibaba Cloud Model Studio Ace Ultra: The choice for gamers
0,17
0,32
Alibaba Cloud Model Studio Flex Fold+: A new era of foldable screens
0,25
0,24
(Facultatif) Poids : Influencer l'ordre de récupération depuis plusieurs bases de connaissances
Lorsqu'une application agent est associée à plusieurs bases de connaissances, vous pouvez attribuer un poids à chacune en fonction de l'importance de la source d'information. Lors d'une récupération multisource, si des fragments provenant de différentes bases de connaissances ont le même score de similarité, le système priorise les fragments de la base de connaissances ayant le poids le plus élevé.- Limitation clé : Le poids n'est effectif qu'entre des bases de connaissances du même type. Par exemple, le poids d'une base de connaissances de recherche documentaire n'affecte pas l'ordre de récupération d'une base de connaissances de requête de données, et vice versa.
- Fonctionnement : Le système calcule d'abord la pertinence de la requête utilisateur par rapport au contenu de chaque base de connaissances pour identifier les fragments les plus pertinents. Il multiplie ensuite le score de similarité de chaque fragment par le poids de sa base de connaissances correspondante. Après un reclassement basé sur ces scores pondérés, les résultats sont fournis au LLM comme contexte, garantissant que les fragments ayant les scores pondérés les plus élevés sont prioritaires dans la réponse finale.
-
Dans la zone de saisie à droite, entrez une question. Le LLM utilise alors la base de connaissances pour générer une réponse.
Par exemple : « Aidez-moi à choisir le téléphone Alibaba Cloud Model Studio avec le meilleur appareil photo pour moins de 3 000 CNY. »
Stratégie de génération par lots : Lorsque vous avez besoin qu'une application agent génère un grand volume de contenu à partir d'une base de connaissances, comme des questions de quiz ou des résumés, une seule requête peut renvoyer moins d'éléments que demandé car la longueur de sortie d'une réponse LLM est limitée. Divisez la requête en plusieurs lots d'environ 30 éléments chacun et complétez-les sur plusieurs tours. Par exemple, envoyez d'abord « Générer les questions 1 à 30 en fonction de la base de connaissances », et une fois ce lot terminé, envoyez « Continuer avec les questions 31 à 60 ». Référence mesurée : une seule requête pour 100 questions n'a renvoyé qu'environ 24 questions, tandis que trois lots de 30 questions chacun ont renvoyé toutes les 30 questions par lot, soit 90 questions au total. Le nombre réel d'éléments générés varie selon le modèle sélectionné et la longueur du contenu ; utilisez donc vos propres résultats de test comme référence finale.
3. Optimiser les performances RAG (facultatif)
Si vous obtenez des résultats incomplets ou inexacts lors du processus de questions-réponses, consultez la section Optimisation des performances RAG.
Procédures
Sur la page base de connaissances, vous pouvez consulter et gérer toutes les bases de connaissances de l'espace de travail actuel.
ID de la base de connaissances : L' ID de chaque base de connaissances, utilisé pour les appels API.
- Créer une base de connaissances
- Mettre à jour une base de connaissances
- Modifier une base de connaissances
- Supprimer une base de connaissances
- Modifier la configuration
- Test de pertinence
- Sur la page base de connaissances, cliquez sur Create Knowledge Base.
-
Informations de base
Sélectionnez un Knowledge Base Type en fonction de votre cas d'utilisation. Une seule base de connaissances prend en charge un seul type. Si vous sélectionnez le type document search, vous devez également sélectionner un use case : Basic document Q&A, Rich-text Reply.
- Basic document Q&A : Idéal pour la recherche sémantique sur des documents en texte brut.
- Rich-text Reply : Idéal pour les cas d'utilisation nécessitant des réponses contenant à la fois du texte et des images.
Le type de base de connaissances ne peut pas être modifié après la création de la base de connaissances.
-
Document search
-
Cas d'utilisation :
- Idéal pour la récupération d'informations à partir de données non structurées, telles que les documents internes d'entreprise et les manuels de produits. Les données non structurées sont des informations qui ne sont pas organisées selon un modèle de données ou un schéma prédéfini et peuvent inclure du texte, des tableaux et des images.
- Si vos fichiers contiennent des images que vous souhaitez que l'application inclue dans ses réponses, sélectionnez document search.
-
Data source : Vous pouvez télécharger des fichiers locaux ou les importer depuis Object Storage Service (OSS).
Création de recherche documentaire
-
Select data : Spécifiez une source de données (fichiers ou contenu) pour la base de connaissances. Le système importe le contenu source dans la base de connaissances pour la récupération. Vous pouvez utiliser local upload ou cloud import (en sélectionnant une catégorie ou un fichier existant).
-
Local upload : Téléchargez des fichiers directement depuis votre ordinateur. Développez le panneau réductible ci-dessous pour savoir comment sélectionner une méthode d'analyse.
Méthodes d'analyse
Configurez la stratégie d'analyse en fonction de vos besoins. Si vous ne savez pas quelle option choisir, nous vous recommandons d'utiliser les paramètres par défaut.- Digital Parsing : n'analyse pas les illustrations ou les graphiques présents dans les fichiers. Il s'agit de la méthode d'analyse la plus rapide. Un document texte brut de 10 à 20 pages est généralement analysé en quelques secondes à 1 minute.
- Intelligent Document Parsing : reconnaît et extrait le texte des illustrations de vos fichiers pour générer des résumés textuels. Ces résumés, ainsi que les autres contenus non imagés, sont ensuite découpés en segments et vectorisés pour la recherche. Cette méthode est relativement rapide. L'analyse d'un document de 10 à 20 pages contenant des illustrations prend généralement entre 1 et 5 minutes.
- LLM Parsing : permet aux applications utilisant le modèle Qwen-VL de répondre à des questions sur le contenu des illustrations et des graphiques de vos fichiers. Pour activer la reconnaissance et la compréhension de ce contenu, sélectionnez LLM Parsing. Étant donné que cette méthode fait appel à un LLM pour une compréhension approfondie, l'analyse d'un document de 10 à 20 pages contenant des graphiques prend généralement entre 2 et 10 minutes.
- Qwen-VL parsing : conçu spécifiquement pour les fichiers image. Vous pouvez spécifier un modèle Qwen-VL et fournir une invite pour guider la reconnaissance et l'extraction de la mise en page et des éléments de l'image. Une seule image est généralement analysée en quelques secondes à 1 minute.
- Importation depuis le cloud : importez des fichiers existants depuis Object Storage Service (OSS).
-
Local upload : Téléchargez des fichiers directement depuis votre ordinateur. Développez le panneau réductible ci-dessous pour savoir comment sélectionner une méthode d'analyse.
-
Configuration de l'index : définit la manière dont les données importées sont traitées et stockées, ce qui affecte directement les performances de recherche.
Parmi les paramètres suivants, seul le stockage vectoriel avec AnalyticDB for PostgreSQL (ADB-PG) peut engendrer des frais. Tous les autres paramètres sont gratuits.
- Extraction des métadonnées
- Assemblage des en-têtes Excel
- Méthode de découpage
- Réécriture des conversations multi-tours
- Embedding model
- Reranking model
- Similarity threshold
- Maximum recall count
- Vector storage
Les métadonnées sont constituées d'attributs supplémentaires pour les données non structurées, qui sont intégrés aux segments sous forme de paires clé-valeur.- Objectif : les métadonnées fournissent un contexte important pour les segments et peuvent améliorer considérablement la précision de la recherche dans la base de connaissances. Par exemple, prenons une base de connaissances contenant des milliers de fichiers de présentation de produits, où le nom du fichier correspond au nom du produit. Lorsqu'un utilisateur recherche « aperçu fonctionnel du Produit A », si le corps de chaque fichier contient « aperçu fonctionnel » mais qu'aucun ne mentionne « Produit A », la base de connaissances risque de récupérer de nombreux segments non pertinents. En revanche, si vous ajoutez le nom du produit comme métadonnée à tous les segments, la base de connaissances peut filtrer avec précision les segments liés au « Produit A » qui contiennent également « aperçu fonctionnel ». Cela améliore la précision de la recherche et réduit la consommation de jetons d'entrée du LLM.
- Utilisation : lorsque vous appelez une application via une API, vous pouvez spécifier
metadatadans le paramètre de requêtemetadata_filter. Lorsque l'application récupère des informations depuis la base de connaissances, elle filtre d'abord les fichiers pertinents en fonction desmetadataspécifiées. - Remarque : vous ne pouvez pas configurer l'extraction des métadonnées après la création d'une base de connaissances.
Configuration des métadonnées
Activez Metadata extraction, puis cliquez sur Settings pour associer des métadonnées uniformes ou personnalisées à tous les fichiers de la base de connaissances. Lors du découpage en segments, les métadonnées de chaque fichier sont intégrées à ses segments respectifs.Nouveau modèle de métadonnées
Méthodes d'extraction des valeurs-
Constant : associe un attribut fixe à tous les fichiers de la base de connaissances.
Comme illustré dans l'exemple précédent, si tous les fichiers de la base de connaissances ont le même auteur, vous pouvez définir une constante pour un champ nommé
author. -
Variable : associe un attribut variable à chaque fichier de la base de connaissances. Les attributs actuellement pris en charge sont
file_nameetcat_name. Si vous sélectionnezfile_name, Alibaba Cloud Model Studio associe le nom du fichier à ses métadonnées, comme indiqué dans l'exemple précédent. Si vous sélectionnezcat_name, Alibaba Cloud Model Studio associe le nom de la catégorie contenant le fichier aux métadonnées de ce dernier. -
LLM : le système met en correspondance le contenu du fichier avec la règle Entity Description configurée, extrait les informations pertinentes et les associe en tant qu'attribut de métadonnée.
Comme illustré dans le modèle de métadonnées de l'exemple précédent, pour extraire toutes les années apparaissant dans chaque fichier en tant qu'attributs de fichier, vous pouvez configurer un champ LLM nommé
Dans la zone de saisie Entity Description, entrezdate. La description de l'entité est configurée comme suit :date information, extract only the year, puis cliquez sur OK. -
RegEx : le système met en correspondance le contenu textuel de chaque fichier de la base de connaissances avec l'expression régulière spécifiée. Le contenu correspondant à l'expression est extrait et ajouté en tant qu'attribut aux métadonnées du fichier.
Comme illustré dans le modèle de métainformations de l'exemple ci-dessus, si vous devez extraire toutes les références apparaissant dans chaque fichier (en supposant qu'une référence est tout texte commençant par « 《 » et se terminant par « 》 »), vous pouvez configurer un champ d'expression régulière nommé
Définissez la valeur de l'expression régulière surreference. L'expression régulière est configurée comme suit :《.*?》. -
Keyword search : le système recherche des mots-clés prédéfinis dans chaque fichier et ajoute les mots-clés correspondants en tant qu'attributs aux métadonnées du fichier.
Par exemple, dans le modèle de métadonnées de l'exemple précédent, les mots-clés prédéfinis sont :
Étant donné que le fichier ne contient que les mots-clés « financing », « industry », « green » et « capital », le système extrait uniquement ces quatre mots-clés en tant que valeur pour l'attribut
keywordsdu fichier.
Création avec compréhension visuelle
Lorsque vous sélectionnez le cas d'utilisation visual understanding (rich-text documents), la base de connaissances utilise un modèle d'embedding multimodal pour analyser visuellement les documents et préserver les informations de mise en page d'origine, au lieu d'appliquer des méthodes de découpage traditionnelles.Restrictions de format de fichier
Dans la zone de téléchargement de fichiers de l'onglet Select data, placez le curseur sur View format requirements pour consulter les exigences.Différences de configuration d'index
La configuration d'index pour le cas d'utilisation de compréhension visuelle diffère de celle du cas Basic document Q&A :- Modèle d'embedding : le modèle qwen3-vl-embedding est automatiquement sélectionné et ne peut pas être modifié après la création.
- Réécriture des conversations multi-tours : peut être activée ou désactivée.
- Seuil de similarité : la valeur par défaut est 0,20.
- Nombre maximal de rappels final : la valeur par défaut est 5.
- Méthode de découpage : la compréhension visuelle n'utilise pas les méthodes de découpage traditionnelles telles que le découpage intelligent ou le découpage personnalisé. Elle analyse plutôt l'intégralité de la page du document via l'indexation visuelle.
Restrictions de modification
- Le modèle d'embedding (qwen3-vl-embedding) et le type de stockage vectoriel (built-in) ne peuvent pas être modifiés après la création.
- Vous ne pouvez modifier l'édition de la base de connaissances qu'une seule fois par jour.
-
Select data : Spécifiez une source de données (fichiers ou contenu) pour la base de connaissances. Le système importe le contenu source dans la base de connaissances pour la récupération. Vous pouvez utiliser local upload ou cloud import (en sélectionnant une catégorie ou un fichier existant).
-
Cas d'utilisation :
-
Data query
-
Cas d'utilisation :
- Idéal pour construire des systèmes Q&A basés sur des données structurées (données organisées selon un schéma de table prédéfini), tels que des assistants pour interroger des FAQ, des données produits ou des informations sur le personnel.
-
Si vos données se composent de paires question-réponse complètes, sélectionnez Data Query. Par exemple, si un fichier Excel contient deux colonnes,
QuestionetAnswer, une base de connaissances Data Query peut utiliser la colonneQuestionpour la recherche et la colonneAnswercomme contexte pour la réponse du LLM.Ce traitement spécifique aux colonnes n'est pas disponible dans le type de base de connaissances de recherche documentaire.
- Vous pouvez importer plusieurs fichiers Excel, mais leurs schémas de table doivent être identiques.
-
Intégration de source de données : vous pouvez télécharger des fichiers XLS ou XLSX locaux .
Création Data query
-
Select data : spécifiez une source de données (fichiers ou contenu) pour la base de connaissances. Le système importe le contenu source dans la base de connaissances pour la recherche. Vous pouvez utiliser local upload ou cloud import.
La source de données ne peut pas être modifiée après la création de la base de connaissances. Une seule base de connaissances prend en charge une unique source de données.
- Local upload : téléchargez des tables de données au format XLS ou XLSX depuis votre ordinateur. La première ligne doit correspondre à l'en-tête du tableau.
- Cloud import (select data table) : sélectionnez une table de données existante depuis un Alibaba Cloud Model Studio.
-
Index configuration : définit le traitement et le stockage des données importées, ce qui affecte directement les performances de recherche.
Parmi les paramètres suivants, seul le vector storage avec AnalyticDB for PostgreSQL (ADB-PG) peut engendrer des frais. Tous les autres paramètres sont gratuits.
- Retrieval and reply settings
- Multi-turn conversation rewriting
- Embedding model
- Reranking model
- Similarity threshold
- Maximum recall count
- Vector storage
- Used for Retrieval : si cette option est activée, la base de connaissances effectue une recherche sur cette colonne.
- Used for Model Reply : si cette option est activée, les résultats de recherche provenant de cette colonne sont fournis au LLM comme contexte pour la génération de la réponse. Par exemple, si vous activez Used for Retrieval pour les colonnes « Name », « Gender », « Position » et « Age », mais que vous activez Used for Model Reply uniquement pour les colonnes « Name » et « Position », la base de connaissances effectuera des recherches dans les quatre colonnes. Toutefois, seul le contenu des colonnes « Name » et « Position » des données récupérées sera fourni au LLM comme contexte pour sa réponse. Étant donné que la colonne « Age » n'est pas activée pour les réponses du modèle, le LLM associé à cette base de connaissances ne pourra pas répondre à la question « Quel est l'âge de Zhang San ? ».
-
Select data : spécifiez une source de données (fichiers ou contenu) pour la base de connaissances. Le système importe le contenu source dans la base de connaissances pour la recherche. Vous pouvez utiliser local upload ou cloud import.
-
Cas d'utilisation :
-
Image Q&A
-
Cas d'utilisation :
- Idéal pour créer des applications de recherche multimodales prenant en charge la recherche par image et la recherche par image plus texte, telles que des assistants de découverte de produits ou des assistants de questions-réponses visuels.
-
Intégration de source de données : vous pouvez télécharger des fichiers XLS ou XLSX locaux .
Les fichiers XLS et XLSX doivent contenir des URL d'images publiquement accessibles pour générer les index d'images. Pour plus de détails, consultez les instructions de création ci-dessous.
Création Image Q&A
-
Select data : spécifiez une source de données (fichiers ou contenu) à importer dans la base de connaissances pour la recherche. Vous pouvez utiliser local upload ou cloud import (sélectionner une table de données existante depuis un connecteur de données).
La source de données ne peut pas être modifiée après la création et une seule base de connaissances prend en charge une unique source de données.
-
Local upload : téléchargez directement des tables de données au format XLS ou XLSX depuis votre ordinateur.
- Exigence de champ : la table de données doit contenir au moins un champ de type
image_urlpour générer l'index d'image. - Processus de construction : la base de connaissances accède à l'URL de l'image dans le champ
image_url, extrait les caractéristiques visuelles et les convertit en vecteurs pour le stockage. - Processus de recherche : la base de connaissances compare le vecteur généré à partir de l'image téléchargée par l'utilisateur avec les vecteurs d'images stockés et renvoie les enregistrements les plus pertinents.
- Exigence de champ : la table de données doit contenir au moins un champ de type
- Cloud import (select a data table) : sélectionnez une table de données existante parmi les données de votre application dans Alibaba Cloud Model Studio.
-
Local upload : téléchargez directement des tables de données au format XLS ou XLSX depuis votre ordinateur.
-
Index configuration : définit le traitement et le stockage des données importées, ce qui affecte directement les performances de recherche.
Parmi les paramètres suivants, seul le vector storage avec AnalyticDB for PostgreSQL (ADB-PG) peut engendrer des frais. Tous les autres paramètres sont gratuits.
- Paramètres de récupération et de réponse
- Réécriture des conversations multi-tours
- Modèle d'embedding
- Modèle de reranking
- Seuil de similarité
- Nombre maximal de rappels
- Stockage vectoriel
- Used for Retrieval : si cette option est activée, la base de connaissances effectue une récupération sur cette colonne.
- Used for Model Reply : si cette option est activée, les résultats de récupération issus de cette colonne sont fournis au LLM comme contexte pour la génération de la réponse. Par exemple, si vous activez Used for Retrieval pour les colonnes « Name », « Gender », « Position » et « Age », mais que vous n'activez Used for Model Reply que pour les colonnes « Name » et « Position », la base de connaissances effectuera une récupération sur les quatre colonnes. Toutefois, seul le contenu des colonnes « Name » et « Position » des données récupérées sera transmis au LLM comme contexte pour sa réponse. Étant donné que la colonne « Age » n'est pas activée pour les réponses du modèle, le LLM associé à cette base de connaissances ne pourra pas répondre à la question « What is Zhang San's age? ».
-
Select data : spécifiez une source de données (fichiers ou contenu) à importer dans la base de connaissances pour la recherche. Vous pouvez utiliser local upload ou cloud import (sélectionner une table de données existante depuis un connecteur de données).
-
Cas d'utilisation :
 pour télécharger les données au format XLSX.
 dans le coin supérieur gauche de la table de données et confirmez l'invite pour synchroniser le dernier contenu de la table de données avec la base de connaissances.
 sur sa carte, puis cliquez sur Edit. Remarque : Vous ne pouvez modifier la configuration d'une base de connaissances qu'une seule fois par jour civil. Les tentatives suivantes seront rejetées silencieusement.
 Icône : Pour une base de connaissances Q&A d'images, le système convertit d'abord l'image d'entrée en vecteur et récupère les segments pertinents. Il envoie ensuite ces segments ainsi que la question à un LLM pour générer une réponse. Pour les bases de connaissances de recherche documentaire, de requête de données , le système n'utilise pas l'image téléchargée pour la récupération. Toutefois, une base de connaissances de recherche documentaire configurée pour la « compréhension visuelle » utilise bien l'image pour la récupération, prenant en charge les modes de requête texte seul, image seule et image+texte. Cette requête combinée peut améliorer la pertinence de la récupération.

Quotas et limites
- Pour plus d'informations sur les sources de données prises en charge, la capacité et les autres limites d'une base de connaissances, consultez la rubrique Quotas et limites des bases de connaissances.
-
Les limites suivantes s'appliquent lorsque vous associez des bases de connaissances à une application Model Studio :
- Recherche documentaire : jusqu'à 5
- Requête de données : jusqu'à 5
- Questions-réponses sur images : jusqu'à 1
Facturation
L'utilisation de la fonctionnalité de base de connaissances est gratuite, mais l'appel d'une application Alibaba Cloud Model Studio qui l'utilise peut entraîner des frais.
| Étape | Facturation | |
|---|---|---|
| Créer une base de connaissances | Gratuit. | |
| Intégration avec les applications métier | Lorsque vous appelez une application Alibaba Cloud Model Studio, les fragments de texte extraits de la base de connaissances augmentent le nombre de jetons d'entrée du LLM, ce qui accroît les frais d'inférence du modèle. Pour plus d'informations, consultez la page Éléments facturables et tarification.Remarque : Aucun frais ne vous est facturé si vous utilisez uniquement l'API Retrieve pour la récupération sans utiliser d'application Alibaba Cloud Model Studio pour générer une réponse. | |
| Gestion et O&M | Gratuit. | |
Référence API
- Consultez le Répertoire des API (Base de connaissances) pour obtenir la liste complète des API de base de connaissances et de leurs paramètres.
- Consultez le Guide des API de base de connaissances pour des exemples d'utilisation détaillés et du code.
FAQ
Création d'une base de connaissances
Q : Puis-je supprimer un fichier ou une table de données des Données d'application après les avoir importés dans une base de connaissances ?
Q : Puis-je supprimer un fichier ou une table de données des Données d'application après les avoir importés dans une base de connaissances ?
- Pour les bases de connaissances de recherche documentaire: Oui. Les fichiers d'une base de connaissances sont indépendants de leur source dans les Données d'application. La suppression du fichier source n'affecte pas les données importées.
- Pour les bases de connaissances de requête de données et de questions-réponses sur images : Non. La suppression des données sources interrompra des fonctionnalités telles que la synchronisation des données et la visualisation de la base de connaissances.
Q : Que faire si un appel d'API de base de connaissances renvoie le code d'erreur BailianIndexServiceNotOpen ?
Q : Que faire si un appel d'API de base de connaissances renvoie le code d'erreur BailianIndexServiceNotOpen ?
BailianIndexServiceNotOpen signifie que vous n'avez pas activé le service de base de connaissances Model Studio. Connectez-vous à la console Model Studio, accédez à la page Data > Knowledge Base, puis cliquez sur Activate Now pour activer le service. Réessayez ensuite l'appel d'API.Gestion des images et du contenu multimodal
Q : Mon fichier contient des illustrations que je souhaite voir incluses dans les réponses d'une application Model Studio. Que dois-je faire ?
Q : Mon fichier contient des illustrations que je souhaite voir incluses dans les réponses d'une application Model Studio. Que dois-je faire ?
- Recherche documentaire
- Questions-réponses sur images
Méthode 1 (pour les applications agents uniquement)
Méthode 1 (pour les applications agents uniquement)
-
Lorsque vous créez une base de connaissances, définissez le Type de base de connaissances sur recherche documentaire et l'option With Illustrations sur With Illustrations.
Lorsque vous sélectionnez With Illustrations, la base de connaissances extrait des résumés des illustrations présentes dans le fichier. Le grand modèle de langage décide ensuite s'il doit insérer une image en fonction de la pertinence du résumé par rapport à la question de l'utilisateur.
-
Lors de la création ou de la modification d'une application agent, sélectionnez le modèle Qwen-Plus ou Qwen-Plus-Latest (les tests montrent que ces modèles offrent les meilleures performances). Cliquez sur le bouton + à droite de Document Knowledge Base et ajoutez la base de connaissances créée à l'étape précédente.
La longueur de rappel doit être inférieure à la longueur du document. Si elle est supérieure, le système renvoie l'intégralité du document et contourne la logique With Illustrations.
Remarque : Les fonctionnalités « With Illustrations » et « Show Answer Source » ne peuvent pas être activées simultanément.
-
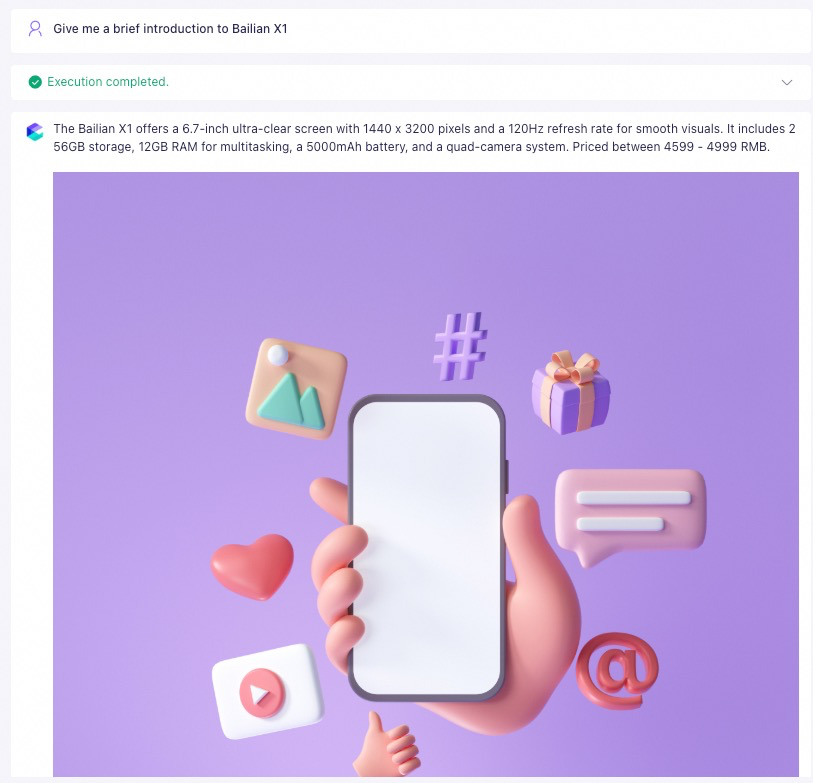
Résultat réel des questions-réponses :
Méthode 2 (pour les applications agents et workflows)
Méthode 2 (pour les applications agents et workflows)
- Téléchargez l'image vers un emplacement accessible publiquement et obtenez son URL complète. Nous recommandons l'utilisation d'OSS. Pour les instructions, consultez la rubrique Télécharger une image sur OSS et utiliser son URL de fichier.
-
Insérez l'URL complète dans le fichier. Les chemins relatifs ne sont pas pris en charge. N'intégrez pas directement les fichiers image dans le document (par exemple, par copier-coller ou en insérant une image locale depuis un menu). Vous devez référencer les images en utilisant leurs URL accessibles publiquement.
Si une image ne s'affiche pas, vérifiez que l'URL dans le fragment est complète. Supprimez les espaces supplémentaires ou les caractères spéciaux susceptibles de provoquer des erreurs d'analyse. Vous pouvez modifier le fragment directement pour effectuer ces corrections.
Exemple de référence correcte d'une image dans un fichier Modèle d'invite exemple Résultat réel des questions-réponses 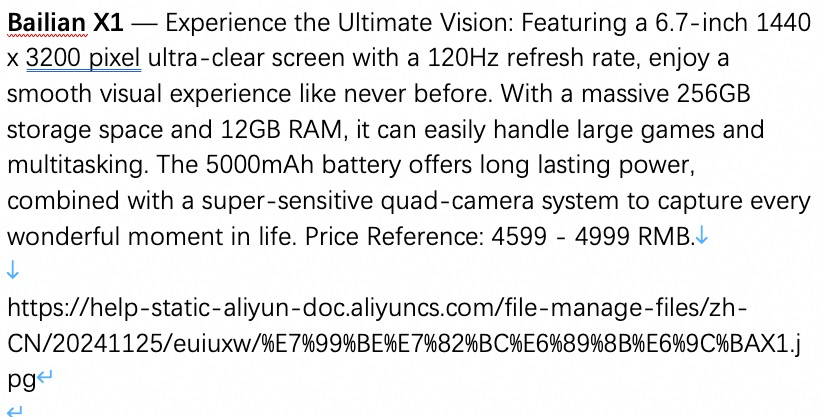
Exemple de référence incorrecte d'une image dans un fichier Modèle d'invite exemple Résultat réel des questions-réponses 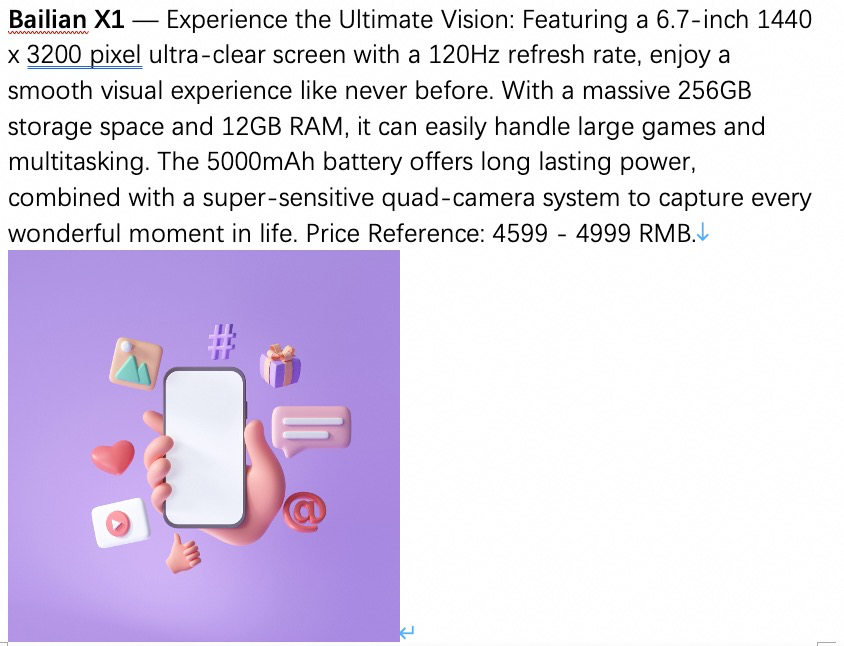
Dans l'interface de test de chat, après avoir saisi une invite, la réponse de l'IA renvoie uniquement du contenu textuel brut, sans aucune image.Explication : Lorsque vous intégrez directement une image dans un fichier, l'application Model Studio n'affiche pas l'image dans sa réponse.
Autorisations et sécurité
Q : Que faire si j'obtiens l'erreur « Missing permissions for this module » lors de la gestion d'une base de connaissances ?
Q : Que faire si j'obtiens l'erreur « Missing permissions for this module » lors de la gestion d'une base de connaissances ?
Administrator, soit inclure au minimum les autorisations Application Data-Actions et Knowledge Base-Actions.Q : Une base de connaissances est-elle privée ? D'autres organisations ou utilisateurs peuvent-ils y accéder ?
Q : Une base de connaissances est-elle privée ? D'autres organisations ou utilisateurs peuvent-ils y accéder ?
Q : Alibaba Cloud utilisera-t-il les bases de connaissances de mon compte pour répondre aux questions d'autres utilisateurs ?
Q : Alibaba Cloud utilisera-t-il les bases de connaissances de mon compte pour répondre aux questions d'autres utilisateurs ?
Migration et exportation
Q : Comment exporter une base de connaissances vers ma machine locale ?
Q : Comment exporter une base de connaissances vers ma machine locale ?