

Una base de conocimientos complementa un LLM con datos privados e información actualizada. Mediante la generación aumentada por recuperación (RAG), el LLM mejora la precisión de las respuestas recuperando primero contenido relevante de la base de conocimientos antes de generar una respuesta.
Aplicación sin una base de conocimientos dedicada Sin una base de conocimientos dedicada, un LLM no puede responder con precisión a preguntas específicas del dominio. Por ejemplo, cuando un usuario envía "Por favor, ayúdame a elegir el mejor teléfono con cámara de Alibaba Cloud Model Studio, con un presupuesto de 3,000 yuan" en la interfaz de chat, el asistente de IA no puede proporcionar recomendaciones precisas de productos debido a la falta de una base de conocimientos relevante. | Aplicación con una base de conocimientos dedicada Con una base de conocimientos dedicada, un LLM puede responder con precisión a preguntas específicas del dominio. 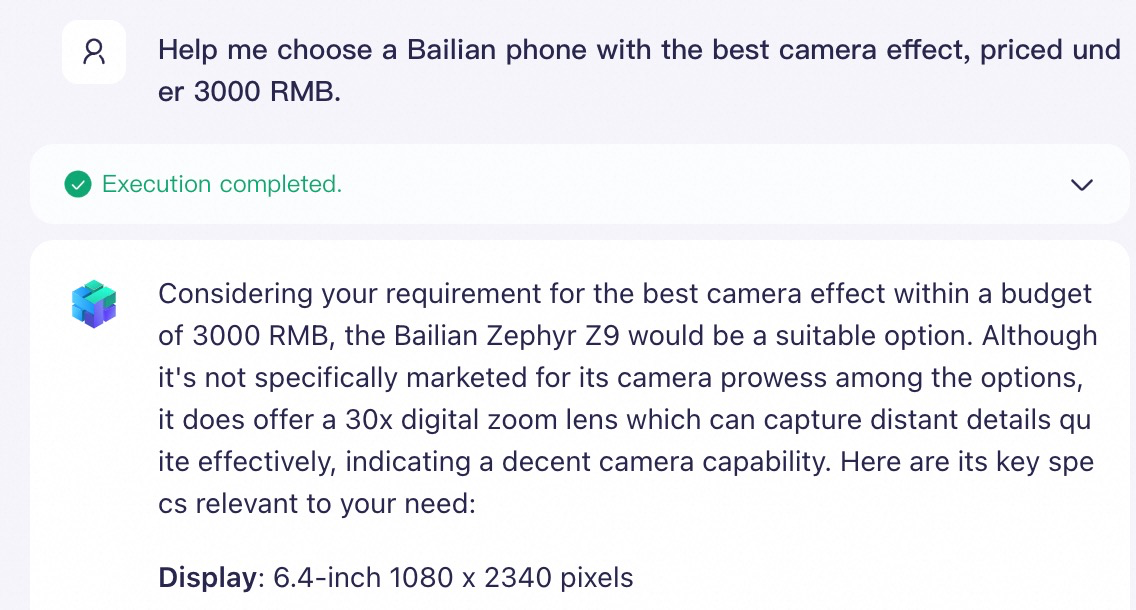 |
Modelos admitidos
Los siguientes modelos se pueden usar con una base de conocimientos. Configurar Qwen para usar una base de conocimientos
- Qwen-Max/Plus/Turbo
- QwenVL-Max/Plus
- Qwen versión de código abierto (por ejemplo, Qwen2.5)
Para obtener una lista actualizada de los modelos disponibles, consulte la página de Gestión de aplicaciones al crear una aplicación.
Inicio rápido
Este inicio rápido muestra cómo crear una aplicación de preguntas y respuestas de LLM sin código para responder preguntas específicas del dominio, utilizando "teléfonos de Alibaba Cloud Model Studio" como ejemplo.
1. Crear una base de conocimientos
- Vaya a la página Base de conocimientos y haga clic en Create Knowledge Base. Ingrese un Nombre y una Descripción, deje las demás configuraciones con sus valores predeterminados y haga clic en Next Step.
- Seleccione la Default Category y cargue el archivo Alibaba Cloud Model Studio Phone Series Product Introduction.docx. Haga clic en Next Step y luego haga clic en Complete.
2. Integración con aplicaciones empresariales
Después de crear una base de conocimiento, puede asociarla con una aplicación de Alibaba Cloud Model Studio o una aplicación externa dentro del mismo espacio de trabajo para procesar solicitudes de recuperación.
- Aplicación de agente
- Aplicación de flujo de trabajo
- Aplicación externa
- Vaya a la página de Centro de aplicaciones, busque su aplicación de agente, haga clic en Configure en su tarjeta y seleccione un modelo para la aplicación.
-
Haga clic en el icono + junto a Document Knowledge Base para agregar la base de conocimiento que acaba de crear. Puede mantener los valores predeterminados para el umbral de similitud y el peso.
(Opcional) Umbral de similitud: Filtrar resultados de recuperación
Una base de conocimientos utiliza búsqueda semántica para encontrar texto conceptualmente relevante en sus datos o archivos privados, incluso sin palabras clave coincidentes.Por ejemplo, un usuario envía la siguiente consulta:Which Alibaba Cloud phone is best for photography?La respuesta real (por ejemplo, "Qwen Vivid 7...") no contiene ninguna palabra clave de la consulta.En la siguiente tabla, la similitud por palabras clave se calcula utilizando el índice de Jaccard, y la similitud semántica es la similitud del coseno calculada por el modelo
text-embedding-v4.
Umbral de similitud: Solo se recupera texto con una puntuación de similitud semántica superior a este valor. Establecer este umbral demasiado alto puede provocar que se filtre texto relevante.Texto recuperado
Similitud por palabras clave
Similitud semántica
Qwen Vivid 7: Una nueva experiencia en fotografía inteligente
0
0.43
Alibaba Cloud Model Studio Ace Ultra: La elección para jugadores
0.17
0.32
Alibaba Cloud Model Studio Flex Fold+: Una nueva era de pantallas plegables
0.25
0.24
(Opcional) Peso: Influir en el orden de recuperación de múltiples bases de conocimientos
Cuando una aplicación de agente está asociada con múltiples bases de conocimientos, puede asignar un peso a cada una según la importancia de la fuente de información. Durante la recuperación de múltiples fuentes, si los fragmentos de diferentes bases de conocimientos tienen la misma puntuación de similitud, el sistema prioriza los fragmentos de la base de conocimientos con el mayor peso.- Limitación clave: El peso solo surte efecto entre bases de conocimiento del mismo tipo. Por ejemplo, el peso de una base de conocimiento de búsqueda de documentos no afecta el orden de recuperación de una base de conocimiento de consulta de datos, y viceversa.
- Cómo funciona: El sistema primero calcula la relevancia de la consulta del usuario respecto al contenido de cada base de conocimientos para identificar los fragmentos más relevantes. Luego, multiplica la puntuación de similitud de cada fragmento por el peso de su base de conocimientos correspondiente. Después de reordenar los resultados basándose en estas puntuaciones ponderadas, se proporcionan al LLM como contexto, asegurando que los fragmentos con mayores puntuaciones ponderadas tengan prioridad en la respuesta final.
-
En el cuadro de entrada de la derecha, introduzca una pregunta. El LLM utiliza entonces la base de conocimientos para generar una respuesta.
Por ejemplo: "Ayúdame a elegir el teléfono de Alibaba Cloud Model Studio con la mejor cámara por menos de 3,000 CNY".
Estrategia de generación por lotes: Cuando necesita que una aplicación de agente genere un gran volumen de contenido desde una base de conocimientos, como preguntas de examen o resúmenes, una sola solicitud puede devolver menos elementos de los solicitados porque la longitud de salida de una respuesta del LLM es limitada. Divida la solicitud en varios lotes de aproximadamente 30 elementos cada uno y complételos en múltiples turnos. Por ejemplo, primero envíe "Generar preguntas 1-30 basadas en la base de conocimientos" y, después de completar ese lote, envíe "Continue con las preguntas 31-60". Referencia medida: una sola solicitud de 100 preguntas devolvió solo unas 24 preguntas, mientras que tres lotes de 30 preguntas cada uno devolvieron las 30 preguntas por lote, para un total de 90 preguntas. El número real de elementos generados varía según el modelo seleccionado y la longitud del contenido, por lo que debe usar sus propios resultados de prueba como referencia final.
3. Optimizar el rendimiento de RAG (Opcional)
Si recibe resultados incompletos o inexactos del proceso de preguntas y respuestas, consulte Optimización del rendimiento de RAG.
Guías prácticas
En la página de base de conocimiento, puede ver y administrar todas las bases de conocimiento en el espacio de trabajo actual.
ID de base de conocimientos: El ID de cada base de conocimientos, utilizado para llamadas a la API.
- Crear una base de conocimientos
- Actualizar una base de conocimientos
- Editar base de conocimientos
- Eliminar una base de conocimientos
- Cambiar configuración
- Prueba de recuperación
- En la página de base de conocimientos, haga clic en Create Knowledge Base.
-
Información básica
Seleccione un Knowledge Base Type según su caso de uso. Una sola base de conocimientos admite solo un tipo. Si selecciona el tipo document search, también debe seleccionar un use case: Basic document Q&A, Rich-text Reply.
- Preguntas y respuestas básicas de documentos: Ideal para búsquedas semánticas en documentos de texto sin formato.
- Respuesta con texto enriquecido: Ideal para casos de uso que requieren respuestas que contengan tanto texto como imágenes.
El tipo de base de conocimientos no se puede cambiar después de crearla.
-
Búsqueda de documentos
-
Casos de uso:
- Ideal para recuperar información de datos no estructurados, como documentos corporativos internos y manuales de productos. Los datos no estructurados son información que no está organizada en un modelo de datos o esquema predefinido y pueden incluir texto, tablas e imágenes.
- Si sus archivos contienen imágenes que want desea que la aplicación incluya en sus respuestas, seleccione document search.
-
Fuente de datos: Puede cargar archivos locales o importarlos desde Object Storage Service (OSS).
Creación de búsqueda de documentos
-
Seleccionar datos: Especifique una fuente de datos (archivos o contenido) para la base de conocimientos. El sistema importa el contenido de origen a la base de conocimientos para su recuperación. Puede utilizar carga local o importación en la nube (seleccionando una categoría o archivo existente).
-
Carga local: Cargue archivos directamente desde su computadora. Expanda el panel desplegable a continuación para aprender cómo seleccionar un parsing method.
Métodos de análisis
Configure la estrategia de análisis según sus necesidades. Si no está seguro de qué opción elegir, recomendamos utilizar la configuración predeterminada.- Análisis digital: No analiza ilustraciones ni gráficos en los archivos. Este es el método de análisis más rápido. Un documento de texto sin formato de 10 a 20 páginas generalmente se analiza en unos pocos segundos a 1 minuto.
- Análisis inteligente de documentos: Reconoce y extrae texto de las ilustraciones en sus archivos para generar resúmenes de texto. Estos resúmenes, junto con otro contenido no gráfico, se fragmentan y vectorizan para su recuperación. Este método es relativamente rápido. Un documento de 10 a 20 páginas con ilustraciones generalmente tarda de 1 a 5 minutos en analizarse.
- Análisis con LLM: Permite que las aplicaciones que utilizan el modelo Qwen-VL respondan preguntas sobre el contenido de ilustraciones y gráficos en sus archivos. Para habilitar el reconocimiento y la comprensión de este contenido, seleccione LLM Parsing. Dado que este método llama a un LLM para una comprensión profunda, un documento de 10 a 20 páginas con gráficos generalmente tarda de 2 a 10 minutos en analizarse.
- Análisis con Qwen-VL: Diseñado específicamente para archivos de imagen. Puede especificar un modelo Qwen-VL y proporcionar un prompt para guiar el reconocimiento y la extracción del diseño y los elementos de la imagen. Una sola imagen generalmente se analiza en unos pocos segundos a 1 minuto.
- Importación desde la nube: Importe archivos existentes desde Object Storage Service (OSS).
-
Carga local: Cargue archivos directamente desde su computadora. Expanda el panel desplegable a continuación para aprender cómo seleccionar un parsing method.
-
Configuración de índice: Define cómo se procesan y almacenan los datos importados, lo cual afecta directamente al rendimiento de recuperación.
Entre las siguientes configuraciones, solo el almacenamiento vectorial con AnalyticDB for PostgreSQL (ADB-PG) puede generar cargos. Todas las demás configuraciones son gratuitas.
- Extracción de metadatos
- Ensamblaje de encabezado de Excel
- Método de fragmentación
- Reescritura de conversación multironda
- Modelo de incrustación
- Modelo de reordenamiento
- Umbral de similitud
- Recuento máximo de recuperación
- Almacenamiento vectorial
Los metadatos consisten en atributos adicionales para datos no estructurados, que se integran en los fragmentos como pares clave-valor.- Propósito: Los metadatos proporcionan un contexto importante para los fragmentos y pueden mejorar significativamente la precisión de la recuperación de la base de conocimientos. Por ejemplo, considere una base de conocimientos que contiene miles de archivos de introducción de productos donde el nombre del archivo es el nombre del producto. Cuando un usuario busca "descripción funcional del Producto A", si el cuerpo de cada archivo contiene "descripción funcional" pero none menciona "Producto A", la base de conocimientos podría recuperar muchos fragmentos irrelevantes. Sin embargo, si agrega el nombre del producto como metadato a todos los fragmentos, la base de conocimientos puede filtrar con precisión los fragmentos relacionados con "Producto A" que también contengan "descripción funcional". Esto mejora la precisión de la recuperación y reduce el consumo de tokens de entrada del LLM.
- Uso: Cuando usted llama a una aplicación mediante una API, puede especificar
metadataen el parámetro de solicitudmetadata_filter. Cuando la aplicación recupera información de la base de conocimientos, primero filtra los archivos relevantes basándose en losmetadataespecificados. - Nota: No puede configurar la extracción de metadatos después de crear una base de conocimientos.
Configuración de metadatos
Habilite Extracción de metadatos y luego haga clic en Settings para adjuntar metadatos uniformes o personalizados a all files in the knowledge base. Durante la fragmentación, los metadatos de cada archivo se integran en sus respectivos fragmentos.Nueva plantilla de metadatos
Métodos de extracción de valores-
Constante: Adjunta un atributo fijo a todos los archivos de la base de conocimientos.
Como se muestra en el ejemplo anterior, si todos los archivos en la base de conocimientos tienen el mismo autor, puede establecer una constante para un campo llamado
author. -
Variable: Adjunta un atributo variable a cada archivo en la base de conocimientos. Los atributos admitidos actualmente son
file_nameycat_name. Si seleccionafile_name, Alibaba Cloud Model Studio adjunta el nombre del archivo a sus metadatos, como se muestra en el ejemplo anterior. Si seleccionacat_name, Alibaba Cloud Model Studio adjunta el nombre de la categoría que contiene el archivo a los metadatos del archivo. -
LLM: El sistema compara el contenido del archivo con la regla de Descripción de entidad configurada, extrae la información relevante y la adjunta como un atributo de metadatos.
Como se muestra en la plantilla de metadatos del ejemplo anterior, para extraer todos los años que aparecen en cada archivo como atributos de archivo, puede configurar un campo LLM llamado
En el cuadro de entrada Descripción de entidad, ingresedate. La descripción de la entidad se configura de la siguiente manera:date information, extract only the yeary luego haga clic en OK. -
RegEx: El sistema compara el contenido de texto de cada archivo en la base de conocimiento con la expresión regular especificada. El contenido que coincide con la expresión se extrae y se agrega como un atributo a los metadatos del archivo.
Como se muestra en la plantilla de metainformación del ejemplo anterior, si necesita extraer todas las referencias que aparecen en cada archivo (suponiendo que una referencia es cualquier texto que comienza con '《' y termina con '》'), puede configurar un campo de expresión regular llamado
Establezca el valor de la expresión regular enreference. La expresión regular se configura de la siguiente manera:《.*?》. -
Búsqueda por palabras clave: El sistema busca palabras clave predefinidas en cada archivo y agrega las palabras clave coincidentes como atributos a los metadatos del archivo.
Por ejemplo, en la plantilla de metadatos del ejemplo anterior, las palabras clave predefinidas son:
Debido a que el archivo contiene solo las palabras clave "financiamiento", "industria", "verde" y "capital", el sistema extrae solo estas cuatro palabras clave como valor para el atributo
keywordsdel archivo.
Creación de comprensión visual
Cuando selecciona el caso de uso de visual understanding (rich-text documents), la base de conocimientos utiliza un modelo de incrustación multimodal para comprender visualmente los documentos y preservar la información del diseño original, en lugar de utilizar métodos de fragmentación tradicionales.Restricciones de formato de archivo
En el área de carga de archivos de la pestaña Seleccionar datos, pase el cursor sobre View format requirements para ver los requisitos.Diferencias en la configuración del índice
La configuración del índice para el caso de uso de comprensión visual difiere de la de Preguntas y respuestas básicas de documentos:- Modelo de embedding: El modelo qwen3-vl-embedding se selecciona automáticamente y no se puede cambiar después de la creación.
- Reescritura de conversaciones de múltiples turnos: Se puede activar o desactivar.
- Umbral de similitud: El valor predeterminado es 0.20.
- Recuento máximo final de recuperaciones: El valor predeterminado es 5.
- Método de fragmentación: La comprensión visual no utiliza métodos de fragmentación tradicionales como la fragmentación inteligente o la fragmentación personalizada. En su lugar, comprende toda la página del documento basándose en la indexación visual.
Restricciones de edición
- El modelo de incrustación (qwen3-vl-embedding) y el tipo de almacenamiento vectorial (integrado) no se pueden cambiar después de la creación.
- Solo puede cambiar la edición de la base de conocimientos una vez al día.
-
Seleccionar datos: Especifique una fuente de datos (archivos o contenido) para la base de conocimientos. El sistema importa el contenido de origen a la base de conocimientos para su recuperación. Puede utilizar carga local o importación en la nube (seleccionando una categoría o archivo existente).
-
Casos de uso:
-
Consulta de datos
-
Casos de uso:
- Ideal para crear sistemas de preguntas y respuestas basados en datos estructurados (datos organizados según un esquema de tabla predefinido), como asistentes para consultar preguntas frecuentes, datos de productos o información personal.
-
Si sus datos consisten en pares completos de preguntas y respuestas de FAQ, seleccione Data Query. Por ejemplo, si un archivo de Excel contiene dos columnas,
QuestionyAnswer, una base de conocimientos de Consulta de datos puede usar la columnaQuestionpara la recuperación y la columnaAnswercomo contexto para la respuesta del LLM.Este procesamiento específico por columna no está disponible en el tipo de base de conocimientos de búsqueda de documentos.
- Puede importar múltiples archivos de Excel, pero sus esquemas de tabla deben ser idénticos.
-
Integración de fuentes de datos: Puede cargar archivos XLS o XLSX locales.
Creación de consulta de datos
-
Seleccionar datos: Especifique un origen de datos (archivos o contenido) para la base de conocimiento. El sistema importa el contenido de origen a la base de conocimiento para su recuperación. Puede utilizar carga local o importación desde la nube.
El origen de datos no se puede cambiar después de crear la base de conocimientos. Una sola base de conocimientos admite únicamente un origen de datos.
- Carga local: Cargue tablas de datos en formato XLS o XLSX desde su computadora. La primera fila debe ser el encabezado de la tabla.
- Importación desde la nube (seleccionar tabla de datos): Seleccione una tabla de datos existente de Alibaba Cloud Model Studio.
-
Configuración de índice: Define cómo se procesan y almacenan los datos importados, lo cual afecta directamente al rendimiento de recuperación.
Entre las siguientes configuraciones, solo el almacenamiento vectorial con AnalyticDB for PostgreSQL (ADB-PG) puede generar cargos. Todas las demás configuraciones son gratuitas.
- Configuración de recuperación y respuesta
- Reescritura de conversación multironda
- Modelo de incrustación
- Modelo de reordenamiento
- Umbral de similitud
- Recuento máximo de recuperación
- Almacenamiento vectorial
- Usado para recuperación: Si está activado, la base de conocimientos realiza la recuperación en esta columna.
- Usado para respuesta del modelo: Si está habilitado, los resultados de recuperación de esta columna se proporcionan al LLM como contexto para la generación de respuestas. Por ejemplo, si habilita Usado para recuperación para las columnas "Nombre", "Género", "Puesto" y "Edad", pero habilita Usado para respuesta del modelo solo para las columnas "Nombre" y "Puesto", la base de conocimientos realizará la búsqueda en las cuatro columnas. Sin embargo, solo el contenido de las columnas "Nombre" y "Puesto" de los datos recuperados se proporcionará al LLM como contexto para su respuesta. Dado que la columna "Edad" no está habilitada para las respuestas del modelo, el LLM asociado con esta base de conocimientos no puede responder a la pregunta "¿Cuál es la edad de Zhang San?".
-
Seleccionar datos: Especifique un origen de datos (archivos o contenido) para la base de conocimiento. El sistema importa el contenido de origen a la base de conocimiento para su recuperación. Puede utilizar carga local o importación desde la nube.
-
Casos de uso:
-
Preguntas y respuestas con imágenes
-
Casos de uso:
- Ideal para crear aplicaciones de recuperación multimodal que admiten búsqueda por imagen y búsqueda por imagen más texto, como asistentes de descubrimiento de productos o asistentes visuales de preguntas y respuestas.
-
Integración de fuentes de datos: Puede cargar archivos XLS o XLSX locales.
Los archivos XLS y XLSX deben contener URL de imágenes accesibles públicamente para crear índices de imágenes. Para más detalles, consulte las instrucciones de creación a continuación.
Creación de preguntas y respuestas de imágenes
-
Seleccionar datos: Especifique un origen de datos (archivos o contenido) para importar a la base de conocimiento para su recuperación. Puede utilizar carga local o importación desde la nube (seleccione una tabla de datos existente de un conector de datos).
La fuente de datos no se puede cambiar después de la creación, y una sola base de conocimientos solo admite una fuente de datos.
-
Carga local: Cargue tablas de datos en formato XLS o XLSX directamente desde su computadora.
- Requisito de campo: La tabla de datos debe contener al menos un campo del tipo
image_urlpara generar el índice de imágenes. - Proceso de creación: La base de conocimientos accede a la URL de la imagen en el campo
image_url, extrae características visuales y las convierte en vectores para su almacenamiento. - Proceso de recuperación: La base de conocimientos compara el vector generado a partir de la imagen cargada por el usuario con los vectores de imágenes almacenados y devuelve los registros más relevantes.
- Requisito de campo: La tabla de datos debe contener al menos un campo del tipo
- Importación desde la nube (seleccionar una tabla de datos): Seleccione una tabla de datos existente de sus datos de aplicación en Alibaba Cloud Model Studio.
-
Carga local: Cargue tablas de datos en formato XLS o XLSX directamente desde su computadora.
-
Configuración de índice: Define cómo se procesan y almacenan los datos importados, lo cual afecta directamente al rendimiento de recuperación.
Entre las siguientes configuraciones, solo el almacenamiento vectorial con AnalyticDB for PostgreSQL (ADB-PG) puede generar cargos. Todas las demás configuraciones son gratuitas.
- Configuración de recuperación y respuesta
- Reescritura de conversación multironda
- Modelo de incrustación
- Modelo de reordenamiento
- Umbral de similitud
- Recuento máximo de recuperación
- Almacenamiento vectorial
- Usado para recuperación: Si está activado, la base de conocimientos realiza la recuperación en esta columna.
- Usado para respuesta del modelo: Si está habilitado, los resultados de recuperación de esta columna se proporcionan al LLM como contexto para la generación de respuestas. Por ejemplo, si habilita Usado para recuperación para las columnas "Nombre", "Género", "Puesto" y "Edad", pero habilita Usado para respuesta del modelo solo para las columnas "Nombre" y "Puesto", la base de conocimientos realizará la búsqueda en las cuatro columnas. Sin embargo, solo el contenido de las columnas "Nombre" y "Puesto" de los datos recuperados se proporcionará al LLM como contexto para su respuesta. Dado que la columna "Edad" no está habilitada para las respuestas del modelo, el LLM asociado con esta base de conocimientos no puede responder a la pregunta "¿Cuál es la edad de Zhang San?".
-
Seleccionar datos: Especifique un origen de datos (archivos o contenido) para importar a la base de conocimiento para su recuperación. Puede utilizar carga local o importación desde la nube (seleccione una tabla de datos existente de un conector de datos).
-
Casos de uso:
 icono para descargar los datos en formato XLSX.
 icono en la esquina superior izquierda de la tabla de datos y confirme el aviso para sincronizar el contenido más reciente de la tabla de datos con la base de conocimientos.
 icono en su tarjeta y luego haga clic en Edit. Nota: Solo puede modificar la configuración de una base de conocimientos una vez por día natural. Los intentos posteriores se rechazarán silenciosamente.
 Icono: Para una base de conocimientos de preguntas y respuestas de imágenes, el sistema primero convierte la imagen de entrada en un vector y recupera segmentos relevantes. Luego envía estos segmentos junto con la pregunta a un LLM para generar una respuesta. Para las bases de conocimientos de búsqueda de documentos y consulta de datos, el sistema no utiliza la imagen cargada para la recuperación. Sin embargo, una base de conocimientos de búsqueda de documentos configurada para "comprensión visual" sí utiliza la imagen para la recuperación, admitiendo modos de consulta de solo texto, solo imagen e imagen+texto. Esta consulta combinada puede mejorar la relevancia de la recuperación.

Cuotas y límites
- Para obtener información sobre orígenes de datos compatibles, capacidad y otros límites para una base de conocimientos, consulte Cuotas y límites de la base de conocimientos.
-
Se aplican los siguientes límites cuando asocia bases de conocimientos con una aplicación de Model Studio:
- Búsqueda de documentos: Hasta 5
- Consulta de datos: Hasta 5
- Preguntas y respuestas con imágenes: Hasta 1
Facturación
El uso de la función de base de conocimientos es gratuito, pero se le puede cobrar por llamar a una aplicación de Alibaba Cloud Model Studio que la utilice.
| Paso | Facturación | |
|---|---|---|
| Crear una base de conocimientos | Sin costo. | |
| Integración con aplicaciones empresariales | Cuando llama a una aplicación de Alibaba Cloud Model Studio, los fragmentos de texto recuperados de la base de conocimientos aumentan el recuento de tokens de entrada para el LLM, lo que incrementa las tarifas de inferencia del modelo. Para obtener más información, consulte Artículos facturables y precios.Nota: No se le cobra si solo utiliza la API Retrieve para la recuperación y no utiliza una aplicación de Alibaba Cloud Model Studio para generar una respuesta. | |
| Gestión y operaciones | Sin costo. | |
Referencia de API
- Consulte el Directorio de API (Base de conocimientos) para obtener una lista completa de las API de base de conocimientos y sus parámetros.
- Consulte la Guía de la API de base de conocimientos para obtener información detallada sobre el uso y ejemplos de código.
FAQ
Creación de una base de conocimientos
P: ¿Puedo eliminar un archivo o una tabla de datos de Datos de la aplicación después de importarlo a una base de conocimientos?
P: ¿Puedo eliminar un archivo o una tabla de datos de Datos de la aplicación después de importarlo a una base de conocimientos?
- Para bases de conocimientos de búsqueda de documentos: Sí. Los archivos en una base de conocimientos son independientes de su origen en Datos de la aplicación. Eliminar el archivo de origen no afecta a los datos importados.
- Para bases de conocimientos de consulta de datos y Preguntas y respuestas de imágenes: No. Eliminar los datos de origen interrumpirá funciones como la sincronización de datos y la visualización de la base de conocimientos.
P: ¿Qué debo hacer si una llamada a la API de la base de conocimientos devuelve el código de error BailianIndexServiceNotOpen?
P: ¿Qué debo hacer si una llamada a la API de la base de conocimientos devuelve el código de error BailianIndexServiceNotOpen?
BailianIndexServiceNotOpen significa que no ha activado el servicio de base de conocimientos de Model Studio. Inicie sesión en la consola de Model Studio, vaya a la página Datos > Knowledge Base y haga clic en Activate Now para activar el servicio. Luego, intente nuevamente la llamada a la API.Manejo de imágenes y contenido multimodal
P: Mi archivo contiene ilustraciones que want que una aplicación de Model Studio incluya en sus respuestas. ¿Qué debo hacer?
P: Mi archivo contiene ilustraciones que want que una aplicación de Model Studio incluya en sus respuestas. ¿Qué debo hacer?
- Búsqueda de documentos
- Preguntas y respuestas de imágenes
Método 1 (Solo para aplicaciones de agente)
Método 1 (Solo para aplicaciones de agente)
-
Cuando usted crea una base de conocimiento, establezca el Tipo de base de conocimiento en búsqueda de documentos y With Illustrations en With Illustrations.
Cuando selecciona With Illustrations, la base de conocimientos extrae resúmenes de las ilustraciones del archivo. Luego, el modelo de lenguaje grande decide si insertar una imagen basándose en la relevancia del resumen respecto a la pregunta del usuario.
-
Cuando crea o edita una aplicación de agente, seleccione el modelo Qwen-Plus o Qwen-Plus-Latest (las pruebas muestran que estos modelos ofrecen el mejor rendimiento). Haga clic en el botón + a la derecha de Document Knowledge Base y agregue la base de conocimientos que creó en el paso anterior.
La longitud de recuperación debe ser menor que la longitud del documento. Si es mayor, el sistema devuelve el documento completo y omite la lógica Con ilustraciones.
Nota: Las funciones "Con ilustraciones" y "Mostrar fuente de la respuesta" no se pueden activar simultáneamente.
-
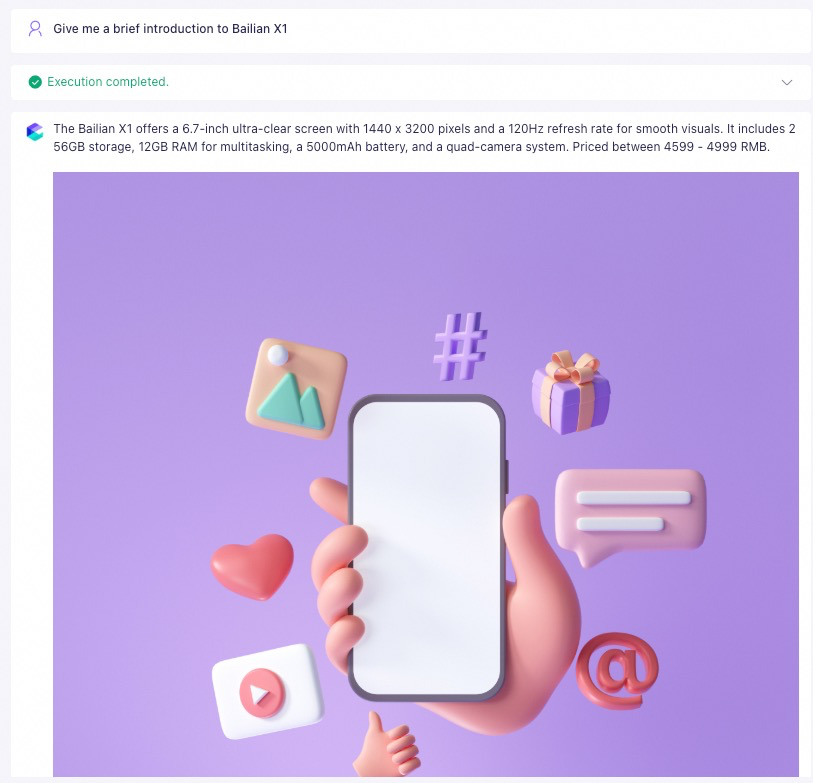
Resultado real de preguntas y respuestas:
Método 2 (Para aplicaciones de agente y flujo de trabajo)
Método 2 (Para aplicaciones de agente y flujo de trabajo)
- Cargue la imagen en una ubicación accesible públicamente y obtenga su URL completa. Recomendamos utilizar OSS. Para obtener instrucciones, consulte Cargar una imagen en OSS y usar su URL de archivo.
-
Inserte la URL completa en el archivo. No se admiten rutas relativas. No incruste archivos de imagen directamente en el documento (por ejemplo, copiando y pegando o insertando una imagen local desde un menú). Debe hacer referencia a las imágenes utilizando sus URLs accesibles públicamente.
Si una imagen no se muestra, asegúrese de que la URL en el fragmento esté completa. Elimine cualquier espacio adicional o carácter especial que pueda causar errores de análisis. Puede editar el fragmento directamente para realizar estas correcciones.
Ejemplo de referencia correcta a una imagen en un archivo Plantilla de prompt de ejemplo Resultado real de preguntas y respuestas 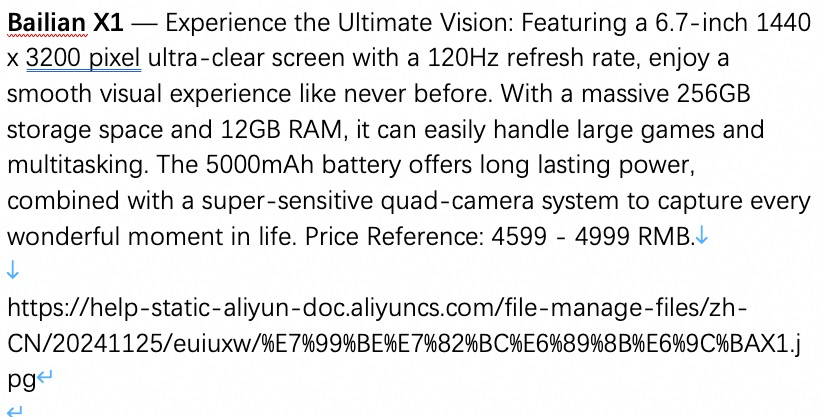
Ejemplo de referencia incorrecta a una imagen en un archivo Plantilla de prompt de ejemplo Resultado real de preguntas y respuestas 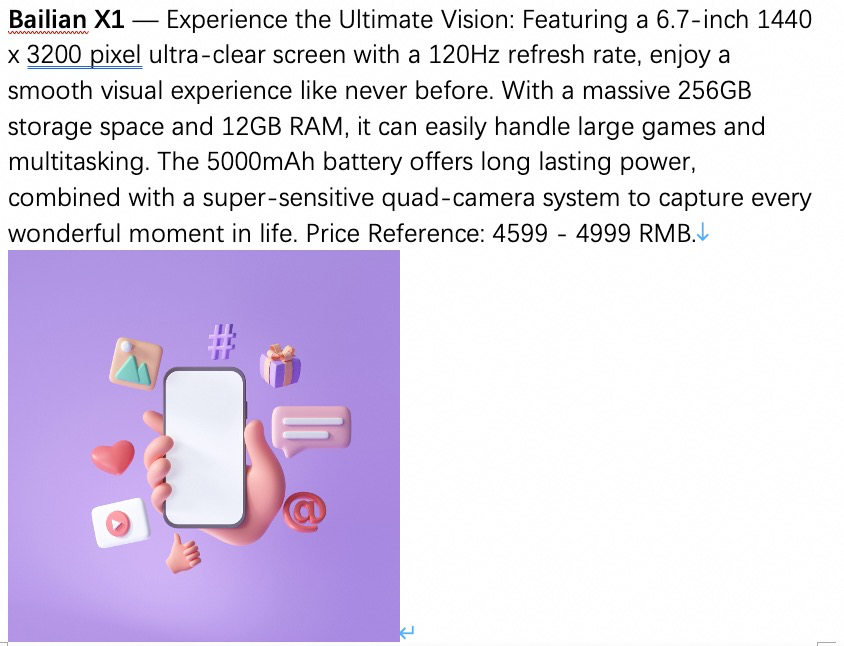
En la interfaz de prueba de chat, después de ingresar un prompt, la respuesta de la IA devuelve solo contenido de texto sin formato, sin ninguna imagen.Explicación: Cuando incrusta una imagen directamente en un archivo, la aplicación Model Studio no muestra la imagen en su respuesta.
Permisos y seguridad
P: ¿Qué debo hacer si obtengo un error de "Permisos faltantes para este módulo" al gestionar una base de conocimientos?
P: ¿Qué debo hacer si obtengo un error de "Permisos faltantes para este módulo" al gestionar una base de conocimientos?
Administrator o incluir al menos tanto los permisos de Application Data-Actions como los de Knowledge Base-Actions.P: ¿Es privada una base de conocimientos? ¿Pueden otras organizaciones o usuarios acceder a ella?
P: ¿Es privada una base de conocimientos? ¿Pueden otras organizaciones o usuarios acceder a ella?
P: ¿Utilizará Alibaba Cloud las bases de conocimientos de mi cuenta para responder preguntas de otros usuarios?
P: ¿Utilizará Alibaba Cloud las bases de conocimientos de mi cuenta para responder preguntas de otros usuarios?
Migración y exportación
P: ¿Cómo exporto una base de conocimientos a mi máquina local?
P: ¿Cómo exporto una base de conocimientos a mi máquina local?