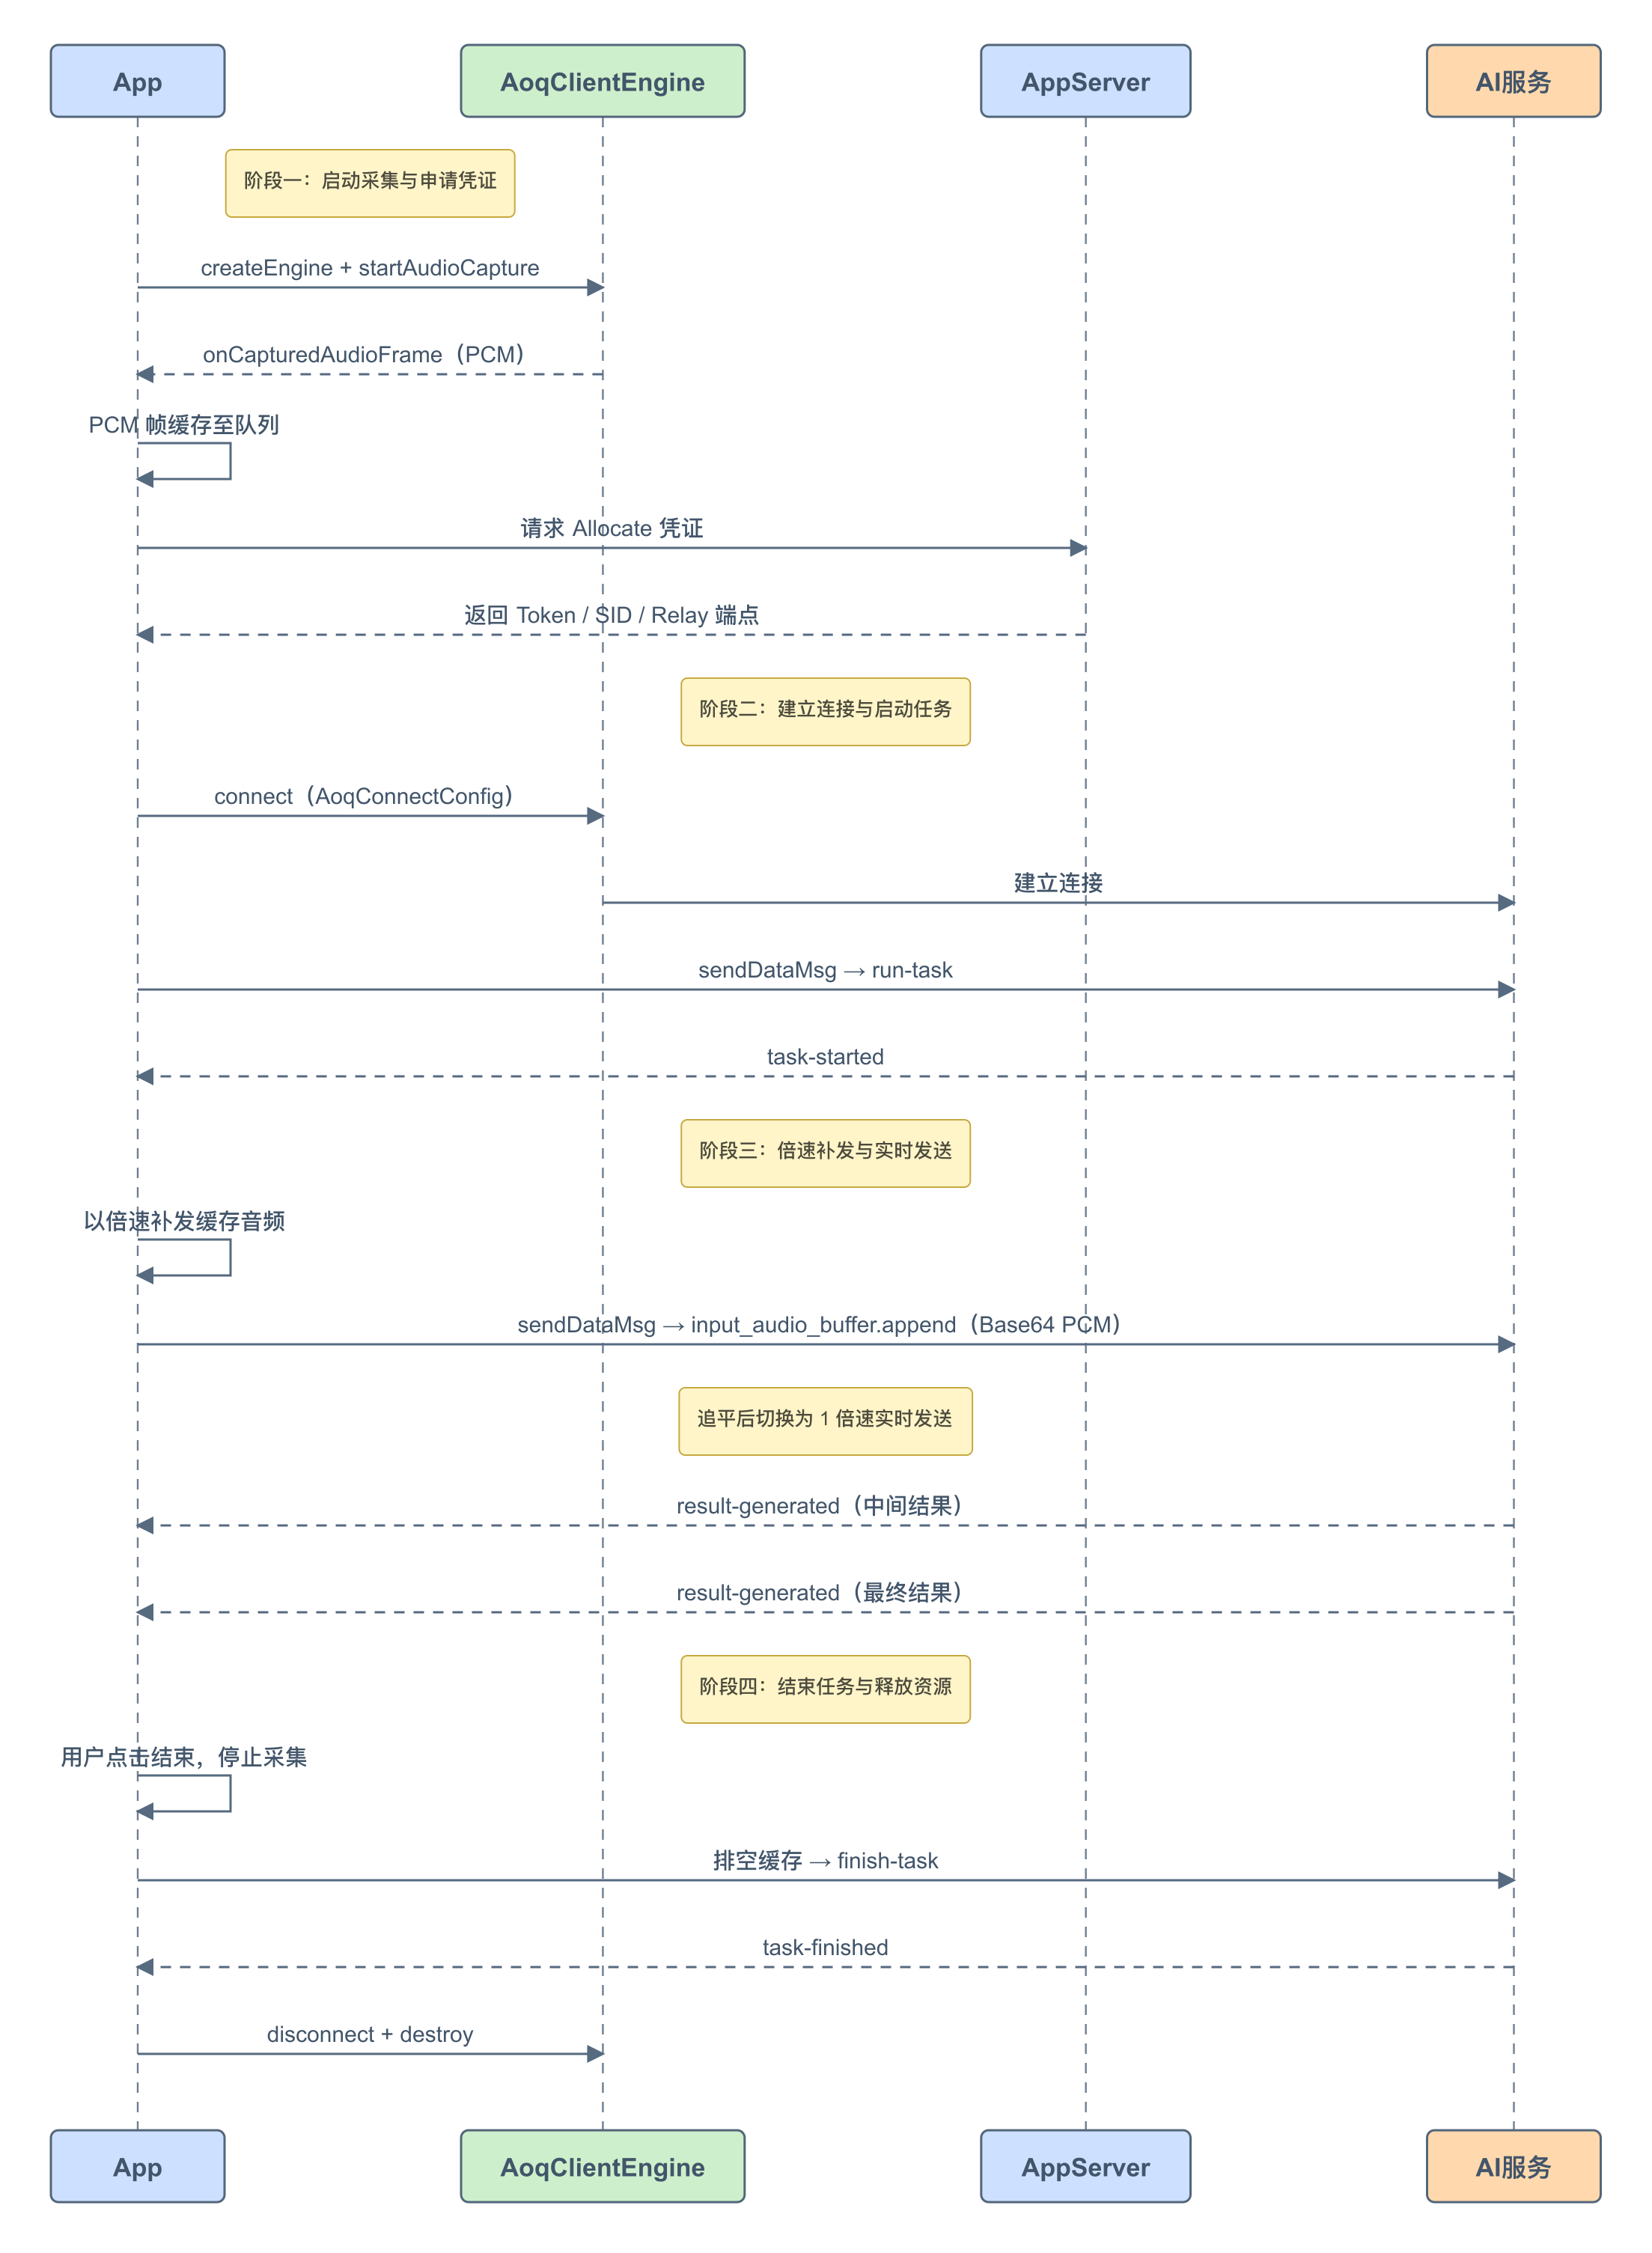
方案概述
語音輸入法的典型交互流程為:用戶點擊語音輸入按鈕後立即開始說話,識別結果實時回顯到輸入框。客戶端核心實現要點如下:
- 點擊即採集:用戶點擊按鈕後立即啓動音頻採集並緩存 PCM 數據,同時異步申請連接憑證和建立連接。由於連接建立需要一定時間,而用戶在此期間已經開始說話,因此需要先緩存再補發。
- 倍速補發追平:連接成功並收到模型就緒事件後,將緩存的音頻以倍速發送給模型,追平後再切換為實時發送。
- Data 通道傳輸音頻:qwen-audio-3.1-asr-flash-streaming 採用 Inference 協議(run-task / finish-task)。當前場景需要先緩存音頻再倍速補發,因此通過
sendDataMsg 接口以 JSON 消息形式傳輸音頻數據。AOQ 服務端已對 JSON 格式的音頻消息做了封裝,客戶端發送 JSON 後服務端自動解析為二進制數據轉發給模型。
- 中間結果與最終結果:模型持續返回識別結果,中間結果(
sentence_end: false)實時展示,最終結果(sentence_end: true)追加到輸入框。
準備工作
前置條件
- 開通阿里雲百鍊,並按獲取與配置 API Key獲取 API Key。API Key 只保存在業務 AppServer,不要寫入客戶端代碼或提交到代碼倉庫。
{endpoint} 使用華北2(北京)的 {WorkspaceId}.cn-beijing.maas.aliyuncs.com 或新加坡的 {WorkspaceId}.ap-southeast-1.maas.aliyuncs.com,替換為實際業務空間 ID,並使用對應地域和業務空間的 API Key。- 從 SDK 下載獲取最新版 AOQ Client SDK。
- 搭建業務 AppServer,並按 Token 鑒權實現服務端代理鑒權。每次建立新連接前,客戶端都應從 AppServer 獲取新的連接憑證。
導入 SDK
從 SDK 下載獲取最新版 AOQ Client SDK 後,根據開發平台導入對應 SDK。後續客戶端代碼以 Android 為例,其他平台使用相同的接口設計和事件流程。
-
將 Opus 插件中的
libPluginOpus.so 按 ABI 放入 app/src/main/jniLibs/armeabi-v7a/ 和 app/src/main/jniLibs/arm64-v8a/,將 AoqClientSdk-release.aar 放入 app/libs,並在 app/build.gradle 中配置依賴和 SDK 支持的 ABI:
android {
defaultConfig {
minSdk 21
ndk { abiFilters 'armeabi-v7a', 'arm64-v8a' }
}
}
dependencies {
implementation fileTree(dir: 'libs', include: ['*.aar'])
}
-
在
AndroidManifest.xml 中聲明以下權限:
<uses-permission android:name="android.permission.INTERNET" />
<uses-permission android:name="android.permission.ACCESS_NETWORK_STATE" />
<uses-permission android:name="android.permission.RECORD_AUDIO" />
<uses-permission android:name="android.permission.MODIFY_AUDIO_SETTINGS" />
-
在使用麥克風前動態申請
RECORD_AUDIO 權限。
- 將
AoqClientSdk.framework 與 PluginOpus.framework 拖入 Xcode 工程,在 Target > General > Frameworks, Libraries, and Embedded Content 中選擇 Embed & Sign。SDK 支持 iOS 13.0 及以上 arm64 設備。
- 在 Info.plist 中添加
NSMicrophoneUsageDescription,並在使用麥克風前請求用戶授權。
- Swift 工程使用
import AoqClientSdk;Objective-C 工程使用 #import <AoqClientSdk/AoqClientSdk.h>。
-
將 Opus 插件中的
libPluginOpus.so 放入 entry/libs/arm64-v8a/,將 AoqClientSdk.har 放入 entry/libs,並在 entry/oh-package.json5 中聲明依賴。該 SDK 兼容 API 12,支持 arm64-v8a:
{
"dependencies": {
"@aoq/client-sdk": "file:./libs/AoqClientSdk.har"
}
}
-
在
entry/src/main/module.json5 中聲明以下權限:
"requestPermissions": [
{ "name": "ohos.permission.INTERNET" },
{ "name": "ohos.permission.MICROPHONE",
"reason": "$string:perm_mic_reason",
"usedScene": { "abilities": ["EntryAbility"], "when": "inuse" } }
]
-
在使用麥克風前調用
abilityAccessCtrl.createAtManager().requestPermissionsFromUser 申請 ohos.permission.MICROPHONE。
-
解壓 SDK,並保持
aoq_client_sdk.py、libAoqClientSdk.so 和 libonnxruntime.so.1.16.3 位於同一目錄。
-
將 SDK 目錄加入 Python 和動態庫搜索路徑:
export PYTHONPATH="$PWD/AoqClientSdk:$PYTHONPATH"
export LD_LIBRARY_PATH="$PWD/AoqClientSdk:$LD_LIBRARY_PATH"
-
在 Python 代碼中使用
import aoq_client_sdk。也可通過 AOQ_CLIENT_SDK_LIB 環境變量指定 libAoqClientSdk.so 的絕對路徑。
AppServer 獲取 Token
客戶端通過 AppServer 獲取連接憑證。按 Token 鑒權實現服務端代理鑒權,AppServer 調用百鍊分配接口,返回 SDK 連接所需的 Token、SID、Relay 端點等信息。
curl -X POST \
"https://{endpoint}/api/v1/webrtc/inference?model=qwen-audio-3.1-asr-flash-streaming" \
-H "Content-Type: application/json" \
-H "Authorization: Bearer ${DASHSCOPE_API_KEY}" \
-H "x-dashscope-rtc-transport: moq" \
-d "{\"clientIp\": \"${CLIENT_REAL_IP}\"}"
| 響應字段 | SDK 字段 |
|---|
aoqTokenForClient | AoqConnectConfig.token |
sid | AoqConnectConfig.sid |
clientRelayCertFingerprint | AoqConnectConfig.certFingerprint |
clientRelayEndpoints | AoqConnectConfig.relayEndpoints |
extraInfo.workspaceIdHash | AoqConnectConfig.workspaceIdHash |
客戶端實現流程
以下以 Android 為例,按實現順序分步說明。其他平台使用相同的接口設計和事件流程。
1. 創建引擎並設置回調
創建 AoqClientEngine 實例,註冊連接狀態回調和 Data 消息回調。連接成功後發送 run-task,Data 消息回調負責處理服務端事件。
// 創建引擎
AoqClientEngine.AoqCreateConfig create = new AoqClientEngine.AoqCreateConfig();
create.workDir = getCacheDir().getAbsolutePath();
engine = AoqClientEngine.createEngine(this, create, new AoqClientListener() {
@Override
public void onConnectionStatusChange(
@NonNull AoqClientEngine.AoqConnectionStatus state) {
if (state == AoqClientEngine.AoqConnectionStatus.AoqConnectionStatusConnected) {
// 連接成功,發送 run-task(見步驟 4)
}
}
@Override
public void onDataMsg(@NonNull AoqClientEngine.AoqDataMsg msg) {
// 解析服務端事件(見步驟 5)
}
@Override
public void onError(int code, String message) {
// 錯誤處理
}
});
2. 配置音頻編碼並啓動採集
配置 PCM 編碼(16 kHz、單聲道),通過 setAudioFrameObserver 註冊採集回調獲取 PCM 數據,調用 enableSendMediaStream(Audio, false) 關閉音頻媒體上行(音頻通過 Data 通道發送),最後調用 startAudioCapture() 啓動採集。
本文示例使用 AOQ SDK 內部採集,通過 onCapturedAudioFrame 回調獲取 PCM 數據。也可以自行實現音頻採集(如 Android 的 AudioRecord),只需將採集到的 PCM 數據放入緩存隊列,後續的發送邏輯完全相同。
本文代碼示例調用 startAudioCapture,通過 onCapturedAudioFrame 獲取 PCM,然後複製到應用緩存。應註冊 AoqAudioSourceCaptured 原始採集回調,用於連接建立前的緩存。int SAMPLE_RATE = 16000;
// 配置 PCM 編碼
AoqClientEngine.AoqAudioCodecConfig codec = new AoqClientEngine.AoqAudioCodecConfig();
codec.codecType = AoqClientEngine.AoqEncoderType.AoqEncoderTypeAudioPCM;
codec.sampleRate = SAMPLE_RATE;
codec.channel = 1;
codec.bitrate = 256000;
engine.setAudioEncoderConfig(codec);
// 註冊採集回調
engine.setAudioFrameObserver(new AoqClientListener.AoqAudioFrameListener() {
@Override
public void onCapturedAudioFrame(
@NonNull AoqClientEngine.AoqAudioFrameData frame) {
if (frame.dataPtr != null && frame.dataSize > 0) {
// 將 PCM 數據緩存到隊列(見步驟 5)
pcmQueue.offer(frame.dataPtr, frame.dataSize);
}
Arrays.fill(frame.dataPtr, (byte) 0); // 清零防止媒體上行
}
});
AoqClientEngine.AoqAudioObserverConfig observer = new AoqClientEngine.AoqAudioObserverConfig();
observer.sampleRate = SAMPLE_RATE;
observer.channels = 1;
observer.mode = AoqClientEngine.AoqAudioObserverMode.AoqAudioObserverModeReadWrite;
engine.enableAudioFrameObserver(true,
AoqClientEngine.AoqAudioSource.AoqAudioSourceCaptured, observer);
// 關閉音頻媒體上行(音頻通過 Data 通道發送)
engine.enableSendMediaStream(AoqClientEngine.AoqTrackType.AoqTrackTypeAudio, false);
// 啓動採集(點擊即採集,不等連接)
engine.startAudioCapture(new AoqClientEngine.AoqAudioCaptureConfig());
業務使用平台錄音能力或已有音頻採集組件,輸出符合上述格式要求的 PCM,並寫入同一個緩存隊列。後續仍然通過 sendDataMsg 發送本文定義的音頻 JSON,無需把 PCM 再送入 SDK 的採集接口。
3. 配置連接和傳輸軌道並建立連接
將 AppServer 返回的憑證填入 AoqConnectConfig,發佈 Audio + Data 軌道,訂閱 Data 軌道。Audio 軌道聲明是連接所需的,但媒體上行已關閉,實際音頻通過 Data 通道傳輸。
必須發佈 Audio 軌道:ASR 模型要求連接時聲明 Audio 軌道,否則連接會失敗。但實際音頻數據不通過音頻媒體通道發送,而是通過 Data 通道以 input_audio_buffer.append 消息傳輸。因此需要在連接前調用 enableSendMediaStream(Audio, false) 關閉音頻媒體上行,避免 SDK 自動發送採集到的音頻。
// 從 AppServer 獲取憑證後,構建連接配置
AoqClientEngine.AoqConnectConfig config = new AoqClientEngine.AoqConnectConfig();
config.token = aoqTokenForClient;
config.sid = sid;
config.certFingerprint = clientRelayCertFingerprint;
config.workspaceIdHash = workspaceIdHash;
// relayEndpoints 從響應解析後添加
// 發布 Audio + Data 軌道
AoqClientEngine.AoqTrackParam audioTrack = new AoqClientEngine.AoqTrackParam();
audioTrack.trackType = AoqClientEngine.AoqTrackType.AoqTrackTypeAudio;
config.publishTracks.add(audioTrack);
AoqClientEngine.AoqTrackParam dataTrack = new AoqClientEngine.AoqTrackParam();
dataTrack.trackType = AoqClientEngine.AoqTrackType.AoqTrackTypeData;
config.publishTracks.add(dataTrack);
// 訂閱 Data 軌道
AoqClientEngine.AoqTrackParam subData = new AoqClientEngine.AoqTrackParam();
subData.trackType = AoqClientEngine.AoqTrackType.AoqTrackTypeData;
config.subscribeTracks.add(subData);
// 建立連接
engine.connect(config);
4. 發送 run-task 啓動識別任務
連接成功後,每輪語音輸入生成一個新的 task_id,例如使用 UUID.randomUUID().toString()。在連接成功回調中,通過 sendDataMsg 發送下列 JSON;同一輪只發送一次 run-task。
run-task 事件結構如下,任務 ID 為示例值,實際應替換為本輪新生成的值。具體事件請參考客戶端事件。
{
"header": {
"action": "run-task",
"task_id": "9fb212ea-6f83-4aef-9b8e-1bdd71f1d4d3",
"streaming": "duplex"
},
"payload": {
"task_group": "audio",
"task": "asr",
"function": "recognition",
"model": "qwen-audio-3.1-asr-flash-streaming",
"parameters": {
"format": "pcm",
"sample_rate": 16000
},
"input": {}
}
}
sendDataMsg 接口發送:
String taskId = UUID.randomUUID().toString();
JSONObject root = new JSONObject()
.put("header", new JSONObject()
.put("action", "run-task")
.put("task_id", taskId)
.put("streaming", "duplex"))
.put("payload", new JSONObject()
.put("task_group", "audio")
.put("task", "asr")
.put("function", "recognition")
.put("model", "qwen-audio-3.1-asr-flash-streaming")
.put("parameters", new JSONObject()
.put("format", "pcm")
.put("sample_rate", 16000))
.put("input", new JSONObject()));
AoqClientEngine.AoqDataMsg msg = new AoqClientEngine.AoqDataMsg();
msg.data = root.toString().getBytes(StandardCharsets.UTF_8);
engine.sendDataMsg(msg);
5. 收到 task-started 後倍速補發緩存音頻
在 onDataMsg 中解析 JSON。收到當前任務的下列事件後,才將發送狀態切換為就緒。
{
"header": {
"event": "task-started",
"task_id": "9fb212ea-6f83-4aef-9b8e-1bdd71f1d4d3"
},
"payload": {}
}
task_id 的響應核對當前任務 ID;重復的 task-started 不應啓動第二個發送循環。
音頻數據封裝格式: qwen-audio-3.1-asr-flash-streaming 的 Inference 協議(客戶端事件)只定義了 run-task、finish-task 兩種控制事件,音頻數據本身不是通過 JSON 事件發送的。但通過 AOQ Data 通道傳輸時,音頻數據需要以 JSON 消息形式發送。為此,AOQ 在 SDK 層面封裝了 input_audio_buffer.append 事件,用於承載音頻數據:
| 字段 | 類型 | 說明 |
|---|
type | string | 固定為 input_audio_buffer.append |
event_id | string | 事件唯一標識,用於關聯和去重 |
audio | string | Base64 編碼的 PCM 音頻數據 |
客戶端將採集到的 PCM 數據編碼為 Base64 後包裝到此 JSON 中,通過 sendDataMsg 發送。AOQ 服務端收到此 JSON 後,解析 audio 字段為二進制 PCM 數據,按照模型協議轉發給 ASR 模型。客戶端無需關心二進制幀的封裝細節,只需確保 PCM 格式(採樣率、聲道數、位深)與 run-task 中聲明的 format 和 sample_rate 一致。
{
"type": "input_audio_buffer.append",
"event_id": "event_550e8400-e29b-41d4-a716-446655440000",
"audio": "AQID//+AgAAEAACAAAAA..."
}
input_audio_buffer.append JSON 後通過 sendDataMsg 發送:
byte[] pcm = pcmQueue.poll(640); // 取出一幀 PCM 數據
if (pcm != null) {
JSONObject event = new JSONObject()
.put("type", "input_audio_buffer.append")
.put("event_id", "event_" + UUID.randomUUID())
.put("audio", Base64.encodeToString(pcm, Base64.NO_WRAP));
AoqClientEngine.AoqDataMsg msg = new AoqClientEngine.AoqDataMsg();
msg.data = event.toString().getBytes(StandardCharsets.UTF_8);
engine.sendDataMsg(msg);
}
onDataMsg 回調中解析服務端事件,收到 task-started 後啓動音頻發送,收到 result-generated 後解析識別結果,具體事件請參考服務端事件。
JSONObject root = new JSONObject(new String(msg.data, StandardCharsets.UTF_8));
String event = root.optJSONObject("header").optString("event");
if ("task-started".equals(event)) {
// 模型就緒,啓動音頻發送(倍速補發緩存,追平後實時發送)
} else if ("result-generated".equals(event)) {
// 解析識別結果(見步驟 6)
JSONObject sentence = root.optJSONObject("payload")
.optJSONObject("output").optJSONObject("sentence");
if (sentence != null && !sentence.optBoolean("heartbeat")) {
String text = sentence.optString("text", "");
boolean isFinal = sentence.optBoolean("sentence_end");
// 展示識別結果
}
} else if ("task-finished".equals(event)) {
// 任務完成
} else if ("task-failed".equals(event)) {
// 任務失敗
}
6. 處理識別結果並顯示
result-generated 事件攜帶識別句子,包含 text、sentence_end 等字段。中間結果實時展示,最終結果追加到輸入框。具體事件定義請參考服務端事件。
private void handleRecognitionResult(JSONObject root) {
JSONObject payload = root.optJSONObject("payload");
JSONObject output = payload == null ? null : payload.optJSONObject("output");
JSONObject sentence = output == null ? null : output.optJSONObject("sentence");
if (sentence == null || sentence.optBoolean("heartbeat")) return;
String text = sentence.optString("text", "");
if (text.isEmpty()) return;
boolean isFinal = sentence.optBoolean("sentence_end");
// 中間結果用於實時展示,最終結果用於追加
listener.onResult(text, isFinal);
}
7. 發送 finish-task 結束識別任務
用戶點擊結束後,先調用 engine.stopAudioCapture() 停止採集,等待緩存中剩餘的 PCM 數據排空後,發送 finish-task 通知服務端音頻已發送完畢,具體事件定義請參考客戶端事件。
task_id 必須與本輪 run-task 一致。
{
"header": {
"action": "finish-task",
"task_id": "UUID",
"streaming": "duplex"
},
"payload": {
"input": {}
}
}
sendDataMsg 發送:
engine.stopAudioCapture(); // 停止採集
// 等待緩存排空後發送 finish-task
JSONObject root = new JSONObject()
.put("header", new JSONObject()
.put("action", "finish-task")
.put("task_id", taskId)
.put("streaming", "duplex"))
.put("payload", new JSONObject()
.put("input", new JSONObject()));
AoqClientEngine.AoqDataMsg msg = new AoqClientEngine.AoqDataMsg();
msg.data = root.toString().getBytes(StandardCharsets.UTF_8);
engine.sendDataMsg(msg);
{
"header": {
"event": "task-finished",
"task_id": "9fb212ea-6f83-4aef-9b8e-1bdd71f1d4d3"
},
"payload": {}
}
8. 斷開連接並銷毀引擎
收到 task-finished 後,如果不再需要複用連接,按以下方式清理資源;發生異常或超時時也應清理資源。
engine.stopAudioCapture();
engine.setAudioFrameObserver(null);
engine.disconnect();
AoqClientEngine.destroy();
engine = null;
注意事項
- 必須收到
task-started 後才能發送音頻,否則數據會被丟棄。
finish-task 必須在緩存排空(queue.size() == 0)後發送,確保最後一段音頻被模型處理。- 收到
task-finished 後不要立即斷開連接,可復用同一連接發起新任務(新 task_id)。
result-generated 中的心跳包(heartbeat: true)應忽略,不作為識別結果。
典型場景
同一連接多次識別
收到 task-finished 後,連接仍然可用。客戶端可以使用新的 task_id 再次發送 run-task,開始新一輪識別,無需重新建立連接。這適用於連續語音輸入場景,減少重復連接的延遲。
// 第一輪識別結束後(收到 task-finished)
// 使用新的 task_id 發送 run-task,開始第二輪
taskId = UUID.randomUUID().toString();
sendRunTask();
自行實現音頻採集
本文示例使用 AOQ SDK 的內部採集(startAudioCapture + onCapturedAudioFrame 回調),也可以自行實現音頻採集。只需將採集到的 PCM 數據(16 kHz、單聲道、16 位)放入 PcmQueue,後續的緩存補發和發送邏輯完全相同。
相關文檔