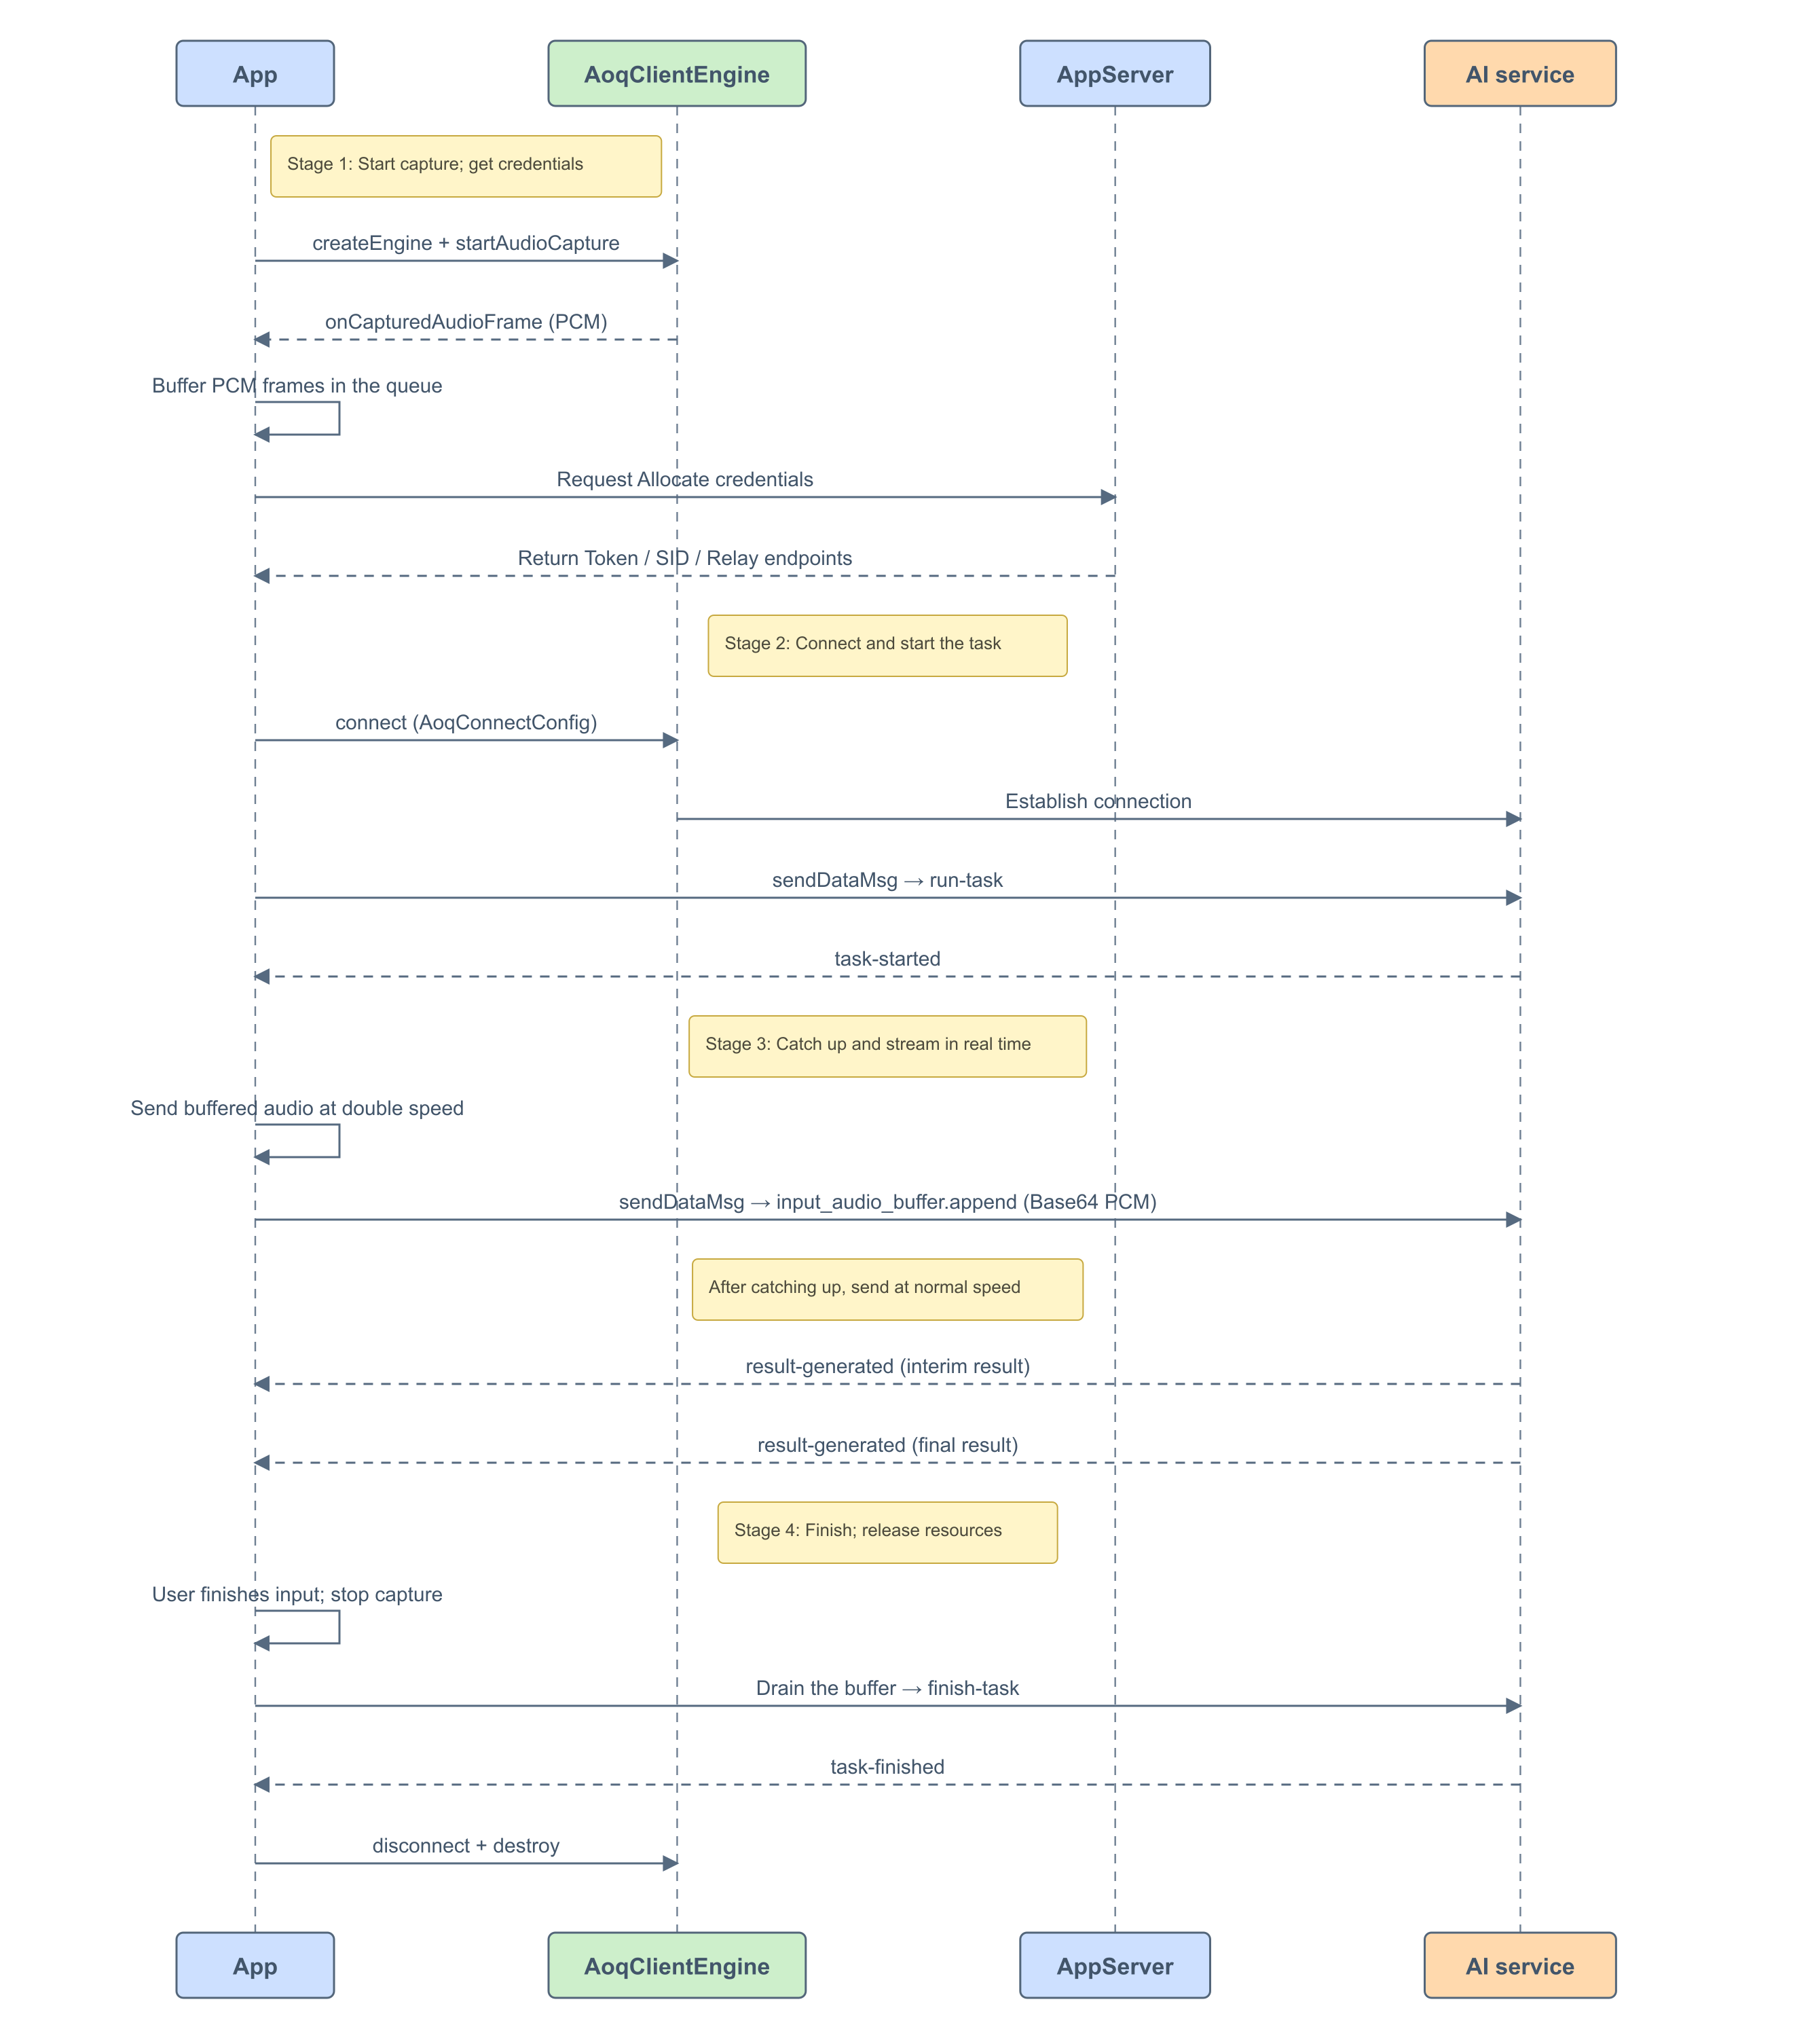
方式の概要
音声入力の一般的な操作では、ユーザーが音声入力ボタンを押して話し始めると、認識結果が入力欄にリアルタイムで表示されます。クライアント実装の要点は次のとおりです。
- 押したらすぐに収集:ボタンが押されたら直ちに音声収集と PCM データのバッファリングを開始し、接続資格情報の取得と接続を非同期で行います。接続には時間がかかり、その間にもユーザーは話し始めるため、音声を先に保存してから送信します。
- 倍速で追いつく:接続が成功し、モデルの準備完了イベントを受信したら、保存した音声を倍速で送信します。追いついたらリアルタイム送信に切り替えます。
- Data チャネルで音声を送信:qwen-audio-3.1-asr-flash-streaming は Inference プロトコル(run-task / finish-task)を使用します。このシナリオでは音声を保存してから倍速で送信するため、
sendDataMsg を使用して JSON メッセージとして音声を送信します。AOQ サーバーはこの JSON 音声メッセージ形式に対応しており、受信したメッセージを自動的にバイナリデータに変換してモデルに転送します。
- 中間結果と最終結果:モデルは認識結果を継続的に返します。中間結果(
sentence_end: false)はリアルタイムで表示し、最終結果(sentence_end: true)は入力欄に追加します。
前提条件
- Alibaba Cloud Model Studio を有効にし、API キーの取得と設定に従って API キーを取得します。API キーは AppServer のみに保存してください。クライアントコードに埋め込んだり、コードリポジトリにコミットしたりしないでください。
{endpoint} は中国(北京)の {WorkspaceId}.cn-beijing.maas.aliyuncs.com またはシンガポールの {WorkspaceId}.ap-southeast-1.maas.aliyuncs.com にします。実際のワークスペース ID に置き換え、対応するリージョンとワークスペースの API キーを使用します。- SDK ダウンロードから最新の AOQ Client SDK を取得します。
- Qwen-Audio-ASR-Streaming の AOQ 認証手順に従って AppServer を構築します。新しい接続のたびに、クライアントは AppServer から新しい接続認証情報を取得する必要があります。
SDK のインポート
SDK ダウンロードから最新の AOQ Client SDK を取得し、開発プラットフォームに対応する SDK をインポートします。以降のクライアントコードは Android の例です。他のプラットフォームも同じインターフェイス設計とイベントフローを使用します。
-
Opus プラグインの
libPluginOpus.so を ABI に応じて app/src/main/jniLibs/armeabi-v7a/ と app/src/main/jniLibs/arm64-v8a/ に配置します。AoqClientSdk-release.aar を app/libs に配置し、app/build.gradle で依存関係と対応 ABI を設定します。
android {
defaultConfig {
minSdk 21
ndk { abiFilters 'armeabi-v7a', 'arm64-v8a' }
}
}
dependencies {
implementation fileTree(dir: 'libs', include: ['*.aar'])
}
-
AndroidManifest.xml で次の権限を宣言します。
<uses-permission android:name="android.permission.INTERNET" />
<uses-permission android:name="android.permission.ACCESS_NETWORK_STATE" />
<uses-permission android:name="android.permission.RECORD_AUDIO" />
<uses-permission android:name="android.permission.MODIFY_AUDIO_SETTINGS" />
-
マイクを使用する前に、実行時に
RECORD_AUDIO 権限を要求します。
AoqClientSdk.framework と PluginOpus.framework を Xcode プロジェクトにドラッグします。Target > General > Frameworks, Libraries, and Embedded Content で Embed & Sign を選択します。SDK は iOS 13.0 以降の arm64 デバイスに対応します。- Info.plist に
NSMicrophoneUsageDescription を追加し、マイクを使用する前にユーザーの許可を要求します。
- Swift プロジェクトでは
import AoqClientSdk、Objective-C プロジェクトでは #import <AoqClientSdk/AoqClientSdk.h> を使用します。
-
Opus プラグインの
libPluginOpus.so を entry/libs/arm64-v8a/、AoqClientSdk.har を entry/libs に配置し、entry/oh-package.json5 で依存関係を宣言します。SDK は API 12 と互換性があり、arm64-v8a に対応します。
{
"dependencies": {
"@aoq/client-sdk": "file:./libs/AoqClientSdk.har"
}
}
-
entry/src/main/module.json5 で次の権限を宣言します。
"requestPermissions": [
{ "name": "ohos.permission.INTERNET" },
{ "name": "ohos.permission.MICROPHONE",
"reason": "$string:perm_mic_reason",
"usedScene": { "abilities": ["EntryAbility"], "when": "inuse" } }
]
-
マイクを使用する前に
abilityAccessCtrl.createAtManager().requestPermissionsFromUser を呼び出して、ohos.permission.MICROPHONE を要求します。
-
SDK を展開し、
aoq_client_sdk.py、libAoqClientSdk.so、libonnxruntime.so.1.16.3 を同じディレクトリに配置します。
-
SDK ディレクトリを Python と動的ライブラリの検索パスに追加します。
export PYTHONPATH="$PWD/AoqClientSdk:$PYTHONPATH"
export LD_LIBRARY_PATH="$PWD/AoqClientSdk:$LD_LIBRARY_PATH"
-
Python コードで
import aoq_client_sdk を使用します。AOQ_CLIENT_SDK_LIB 環境変数で libAoqClientSdk.so の絶対パスを指定することもできます。
AppServer でトークンを取得
AppServer は Model Studio の割り当て API を呼び出し、SDK の接続に必要な Token、SID、Relay エンドポイントなどの情報をクライアントへ返します。
curl -X POST \
"https://{endpoint}/api/v1/webrtc/inference?model=qwen-audio-3.1-asr-flash-streaming" \
-H "Content-Type: application/json" \
-H "Authorization: Bearer ${DASHSCOPE_API_KEY}" \
-H "x-dashscope-rtc-transport: moq" \
-d "{\"clientIp\": \"${CLIENT_REAL_IP}\"}"
| 応答フィールド | SDK フィールド |
|---|
aoqTokenForClient | AoqConnectConfig.token |
sid | AoqConnectConfig.sid |
clientRelayCertFingerprint | AoqConnectConfig.certFingerprint |
clientRelayEndpoints | AoqConnectConfig.relayEndpoints |
extraInfo.workspaceIdHash | AoqConnectConfig.workspaceIdHash |
クライアントの実装
以下では Android を例に、実装順に説明します。他のプラットフォームも同じインターフェイス設計とイベントフローを使用します。
1. エンジンを作成してコールバックを登録
AoqClientEngine インスタンスを作成し、接続状態と Data メッセージのコールバックを登録します。接続成功後に run-task を送信します。Data メッセージコールバックでサーバーイベントを処理します。
// Create the engine
AoqClientEngine.AoqCreateConfig create = new AoqClientEngine.AoqCreateConfig();
create.workDir = getCacheDir().getAbsolutePath();
engine = AoqClientEngine.createEngine(this, create, new AoqClientListener() {
@Override
public void onConnectionStatusChange(
@NonNull AoqClientEngine.AoqConnectionStatus state) {
if (state == AoqClientEngine.AoqConnectionStatus.AoqConnectionStatusConnected) {
// Connected: send run-task (see step 4)
}
}
@Override
public void onDataMsg(@NonNull AoqClientEngine.AoqDataMsg msg) {
// Parse server events (see step 5)
}
@Override
public void onError(int code, String message) {
// Handle errors
}
});
2. 音声エンコードを設定して収集を開始
PCM エンコード(16 kHz、モノラル)を設定し、setAudioFrameObserver で収集コールバックを登録して PCM データを取得します。enableSendMediaStream(Audio, false) で音声メディアの上り送信を無効にします(音声は Data チャネルで送信)。最後に startAudioCapture() で収集を開始します。
この例では AOQ SDK の内部収集を使用し、onCapturedAudioFrame コールバックで PCM データを取得します。Android の AudioRecord などを使って独自に収集することもできます。PCM データをバッファキューに追加すれば、以降の送信ロジックは同じです。
コード例では startAudioCapture を呼び出し、onCapturedAudioFrame で PCM を取得してアプリケーションのバッファにコピーします。接続前に保存するため、AoqAudioSourceCaptured の元の収集コールバックを登録します。int SAMPLE_RATE = 16000;
// Configure PCM encoding
AoqClientEngine.AoqAudioCodecConfig codec = new AoqClientEngine.AoqAudioCodecConfig();
codec.codecType = AoqClientEngine.AoqEncoderType.AoqEncoderTypeAudioPCM;
codec.sampleRate = SAMPLE_RATE;
codec.channel = 1;
codec.bitrate = 256000;
engine.setAudioEncoderConfig(codec);
// Register the capture callback
engine.setAudioFrameObserver(new AoqClientListener.AoqAudioFrameListener() {
@Override
public void onCapturedAudioFrame(
@NonNull AoqClientEngine.AoqAudioFrameData frame) {
if (frame.dataPtr != null && frame.dataSize > 0) {
// Buffer PCM data in the queue (see step 5)
pcmQueue.offer(frame.dataPtr, frame.dataSize);
}
Arrays.fill(frame.dataPtr, (byte) 0); // Clear the buffer to prevent outgoing audio media
}
});
AoqClientEngine.AoqAudioObserverConfig observer = new AoqClientEngine.AoqAudioObserverConfig();
observer.sampleRate = SAMPLE_RATE;
observer.channels = 1;
observer.mode = AoqClientEngine.AoqAudioObserverMode.AoqAudioObserverModeReadWrite;
engine.enableAudioFrameObserver(true,
AoqClientEngine.AoqAudioSource.AoqAudioSourceCaptured, observer);
// Disable outgoing audio media (send audio over the Data channel)
engine.enableSendMediaStream(AoqClientEngine.AoqTrackType.AoqTrackTypeAudio, false);
// Start capture immediately, without waiting for the connection
engine.startAudioCapture(new AoqClientEngine.AoqAudioCaptureConfig());
プラットフォームの録音機能または既存の収集コンポーネントから、上記の形式の PCM を出力し、同じバッファキューに追加します。以降は sendDataMsg で本チュートリアルの音声 JSON を送信します。PCM を SDK の収集インターフェイスに再入力する必要はありません。
3. 接続資格情報とトラックを設定して接続
AppServer から返された資格情報を AoqConnectConfig に設定し、Audio + Data トラックを公開して Data トラックを購読します。Audio トラックの宣言は接続に必要ですが、メディアの上り送信は無効で、実際の音声は Data チャネルで送信します。
Audio トラックの公開が必要です:ASR モデルは接続時に Audio トラックの宣言を要求するため、宣言しないと接続に失敗します。実際の音声は音声メディアチャネルではなく、Data チャネルの input_audio_buffer.append メッセージで送信します。接続前に enableSendMediaStream(Audio, false) を呼び出し、SDK による収集音声の自動送信を防ぎます。
// Build the connection configuration after obtaining credentials from AppServer
AoqClientEngine.AoqConnectConfig config = new AoqClientEngine.AoqConnectConfig();
config.token = aoqTokenForClient;
config.sid = sid;
config.certFingerprint = clientRelayCertFingerprint;
config.workspaceIdHash = workspaceIdHash;
// Parse relayEndpoints from the response and add them to the configuration
// Publish Audio + Data tracks
AoqClientEngine.AoqTrackParam audioTrack = new AoqClientEngine.AoqTrackParam();
audioTrack.trackType = AoqClientEngine.AoqTrackType.AoqTrackTypeAudio;
config.publishTracks.add(audioTrack);
AoqClientEngine.AoqTrackParam dataTrack = new AoqClientEngine.AoqTrackParam();
dataTrack.trackType = AoqClientEngine.AoqTrackType.AoqTrackTypeData;
config.publishTracks.add(dataTrack);
// Subscribe to the Data track
AoqClientEngine.AoqTrackParam subData = new AoqClientEngine.AoqTrackParam();
subData.trackType = AoqClientEngine.AoqTrackType.AoqTrackTypeData;
config.subscribeTracks.add(subData);
// Establish the connection
engine.connect(config);
4. run-task を送信して認識を開始
接続成功後、音声入力のラウンドごとに UUID.randomUUID().toString() などで新しい task_id を生成します。接続成功コールバックで sendDataMsg を使って次の JSON を送信します。各ラウンドで run-task は一度だけ送信します。
run-task イベントの構造は次のとおりです。タスク ID は例示値のため、今回のラウンドで生成した ID に置き換えます。詳細はクライアントイベントをご参照ください。
{
"header": {
"action": "run-task",
"task_id": "9fb212ea-6f83-4aef-9b8e-1bdd71f1d4d3",
"streaming": "duplex"
},
"payload": {
"task_group": "audio",
"task": "asr",
"function": "recognition",
"model": "qwen-audio-3.1-asr-flash-streaming",
"parameters": {
"format": "pcm",
"sample_rate": 16000
},
"input": {}
}
}
sendDataMsg インターフェイスで送信します。
String taskId = UUID.randomUUID().toString();
JSONObject root = new JSONObject()
.put("header", new JSONObject()
.put("action", "run-task")
.put("task_id", taskId)
.put("streaming", "duplex"))
.put("payload", new JSONObject()
.put("task_group", "audio")
.put("task", "asr")
.put("function", "recognition")
.put("model", "qwen-audio-3.1-asr-flash-streaming")
.put("parameters", new JSONObject()
.put("format", "pcm")
.put("sample_rate", 16000))
.put("input", new JSONObject()));
AoqClientEngine.AoqDataMsg msg = new AoqClientEngine.AoqDataMsg();
msg.data = root.toString().getBytes(StandardCharsets.UTF_8);
engine.sendDataMsg(msg);
5. task-started の受信後に保存音声を倍速送信
onDataMsg で JSON を解析します。現在のタスクの次のイベントを受信してから、送信状態を準備完了に切り替えます。
{
"header": {
"event": "task-started",
"task_id": "9fb212ea-6f83-4aef-9b8e-1bdd71f1d4d3"
},
"payload": {}
}
task_id を含む応答が現在のタスク ID と一致することを確認し、重複する task-started で二つ目の送信ループを開始しないようにします。
音声メッセージ形式: qwen-audio-3.1-asr-flash-streaming の Inference プロトコル(クライアントイベント)では、run-task、finish-task の二つの制御イベントのみを定義し、音声自体は JSON イベントでは送信しません。一方、AOQ Data チャネルでは音声を JSON メッセージで送信するため、AOQ は SDK 層で音声用の input_audio_buffer.append イベントを提供します。
| フィールド | 型 | 説明 |
|---|
type | string | 固定値:input_audio_buffer.append |
event_id | string | 関連付けと重複排除に使用する一意のイベント ID |
audio | string | Base64 エンコードされた PCM 音声データ |
クライアントは収集した PCM を Base64 エンコードしてこの JSON に格納し、sendDataMsg で送信します。AOQ サーバーは audio をバイナリ PCM に解析し、モデルのプロトコルに従って ASR モデルに転送します。バイナリフレームの組み立てはクライアント側で不要です。PCM の形式(サンプリングレート、チャンネル数、ビット深度)が run-task の format と sample_rate に一致することを確認します。
{
"type": "input_audio_buffer.append",
"event_id": "event_550e8400-e29b-41d4-a716-446655440000",
"audio": "AQID//+AgAAEAACAAAAA..."
}
input_audio_buffer.append JSON に格納して sendDataMsg で送信します。
byte[] pcm = pcmQueue.poll(640); // Read one PCM frame
if (pcm != null) {
JSONObject event = new JSONObject()
.put("type", "input_audio_buffer.append")
.put("event_id", "event_" + UUID.randomUUID())
.put("audio", Base64.encodeToString(pcm, Base64.NO_WRAP));
AoqClientEngine.AoqDataMsg msg = new AoqClientEngine.AoqDataMsg();
msg.data = event.toString().getBytes(StandardCharsets.UTF_8);
engine.sendDataMsg(msg);
}
onDataMsg でサーバーイベントを解析し、task-started で音声送信を開始し、result-generated で認識結果を解析します。詳細はサーバーイベントをご参照ください。
JSONObject root = new JSONObject(new String(msg.data, StandardCharsets.UTF_8));
String event = root.optJSONObject("header").optString("event");
if ("task-started".equals(event)) {
// Model ready: send buffered audio at double speed, then stream in real time
} else if ("result-generated".equals(event)) {
// Parse recognition results (see step 6)
JSONObject sentence = root.optJSONObject("payload")
.optJSONObject("output").optJSONObject("sentence");
if (sentence != null && !sentence.optBoolean("heartbeat")) {
String text = sentence.optString("text", "");
boolean isFinal = sentence.optBoolean("sentence_end");
// Display recognition results
}
} else if ("task-finished".equals(event)) {
// Task finished
} else if ("task-failed".equals(event)) {
// Task failed
}
6. 認識結果を処理して表示
result-generated は text や sentence_end を含む認識文を返します。中間結果はリアルタイムで表示し、最終結果は入力欄に追加します。イベントの定義はサーバーイベントをご参照ください。
private void handleRecognitionResult(JSONObject root) {
JSONObject payload = root.optJSONObject("payload");
JSONObject output = payload == null ? null : payload.optJSONObject("output");
JSONObject sentence = output == null ? null : output.optJSONObject("sentence");
if (sentence == null || sentence.optBoolean("heartbeat")) return;
String text = sentence.optString("text", "");
if (text.isEmpty()) return;
boolean isFinal = sentence.optBoolean("sentence_end");
// Display interim results in real time; append final results
listener.onResult(text, isFinal);
}
7. finish-task を送信して認識を終了
ユーザーが入力を終了したら、まず engine.stopAudioCapture() で収集を停止します。バッファ内の残りの PCM をすべて送信してから finish-task を送信し、音声送信の完了を通知します。定義はクライアントイベントをご参照ください。
task_id は今回のラウンドの run-task と同じ値にする必要があります。
{
"header": {
"action": "finish-task",
"task_id": "UUID",
"streaming": "duplex"
},
"payload": {
"input": {}
}
}
sendDataMsg で送信します。
engine.stopAudioCapture(); // Stop capture
// Wait for the buffer to drain, then send finish-task
JSONObject root = new JSONObject()
.put("header", new JSONObject()
.put("action", "finish-task")
.put("task_id", taskId)
.put("streaming", "duplex"))
.put("payload", new JSONObject()
.put("input", new JSONObject()));
AoqClientEngine.AoqDataMsg msg = new AoqClientEngine.AoqDataMsg();
msg.data = root.toString().getBytes(StandardCharsets.UTF_8);
engine.sendDataMsg(msg);
{
"header": {
"event": "task-finished",
"task_id": "9fb212ea-6f83-4aef-9b8e-1bdd71f1d4d3"
},
"payload": {}
}
8. 接続を切断してエンジンを破棄
task-finished を受信した後、接続を再利用する必要がなければ、次のようにリソースを解放します。異常やタイムアウトが発生した場合もリソースを解放します。
engine.stopAudioCapture();
engine.setAudioFrameObserver(null);
engine.disconnect();
AoqClientEngine.destroy();
engine = null;
注意事項
task-started を受信してから音声を送信します。受信前に送信したデータは破棄されます。- 最後の音声までモデルが処理できるよう、バッファが空(
queue.size() == 0)になってから finish-task を送信します。
task-finished の直後に切断しないでください。同じ接続を、新しい task_id のタスクに再利用できます。result-generated のハートビート(heartbeat: true)は無視し、認識結果として扱わないでください。
一般的なシナリオ
一つの接続で複数回認識
task-finished の後も接続は使用できます。新しい task_id で run-task を再送信すると、再接続せずに次の認識を開始できます。継続的な音声入力に適し、繰り返しの接続遅延を減らせます。
// After the first round finishes (task-finished received)
// Send run-task with a new task_id to start the second round
taskId = UUID.randomUUID().toString();
sendRunTask();
独自の音声収集
この例では AOQ SDK の内部収集(startAudioCapture + onCapturedAudioFrame)を使用しますが、独自収集も可能です。収集した PCM(16 kHz、モノラル、16 ビット)を PcmQueue に追加すると、以降の保存音声の追いつき送信と送信ロジックは同じです。
関連ドキュメント