

画像動画生成 を利用する際に、 プロンプト最適化 や 公式動画エフェクト の呼び出しで 特定のアクション、エフェクト、スタイル に関するカスタム要件を満たせない場合は、 モデルファインチューニング を使用します。
適用範囲
- 適用リージョン:本ドキュメントで説明する機能は、シンガポールリージョンでのみ利用可能です。このリージョンで作成された API キー を使用する必要があります。
- サポートされるファインチューニング手法:効率的な SFT-LoRA ファインチューニング。
-
ファインチューニングをサポートするモデル:
- 画像動画生成 (先頭フレームベース):wan2.7-i2v、wan2.6-i2v、wan2.5-i2v-preview、wan2.2-i2v-flash。
- 画像動画生成 (先頭・最終フレームベース):wan2.2-kf2v-flash。
モデルのファインチューニング方法
- 画像動画生成 (先頭フレームベース)
- 画像動画生成 (先頭・最終フレームベース)
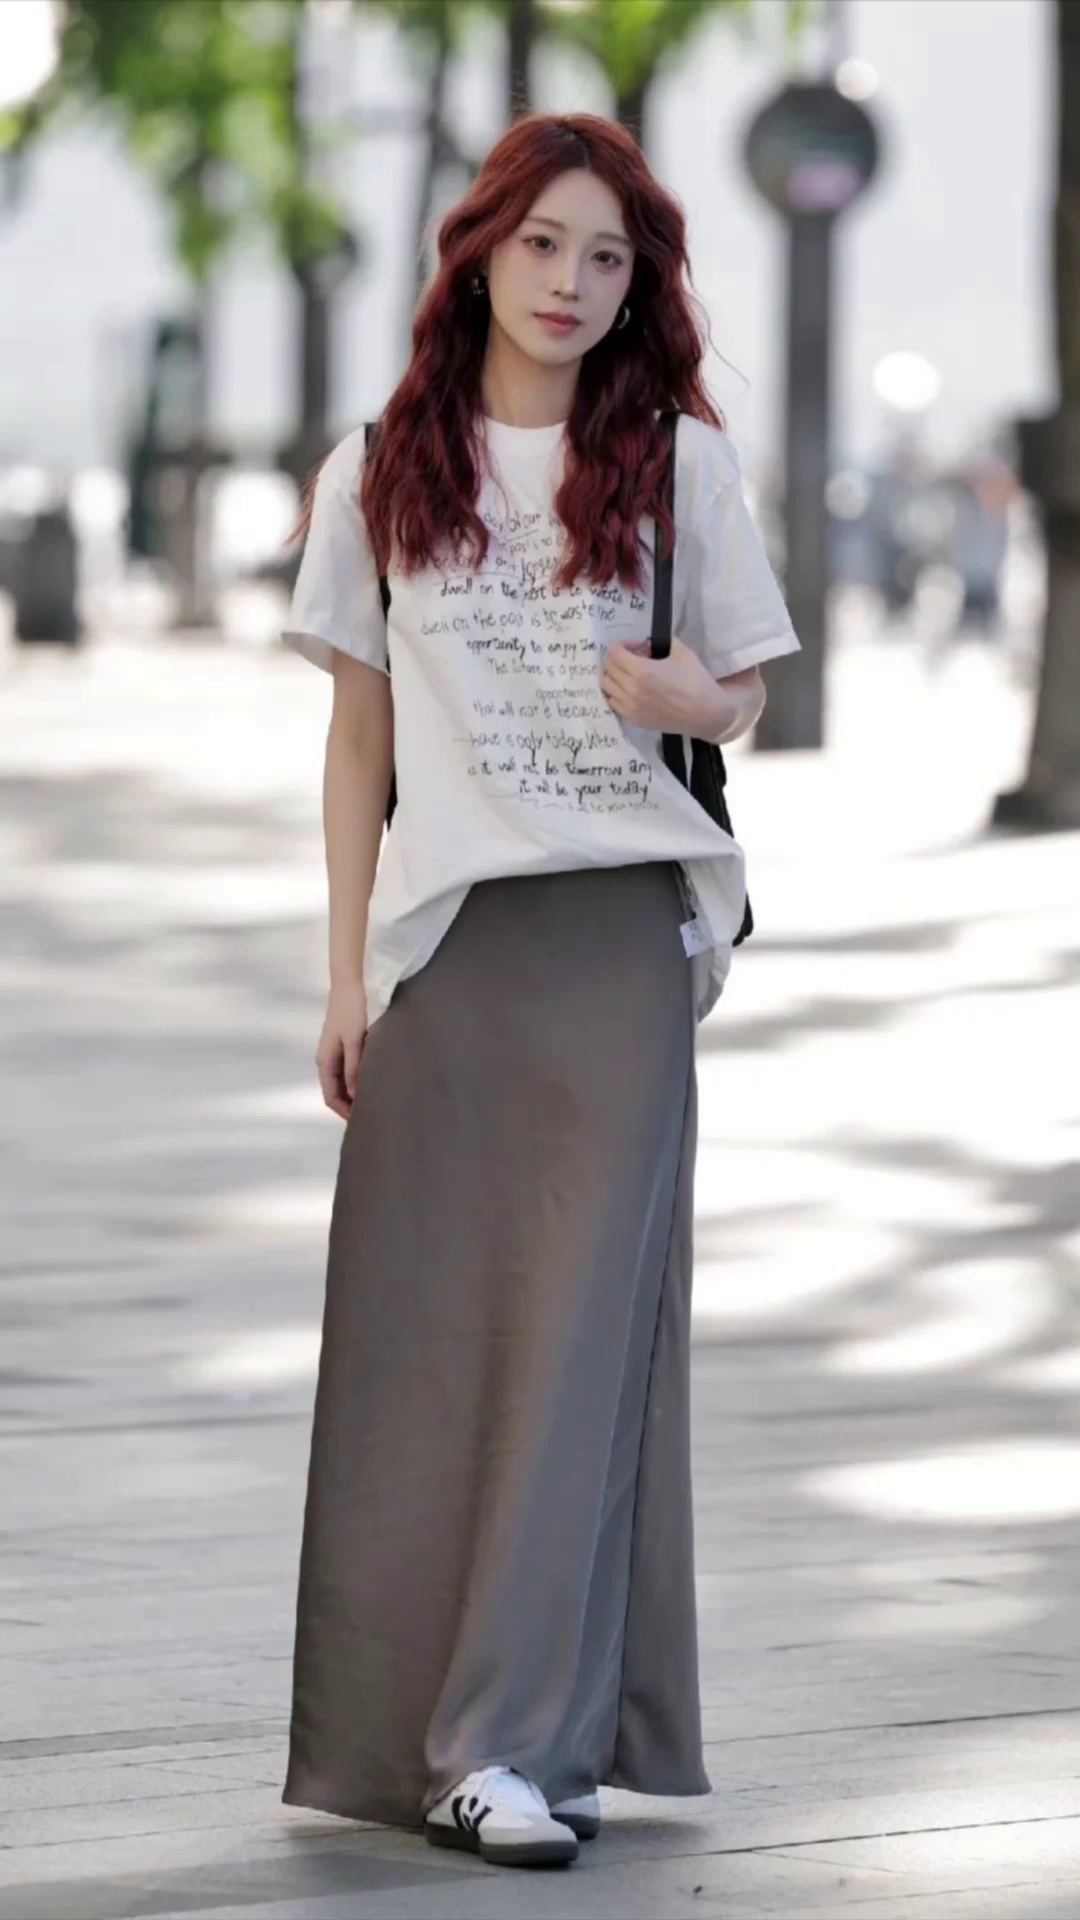
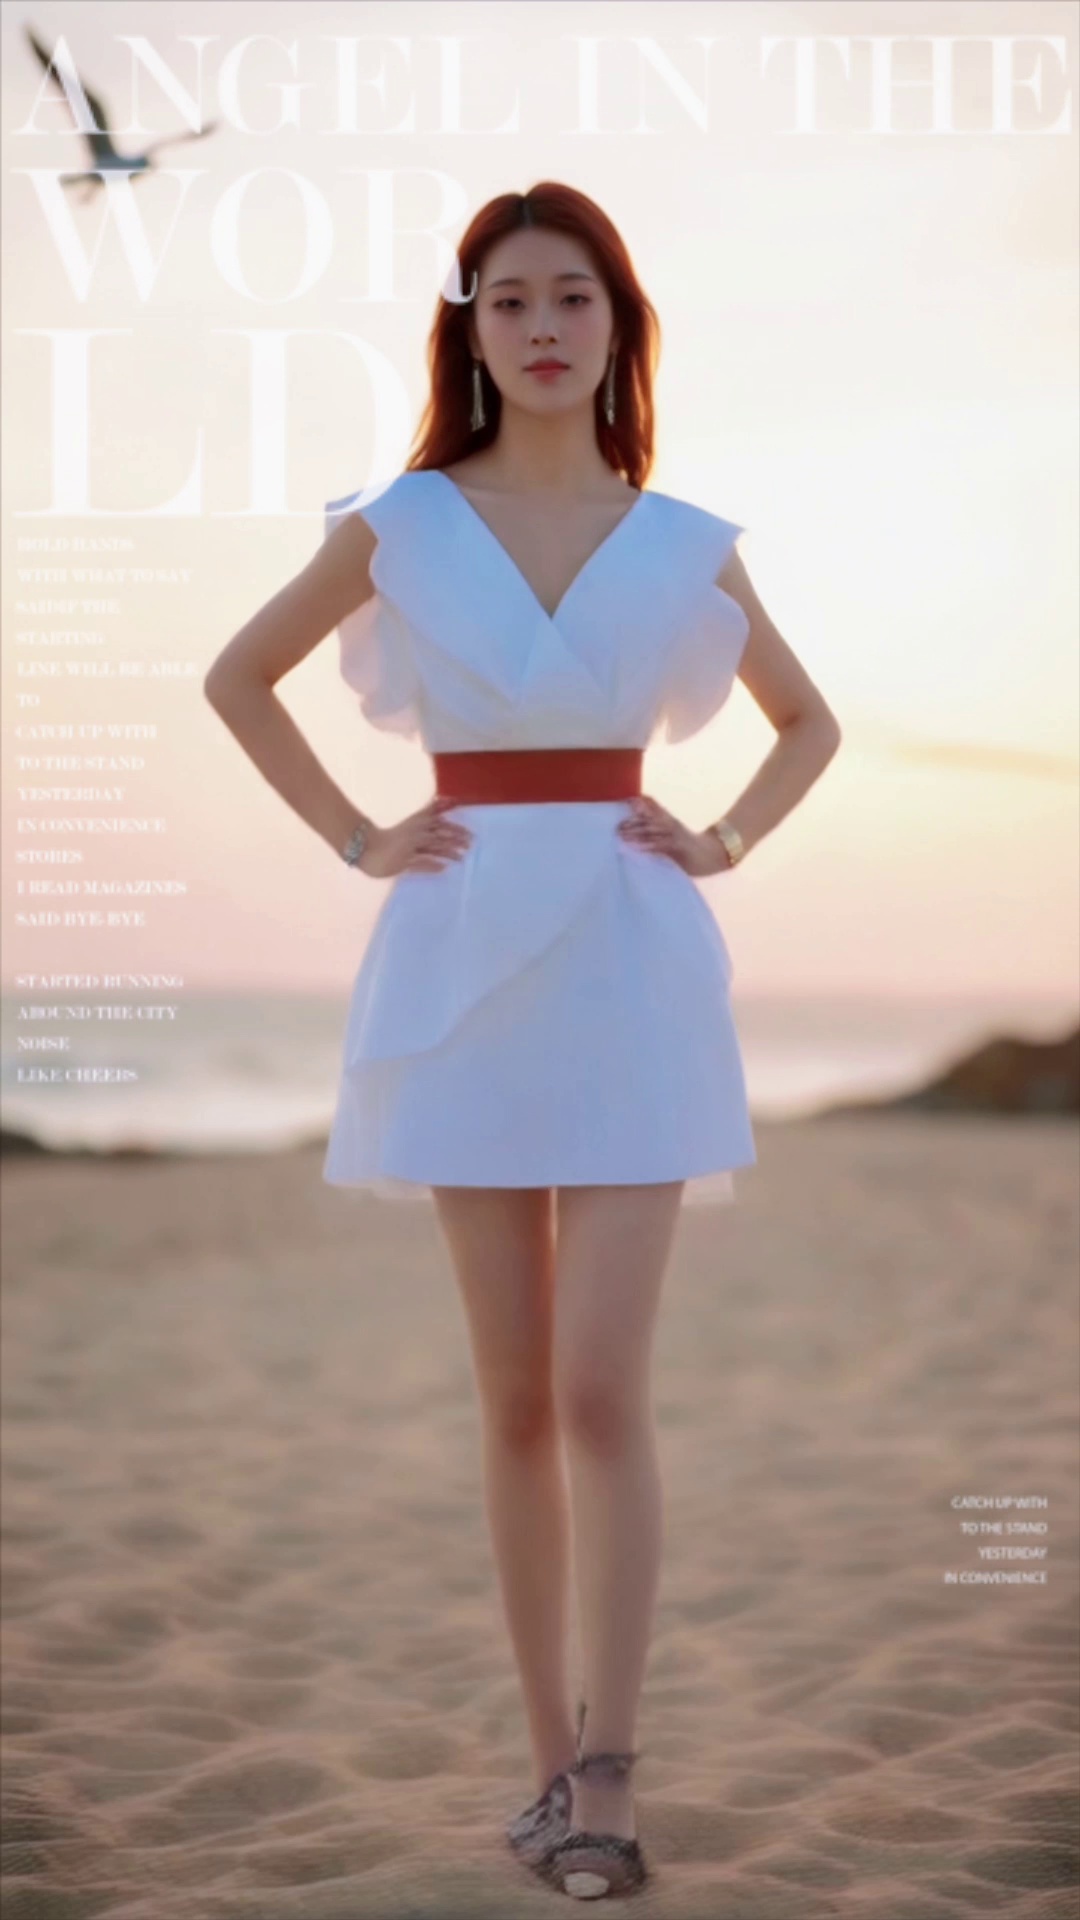
入力された先頭フレーム画像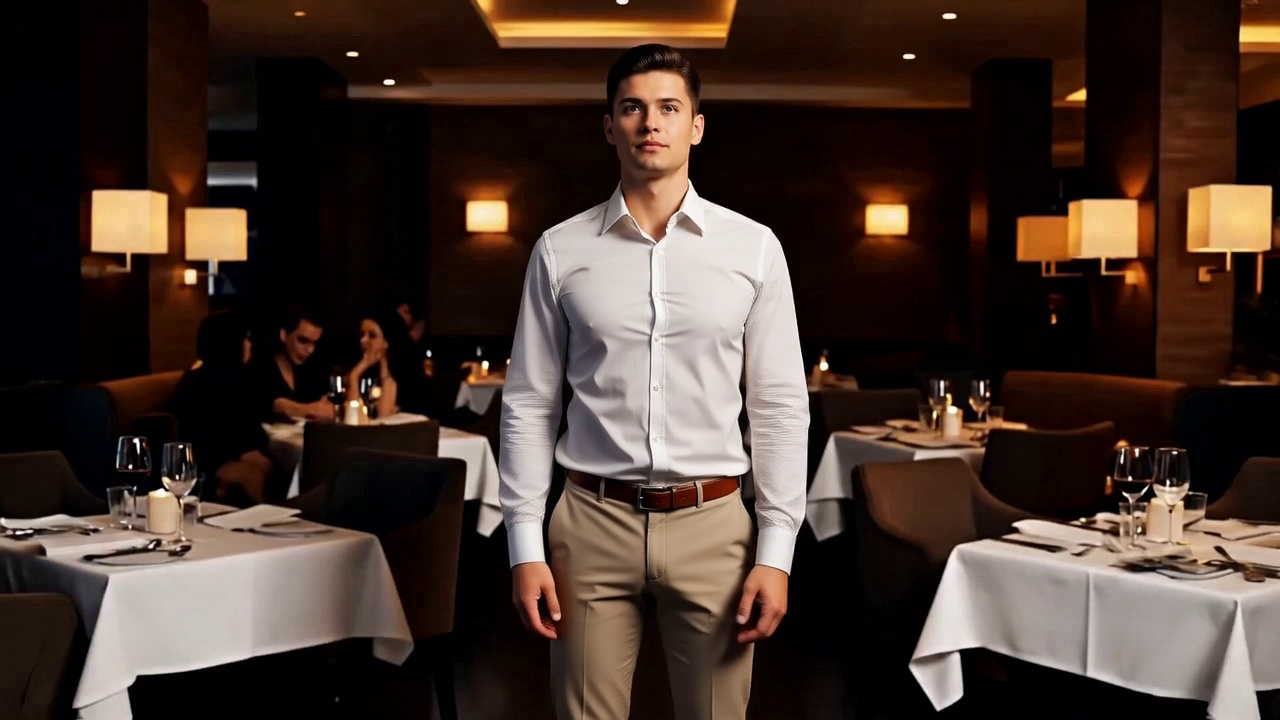 | 出力動画 (ファインチューニング前)プロンプトを使用しても、一貫したマネーレインエフェクトを毎回生成することはできず、動きも制御できません。 | 出力動画 (ファインチューニング後)ファインチューニング済みのモデルは、プロンプトなしでトレーニングデータセットから特定のマネーレインエフェクトを再現します。 |
ステップ 1:データセットのアップロード
ローカルのデータセット (.zip 形式) を Alibaba Cloud Model Studio にアップロードし、ファイル ID (id) を取得します。
トレーニングデータセットのサンプル:フォーマットの詳細はトレーニングセットをご参照ください。
- 画像動画生成 (先頭フレームベース):wan-i2v-training-dataset.zip。
- 画像動画生成 (先頭・最終フレームベース):wan-kf2v-training-dataset.zip。
この例では、先頭フレームベースの画像動画生成モデルを使用します。トレーニングセットのみをアップロードしてください。システムが自動的に一部を検証データセットとして分割します。データセットのアップロードには数分かかります。正確な時間はファイルサイズによって異なります。
id を保存します。これは、アップロードしたデータセットの一意の識別子です。
ステップ 2:モデルのファインチューニング
ステップ 2.1 ファインチューニングジョブの作成
ステップ 1 で取得したファイル ID を使用してトレーニングを開始します。 リクエスト例 前のステップで取得したid の値で <replace with training dataset file ID> を完全に置き換えます。
| フィールド | タイプ | 必須 | 説明 | 推奨値 |
|---|---|---|---|---|
| batch_size | int | はい | バッチサイズ。一度にトレーニングのためにモデルに送信されるデータサンプルの数。このパラメーターはインスタンスごとの設定です。各モデルのデフォルト値を使用することを推奨します。必要な場合以外は調整しないでください。
トレーニングジョブで実行される実際のインスタンス数は、プラットフォームのスケジューリングによって決定されます。トレーニングログの Global Step 出力は推定結果と異なる場合がありますが、これはトレーニングデータの総量や最終的なモデルのパフォーマンスには影響しません。 | モデルに依存 |
| n_epochs | int | はい | トレーニングエポック。steps = n_epochs x ceiling(データセットサイズ / batch_size)。合計ステップ数は 800 以上である必要があります。例:データセットに 5 つのサンプルがあり、batch_size=4 の場合、エポックあたりのステップ数 = ceiling(5/4) = 2、最小 n_epochs = 800/2 = 400。 推奨されるトレーニングエポック数は、データ量に応じて自動的に調整されます。データが少ないほど十分な学習のために多くのエポックが必要になり、データが多いほど各エポックに含まれるサンプル数が多くなるため、必要なエポック数は少なくなります。50 エポックは、主に約 2 サンプルの非常に小さなデータセットに適しています。データ量が 50〜60 の動画に達した場合、通常、約 3000〜5000 ステップのトレーニングが推奨されます。 | 50 |
| learning_rate | float | はい | 学習率。モデルの重み更新の大きさを制御します。高すぎるとモデルが劣化する可能性があり、低すぎると変更がごくわずかになる可能性があります。 | 2e-5 |
| eval_epochs | int | はい | 評価間隔。値は n_epochs/10 以上である必要があります。各評価とチェックポイント保存の間に何エポックを挟むかを指定します。 | 20 |
| max_pixels | int | はい | トレーニング動画の最大解像度 (総ピクセル数 = 幅 x 高さ)。システムは、この値を超える動画のみをスケーリングします。
| モデルに依存 |
| split | float | いいえ | トレーニングセットの分割比率。値の範囲:(0,1)。validation_datasets が指定されていない場合にのみ有効です。 | 0.9 |
| max_split_val_dataset_sample | int | いいえ | 自動分割による検証サンプルの最大数。検証数 = min(合計 x (1 - split), この値)。 | 5 |
| save_total_limit | int | いいえ | 保持するチェックポイントの最大数。システムは最後の N 個のチェックポイントのみを保持します。 | 10 |
| lora_rank | int | いいえ | LoRA の低ランク行列の次元。値は 2n (16/32/64) である必要があります。 | 32 |
| lora_alpha | int | いいえ | LoRA の重みスケーリング係数。値は 2n (16/32/64) である必要があります。 | 32 |
output の中のこれら 3 つの主要なパラメーターを確認してください:
job_id:ジョブ ID。進捗状況の確認に使用します。finetuned_output:新しくファインチューニングされたモデルの名前。デプロイメントにこの名前を使用します。status:トレーニングステータス。ジョブ作成後、初期ステータスは PENDING です。トレーニングはまだ開始されていません。
ステップ 2.2 ファインチューニングジョブのステータス確認
ステップ 2.1 で取得したjob_id を使用して進捗を確認します。status が SUCCEEDED になるまで、このエンドポイントをポーリングします。
<replace with fine-tuning job job_id> を job_id の値で完全に置き換えます。
output フィールドのこれら 2 つのパラメーターを確認してください:
status:この値が SUCCEEDED になると、トレーニングは完了です。モデルをデプロイできます。usage:トレーニングに使用された合計トークン数。課金に使用されます。
ステップ 3:ファインチューニング済みモデルのデプロイ
ステップ 3.1 モデルをオンラインサービスとしてデプロイ
ファインチューニングジョブのステータスが SUCCEEDED になった後、モデルをオンラインサービスとしてデプロイします。 リクエスト例 ファインチューニングジョブの作成で取得したfinetuned_output の値で <replace with model name model_name> を完全に置き換えます。
output の中のこれら 2 つのパラメーターを確認してください:
deployed_model:デプロイ済みモデルの名前。デプロイメントステータスの確認とモデルの呼び出しに使用します。status:デプロイメントステータス。ファインチューニング済みモデルをデプロイした後、初期ステータスは PENDING です。デプロイメントはまだ開始されていません。
ステップ 3.2 デプロイメントステータスの確認
status が RUNNING になるまで、このエンドポイントをポーリングします。
deployed_model の値で <replace with deployed_model> を完全に置き換えます。
レスポンス例
output フィールドのこれら 2 つのパラメーターを確認してください:
status:ステータスが RUNNING になると、モデルは正常にデプロイされました。呼び出しを開始できます。deployed_model:デプロイ済みモデルの名前。
ステップ 4:モデルを呼び出して動画を生成
モデルのデプロイが成功した後 (デプロイメントの status が RUNNING の場合)、モデルの呼び出しを開始できます。
ステップ 4.1:動画生成タスクを作成し、task_id を取得する
ステップ 4.1:動画生成タスクを作成し、task_id を取得する
deployed_model の値で <replace with deployed_model name> を置き換えます。- 画像動画生成 (先頭フレームベース)
- 画像動画生成 (先頭・最終フレームベース)
Wan2.7 モデルの呼び出し
Wan2.7 モデルの呼び出し
Wan2.6/Wan2.5/Wan2.2 モデルの呼び出し
Wan2.6/Wan2.5/Wan2.2 モデルの呼び出し
task_id をコピーして保存します。duration) については、API ドキュメントをご参照ください。フィールド | タイプ | 必須 | 説明 | 値の例 |
|---|---|---|---|---|
model | string | はい | モデル名。 正常にデプロイされ、ステータスが RUNNING のファインチューニング済みモデルを使用する必要があります。 | xxxx-ft-202511111122-xxxx |
input.prompt | string | いいえ | テキストプロンプト。 このパラメーターが有効になるかどうかは、aigc_config.use_input_prompt の設定に依存します:
| - |
parameters.resolution | string | いいえ | 生成される動画の解像度。 wan2.2 および wan2.5 モデル:480P、720P。デフォルトは 720P です。 wan2.6 モデル:720P、1080P。デフォルトは 720P です。 wan2.7 モデル:720P、1080P。デフォルトは 1080P です。 | 720P |
parameters.prompt_extend | boolean | いいえ | プロンプトリライトを有効にします。 ファインチューニングされた LoRA モデルを呼び出す際は、これを無効化し、false に設定してください。 | false |
ステップ 4.2:task_id を使用して結果をクエリする
ステップ 4.2:task_id を使用して結果をクエリする
task_id を使用してタスクステータスをポーリングし、task_status が SUCCEEDED になるまで待ちます。その後、動画の URL を取得します。リクエスト例
86ecf553-d340-4e21-xxxxxxxxx を実際の task_id に置き換えてください。
動画 URL は 24 時間有効です。速やかに動画をダウンロードしてください。
カスタムデータセットの構築
このガイドのサンプルデータセットを使用するだけでなく、ファインチューニング用に独自のデータセットを構築することもできます。
データセットにはトレーニングセット (必須) を含める必要があり、検証データセット (任意、トレーニングセットからの自動分割をサポート) を含めることもできます。すべてのファイルを .zip ファイルにパッケージ化します。ファイル名には英字、数字、アンダースコア、ハイフンのみを使用してください。
データセットのフォーマット
トレーニングセット:必須
- 画像動画生成 (先頭フレームベース)
- 画像動画生成 (先頭・最終フレームベース)
- トレーニングセットのサンプル:wan-i2v-training-dataset.zip。
- ZIP ディレクトリ構造:
- アノテーションファイル (data.jsonl):各行が 1 つのトレーニングサンプルです。JSON オブジェクトである必要があります。構造:
検証データセット:任意
- 画像動画生成 (先頭フレームベース)
- 画像動画生成 (先頭・最終フレームベース)
- 検証データセットのサンプル:wan-i2v-valid-dataset.zip。
- ZIP ディレクトリ構造:
- アノテーションファイル (data.jsonl):各行が 1 つの検証サンプルです。JSON オブジェクトである必要があります。構造:
データ規模と制限
- データ量:少なくとも 10 サンプルを提供してください。トレーニングデータが多いほど、より良い結果が得られます。安定したパフォーマンスのためには 20〜100 サンプルを推奨します。
- ZIP アーカイブ:API 経由でアップロードする場合、合計サイズは 1 GB 以下です。
-
トレーニング画像の要件:
- フォーマット:BMP、JPEG、PNG、WEBP。
- 解像度 ≤ 4096×4096。
- 個々のファイルサイズに厳密な制限はありません (システムが自動的に前処理します)。
-
トレーニング動画の要件:
- フォーマット:MP4、MOV。
- 解像度 ≤ 4096×4096。
- 個々のファイルサイズに厳密な制限はありません (システムが自動的に前処理します)。
- 動画ごとの持続時間:wan2.2 モデルでは 2〜5 秒を推奨、wan2.5 モデルでは 2〜10 秒を推奨、wan2.6 および wan2.7 モデルでは 2〜10 秒を推奨。
データ収集とクリーニング
1. ファインチューニングシナリオの定義
Wanxiang は、以下のシナリオで画像動画生成のファインチューニングをサポートします:- 固定の動画エフェクト:カルーセルや魔法の衣装チェンジなど、特定の視覚的変化をモデルに学習させます。
- 固定のキャラクターアクション:ダンスの動きや武術の技など、特定の身体の動きを再現するモデルの能力を向上させます。
- 固定のカメラモーション:プッシュ、プル、パン、チルト、オービットショットなど、複雑な撮影技術を再現します。
2. 生アセットの収集
- AI 生成とフィルタリング:Wanxiang 基盤モデルを使用して動画をバッチ生成します。ターゲットエフェクトに最も一致する高品質なサンプルを手動で選択します。これが最も一般的な方法です。
- 実写撮影:インタラクティブなシーン (例:ハグ、握手) で高いリアリズムが必要な場合は、実際の映像を使用します。
- 3D ソフトウェアレンダリング:精密な制御が必要なエフェクトや抽象的なアニメーションには、3D ソフトウェア (例:Blender、Cinema 4D) を使用します。
3. データのクリーニング
ディメンション | 肯定的要件 | 悪い例 |
|---|---|---|
一貫性 | コアな特徴は非常に均一でなければなりません。 例:「360 度回転」のトレーニングでは、すべての動画がほぼ同じ速度で時計回りに回転する必要があります。 | 方向が混在している。 データセットに時計回りと反時計回りの両方の回転が含まれている。モデルはどちらの方向を学習すべきか分かりません。 |
多様性 | 被写体やシーンの多様性が高いほど良い。 さまざまな被写体 (男性、女性、子供、動物、建物) や構図 (クローズアップ、ワイドショット、ハイアングル、ローアングル) をカバーします。解像度やアスペクト比も多様化させます。 | 単一のシーンや被写体。 すべての動画が「白い壁の前で回転する赤い服の人」を示している。モデルは「赤い服」と「白い壁」をエフェクトの一部として誤って扱う可能性があります。服が変わると失敗します。 |
バランス | データタイプはバランスが取れているべきです。 複数のスタイルが存在する場合、それらの数はほぼ等しくあるべきです。 | 深刻な不均衡。 90% が縦長の動画で、10% が横長の動画。モデルは横長の動画でパフォーマンスが低下する可能性があります。 |
純粋さ | クリーンでクリアなビジュアル。 干渉のないオリジナルアセットを使用します。 | 干渉要素。 動画に字幕、ロゴ、ウォーターマーク、明らかな黒枠、またはノイズが含まれている。モデルはウォーターマークをエフェクトの一部として学習する可能性があります。 |
持続時間 | アセットの持続時間 ≤ ターゲットの持続時間。 5 秒の動画が必要な場合、アセットを 4〜5 秒にトリミングします。 | 長すぎるアセット。 5 秒の動画が必要なのに、モデルに 8 秒のアセットを与える。これにより、アクションの学習が不完全になり、途切れ途切れの感じになります。 |
動画アノテーション:動画のプロンプト作成
データセットのアノテーションファイル (data.jsonl) では、各動画に対応するプロンプトがあります。プロンプトは動画の内容を記述します。プロンプトの品質は、モデルが何を学習するかを直接決定します。
| プロンプト例動画は、ツタで覆われたレンガの壁の前に立つ若い女性から始まります。彼女は長く滑らかな赤褐色の髪で、白いノースリーブのドレスを着て、光沢のある銀のネックレスをつけ、笑顔を浮かべています。背景は緑のツタで覆われたレンガの壁で、素朴で自然な雰囲気です。そして、s86b5p のマネーレインエフェクトが始まり、巨大な米ドル紙幣 (ベージュの背景/濃い緑の模様) が豪雨のように降り注ぎ、彼女を密集して打ちつけ、取り囲みます。紙幣は降り続け、彼女は腕を上に伸ばし、首を少し後ろに傾け、驚いた表情で、この激しいマネーレインに完全に没頭しています。 |
プロンプト作成の公式
プロンプト = [被写体の説明] + [背景の説明] + [トリガーワード] + [動きの説明]
プロンプト要素 | 説明 | ガイダンス | 例 |
|---|---|---|---|
主題の説明 | フレーム内に存在する人物やオブジェクトを説明する | 必須 | 動画は若い女性から始まります... |
背景の説明 | 被写体がいる環境を説明する | 必須 | 背景は緑のツタで覆われたレンガの壁です... |
トリガーワード | 珍しく、意味のない単語 | 推奨 | s86b5p または m01aa |
動きの説明 | エフェクト中の動的な変化を詳細に説明する | 推奨 | 巨大な米ドル紙幣 (ベージュの背景/濃い緑の模様) が豪雨のように降り注ぎ... |
トリガーワードについて
トリガーワードについて
- トリガーワードとは? 「視覚的なアンカー」として機能します。多くの複雑な動き (例:ユニークなダンスの軌跡や光のエフェクト) はテキストで説明するのが困難です。トリガーワードは、モデルがその単語を見たときに、その正確な視覚効果を生成するように強制します。
- なぜ使用するのか? ファインチューニングは、テキストと動画の特徴のマッピングを構築します。トリガーワードは、説明が難しいエフェクトをユニークな単語に結びつけ、モデルがターゲットにロックオンできるようにします。
-
トリガーワードがあるのに、なぜ動きを詳細に説明するのか?
それぞれ異なる役割を果たし、一緒に使うことでより効果的になります。
- 動きの説明は、シーンで何が起こるかを説明します。基本的な物理的なアクションとロジックをモデルに伝えます。動きの説明は通常、サンプル間で一貫しています。
- トリガーワードは、アクションが具体的にどのように見えるかを説明します。言葉では説明できないユニークな変化や特徴を表します。
良いプロンプトの書き方
エフェクト説明の一貫性ルールに従う
同じエフェクトを含むすべてのサンプルについて、動きの説明部分をできるだけ一貫させるようにしてください。このルールはトレーニングセットと検証セットの両方に適用します。-
目的:モデルが
s86b5pの後に同じ固定された説明を見て、常にマネーレインが表示されると、s86b5p = マネーレインの視覚効果であると学習します。 -
例:被写体が「若い女性」であれ「スーツの男性」であれ、マネーレインエフェクトのプロンプトは同じように終わります:「...そして s86b5p のマネーレインエフェクトが始まり、無数の米ドル紙幣が豪雨のように降り注ぎ...」
サンプルの種類
プロンプトの内容 (下線部分の一貫性に注意)
トレーニングサンプル 1
動画はレンガの壁の前に立つ若い女性から始まります... (環境説明は省略)...
そして s86b5p のマネーレインエフェクトが始まり、巨大な米ドル紙幣 (ベージュの背景/濃い緑の模様) が豪雨のように降り注ぎ、彼女を密集して打ちつけ、取り囲みます。紙幣は降り続け、彼女は腕を上に伸ばし、首を少し後ろに傾け、驚いた表情で、この激しいマネーレインに完全に没頭しています。トレーニングサンプル 2
動画は高級レストランにいるスーツの男性から始まります... (環境説明は省略)...
そして s86b5p のマネーレインエフェクトが始まり、巨大な米ドル紙幣 (ベージュの背景/濃い緑の模様) が豪雨のように降り注ぎ、彼を密集して打ちつけ、取り囲みます。紙幣は降り続け、彼は腕を上に伸ばし、首を少し後ろに傾け、驚いた表情で、この激しいマネーレインに完全に没頭しています。検証サンプル 1
動画は街並みの前に立つ幼い子供から始まります... (環境説明は省略)...
そして s86b5p のマネーレインエフェクトが始まり、巨大な米ドル紙幣 (ベージュの背景/濃い緑の模様) が豪雨のように降り注ぎ、彼を密集して打ちつけ、取り囲みます。紙幣は降り続け、カメラがゆっくりとズームインする間、彼は腕を上に伸ばし、首を少し後ろに傾け、驚いた表情で、この激しいマネーレインに完全に没頭しています。
AI を使用してプロンプトを生成する
高品質なプロンプトを得るために、Qwen-VL などのマルチモーダル大規模言語モデルを使用して支援を受けることができます。-
AI を使用して初期の説明を生成する
-
自由形式のブレインストーミング (インスピレーションを見つける):エフェクトをどのように説明すればよいかわからない場合は、AI に自由に探求させます。
- 「
動画の内容を詳細に説明してください」と送信し、モデルの出力を観察します。 - モデルが動きの軌跡に使用する用語 (例:「豪雨のように降り注ぐ」、「カメラがゆっくりとズームインする」) に注目します。これらの用語は後の最適化に使用できます。
- 「
-
固定形式のプロンプト (出力を標準化する):大まかなアイデアが固まったら、固定形式を設計して、AI がテンプレートに一致するプロンプトを生成するように誘導します。
コード例
API 呼び出しの詳細については、「視覚理解」をご参照ください。
-
自由形式のブレインストーミング (インスピレーションを見つける):エフェクトをどのように説明すればよいかわからない場合は、AI に自由に探求させます。
-
エフェクトテンプレートの抽出
- 同じエフェクトを持つサンプルでこのプロセスを複数回実行します。エフェクトを説明するために使用される高頻度で正確なフレーズを特定します。一般的な「エフェクト説明」を抽出します。
- この標準化されたエフェクト説明を、そのエフェクトのすべてのサンプルにコピー&ペーストします。
- 各サンプルのユニークな「被写体」と「背景」の説明は保持します。「エフェクト説明」部分のみを統一されたテンプレートに置き換えます。
- 手動レビュー AI はハルシネーションを起こしたり、検出エラーを犯したりする可能性があります。最終ステップとして、手動でチェックを行います。例えば、エンティティと背景の説明が実際のシーンと一致しているかを確認します。
検証データセットを使用したモデルの評価
検証データセットの指定
ファインチューニングジョブにはトレーニングセットが必要です。検証データセットは任意です。システムに自動分割させるか、手動でアップロードするかを選択できます。以下のように指定します:
方法 1:検証データセットをアップロードしない (システムが自動分割)
ファインチューニングジョブを作成する際に、別の検証データセットをアップロードしない場合、つまりvalidation_file_ids パラメーターが渡されない場合、システムは以下の 2 つのハイパーパラメーターに基づいてトレーニングセットの一部を自動的に分割して検証セットとして使用します:
split:分割するトレーニングデータの割合。例えば、0.9 は 90% をトレーニング用、10% を検証用とすることを意味します。max_split_val_dataset_sample:自動分割される検証セットの最大サンプル数。
データセットサイズ × (1 - split) と max_split_val_dataset_sample の小さい方の値を選択します。
-
例:100 サンプルのトレーニングセットのみをアップロードし、split=0.9 (10% が検証用)、max_split_val_dataset_sample=5 とします。
- 理論上の分割:100 × 10% = 10 サンプル。
- 実際の分割:min(10, 5)=5。したがって、システムは検証セットにわずか 5 サンプルしか使用しません。
方法 2:検証データセットを手動でアップロードする (validation_file_ids を使用)
ランダムなシステム分割に頼るのではなく、独自に準備したデータでチェックポイントを評価したい場合は、カスタム検証データセットをアップロードします。 注意:手動アップロードを選択すると、システムは上記の自動分割ルールを無視し、アップロードしたデータのみで検証します。ステップ:検証データセットを手動でアップロードする
ステップ:検証データセットを手動でアップロードする
- 検証データセットの準備:検証データをスタンドアロンの
.zipファイルにパッケージ化します。検証データセットのフォーマットをご参照ください。 - 検証データセットのアップロード:データセットのアップロード API を呼び出して、この
.zipファイルをアップロードします。専用のファイル ID を取得します。 - ジョブ作成時に検証データセットを指定:ファインチューニングジョブの作成 API を呼び出す際に、このファイル ID を
validation_file_idsパラメーターに入力します。
デプロイメントに最適なチェックポイントの選択
トレーニング中、システムは定期的に「スナップショット」(チェックポイント) を保存します。デフォルトでは、システムは最終チェックポイントをファインチューニング済みモデルとして出力します。しかし、中間チェックポイントが最終バージョンを上回ることもあります。デプロイメントに最適なものを選択できます。
システムは、ハイパーパラメーター eval_epochs で定義された間隔で、検証セット上でチェックポイントを実行し、プレビュー動画を生成します。
- 評価:プレビュー動画を直接見て判断します。
- 選択基準:最高の視覚品質で、動きの歪みがないチェックポイントを選択します。
手順
ステップ 1:チェックポイントのプレビュー結果の表示
ステップ 1:チェックポイントのプレビュー結果の表示
ステップ 1.1 検証済みチェックポイントのリスト表示
この API は、検証に合格し、プレビュー動画の生成に成功したチェックポイントのみを返します。失敗したチェックポイントはリストされません。リクエスト例<replace_with_fine-tuning_job_id>:ファインチューニングジョブの作成 API からのjob_idで完全に置き換えます。
ステップ 1.2 チェックポイントの検証結果の表示
上記のリストから 1 つのチェックポイント (例:「checkpoint-160」) を選択し、その動画結果を表示します。リクエスト例<replace_with_fine-tuning_job_id>:ファインチューニングジョブの作成からのjob_idで完全に置き換えます。<replace_with_selected_checkpoint>:チェックポイントの値 (例:「checkpoint-160」) で完全に置き換えます。
video_path です。24 時間有効です。速やかにダウンロードして確認してください。このステップを繰り返して複数のチェックポイントを比較し、最適なものを見つけます。ステップ 2:チェックポイントをエクスポートし、デプロイ用のモデル名を取得する
ステップ 2:チェックポイントをエクスポートし、デプロイ用のモデル名を取得する
ステップ 2.1 モデルのエクスポート
「checkpoint-160」が最良の結果をもたらすと仮定します。これをエクスポートします。リクエスト例<replace_with_fine_tuning_job_id>:ファインチューニングジョブの作成からのjob_idで完全に置き換えます。<replace_with_checkpoint_to_export>:チェックポイントの値 (例:「checkpoint-160」) で完全に置き換えます。<replace_with_exported_model_name_for_console_display>:コンソール表示用のカスタムモデル名 (例:「wan2.5-checkpoint-160」) で完全に置き換えます。この名前はグローバルに一意である必要があります。重複した名前は許可されません。パラメーターのガイダンスについては、チェックポイントのエクスポートをご参照ください。
output=true は、エクスポートリクエストが正常に作成されたことを意味します。ステップ 2.2 デプロイ後の新しいモデル名のクエリ
すべてのチェックポイントのステータスをクエリして、エクスポートの完了を確認し、デプロイ用の一意のモデル名 (model_name) を取得します。リクエスト例<replace_with_fine-tuning_job_id>:ファインチューニングジョブの作成からのjob_idで完全に置き換えます。
status が SUCCEEDED になると、エクスポートは成功です。model_name フィールドが、デプロイメントと呼び出し用の新しいモデル名です。ステップ 3:モデルのデプロイと呼び出し
ステップ 3:モデルのデプロイと呼び出し
model_name を取得した後、以下のステップに従います:- モデルのデプロイメント:入力パラメーター
model_nameに、エクスポート後に取得した特定の値を入力します。 - モデルの呼び出し:API ドキュメントに従って、デプロイされたモデルを呼び出します。
本番運用
本番環境で、最初にトレーニングしたモデルのパフォーマンスが低い場合 (例:視覚的な歪み、弱いエフェクト、不正確な動き)、以下のディメンションに沿って調整します:
1. データとプロンプトの確認
- データの一貫性:一貫性は非常に重要です。逆方向や大きく異なるスタイルの「不良サンプル」がないか確認してください。
- サンプル数:高品質なデータを 20 サンプル以上に増やしてください。
- プロンプト:トリガーワードが意味のない、珍しい用語 (例:s86b5p) であることを確認してください。干渉を引き起こす一般的な単語 (例:running) は避けてください。
-
n_epochs (トレーニングエポック)
- デフォルト:50。必要な場合以外はデフォルトを使用してください。調整する場合は、「合計トレーニングステップ数 ≥ 800」のルールに従ってください。
-
合計ステップ数の数式:
steps = n_epochs × ceiling (トレーニングセットサイズ / バッチサイズ)。 -
n_epochs の最小値の数式:
n_epochs = 800 / ceiling (データセットサイズ / バッチサイズ)。 -
例:5 サンプルのトレーニングセットがあり、Wan2.5 モデル (batch_size=4) を使用するとします。
- エポックあたりのステップ数:5 / 4 = 1.25、切り上げて 2。合計エポック数:n_epochs = 800 / 2 = 400。これが推奨される最小値です。必要に応じて増やすことができます。
-
batch_size (バッチサイズ)
- バッチサイズ。一度にトレーニングのためにモデルに送信されるデータサンプルの数。
- このパラメーターはインスタンスごとの設定です。各モデルのデフォルト値を使用することを推奨します。必要な場合以外は調整しないでください。
- wan2.7-i2v:推奨値:1。
- wan2.5-i2v-preview:推奨値:4。
- wan2.2-i2v-flash:推奨値:4。
- wan2.2-kf2v-flash:推奨値:4。
トレーニングジョブで実行される実際のインスタンス数は、プラットフォームのスケジューリングによって決定されます。トレーニングログの Global Step 出力は推定結果と異なる場合がありますが、これはトレーニングデータの総量や最終的なモデルのパフォーマンスには影響しません。
- learning_rate (学習率):デフォルト値 (2e-5) を使用してください。通常、変更は不要です。
課金
-
モデルトレーニング:課金対象。
- コスト = 合計トレーニングトークン数 × 単価。モデルトレーニングの課金をご参照ください。
- トレーニング後、ファインチューニングジョブのステータスをクエリする API の
usageフィールドで消費された合計トークン数を確認してください。
- モデルデプロイメント:無料。
-
モデルの呼び出し:課金対象。
- ファインチューニングされた基盤モデルの標準呼び出し価格に従って課金されます。モデルの価格設定をご参照ください。
API リファレンス
動画および画像生成モデルのファインチューニング API
よくある質問
Q:トレーニングセットと検証セットのデータ量はどのように計算されますか?
A:トレーニングセットは必須で、検証セットは任意です。計算方法は以下の通りです:
-
検証セットが提供されていない場合:アップロードされたトレーニングセットが「合計データセットサイズ」となります。システムは自動的にデータの一部を検証用に分割します。
- 検証セットサイズ =
min(合計データセットサイズ × (1 − split), max_split_val_dataset_sample)。例については、検証データセットの指定をご参照ください。 - トレーニングセットサイズ =
合計データセットサイズ − 検証セットサイズ。
- 検証セットサイズ =
-
検証セットが手動でアップロードされた場合:システムはトレーニングデータから検証セットを分割しなくなります。
- トレーニングセットサイズ = アップロードされたトレーニングセットのデータ量。
- 検証セットサイズ = アップロードされた検証セットのデータ量。
Q:良いトリガーワードを設計するにはどうすればよいですか?
A:以下のルールに従ってください:
- 意味のない文字の組み合わせを使用します。例:sksstyle、a8z2_bbb。
- 一般的な英単語 (例:beautiful、fire、dance) は避けてください。これにより、モデルがこれらの単語に対して元々持っている理解を汚染するのを防ぎます。