

Model Studio API は、リクエスト量、トークン使用量、および増加率を制限します。これらの戦略を適用して、スループットを最大化し、可用性を維持します。
- プラットフォーム設定ソリューション (コード変更は最小限):サーバーサイドキューイング、PTU、および Batch API。
- クライアントサイドのトラフィック制御戦略 (クライアントコードの変更):基本的なリトライから適応型輻輳制御まで、エンジニアリングの複雑さが増す 4 つの戦略。
- アーキテクチャレベルのフォールバックソリューション (システムアーキテクチャーの変更):モデルフォールバックおよびメッセージキュー (MQ) を使用したピークシフト。
429 エラーのトラブルシューティングを行っている場合は、「エラー診断と戦略の推奨」に進み、原因を特定してください。トラフィックバーストエラーの場合は、まずサーバーサイドキューイングを試してください。これはリクエストヘッダーを 1 つ追加するだけで済みます。
プラットフォームのレート制限メカニズム
プラットフォームは、ルートアカウントレベルで各モデルを個別にレート制限します。トリガー後、サービスは通常 1 分以内に再開します。レート制限の条件とモデルごとの現在の使用量については、「レート制限」および「モデルのモニタリング」をご参照ください。3 種類のレート制限ルールが適用されます:
- 分単位のクォータ制限 (RPM / TPM):1 分あたりの最大リクエスト数 (RPM) と 1 分あたりの最大トークン使用量 (TPM)。
- 瞬間的な頻度制限 (RPS / TPS):1 秒あたりの最大リクエスト数 (RPS) と 1 秒あたりの最大トークン使用量 (TPS)。1 秒以内に API 呼び出しやトークン消費が集中すると、レート制限がトリガーされる可能性があります。
- 増加率制限 (トラフィックバースト):リクエスト量やトークン使用量が急増すると、レート制限がトリガーされます。しきい値は動的に調整されます。この制限をトリガーしないように、リクエストを徐々に増やしてください。
エラー診断と戦略の推奨
同じエラーコードが、異なるレート制限ディメンションによってトリガーされることがあります。高い同時実行性もサーバーを飽和させ、タイムアウトを引き起こす可能性があります。適応型輻輳制御戦略は、この緩和に役立ちます。
エラーコード (DashScope / OpenAI) | トリガーディメンション | 特徴診断 | 推奨戦略 |
|---|---|---|---|
Throttling.RateQuota / limit_requests | リクエストレート超過 | 断続的なエラー。成功率は時間とともに低下します。 | トークンバケット:単位時間あたりのリクエストクォータを制御します。 |
リクエストレート超過 | 起動時や同時実行の急増時にエラーが集中します。 | 同時実行セマフォまたは平滑化レートリミッター:リクエスト間の間隔を広げます。 | |
Throttling.AllocationQuota / insufficient_quota | トークン使用量超過 | 長文テキスト処理時に断続的なエラーが発生します。 | デュアルトークンバケット:RPM と TPM の両方のクォータを同時に制限します。 |
トークン使用量超過 | 長文テキストの並行処理中に瞬間的なトークン消費量が高すぎます。 | ||
Throttling.BurstRate / limit_burst_rate | トラフィック増加率超過 | 起動後またはアイドル状態からの復帰後に、突然大量のリクエストが発生します。 | まずサーバーサイドキューイングを試すことを推奨します。あるいは、 |
プラットフォーム設定ソリューション
これらのソリューションはプラットフォームの機能に依存しており、クライアントサイドのコード変更は最小限または不要です。
サーバーサイドキューイング (推奨)
トラフィックバーストのレート制限に対して、Model Studio はリクエストヘッダーで待機時間の上限を指定できます。サーバーはリクエストを受信すると、その時間枠内で随時リトライし、処理が開始されるか時間枠内のリトライが終了するまで続けます。この値は上限であり、設定値に達してからリトライするわけではありません。これにより、即座に 429 応答を返す場合と比較して、トラフィックバースト中の成功率が大幅に向上します。
X-DashScope-Wait-Timeout フィールドを追加します:
ヘッダーフィールド | 例 | 説明 |
|---|---|---|
X-DashScope-Wait-Timeout | 90 | バーストリクエストのキューイング待機時間の上限 (秒単位)。サーバーはこの時間枠内でリトライし、設定値に達してからリトライするわけではありません。
|
- 非ストリーミングリクエスト (stream: false):タイムアウト = 元の基本タイムアウト + Wait-Timeout の値。
- ストリーミングリクエスト (stream: true):タイムアウト > Wait-Timeout の値。ストリーミングリクエストは最初のチャンクの後にタイミングを開始するため、最初の応答タイムアウトはキューイング時間を超えるだけで十分です。
コード例
コード例
プロビジョンドスループットユニット (PTU)
PTU サービスは、専用の予約済みコンピューティング能力を提供します。パブリックリソースプールでの競合を回避し、リアルタイムで高スループットの要件に最適なソリューションです。
ビジネスに確定的なスループット要件 (SLA コミットメントなど) がある場合、またはクライアントサイドのトラフィック制御なしで安定した高スループットが必要な場合は、PTU を使用してください。
PTU は予約済みリソースであり、完全に使用されていない場合でも継続的に課金されます。無駄を避けるために、実際のピーク負荷に基づいて必要な仕様を評価してください。
非同期バッチ処理 (Batch API)
厳密なリアルタイム要件がないタスク (データクレンジング、バッチ分析など) には、Batch API を使用してバッチ処理に送信します。タスクはオフピーク時間に実行され、結果を非同期で返し、オンラインのレート制限の対象にはなりません。
数時間から数日の応答時間を許容できるオフラインタスクに適しています:データアノテーション、ログ分析、バッチ要約など。Batch API のコストは、通常、リアルタイム API 呼び出しよりも低くなります。
応答時間は保証されません。即時応答が必要なサービスには適していません。送信後、ポーリングまたはコールバックを介して結果を取得します。
クライアントサイドのトラフィック制御戦略
サーバーサイドキューイングなどのプラットフォームソリューションでは不十分な場合、クライアントサイドにトラフィック制御を追加します。基本原則は、バーストを避けるためにリクエストをタイムウィンドウ内で均等に分散させることです。システムの起動後や長時間のアイドル期間の後には、同時実行数を徐々に増やしてください。
複雑さが増す順に 4 つの戦略があります。各戦略は前の戦略を含み、さらに機能を追加します:
- 基本的なリトライは、受動的な防御のみを提供します。
- リクエストレート制限は、アクティブなキューイングを追加します。
- トラフィックシェーピングは、さらにトークンレベルの制御とスムーズな送信を導入します。
- 適応型輻輳制御は、リアルタイムのフィードバックに基づいて送信レートを動的に調整します。
各戦略のスループット性能比較
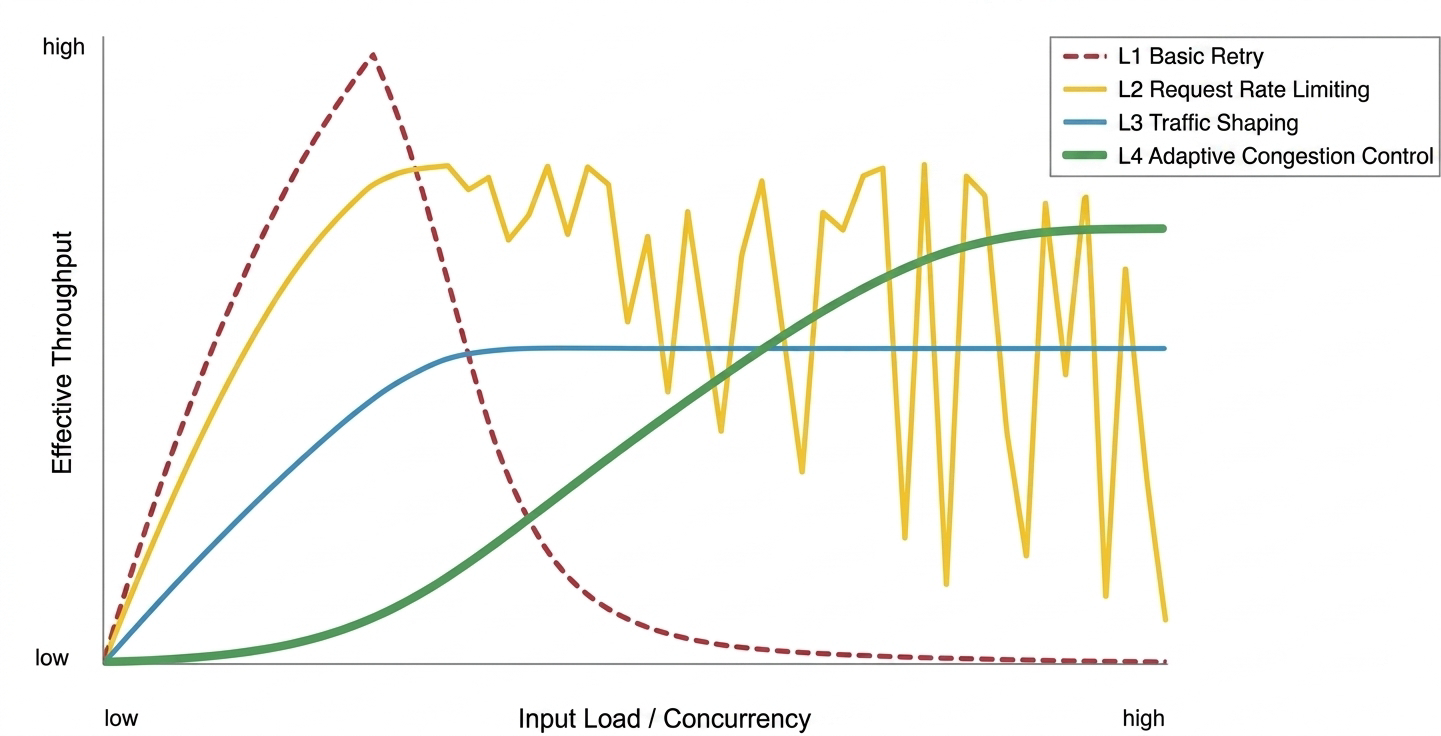
- 基本的なリトライ戦略:低負荷下では効果的です。高い同時実行性の下では輻輳崩壊を起こしやすく、スループットが急激に低下します。
- リクエストレート制限戦略:輻輳崩壊に対する強力な保護を提供します。ただし、長文テキストを含む混合ワークロード下では、トークン制御がないため、スループットはのこぎり状の変動を示します。
- トラフィックシェーピング戦略:高い安定性。ピークスループットを一部犠牲にすることで、スムーズな出力を実現します。
- 適応型輻輳制御戦略:高負荷下で安定した高スループットポイントに動的に収束できますが、コールドスタート時のプロービングオーバーヘッドがあります。
基本的なリトライ戦略
個人テスト、ローカルスクリプト、および低頻度のバックグラウンドタスクに適しています。送信リクエストにレート制限はありません。429 または 5xx エラーが発生した場合にのみ、ランダムジッター付きの指数バックオフリトライをトリガーします。
積極的なトラフィック制御はありません。マルチスレッドの同時実行下では、これによりレート制限が容易にトリガーされ、リクエストのバックアップが発生します。
コード例
コード例
- 待機時間が段階的に倍増:例えば、
1s, 2s, 4s...。これにより、短期間での繰り返しリクエストを回避します。 - ランダムジッターを追加:ランダムな値 (例:
2s +/- 0.5s) を加えることで、リトライのトラフィックを分散させ、二次的なフラッディング (サンダーリングハード効果) を防ぎます。
リクエストレート制限戦略
受動的なリトライだけでは、実際のトラフィックを処理できません。頻繁なリトライはレイテンシーを増加させます。この戦略はアクティブなトラフィック制御を導入します:リクエストを送信する前にチェックしてスロットルし、順序のないトラフィックを RPM 制限を尊重するキューに整理します。アクティブな平滑化は、予測可能な小さなキューイング遅延を追加しますが、これは「エラー — 待機 — リトライ」ループのコストよりもはるかに小さいです。小さな既知のコストは、大きな未知のコストに勝ります。
チャットボットや、最初のトークンまでの時間が重要な他の軽量なリクエスト・レスポンスサービスに適しています。
クライアントサイドのアクティブなキューイングは、2 段階の制御を使用します:
- RPM トークンバケット:1 分あたりの総リクエスト数を制限します。バケットの容量は RPM クォータに等しく、トークンは一定のレートで補充されます。借用をサポート:トークンが不十分な場合、リクエストは将来のクォータから借用し、厳密に FIFO を守ります。
- 同時実行セマフォ:同時リクエストを制限し、瞬間的な高い同時実行性が RPS 制限をトリガーするのを防ぎます。
initial_tokens=rpm_limit) で初期化します。これは、起動時にすぐにリクエストを処理する必要があるオンラインサービスに適しています。フルのバケットがレート制限をトリガーする場合は、初期値を下げて (例えば、「空のバケットで開始」するために initial_tokens=0)、より緩やかに立ち上げてください。
この戦略はトークン使用量を追跡しません。長文テキストのタスクは、依然として TPM クォータを使い果たす可能性があります。
コード例
コード例
トラフィックシェーピング戦略
高く安定したスループットを必要とするバッチシナリオ (リアルタイム RAG インジェスト、バルク長文ドキュメント分析など) では、リクエストレート制限には TPM の死角があります。トラフィックシェーピングは、デュアルリソース認識 (RPM & TPM) と、バースト的なトラフィックをスムーズなフローに変換するシェーピングメカニズムを追加します。
リクエストレート制限に対する機能強化:
- デュアルリソース制御 (RPM & TPM):RPM と TPM の両方のトークンバケットを維持します。すべてのリクエストは、送信される前に両方のディメンションのクォータチェックを通過する必要があります。
- 入力時の事前控除、出力後の精算:出力長はリクエスト前に不明です。TPM バケットは、送信時に入力トークンを事前控除し、完了後に実際の出力トークンを精算します。トークンがマイナスになっても、後続のリクエストはカウントがプラスになるのを待つため、自然にフローが平滑化されます。
- 継続的なウォームアップ:コールドスタート中、トークン発行レートは時間とともに線形に増加し、初期バーストのリスクを排除します。
- 平滑化レートリミッター (ペーシング):リクエスト間の最小間隔を強制する (ペーシング) ことで送信レートを平滑化し、レート制限がトリガーされるリスクを低減します。
initial_tokens=0 に設定)、より低い複雑さで安全なスタートを実現します。ここでの Python トークンバケットはデモンストレーション用です。本番環境では、Java の Guava の SmoothRateLimiter のような成熟したレート制限ライブラリを使用してください。
コード例では、平滑化の待機は同時実行ロックの内側に配置されています。待機が終了した後、複数のリクエストが同時にセマフォを競合し、出口でトラフィックが再び束になる可能性があります。ロック内での平滑化は、同時実行効率をわずかに低下させますが、正確な送信間隔を保証します。
完全なトラフィックシェーピングパイプラインは次のとおりです:入力トークンの推定 → デュアルアドミッション (RPM & TPM) → 同時実行ロック → トラフィックシェーピング → 送信 → 出力トークンの精算。
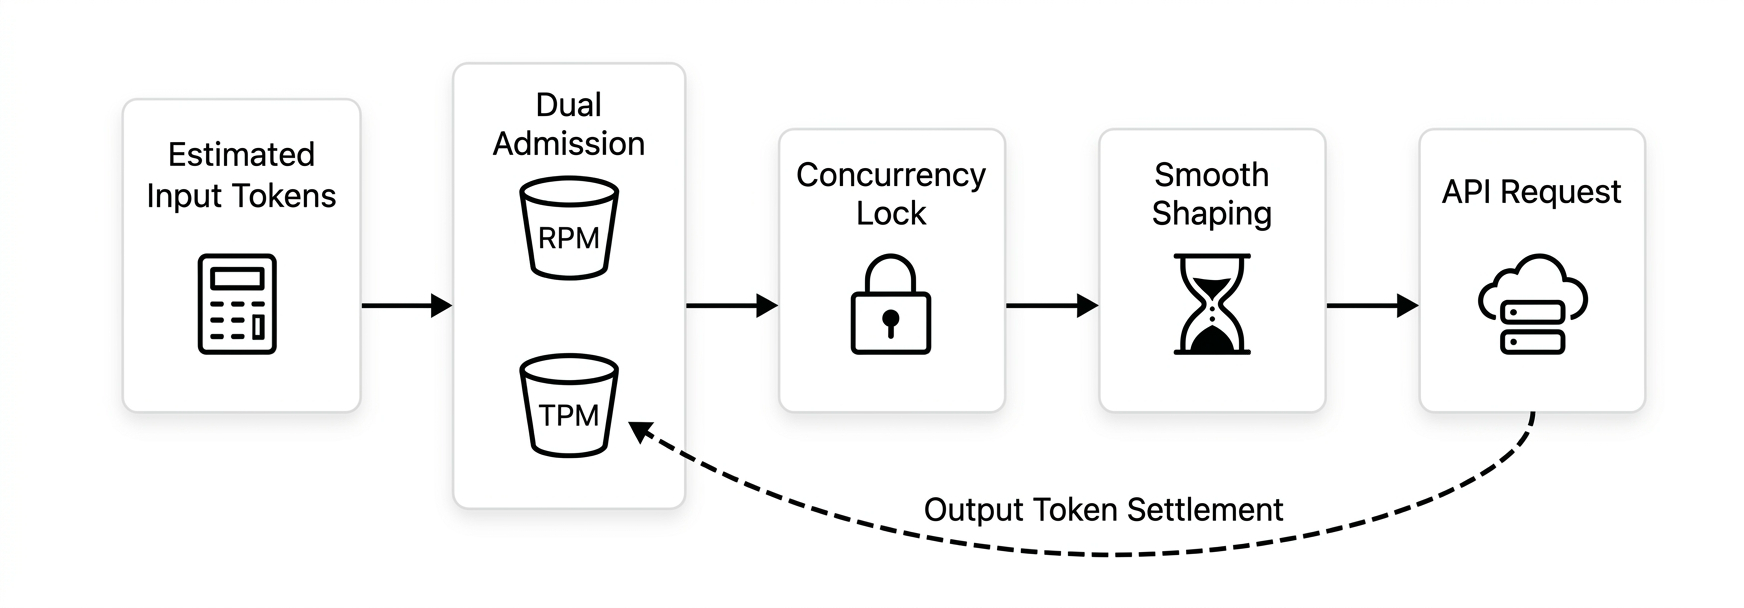
コード例
コード例
適応型輻輳制御戦略
大規模で動的なワークロードに適しています:API ゲートウェイ、複雑なプロキシ、マルチテナントシステムなど。
- パフォーマンスのパラドックス:負荷が予測可能である場合 (バッチ処理など)、最適な静的パラメーターは、「試行と収束」を必要とする動的プロービングよりも優れたパフォーマンスを発揮します。
- プロービングのオーバーヘッド:動的アルゴリズムには、必然的にコールドスタートのランプアップと探索的な変動が伴います。これは、既知のシナリオでは不要なオーバーヘッドです。
- メンテナンスコスト:閉ループフィードバックは、システムの複雑さとトラブルシューティングの難易度を増大させます。
- EBP:過去の最高の成功ウォーターマークを保存します。現在の同時実行数とウォーターマークとの距離に基づいてバネの張力をシミュレートすることで、プロービングゲインを計算します (遠いほど速く、近いほど遅く)。高い飽和状態でも探索を続けるために、小さな線形推力を追加します。
- TPT 輻輳認識:LLM の生成時間は出力長に比例します。長文テキストでの高レイテンシーは輻輳を意味しません。TPT (トークンあたりの時間) は、コンテンツ長のノイズを除去します。輻輳は、TPT が著しく悪化した場合にのみ宣言されます。
- バースト防止レートガバナー:EBP のターゲットに関係なく、ガバナーは同時実行数の増加加速度を制限し、スムーズなランプアップを保証し、増加率制限をトリガーするステップ変更を回避します。
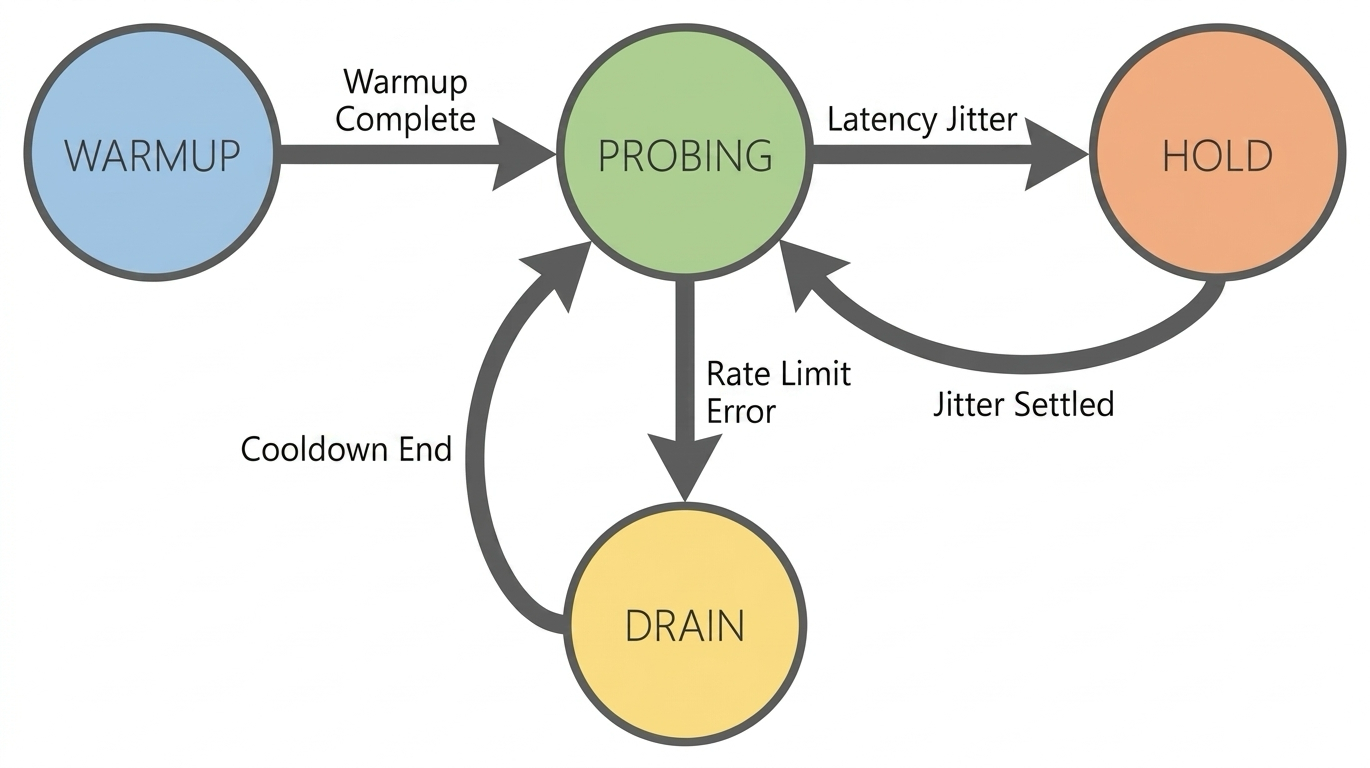
- ガイド付きプロービング:既知の RPM/TPM クォータを「ガイド的な上限」として導入し、盲目的なプロービングによる頻繁な衝突を回避します。
- シグナルソース (RTT → TPT):ネイティブ BBR は RTT を使用します。LLM シナリオでは、コンテンツ長のレイテンシーがネットワークジッターをはるかに上回ります。TPT はその干渉を排除します。
- 応答メカニズムの強化 (ProbeRTT → Hold):レイテンシーの変動に直面した場合、積極的にバックオフしてスループットを低下させるのではなく、現在の同時実行数レベルを維持することを選択します。
- ハードレート制限応答 (Packet Loss → 429 Drain):
429エラーがトリガーされると、即座にアグレッシブな Drain 状態に入り、クールダウン期間後に高速回復を実行します。
- TPT ノイズ:TPT は「合計レイテンシー / 合計トークン」として推定されます。合計レイテンシーには、ネットワークのラウンドトリップ、キューイング、最初のトークンまでの時間が含まれ、ジッターや長い入力の影響を受けやすく、誤って Hold 状態をトリガーする可能性があります。
- 大規模リクエストのスターベーション:スケジューリングパフォーマンスのために、非厳密な FIFO ウェイクアップを使用します。クォータが不足している場合、短いトークンのリクエストがリソースを先取りし、長いトークンのリクエストが長時間待たされる可能性があります。
- コールドスタート:統計モデルを構築するためにウォームアップ期間が必要です。低負荷または短命のタスクでは、スループットが最初の 3 つの戦略よりも低くなる可能性があります。
コード例
コード例
アーキテクチャレベルのフォールバックソリューション
プラットフォーム設定とクライアントサイドのトラフィック制御が、可用性やピークスループットの要件をまだ満たせない場合、アーキテクチャレベルでフォールバックメカニズムを追加します。
モデルフォールバック
プライマリモデルがレート制限やサービスの問題で応答できない場合、より寛大なクォータを持つ代替モデルに自動的にフォールバックします。
フォールバックパスの設計原則
- 異なるシリーズのモデルを選択:レート制限はモデルごとです。フォールバックには異なるモデルを使用します。例えば、
qwen3.6-plusからqwen3.6-flashにフォールバックします。 - レート制限エラーでのみフォールバックをトリガー:すべての例外ではなく、
429エラーでフォールバックします。モデルを切り替えても、ネットワークタイムアウトやパラメーターエラーは解決しません。 - フォールバックモデルを事前に検証:フォールバック後に機能的な問題が発生しないように、必要な機能 (Function Calling、構造化出力など) をサポートしていることを確認します。
コード例
コード例
メッセージキュー (MQ) を使用したピークシフト
即時応答を必要としないバックエンドサービスには、ピークシフトのためにメッセージミドルウェア (RabbitMQ, Kafka) を導入します。バーストトラフィックはまず MQ に入り、コンシューマーはレート制限クォータに合わせて一定のレートでプルして処理します。これにより、フロントエンドのピークとバックエンドの呼び出しが分離されます。
ユーザーが非同期の結果を受け入れるビジネスに適しています:チケット処理、コンテンツモデレーション、バッチデータアノテーションなど。
主要な設計ポイント:
- コンシューマーのレート制御:コンシューマー側は、メッセージを無制限にプルするのではなく、RPM/TPM クォータに基づいて一定のレートでメッセージを消費するために、リクエストレート制限またはトラフィックシェーピング戦略を使用する必要があります。
- デッドレター処理:複数回のリトライ後に失敗したメッセージをデッドレターキューに移動し、アラートをトリガーします。無限リトライが消費をブロックするのを防ぎます。
- バックプレッシャーの伝播:MQ のバックログがしきい値を超えた場合、上流にプレッシャーを伝播させ (例えば、キューイングステータスを返す)、キューの無限の増加を防ぎます。
本番環境での考慮事項
コード例では、コアアルゴリズムを実証するために Python の asyncio シングルスレッドループを使用しています。大規模な本番環境で使用する前に、以下を考慮してください。
-
非テキストモデルへの適応
上記の戦略はテキストモデルを例として使用していますが、コア原則はマルチモーダルサービス (画像生成、音声合成) にも適用されます。単位は異なりますが、本質は同じです:送信レートと処理能力の制限。
- 音声認識などのモデルは、通常、単位時間あたりのリクエスト数 (RPM など) と使用量 (音声の長さなど) の両方で制約されます。戦略は基本的にテキストモデルと同じです。
- 画像やビデオのモデルは、通常、タスクの送信レートと同時タスク数によって制約されます。リクエストレート制限戦略と同じアプローチを使用できます:タスクの送信レートを制限し、セマフォを使用して同時実行数を制御します。
-
並行モデルにおける原子性
例:
asyncioはシングルスレッドの協調スケジューリングを使用するため、状態の変更は単一プロセス内で本質的にアトミックです。 本番環境:マルチスレッドまたはマルチプロセス環境では、トークンバケットと統計ウィンドウの同時実行安全性を確保してください。競合状態はトラフィック制御を破壊します。 - 分散レート制限 例:すべてのトラフィック制御コンポーネントはインメモリです。 本番環境:マルチインスタンスのデプロイメントでは、各インスタンスが独立してスロットルします。合計使用量が制限を超える可能性があります。すべてのノードで一元的に使用量を管理するために、中央集権的なカウンター (Redis など) を使用してください。
- 優先度付きキューとスターベーション防止 例:優先度の区別はありません。適応型輻輳制御戦略は、スケジューリングパフォーマンスのために非厳密な FIFO ウェイクアップを使用します。 本番環境:高/低優先度のリクエストには、重み付き優先度付きキューを実装して、高優先度トラフィックの帯域幅を保証します。低優先度キューには最小クォータを予約して、スターベーションを防ぎます。